Laboratorium 2
Zadania laboratoryjne dla studentów IT - ocena 4.0

Poziom: ocena 4.0 - kryptoanaliza statystyczna i programistyczna w środowisku Linux / Python

Zestaw 10 zaawansowanych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 2 (szyfrowanie konwencjonalne - techniki klasyczne).
Zadania do wykonania samodzielnego.

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 4.0 wymagają łączenia analizy teoretycznej z pisaniem i uruchamianiem skryptów w języku Python w środowisku konsolowym emulatora JSLinux Alpine (lub lokalnym interpreterze) oraz zaawansowanymi narzędziami analitycznymi online (CyberChef, CrypTool-Online, dCode, Boxentriq).
  • Zakres zadań obejmuje m.in.: automatyczny test chi-kwadrat, arytmetykę modularną w kryptoanalizie afinicznej, metodę Kasiskiego i test indeksu zbieżności Friedmana, dekompozycję Vigenère’a na kolumny, analizę niszczenia digramów w podwójnej transpozycji, matryce obrotowe Fleissnera, anatomię szyfru Playfair, modelowanie łącznicy Enigmy oraz analizę podatności Two-Time Pad w szyfrze jednorazowym.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (4.0).
    • Opis konfiguracji środowiska badawczego, wersji interpretera Python oraz wykorzystanych narzędzi internetowych.
    • Pełny kod źródłowy opracowanych skryptów w języku Python opatrzony komentarzami technicznymi.
    • Opis procesu badawczego: zrzuty ekranu konsoli i serwisów WWW, wygenerowane tabele wyników, obliczone statystyki i wykazane zależności kryptoanalityczne.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami) oraz bibliografia techniczna i źródła internetowe.
Kryptologia
lab 2 - 4.0
Spis
Spis zadań laboratoryjnych na ocenę 4.0
01/10
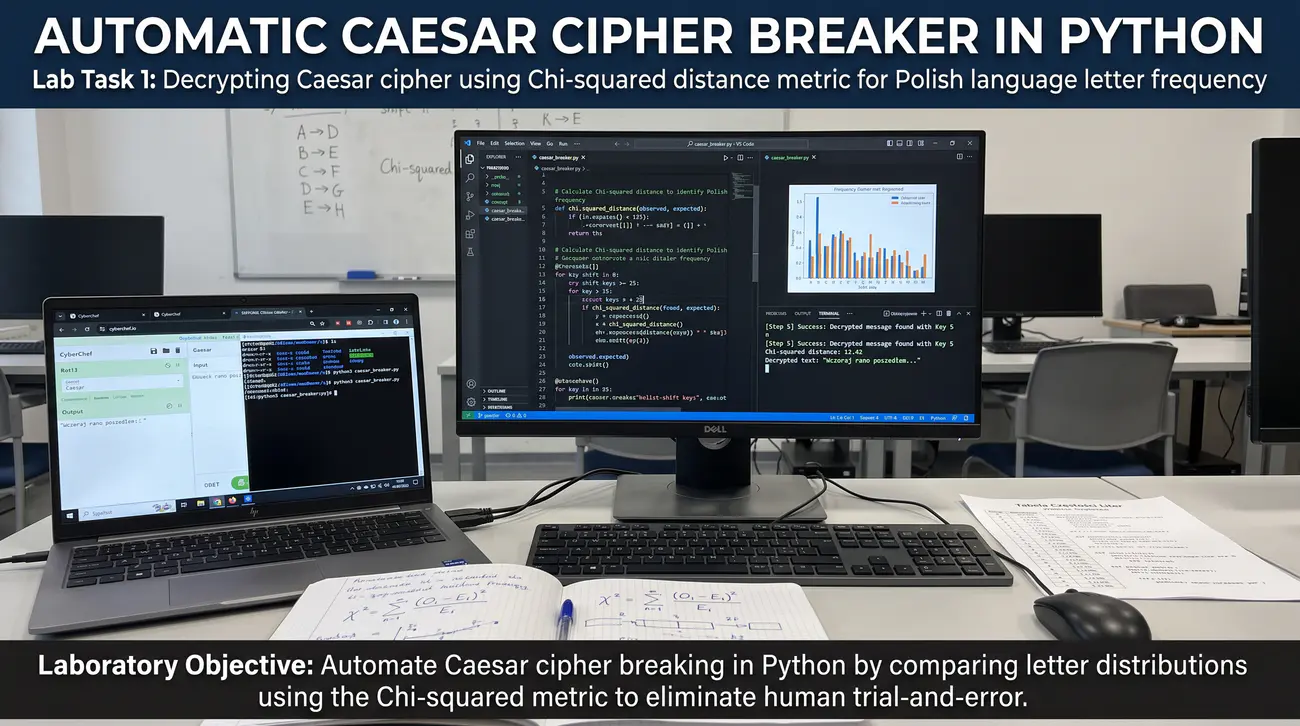
Zadanie 1. Automatyczny łamacz szyfru Cezara w Pythonie z metryką odległości chi-kwadrat
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 2 - slajdy 8, 13, 38: kryptoanaliza szyfru Cezara, test dopasowania chi-kwadrat do rozkładu liter języka polskiego, automatyzacja w Pythonie, eliminacja subiektywnej oceny człowieka.

Cel

Celem ćwiczenia jest zaimplementowanie i przetestowanie automatycznego kryptoanalityka szyfru Cezara opartego na statystyce matematycznej. Student tworzy w języku Python w środowisku JSLinux program obliczający odległość chi-kwadrat pomiędzy empirycznym rozkładem liter w odszyfrowanym tekście a wzorcem języka polskiego dla wszystkich 25 przesunięć. Program ma bezbłędnie i bez udziału człowieka wskazywać poprawny klucz dla tekstów o różnej długości.

Scenariusz – opis

W ramach tego zadania przechodzisz od prostych ręcznych prób do w pełni zautomatyzowanej kryptoanalizy statystycznej szyfru Cezara. Uruchamiasz przeglądarkę internetową i otwierasz emulator JSLinux Alpine pod adresem bellard.org/jslinux oraz serwis CyberChef. W pierwszej kolejności tworzysz w CyberChef zestaw trzech testowych szyfrogramów o zróżnicowanej długości: 30 znaków, 100 znaków oraz 400 znaków. Wszystkie komunikaty przygotowujesz w języku polskim bez znaków diakrytycznych i szyfrujesz losowo wybranymi przesunięciami. W konsoli JSLinux uruchamiasz edytor tekstu nano lub vi i tworzysz plik programu caesar_solver.py.

Co ma wykonać student / grupa

W programie definiujesz słownik wzorcowych częstości liter alfabetu łacińskiego dla języka polskiego na podstawie danych z wykładu (slajdy 8 i 13). Implementujesz funkcję deszyfrującą tekst dla zadanego przesunięcia k od 1 do 25 przy użyciu arytmetyki modularnej.

Następnie implementujesz funkcję obliczającą statystykę chi-kwadrat według wzoru sumującego kwadraty różnic liczebności obserwowanych i oczekiwanych podzielone przez liczebność oczekiwaną. Zapewniasz, że program ignoruje spacje i znaki interpunkcyjne, a wielkie i małe litery traktuje jednolicie. Główna pętla skryptu przetwarza wszystkie 25 potencjalnych przesunięć i rejestruje wartość chi-kwadrat dla każdego wariantu. Program automatycznie wskazuje to przesunięcie, dla którego wyliczona wartość statystyki jest najmniejsza, co odpowiada największej zgodności z językiem polskim.

Uruchamiasz program dla najdłuższego szyfrogramu liczącego 400 znaków i analizujesz wygenerowaną tabelę wyników. Odnotowujesz, że minimum funkcji chi-kwadrat jednoznacznie wskazuje poprawny klucz z bardzo dużą przewagą nad pozostałymi wariantami. Następnie testujesz działanie algorytmu na średnim szyfrogramie o długości 100 znaków, weryfikując stabilność decyzji programu.

Wreszcie uruchamiasz skrypt na najkrótszym szyfrogramie liczącym 30 znaków i analizujesz ewentualne fluktuacje statystyczne. Zauważasz, że dla bardzo krótkich tekstów naturalne wahania frekwencji liter mogą zbliżyć wartość chi-kwadrat innych przesunięć do minimum. Wprowadzasz do programu mechanizm wypisujący trzy najlepsze dopasowania wraz z odpowiadającymi im fragmentami odszyfrowanego tekstu. Porównujesz wyniki działania swojego skryptu z automatycznym łamaczem ROT13 Brute Force w CyberChef. Wykonujesz zrzuty ekranu kodu źródłowego programu w JSLinux oraz jego wyjścia dla wszystkich trzech badanych próbek. Sporządzasz tabelę zestawiającą długość szyfrogramu, poprawny klucz, wyliczoną wartość chi-kwadrat oraz margines przewagi nad drugim kandydatem. Formułujesz podsumowanie techniczne wyjaśniające, jak kryteria statystyczne zastępują konieczność czytania tekstu przez człowieka.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine i upewnij się, że masz dostęp do środowiska python3.
  2. Otwórz w przeglądarce serwis CyberChef (gchq.github.io/CyberChef).
  3. Przygotuj trzy teksty w języku polskim: krótki (30 liter), średni (100 liter) i długi (400 liter).
  4. Zaszyfruj każdy tekst innym kluczem Cezara w CyberChef i zapisz szyfrogramy do plików w JSLinux.
  5. Stwórz w JSLinux plik caesar_solver.py przy użyciu edytora nano.
  6. Zdefiniuj tabelę oczekiwanych częstości liter języka polskiego (np. A: 0.089, I: 0.082, E: 0.076...).
  7. Zaimplementuj funkcję deszyfrowania z przesunięciem k: c_dec = (ord( char) - ord('A') - k) % 26.
  8. Napisz funkcję zliczającą litery w tekście testowym i obliczającą częstości empiryczne.
  9. Zaimplementuj wzór statystyki chi-kwadrat: chi2 = sum(pow(obs[ c] - exp[c], 2) / exp[c] for c in ALPHABET).
  10. Zbuduj pętlę testującą k w zakresie od 1 do 25 i rejestrującą pary (k, chi2).
  11. Dodaj sortowanie wyników i automatyczne wyłonienie klucza o minimalnej wartości chi-kwadrat.
  12. Uruchom skrypt dla tekstu 400-znakowego: python3 caesar_solver.py dlugi.txt.
  13. Zweryfikuj poprawność odzyskanego klucza i zapotrzebowanie czasowe na obliczenia.
  14. Powtórz test dla pliku 100-znakowego oraz 30-znakowego, odnotowując wartości metryki. Dla każdej długości zapisz pełny ranking 3 najlepszych kandydatów wraz z wartościami chi2 i odstępem kandydata 1. od 2. Kryterium zaliczenia: dla 400 i 100 znaków minimum chi2 musi być jednoznaczne (wyraźny odstęp od reszty); dla 30 znaków zaliczeniem jest trafienie klucza w top-3 albo rzetelnie udokumentowane pudło z analizą fluktuacji - samo pudło nie jest porażką, jeżeli je wyjaśnisz.
  15. Wykonaj zrzuty ekranu kodu programu oraz tabeli wyników wypisanej przez konsolę.
  16. Zestaw otrzymane rezultaty w sprawozdaniu wraz z omówieniem zjawiska fluktuacji w krótkich próbkach.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt Python (JSLinux) i zachowano pełny log: ranking 25 kluczy metryką chi-kwadrat ze wskazaniem minimum jako klucza poprawnego.
  2. Dołączono kod (szkielet ze startera + własne min. 20 linii): funkcja chi-kwadrat na wzorcu PL, pętla po przesunięciach, wybór minimum.
  3. Przeprowadzono test pozytywny (długi tekst PL — trafienie za 1. razem) i negatywny (tekst <40 znaków / losowy — wykazana niepewność lub remis).
  4. Opisano wynik w 3–5 zdaniach: dlaczego minimum chi-kwadrat wskazuje klucz, wpływ długości tekstu na margines błędu, automatyzacja bez udziału człowieka.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób metryka chi-kwadrat pozwala obiektywnie zautomatyzować proces łamania szyfru bez udziału człowieka.
  • Jak długość analizowanego tekstu wpływa na poziom ufności i margines błędu decyzji kryptoanalitycznej.
  • Dlaczego podejście statystyczne jest fundamentem współczesnych automatycznych kryptoanalityków.
  • Student potrafi samodzielnie zaimplementować test statystyczny chi-kwadrat w języku Python i ocenić jego skuteczność.
Zadanie 1 - ilustracja
02/10
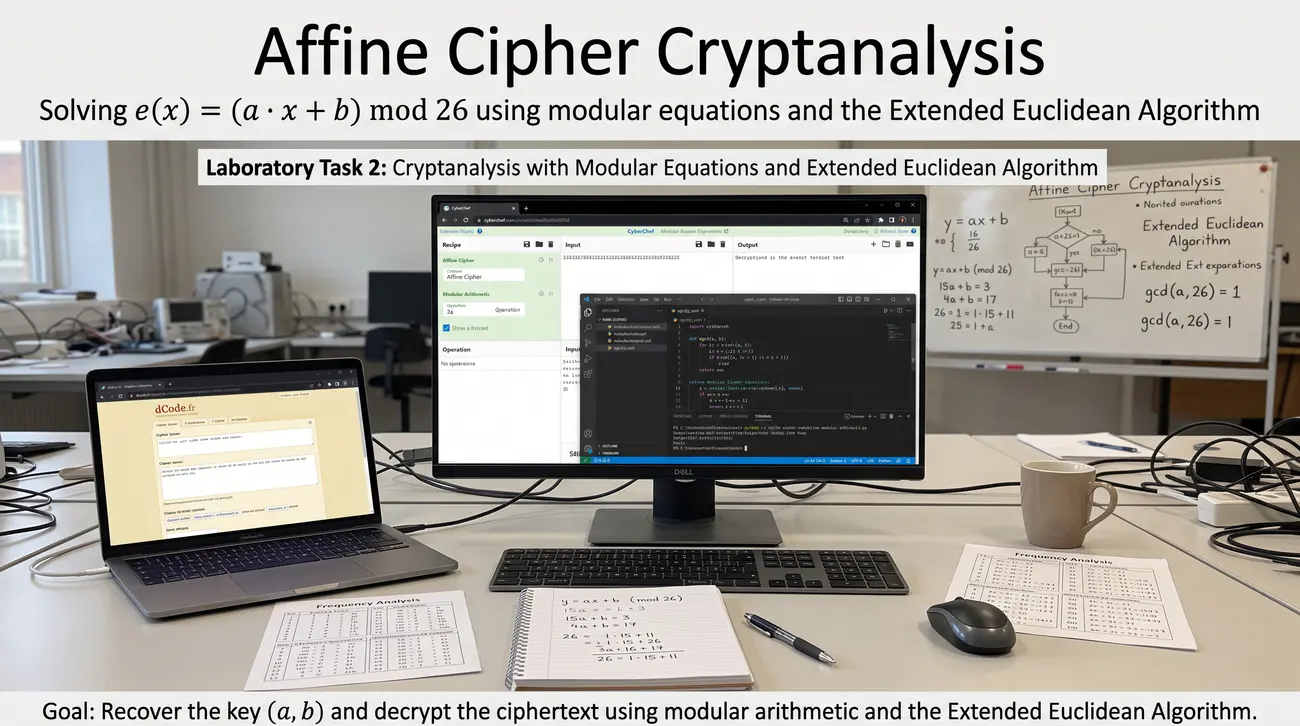
Zadanie 2. Kryptoanaliza szyfru afinicznego w oparciu o układ równań modularnych i rozszerzony algorytm Euklidesa
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 10, 11, 38: kryptoanaliza szyfru afinicznego e(x)=(a*x+b) mod 26, układ dwóch równań modularnych, wyznaczanie odwrotności modularnej a^(-1) mod 26 rozszerzonym algorytmem Euklidesa.

Cel

Celem zadania jest praktyczne rozwiązanie problemu kryptoanalizy szyfru afinicznego z wykorzystaniem aparatu arytmetyki modularnej. Student identyfikuje w przechwyconym szyfrogramie dwie najczęstsze litery, formułuje układ dwóch równań liniowych z dwiema niewiadomymi modulo 26, implementuje rozszerzony algorytm Euklidesa w Pythonie do wyznaczenia odwrotności modularnej, a następnie weryfikuje odzyskane parametry na pełnym tekście w serwisie dCode.

Scenariusz – opis

W tym zadaniu mierzysz się z matematycznym przełamaniem szyfru afinicznego bez przeszukiwania siłowego przestrzeni 312 kluczy. Uruchamiasz przeglądarkę internetową, otwierasz serwis CyberChef, narzędzie dCode Affine Cipher oraz konsolę JSLinux. W serwisie CyberChef przygotowujesz polski tekst techniczny o długości około 400 znaków i szyfrujesz go szyfrem afinicznym z tajnymi parametrami a = 7 oraz b = 11. Wygenerowany szyfrogram traktujesz jako materiał przechwycony w kanale łączności przez stronę atakującą. Twoim pierwszym krokiem jest wyznaczenie histogramu liter szyfrogramu w CyberChef lub za pomocą konsolowego polecenia sort i uniq w JSLinux.

Co ma wykonać student / grupa

Zauważasz dwie litery o najwyższej liczbie wystąpień w szyfrogramie, na przykład litery P oraz W. Stawiasz hipotezę kryptoanalityczną, że w tekście polskim odpowiadają one odpowiednio najczęstszym literom A (numer 0) oraz I lub E (numer 8 lub 4).

Formułujesz w notatkach układ dwóch kongruencji liniowych: y_1 = (a * x_1 + b) mod 26 oraz y_2 = (a * x_2 + b) mod 26. Odejmujesz kongruencje stronami, uzyskując równanie postaci: (y_2 - y_1) = a * (x_2 - x_1) mod 26.

Przechodzisz do konsoli JSLinux i otwierasz edytor, aby stworzyć skrypt affine_crack.py. Implementujesz rozszerzony algorytm Euklidesa (egcd), który dla podanych liczb zwraca największy wspólny dzielnik oraz współczynniki Bézouta. Na bazie współczynników Bézouta tworzysz funkcję mod_inverse obliczającą odwrotność modularną liczby modulo 26. Używasz wyznaczonej odwrotności do wyliczenia wartości współczynnika mnożenia a ze sformułowanego wcześniej równania.

Po wyznaczeniu a obliczasz wartość przesunięcia b z pierwszego równania: b = (y_1 - a * x_1) mod 26. Sprawdzasz, czy wyliczone a należy do zbioru 12 dozwolonych wartości względnie pierwszych z 26. Jeżeli wartość a nie spełnia warunku lub odszyfrowany fragment jest nieczytelny, testujesz alternatywną parę najczęstszych liter (np. A oraz E). Po odnalezieniu spójnej pary parametrów a i b skrypt odszyfrowuje całą treść przechwyconej wiadomości. Wprowadzasz uzyskane parametry do modułu deszyfrującego w serwisie dCode i weryfikujesz identyczność odzyskanego tekstu jawnego. Wykonujesz zrzuty ekranu ręcznych przekształceń matematycznych, kodu rozszerzonego algorytmu Euklidesa oraz wyjścia programu.

Sporządzasz tabelę przedstawiającą testowane hipotezy par literowych i odpowiadające im rozwiązania układu równań. Podsumowujesz zadanie wnioskiem dowodzącym, że znajomość zaledwie dwóch liter pozwala natychmiast złamać szyfr afiniczny.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef oraz stronę dcode.fr/affine-cipher.
  2. Uruchom środowisko JSLinux Alpine.
  3. Zaszyfruj w CyberChef tekst 400-znakowy z kluczami a=7, b=11 i skopiuj szyfrogram do JSLinux.
  4. Wyznacz dwie najczęściej występujące litery w szyfrogramie za pomocą potoku powłoki.
  5. Zapisz układ kongruencji liniowych dla założenia x1='A' (0) i x2='E' (4) lub 'I' (8).
  6. Odejmij równania stronami w celu wyeliminowania parametru b: Delta_y = a * Delta_x (mod 26).
  7. W JSLinux utwórz plik affine_crack.py i zaimplementuj rozszerzony algorytm Euklidesa.
  8. Napisz funkcję mod_inverse(val, 26) wykorzystującą współczynnik Bézouta.
  9. Wylicz współczynnik a = (Delta_y * mod_inverse(Delta_x, 26)) % 26.
  10. Wylicz parametr b = (y1 - a * x1) % 26.
  11. Sprawdź warunek gcd(a, 26) == 1 w kodzie programu.
  12. Zaimplementuj pętlę testującą kombinacje 4 najczęstszych liter szyfrogramu z hipotezami ze zbioru {A, E, I, O} (nie więcej niż 12 układów par): każdy kandydujący klucz (a, b) oceniaj odszyfrowaniem pierwszych 60 znaków i wyborem wariantu o najmniejszym chi2 względem języka polskiego. Nie poprzestawaj na pierwszej parze top-2 - w krótkich tekstach prawdziwe A/E/I/O bywa na 3.–4. miejscu rankingu, więc wygrywa dopiero pełny przegląd hipotez.
  13. Uruchom skrypt i odczytaj odzyskane wartości parametrów a oraz b.
  14. Zweryfikuj poprawność deszyfrowania w serwisie dCode.
  15. Wykonaj zrzuty ekranu kodu źródłowego i demonstracji działania skryptu w terminalu.
  16. Sporządź dokumentację z analitycznym rozwiązaniem kongruencji i wnioskami technicznymi.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log: wykryte 2 najczęstsze litery, wyznaczony układ równań, obliczone (a,b) oraz poprawne deszyfrowanie całego szyfrogramu.
  2. Dołączono kod (własne min. 25 linii): rozszerzony Euklides (NWD + odwrotność), solver układu 2×2 mod 26, obsługa braku odwrotności.
  3. Przeprowadzono test pozytywny (szyfrogram z poprawną statystyką) i negatywny (zły wybór liter / różnica bez odwrotności — program zgłasza brak rozwiązania zamiast śmieci).
  4. Opisano w 3–5 zdaniach: dlaczego 2 litery wystarczają, rola Euklidesa, pułapka niekopierwszości różnicy z 26.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego znajomość odwzorowania zaledwie dwóch liter wystarcza do pełnego złamania szyfru afinicznego.
  • W jaki sposób rozszerzony algorytm Euklidesa pozwala wyznaczyć odwrotność modularną bez przeszukiwania.
  • Jakie ograniczenia pojawiają się, gdy różnica pozycji liter nie jest względnie pierwsza z modułem 26.
  • Student potrafi rozwiązać układ równań modularnych programistycznie oraz zinterpretować wyniki kryptoanalityczne.
Zadanie 2 - ilustracja
03/10
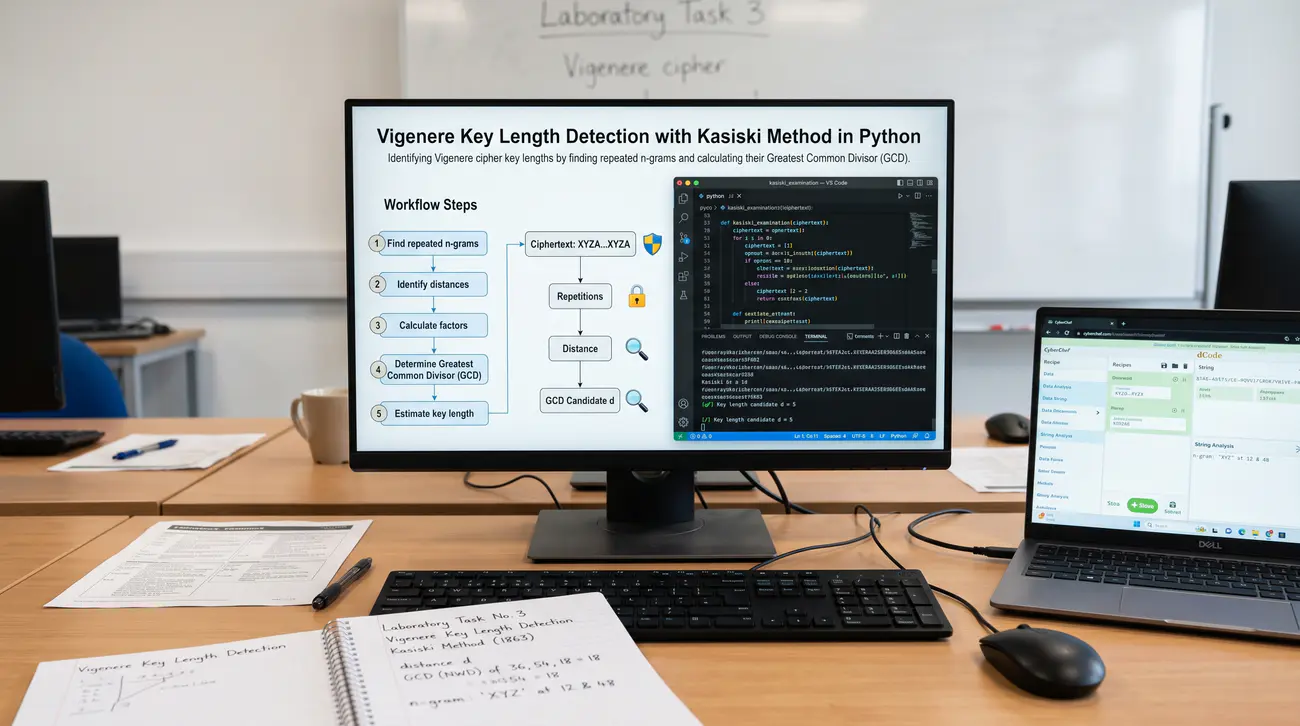
Zadanie 3. Wykrywanie długości klucza szyfru Vigenère metodą Kasiskiego przy użyciu Pythona
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 18, 19: metoda Kasiskiego (1863), identyfikacja powtórzonych n-gramów w szyfrogramie, wyznaczanie odległości między powtórzeniami, największy wspólny dzielnik (NWD) jako kandydat na długość klucza.

Cel

Celem zadania jest praktyczne opanowanie historycznej metody Kasiskiego służącej do wyznaczania długości hasła w szyfrze Vigenère’a. Student tworzy w języku Python skrypt wyszukujący powtarzające się trigramy i tetragramy w długim szyfrogramie, oblicza odległości pomiędzy ich wystąpieniami, wyznacza wspólne dzielniki tych odległości, a następnie weryfikuje poprawność estymacji w internetowym analizatorze serwisu dCode.

Scenariusz – opis

W tym zadaniu zajmujesz się przełamaniem bariery polialfabetyczności poprzez wykrycie okresu powtarzania słowa kluczowego. Uruchamiasz przeglądarkę internetową i otwierasz serwis CyberChef, narzędzie dCode Kasiski pod adresem dcode.fr/kasiski-test oraz emulator JSLinux. W serwisie CyberChef przygotowujesz długi tekst w języku polskim liczący co najmniej 800 znaków bez znaków diakrytycznych. Dobierasz słowo kluczowe o długości 6 liter, na przykład BRAMKA lub SYGNAŁ (zapisane jako SYGNAL), i szyfrujesz tekst modułem Vigenère Encode. Zapisujesz otrzymany szyfrogram do pliku vigenere_kasiski.txt w środowisku JSLinux.

Co ma wykonać student / grupa

Tworzysz w JSLinux plik skryptu kasiski_analyzer.py w języku Python. Implementujesz w skrypcie funkcję skanującą szyfrogram i odnajdującą wszystkie powtarzające się fragmenty o długości 3, 4 oraz 5 liter. Dla każdej powtórzonej sekwencji znaków program rejestruje pozycje jej wystąpień oraz wylicza odległość w znakach między kolejnymi powtórzeniami. Zgodnie z teorią Kasiskiego powtórzenie tego samego fragmentu szyfrogramu najczęściej wynika z zaszyfrowania identycznego słowa tekstu jawnego tą samą partią klucza.

W związku z tym odległości między powtórzeniami powinny być wielokrotnościami rzeczywistej długości hasła. Wzbogacasz program o funkcję rozkładającą każdą obliczoną odległość na dzielniki całkowite w zakresie od 2 do 15. Skrypt zlicza wystąpienia poszczególnych dzielników i generuje ranking najbardziej prawdopodobnych długości klucza. Uruchamiasz program na przygotowanym pliku z szyfrogramem i analizujesz wygenerowane zestawienie. Odnotowujesz, że dzielnik odpowiadający długości 6 (oraz jego wielokrotności i poddzielniki, np. 2 i 3) zdecydowanie dominuje w rankingu.

Przechodzisz do serwisu dCode do modułu Kasiski Test i wklejasz ten sam szyfrogram w celu walidacji. Porównujesz listę odnalezionych n-gramów oraz wyznaczonych dzielników z wynikami wygenerowanymi przez twój skrypt. Wykonujesz test odporności metody: powtarzasz analizę na szyfrogramie o długości zaledwie 150 znaków. Zauważasz, że w krótkim tekście liczba powtórzeń jest mała, a część z nich powstaje przypadkowo, co może zaburzyć poprawność estymacji. Wykonujesz zrzuty ekranu kodu źródłowego w JSLinux, wyników zliczania dzielników oraz wykresu z serwisu dCode. Sporządzasz tabelę przedstawiającą powtórzone sekwencje, ich pozycje, odległości oraz wyznaczone dzielniki. Podsumowujesz ćwiczenie wnioskiem wyjaśniającym, dlaczego metoda Kasiskiego zredukowała szyfr polialfabetyczny do problemu szyfrów Cezara.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef oraz stronę dcode.fr/kasiski-test.
  2. Uruchom maszynę JSLinux Alpine.
  3. Przygotuj polski tekst jawny o długości minimum 800 znaków.
  4. Zaszyfruj tekst w CyberChef szyfrem Vigenère'a z 6-literowym kluczem.
  5. Zapisz szyfrogram w pliku vigenere_kasiski.txt w JSLinux.
  6. Stwórz w JSLinux skrypt kasiski_analyzer.py.
  7. Zaimplementuj algorytm wyszukiwania powtarzających się trigramów i tetragramów.
  8. Napisz kod obliczający odległości (interwały) pomiędzy identycznymi sekwencjami.
  9. Zaimplementuj funkcję wyznaczającą dzielniki całkowite obliczonych odległości (2..15).
  10. Dodaj zliczanie wystąpień dzielników i sortowanie wyników za pomocą collections.Counter.
  11. Uruchom skrypt: python3 kasiski_analyzer.py i zanotuj dominujący dzielnik.
  12. Wprowadź szyfrogram do narzędzia Kasiski Test w serwisie dCode i uruchom analizę.
  13. Porównaj zidentyfikowane n-gramy oraz sugerowaną długość klucza z wynikami skryptu.
  14. Przeprowadź eksperyment z krótkim szyfrogramem (150 znaków) i zbadaj powtórzenia przypadkowe. Jeżeli skrypt nie znajdzie żadnego powtórzonego trigramu (sytuacja normalna dla krótkich tekstów), nie wymuszaj wyniku: odnotuj zerowy zbiór powtórzeń jako wniosek o granicy metody i wyznacz długość klucza testem Friedmana z Zadania 4, porównując obie ścieżki w raporcie.
  15. Wykonaj zrzuty ekranu terminala linuksowego oraz panelu wyników w dCode.
  16. Opracuj sprawozdanie z tabelarycznym zestawieniem znalezionych odległości i analizą błędu.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt Kasiskiego i zachowano log: lista powtórzonych tri-/tetragramów, odległości, NWD odległości = długość klucza.
  2. Dołączono kod (własne min. 25 linii): wyszukiwanie powtórzeń, funkcja NWD dla wielu odległości, ranking kandydatów.
  3. Przeprowadzono test pozytywny (długi szyfrogram Vigenère — poprawna długość) i negatywny (krótki tekst — wykazane fałszywe powtórzenia/szum).
  4. Opisano w 3–5 zdaniach: związek periodyczności z powtórzeniami, dlaczego NWD wskazuje klucz, rola długości tekstu.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób periodyczność powtarzania klucza prowadzi do powstawania identycznych sekwencji w szyfrogramie.
  • Dlaczego największy wspólny dzielnik odległości wskazuje rzeczywistą długość słowa kluczowego.
  • Jakie znaczenie ma długość przechwyconego tekstu dla eliminacji powtórzeń przypadkowych (szumu statystycznego).
  • Student potrafi zaimplementować algorytm Kasiskiego w języku Python i wyznaczyć długość klucza szyfru Vigenère’a.
Zadanie 3 - ilustracja
04/10
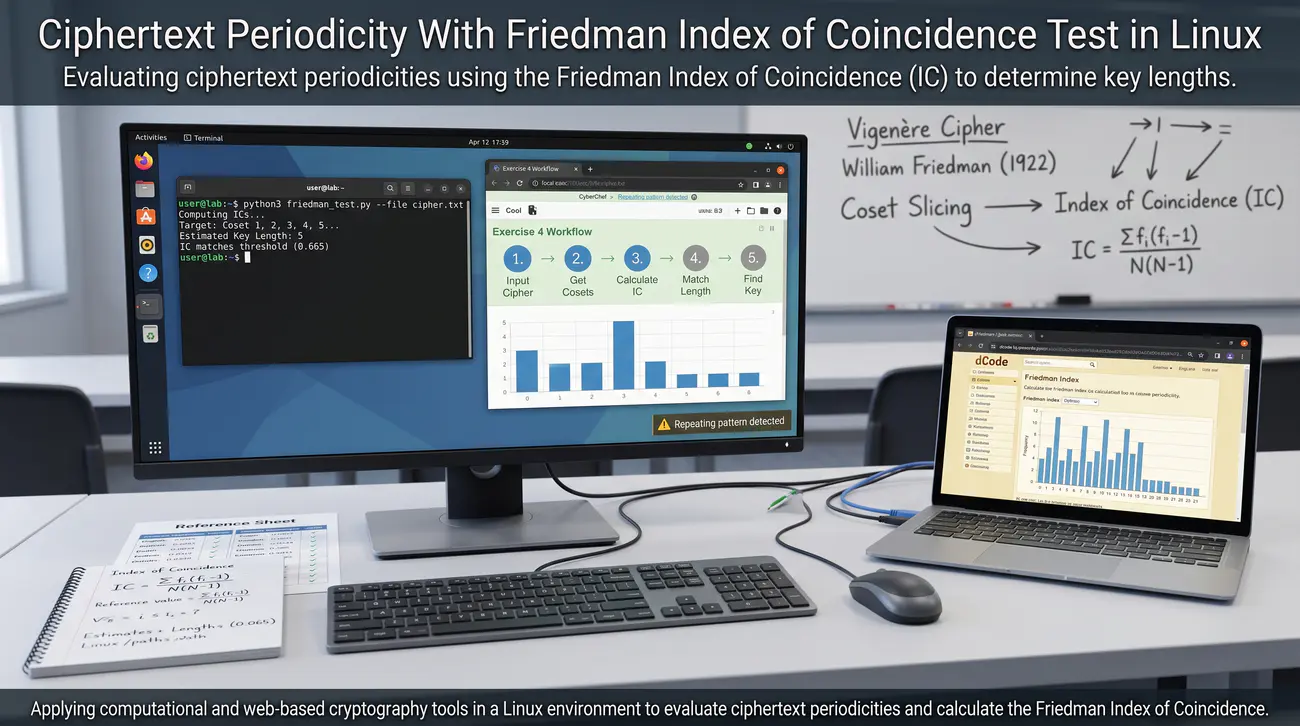
Zadanie 4. Wyznaczanie okresowości szyfrogramu testem indeksu zbieżności Friedmana w środowisku Linux
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + dCode + Boxentriq + Python 3 + CrypTool-Online
Podstawa wykładowa: Część 2 - slajdy 20, 38: test indeksu zbieżności (Index of Coincidence - IC), William Friedman (1922), wzór IC, wartości progowe dla języków naturalnych i ciągu losowego, badanie okresowości przez podział na paski kolumnowe.

Cel

Celem ćwiczenia jest zbadanie indeksu zbieżności Friedmana jako narzędzia diagnostycznego w kryptoanalizie. Student implementuje w Pythonie w środowisku JSLinux formułę obliczania IC, bada wartość wskaźnika dla tekstu jawnego w języku polskim, dla szyfrogramu Cezara, dla szyfrogramu Vigenère’a oraz dla ciągu czysto losowego, a następnie wykorzystuje podział na kolumny do precyzyjnego wyznaczenia długości klucza.

Scenariusz – opis

W ramach tego zadania poznajesz potężne narzędzie statystyczne opracowane przez Williama Friedmana – indeks zbieżności. Uruchamiasz przeglądarkę internetową, wchodzisz do narzędzia Boxentriq Text Analysis pod adresem boxentriq.com/code-breaking/text-analysis oraz konsoli JSLinux. W pierwszej części ćwiczenia zapoznajesz się ze wzorem matematycznym indeksu zbieżności: IC = sum(f_i * (f_i - 1)) / (N * (N - 1)). Wzór ten określa prawdopodobieństwo, że dwie losowo wybrane litery z danego tekstu okażą się identyczne. Dla języka polskiego wartość teoretyczna wynosi około 0.061, dla angielskiego 0.067, natomiast dla ciągu idealnie losowego zbliża się do 1/26, czyli około 0.038.

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz plik programu ic_calculator.py w języku Python. Implementujesz funkcję liczącą wartość IC dla dowolnego przekazanego ciągu znaków po uprzednim usunięciu spacji i normalizacji liter. Przygotowujesz polski tekst techniczny liczący 600 znaków i obliczasz jego indeks zbieżności w swoim programie oraz w serwisie Boxentriq. Potwierdzasz, że wartość IC dla tekstu jawnego wynosi około 0.060-0.062, co idealnie zgadza się z teorią. Następnie szyfrujesz ten tekst szyfrem Cezara i ponownie obliczasz IC, odnotowując, że wartość nie ulega zmianie, gdyż permutacja liter nie zmienia prawdopodobieństwa kolizji par.

W kolejnym kroku szyfrujesz ten sam tekst szyfrem Vigenère’a z hasłem o długości 5 liter i mierzysz IC całego szyfrogramu. Zauważasz gwałtowny spadek wartości IC do poziomu około 0.042, co świadczy o silnym wymieszaniu alfabetów zbliżonym do szumu losowego. Rozbudowujesz swój skrypt o algorytm podziału szyfrogramu na d kolumn (podciągów) dla hipotetycznych długości klucza d od 1 do 10. Dla każdego badanego okresu d program oblicza średnią wartość IC ze wszystkich d powstałych kolumn.

Uruchamiasz procedurę i analizujesz wygenerowaną tabelę średnich wartości IC dla poszczególnych kandydatów na okres d. Obserwujesz wyraźny skok średniego IC z powrotem do poziomu około 0.061 wyłącznie dla d = 5 oraz jego wielokrotności d = 10. Dla pozostałych wartości d średnie IC pozostaje na niskim poziomie około 0.040-0.043. Weryfikujesz uzyskany wynik w serwisie CrypTool-Online lub dCode Index of Coincidence. Wykonujesz zrzuty ekranu konsoli prezentujące kod programu, wyniki obliczeń dla poszczególnych etapów oraz tabelę testu okresowości. Sporządzasz wykres słupkowy zależności wartości średniego IC od testowanego okresu d. Podsumowujesz zadanie wnioskiem wyjaśniającym, dlaczego indeks zbieżności jest odporny na wady metody Kasiskiego w krótkich tekstach.

Przykładowe kroki do wykonania jako sugestia

  1. Wejdź na stronę serwisu Boxentriq (boxentriq.com/code-breaking/text-analysis).
  2. Uruchom konsolę JSLinux Alpine.
  3. Przygotuj polski tekst jawny o długości minimum 600 znaków.
  4. Stwórz w JSLinux plik ic_calculator.py przy użyciu edytora nano.
  5. Zaimplementuj funkcję obliczania indeksu zbieżności według wzoru Friedmana.
  6. Zanim zmierzysz cokolwiek, przetestuj funkcję testem znanej odpowiedzi: dla tekstu AAAAABBBBB (N = 10, po pięć A i B) poprawny wynik to IC = (5·4 + 5·4)/(10·9) = 40/90 ≈ 0,4444 - program ma wypisać wartość zgodną z oczekiwaną z dokładnością do 0,0001, w przeciwnym razie szukaj błędu w mianowniku N(N−1), a nie w danych.
  7. Oblicz IC tekstu jawnego i porównaj z wartością referencyjną dla języka polskiego (~0.061).
  8. Zaszyfruj tekst szyfrem Cezara i wykaż niezmienność wartości IC.
  9. Zaszyfruj tekst szyfrem Vigenère'a z 5-literowym hasłem (np. WIRUS) w CyberChef.
  10. Oblicz IC pełnego szyfrogramu Vigenère'a i zarejestruj spadek w okolice 0.042.
  11. Zaimplementuj w skrypcie funkcję dzielącą tekst na d kolumn: [tekst[i::d] for i in range(d)].
  12. Oblicz średnią wartość IC kolumn dla d od 1 do 10.
  13. Wyświetl sformatowaną tabelę: okres d, średnie IC, interpretacja (losowy vs język naturalny).
  14. Wskaż okres d wykazujący pik wartości IC odpowiadający rzeczywistemu kluczowi.
  15. Porównaj wyniki z analizatorem indeksu zbieżności w serwisie dCode.
  16. Wykonaj zrzuty ekranu kodu, tabeli z terminala oraz panelu Boxentriq.
  17. Sporządź raport dokumentujący matematyczne podstawy i wyniki testu Friedmana.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt IC i zachowano log: IC tekstu jawnego PL (~0.06–0.07), IC szyfrogramu Vigenère (~0.038) oraz IC pasków po podziale na k kolumn (powrót do ~0.06).
  2. Dołączono kod (własne min. 20 linii): funkcja IC Friedmana, podział na paski dla k=1..K, wykres/tabela IC(k).
  3. Przeprowadzono test pozytywny (monoalfabetyczny zachowuje IC) i negatywny (losowy tekst ~0.038 — brak okresowości mimo podziału).
  4. Opisano w 3–5 zdaniach: dlaczego monoalfabetyczność zachowuje IC, jak paski demaskują k, przewaga nad Kasiskiem przy braku powtórzonych słów.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego szyfry monoalfabetyczne zachowują nienaruszony indeks zbieżności języka tekstu jawnego.
  • W jaki sposób rozbicie szyfrogramu Vigenère’a na paski przywraca cechy monoalfabetyczne wewnątrz każdej kolumny.
  • Dlaczego test Friedmana działa niezawodnie nawet w przypadku braku powtarzających się słów w szyfrogramie.
  • Student potrafi napisać program obliczający indeks zbieżności i wykorzystać go do precyzyjnej detekcji okresowości.
Zadanie 4 - ilustracja
05/10
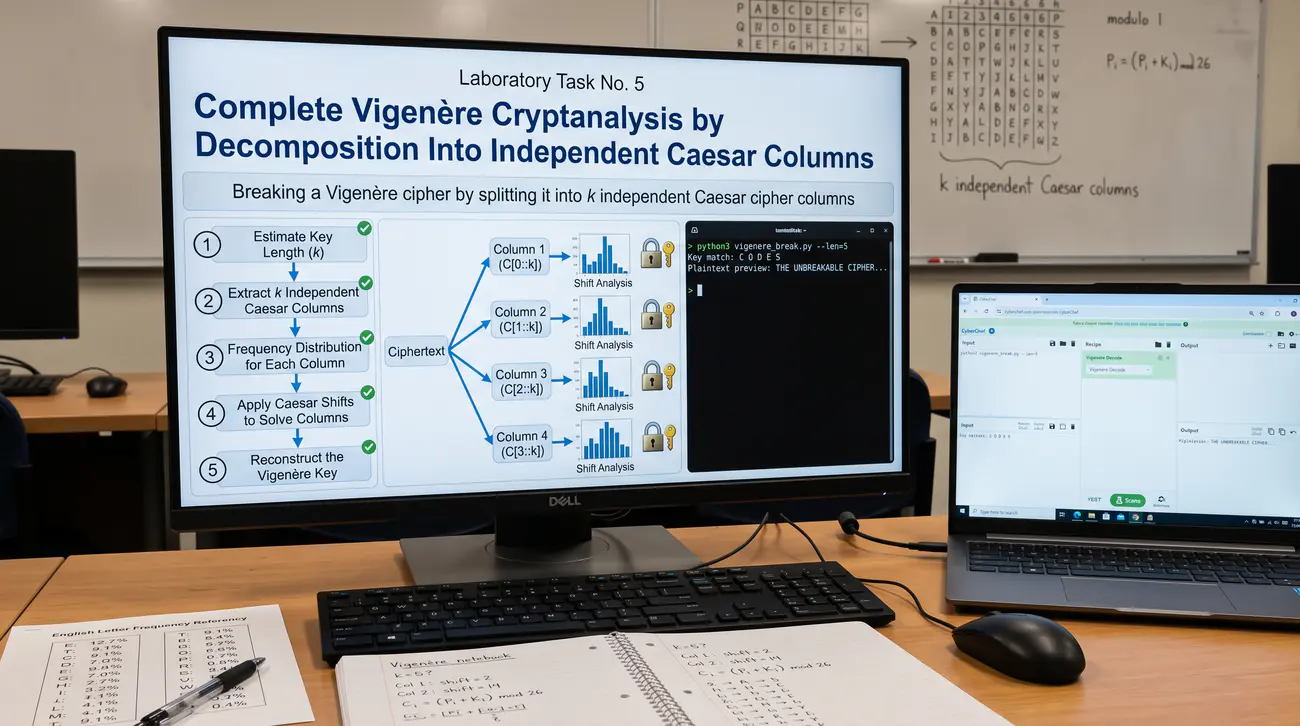
Zadanie 5. Kompletna kryptoanaliza szyfru Vigenère przez dekompozycję na niezależne kolumny Cezara
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3 + CrypTool-Online
Podstawa wykładowa: Część 2 - slajdy 21, 46: kompletna kryptoanaliza szyfru Vigenère’a, dekompozycja na k niezależnych kolumn po wyznaczeniu długości klucza, rozwiązanie każdej kolumny analizą przesunięcia Cezara, złożenie hasła i odszyfrowanie.

Cel

Celem zadania jest przeprowadzenie pełnej, dwuetapowej kryptoanalizy szyfru Vigenère’a od przechwyconego szyfrogramu do odzyskania tekstu jawnego i tajnego hasła. Student integruje wiedzę z poprzednich ćwiczeń, tworzy w Pythonie program dekomponujący szyfrogram na k kolumn, łamie każdą kolumnę osobnym dopasowaniem przesunięcia Cezara, rekonstruuje słowo kluczowe, a następnie weryfikuje rezultat w narzędziu CrypTool-Online.

Scenariusz – opis

W tym zadaniu realizujesz najbardziej klasyczny i elegancki atak kryptoanalityczny XIX wieku, wieńczący badania Babbage'a i Kasiskiego. Otwierasz w przeglądarce narzędzie CyberChef, platformę edukacyjną CrypTool-Online pod adresem cryptool.org/en/cto/vigenere oraz konsolę JSLinux. W CyberChef przygotowujesz polski tekst o objętości około 500 znaków i szyfrujesz go tajnym hasłem o długości 5 liter, którego postać zapisujesz w celach kontrolnych. Przekazujesz wygenerowany szyfrogram do pliku vigenere_challenge.txt w środowisku JSLinux, udając, że znasz wyłącznie sam szyfrogram. Tworzysz w JSLinux skrypt vigenere_full_breaker.py, który połączy wszystkie etapy ataku w jeden spójny proces.

Co ma wykonać student / grupa

W pierwszym module skryptu implementujesz automatyczne wyznaczenie długości klucza k przy użyciu testu indeksu zbieżności Friedmana z Zadania 4. Program bada kandydatów na długość klucza od 1 do 12 i automatycznie ustala optymalną wartość k = 5 na podstawie maksymalnego średniego IC. W drugim module program dokonuje formalnego podziału szyfrogramu na k niezależnych podciągów znaków (tzw. plastrów lub kolumn). Każdy podciąg zawiera litery szyfrowane dokładnie tą samą literą hasła, co oznacza, że stanowi autonomiczny szyfrogram Cezara.

W trzecim module program poddaje każdą z k kolumn analizie statystycznej chi-kwadrat z Zadania 1, porównując jej rozkład z językiem polskim. Dla każdej kolumny skrypt typuje najbardziej prawdopodobne przesunięcie i zamienia je na odpowiadającą mu literę alfabetu. Skrypt łączy wyznaczone litery w jeden ciąg znaków, prezentując zrekonstruowane słowo kluczowe. W czwartym module program wykorzystuje odzyskane hasło do pełnego odszyfrowania wiadomości i wypisuje tekst jawny na ekranie.

Uruchamiasz swój skrypt w konsoli JSLinux i obserwujesz kolejno: wyznaczoną długość klucza, odgadnięte litery hasła oraz czytelny tekst końcowy. Porównujesz odzyskane hasło z tajnym kluczem użytym podczas szyfrowania w CyberChef, sprawdzając, czy każda litera została odgadnięta bezbłędnie.

Przechodzisz do serwisu CrypTool-Online i wklejasz ten sam szyfrogram do modułu Vigenère Cipher Analysis. Uruchamiasz automatyczny proces analityczny w CrypTool i porównujesz wygenerowane przez to narzędzie statystyki z wyjściem twojego programu. Badaj zachowanie skryptu w przypadku, gdy jedna z kolumn wygeneruje alternatywną literę z powodu nietypowego słownictwa. Wykonujesz zrzuty ekranu kodu programu w JSLinux, terminala z pełnym procesem łamania oraz widoku z serwisu CrypTool-Online. Sporządzasz tabelę dokumentującą każdą z k kolumn: jej długość, najczęstsze litery, zidentyfikowane przesunięcie i wyznaczoną literę klucza. Formułujesz podsumowanie techniczne wyjaśniające, w jaki sposób dekompozycja matematyczna redukuje złożoność problemu.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef oraz CrypTool-Online (cryptool.org/en/cto/vigenere).
  2. Uruchom terminal JSLinux Alpine.
  3. Zaszyfruj w CyberChef tekst 500-znakowy z 5-literowym kluczem (np. BASZTA).
  4. Zapisz szyfrogram w pliku vigenere_challenge.txt w JSLinux.
  5. Stwórz w JSLinux plik vigenere_full_breaker.py.
  6. Zaimplementuj moduł 1: estymacja długości klucza k przy użyciu średniego IC kolumn.
  7. Zaimplementuj moduł 2: dekompozycja tekstu na k niezależnych wektorów znakowych.
  8. Zaimplementuj moduł 3: łamanie każdego wektora metodą chi-kwadrat z rozkładem wzorcowym języka polskiego.
  9. Napisz kod przekształcający wyznaczone przesunięcia kolumn na litery słowa kluczowego.
  10. Zaimplementuj moduł 4: odszyfrowanie pełnego tekstu znalezionym kluczem.
  11. Uruchom skrypt: python3 vigenere_full_breaker.py vigenere_challenge.txt.
  12. Zweryfikuj zgodność odzyskanego słowa kluczowego z kluczem użytym w CyberChef.
  13. Wklej szyfrogram do modułu analitycznego CrypTool-Online i porównaj wyniki obu implementacji.
  14. Przeanalizuj ewentualne rozbieżności pojedynczych liter i wyjaśnij ich podłoże statystyczne. Pamiętaj o kruchości kaskadowej: błędne k z modułu 1 psuje wszystkie kolumny naraz, więc przy nieczytelnym wyniku powtórz atak dla k−1 i k+1, a dla każdej długości policz chi2 całego odszyfrowanego tekstu. Kryterium stopu: wygrywa wariant o najmniejszym chi2 całości dający czytelny tekst polski i zgodny z kluczem kontrolnym - sam pik IC w module 1 nie jest jeszcze zaliczeniem.
  15. Wykonaj zrzuty ekranu kodu źródłowego, wyjścia konsoli oraz panelu CrypTool-Online.
  16. Sporządź wyczerpujący raport laboratoryjny opisujący cały łańcuch ataku kryptoanalitycznego.

Kontrola zaliczenia (checklist):

  1. Uruchomiono kompletny łańcuch i zachowano log: wykryte k (Friedman/Kasiski) → k złamanych kolumn Cezara chi-kwadrat → odzyskane hasło i pełny tekst jawny.
  2. Dołączono kod (własne min. 30 linii): integracja detekcji k + dekompozycji na kolumny + łamacz Cezara na każdej kolumnie.
  3. Przeprowadzono test pozytywny (pełne odzyskanie hasła i tekstu) i negatywny (błędne k — program pokazuje śmieci i sygnalizuje niepowodzenie zamiast fałszywego sukcesu).
  4. Opisano w 3–5 zdaniach: redukcja złożoności przez dekompozycję, synergia Friedmana z chi-kwadrat, metodologia redukcji problemu.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Jak dekompozycja polialfabetycznego szyfru na k kolumn Cezara dramatycznie redukuje przestrzeń poszukiwań.
  • W jaki sposób połączenie testu Friedmana z metryką chi-kwadrat tworzy w pełni automatyczny łamacz Vigenère’a.
  • Dlaczego kryptoanaliza historycznych szyfrów symetrycznych opiera się na stopniowej redukcji złożoności problemu.
  • Student potrafi zaprojektować i wdrożyć kompletny łańcuch kryptoanalizy szyfru polialfabetycznego w języku Python.
Zadanie 5 - ilustracja
06/10
Zadanie 6. Podwójna transpozycja kolumnowa – implementacja i analiza niszczenia digramów w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 26, 27, 31, 42: szyfry przestawieniowe, podwójna transpozycja kolumnowa, rozbijanie n-gramów, zachowanie rozkładu jednoliterowego, wzrost trudności kryptoanalizy w stosunku do pojedynczej transpozycji.

Cel

Celem zadania jest zbadanie mechanizmu oraz właściwości bezpieczeństwa podwójnej transpozycji kolumnowej. Student implementuje w Pythonie algorytm podwójnego szyfrowania przestawieniowego z dwoma niezależnymi słowami kluczowymi, bada zachowanie statystyk jednoliterowych oraz stopień destrukcji naturalnych digramów języka polskiego, a także weryfikuje operację w serwisie CyberChef i dCode.

Scenariusz – opis

W tym zadaniu badasz technikę podwójnego przestawienia, która przez dziesięciolecia uchodziła za najsilniejszy szyfr polowy stosowany w łączności wojskowej. Uruchamiasz przeglądarkę internetową, otwierasz serwis CyberChef, dCode Double Columnar Transposition oraz terminal JSLinux. Wybierasz polski tekst techniczny liczący dokładnie 64 lub 80 znaków, tak aby dał się podzielić na równe prostokąty macierzowe. Wybierasz dwa różne słowa kluczowe o różnych długościach, na przykład klucz K1 o długości 5 liter (np. WIATR) oraz klucz K2 o długości 7 liter (np. SAMOLOT). W konsoli JSLinux tworzysz plik double_transposition.py w języku Python.

Co ma wykonać student / grupa

Implementujesz funkcję pojedynczej transpozycji kolumnowej przyjmującą tekst jawny oraz słowo kluczowe wyznaczające kolejność odczytu kolumn.

Następnie tworzysz funkcję podwójnej transpozycji, która przepuszcza wynik pierwszego przestawienia przez drugi prostokąt z drugim kluczem. Szyfrujesz swój tekst testowy i wypisujesz na ekranie: tekst pierwotny, szyfrogram pośredni po pierwszej transpozycji oraz szyfrogram końcowy po drugiej transpozycji. Przechodzisz do serwisu CyberChef i budujesz recepturę Recipe składającą się z dwóch kolejnych operacji przestawieniowych lub weryfikujesz wynik w serwisie dCode. Upewniasz się, że wynik działania twojego skryptu jest w pełni zgodny ze standardowymi implementacjami.

W kolejnym kroku przeprowadzasz badanie kryptoanalityczne: zliczasz wystąpienia liter w tekście jawnym oraz w szyfrogramie podwójnym. Potwierdzasz, że histogram jednoliterowy jest całkowicie identyczny we wszystkich trzech stadiach, co jest nieodłączną cechą szyfrów przestawieniowych.

Następnie w skrypcie implementujesz moduł zliczający wystąpienia sąsiednich par liter (digramów) w tekście jawnym, szyfrogramie pojedynczym oraz podwójnym. Analizujesz, ile naturalnych polskich digramów (np. st, pr, po, na, ie) przetrwało po pierwszej transpozycji, a ile po drugiej. Odnotowujesz, że pojedyncza transpozycja pozostawia całe pionowe segmenty kolumn nienaruszone, co pozwala kryptoanalitykowi sklejać sąsiednie kolumny. Druga transpozycja z kluczem o innej długości całkowicie rozbija te segmenty, niszcząc niemal sto procent powiązań digramowych.

Implementujesz w skrypcie procedurę deszyfrującą, pamiętając o konieczności odwrócenia operacji w ściśle odwrotnej kolejności (najpierw K2, potem K1). Weryfikujesz poprawne odzyskanie tekstu wyjściowego z szyfrogramu końcowego. Wykonujesz zrzuty ekranu kodu w JSLinux, tabel macierzowych obu etapów oraz wyników analizy digramów. Sporządzasz tabelę porównującą zachowanie n-gramów dla tekstu jawnego, pojedynczej transpozycji oraz podwójnej transpozycji. Formułujesz podsumowanie techniczne wyjaśniające, dlaczego złożenie dwóch permutacji tworzy jakościowo nową barierę analityczną.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef oraz stronę dcode.fr/double-columnar-transposition.
  2. Uruchom maszynę wirtualną JSLinux Alpine.
  3. Przygotuj polski tekst techniczny o długości będącej wielokrotnością kluczy (np. 70 znaków).
  4. Dobierz dwa różne klucze słowne o długościach względnie pierwszych (np. K1 o długości 5, K2 o długości 7).
  5. W JSLinux stwórz plik double_transposition.py.
  6. Zaimplementuj funkcję transpozycji kolumnowej z porządkowaniem alfabetycznym liter klucza.
  7. Zaimplementuj szyfrowanie dwuetapowe: C_final = transponuj(transponuj(M, K1), K2).
  8. Wypisz wyniki pośrednie i wynik końcowy w terminalu.
  9. Zweryfikuj poprawność szyfrogramu w narzędziu dCode.
  10. Napisz funkcję analizującą n-gramy i policz liczbę typowych polskich digramów w M, C1 i C_final.
  11. Zbadaj zachowanie histogramu jednoliterowego i potwierdź jego stałość.
  12. Zaimplementuj funkcję deszyfrującą z odwróconą kolejnością kluczy (najpierw K2, potem K1).
  13. Przetestuj odwrócenie procesu i potwierdź odzyskanie tekstu pierwotnego.
  14. Wykonaj zrzuty ekranu kodu źródłowego oraz tabeli zachowania digramów z konsoli.
  15. Sporządź tabelę zestawiającą liczbę przetrwałych digramów po 1 i po 2 rundach przestawienia.
  16. Zalążek ataku (obowiązkowy): na szyfrogramie po 1 rundzie (C1) pokaż ręczne sklejenie dwóch kolumn po wspólnym pionowym digramie (np. odnajdź kolumnę kończącą się na S i kolumnę zaczynającą się od T i złóż je w ST) i wyjaśnij na zmierzonych liczbach, dlaczego po 2 rundach ta metoda sklejania zawodzi - to jest właściwy wniosek kryptoanalityczny zadania, nie samo szyfrowanie.
  17. Sformułuj wnioski kryptoanalityczne na temat odporności podwójnej transpozycji na ataki anagramowania.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log: szyfrogram podwójnej transpozycji dla 2 słów kluczowych, pomiar zniszczenia digramów (statystyka przed/po) oraz poprawne deszyfrowanie przy odwróconej kolejności kluczy.
  2. Dołączono kod (własne min. 25 linii): funkcje szyfruj/deszyfruj z permutacją kolumn, licznik zachowania digramów.
  3. Przeprowadzono test pozytywny (poprawna kolejność odwrotna działa) i negatywny (zła kolejność lub zły klucz — czytelny śmieć + wykazane zniszczenie kontynuacji pionowych).
  4. Opisano w 3–5 zdaniach: eliminacja segmentów pionowych, rozbicie digramów vs sklejanie kolumn, zasada odwracania operacji.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób podwójna transpozycja eliminuje ciągłość segmentów pionowych charakterystyczną dla pojedynczego przestawienia.
  • Dlaczego rozbicie digramów uniemożliwia proste techniki sklejania kolumn oparte na prawdopodobieństwie przejść literowych.
  • W jaki sposób zasada odwracania kolejności operacji determinuje poprawność algorytmu deszyfrującego.
  • Student potrafi zaimplementować podwójną transpozycję w Pythonie i ilościowo zmierzyć stopień destrukcji n-gramów.
Zadanie 6 - ilustracja
07/10
Zadanie 7. Szyfr szablonowy Fleissnera (obracany grill) – modelowanie obrotów matrycy i deszyfrowanie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 29, 31: transpozycja szablonowa, obracany szablon Fleissnera (1881), siatka kwadratowa 2k x 2k, 4 położenia kątowe o 90 stopni, bezkolizyjne pokrycie całej powierzchni, kryptoanaliza szablonów.

Cel

Celem zadania jest poznanie geometrycznej techniki szyfrowania szablonowego opartej na obracanej siatce Fleissnera (turning grille). Student bada matematyczne warunki bezkolizyjnego rozmieszczenia otworów w matrycy 6x6, implementuje w Pythonie symulator obrotu matrycy o 90 stopni, przeprowadza szyfrowanie tekstu jawnego o długości 36 znaków, a następnie weryfikuje operację w internetowym symulatorze dCode Fleissner Grille.

Scenariusz – opis

W tym zadaniu zgłębiasz tajniki szyfru szablonowego opisanego przez Eduarda Fleissnera von Wostrowitza w 1881 roku. Uruchamiasz przeglądarkę internetową, otwierasz serwis dCode pod adresem dcode.fr/fleissner-grille-cipher oraz emulator JSLinux. Analizujesz zasadę matematyczną obracanego grilla: dla siatki kwadratowej o boku 2k (np. 6 na 6) powierzchnia wynosi 36 pól. W szablonie wycina się dokładnie jedną czwartą pól, czyli 9 otworów, przy czym każdy otwór musi leżeć w innej orbicie obrotowej. Czterokrotny obrót szablonu o 90 stopni musi bezkolizyjnie i bez nakładania się odsłonić wszystkie 36 komórek matrycy.

Co ma wykonać student / grupa

Wybierasz na kartce lub w pliku współrzędne 9 otworów dla matrycy 6x6, dbając o to, by żadne dwa otwory po obrocie o 90, 180 lub 270 stopni nie trafiły w to samo pole. Przygotowujesz polski komunikat jawny liczący dokładnie 36 znaków, na przykład zdanie TAJNA OPERACJA ZOSTANIE ROZPOCZETA O SWICIE. W konsoli JSLinux tworzysz plik fleissner_simulator.py w języku Python. Implementujesz reprezentację matrycy 6 na 6 za pomocą dwuwymiarowej listy lub tablicy znaków.

Tworzysz funkcję obracającą współrzędne otworów o 90 stopni w prawo według wzoru: nowy_wiersz = kolumna, nowa_kolumna = (rozmiar - 1) - wiersz. Program wpisuje pierwsze 9 liter tekstu jawnego w odsłonięte pola matrycy w pozycji początkowej 0 stopni.

Następnie obraca szablon o 90 stopni i wpisuje kolejne 9 liter w nowo odsłonięte pozycje. Czynność powtarzana jest dla kątów 180 oraz 270 stopni, aż do całkowitego zapełnienia wszystkich 36 pól matrycy. Szyfrogram powstaje przez odczytanie całej matrycy wiersz po wierszu od lewej do prawej. Kopiujesz wygenerowany szyfrogram i przechodzisz do serwisu dCode do modułu Fleissner Grille. Konfigurujesz w dCode siatkę 6x6, zaznaczasz wybrane wcześniej 9 pozycji otworów i uruchamiasz weryfikację deszyfrowania.

Upewniasz się, że serwis dCode poprawnie odczytuje twój pierwotny tekst jawny. W skrypcie implementujesz operację odwrotną, czyli odzyskanie tekstu jawnego z szyfrogramu przy znajomości maski otworów. Przeprowadzasz analizę kryptoanalityczną: badasz, jak duża jest przestrzeń możliwych poprawnych masek dla siatki 6x6 (wynosi ona 4^9 = 262144 wariantów). Wykonujesz zrzuty ekranu kodu źródłowego w JSLinux, schematu matrycy na 4 etapach obrotu oraz interfejsu serwisu dCode. Sporządzasz sprawozdanie dokumentujące matematyczne warunki bezkolizyjności szablonu i analizę trudności kryptoanalizy.

Przykładowe kroki do wykonania jako sugestia

  1. Wejdź na stronę dcode.fr/fleissner-grille-cipher w przeglądarce.
  2. Uruchom konsolę JSLinux Alpine.
  3. Przeanalizuj podział siatki 6x6 na 9 niezależnych 4-elementowych orbit obrotowych.
  4. Wybierz po jednym polu z każdej orbity, tworząc maskę 9 otworów.
  5. Przygotuj tekst jawny liczący dokładnie 36 znaków bez spacji.
  6. W JSLinux stwórz plik fleissner_simulator.py.
  7. Zaimplementuj matematyczną funkcję obrotu punktu o 90 stopni: rotate(r, c, 6).
  8. Sprawdź programowo, czy wybrana maska pokrywa dokładnie 36 unikalnych pól w 4 obrotach.
  9. Zaimplementuj proces wpisywania tekstu partiami po 9 znaków i odczytu wierszami.
  10. Uruchom skrypt i wyświetl zawartość matrycy na każdym z 4 etapów oraz wynikowy szyfrogram.
  11. Wprowadź szyfrogram i układ otworów do serwisu dCode.
  12. Zweryfikuj poprawność deszyfrowania w dCode.
  13. Zaimplementuj w Pythonie procedurę deszyfrującą przy użyciu tej samej maski.
  14. Oblicz teoretyczną przestrzeń możliwych szablonów dla siatki 6x6 (4^9 kombinacji).
  15. Wykonaj zrzuty ekranu konsoli z wizualizacją siatki oraz panelu dCode.
  16. Sformułuj wnioski wyjaśniające specyfikę transpozycji geometrycznej i metody jej łamania.

Kontrola zaliczenia (checklist):

  1. Uruchomiono symulator grilla i zachowano log: maska 6×6 spełniająca bezkolizyjność (4 obroty × otwory = 36 pól, brak powtórek) + poprawne szyfrowanie/deszyfrowanie pełnego tekstu.
  2. Dołączono kod (własne min. 25 linii): macierz maski, rotacja 90°, walidator kolizji, funkcje zapisu/odczytu.
  3. Przeprowadzono test pozytywny (poprawna maska — pełne pokrycie) i negatywny (maska z kolizją — walidator odrzuca i wskazuje pole konfliktu; weryfikacja w dCode).
  4. Opisano w 3–5 zdaniach: warunki symetrii otworów, rozproszenie sąsiadów przez rotację, przestrzeń 4⁹ vs trywialny brute force komputera.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Jakie warunki symetrii geometrycznej muszą spełniać otwory w siatce Fleissnera, aby uniknąć kolizji.
  • W jaki sposób rotacja matrycy rozprasza sąsiednie litery tekstu jawnego po całej przestrzeni prostokąta.
  • Dlaczego przestrzeń 4^9 masek w siatce 6x6 stanowi wyzwanie dla analizy ręcznej, lecz jest trywialna dla komputerowego ataku brute force.
  • Student potrafi zamodelować obroty matrycy geometrycznej w Pythonie oraz przeprowadzić walidację w narzędziu dCode.
Zadanie 7 - ilustracja
08/10
Zadanie 8. Badanie właściwości strukturalnych i kryptoanaliza szyfru Playfair w środowisku programistycznym
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Boxentriq + Cryptii + Python 3
Podstawa wykładowa: Część 2 - slajdy 22, 23, 24, 25: szyfr Playfair, analiza digramowa, cechy kryptoanalityczne (parzystość długości, brak identycznych liter w digramie, odwracalność reguły prostokąta), techniki łamania oparte na słowniku i statystyce par.

Cel

Celem zadania jest zbadanie głębokich właściwości kryptoanalitycznych szyfru Playfair. Student tworzy w Pythonie program wykrywający charakterystyczne anomalie szyfrogramu Playfair (parzystość, brak dubletów, symetria par), przeprowadza analizę statystyczną częstotliwości digramów, a następnie podejmuje próbę rekonstrukcji słowa kluczowego przy użyciu specjalistycznego narzędzia Boxentriq Playfair Solver.

Scenariusz – opis

W tym zadaniu przechodzisz od podstawowego stosowania szyfru Playfair do badania jego cech diagnostycznych i podatności kryptoanalitycznych. Uruchamiasz przeglądarkę internetową, otwierasz serwis Cryptii, narzędzie Boxentriq Playfair Solver pod adresem boxentriq.com/code-breaking/playfair-cipher oraz konsolę JSLinux. W serwisie Cryptii przygotowujesz polski tekst techniczny o długości około 350 znaków i szyfrujesz go szyfrem Playfair z hasłem słownikowym, na przykład STRATEGIA. Zapisujesz wygenerowany szyfrogram do pliku playfair_sample.txt w środowisku JSLinux. W konsoli JSLinux tworzysz plik playfair_detector.py w języku Python.

Co ma wykonać student / grupa

Pierwszym modułem programu jest weryfikator cech diagnostycznych, które pozwalają kryptoanalitykowi rozpoznać szyfr Playfair bez wiedzy o użytym algorytmie. Sprawdzasz pierwszą cechę: program potwierdza, że całkowita liczba liter w szyfrogramie jest ściśle parzysta. Sprawdzasz drugą cechę: program dzieli szyfrogram na rozłączne digramy i weryfikuje, czy w którymkolwiek digramie występuje powtórzenie tej samej litery (np. AA, BB). W myśl reguł Playfair taki digram nie może powstać w szyfrogramie, co stanowi jednoznaczny odcisk palca tego algorytmu.

Sprawdzasz trzecią cechę: brak litery J w całym szyfrogramie, wynikający ze scalenia jej z literą I w matrycy 5 na 5. Drugi moduł programu zlicza częstości występowania poszczególnych digramów w szyfrogramie i porównuje je z naturalnym rozkładem digramów w języku polskim. Zauważasz, że choć histogram jednoliterowy uległ zatarciu, to histogram dwuliterowy zachowuje widoczne nierównomierności, ujawniając najczęstsze pary.

Przechodzisz do narzędzia Boxentriq Playfair Solver i wklejasz przechwycony szyfrogram do pola analizatora. Uruchamiasz moduł kryptoanalityczny, który wykorzystuje algorytm wspinaczkowy (hill climbing) lub analizę słownikową w celu odtworzenia matrycy klucza. Obserwujesz kolejne iteracje algorytmu optymalizującego układ liter w matrycy 5 na 5 na podstawie dopasowania n-gramów. Po ustabilizowaniu wyniku porównujesz odzyskany tekst jawny z oryginałem, oceniając jakość rekonstrukcji.

Analizujesz zrekonstruowaną matrycę 5 na 5 i odnajdujesz w jej pierwszych wierszach słowo kluczowe STRATEGIA. W skrypcie Python w JSLinux sprawdzasz własność symetrii prostokąta: jeżeli para AB szyfruje się do CD, to para BA musi szyfrować się do DC. Wykonujesz zrzuty ekranu kodu programu detekcyjnego w JSLinux, wyjścia z konsoli oraz zrekonstruowanej matrycy w Boxentriq. Sporządzasz zestawienie wykrytych cech diagnostycznych Playfair i opisujesz ich znaczenie w identyfikacji szyfru. Podsumowujesz ćwiczenie wnioskiem o kompromisie pomiędzy prostotą szyfrowania digramowego a wyciekiem statystyki par.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis Cryptii oraz stronę boxentriq.com/code-breaking/playfair-cipher.
  2. Uruchom maszynę JSLinux Alpine.
  3. Przygotuj polski tekst techniczny o długości minimum 350 znaków.
  4. Zaszyfruj tekst w Cryptii szyfrem Playfair ze słowem kluczowym (np. STRATEGIA).
  5. Zapisz szyfrogram w pliku playfair_sample.txt w JSLinux.
  6. Stwórz w JSLinux plik playfair_detector.py.
  7. Zaimplementuj test parzystości długości tekstu: len( tekst) % 2 == 0.
  8. Zaimplementuj test braku dubletów w parach: all( tekst[i] != tekst[i+1] for i in range(0, len( tekst), 2)).
  9. Zaimplementuj test nieobecności litery 'J' w tekście.
  10. Napisz moduł zliczający i sortujący najczęstsze digramy w badanym szyfrogramie.
  11. Uruchom program w JSLinux i potwierdź obecność wszystkich trzech cech diagnostycznych.
  12. Wprowadź szyfrogram do narzędzia Playfair Solver w Boxentriq.
  13. Uruchom automatyczną kryptoanalizę i obserwuj rekonstrukcję matrycy klucza.
  14. Zweryfikuj czytelność odzyskanego tekstu jawnego i odczytaj słowo kluczowe z matrycy. Jeżeli solver nie odzyskał pełnego tekstu (typowe dla polskich próbek i słowników angielskich), jest to oczekiwany wynik cząstkowy, a nie porażka: udokumentuj odzyskany procent tekstu, wskaż blokadę (obcy słownik, za krótki tekst, za słabe dopasowanie digramów) i pokaż, które cechy diagnostyczne mimo to potwierdziły Playfair - pełna rekonstrukcja wraca dopiero w Zadaniu 7 z poziomu 5.0.
  15. Wykonaj zrzuty ekranu testu diagnostycznego w terminalu oraz wyników z Boxentriq.
  16. Sporządź raport dokumentujący podatności strukturalne szyfru digramowego Playfair.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt diagnostyczny i zachowano log: wykryte cechy Playfair (parzysta długość, brak dubletów w parach, brak J, symetria prostokąta) + statystyka digramów wskazująca przeciek.
  2. Dołączono kod (własne min. 25 linii): detektor cech negatywnych, licznik digramów, weryfikator reguły prostokąta.
  3. Przeprowadzono test pozytywny (szyfrogram Playfair — wszystkie flagi zapalone) i negatywny (tekst losowy/monoalfabetyczny — brak sygnatury, program odrzuca hipotezę).
  4. Opisano w 3–5 zdaniach: identyfikacja szyfru po cechach negatywnych, przeciek digramów do ataku heurystycznego, symetria prostokąta.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób cechy negatywne (brak dubletów liter w parach, brak litery J) pozwalają zidentyfikować szyfr Playfair.
  • Dlaczego rozkład częstości digramów przecieka do szyfrogramu, umożliwiając ataki heurystyczne na matrycę.
  • Na czym polega własność symetrii prostokąta i jak wspomaga weryfikację poprawności deszyfrowania par.
  • Student potrafi programistycznie zdiagnozować cechy szyfru Playfair i przeprowadzić jego kryptoanalizę narzędziową.
Zadanie 8 - ilustracja
09/10
Zadanie 9. Modelowanie łącznicy kablowej (Steckerbrett) i wirników Enigmy w symulatorze oraz skrypcie Python
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3 + symulator Enigmy
Podstawa wykładowa: Część 2 - slajdy 33, 34, 35: maszyny wirnikowe, Enigma, wirniki I, II, III, reflektor B, łącznica kablowa (Steckerbrett), przestrzeń kluczy łącznicy (ponad 1.5 * 10^14 kombinacji dla 10 par), niezmienniki permutacji.

Cel

Celem zadania jest zbadanie wpływu łącznicy kablowej (Steckerbrett) na bezpieczeństwo maszyny Enigma. Student modeluje matematycznie permutację inwolucyjną łącznicy w języku Python, analizuje gigantyczny wzrost przestrzeni kluczy generowany przez 10 par połączeń wtykowych, a następnie sprawdza w zaawansowanym symulatorze Enigmy, dlaczego łącznica kablowa nie chroniła maszyny przed atakami opartymi na niezmiennikach cyklicznych Rejewskiego.

Scenariusz – opis

W tym ćwiczeniu analizujesz element Enigmy, który stanowił największe wyzwanie dla kryptoanalityków – łącznicę kablową Steckerbrett. Otwierasz w przeglądarce symulator Enigmy w serwisie CyberChef lub dedykowany symulator pod adresem ciphermachinesandcryptology.com/en/enigma.htm. W konsoli JSLinux uruchamiasz interpreter Python do przeprowadzenia obliczeń kombinatorycznych i symulacji permutacji. Zaczynasz od analizy matematycznej: łącznica kablowa realizuje permutację inwolucyjną (samoodwracalną) zamieniającą miejscami wybrane pary liter przed wejściem na wirniki i po wyjściu z nich. W standardowej wojskowej procedurze Enigmy stosowano dokładnie 10 par połączeń wtykowych na łącznicy, pozostawiając 6 liter niepołączonych.

Co ma wykonać student / grupa

W konsoli JSLinux piszesz skrypt kombinatoryczny stecker_space.py obliczający dokładną liczbę możliwych konfiguracji 10 par wtyków w alfabecie 26-literowym. Program oblicza wartość: 26! / ( (26 - 20)! * 10! * 2^10 ), uzyskując wynik przekraczający 1.5 * 10^14 kombinacji. Odnotowujesz, że łącznica wnosiła do przestrzeni kluczy znacznie więcej kombinacji niż same bębny i ich pozycje początkowe.

Następnie w skrypcie implementujesz funkcję apply_plugboard zamieniającą litery zgodnie ze zdefiniowaną listą 10 par (np. AV, BS, CG, DL, FU, HZ, IN, KM, OW, RX). W symulatorze Enigmy ustawiasz bębny w pozycji I, II, III, reflektor B oraz pozycję początkową A-A-A. Szyfrujesz krótki komunikat bez użycia łącznicy, a następnie ten sam komunikat z ustawionymi 10 parami wtyków na łącznicy. Porównujesz oba szyfrogramy, odnotowując całkowicie różny przebieg tekstu.

W kolejnym kroku badasz dlaczego polski matematyk Marian Rejewski zdołał pominąć wpływ łącznicy kablowej w swojej metodzie permutacji. Implementujesz w skrypcie złożenie permutacji: S * P * S, gdzie S reprezentuje łącznicę, a P permutację bębnów. Wyjaśniasz w notatkach matematycznych, że sprzężenie permutacji łącznicą nie zmienia struktury cykli permutacji głównej (liczby i długości cykli są niezmiennikami). Oznacza to, że analiza długości cykli pozwalała Rejewskiemu wyznaczyć pozycje wirników bez znajomości ani jednego połączenia łącznicy. Sprawdzasz tę właściwość na prostym przykładzie numerycznym w Pythonie w środowisku JSLinux. Wykonujesz zrzuty ekranu symulatora Enigmy z widokiem łącznicy kablowej oraz wyników obliczeń kombinatorycznych z konsoli.

Sporządzasz tabelę przedstawiającą liczbę kombinacji dla różnej liczby podłączonych wtyków (od 1 do 13 par). Formułujesz podsumowanie techniczne wyjaśniające, dlaczego gigantyczna przestrzeń kluczy łącznicy okazała się bezradna wobec twierdzenia o niezmiennikach cykli. Upewniasz się, że wszystkie kroki zostały starannie udokumentowane.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz zaawansowany symulator Enigmy w CyberChef lub w serwisie online.
  2. Uruchom terminal JSLinux Alpine.
  3. Przeanalizuj wzór kombinatoryczny liczby możliwych parowań k elementów ze zbioru n elementów.
  4. W JSLinux stwórz plik stecker_space.py i napisz kod liczący przestrzeń kluczy dla p od 1 do 13 par.
  5. Uruchom skrypt i odczytaj maksymalną wartość osiąganą dla p=10 (ponad 150 bilionów możliwości).
  6. Skonfiguruj symulator Enigmy: wirniki I-II-III, reflektor B, pozycja startowa AAA, łącznica pusta.
  7. Zaszyfruj komunikat 30-literowy i zapisz wynik w notatkach.
  8. Dodaj 10 par połączeń na łącznicy w symulatorze i powtórz szyfrowanie tej samej treści.
  9. W JSLinux napisz funkcję w Pythonie symulującą permutację łącznicy: apply_plugboard( text, pairs).
  10. Zbadaj właściwość inwolucji permutacji łącznicy: S(S(x)) == x.
  11. Zaimplementuj prosty przykład permutacji P i sprawdź rozkład na cykle dla P oraz dla S*P*S^(-1).
  12. Wykryj tożsamość długości cykli w obu przypadkach, potwierdzając niezmiennik Rejewskiego.
  13. Wykonaj zrzuty ekranu konfiguracji wtyków w symulatorze oraz wyników obliczeń w Pythonie.
  14. Sporządź tabelę zestawiającą liczbę par w łącznicy z rozmiarem generowanej przestrzeni kluczy.
  15. Sformułuj wnioski wyjaśniające, w jaki sposób aparat teorii grup pozwolił zneutralizować wpływ łącznicy.
  16. Skompletuj dokumentację zadania do raportu laboratoryjnego.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log: permutacja Stecker jako inwolucja (S(S(x))=x), wyliczona przestrzeń dla 10 par oraz pomiar wpływu łącznicy na tekst przy stałych wirnikach.
  2. Dołączono kod (własne min. 25 linii): model łącznicy + uproszczony zespół wirników, licznik przestrzeni kombinatorycznej, test inwolucji.
  3. Przeprowadzono test pozytywny (10 par — gigantyczna przestrzeń, poprawna inwolucja) i negatywny (0 par / błędna parzystość — program wykrywa nieinwolucyjność).
  4. Opisano w 3–5 zdaniach: wzrost przestrzeni o ~14 rzędów, inwolucyjność wejścia/wyjścia, idea Rejewskiego (cykle niezależne od Stecker).

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób łącznica kablowa Steckerbrett zwiększała przestrzeń kluczy maszyny o ponad 14 rzędów wielkości.
  • Dlaczego permutacja łącznicy jest inwolucją i jak wpływa na wejście i wyjście zespołu wirników.
  • Na czym polegał geniusz Rejewskiego polegający na wykorzystaniu niezmienniczości cykli permutacji sprzężonych.
  • Student potrafi przeprowadzić analizę kombinatoryczną łącznicy i zweryfikować właściwości permutacji w Pythonie.
Zadanie 9 - ilustracja
10/10
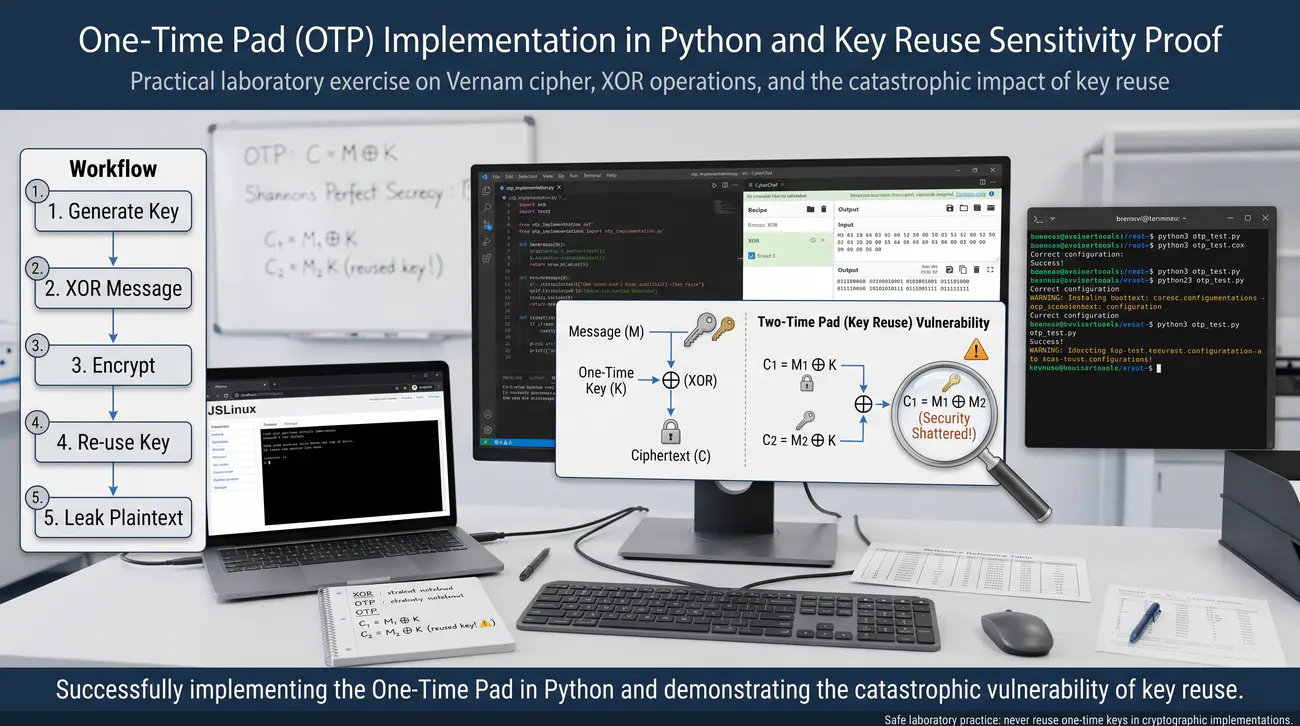
Zadanie 10. Implementacja szyfru jednorazowego (OTP) w Pythonie i dowód wrażliwości na powtórzenie klucza
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 2 - slajdy 36, 37: szyfr jednorazowy (one-time pad, Vernam, 1917), operacja XOR, idealne bezpieczeństwo Shannona (1949), warunki poprawności, katastrofalne skutki ponownego użycia klucza (two-time pad / many-time pad).

Cel

Celem zadania jest praktyczne zbadanie szyfru jednorazowego (One-Time Pad) oraz eksperymentalny dowód jego bezwzględnego bezpieczeństwa i skrajnej wrażliwości na błędy operacyjne. Student implementuje szyfrowanie XOR w języku Python z kryptograficznie bezpiecznym generatorem losowym, bada entropię i rozkład szyfrogramu, a następnie demonstruje atak na ponowne użycie tego samego klucza do dwóch różnych wiadomości (C1 XOR C2 = M1 XOR M2).

Scenariusz – opis

W tym zadaniu badasz jedyny szyfr o udowodnionym matematycznie bezwzględnym bezpieczeństwie – szyfr jednorazowy (One-Time Pad / Vernam). Uruchamiasz przeglądarkę internetową, otwierasz serwis CyberChef oraz emulator konsoli JSLinux z interpreterem Python 3. Rozpoczynasz od analizy warunków twierdzenia Claude'a Shannona z 1949 roku: klucz musi być idealnie losowy, o długości równej wiadomości, tajny i użyty wyłącznie raz. W konsoli JSLinux tworzysz plik programu otp_system.py w języku Python. W module szyfrującym wykorzystujesz moduł secrets z biblioteki standardowej Pythona, który pobiera kryptograficznie bezpieczną losowość z systemu operacyjnego (/dev/urandom).

Co ma wykonać student / grupa

Generujesz losowy klucz bajtowy o długości dokładnie równej przygotowanej polskiej wiadomości technicznej M1 liczącej 60 znaków. Realizujesz szyfrowanie za pomocą operacji bitowej XOR pomiędzy kodami bajtowymi tekstu jawnego a bajtami losowego klucza. Wypisujesz szyfrogram C1 w postaci szesnastkowej (hex) oraz badasz jego rozkład bitowy i entropię w serwisie CyberChef przy użyciu operacji Entropy. Potwierdzasz, że szyfrogram C1 ma maksymalną entropię zbliżoną do 8 bitów na bajt i nie zawiera żadnych korelacji z tekstem jawnym.

Teraz symulujesz krytyczny błąd proceduralny, który doprowadził do złamania radzieckich depesz w słynnym projekcie Venona: ponowne użycie tego samego klucza. Przygotowujesz drugą, zupełnie inną wiadomość w języku polskim M2 o identycznej długości 60 znaków. Szyfrujesz wiadomość M2 tym samym kluczem K, uzyskując szyfrogram C2. Wcielasz się w postać kryptoanalityka przechwytującego szyfrogramy C1 oraz C2 bez znajomości tajnego klucza K.

Wykonujesz operację XOR pomiędzy dwoma szyfrogramami: C1 XOR C2. Z właściwości operacji XOR (gdzie K XOR K = 0) natychmiast wynika równość matematyczna: C1 XOR C2 = M1 XOR M2. Oznacza to, że klucz jednorazowy całkowicie zniknął z równania, pozostawiając kryptoanalityka z czystą sumą XOR dwóch tekstów jawnych. W CyberChef lub w skrypcie Python testujesz nałożenie znanego słowa (crib), na przykład słowa 'serwer' lub 'haslo', na ciąg C1 XOR C2. Obserwujesz, jak w wyniku nałożenia słowa w jednym tekście natychmiast wyłaniają się czytelne fragmenty liter drugiego tekstu jawnego. Wykonujesz zrzuty ekranu kodu programu w JSLinux, operacji XOR w CyberChef oraz wyniku demonstracji ataku two-time pad.

Sporządzasz tabelę zestawiającą binarne wartości M1, M2, K, C1, C2 oraz eliminację klucza w C1 XOR C2. Podsumowujesz zadanie wnioskiem wyjaśniającym, dlaczego idealne bezpieczeństwo OTP w teorii staje się całkowicie bezużyteczne przy błędach procedury.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz serwis CyberChef w przeglądarce i przejdź do konsoli JSLinux Alpine.
  2. Przygotuj dwie wiadomości tekstowe w języku polskim (M1 i M2) o identycznej długości 60 znaków.
  3. W JSLinux stwórz plik otp_system.py.
  4. Zaimportuj moduł secrets i wygeneruj losowy klucz: key = secrets.token_bytes(len(m1)).
  5. Zaimplementuj operację szyfrowania XOR: bytes([ a ^ b for a, b in zip(m1, key)]).
  6. Wyświetl szyfrogram C1 w zapisie szesnastkowym.
  7. Zweryfikuj entropię szyfrogramu C1 w narzędziu CyberChef (operacja Entropy).
  8. Zaszyfruj wiadomość M2 dokładnie tym samym kluczem, generując szyfrogram C2.
  9. Zaimplementuj operację XOR dwóch szyfrogramów: c_diff = bytes([ a ^ b for a, b in zip(c1, c2)]).
  10. Udowodnij matematycznie i programowo równość c_diff == bytes([ a ^ b for a, b in zip(m1, m2)]).
  11. Wytłumacz anihilację klucza tajnego: K ^ K == 0.
  12. Zaimplementuj prostą próbę odgadnięcia słowa (crib) i zaobserwuj odczyt drugiego tekstu.
  13. W CyberChef przetestuj operację XOR z dwoma wejściami szesnastkowymi.
  14. Wykonaj zrzuty ekranu kodu źródłowego oraz wyników operacji eliminacji klucza w terminalu.
  15. Sporządź tabelę przedstawiającą operacje na poszczególnych bajtach obu depesz.
  16. Sformułuj wnioski wyjaśniające projekt Venona i przyczyny rygoru jednorazowości w kryptografii.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt OTP i zachowano log: szyfrowanie XOR kluczem z CSPRNG, poprawne deszyfrowanie, oraz demonstracja Two-Time Pad (C1⊕C2 = M1⊕M2) z czytelnym wyciekiem obu tekstów.
  2. Dołączono kod (własne min. 20 linii): generator klucza, XOR, test unikalności klucza, demo ponownego użycia.
  3. Przeprowadzono test pozytywny (świeży klucz — brak wycieku) i negatywny (ten sam klucz dwukrotnie — program wykazuje czytelny XOR tekstów, lekcja Venony).
  4. Opisano w 3–5 zdaniach: warunki Shannona (losowość, długość, jednorazowość), dlaczego powtórka kasuje losowość, koszty logistyki kluczy.

Wariant offline (fallback): Brak sieci/bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3; brak modułów statystycznych zastąp własną implementacją (collections, math); CyberChef/JSLinux zastąp lokalnym uruchomieniem skryptu i wklejonym logiem konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Na czym polega dowód Shannona na idealne bezpieczeństwo szyfru jednorazowego przy spełnieniu warunków brzegowych.
  • Dlaczego ponowne użycie klucza eliminuje czynnik losowy i sprowadza problem do analizy dwóch nałożonych tekstów naturalnych.
  • W jaki sposób historyczne błędy implementacyjne (np. projekt Venona) obnażyły trudności logistyczne zarządzania jednorazowymi kluczami.
  • Student potrafi zaimplementować szyfrowanie OTP w Pythonie i zademonstrować podatność Two-Time Pad.
Zadanie 10 - ilustracja
Podgląd