Laboratorium 2
Zadania laboratoryjne dla studentów IT - ocena 5.0

Poziom: ocena 5.0 - zaawansowana kryptoanaliza rekonstrukcyjna, ataki na błędy procedur i modele Shannona

Zestaw 10 wysoce specjalistycznych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 2 (szyfrowanie konwencjonalne - techniki klasyczne).
Zadania do wykonania samodzielnego.

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 5.0 koncentrują się na zaawansowanych problemach kryptoanalitycznych, rekonstrukcji danych przy błędach procedur kryptograficznych oraz implementacji modeli matematycznych w języku Python w środowisku konsolowym emulatora JSLinux Alpine.
  • Tematyka zadań obejmuje m.in.: atak Two-Time Pad Crib Dragging w szyfrze jednorazowym, metodę permutacji cyklicznych Rejewskiego w Enigmie, eliminację kolizji reflektora (Crib Matching w Bombie Turinga), metaheurystyki Hill Climbing i Simulated Annealing w łamaniu Vigenère’a i Playfair, kryptoanalizę nieregularnej transpozycji kolumnowej na bazie grafu digramów, budowę sieci SPN i pomiar efektu lawinowego konfuzji i dyfuzji Shannona, łamanie szyfru autokluczowego atakiem kaskadowym, lingwistyczny algorytm Sukhotina do detekcji samogłosek w homofonach oraz atak Known-Plaintext na generator LCG.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (5.0).
    • Szczegółowy opis aparatu matematycznego i logicznego leżącego u podstaw przeprowadzonego ataku kryptoanalitycznego.
    • Pełny kod źródłowy autorskich skryptów w języku Python z komentarzami objaśniającymi kluczowe algorytmy i struktury danych.
    • Dowody empiryczne: zrzuty ekranu konsoli, wykresy zbieżności funkcji oceny, tabele pomiarów odległości Hamminga lub permutacji cyklicznych.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami), wykaz literatury naukowej i standardów.
Kryptologia
lab 2 - 5.0
Spis
Spis zadań laboratoryjnych na ocenę 5.0
01/10
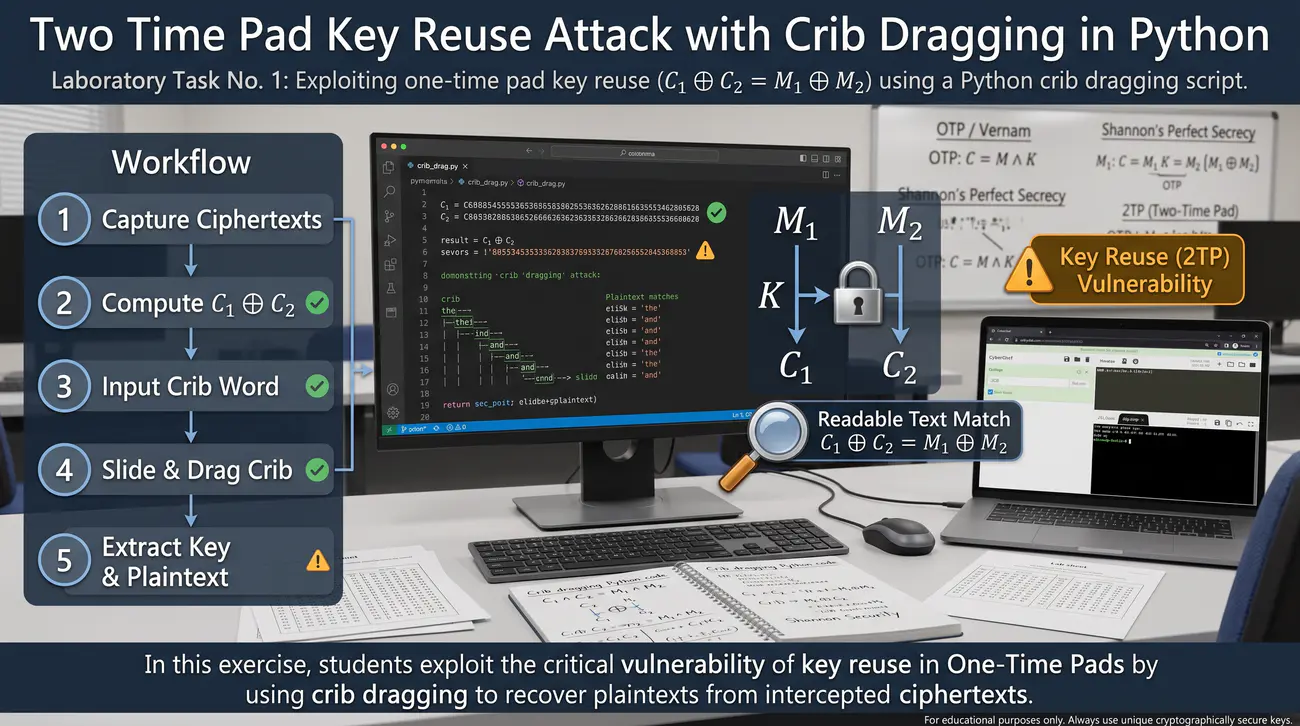
Zadanie 1. Atak na ponowne użycie klucza w szyfrze jednorazowym (Two-Time Pad Crib Dragging) w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 2 - slajdy 36, 37, 42: szyfr jednorazowy (OTP / Vernam), operacja XOR, bezwzględne bezpieczeństwo Shannona, krytyczna luka Two-Time Pad (C1 XOR C2 = M1 XOR M2), zaawansowana technika crib dragging z filtrami leksykalnymi.

Cel

Celem zadania jest praktyczne zaimplementowanie i przeprowadzenie ataku kryptoanalitycznego typu Two-Time Pad Crib Dragging. Student tworzy w języku Python w środowisku JSLinux program do przeciągania słów domniemanych (cribs) po sumie XOR dwóch szyfrogramów powstałych przy użyciu tego samego klucza jednorazowego. Program analizuje wyłaniające się fragmenty tekstu pod kątem reguł języka polskiego i krok po kroku rekonstruuje obie wiadomości jawne bez znajomości klucza.

Scenariusz – opis

W tym zadaniu wcielasz się w rolę kryptoanalityka badającego przypadek katastrofalnego błędu proceduralnego w szyfrze jednorazowym. Uruchamiasz przeglądarkę internetową, otwierasz konsolę JSLinux Alpine z interpreterem Python oraz narzędzie CyberChef. W pierwszym etapie przygotowujesz dwie różne wiadomości w języku polskim (M1 oraz M2) o długości 120 znaków każda, dotyczące konfiguracji sieci i bezpieczeństwa bazy danych. W konsoli JSLinux generujesz 120-bajtowy kryptograficznie bezpieczny klucz OTP za pomocą biblioteki secrets. Szyfrujesz obie wiadomości tym samym kluczem przy użyciu operacji XOR, uzyskując szyfrogramy C1 oraz C2.

Co ma wykonać student / grupa

Obliczasz sumę bitową przechwyconych szyfrogramów XOR: C_diff = C1 XOR C2. Wiesz z teorii Shannona, że wartość C_diff jest matematycznie równoważna M1 XOR M2, a klucz tajny został bezpowrotnie wyeliminowany z równania. Tworzysz w JSLinux zaawansowany skrypt crib_drag.py implementujący technikę przeciągania słów (crib dragging). Definiujesz listę popularnych polskich słów (tzw. cribs), takich jak: 'serwer', 'haslo', 'dostęp', 'baza', 'konfiguracja' oraz typowych spójników.

Dla każdej możliwej pozycji przesunięcia w ciągu C_diff program nakłada słowo testowe za pomocą operacji XOR. Skrypt analizuje powstały w drugim ciągu fragment pod kątem kryteriów językowych: czy składa się wyłącznie z poprawnych liter alfabetu, spacji i znaków interpunkcyjnych. W przypadku wykrycia czytelnego fragmentu w drugim tekście program wyświetla parę: nałożone słowo w M1 oraz odsłonięty fragment w M2 wraz z numerem indeksu. Uruchamiasz program i analizujesz listę trafień generowaną przez algorytm przeciągania.

Odnajdujesz trafienie o wysokiej wiarygodności, w którym nałożenie słowa 'serwer' ujawnia fragment 'bazy da' w drugiej wiadomości. Wykorzystujesz wiedzę lingwistyczną o języku polskim do rozszerzenia odgadniętej frazy w M2 o brakujące litery 'nych' (tworząc 'bazy danych'). Nakładasz nowo odgadnięte litery na ciąg C_diff w celu odsłonięcia kolejnych znaków w pierwszej wiadomości M1. Proces prowadzisz iteracyjnie, przeskakując na przemian pomiędzy M1 i M2, aż do odzyskania ponad 90 procent treści obu depesz.

Mając odtworzone teksty jawne, wyliczasz oryginalny klucz tajny wzorem: K = C1 XOR M1. Porównujesz odzyskany klucz z plikiem klucza wygenerowanym na początku, potwierdzając jego stuprocentową zgodność. Wykonujesz zrzuty ekranu kodu skryptu crib_drag.py, kolejnych kroków rekonstrukcji depesz oraz odtworzonego klucza. Sporządzasz sprawozdanie z dogłębną analizą matematyczną eliminacji klucza i wnioskami o rygorze jednorazowości w kryptografii.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom środowisko JSLinux Alpine z interpreterem python3.
  2. Otwórz serwis CyberChef w sąsiedniej karcie przeglądarki.
  3. Sformułuj dwie wiadomości jawne w języku polskim M1 i M2 o identycznej długości 120 znaków.
  4. W JSLinux napisz skrypt generujący 120-bajtowy klucz OTP modułem secrets i zaszyfruj M1 i M2.
  5. Oblicz C_diff = bytes([ c1 ^ c2 for c1, c2 in zip(C1, C2)]) i zapisz do pliku c_diff.bin.
  6. Stwórz skrypt crib_drag.py realizujący przeciąganie zadanego słowa po ciągu C_diff.
  7. Zaimplementuj filtr leksykalny sprawdzający, czy uzyskane znaki należą do zbioru liter polskich i spacji.
  8. Zdefiniuj bibliotekę 15 popularnych słów technicznych (cribs) i przetestuj ich dopasowanie.
  9. Uruchom wyszukiwanie i zidentyfikuj pierwsze bezbłędne trafienie par słów w M1 i M2.
  10. Wykorzystaj kontekst językowy do rozwinięcia słowa w M2 i odsłoń odpowiadający fragment M1.
  11. Kontynuuj procedurę naprzemienną aż do odczytania obu pełnych komunikatów.
  12. Wylicz odzyskany klucz: recovered_key = bytes([ c ^ m for c, m in zip(C1, M1)]).
  13. Zweryfikuj tożsamość odzyskanego klucza z oryginalnym kluczem generowanym przez secrets.
  14. W CyberChef przeprowadź weryfikację operacji XOR dla wybranego fragmentu obu szyfrogramów.
  15. Wykonaj zrzuty ekranu kodu programu, wyników filtracji leksykalnej oraz odtworzonych tekstów.
  16. Sformułuj wnioski techniczne omawiające podatność Two-Time Pad w protokołach telekomunikacyjnych.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak Two-Time Pad na wektorze ze startera: z C1⊕C2 wyciągnięto oba teksty jawne techniką crib dragging i odtworzono klucz.
  2. Wykazano różnicę: weryfikator poprawny (świeży klucz — brak wycieku) vs podatny (ten sam klucz — pełny wyciek M1⊕M2); dołączono oba logi.
  3. Dołączono log ataku (przeciągane cribs, odsiane trafienia, zrekonstruowane teksty) + kod łatki (unikalny klucz/CSPRNG, zakaz reuse).
  4. Opisano w 3–5 zdaniach kompromis: wygoda reuse vs całkowita utrata poufności, filtry leksykalne, koszt zarządzania kluczami jednorazowymi.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób anihilacja klucza w operacji C1 XOR C2 umożliwia zastosowanie techniki crib dragging.
  • Jakie kryteria leksykalne pozwalają automatycznie odsiać fałszywe dopasowania słów domniemanych.
  • Dlaczego sukces ataku na jedną wiadomość natychmiastowo demaskuje treść drugiej wiadomości oraz sam klucz.
  • Student potrafi wdrożyć i przeprowadzić kompletny atak crib dragging w języku Python na danych rzeczywistych.
Zadanie 1 - ilustracja
02/10
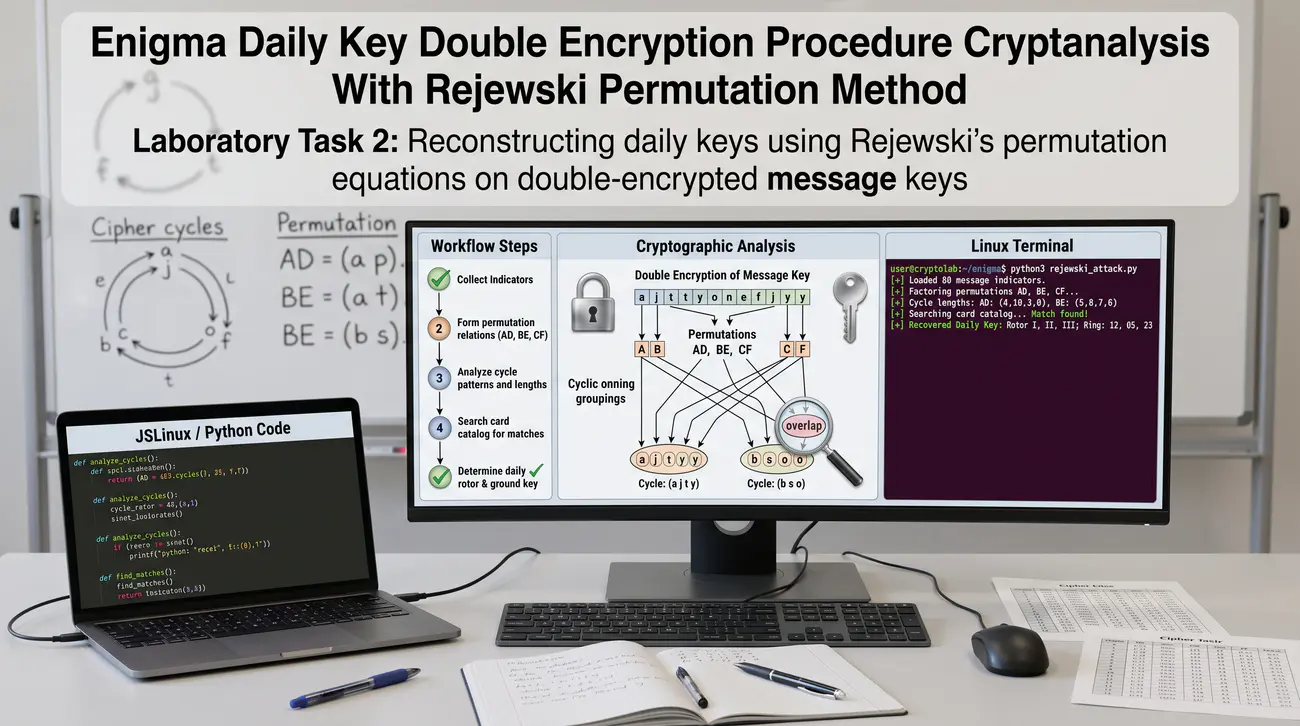
Zadanie 2. Kryptoanaliza procedury Enigmy z podwójnym szyfrowaniem klucza dziennego (metoda permutacji Rejewskiego)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3 + symulator Enigmy
Podstawa wykładowa: Część 2 - slajdy 33, 35: kryptoanaliza Enigmy, wkład Biura Szyfrów (Rejewski, Różycki, Zygalski), niemiecka procedura podwójnego szyfrowania klucza depeszy, permutacje iloczynowe AD, BE, CF, twierdzenie o rozkładzie permutacji na cykle.

Cel

Celem ćwiczenia jest zrekonstruowanie fundamentalnego przełomu matematycznego Mariana Rejewskiego z 1932 roku. Student bada procedurę podwójnego szyfrowania trójliterowego klucza depeszy stosowaną przez Niemców przed II wojną światową, generuje depesze w symulatorze Enigmy, tworzy w Pythonie program wyznaczający permutacje iloczynowe łączące znaki 1-4, 2-5 i 3-6, rozkłada je na cykle rozłączne i wykazuje, jak struktura cykli identyfikuje położenie bębnów bez znajomości łącznicy.

Scenariusz – opis

W tym zadaniu odtwarzasz jedno z największych osiągnięć w historii kryptologii – metodę permutacji Mariana Rejewskiego. Otwierasz w przeglądarce zaawansowany symulator maszyny Enigma oraz konsolę JSLinux z interpreterem Python. Zapoznajesz się z ówczesną niemiecką procedurą wojskową: operator wybierał klucz dzienny z książki kodów, a następnie wymyślał własny trójliterowy klucz depeszy (np. R-T-Z). Aby uniknąć błędów transmisji radiowej, operator szyfrował ten klucz depeszy dwukrotnie na ustawieniach klucza dziennego, przesyłając na początku depeszy sześcioliterowy nagłówek. Jeżeli klucz depeszy brzmiał RTZ, to szyfrowaniu podlegał ciąg RTZRTZ, dający 6 liter szyfrogramu l1, l2, l3, l4, l5, l6.

Co ma wykonać student / grupa

W symulatorze Enigmy ustawiasz bębny w konfiguracji I, II, III, reflektor B oraz losowo wybrane ustawienie dzienne (np. D-A-N). Na łącznicy Steckerbrett konfigurujesz 6 par wtyków (np. AB, CD, EF, GH, IJ, KL). Generujesz 30 różnych sześcioliterowych nagłówków, wybierając różne klucze depesz i szyfrując każdy podwójnie na tej samej konfiguracji dziennej. Zapisujesz otrzymane nagłówki do pliku depesze_rejewski.txt w środowisku JSLinux.

Tworzysz w JSLinux program rejewski_cycles.py w języku Python. Program wczytuje przechwycone nagłówki i buduje relacje przejścia pomiędzy 1. a 4. literą nagłówka (reprezentujące permutację iloczynową AD). To samo wykonuje dla par liter 2-5 (permutacja BE) oraz par liter 3-6 (permutacja CF).

Następnie skrypt implementuje algorytm teorii grup rozkładający każdą z wyznaczonych permutacji na rozłączne cykle (np. cykle o długościach 10, 8, 5, 3). Z twierdzenia Rejewskiego wiesz, że struktura tych cykli zależy wyłącznie od ułożenia wirników, a łącznica kablowa jedynie zamienia litery wewnątrz cykli, nie zmieniając ich długości. Uruchamiasz program i rejestrujesz otrzymaną charakterystykę cykliczną (zbiór długości cykli) dla permutacji AD, BE oraz CF. Zmieniasz w symulatorze konfigurację łącznicy kablowej, dodając inne pary wtyków, lecz pozostawiając wirniki w identycznym położeniu D-A-N.

Generujesz nową serię nagłówków, uruchamiasz skrypt i porównujesz strukturę cykli. Z zachwytem stwierdzasz, że długości cykli pozostały dokładnie takie same, co w pełni potwierdza genialne twierdzenie polskiego matematyka. Wykonujesz zrzuty ekranu symulatora z ustawieniami Enigmy, kodu programu w JSLinux oraz wygenerowanych rozkładów cyklicznych. Sporządzasz tabelę przedstawiającą permutacje iloczynowe, ich rozkład na cykle oraz dowód niezmienniczości względem łącznicy. Podsumowujesz ćwiczenie wnioskiem o fundamentalnym znaczeniu algebry abstrakcyjnej w pokonaniu Enigmy.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce symulator Enigmy oraz terminal JSLinux Alpine.
  2. Skonfiguruj Enigmę: wirniki I-II-III, reflektor B, pozycję dzienną (np. D-A-N) oraz 6 par wtyków.
  3. Zrozum procedurę podwójnego szyfrowania: klucz depeszy xyz szyfrowany jako xyzxyz.
  4. Wygeneruj 30 nagłówków sześcioliterowych przy różnych kluczach depeszy i stałym kluczu dziennym.
  5. Zapisz nagłówki w pliku depesze_rejewski.txt w JSLinux.
  6. Stwórz plik rejewski_cycles.py w edytorze nano.
  7. Zaimplementuj wczytywanie nagłówków i tworzenie grafu przejść dla par znaków (1, 4), (2, 5) oraz (3, 6).
  8. Napisz funkcję rozkładającą permutację na rozłączne cykle permutacji.
  9. Zaimplementuj formatowanie i sortowanie długości cykli (charakterystyka cykliczna). Każdą permutację wypisuj dwupoziomowo: najpierw pełne łańcuchy (np. A→F→W→A, długość 3), potem posortowaną listę długości (np. [10, 8, 5, 3]) - łańcuchy pozwalają zweryfikować poprawność kodu na pojedynczym nagłówku, a lista długości służy do porównania dwóch próbek przy dowodzie niezmienniczości względem łącznicy.
  10. Uruchom program i odczytaj długości cykli dla permutacji AD, BE i CF.
  11. Zmień konfigurację łącznicy kablowej w symulatorze (inne pary wtyków) przy zachowaniu tych samych wirników.
  12. Wygeneruj drugą próbkę nagłówków i powtórz analizę w skrypcie.
  13. Udowodnij tożsamość długości cykli w obu przypadkach (niezmiennik Rejewskiego).
  14. Wyjaśnij, jak Biuro Szyfrów wykorzystało te charakterystyki do stworzenia katalogu kart i bomby kryptologicznej.
  15. Wykonaj zrzuty ekranu symulatora i konsoli JSLinux z wypisanymi cyklami.
  16. Sporządź raport laboratoryjny opisujący matematyczne tło przełomu Rejewskiego.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano metodę Rejewskiego na wektorze ze startera: z depesz z podwójnie szyfrowanym kluczem wyznaczono cykle permutacji i odtworzono ustawienia bębnów.
  2. Wykazano różnicę: procedura podatna (powtórzony klucz — cykle ujawniają bębny) vs poprawiona (bez powtórki — brak relacji 1-4/2-5/3-6); dołączono porównanie logów.
  3. Dołączono log ataku (rozkład na cykle, katalog charakterystyk) + kod łatki (procedura bez powtórki / losowy klucz depeszy).
  4. Opisano w 3–5 zdaniach kompromis: wygoda operacyjna powtórki vs katastrofa kryptograficzna, niezmienniczość cykli sprzężonych, droga do bomb.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób niemiecki błąd proceduralny podwójnego przesyłania klucza stworzył relacje pomiędzy pozycjami 1-4, 2-5 i 3-6.
  • Dlaczego twierdzenie o niezmienniczości cykli permutacji sprzężonych pozwoliło oddzielić bębny od łącznicy kablowej.
  • W jaki sposób katalog charakterystyk cyklicznych doprowadził do powstania polskich bomb kryptologicznych.
  • Student potrafi odtworzyć metodę Rejewskiego programistycznie i zinterpretować rozkład permutacji na cykle.
Zadanie 2 - ilustracja
03/10
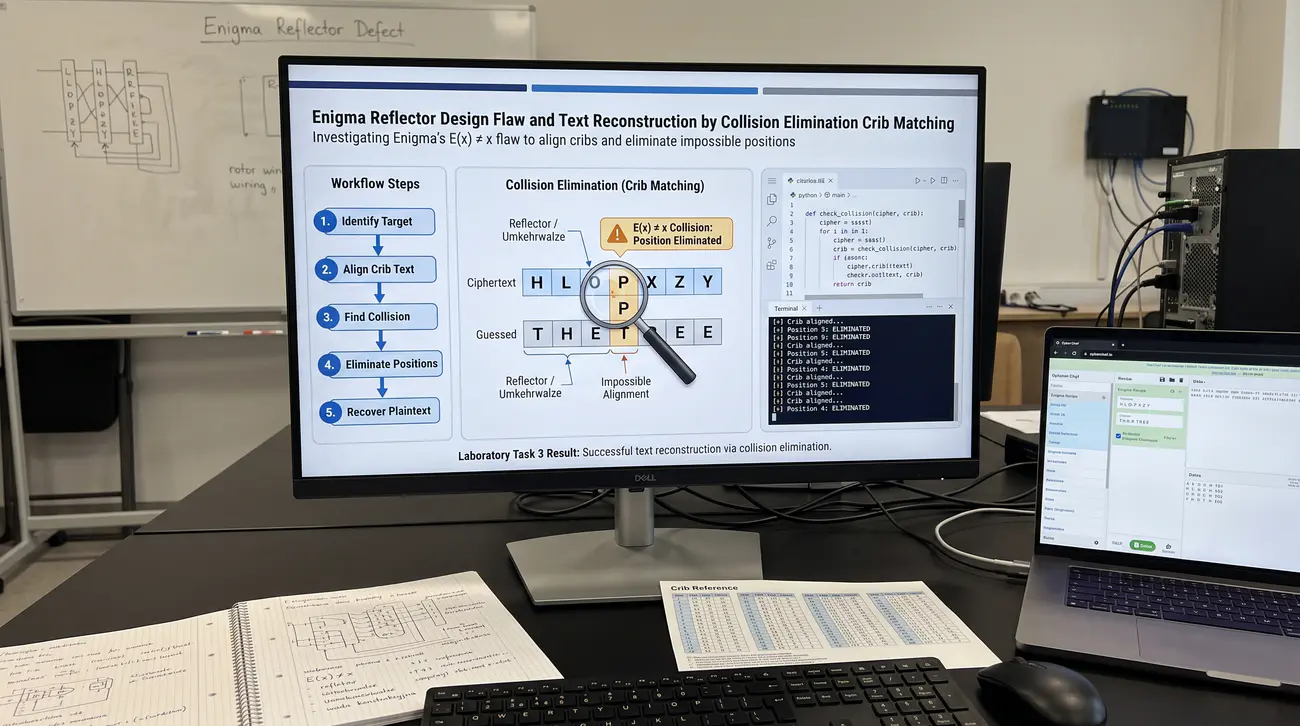
Zadanie 3. Badanie wady konstrukcyjnej reflektora Enigmy i rekonstrukcja tekstu metodą eliminacji kolizji (Crib Matching)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3 + symulator Enigmy
Podstawa wykładowa: Część 2 - slajdy 34, 35: bęben odwracający Enigmy (reflektor / Umkehrwalze), wada konstrukcyjna E(x) != x, technika dopasowywania tekstu domniemanego (crib matching), eliminacja niemożliwych położeń, fundament Bomby Turinga.

Cel

Celem zadania jest zbadanie fundamentalnej wady konstrukcyjnej reflektora Enigmy polegającej na niemożności zaszyfrowania litery w samą siebie. Student tworzy w języku Python program realizujący test dopasowania słowa prawdopodobnego (crib matching) w przechwyconym szyfrogramie wojskowym, odrzuca pozycje sprzeczne logicznie (zawierające kolizję identycznych znaków) i zawęża przestrzeń poszukiwań bębnów do pojedynczych pozycji, symulując założenia pracy Bomby Turinga w Bletchley Park.

Scenariusz – opis

W tym ćwiczeniu analizujesz najważniejszą wadę konstrukcyjną Enigmy, która stała się fundamentem brytyjskiej Bomby Turinga w Bletchley Park. Uruchamiasz przeglądarkę internetową, otwierasz symulator Enigmy w serwisie CyberChef oraz emulator konsoli JSLinux. Reflektor (Umkehrwalze) zapewniał samoodwracalność maszyny, łącząc litery w 13 par, co jednak oznaczało, że prąd elektryczny nigdy nie mógł powrócić do tego samego klawisza. W rezultacie żadna litera tekstu jawnego nigdy, pod żadnym warunkiem, nie mogła zostać zaszyfrowana jako ta sama litera w szyfrogramie: E(x) != x. W symulatorze Enigmy konfigurujesz maszynę i szyfrujesz autentyczny meldunek pogodowy zaczynający się od niemieckiej frazy wojskowej, na przykład 'WETTERVORHERSAGE'.

Co ma wykonać student / grupa

Uzyskany szyfrogram o długości 160 znaków zapisujesz do pliku meldunek.txt w środowisku JSLinux. Wyobrażasz sobie, że jesteś kryptoanalitykiem w Bletchley Park, który wie z doświadczenia, że poranne meldunki niemieckie niemal zawsze zawierają słowo WETTERVORHERSAGE (tzw. crib). Nie wiesz jednak, w którym dokładnie miejscu depeszy to słowo się znajduje, ani jakie były pozycje wirników. Tworzysz w JSLinux skrypt crib_matcher.py w języku Python.

Skrypt przesuwa wzorzec słowa WETTERVORHERSAGE pozycja po pozycji wzdłuż całego 160-znakowego szyfrogramu. Dla każdego położenia program sprawdza, czy którakolwiek litera wzorca pokrywa się z literą szyfrogramu na tej samej pozycji (warunek kolizji: crib[j] == ciphertext[i + j]). Wystąpienie choćby jednej identycznej litery natychmiast wyklucza dane położenie jako fizycznie niemożliwe w maszynie Enigma. Uruchamiasz program i analizujesz wygenerowaną mapę dopasowań w konsoli JSLinux.

Odnotowujesz, że z ponad 140 potencjalnych pozycji wzorca, zaledwie kilka pozycji nie generuje żadnej kolizji znakowej. Wskazujesz tę jedną pozycję, która idealnie pasuje do kontekstu nagłówka depeszy. Rozszerzasz program o moduł testujący zaangażowanie obrotu wirników dla znalezionej pozycji wzorca. Wyjaśniasz w sprawozdaniu, w jaki sposób wyeliminowanie ponad 90 procent pozycji za pomocą prostej reguły kolizji umożliwiało efektywne działanie elektromechanicznych bomb Turinga. Wykonujesz zrzuty ekranu symulatora Enigmy z zaszyfrowanym meldunkiem oraz konsoli JSLinux z wizualizacją odrzuconych i dopuszczalnych położeń słowa. Sporządzasz tabelę przedstawiającą testowane pozycje wzorca z zaznaczonymi literami kolidującymi.

Formułujesz podsumowanie techniczne wyjaśniające, jak pozorna zaleta konstrukcyjna (reflektor) stała się przyczyną klęski całego systemu szyfrowania. Upewniasz się, że wszystkie kroki zostały przejrzyście udokumentowane.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce symulator Enigmy oraz terminal JSLinux Alpine.
  2. Skonfiguruj Enigmę i zaszyfruj meldunek wojskowy zawierający frazę WETTERVORHERSAGE.
  3. Zapisz otrzymany szyfrogram do pliku meldunek.txt w JSLinux.
  4. Stwórz w JSLinux plik crib_matcher.py w języku Python.
  5. Zaimplementuj funkcję sprawdzającą kolizje: has_collision( crib, cipher_slice).
  6. Napisz pętlę przesuwającą słowo crib wzdłuż całego szyfrogramu z krokiem 1.
  7. Zaimplementuj kolorowe lub tekstowe oznaczanie kolidujących liter w terminalu.
  8. Zlicz liczbę pozycji odrzuconych oraz liczbę pozycji potencjalnie poprawnych.
  9. Uruchom program: python3 crib_matcher.py i przeanalizuj wyjście konsoli.
  10. Zidentyfikuj pozycję o zerowej liczbie kolizji odpowiadającą faktycznemu umiejscowieniu frazy.
  11. Zweryfikuj, dlaczego żaden poprawny meldunek Enigmy nie może wygenerować kolizji.
  12. Wyjaśnij powiązanie pomiędzy crib matchingiem a konstrukcją menu Bomby Turinga.
  13. Przetestuj działanie programu dla innego słowa domniemanego (np. OBERKOMMANDO).
  14. Wykonaj zrzuty ekranu symulatora oraz raportu z dopasowania wygenerowanego przez skrypt.
  15. Sporządź tabelę zestawiającą pozycje, liczbę kolizji i status dopasowania.
  16. Sformułuj wnioski kryptoanalityczne na temat wady konstrukcyjnej walca odwracającego.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak crib matching na wektorze ze startera: wykorzystując zakaz E(x)=x odrzucono kolizyjne pozycje i jednoznacznie zlokalizowano cribs w szyfrogramie.
  2. Wykazano różnicę: weryfikator podatny (reflektor bez punktów stałych — szybka eliminacja) vs hipotetyczny poprawiony (dopuszczone punkty stałe — brak eliminacji); dołączono logi eliminacji.
  3. Dołączono log ataku (tabela pozycji odrzuconych/przyjętych) + kod łatki (procedura operacyjna maskująca: cribs bez stereotypów, dłuższe klucze).
  4. Opisano w 3–5 zdaniach kompromis: samoodwracalność reflektora vs luka E(x)≠x, zasada sprzeczności Turinga, koszt eliminacji przestrzeni.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego właściwość braku punktów stałych E(x) != x stanowiła krytyczną lukę konstrukcyjną Enigmy.
  • W jaki sposób technika dopasowywania cribs pozwala drastycznie zredukować przestrzeń poszukiwań tekstu jawnego.
  • Jak zasada eliminacji sprzeczności umożliwiła Turingowi i Welchmanowi stworzenie Bomby w Bletchley Park.
  • Student potrafi zaimplementować algorytm testowania kolizji w Pythonie i zidentyfikować pozycję frazy w szyfrogramie.
Zadanie 3 - ilustracja
04/10
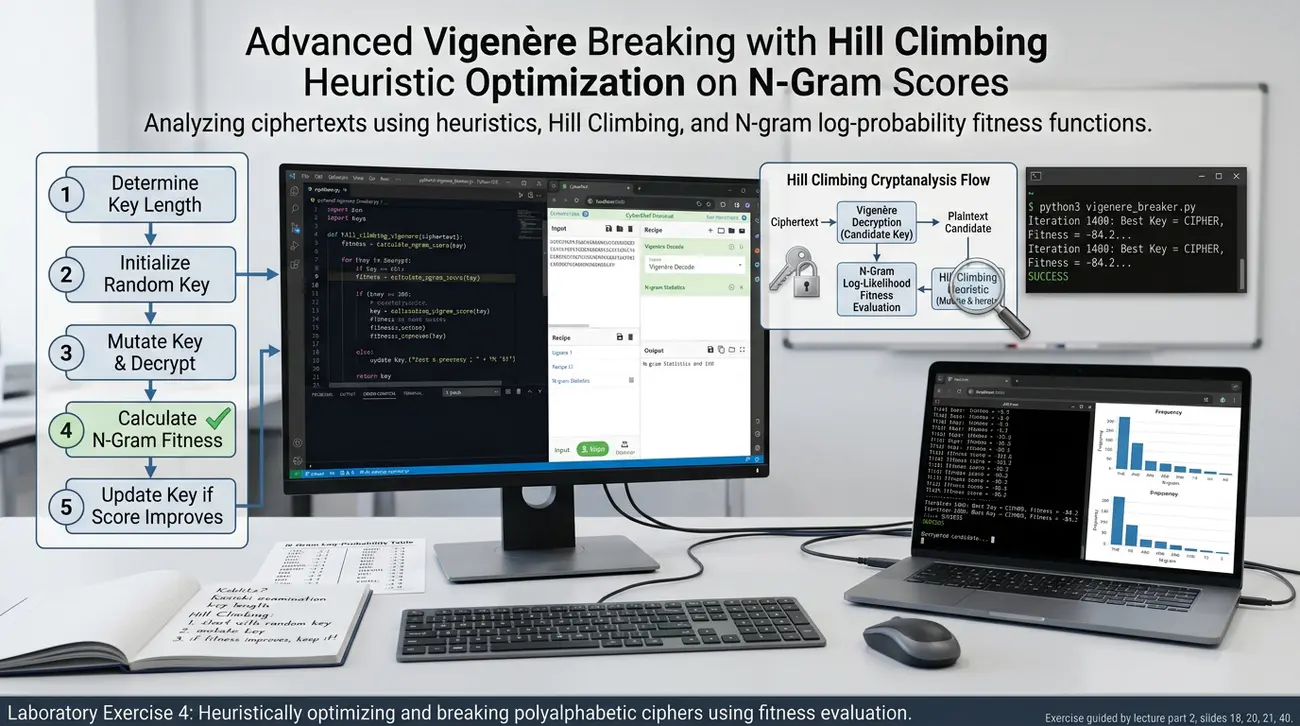
Zadanie 4. Zaawansowane łamanie szyfru Vigenère metodą optymalizacji heurystycznej (Hill-Climbing) na bazie n-gramów
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3 + CrypTool-Online
Podstawa wykładowa: Część 2 - slajdy 18, 20, 21, 40: szyfry polialfabetyczne, zaawansowana kryptoanaliza heurystyczna, algorytm wspinaczkowy (hill climbing), funkcja przystosowania (fitness) oparta na logarytmach prawdopodobieństw tetragramów języka.

Cel

Celem zadania jest opanowanie nowoczesnych metod kryptoanalizy heurystycznej stosowanych do łamania szyfrów klasycznych bez polegania na metodzie Kasiskiego. Student implementuje w Pythonie w JSLinux algorytm wspinaczkowy (hill climbing), który wykorzystuje statystykę logarytmiczną tetragramów do oceny jakości odszyfrowanego tekstu, dokonuje losowych mutacji klucza i w pełni automatycznie odnajduje hasło szyfru Vigenère’a o dowolnej długości.

Scenariusz – opis

W tym zadaniu sięgasz po algorytmy optymalizacji sztucznej inteligencji w celu przełamania trudnych przypadków szyfru Vigenère’a. Uruchamiasz przeglądarkę internetową, otwierasz serwis CyberChef, narzędzie CrypTool-Online oraz konsolę JSLinux Alpine. W CyberChef przygotowujesz polski tekst techniczny o długości około 400 znaków i szyfrujesz go długim hasłem o długości 8 liter, na przykład 'DIAMENTY'. W tak krótkim tekście z długim kluczem metoda Kasiskiego często zawodzi z powodu braku powtarzających się sekwencji. Do rozwiązania problemu zastosujesz algorytm wspinaczkowy (hill climbing) sterowany funkcją oceny tetragramów (sekwencji 4 liter).

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz plik tetragrams.py zawierający znormalizowaną bazę logarytmicznych częstości najczęstszych polskich lub angielskich tetragramów. Funkcja oceny (fitness score) oblicza sumę logarytmów prawdopodobieństw wszystkich sąsiadujących czwórek liter w odszyfrowanym tekście. Tekst w języku naturalnym osiąga wysoki wynik oceny, natomiast tekst chaotyczny uzyskuje wynik bardzo niski. Tworzysz główny program vigenere_hill_climber.py w języku Python.

Program losuje początkowy klucz o testowanej długości 8 liter złożony z przypadkowych liter alfabetu (np. AAAAAAAA). W pętli optymalizacyjnej algorytm wybiera losową pozycję w haśle i zamienia literę na inną literę alfabetu (krok mutacji).

Następnie odszyfrowuje tekst zmutowanym hasłem i oblicza nową wartość funkcji oceny. Jeżeli nowy wynik jest wyższy od dotychczasowego najlepszego, algorytm akceptuje zmianę i kontynuuje wspinaczkę od nowego punktu. Jeżeli wynik jest gorszy, zmiana jest odrzucana, a algorytm testuje inną mutację. Uruchamiasz program w JSLinux i obserwujesz w czasie rzeczywistym rosnący wynik funkcji dopasowania na ekranie terminala.

Śledzisz, jak w ciągu kilkudziesięciu sekund z przypadkowego ciągu liter wyłaniają się kolejne poprawne litery hasła 'DIAMENTY'. Po ustabilizowaniu wyniku program wypisuje odzyskany klucz oraz w pełni czytelny tekst jawny. Weryfikujesz uzyskany rezultat w module Vigenère Breaker serwisu CrypTool-Online, porównując czas i zbieżność obu metod. Wykonujesz zrzuty ekranu kodu programu, wykresu zbieżności funkcji oceny oraz wyjścia konsoli JSLinux. Sporządzasz sprawozdanie techniczne opisujące działanie funkcji fitness, problem minimów lokalnych oraz efektywność algorytmów heurystycznych. Upewniasz się, że wszystkie kroki zostały należycie udokumentowane.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef oraz konsolę JSLinux Alpine.
  2. Zaszyfruj w CyberChef tekst 400-znakowy z 8-literowym kluczem (np. DIAMENTY).
  3. Zapisz szyfrogram w pliku vigenere_hard.txt w JSLinux.
  4. Zdobądź moduł z tabelą logarytmów prawdopodobieństw tetragramów dla języka polskiego: użyj pliku tetragrams_pl.py z materiałów zajęć, a jeżeli go nie ma, zbuduj własny na podstawie najdłuższego dostępnego polskiego tekstu (minimum kilkadziesiąt tysięcy znaków, nie na podstawie samego szyfrogramu). Przed atakiem wykonaj test kontrolny modułu: fitness_score( tekst jawny) musi być wyraźnie wyższy niż fitness_score( losowy ciąg tej samej długości); jeżeli nie jest, moduł jest uszkodzony i atak nie ma sensu. Uwaga: korpusu nie poprawiasz w trakcie strojenia ataku - walczysz z algorytmem, nie z danymi.
  5. Napisz funkcję oceny fitness_score( tekst), sumującą wagi czwórek liter.
  6. Zaimplementuj algorytm Hill Climbing w pliku vigenere_hill_climber.py.
  7. Zainicjuj klucz losowym ciągiem 8 liter i oblicz początkowy wynik punktowy.
  8. Zaimplementuj pętlę 2000 iteracji z mutacją pojedynczej litery klucza.
  9. Dodaj warunek akceptacji: if new_score > best_score: best_key = new_key.
  10. Dodaj wyświetlanie postępów co 100 iteracji: numer kroku, aktualny klucz, score.
  11. Uruchom program i zaobserwuj zbieżność do oryginalnego słowa DIAMENTY.
  12. Przetestuj odporność algorytmu na utknięcie w lokalnym maksimum poprzez restart z nowego punktu.
  13. Wprowadź szyfrogram do modułu analitycznego CrypTool-Online w celu walidacji.
  14. Wykonaj zrzuty ekranu kodu skryptu oraz terminala z przebiegiem optymalizacji.
  15. Sporządź wykres punktacji w funkcji liczby iteracji w sprawozdaniu.
  16. Sformułuj wnioski wyjaśniające potęgę n-gramowych funkcji oceny w kryptoanalizie.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano łamanie Vigenère hill-climbing na wektorze ze startera: bez Kasiskiego odzyskano klucz i tekst samą optymalizacją oceny n-gramowej.
  2. Wykazano różnicę: weryfikator podatny (krótki klucz, tekst zdradza n-gramy — szybka zbieżność) vs kontrola (losowy tekst — płaska ocena, brak zbieżności); dołączono krzywe fitness.
  3. Dołączono log ataku (iteracje, restarty, odzyskany klucz) + kod łatki (klucz długości tekstu / OTP — brak struktury do optymalizacji).
  4. Opisano w 3–5 zdaniach kompromis: szybkość heurystyki vs minima lokalne i restarty, siła n-gramów bez słownika, koszt obliczeniowy oceny.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego funkcja oceny oparta na n-gramach pozwala oceniać sensowność tekstu bez znajomości słownika wyrazów.
  • W jaki sposób heurystyka wspinaczkowa przeszukuje gigantyczną przestrzeń kluczy w ułamku sekundy.
  • Jakie ograniczenia niosą minima lokalne i jak techniki restartu zapobiegają fałszywym rozwiązaniom.
  • Student potrafi zaimplementować algorytm Hill Climbing z n-gramową funkcją oceny w języku Python.
Zadanie 4 - ilustracja
05/10
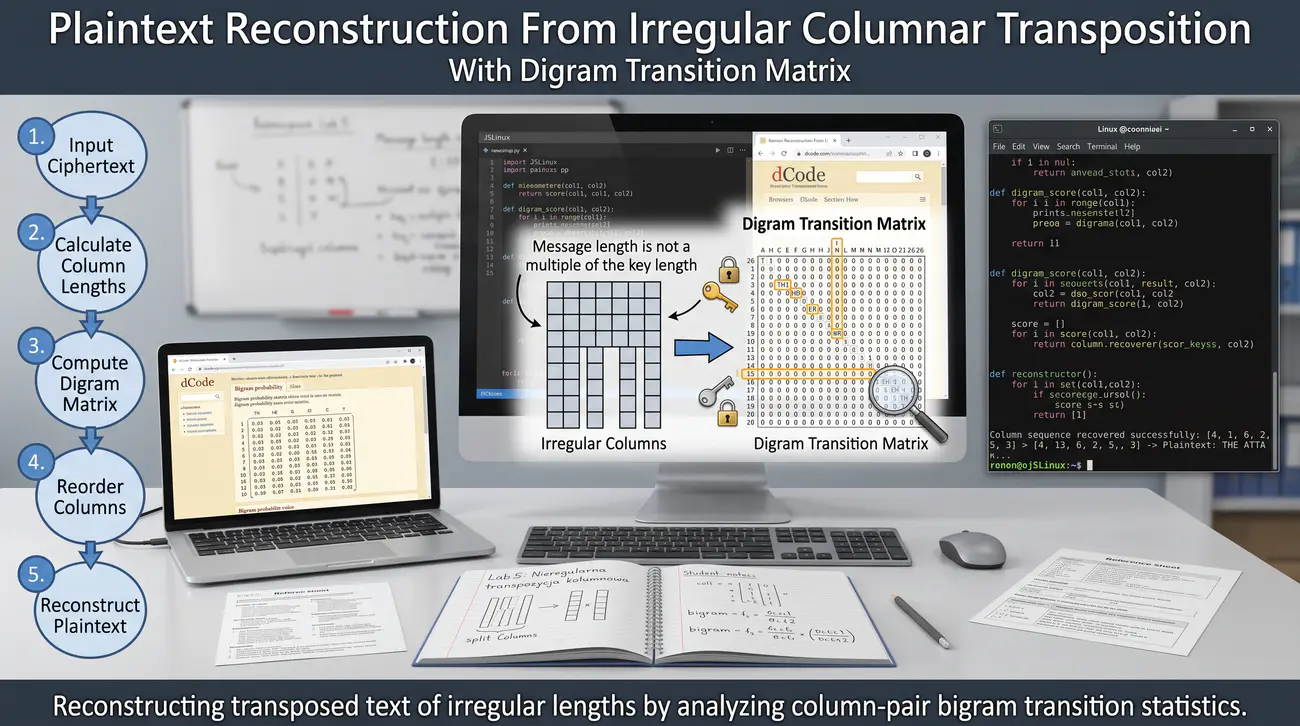
Zadanie 5. Rekonstrukcja tekstu z nieregularnej transpozycji kolumnowej z użyciem macierzy przejść digramowych
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 27, 31, 40: nieregularna transpozycja kolumnowa (długość tekstu nie jest wielokrotnością klucza, kolumny mają zróżnicowaną liczbę znaków), niszczenie n-gramów, łączenie kolumn na bazie prawdopodobieństwa digramów.

Cel

Celem zadania jest zmierzenie się z jednym z najtrudniejszych szyfrów klasycznych – nieregularną transpozycją kolumnową. Student analizuje matematyczną strukturę prostokąta o nierównych kolumnach, implementuje w Pythonie algorytm wyliczający dokładną długość każdej kolumny, a następnie tworzy program kryptoanalityczny, który na podstawie prawdopodobieństwa przejść dwuznakowych (macierzy digramów) automatycznie łączy kolumny w poprawny tekst jawny.

Scenariusz – opis

W tym zadaniu rozwiązujesz problem kryptoanalizy nieregularnej transpozycji kolumnowej, uważanej przez historyków za najtwardszy szyfr ręczny. Uruchamiasz przeglądarkę internetową, otwierasz serwis dCode Columnar Transposition oraz emulator konsoli JSLinux z Pythonem. W nieregularnej transpozycji długość tekstu nie dzieli się bez reszty przez długość klucza, co oznacza, że część kolumn posiada o jeden znak więcej niż pozostałe. Fakt ten całkowicie uniemożliwia proste cięcie szyfrogramu na równe bloki i dramatycznie utrudnia kryptoanalizę. W serwisie dCode przygotowujesz polski tekst techniczny liczący 73 znaki i szyfrujesz go kluczem o długości 6 liter (np. KOBRA).

Co ma wykonać student / grupa

Przy 73 znakach i kluczu o długości 6, pełna liczba wierszy wynosi 13, przy czym pierwsza kolumna ma 13 znaków, a pozostałe pięć kolumn ma po 12 znaków. Zapisujesz otrzymany szyfrogram do pliku irregular.txt w środowisku JSLinux. Tworzysz w JSLinux program irregular_analyzer.py w języku Python. W pierwszym module program wylicza na podstawie długości tekstu L = 73 i testowanej liczby kolumn K = 6 dokładną liczbę kolumn długich oraz krótkich.

Następnie skrypt rozcina szyfrogram na 6 odrębnych wektorów kolumnowych o właściwych długościach. W drugim module implementujesz macierz logarytmów prawdopodobieństw polskich digramów P(b | a). Dla każdej możliwej pary kolumn (A, B) program oblicza sumę prawdopodobieństw digramów, jakie powstałyby przy umieszczeniu kolumny B bezpośrednio po prawej stronie kolumny A. Pary kolumn tworzące naturalne polskie słowa (np. 'st', 'rz', 'pr', 'ie') uzyskują bardzo wysokie wagi sumaryczne.

Skrypt buduje graf przejść i odnajduje optymalną ścieżkę Hamiltona łączącą wszystkie 6 kolumn w jeden spójny ciąg. Uruchamiasz program w JSLinux i analizujesz macierz powiązań pomiędzy kolumnami. Obserwujesz, jak algorytm łączy kolejne kolumny i odtwarza pierwotną kolejność klucza permutacji. Program odczytuje połączone kolumny wiersz po wierszu, prezentując w pełni odzyskany tekst jawny. Weryfikujesz wynik w serwisie dCode, upewniając się, że odtworzony tekst i kolejność kolumn są bezbłędne. Wykonujesz zrzuty ekranu kodu programu w JSLinux, macierzy wag digramowych oraz terminala z odtworzonym tekstem.

Sporządzasz sprawozdanie techniczne opisujące geometrię nieregularnego prostokąta i metodę łączenia kolumn za pomocą grafu digramowego. Podsumowujesz zadanie wnioskiem o roli analizy dwuznakowej w przełamywaniu zaawansowanych przestawień.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz stronę dcode.fr/columnar-transposition-cipher oraz konsolę JSLinux Alpine.
  2. Przygotuj polski tekst jawny o długości niepodzielnej przez klucz (np. 73 znaki).
  3. Zaszyfruj tekst w dCode nieregularną transpozycją z 6-literowym kluczem (np. KOBRA).
  4. Zapisz szyfrogram w pliku irregular.txt w JSLinux.
  5. Stwórz w JSLinux plik irregular_analyzer.py.
  6. Zaimplementuj funkcję obliczającą liczbę kolumn długich i krótkich według szkieletu (przepisz 1:1 i tylko go użyj): base = L // K; n_long = L % K - pierwsze n_long kolumn ma długość base + 1, pozostałe base. Kontrola: dla L = 73 i K = 6 szkielet daje base = 12, n_long = 1 (jedna kolumna 13-znakowa, pięć kolumn 12-znakowych); jeżeli twój program twierdzi inaczej, błąd jest w cięciu szyfrogramu, nie w teorii.
  7. Napisz kod dzielący szyfrogram na K wektorów kolumnowych o wyznaczonych długościach.
  8. Zaimportuj tablicę logarytmów częstości digramów języka polskiego.
  9. Zaimplementuj funkcję scoringową pair_score(col_A, col_B) sumującą wagi digramów w wierszach.
  10. Oblicz macierz wag przejść pomiędzy wszystkimi parami kolumn K x K.
  11. Zaimplementuj algorytm przeszukiwania permutacji kolumn w celu maksymalizacji łącznej sumy wag.
  12. Uruchom skrypt w JSLinux: python3 irregular_analyzer.py irregular.txt.
  13. Odczytaj zrekonstruowany porządek kolumn i odszyfrowany tekst jawny.
  14. Potwierdź poprawność rekonstrukcji w narzędziu dCode.
  15. Wykonaj zrzuty ekranu kodu źródłowego, macierzy powiązań i wyniku konsoli.
  16. Opracuj raport dokumentujący matematyczne i lingwistyczne aspekty ataku na nieregularną transpozycję.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak na nieregularną transpozycję na wektorze ze startera: wyliczono długości kolumn, oceną digramową posklejano sąsiedztwa i odzyskano tekst.
  2. Wykazano różnicę: weryfikator podatny (tekst naturalny — wysokie wyniki digramów dla dobrych sąsiedztw) vs kontrola (tekst losowy — brak wyróżnika); dołączono macierz przejść i ścieżkę.
  3. Dołączono log ataku (długości kolumn, ranking sąsiedztw, odzyskana permutacja) + kod łatki (podwójna transpozycja / dłuższy klucz — eksplozja kombinatoryczna).
  4. Opisano w 3–5 zdaniach kompromis: bariera ręczna vs graf permutacji + lingwistyka, koszt O(n!) a ocena digramowa, granice metody.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego nieregularność długości kolumn stanowiła tak poważną barierę dla kryptoanalizy ręcznej.
  • W jaki sposób macierz przejść digramowych pozwala ocenić prawdopodobieństwo sąsiedztwa kolumn.
  • Jak pojęcie ścieżki w grafie permutacji łączy algebrę kombinatoryczną z lingwistyką komputerową.
  • Student potrafi zaimplementować i przeprowadzić kryptoanalizę nieregularnej transpozycji kolumnowej w Pythonie.
Zadanie 5 - ilustracja
06/10
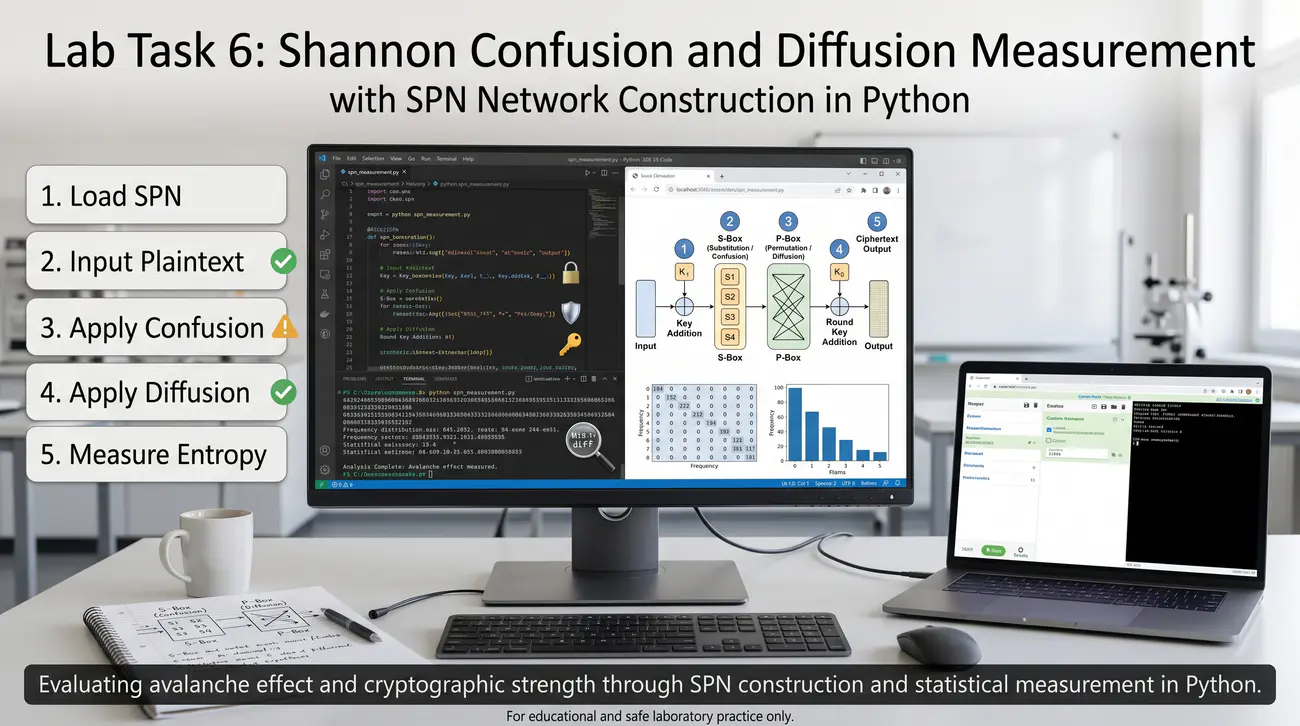
Zadanie 6. Pomiar i implementacja konfuzji i dyfuzji w modelu Shannona – konstrukcja sieci SPN w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 2 - slajdy 42, 43, 44: ograniczenia technik klasycznych, teoria Claude'a Shannona (1949), konfuzja (confusion, nieliniowe S-boxy), dyfuzja (diffusion, liniowe P-boxy), miniaturowa sieć SPN (Substitution-Permutation Network), efekt lawinowy (avalanche effect).

Cel

Celem zadania jest praktyczne zrozumienie i pomiar dwóch fundamentalnych zasad nowoczesnej kryptografii zdefiniowanych przez Claude'a Shannona – konfuzji i dyfuzji. Student buduje w języku Python w JSLinux miniaturową 16-bitową sieć SPN (Substitution-Permutation Network) wykorzystującą 4-bitowe S-boxy i permutację bitową P-box, a następnie przeprowadza rygorystyczny pomiar efektu lawinowego (avalanche effect) po 1, 2, 3 i 4 rundach szyfrowania przy zmianie pojedynczego bitu tekstu jawnego.

Scenariusz – opis

W tym zadaniu przekraczasz granicę pomiędzy kryptografią klasyczną a nowoczesną, badając fundamenty teorii Claude'a Shannona z 1949 roku. Uruchamiasz przeglądarkę internetową, otwierasz konsolę JSLinux Alpine oraz narzędzie CyberChef. Shannon wykazał, że pojedyncze podstawienie daje wyłącznie konfuzję (zamazywanie relacji klucz-szyfrogram), a pojedyncze przestawienie daje wyłącznie dyfuzję (rozpraszanie statystyki tekstu jawnego). Dopiero wielokrotne, naprzemienne łączenie obu operacji w strukturze rundowej tworzy szyfr odporny na kryptoanalizę. W konsoli JSLinux tworzysz plik spn_cipher.py w języku Python.

Co ma wykonać student / grupa

Projektujesz miniaturową sieć SPN przetwarzającą 16-bitowe bloki danych (2 bajty). Implementujesz nieliniowy 4-bitowy S-box (podstawienie zamieniające 4 bity wejściowe na 4 bity wyjściowe według ustalonej permutacji) spełniający kryteria braku punktów stałych. Implementujesz 16-bitowy P-box (permutację przestawiającą 16 bitów tak, aby 4 wyjścia każdego S-boxa trafiały do 4 różnych S-boxów w kolejnej rundzie – klucz do dyfuzji). Tworzysz funkcję rundy wykonującą: dodanie podklucza rundy (XOR), warstwę 4 S-boxów oraz warstwę permutacji bitowej P-box. Implementujesz pełny szyfr składający się z 4 rund z niezależnymi 16-bitowymi podkluczami rundowymi.

W kolejnym module programu implementujesz procedurę pomiaru efektu lawinowego (avalanche effect). Wybierasz bazowy 16-bitowy blok danych i szyfrujesz go, rejestrując stan bitów po rundzie 1, 2, 3 oraz 4.

Następnie zmieniasz dokładnie jeden, wybrany bit w bloku wejściowym (odległość Hamminga = 1) i ponownie szyfrujesz zmodyfikowany blok. Dla każdej rundy program oblicza odległość Hamminga pomiędzy stanem pierwotnym a zmodyfikowanym (liczbę bitów, które uległy zmianie). Test powtarzasz w pętli dla 1000 losowych wektorów wejściowych i obliczasz średni procent zmienionych bitów po każdej rundzie. Analizujesz wyniki: po 1 rundzie zmienia się zaledwie 2-4 bity (brak pełnej dyfuzji).

Po 2 rundach zmiana obejmuje średnio 6-8 bitów. Po 3 i 4 rundach średnia liczba zmienionych bitów osiąga dokładnie 8 bitów na 16 (idealne 50 procent – pełny efekt lawinowy). Przeprowadzasz test kontrolny, wyłączając warstwę P-box (pozostawiając same S-boxy), i obserwujesz drastyczne załamanie dyfuzji (zmiana bitu pozostaje uwięziona w jednym S-boxie). Wykonujesz zrzuty ekranu kodu sieci SPN w JSLinux oraz wygenerowanej tabeli średnich wag Hamminga po kolejnych rundach. Sporządzasz wykres efektu lawinowego w funkcji numeru rundy i podsumowujesz ćwiczenie wnioskiem o synergii konfuzji i dyfuzji.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom środowisko JSLinux Alpine z interpreterem python3.
  2. Przeanalizuj budowę 16-bitowej sieci SPN: 4 S-boxy po 4 bity, 16-bitowa permutacja P-box.
  3. Stwórz w JSLinux plik spn_cipher.py w edytorze nano.
  4. Zdefiniuj tabelę 4-bitowego S-boxa (np. 0xE, 0x4, 0xD, 0x1, 0x2, 0xF...).
  5. Zaimplementuj permutację P-box rozpraszającą bity pomiędzy 4 S-boxami kolejnej rundy.
  6. Napisz funkcję round_function( state, round_key, is_last_round).
  7. Zaimplementuj pełne 4-rundowe szyfrowanie SPN z generatorem prostych podkluczy.
  8. Napisz funkcję hamming_distance(v1, v2) liczącą liczbę różniących się bitów.
  9. Stwórz pętlę testową dla 1000 losowych bloków 16-bitowych.
  10. Dla każdego bloku odwróć 1 losowy bit i zmierz odległość Hamminga po rundzie 1, 2, 3 i 4.
  11. Oblicz średnią liczbę zmienionych bitów oraz procent zmiany dla każdej rundy.
  12. Przeprowadź eksperyment z wyłączoną permutacją P-box (sama konfuzja bez dyfuzji).
  13. Porównaj wyniki obu wariantów i wykaż rolę P-boxa w propagacji zmian.
  14. Wykonaj zrzuty ekranu kodu źródłowego oraz tabeli z wynikami pomiaru efektu lawinowego.
  15. Sporządź wykres zależności efektu lawinowego od liczby rund w sprawozdaniu.
  16. Sformułuj wnioski wyjaśniające, w jaki sposób konfuzja i dyfuzja Shannona dały początek szyfrom DES i AES.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano sieć SPN na wektorze ze startera: zmierzono konfuzję/dyfuzję (lawina ~50% bitów) i pokazano załamanie po wyłączeniu P-boxa.
  2. Wykazano różnicę: weryfikator poprawny (S-box+P-box — pełna lawina) vs okaleczony (samo S-box — zmiany lokalne, brak propagacji); dołączono pomiary Hamminga.
  3. Dołączono log pomiarów (tabele lawinowe dla 1-bitowych zmian) + kod łatki (pełne rundy SPN, min. 4 rundy, test SAC w CI).
  4. Opisano w 3–5 zdaniach kompromis: koszt rund/nieliniowości vs bezpieczeństwo, 50% jako warunek konieczny, lekcja Shannona dla projektantów.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Na czym polega matematyczna różnica pomiędzy konfuzją realizowaną przez S-box a dyfuzją realizowaną przez P-box.
  • Dlaczego osiągnięcie 50% zmienionych bitów (efekt lawinowy) jest warunkiem koniecznym bezpieczeństwa szyfru blokowego.
  • W jaki sposób wyłączenie warstwy permutacji bitowej uniemożliwia rozprzestrzenianie zmian na sąsiednie bloki.
  • Student potrafi zaimplementować sieć SPN w Pythonie i ilościowo zmierzyć efekt lawinowy w warunkach laboratoryjnych.
Zadanie 6 - ilustracja
07/10
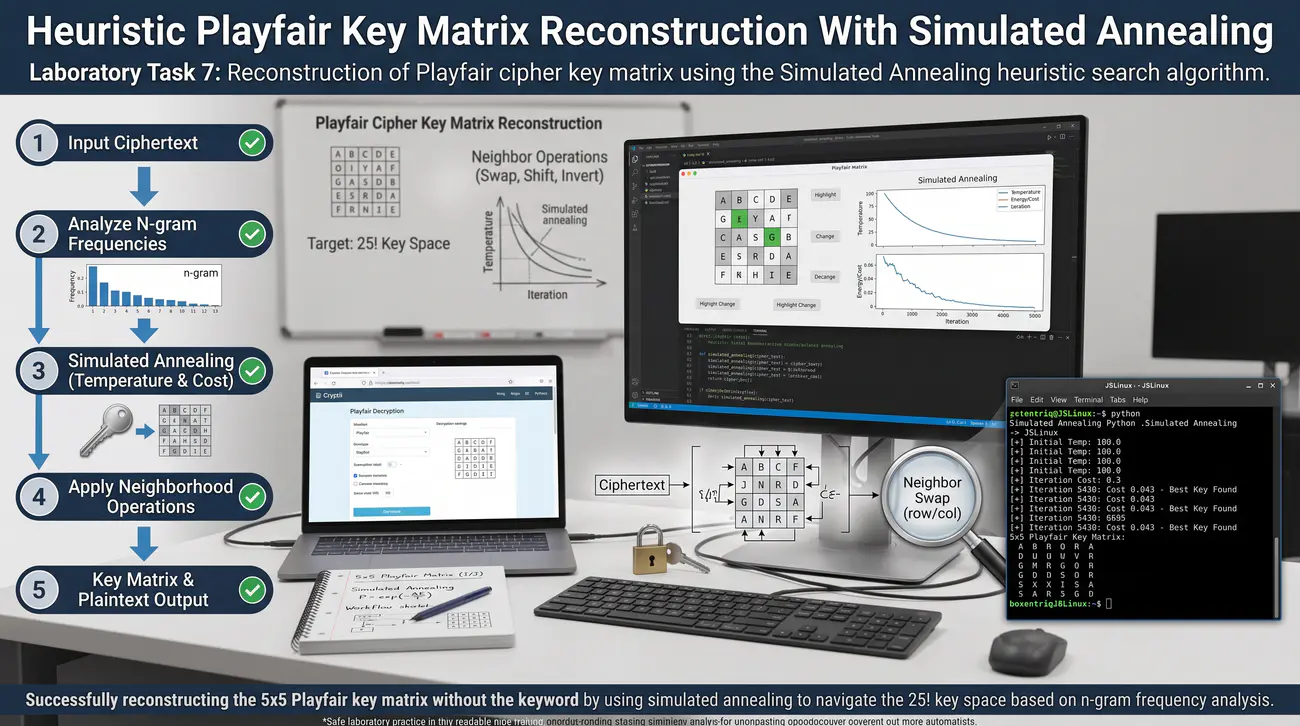
Zadanie 7. Heurystyczna rekonstrukcja matrycy klucza szyfru Playfair metodą symulowanego wyżarzania
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Boxentriq + Cryptii + Python 3
Podstawa wykładowa: Część 2 - slajdy 22, 23, 24, 25, 40: szyfr Playfair, kryptoanaliza bez znajomości słowa kluczowego, przestrzeń 25! kluczy, algorytm symulowanego wyżarzania (Simulated Annealing), operacje sąsiedztwa na matrycy 5x5, funkcja scoringu digramowego/trigramowego.

Cel

Celem zadania jest przełamanie szyfru Playfair bez znajomości słowa kluczowego i bez słownika wyrazów za pomocą zaawansowanego algorytmu symulowanego wyżarzania (Simulated Annealing). Student implementuje w Pythonie w środowisku JSLinux algorytm probabilistyczny przeszukujący przestrzeń 25 silnia konfiguracji matrycy 5x5, definiuje operacje mutacji układu liter oraz funkcję oceny digramowej, doprowadzając do pełnej automatycznej rekonstrukcji matrycy i odszyfrowania wiadomości.

Scenariusz – opis

W tym zadaniu realizujesz jeden z najbardziej spektakularnych ataków kryptoanalitycznych – złamanie szyfru Playfair metodą symulowanego wyżarzania. Uruchamiasz przeglądarkę internetową, otwierasz serwis Cryptii, narzędzie Boxentriq oraz emulator konsoli JSLinux Alpine. Przestrzeń możliwych matryc 5 na 5 w szyfrze Playfair wynosi 25! (około 1.5 * 10^25), co całkowicie wyklucza przeszukiwanie siłowe brute force. Zwykły algorytm wspinaczkowy (Hill Climbing) łatwo grzęźnie w lokalnych maksimach z powodu skomplikowanej geometrii reguł Playfair. Rozwiązaniem jest symulowane wyżarzanie (Simulated Annealing), które z malejącym prawdopodobieństwem P = exp(Delta_score / T) akceptuje również rozwiązania chwilowo gorsze, uciekając z pułapek lokalnych.

Co ma wykonać student / grupa

W serwisie Cryptii przygotowujesz polski tekst techniczny o długości około 450 znaków i szyfrujesz go tajnym kluczem słownym w szyfrze Playfair. Zapisujesz uzyskany szyfrogram do pliku playfair_challenge.txt w środowisku JSLinux. Tworzysz w JSLinux plik playfair_annealing.py w języku Python. Implementujesz tablicę logarytmicznych częstości polskich digramów i trigramów stanowiącą funkcję oceny (fitness score) odszyfrowanego tekstu.

Definiujesz zestaw losowych modyfikacji matrycy 5x5: zamiana dwóch losowych liter, zamiana dwóch wierszy, zamiana dwóch kolumn oraz odwrócenie kolejności całej siatki. Inicjalizujesz temperaturę początkową T = 20.0, współczynnik chłodzenia alpha = 0.995 oraz losową matrycę początkową. W głównej pętli algorytm modyfikuje matrycę, odszyfrowuje szyfrogram i oblicza nowy wynik punktowy. Jeżeli wynik jest lepszy, zmiana jest akceptowana; jeżeli gorszy, zmiana jest akceptowana z prawdopodobieństwem zależnym od aktualnej temperatury T.

Temperatura T jest stopniowo obniżana w każdej epoce obliczeniowej. Uruchamiasz program w JSLinux i obserwujesz w konsoli proces chłodzenia oraz ewolucję matrycy. W miarę spadku temperatury chaotyczny tekst zaczyna układać się w spójne polskie słowa. Po osiągnięciu temperatury bliskiej zeru program stabilizuje się na optymalnej matrycy i wypisuje w pełni czytelny tekst jawny. Analizujesz odtworzoną matrycę 5 na 5 i identyfikujesz w niej oryginalny klucz słowny. Wykonujesz zrzuty ekranu kodu skryptu w JSLinux, wykresu temperatury i punktacji oraz terminala z odzyskanym tekstem.

Sporządzasz sprawozdanie techniczne opisujące mechanizm ucieczki z lokalnych maksimów i przewagę wyżarzania nad wspinaczką prostą. Podsumowujesz zadanie wnioskiem o zmierzchu ręcznych szyfrów wieloalfabetycznych i digramowych w obliczu algorytmów metaheurystycznych.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis Cryptii oraz konsolę JSLinux Alpine.
  2. Zaszyfruj w Cryptii polski tekst 450-znakowy szyfrem Playfair z tajnym hasłem.
  3. Zapisz szyfrogram w pliku playfair_challenge.txt w JSLinux.
  4. Stwórz w JSLinux plik playfair_annealing.py w edytorze nano.
  5. Zaimplementuj moduł deszyfrowania Playfair dla dowolnej matrycy 5x5 (zgodnie z regułami odwrotnymi).
  6. Zaimportuj bazę logarytmicznych wag digramów i trigramów języka polskiego.
  7. Napisz funkcję mutacji matrycy: swap_chars, swap_rows, swap_cols, reverse_matrix.
  8. Zaimplementuj pętlę symulowanego wyżarzania z parametrami: T_start=20.0, T_min=0.05, alpha=0.995.
  9. Zastosuj kryterium akceptacji Metropolisa: if math.exp((new_score - current_score)/T) > random.random().
  10. Dodaj rejestrowanie najlepszego globalnego wyniku i najlepszej znalezionej matrycy.
  11. Wykonaj minimum 3 niezależne restarty z nowej losowej matrycy; do raportu wpisz najlepszy wynik ze wszystkich restartów oraz numer restartu, w którym padł czytelny tekst. Pojedynczy przebieg bez restartu nie jest zaliczeniem - utknięcie w lokalnym maksimum to normalne zachowanie wyżarzania, a nie błąd implementacji.
  12. Uruchom skrypt: python3 playfair_annealing.py playfair_challenge.txt.
  13. Obserwuj spadek temperatury i dynamiczny wzrost czytelności tekstu w terminalu.
  14. Odczytaj zrekonstruowany tekst jawny oraz strukturę matrycy 5x5.
  15. Porównaj uzyskany wynik z oryginalnym tekstem jawnym i zidentyfikuj słowo kluczowe.
  16. Wykonaj zrzuty ekranu kodu programu, panelu chłodzenia w konsoli oraz odtworzonej treści.
  17. Opracuj raport dokumentujący zastosowanie metaheurystyk probabilistycznych w łamaniu szyfrów digramowych.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano łamanie Playfair wyżarzaniem na wektorze ze startera: bez klucza odzyskano matrycę i tekst samą oceną tetragramową.
  2. Wykazano różnicę: weryfikator podatny (długi tekst — zbieżność do czytelnego tekstu) vs kontrola (krótki tekst — wiele matryc remisuje); dołączono krzywą temperatury i fitness.
  3. Dołączono log ataku (iteracje, akceptacje Metropolisa, odzyskana matryca) + kod łatki (porzucenie Playfair / dłuższe jednostki — brak sensownej oceny).
  4. Opisano w 3–5 zdaniach kompromis: przestrzeń 25! vs probabilistyczna optymalizacja, rola temperatury/chłodzenia, koszt obliczeń a skuteczność.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego przestrzeń 25! matrycy Playfair nie stanowi bariery dla probabilistycznych algorytmów optymalizacyjnych.
  • W jaki sposób kryterium Metropolisa umożliwia wyjście z lokalnych pułapek funkcji oceny tekstu.
  • Jakie znaczenie ma odpowiedni dobór temperatury początkowej i tempa chłodzenia dla zbieżności algorytmu.
  • Student potrafi zaimplementować symulowane wyżarzanie w Pythonie i z sukcesem odtworzyć matrycę klucza Playfair.
Zadanie 7 - ilustracja
08/10
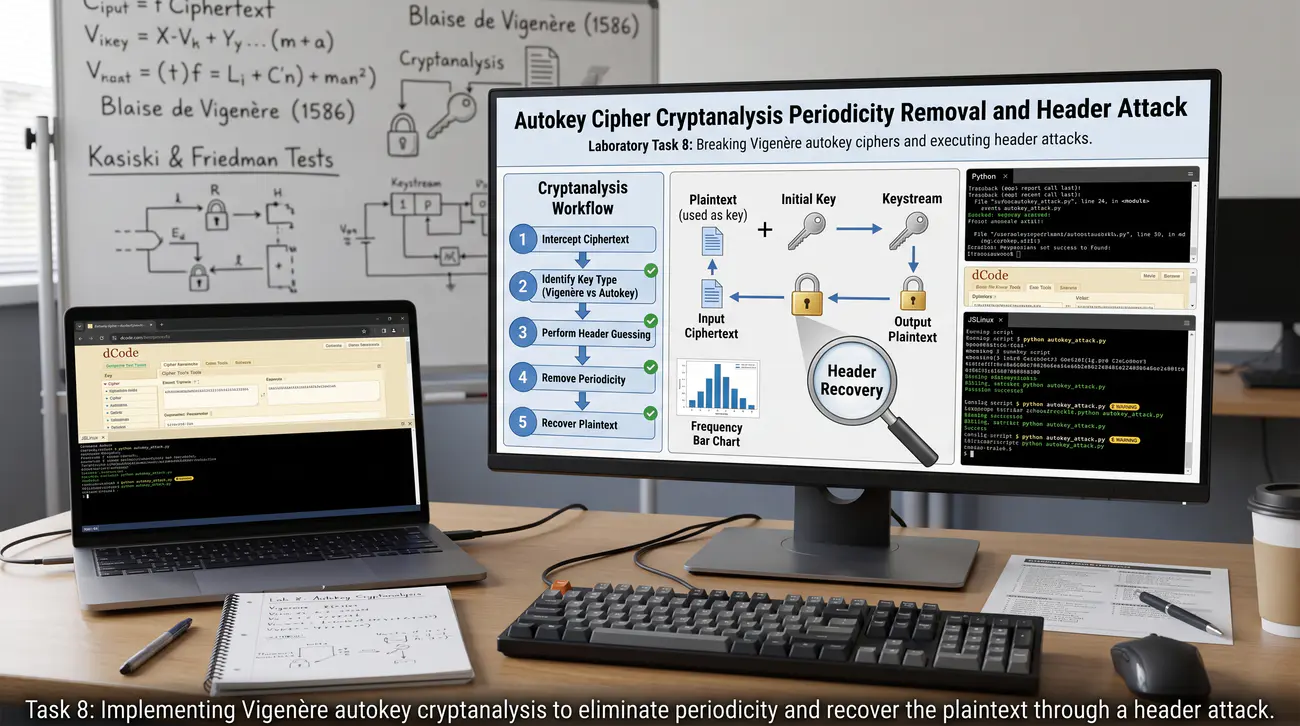
Zadanie 8. Kryptoanaliza szyfru autokluczowego (Autokey Cipher) – likwidacja periodyczności i atak na nagłówek
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 15, 18, 41: szyfr autokluczowy Vigenère’a (Blaise de Vigenère, 1586), eliminacja periodyczności przez dołączenie tekstu jawnego do klucza, nieskuteczność metody Kasiskiego i testu Friedmana, kryptoanaliza ze znanym słowem początkowym (crib) i propagacja kaskadowa.

Cel

Celem zadania jest poznanie i przełamanie szyfru autokluczowego (Autokey Cipher), który powstał w celu wyeliminowania okresowości szyfru Vigenère’a. Student bada matematyczny mechanizm autoklucza, wykazuje eksperymentalnie nieskuteczność metody Kasiskiego i testu indeksu zbieżności, a następnie implementuje w Pythonie atak kaskadowy ze słowem domniemanym (crib-driven cascade attack), który po odgadnięciu pierwszego słowa odzyskuje cały tekst jawny litera po literze.

Scenariusz – opis

W tym zadaniu mierzysz się z rzeczywistym szyfrem Blaise'a de Vigenère’a z 1586 roku – szyfrem autokluczowym. Wbrew powszechnemu mitowi, Vigenère nie stworzył szyfru z krótkim powtarzanym hasłem, lecz genialny system autoklucza, w którym hasło używane jest tylko raz na początku, a resztę strumienia klucza tworzy sam tekst jawny. Uruchamiasz przeglądarkę internetową, otwierasz serwis dCode Autokey Cipher pod adresem dcode.fr/autokey-cipher oraz konsolę JSLinux Alpine. W serwisie dCode przygotowujesz polski tekst techniczny liczący 300 znaków i szyfrujesz go szyfrem autokluczowym z krótkim hasłem początkowym 'KLUCZ'. Zapisujesz otrzymany szyfrogram do pliku autokey_sample.txt w środowisku JSLinux.
Uwaga: w zależności od programu/systemu w jakim robisz zadanie trzeba ustalić alfabet w obszarze którego program prowadzi prace. Litera 'A', 'a', 'ą' mają różne kody, jeśli program wspiera tylko znaki ze standardowego zbioru ASCII to nie użyjesz np. 'ą' bo może być kodowany liczbą większą niż 255.

Co ma wykonać student / grupa

W pierwszym etapie testujesz na szyfrogramie metody poznane na wcześniejszych zajęciach: metodę Kasiskiego oraz test indeksu zbieżności Friedmana. W konsoli JSLinux uruchamiasz skrypt zliczający IC i ze zdumieniem stwierdzasz, że indeks zbieżności wynosi około 0.039 dla wszystkich testowanych przesunięć. Brak okresowości całkowicie neutralizuje metodę Kasiskiego i test Friedmana, ponieważ klucz nigdy się nie powtarza. Do przełamania autoklucza stosuje się technikę kaskadowej propagacji tekstu domniemanego (crib-driven cascade).

Jako analityk zakładasz prawdopodobne pierwsze słowo wiadomości (np. 'SZANOWNY', 'RAPORT' lub 'UWAGA'). Tworzysz w JSLinux plik autokey_cascade.py w języku Python. W szyfrze autokluczowym wzór szyfrowania ma postać: C_i = (P_i + K_i) mod 26 dla fazy hasła oraz C_i = (P_i + P_{i-L}) mod 26 dla fazy autoklucza. Oznacza to, że odgadnięcie tekstu jawnego na danej pozycji natychmiast ujawnia klucz na pozycji przesuniętej o długość hasła L.

Skrypt testuje słowo domniemane na początku tekstu, odgaduje litery tekstu jawnego i wykorzystuje je jako klucz do odszyfrowania kolejnych liter. Jeżeli początkowe założenie było poprawne, odzyskane litery tworzą czytelne słowa, które w następnym kroku kaskadowo odszyfrowują dalszy ciąg depeszy. W przypadku błędnego założenia kaskada natychmiast generuje bełkotliwy ciąg spółgłosek, co pozwala odrzucić fałszywy trop. Uruchamiasz program, testując słownik popularnych zwrotów początkowych, aż do uruchomienia poprawnej kaskady. Obserwujesz, jak cała 300-znakowa wiadomość zostaje odkodowana w jednej lawinowej reakcji łańcuchowej. Wykonujesz zrzuty ekranu kodu programu w JSLinux, wyjścia konsoli z efektem kaskadowym oraz weryfikacji w dCode.

Sporządzasz tabelę przedstawiającą matematyczny mechanizm propagacji tekstu jawnego w strumieniu klucza. Podsumowujesz ćwiczenie wnioskiem o kruchości systemów autokluczowych wobec ataku ze znanym nagłówkiem.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce stronę dcode.fr/autokey-cipher oraz konsolę JSLinux Alpine.
  2. Przygotuj polski tekst jawny o długości minimum 300 znaków.
  3. Zaszyfruj tekst w dCode szyfrem autokluczowym z hasłem początkowym (np. BAZA).
  4. Zapisz szyfrogram w pliku autokey_sample.txt w JSLinux.
  5. Uruchom test indeksu zbieżności Friedmana na szyfrogramie i potwierdź brak pików okresowości.
  6. Uruchom test Kasiskiego i wykaż brak regularnych powtórzeń interwałowych.
  7. Stwórz w JSLinux plik autokey_cascade.py w języku Python.
  8. Zaimplementuj funkcję sprawdzającą kaskadę dla zadanego słowa początkowego (crib) i długości hasła L.
  9. Napisz wzór odzyskiwania: P[i] = (C[ i] - P[i - L]) % 26.
  10. Zaimplementuj filtr leksykalny weryfikujący czytelność kolejnych wyrazów kaskady.
  11. Zbuduj pętlę testującą bibliotekę 20 popularnych słów otwarcia oraz długości L od 3 do 8. Bibliotekę zaczynaj od formuł kancelaryjnych i nagłówkowych (SZANOWNY, RAPORT, UWAGA, PROTOKOL, DECYZJA, MELDUNEK, WNIOSEK), nazw miesięcy i słów WSTEP / ROZDZIAL / ZALACZNIK; jeżeli żaden crib nie zapali kaskady, najpierw rozszerz bibliotekę o słownictwo z domniemanej tematyki depeszy, a dopiero potem wątp w poprawność kodu - chybiony crib blokuje cały atak dokładnie tak samo jak błąd programu.
  12. Uruchom skrypt i zlokalizuj właściwe słowo inicjujące lawinowe odszyfrowanie.
  13. Odczytaj pełną treść depeszy oraz pierwotne hasło startowe.
  14. Zweryfikuj zgodność odzyskanego tekstu w serwisie dCode.
  15. Wykonaj zrzuty ekranu kodu źródłowego, terminala z kaskadą oraz wyników testu IC.
  16. Opracuj raport dokumentujący mechanizm autoklucza i analizę podatności łańcuchowej.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak kaskadowy na autokey na wektorze ze startera: po odgadnięciu nagłówka rozwinięto kaskadę i odzyskano całość mimo braku periodyczności.
  2. Wykazano różnicę: weryfikator podatny (znany nagłówek — pełna kaskada) vs kontrola (błędny nagłówek — kaskada śmieci po 1 literze); dołączono log kaskady.
  3. Dołączono log ataku (nagłówek, kolejne litery kaskady) + kod łatki (autokey z szyfrogramu / strumień z nonce — brak zależności jawnej).
  4. Opisano w 3–5 zdaniach kompromis: eliminacja periodyczności vs samopodszywająca się kaskada, czułość na 1 literę, lekcja Kasiski→Friedman→kaskada.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego szyfr autokluczowy skutecznie eliminuje periodyczność i paraliżuje metody Kasiskiego i Friedmana.
  • W jaki sposób zależność klucza od tekstu jawnego tworzy kaskadową podatność na atak ze znanym nagłówkiem.
  • Jakie znaczenie ma błąd odgadnięcia pojedynczej litery dla załamania całej kaskady deszyfrującej.
  • Student potrafi przeprowadzić atak kaskadowy na szyfr autokluczowy w języku Python i odzyskać pełną treść wiadomości.
Zadanie 8 - ilustracja
09/10
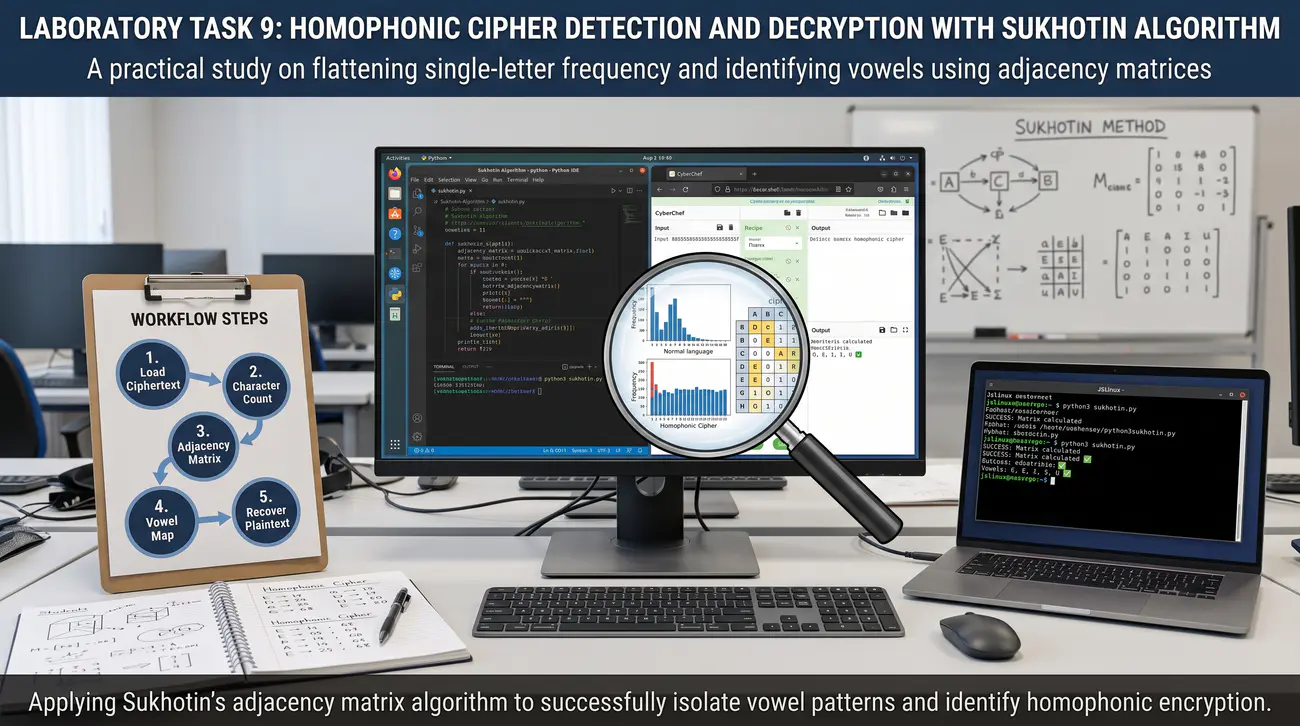
Zadanie 9. Detekcja i kryptoanaliza szyfru homofonicznego z wykorzystaniem algorytmu Sukhotina
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + dCode + Python 3
Podstawa wykładowa: Część 2 - slajdy 5, 12, 13: szyfr homofoniczny (przypisanie wielu symboli częstym literom w celu spłaszczenia histogramu jednoliterowego), ograniczenia kryptoanalizy częstości, algorytm Borysa Sukhotina (1973) do automatycznej identyfikacji samogłosek na bazie symetrycznej macierzy digramów.

Cel

Celem zadania jest zbadanie mechanizmu szyfru homofonicznego oraz przełamanie jego zabezpieczeń za pomocą zaawansowanego lingwistycznego algorytmu Sukhotina. Student implementuje w Pythonie szyfr homofoniczny spłaszczający histogram jednoliterowy do poziomu płaskiego rozkładu, weryfikuje nieskuteczność prostej analizy częstości, a następnie tworzy program realizujący algorytm Sukhotina, który na bazie symetrycznej macierzy sąsiedztwa digramów bezbłędnie identyfikuje samogłoski ukryte pod różnymi symbolami.

Scenariusz – opis

W tym zadaniu mierzysz się z szyfrem homofonicznym, zaprojektowanym w celu oszukania klasycznej analizy częstotliwości. W szyfrze homofonicznym rzadkie litery otrzymują jeden symbol szyfru, natomiast litery częste (np. samogłoski A, E, O, I) otrzymują wiele równoważnych symboli losowanych w trakcie szyfrowania. Dzięki temu histogram jednoliterowy szyfrogramu staje się idealnie płaski, uniemożliwiając rozpoznanie liter po słupkach frekwencji. Uruchamiasz przeglądarkę internetową, otwierasz serwis dCode Homophonic Substitution pod adresem dcode.fr/homophonic-cipher oraz konsolę JSLinux Alpine. W konsoli JSLinux tworzysz plik homophonic_system.py w języku Python.

Co ma wykonać student / grupa

Projektujesz tabelę podstawień homofonicznych dla języka polskiego, gdzie zbiorem symboli wyjściowych są liczby dwucyfrowe od 00 do 99. Literom najczęstszym (A, E, O, I) przypisujesz po 8-10 różnych liczb, literom średnim po 3-4 liczby, a literom rzadkim po 1 liczbie. Szyfrujesz polski tekst techniczny o długości 600 znaków, losując przy każdym wystąpieniu litery jeden z jej dozwolonych homofonów. Generujesz histogram symboli w wyjściowym szyfrogramie i potwierdzasz, że żaden symbol nie wykazuje dominacji – rozkład jest sztucznie spłaszczony.

Do przełamania tej ochrony wykorzystasz algorytm radzieckiego lingwisty Borysa Sukhotina z 1973 roku. Sukhotin zaobserwował uniwersalne prawo języków naturalnych: samogłoski rzadko sąsiadują bezpośrednio ze sobą, natomiast bardzo często sąsiadują ze spółgłoskami. Tworzysz w JSLinux plik sukhotin_vowels.py implementujący ten algorytm. Program buduje macierz sąsiedztwa digramów M, w której komórka M[x][y] zlicza liczbę przypadków, gdy symbol x sąsiaduje z symbolem y. Algorytm Sukhotina oblicza sumy brzegowe dla każdego symbolu, wybiera kandydata o najwyższej sumie sąsiedztwa i oznacza go jako samogłoskę.

Następnie w kolejnych iteracjach odejmuje dwukrotność wzajemnych powiązań od pozostałych symboli i wyłania kolejne samogłoski. Uruchamiasz program na swoim szyfrogramie homofonicznym. Z zachwytem obserwujesz, jak algorytm krok po kroku grupuje różne liczby dwucyfrowe i bezbłędnie przyporządkowuje je do wspólnej klasy samogłosek. Mając zidentyfikowane zbiory samogłosek, odtwarzasz szkielet spółgłoskowo-samogłoskowy tekstu (tzw. CV-pattern) i deszyfrujesz treść. Wykonujesz zrzuty ekranu kodu programu w JSLinux, płaskiego histogramu homofonów oraz macierzy Sukhotina. Sporządzasz sprawozdanie techniczne opisujące matematyczne podstawy algorytmu Sukhotina i granice obrony homofonicznej. Upewniasz się, że wszystkie kroki zostały starannie udokumentowane.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis dCode Homophonic Substitution oraz konsolę JSLinux Alpine.
  2. Przygotuj polski tekst techniczny o długości minimum 600 znaków.
  3. Zanim napiszesz kod, wykonaj na kartce mikro-przykład budujący intuicję macierzy Sukhotina: tekst ALAMAKOTA (zdanie ALA MA KOTA bez spacji), homofony A→{11, 12}, L→{21}, M→{22}, K→{23}, O→{31, 32}, T→{33}; zaszyfruj, losując homofon przy każdym wystąpieniu litery (np. 11 21 12 22 11 23 31 33 12), a potem wskaż, które pary symboli nigdy ze sobą nie sąsiadują - to unikanie samogłosek jest dokładnie tym, co algorytm wykrywa w dużej macierzy.
  4. W JSLinux stwórz plik homophonic_system.py definiujący podział 100 liczb na litery polskie.
  5. Zaimplementuj losowy wybór homofonu przy szyfrowaniu każdej litery.
  6. Zaszyfruj tekst i wygeneruj wykres częstości symboli w konsoli lub CyberChef.
  7. Potwierdź empirycznie skuteczne spłaszczenie histogramu jednoliterowego.
  8. Stwórz w JSLinux plik sukhotin_vowels.py implementujący algorytm Sukhotina.
  9. Zbuduj symetryczną macierz sąsiedztwa digramów 100x100 dla badanego tekstu.
  10. Zaimplementuj obliczanie wag początkowych: sum(M[ x][y] for y in symbols).
  11. Napisz pętlę iteracyjną wyłaniającą symbole samogłosek z aktualizacją wag.
  12. Uruchom skrypt: python3 sukhotin_vowels.py szyfrogram_homofoniczny.txt.
  13. Przeanalizuj wyodrębnioną grupę symboli i porównaj ją z rzeczywistymi homofonami samogłosek.
  14. Oceń precyzję i czułość klasyfikacji algorytmu Sukhotina.
  15. Wykorzystaj wzorzec samogłosek do odtworzenia pierwotnego tekstu jawnego.
  16. Wykonaj zrzuty ekranu kodu, histogramu oraz macierzy sąsiedztwa w konsoli.
  17. Opracuj raport laboratoryjny dokumentujący lingwistyczne techniki łamania homofonów.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak Sukhotina na wektorze ze startera: z szyfru homofonicznego (płaski histogram) wyodrębniono klasę samogłosek samą analizą styków.
  2. Wykazano różnicę: weryfikator podatny (tekst naturalny — samogłoski wyraźnie odstają łączliwością) vs kontrola (tekst losowy — brak podziału); dołączono graf styków i ranking.
  3. Dołączono log ataku (macierz styków, iteracje Sukhotina, lista samogłosek) + kod łatki (homofony + frakcjonowanie / nulle — zatarcie fonotaktyki).
  4. Opisano w 3–5 zdaniach kompromis: spłaszczenie histogramu vs przeciek dwuznakowy, uniwersalność samogłosek, koszt strojenia homofonów.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób rozpraszanie liter na wiele homofonów neutralizuje tradycyjną analizę częstotliwości jednoliterowej.
  • Na jakiej uniwersalnej własności fonotaktycznej języka naturalnego opiera się algorytm Sukhotina.
  • Dlaczego zbadanie powiązań dwuznakowych pozwala zidentyfikować klasę samogłosek mimo ukrycia tożsamości liter.
  • Student potrafi zaimplementować szyfr homofoniczny oraz algorytm Sukhotina do detekcji samogłosek w Pythonie.
Zadanie 9 - ilustracja
10/10
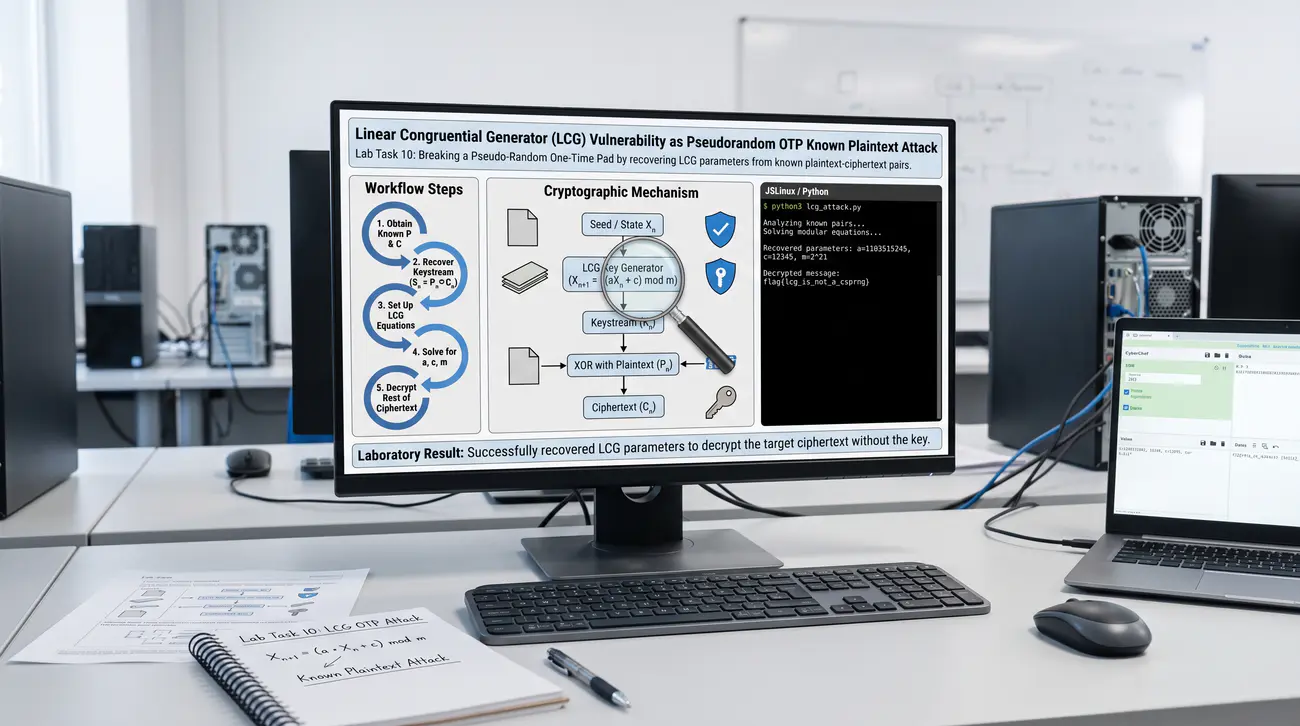
Zadanie 10. Podatność liniowego generatora kongruentnego (LCG) jako pseudolosowego OTP – atak ze znanym tekstem jawnym
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 2 - slajdy 36, 37, 41: próby automatyzacji OTP za pomocą generatorów pseudolosowych (PRNG), liniowy generator kongruentny LCG X_{n+1} = (a*X_n + c) mod m, atak kryptoanalityczny ze znanym tekstem jawnym (Known-Plaintext Attack), wyznaczanie stanu i odzyskiwanie całego strumienia.

Cel

Celem zadania jest zbadanie fundamentalnej różnicy pomiędzy idealnym szyfrem jednorazowym (OTP) a naiwnym szyfrem strumieniowym opartym na generatorze pseudolosowym LCG. Student implementuje w Pythonie szyfr strumieniowy XOR zasilany generatorem LCG, przeprowadza atak typu Known-Plaintext Attack przy znajomości zaledwie kilku bajtów nagłówka depeszy, rozwiązuje algebraiczny układ równań wyznaczający stan i parametry generatora, a następnie odszyfrowuje całą resztę wiadomości bez znajomości klucza początkowego.

Scenariusz – opis

W ostatnim zadaniu zestawu badasz historyczną pułapkę, w którą wpadło wielu projektantów systemów łączności: próbę zastąpienia prawdziwego OTP generatorem pseudolosowym. Prawdziwy OTP wymaga klucza idealnie losowego o długości równej wiadomości, co stwarza gigantyczne problemy logistyczne. Inżynierowie próbowali przesyłać jedynie krótkie ziarno (seed), z którego algorytm LCG generował pseudolosowy ciąg kluczowy. Liniowy generator kongruentny (LCG) opisany jest wzorem rekurencyjnym: X_{n+1} = (a * X_n + c) mod m. Uruchamiasz przeglądarkę internetową, otwierasz konsolę JSLinux Alpine oraz serwis CyberChef.

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz plik lcg_cipher.py w języku Python. Definiujesz parametry generatora LCG: moduł m = 256 (dla operacji na bajtach), mnożnik a = 137, przyrost c = 187 oraz tajne ziarno seed = 42. Generator wytwarza pseudolosowy strumień bajtów, który jest łączony z polskim komunikatem jawnym o długości 200 znaków za pomocą operacji bitowej XOR. Zapisujesz wygenerowany szyfrogram do pliku lcg_stream.bin w środowisku JSLinux.

Wcielasz się w rolę kryptoanalityka, który przechwycił ten szyfrogram i wie z formatu pliku lub protokołu, że pierwsze 4 bajty tekstu jawnego to słowo 'POST' (tzw. znany tekst jawny / Known-Plaintext). Tworzysz w JSLinux program lcg_cracker.py w języku Python. Ze znajomości pierwszych 4 bajtów tekstu jawnego M[0..3] oraz szyfrogramu C[0..3] program natychmiast wylicza pierwsze 4 stany generatora: X_i = C_i XOR M_i. Mając stany X_0, X_1, X_2 oraz X_3, program układa układ równań modularnych: X_2 - X_1 = a * (X_1 - X_0) mod 256. Wykorzystując arytmetykę modularną i rozszerzony algorytm Euklidesa, program wyznacza mnożnik a.

Następnie z równania c = (X_1 - a * X_0) mod 256 program bezbłędnie oblicza przyrost c. Mając odtworzone parametry a, c oraz aktualny stan X_3, program generuje w nieskończoność dalszy ciąg pseudolosowy i odszyfrowuje całą pozostałą treść wiadomości. Uruchamiasz program lcg_cracker.py w konsoli JSLinux i obserwujesz natychmiastowe odzyskanie parametrów generatora oraz pełnego tekstu jawnego. Porównujesz odzyskane parametry z tajną konfiguracją z lcg_cipher.py, potwierdzając ich całkowitą tożsamość. Wykonujesz zrzuty ekranu kodu programu szyfrującego, skryptu kryptoanalitycznego oraz terminala z odtworzonym tekstem. Sporządzasz tabelę zestawiającą kryptograficzne generatory liczb losowych (CSPRNG) z generatorami deterministycznymi (LCG). Podsumowujesz zadanie wnioskiem wyjaśniającym, dlaczego generatory liniowe są całkowicie nieprzydatne w kryptografii.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom środowisko JSLinux Alpine z interpreterem python3.
  2. Przeanalizuj wzór matematyczny liniowego generatora kongruentnego LCG.
  3. Stwórz w JSLinux plik lcg_cipher.py realizujący szyfrowanie XOR ze strumieniem LCG.
  4. Skonfiguruj parametry: m=256, a=137, c=187, seed=42 i zaszyfruj tekst 200-znakowy.
  5. Zapisz szyfrogram w pliku lcg_stream.bin.
  6. Zdefiniuj założenie ataku: pierwsze 4 bajty tekstu jawnego są znane (np. 'POST').
  7. Stwórz w JSLinux plik lcg_cracker.py w edytorze nano.
  8. Wylicz pierwsze 4 stany generatora: X = [c ^ m for c, m in zip(C[:4], M_known)].
  9. Sformułuj równanie dla mnożnika a: (X2 - X1) = a * (X1 - X0) mod 256.
  10. Zaimplementuj rozwiązanie kongruencji i wyznacz parametr a.
  11. Wylicz przyrost c = (X1 - a * X0) % 256.
  12. Uruchom generator LCG ze stanu X[3] i wygeneruj brakujące 196 bajtów klucza.
  13. Odszyfruj pozostałą część szyfrogramu: M_rest = C[4:] XOR Key_rest.
  14. Wyświetl w terminalu odzyskane parametry a, c oraz pełny tekst jawny.
  15. Wykonaj zrzuty ekranu kodu źródłowego oraz demonstracji ataku w konsoli.
  16. Sformułuj raport laboratoryjny wyjaśniający kryteria bezpieczeństwa generatorów CSPRNG.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak known-plaintext na LCG na wektorze ze startera: z 4 znanych bajtów odtworzono stan (a,c,m) i przewidziano cały strumień OTP.
  2. Wykazano różnicę: weryfikator podatny (LCG — pełna przewidywalność po 4 bajtach) vs poprawiony (CSPRNG/os.urandom — brak ekstrapolacji); dołączono logi predykcji.
  3. Dołączono log ataku (odzyskany stan, wygenerowany strumień, odszyfrowany tekst) + kod łatki (CSPRNG + nonce, zakaz LCG do kryptografii).
  4. Opisano w 3–5 zdaniach kompromis: szybkość/testy NIST vs nieprzewidywalność, 4 bajty wystarczą przez liniowość, koszt audytu generatora.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; symulator Enigmy/CyberChef zastąp logiem skryptu; do sprawozdania dołącz kod ataku, log odzyskanych tekstów oraz opis kompromisu bezpieczeństwo/wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego deterministyczny generator pseudolosowy LCG nie spełnia warunków twierdzenia Shannona o OTP.
  • W jaki sposób znajomość zaledwie 4 bajtów tekstu jawnego pozwala odtworzyć pełny stan wewnętrzny LCG.
  • Czym różni się statystyczna losowość (np. testy NIST) od kryptograficznej nieprzewidywalności (CSPRNG).
  • Student potrafi przeprowadzić skuteczny Known-Plaintext Attack na generator LCG w języku Python.
Zadanie 10 - ilustracja
Podgląd