Laboratorium 3
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 4.0

Poziom: ocena 4.0 - programistyczna i statystyczna analiza w środowisku Linux / Python

Zestaw 10 zaawansowanych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 3 (kryptografia symetryczna - nowoczesne algorytmy i funkcje skrótu).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 4.0 wymagają łączenia analizy teoretycznej z pisaniem i uruchamianiem autorskich skryptów w języku Python w środowisku konsolowym emulatora JSLinux Alpine (lub lokalnym interpreterze) oraz zaawansowanym posługiwaniem się narzędziami OpenSSL.
  • Zakres zadań obejmuje m.in.: skryptową analizę propagacji błędów w trybach blokowych, atak bit-flipping na tryb CTR, modelowanie 4 transformacji rundy AES na wektorach FIPS 197, implementację procedury rozszerzania klucza AES Key Expansion, konstrukcję operacji Quarter Round ChaCha20 w architekturze ARX, statystyczny pomiar spełnienia kryterium SAC dla MD5/SHA-1/SHA-256, demonstrację ataku Length Extension na SHA-256, empiryczne badanie paradoksu dnia urodzin w przestrzeniach zredukowanych, benchmark openssl speed oraz implementację ataku słownikowego z solą na KDF PBKDF2.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (4.0).
    • Opis konfiguracji środowiska badawczego, wersji interpretera Python oraz wykorzystanych narzędzi internetowych i bibliotek.
    • Pełny kod źródłowy opracowanych skryptów w języku Python opatrzony komentarzami technicznymi.
    • Opis procesu badawczego: zrzuty ekranu konsoli i wygenerowane tabele wyników, obliczone statystyki i wykazane zależności kryptoanalityczne.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami) oraz bibliografia techniczna i źródła internetowe.
Kryptologia
lab 3 - 4.0
Spis
Spis zadań laboratoryjnych na ocenę 4.0
01/10
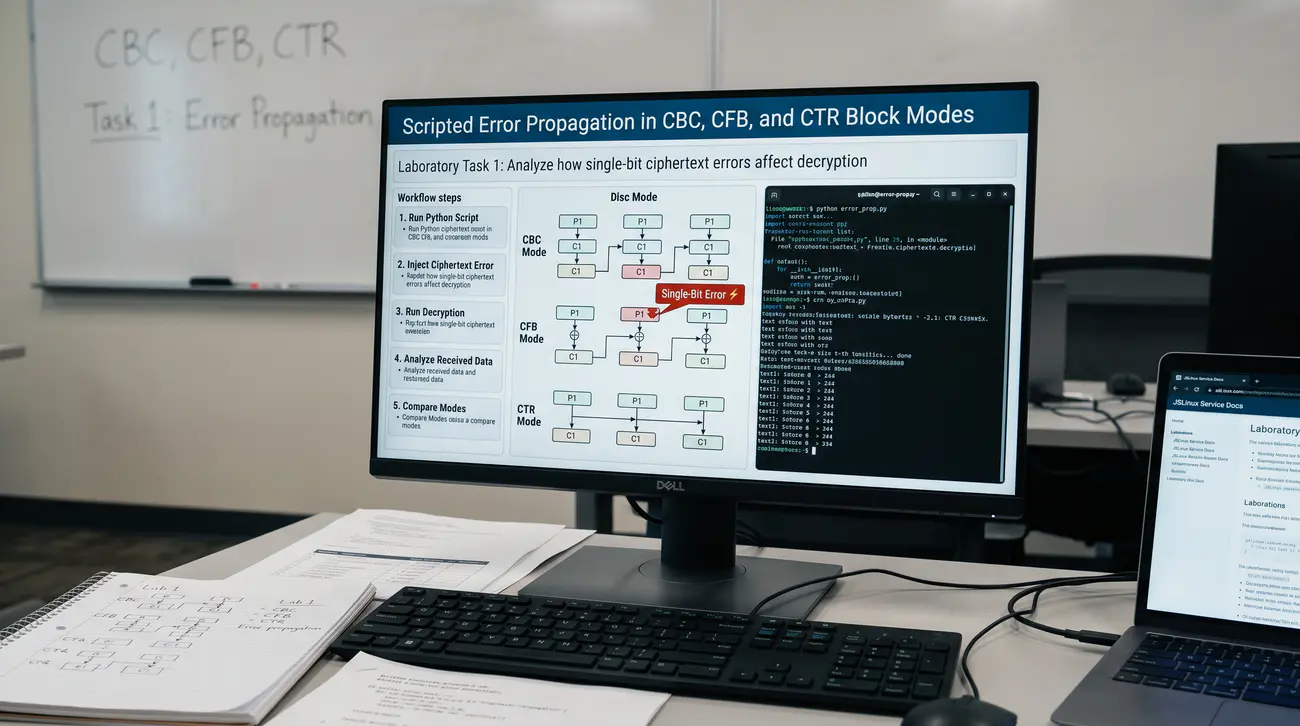
Zadanie 1. Skryptowa analiza propagacji błędów w trybach blokowych CBC, CFB i CTR w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 3 - slajdy 21, 23, 24, 26: tryby pracy szyfrów blokowych, CBC (Cipher Block Chaining), CFB (Cipher Feedback), CTR (Counter), propagacja błędów transmisji, uszkodzenie bitu szyfrogramu.

Cel

Celem zadania jest zbadanie mechanizmu propagacji błędów w trybach pracy szyfrów blokowych przy użyciu skryptu w języku Python w środowisku konsolowym Linux. Student analizuje, w jaki sposób przekłamanie pojedynczego bitu w szyfrogramie niszczy dane w trybie CBC, jak propaguje się w trybie CFB oraz dlaczego tryb CTR wykazuje całkowity brak propagacji błędu.

Scenariusz – opis

W rzeczywistych kanałach telekomunikacyjnych transmitowane dane są narażone na zakłócenia, w wyniku których pojedyncze bity szyfrogramu ulegają przekłamaniu. Wpływ takiego błędu na odszyfrowany tekst jawny zależy fundamentalnie od wybranego trybu pracy szyfru blokowego. W trybie CBC odwrócenie jednego bitu w bloku C_n powoduje całkowite zniszczenie (losowy szum) bloku P_n oraz przekłamanie dokładnie odpowiadającego bitu w bloku P_(n+1). W trybie strumieniowym CTR odwrócenie bitu w szyfrogramie powoduje przekłamanie wyłącznie jednego, odpowiadającego mu bitu tekstu jawnego. W tym ćwiczeniu przygotujesz program w języku Python w terminalu JSLinux Alpine, który dokona automatycznej analizy propagacji błędów na spreparowanych danych. Jako podstawowy algorytm szyfrujący wykorzystasz AES-128 z biblioteki standardowej lub modułu kryptograficznego.

Co ma wykonać student / grupa

Otwierasz terminal emulatora JSLinux Alpine i uruchamiasz interpreter Python 3. Tworzysz trójblokowy komunikat tekstowy o długości dokładnie 48 bajtów (trzy 16-bajtowe bloki AES), na przykład 'BLOK_PIERWSZY___BLOK_DRUGI______BLOK_TRZECI_____'. W skrypcie Pythona implementujesz funkcję szyfrującą dane w trybie CBC z ustalonym kluczem i wektorem IV.

Następnie w wygenerowanym szyfrogramie celowo odwracasz 5. bit w drugim bloku szyfrogramu (czyli bajt o indeksie 20). Odszyfrowujesz zmodyfikowany szyfrogram i porównujesz otrzymany tekst z pierwotnym tekstem jawnym bajt po bajcie. Rejestrujesz liczbę uszkodzonych bajtów w bloku 1 (0 błędów), bloku 2 (pełna dezintegracja, około 16 zmienionych bajtów) oraz bloku 3 (dokładnie jeden uszkodzony bajt).

W kolejnym kroku powtarzasz procedurę dla trybu CTR: szyfrujesz ten sam komunikat i odwracasz ten sam bit w szyfrogramie. Po odszyfrowaniu sprawdzasz błędy i potwierdzasz, że uszkodzeniu uległ wyłącznie jeden bit w bloku drugim, a cała reszta danych pozostała nienaruszona. Implementujesz funkcję wizualizującą macierz różnic bitowych w konsoli za pomocą znaków graficznych. Testujesz również zachowanie trybu CFB (Cipher Feedback) i dokumentujesz jego właściwość samo-synchronizacji po przesunięciu rejestru.

Przeprowadzasz serię testów z błędami wielobitowymi oraz utratą bajtu (błąd synchronizacji ramki). Analizujesz, dlaczego w protokołach przesyłających strumienie audio/wideo tryb CTR jest bardziej tolerancyjny na zakłócenia niż CBC. Sporządzasz tabelę porównawczą propagacji błędów dla trybów ECB, CBC, CFB, OFB i CTR.

Wykonujesz zrzuty ekranu prezentujące kod programu w Pythonie oraz wygenerowaną mapę błędów w konsoli JSLinux. Weryfikujesz poprawność obliczeń statystycznych odległości Hamminga dla zdeszyfrowanych bloków. Kompletujesz raport laboratoryjny z techniczną interpretacją zjawiska samosynchronizacji.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine (bellard.org/jslinux/vm.html?cpu=x86_64&url=alpine-x86_64.cfg&mem=256).
  2. Uruchom edytor tekstu (nano lub vi) i utwórz plik skryptu: nano error_prop.py.
  3. Zaimplementuj w Pythonie prostą obsługę szyfrowania AES lub wykorzystaj moduł openssl przez subprocess.
  4. Zdefiniuj wiadomość o długości 48 bajtów podzieloną na trzy czytelne bloki po 16 bajtów.
  5. Zaszyfruj wiadomość w trybie CBC przy użyciu stałego klucza i wektora IV.
  6. Wprowadź funkcję modyfikującą k-ty bit w zadanym bajcie szyfrogramu: data[idx] ^= (1 << bit).
  7. Zmodyfikuj bit w bloku drugim (bajt 20, bit 3) i odszyfruj zmodyfikowany szyfrogram.
  8. Oblicz odległość Hamminga między oryginalnym a zdeszyfrowanym tekstem dla każdego z trzech bloków z osobna.
  9. Wypisz w konsoli zdeszyfrowane bloki w formacie hex oraz ascii, uwypuklając uszkodzenia.
  10. Zaimplementuj analogiczne szyfrowanie i modyfikację bitu dla trybu CTR.
  11. Odszyfruj dane w trybie CTR i wykaż, że błąd ograniczył się wyłącznie do jednego bitu.
  12. Zbadaj zachowanie trybu CFB-128 i odnotuj propagację błędu na kolejny blok.
  13. Przetestuj skutki usunięcia jednego bajtu ze środka szyfrogramu (desynchronizacja blokowa).
  14. Zapisz wyniki pomiarów do tabeli: Tryb, Blok uszkodzony, Blok następny, Łączna liczba błędnych bitów.
  15. Wykonaj zrzuty ekranu z działania programu w konsoli JSLinux.
  16. Sformułuj techniczne wnioski podsumowujące przydatność poszczególnych trybów w kanałach o różnej stopie błędów (BER).
  17. Dopisz do wniosków obowiązkowe zdanie rozbrajające pułapkę: „Brak propagacji błędu w CTR nie jest zaletą bezpieczeństwa - ten sam brak propagacji umożliwia cichy atak bit-flipping bez wykrycia (dowód: Zadanie 2)". Sam pomiar BER bez tego zdania jest niezaliczony.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log/mapę błędów: 1 przekłamany bit szyfrogramu → CBC: cały blok n + 1 bit w n+1; CTR: tylko ten bit; CFB: zgodnie z teorią.
  2. Dołączono kod (własne min. 25 linii): symulator CBC/CFB/CTR, wstrzykiwanie błędu, tabela P_n = D(C_n)⊕C_{n-1}.
  3. Przeprowadzono test pozytywny (błąd w bloku 1 — pełna destrukcja) i negatywny (błąd w IV — tylko blok 1 w CBC, sygnalizowany).
  4. Opisano w 3–5 zdaniach: matematyka propagacji, brak sprzężenia w CTR, wnioski dla FEC/sum kontrolnych.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób zależność matematyczna P_n = D_K(C_n) XOR C_(n-1) w CBC tłumaczy całkowite zniszczenie bloku n i pojedynczy błąd w bloku n+1.
  • Dlaczego brak sprzężenia zwrotnego szyfrogramu w trybie CTR ogranicza błąd ściśle do pozycji przekłamanego bitu.
  • Jak zjawisko propagacji błędu wpływa na projektowanie sum kontrolnych i kodów korekcyjnych (FEC) w warstwie łącza danych.
  • Student potrafi napisać program w Pythonie modelujący uszkodzenia bitowe i zinterpretować mapę błędów dla różnych trybów pracy.
Zadanie 1 - ilustracja
02/10
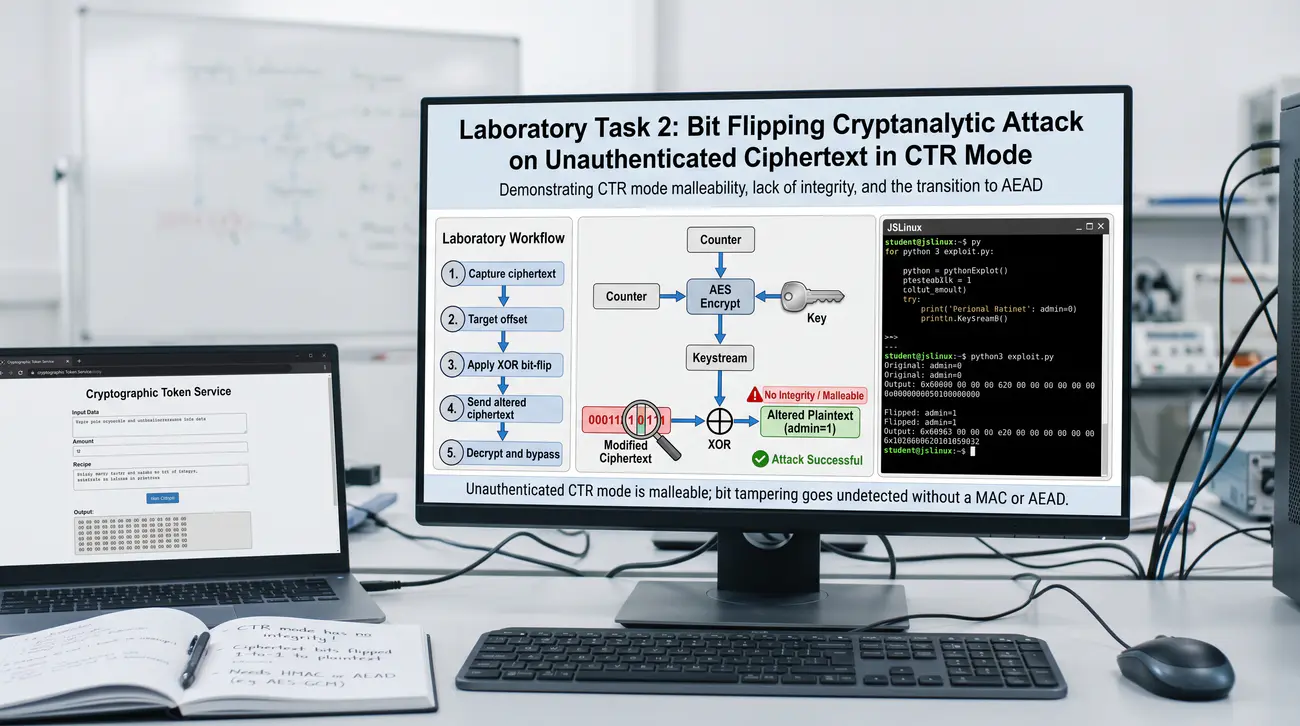
Zadanie 2. Kryptoanalityczny atak bit-flipping na nieautoryzowany szyfrogram w trybie CTR
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 3 - slajdy 24, 25, 26: podatność trybu CTR na manipulację bitową (malleability), brak integralności, konieczność warstwy MAC, przejście do AEAD.

Cel

Celem zadania jest praktyczna demonstracja ataku manipulacji bitowej (Bit-Flipping Attack) na szyfrogram w trybie CTR bez znajomości klucza tajnego oraz wykazanie, dlaczego sama poufność bez mechanizmów autentyczności (MAC/AEAD) nie zapewnia bezpieczeństwa danych.

Scenariusz – opis

Częstym złudzeniem w projektowaniu systemów IT jest przekonanie, że silne szyfrowanie (np. AES-256) chroni dane przed jakąkolwiek manipulacją. W trybach strumieniowych, takich jak CTR, deszyfrowanie polega na wykonaniu operacji P[i] = C[i] XOR K[i]. Jeśli atakujący zna lub domyśla się treści tekstu jawnego na określonych pozycjach, może precyzyjnie zmodyfikować odszyfrowany tekst bez znajomości klucza K. Wystarczy obliczyć nowy bajt szyfrogramu według wzoru: C'[i] = C[i] XOR P_stare[i] XOR P_nowe[i]. Gdy odbiorca odszyfruje tak spreparowany szyfrogram, otrzyma żądaną przez atakującego treść P_nowe bez wywołania jakiegokolwiek błędu deszyfrowania. W tym laboratorium zaimplementujesz ten atak w Pythonie w JSLinux i porównasz go z zachowaniem trybu uwierzytelnionego AES-GCM.

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz skrypt symulujący komunikację bankową pomiędzy klientem a serwerem. Klient generuje komunikat przelewu: 'PRZELEW: ID=10492; KWOTA=00100_PLN; ODBIORCA=PL9810200000; STATUS=OK'. Komunikat jest szyfrowany algorytmem AES-128 w trybie CTR za pomocą losowego klucza, który zna wyłącznie klient i serwer. Jako atakujący Man-in-the-Middle przechwytujesz zaszyfrowany pakiet danych przesyłany przez sieć.

Wiesz z dokumentacji protokołu, że pole kwoty znajduje się na stałej pozycji w komunikacie i ma format '00100_PLN'. W Pythonie piszesz moduł kryptoanalityczny, który lokalizuje indeksy bajtów odpowiadające kwocie w szyfrogramie. Aplikujesz przekształcenie bit-flipping: C'[i] = C[i] XOR ord('0') XOR ord('9'), zamieniając kwotę 00100 na 99100 PLN. Przekazujesz zmodyfikowany szyfrogram do procedury serwera, który dokonuje deszyfrowania z oryginalnym kluczem. Serwer odczytuje sfałszowaną kwotę 99100 PLN i zatwierdza transakcję jako w pełni poprawną syntaktycznie.

Następnie w drugiej części zadania implementujesz tę samą procedurę z wykorzystaniem standardu AES-GCM. Powtarzasz modyfikację dokładnie tego samego bajtu w szyfrogramie GCM i przekazujesz pakiet do serwera. Obserwujesz, że serwer natychmiast wykrywa manipulację dzięki weryfikacji tagu GMAC i odrzuca całą transakcję z błędem bezpieczeństwa. Analizujesz konsekwencje podatności plastyczności (ang. malleability) w protokołach sieciowych pozbawionych warstwy MAC. Sporządzasz zestawienie matematyczne operacji XOR dowodzące poprawności ataku bit-flipping.

Wykonujesz zrzuty ekranu prezentujące pomyślne sfałszowanie transakcji w CTR oraz odrzucenie w GCM. Zapisujesz wnioski formalne do sprawozdania laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine w przeglądarce.
  2. Utwórz plik skryptu: nano bit_flip_attack.py.
  3. Napisz funkcję szyfrującą tekst algorytmem AES w trybie CTR z użyciem narzędzia openssl lub czystego Pythona.
  4. Zdefiniuj wiadomość transakcyjną z kwotą 00100_PLN i zaszyfruj ją do tablicy bajtów ciphertext.
  5. Zidentyfikuj indeks początkowy podciągu '00100' w tekście jawnym.
  6. Zaimplementuj funkcję ataku: zmodyfikuj bajty szyfrogramu zgodnie z regułą c_mod = c ^ ord(old_char) ^ ord(new_char).
  7. Zamień cyfry '00100' na '99100' w zaszyfrowanym strumieniu.
  8. Przeprowadź wariant drugi ze słabszą wiedzą: załóż, że znasz tylko format pola (5 cyfr, potem '_PLN'), ale nie jego wartość - pokaż, że ślepe przekręcenie bitów daje losową kwotę (atak działa), lecz celowana kwota '99999' wymaga pełnej znajomości pozycji i treści (granica ataku). Oba warianty (celowany i ślepy) trafiają do tabeli wyników.
  9. Zasymuluj deszyfrowanie zmodyfikowanego szyfrogramu przez serwer bankowy.
  10. Wypisz odszyfrowany tekst i potwierdź skuteczną modyfikację kwoty bez znajomości klucza.
  11. Zaimplementuj wariant systemu wykorzystujący szyfrowanie uwierzytelnione AES-GCM.
  12. Zaszyfruj oryginalny komunikat w trybie GCM, uzyskując szyfrogram oraz 16-bajtowy tag autoryzacyjny.
  13. Zastosuj ten sam wektor ataku bit-flipping na szyfrogramie GCM.
  14. Przekaż zmodyfikowane dane do deszyfrowania GCM i zarejestruj wyjątek odrzucenia tagu.
  15. Zapisz kody źródłowe obu eksperymentów i wykonaj zrzuty ekranu wyjścia konsoli.
  16. Sporządź diagram sekwencji obrazujący atak MitM na nieautoryzowany kanał CTR.
  17. Sformułuj wnioski techniczne dotyczące zasady 'zawsze stosuj uwierzytelnianie przy szyfrach strumieniowych'.

Kontrola zaliczenia (checklist):

  1. Uruchomiono atak i zachowano log: bez klucza zmieniono sens odszyfrowanej wiadomości (np. kwota/rozkaz) samym XOR delty w szyfrogramie CTR.
  2. Dołączono kod (własne min. 20 linii): funkcja flip(C, pozycja, delta) + demo deszyfrowania przed/po.
  3. Przeprowadzono test pozytywny (celowa zmiana działa) i negatywny (ten sam atak na AES-GCM — weryfikator odrzuca tag, atak wykryty).
  4. Opisano w 3–5 zdaniach: plastyczność XOR, kontrola wyjścia bez klucza, MAC/AEAD jako jedyna obrona.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego liniowość operacji XOR w trybie CTR czyni go w pełni plastycznym (malleable) na celowane modyfikacje.
  • W jaki sposób atakujący może kontrolować wyjście deszyfratora bez jakiejkolwiek wiedzy o kluczu tajnym.
  • Rola kodów uwierzytelniania wiadomości i schematów AEAD (AES-GCM) w natychmiastowym wykrywaniu ataków bit-flipping.
  • Student potrafi przeprowadzić skuteczny atak manipulacji bitowej w Pythonie oraz zademonstrować mechanizm obronny w AES-GCM.
Zadanie 2 - ilustracja
03/10
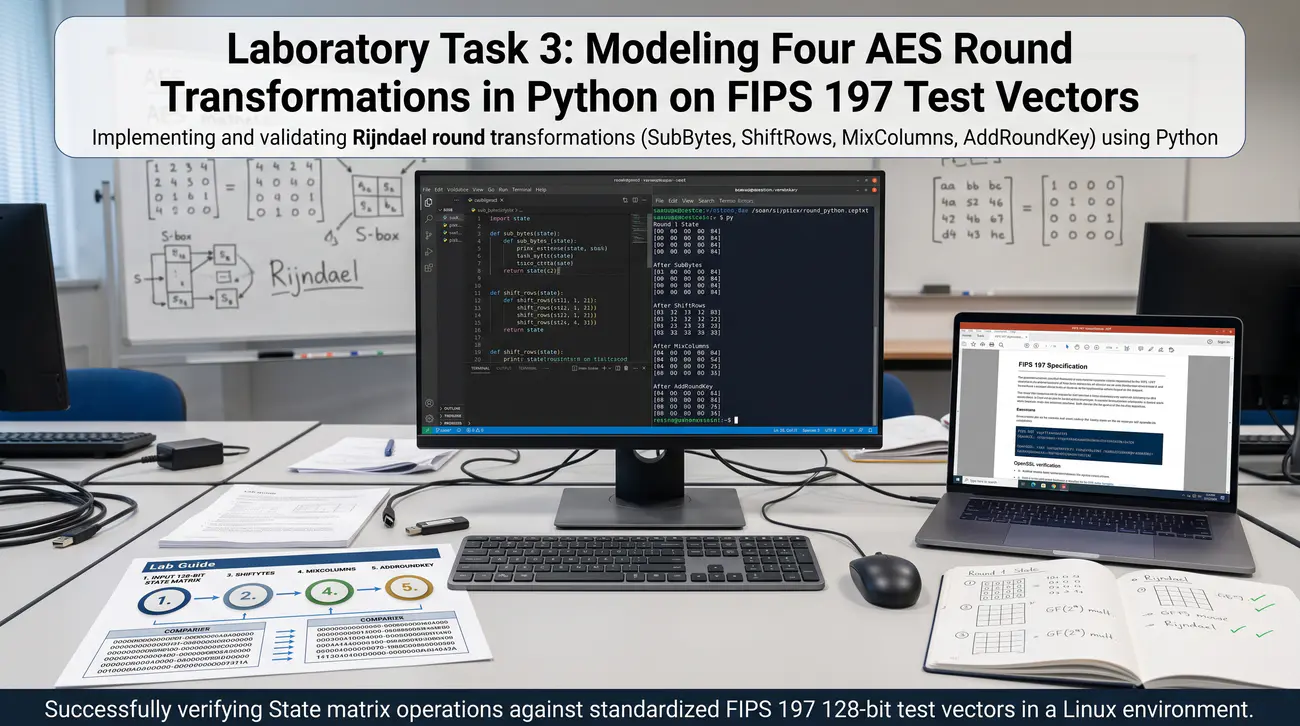
Zadanie 3. Modelowanie czterech transformacji rundy AES w Pythonie na oficjalnych wektorach FIPS 197
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 3 - slajdy 13, 14, 15, 16, 17, 18: AES (Rijndael), macierz stanu State 4x4, transformacja SubBytes (S-box w ciele GF(2^8)), ShiftRows, MixColumns (mnożenie wielomianowe), AddRoundKey.

Cel

Celem zadania jest dogłębne zrozumienie wewnętrznej mechaniki szyfru AES poprzez zaimplementowanie w języku Python czterech elementarnych operacji rundy: SubBytes, ShiftRows, MixColumns oraz AddRoundKey. Student weryfikuje poprawność implementacji krok po kroku na oficjalnym wektorze testowym ze standardu NIST FIPS 197.

Scenariusz – opis

Standard Advanced Encryption Standard (AES) opiera się na strukturze sieci podstawieniowo-permutacyjnej (SPN) operującej na 128-bitowej macierzy stanu State. Macierz stanu składa się z 16 bajtów ułożonych w tablicy o wymiarach 4x4, wypełnianej kolumnami. Każda runda standardowa AES składa się z czterech precyzyjnie zdefiniowanych przekształceń algebraicznych i geometrycznych. Są to: nieliniowa zamiana bajtów SubBytes za pomocą tabeli S-box, cykliczne przesunięcie wierszy ShiftRows, dyfuzja kolumnowa MixColumns w ciele Galois oraz dodanie podklucza AddRoundKey. W tym laboratorium zaimplementujesz w języku Python w konsoli JSLinux te cztery operacje od podstaw bez korzystania z gotowych bibliotek szyfrujących. Do walidacji poprawności kodu użyjesz oficjalnego wektora pośredniego z załącznika B standardu NIST FIPS 197.

Co ma wykonać student / grupa

W terminalu JSLinux otwierasz edytor i tworzysz plik programu aes_round.py. Definiujesz oficjalną 256-elementową tablicę podstawień S-box standardu AES w postaci tablicy liczb szesnastkowych. Tworzysz funkcję pomocniczą zamieniającą ciąg 16 bajtów na macierz stanu 4x4 oraz funkcję odwrotną wypisującą stan macierzy w czytelnej formie heksadecymalnej. Implementujesz operację SubBytes: iterujesz po wszystkich 16 bajtach macierzy i zastępujesz każdy bajt wartością z tablicy S-box.

Implementujesz operację ShiftRows: wiersz 0 pozostawiasz bez zmian, wiersz 1 przesuwasz cyklicznie w lewo o 1 pozycję, wiersz 2 o 2 pozycje, a wiersz 3 o 3 pozycje. Implementujesz operację MixColumns: każdą kolumnę macierzy traktujesz jako wektor w ciele Galois GF(2^8) i mnożysz przez stałą macierz cykliczną o współczynnikach {02, 03, 01, 01}. Do mnożenia przez 02 stosujesz funkcję xtime(b) realizującą przesunięcie w lewo i warunkowy XOR z wielomianem nierozkładalnym 0x1B. Implementujesz operację AddRoundKey wykonującą bitowy XOR każdego bajtu macierzy stanu z odpowiadającym bajtem podklucza rundowego.

Wprowadzasz do programu oficjalny wektor testowy wejścia rundy 1 ze standardu FIPS 197. Uruchamiasz kolejno SubBytes, ShiftRows, MixColumns oraz AddRoundKey, drukując macierz stanu po każdym kroku. Porównujesz wydrukowane macierze z wartościami podanymi w specyfikacji FIPS 197 i potwierdzasz pełną zgodność co do bajta. Modyfikujesz pojedynczy bit w stanie wejściowym i obserwujesz, jak operacja MixColumns natychmiast rozprasza zmianę na całą kolumnę.

Analizujesz rolę nieliniowości S-boxa w zapewnieniu konfuzji oraz rolę ShiftRows i MixColumns w zapewnieniu dyfuzji według Shannona. Zapisujesz kod programu, zrzuty ekranu oraz zestawienie stanów pośrednich. Przygotowujesz sprawozdanie zawierające szczegółowy opis matematyczny operacji xtime i mnożenia w ciele F_256. Formułujesz wnioski podsumowujące elegancję i bezpieczeństwo architektury SPN w AES.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano aes_round.py.
  3. Zdefiniuj w Pythonie tablicę S-box standardu FIPS 197.
  4. Zaimplementuj funkcję bytes_to_state(b) tworzącą macierz 4x4 ułożoną kolumnowo.
  5. Zaimplementuj funkcję sub_bytes( state) wykonującą nieliniowe podstawienie każdego bajtu.
  6. Zaimplementuj funkcję shift_rows( state) realizującą cykliczne rotacje wierszy w lewo o 0, 1, 2 i 3 pozycje.
  7. Zaimplementuj pomocniczą funkcję xtime(a) dla mnożenia przez x w GF(2^8): ((a << 1) ^ 0x1B) if (a & 0x80) else (a << 1).
  8. Zaimplementuj operację mix_columns( state) mnożącą każdą kolumnę przez wielomian c(x) = 03*x^3 + 01*x^2 + 01*x + 02.
  9. Zaimplementuj funkcję add_round_key( state, round_key) wykonującą operację XOR z podkluczem.
  10. Wprowadź stan wejściowy z Przykładu B.1 FIPS 197: 32 43 f6 a8 88 5a 30 8d 31 31 98 a2 e0 37 07 34.
  11. Wykonaj wstępny AddRoundKey z kluczem głównym i wypisz macierz stanu.
  12. Zaaplikuj po kolei: SubBytes, ShiftRows, MixColumns i AddRoundKey dla rundy 1.
  13. Porównaj stan wyjściowy po każdej transformacji z oficjalną tabelą FIPS 197.
  14. Test krzyżowy z produkcją (rozszerzenie premium, po Zadaniu 4): złóż pełny AES-128, tj. 10 rund z tych samych czterech funkcji oraz podklucze z programu aes_key_schedule.py, zaszyfruj 16-bajtowy blok i porównaj z openssl enc -aes-128-ecb -nopad -K < klucz>; zgodność co do bajta dowodzi, że implementacja nie jest zabawką.
  15. Zmień 1 bit na wejściu i odnotuj liczbę zmienionych bajtów po operacji MixColumns.
  16. Wykonaj zrzuty ekranu działania skryptu dokumentujące pełną zgodność z dokumentem NIST.
  17. Sformułuj wnioski podsumowujące realizację postulatów konfuzji i dyfuzji w architekturze AES.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log: SubBytes/ShiftRows/MixColumns/AddRoundKey krok po kroku zgodne z wektorami FIPS-197 (stan 4×4 po każdej operacji).
  2. Dołączono kod (własne min. 30 linii): S-box, przesunięcia, mnożenie GF(2⁸), dodawanie klucza rundy.
  3. Przeprowadzono test pozytywny (wektor FIPS przechodzi) i negatywny (błędny S-box/kolejność — rozjazd wykryty na 1. rundzie).
  4. Opisano w 3–5 zdaniach: rola State 4×4, branch number 5 w MixColumns, ShiftRows jako dyfuzja międzykolumnowa.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób macierz stanu 4x4 State umożliwia optymalne łączenie operacji nieliniowych i liniowych.
  • Dlaczego mnożenie w ciele Galois GF(2^8) w MixColumns zapewnia maksymalną dyfuzję wewnątrz kolumny (branch number = 5).
  • Rola przesunięcia wierszy ShiftRows w przenoszeniu dyfuzji pomiędzy poszczególnymi kolumnami macierzy.
  • Student potrafi od podstaw zaprogramować cztery transformacje rundy AES w Pythonie i zweryfikować ich zgodność ze standardem NIST.
Zadanie 3 - ilustracja
04/10
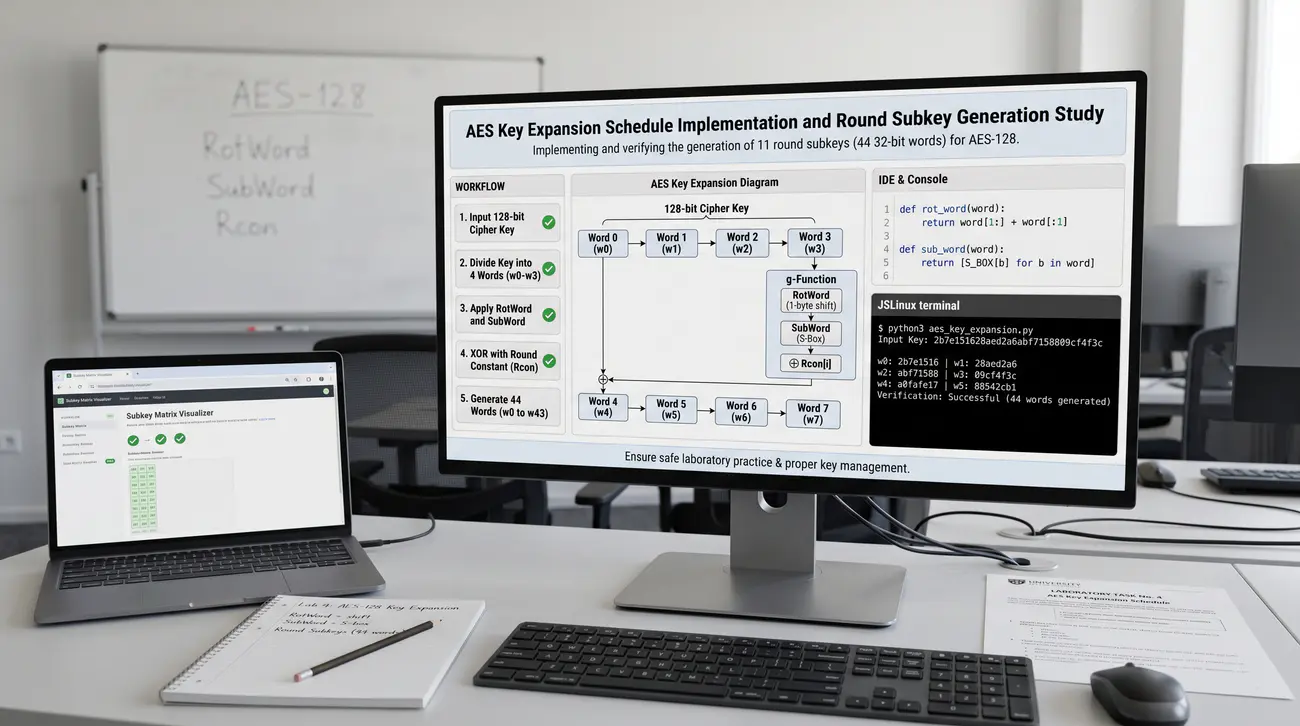
Zadanie 4. Implementacja procedury rozszerzania klucza AES i badanie generacji podkluczy rundowych
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 13, 19, 20: AES Key Expansion, słowa 32-bitowe, RotWord, SubWord, stałe rundowe Rcon, generowanie 11 podkluczy (44 słowa) dla AES-128, efekt lawinowy w harmonogramie klucza.

Cel

Celem zadania jest zaimplementowanie w języku Python procedury rozszerzania klucza (AES Key Expansion) dla wariantu AES-128. Student programuje operacje na słowach 32-bitowych (RotWord, SubWord, Rcon), generuje pełny zestaw 11 podkluczy rundowych (44 słowa) oraz bada, w jaki sposób zmiana pojedynczego bitu w kluczu głównym propaguje się na podklucze kolejnych rund.

Scenariusz – opis

Każda runda algorytmu AES wymaga unikalnego podklucza rundowego o długości 128 bitów (16 bajtów). Dla algorytmu AES-128 wykonuje się 10 rund szyfrowania oraz wstępne dodanie klucza (Runda 0), co wymaga wygenerowania łącznie 11 podkluczy z klucza głównego. Procedura Key Expansion przekształca 16-bajtowy klucz początkowy w tablicę 44 słów 32-bitowych w[0..43]. Pierwsze cztery słowa w[0..3] są tożsame z kluczem głównym, a każde kolejne słowo w[i] jest wyliczane rekurencyjnie z użyciem operacji XOR z w[i-4]. Dla słów, których indeks jest wielokrotnością 4, stosuje się transformację nieliniową obejmującą cykliczną rotację bajtów RotWord, podstawienie S-box SubWord oraz dodanie stałej rundowej Rcon. W tym zadaniu oprogramujesz tę procedurę w Pythonie w JSLinux i zbadasz właściwości dyfuzyjne harmonogramu klucza.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine otwierasz edytor i tworzysz skrypt aes_key_schedule.py. Definiujesz tablicę S-box oraz tablicę stałych rundowych Rcon zawierającą kolejne potęgi x w ciele GF(2^8). Implementujesz funkcję rot_word(w) wykonującą cykliczne przesunięcie 4-bajtowego słowa w lewo o 1 bajt: [b0, b1, b2, b3] -> [b1, b2, b3, b0]. Implementujesz funkcję sub_word(w) zastępującą każdy z 4 bajtów słowa odpowiadającą wartością z tablicy S-box.

Tworzysz główną pętlę generującą 44 słowa w[0..43] zgodnie z oficjalnym algorytmem FIPS 197. Formujesz z wygenerowanych 44 słów 11 kolejnych podkluczy rundowych K_0 do K_10. Wprowadzasz oficjalny wektor klucza testowego ze standardu NIST FIPS 197 (klucz szesnastkowy: 2b 7e 15 16 28 ae d2 a6 ab f7 15 88 09 cf 4f 3c). Uruchamiasz program i wyświetlasz wygenerowane podklucze dla wszystkich 11 rund. Porównujesz otrzymane ciągi szesnastkowe z oficjalnym aneksem A.1 normy FIPS 197 i weryfikujesz stuprocentową zgodność.

W kolejnym kroku badasz rozchodzenie się zmian: tworzysz klucz zmodyfikowany o dokładnie 1 bit w pierwszym bajcie. Generujesz podklucze dla zmodyfikowanego klucza i obliczasz odległość Hamminga pomiędzy odpowiadającymi podkluczami obu zestawów. Obserwujesz, jak różnica jednego bitu w rundzie 0 przekształca się w zmianę kilkudziesięciu bitów w podkluczach rund wyższych. Analizujesz, dlaczego proste harmonogramy klucza (np. w DES) były podatne na ataki korelacyjne, a nieliniowy Key Expansion w AES zapobiega atakom typu Related-Key. Zapisujesz kod źródłowy, wyniki porównania oraz obliczone statystyki odległości Hamminga. Wykonujesz zrzuty ekranu konsoli JSLinux dokumentujące poprawność wygenerowanych podkluczy. Formułujesz wyczerpujące podsumowanie z wnioskami do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano aes_key_schedule.py.
  3. Zaimplementuj tablicę S-box oraz stałe Rcon dla rund 1 do 10. Rcon to nie magia: Rcon[i] to potęga x^(i-1) w ciele GF(2^8), czyli 0x01, 0x02, 0x04, 0x08, 0x10, 0x20, 0x40, 0x80, 0x1B, 0x36 - przed dalszą pracą assert w programie sprawdza Rcon[10] == 0x36; niezgodność oznacza błąd mnożenia modularnego, nie „złą tabelę z internetu".
  4. Napisz funkcję rot_word( word) realizującą cykliczne przesunięcie bajtów w słowie 32-bitowym.
  5. Napisz funkcję sub_word( word) aplikującą S-box do każdego bajtu słowa.
  6. Zaimplementuj algorytm rozszerzania klucza generujący 44 słowa (176 bajtów) dla AES-128.
  7. Napisz funkcję formatującą słowa w 11 podkluczy 128-bitowych.
  8. Wprowadź oficjalny klucz FIPS 197: 2b7e151628aed2a6abf7158809cf4f3c.
  9. Wypisz wygenerowane podklucze od Rundy 0 do Rundy 10 w postaci szesnastkowej.
  10. Zweryfikuj zgodność każdego podklucza z oficjalnym załącznikiem A.1 standardu NIST.
  11. Wprowadź drugi klucz z odwróconym 1 bitem: 2a7e151628aed2a6abf7158809cf4f3c.
  12. Wygeneruj zestaw podkluczy dla drugiego klucza.
  13. Napisz pętlę obliczającą liczbę różniących się bitów (odległość Hamminga) między podkluczami dla każdej rundy.
  14. Sporządź tabelę: Numer rundy, Podklucz oryginalny, Podklucz zmodyfikowany, Odległość Hamminga.
  15. Wykonaj zrzuty ekranu z konsoli prezentujące działanie skryptu.
  16. Sformułuj wnioski wyjaśniające znaczenie nieliniowości funkcji SubWord w odporności na ataki na powiązane klucze (Related-Key Attacks).

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt i zachowano log: 11 podkluczy AES-128 (44 słowa) zgodnych z FIPS-197, z widocznym RotWord/SubWord/Rcon.
  2. Dołączono kod (własne min. 25 linii): ekspansja słów 32-bitowych, stałe Rcon, generacja wszystkich rund.
  3. Przeprowadzono test pozytywny (wektor FIPS przechodzi) i negatywny (brak Rcon — wykazana symetria/slide, test odrzuca).
  4. Opisano w 3–5 zdaniach: nieliniowość harmonogramu, Rcon vs slide attack, propagacja 1 bitu klucza na 11 podkluczy.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób operacje RotWord i SubWord wprowadzają nieliniowość i asymetrię do harmonogramu klucza.
  • Rola stałych rundowych Rcon w eliminacji symetrii i zapobieganiu atakom typu Slide Attack.
  • Szybkość propagacji pojedynczego bitu klucza głównego na przestrzeń wszystkich 11 podkluczy rundowych.
  • Student potrafi w pełni zaimplementować procedurę AES Key Expansion w Pythonie i zweryfikować jej poprawność z normą FIPS 197.
Zadanie 4 - ilustracja
05/10
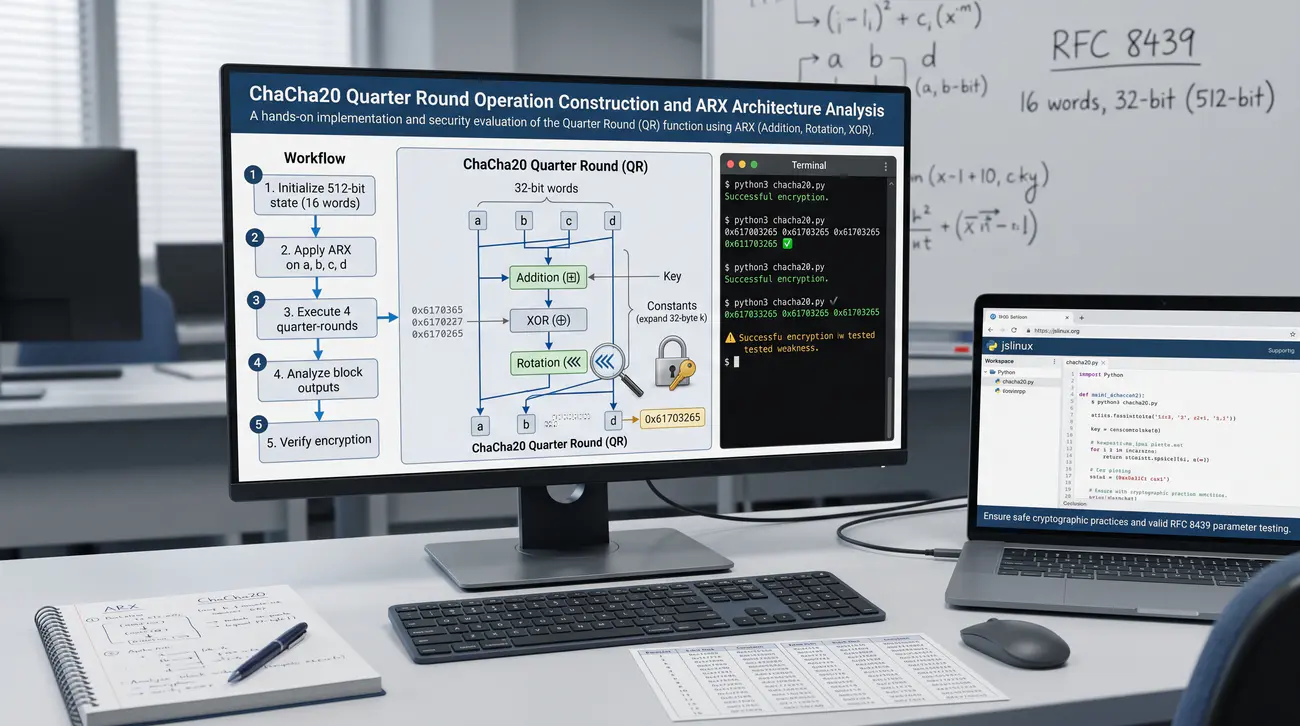
Zadanie 5. Konstrukcja i analiza operacji Quarter Round szyfru ChaCha20 w oparciu o architekturę ARX
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 30, 31, 32, 33: architektura ARX (Addition, Rotation, XOR), funkcja ćwierćrundowa QR, stan 16 słów 32-bitowych (512 bitów), RFC 8439, stałe 'expand 32-byte k'.

Cel

Celem zadania jest zaimplementowanie w języku Python elementarnej funkcji Quarter Round (QR) szyfru ChaCha20, zbadanie mechanizmu dyfuzji w architekturze ARX (Addition-Rotation-XOR) oraz zweryfikowanie poprawności działania na oficjalnych wektorach testowych ze standardu IETF RFC 8439.

Scenariusz – opis

Szyfr strumieniowy ChaCha20 opiera się na architekturze ARX, wykorzystującej wyłącznie trzy operacje na słowach 32-bitowych: dodawanie modulo 2^32, rotację bitową oraz XOR. Fundamentem całego algorytmu jest funkcja ćwierćrundowa QR(a, b, c, d), która modyfikuje cztery słowa 32-bitowe w czterech krokach obliczeniowych. W każdym kroku następuje dodanie dwóch słów, XOR wyniku z kolejnym słowem oraz cykliczna rotacja bitowa w lewo o specyficzną stałą (16, 12, 8 lub 7 bitów). Dzięki brakowi tablic S-box algorytm jest całkowicie odporny na ataki czasowe na pamięć podręczną (ang. cache-timing attacks) i działa wysoce wydajnie na dowolnym procesorze. Pełna runda ChaCha20 składa się z czterech operacji QR na kolumnach macierzy stanu oraz czterech na przekątnych (tzw. Double Round). W tym zadaniu zaimplementujesz funkcję QR oraz rundę podwójną w Pythonie w JSLinux i przetestujesz je na danych ze standardu RFC 8439.

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz plik programu chacha20_qr.py. Definiujesz pomocniczą funkcję rotacji bitowej w lewo dla liczb 32-bitowych: rol(v, c) = ((v << c) & 0xFFFFFFFF) | (v >> (32 - c)). Implementujesz funkcję quarter_round(a, b, c, d) wykonującą cztery kroki transformacji ARX dokładnie według specyfikacji RFC 8439. Krok 1: a = (a + b) mod 2^32; d = (d XOR a)<<< 16.

Krok 2: c = (c + d) mod 2^32; b = (b XOR c)<<< 12. Krok 3: a = (a + b) mod 2^32; d = (d XOR a)<<< 8. Krok 4: c = (c + d) mod 2^32; b = (b XOR c)<<< 7. Wprowadzasz oficjalny wektor testowy z rozdziału 2.1.1 dokumentu RFC 8439 (wejście: a = 0x11111111, b = 0x01020304, c = 0x9b8d6f43, d = 0x01234567).

Uruchamiasz funkcję i porównujesz wynik z wartościami oczekiwanymi z RFC 8439: a = 0xea2a92f4, b = 0xcb1cf8ce, c = 0x4581472e, d = 0x5881c4bb. Potwierdzasz stuprocentową zgodność obliczeń z oficjalną normą IETF.

Następnie budujesz macierz stanu 4x4 słów 32-bitowych i implementujesz rundę kolumnową (QR na kolumnach 0, 1, 2, 3) oraz przekątniową (QR na przekątnych). Badanie rozszerzasz o analizę efektu lawinowego: zmieniasz 1 bit w słowie 'a' i mierzysz, ile bitów ulega zmianie po wykonaniu jednej funkcji QR. Sprawdzasz, że już po pojedynczym wykonaniu QR zmiana jednego bitu rozprzestrzenia się na wszystkie cztery słowa stanu. Sporządzasz tabelę zestawień bitowych i analizujesz, dlaczego stałe rotacji (16, 12, 8, 7) zostały dobrane optymalnie pod kątem szybkości dyfuzji.

Wykonujesz zrzuty ekranu z konsoli JSLinux dokumentujące walidację z RFC 8439. Przygotowujesz kompletne wnioski techniczne do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano chacha20_qr.py.
  3. Zaimplementuj w Pythonie funkcję 32-bitowej rotacji bitowej w lewo rol(x, n).
  4. Zaimplementuj operację dodawania 32-bitowego z obcięciem do maski 0xFFFFFFFF.
  5. Zaimplementuj funkcję quarter_round(a, b, c, d) zgodnie z algorytmem RFC 8439.
  6. Wprowadź oficjalne wektory testowe z sekcji 2.1.1 RFC 8439.
  7. Wykonaj funkcję QR i porównaj wyjściowe wartości szesnastkowe a, b, c, d z normą.
  8. Wypisz w konsoli potwierdzenie poprawności testu jednostkowego (PASS/FAIL).
  9. Zaimplementuj strukturę stanu 16 słów i funkcję column_round( state).
  10. Zaimplementuj funkcję diagonal_round( state) operującą na przekątnych macierzy.
  11. Złóż pełną rundę podwójną (Double Round) składającą się z rundy kolumnowej i przekątniowej.
  12. Przeprowadź test efektu lawinowego: odwróć 1 bit w wejściowym słowie a i przelicz QR.
  13. Oblicz liczbę zmienionych bitów we wszystkich czterech słowach wyjściowych.
  14. Zestaw wyniki pomiaru dyfuzji w tabeli sprawozdania.
  15. Mini-pomiar motywujący dyskusję o sprzęcie: zmierz w Pythonie czas 20 pełnych rund ChaCha20 (Double Round × 10) oraz 10 rund AES z Zadania 3 na tym samym hoście i podaj krotność (nie milisekundy); wyjaśnij, dlaczego na procesorze z AES-NI relacja się odwraca - to jest właściwy wniosek inżynierski, nie same liczby.
  16. Wykonaj zrzuty ekranu kodu oraz wyjścia konsoli w JSLinux.
  17. Sformułuj wnioski wyjaśniające, w jaki sposób architektura ARX eliminuje luki czasowe implementacji programowych w porównaniu z AES.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt QR i zachowano log: wynik Quarter Round zgodny z RFC 8439 dla wektora testowego, z widocznymi krokami ARX.
  2. Dołączono kod (własne min. 20 linii): dodawanie mod 2³², rotacje, XOR, rundy kolumnowe/przekątniowe.
  3. Przeprowadzono test pozytywny (wektor RFC przechodzi) i negatywny (zła rotacja — rozjazd natychmiast wykryty).
  4. Opisano w 3–5 zdaniach: ARX jako dyfuzja bez tablic, stały czas vs cache-timing, kolumny+przekątne jako pełne mieszanie.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób naprzemienne stosowanie dodawania arytmetycznego (nieliniowość) i XOR (liniowość) z rotacją generuje wysoką dyfuzję.
  • Dlaczego brak odwołań do tablic pamięci (S-box) gwarantuje stały czas wykonania operacji i odporność na ataki cache-timing.
  • Rola podziału na rundy kolumnowe i przekątniowe w zapewnieniu pełnego wymieszania wszystkich 16 słów macierzy stanu.
  • Student potrafi poprawnie zaimplementować funkcję QR ChaCha20 w Pythonie i zweryfikować jej poprawność z oficjalnym dokumentem RFC 8439.
Zadanie 5 - ilustracja
06/10
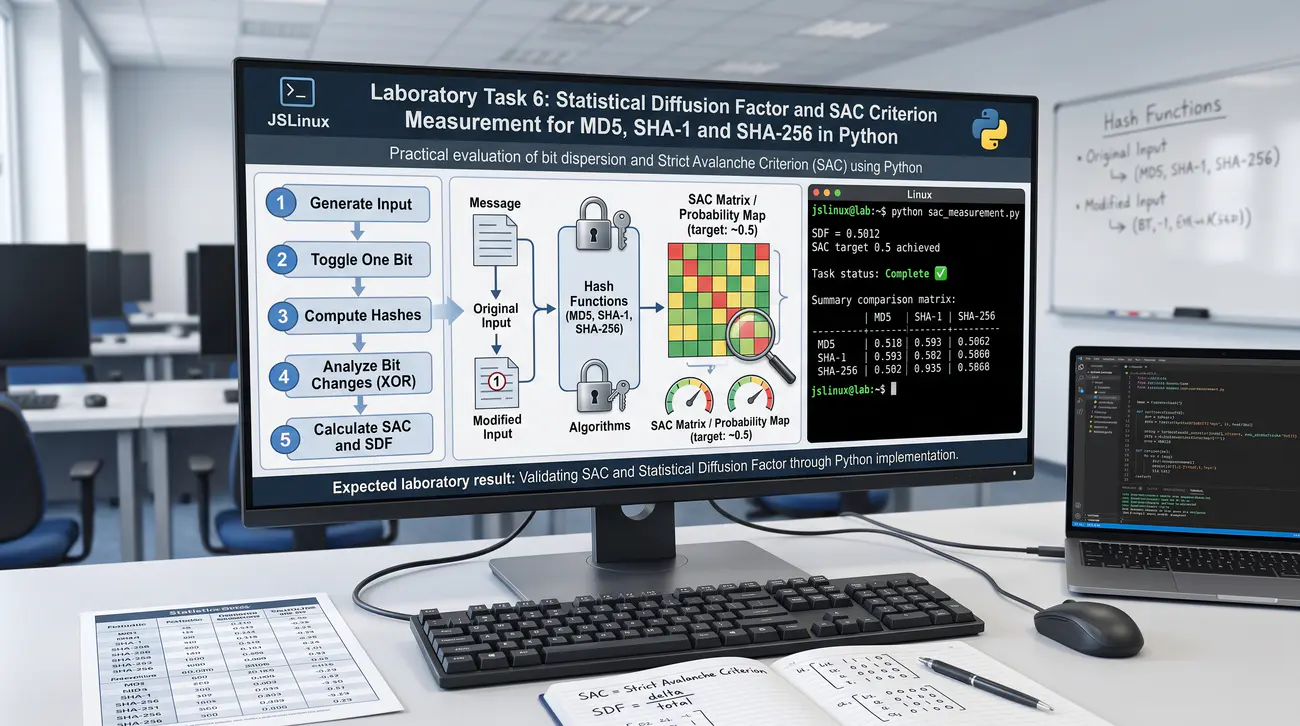
Zadanie 6. Statystyczny pomiar współczynnika dyfuzji i spełnienia kryterium SAC dla MD5, SHA-1 i SHA-256 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 35, 36, 37, 39, 41, 45: własności funkcji skrótu, ścisłe kryterium lawinowe SAC (Strict Avalanche Criterion), MD5, SHA-1, SHA-256, porównanie statystyczne jakości rozproszenia bitów.

Cel

Celem zadania jest zbadanie jakości rozproszenia informacji w popularnych funkcjach skrótu poprzez opracowanie zautomatyzowanego skryptu w języku Python mierzącego spełnienie ścisłego kryterium lawinowego (Strict Avalanche Criterion - SAC) dla algorytmów MD5, SHA-1 oraz SHA-256 na próbie statystycznej 1000 losowych wektorów.

Scenariusz – opis

Ścisłe kryterium lawinowe (SAC), sformułowane przez Webstera i Tavaresa w 1985 roku, jest fundamentalną miarą jakości kryptograficznej. Mówi ono, że funkcja spełnia kryterium SAC, jeśli przy zmianie dowolnego pojedynczego bitu wejściowego każdy bit wyjściowy zmienia się z prawdopodobieństwem dokładnie 50% (p = 0.5). Odchylenie od tej wartości oznacza istnienie korelacji statystycznych, które mogą zostać wykorzystane przez kryptoanalityków do ataków analitycznych. Chociaż algorytmy MD5 i SHA-1 zostały złamane pod kątem odporności na kolizje, ich właściwości lawinowe wciąż stanowią interesujący punkt odniesienia dla nowoczesnego standardu SHA-256. W tym laboratorium opracujesz program w Pythonie w JSLinux, który przeprowadzi zautomatyzowane badanie statystyczne SAC dla tych trzech algorytmów. Do obliczeń wykorzystasz standardowy moduł hashlib dostępny w środowisku Linux.

Co ma wykonać student / grupa

W konsoli JSLinux tworzysz skrypt sac_benchmark.py wykorzystujący moduły hashlib, os oraz math. Definiujesz parametry eksperymentu: liczba prób N = 1000 losowych wiadomości o stałej długości 64 bajtów. Dla każdej próby generujesz losowy ciąg bajtów M_0 oraz 512 wariantów wiadomości M_i, w których odwrócono dokładnie jeden bit. Dla każdego algorytmu (MD5, SHA-1, SHA-256) obliczasz bazowy skrót H(M_0) oraz skróty H(M_i) dla wszystkich zmodyfikowanych wiadomości.

Tworzysz macierz zliczeń zmian bitowych P o wymiarach (liczba bitów wejścia x liczba bitów wyjścia). Dla każdej pary obliczasz wektor XOR bitów wyjściowych i inkrementujesz odpowiednie komórki macierzy. Po zakończeniu 1000 iteracji przeliczasz wartości macierzy na prawdopodobieństwa empiryczne: p_ij = zliczenia / N. Obliczasz globalną średnią wartość prawdopodobieństwa zmiany bitu dla każdego z trzech algorytmów.

Obliczasz odchylenie standardowe sigma od idealnej wartości teoretycznej 0.5000. Generujesz histogram rozkładu prawdopodobieństw w postaci tekstowej w konsoli JSLinux. Porównujesz wyniki: analizujesz, jak blisko wartości 0.5 znajdują się MD5 (128 bitów), SHA-1 (160 bitów) oraz SHA-256 (256 bitów). Formułujesz wnioski dotyczące tego, dlaczego spełnienie kryterium SAC jest warunkiem koniecznym, lecz niewystarczającym do uznania funkcji skrótu za bezpieczną (przypadek MD5).

Sporządzasz tabelę zbiorczą zawierającą: średnie prawdopodobieństwo, odchylenie standardowe, minimalne i maksymalne prawdopodobieństwo w macierzy. Zapisujesz kod programu oraz zrzuty ekranu z wykonania analizy statystycznej. Dokumentujesz czas wykonania obliczeń w emulatorze JSLinux. Przygotowujesz pełny raport laboratoryjny z interpretacją wyników.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine z interpreterem Python 3.
  2. Utwórz plik programu: nano sac_benchmark.py.
  3. Zaimportuj moduły hashlib, random i time.
  4. Zaimplementuj funkcję flip_bit(byte_array, bit_index) odwracającą jeden bit w tablicy bajtów.
  5. Napisz funkcję calculate_sac(hash_func_name, num_samples, input_len_bytes).
  6. Zaimplementuj pętlę testową dla MD5 generującą macierz zmian bitowych.
  7. Zaimplementuj pętlę testową dla SHA-1.
  8. Zaimplementuj pętlę testową dla SHA-256.
  9. Dla każdego algorytmu wylicz średnią odległość Hamminga oraz średnie prawdopodobieństwo zmiany bitu p_mean.
  10. Oblicz odchylenie standardowe od wartości idealnej 0.5: std_dev = sqrt(sum(pow(p - 0.5, 2) for p in probs) / total_pairs).
  11. Zaimplementuj prosty tekstowy wykres słupkowy prezentujący histogram rozkładu prawdopodobieństw.
  12. Uruchom skrypt i zarejestruj wygenerowane raporty statystyczne dla wszystkich trzech funkcji.
  13. Porównaj uzyskane odchylenia standardowe (np. SHA-256 vs MD5).
  14. Sporządź tabelę porównawczą parametrów statystycznych w sprawozdaniu.
  15. Wykonaj zrzuty ekranu z wynikami działania skryptu w JSLinux.
  16. Sformułuj techniczne wnioski podsumowujące relację pomiędzy kryterium SAC a faktyczną odpornością na ataki kolizyjne. Obowiązkowe zdanie rozróżniające (dosłownie w raporcie): „SAC mierzy wyłącznie dyfuzję, nie odporność na kolizje - MD5 zalicza SAC z wynikiem ~0,5, a jest praktycznie złamany (dowód: pary kolizyjne Wanga, Zadanie 5 z poziomu 5.0)". Bez tego zdania pomiary są niezaliczone.

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt SAC i zachowano log/macierz: p≈0.5 dla MD5/SHA-1/SHA-256 z odchyleniem, wykazana dobra lawina mimo złamania MD5.
  2. Dołączono kod (własne min. 25 linii): pętla 1-bitowych zmian, licznik flips, statystyka SAC per bit wyjścia.
  3. Przeprowadzono test pozytywny (SHA-256 — wąski rozkład wokół 0.5) i negatywny (funkcja tożsamościowa — SAC=0, test demaskuje).
  4. Opisano w 3–5 zdaniach: SAC jako konieczność lecz nie wystarczalność, MD5 dobry statystycznie a złamany, rola rund SHA-256.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego wysoki stopień spełnienia kryterium SAC (p ~ 0.5) jest kluczowy dla uniemożliwienia przewidywania zmian skrótu.
  • Dlaczego funkcja może doskonale spełniać kryterium SAC, a jednocześnie być całkowicie skompromitowana kryptoanalitycznie (MD5).
  • Jak rosnąca liczba rund i złożoność operacji w SHA-256 zapewnia minimalne odchylenie standardowe rozkładu dyfuzji.
  • Student potrafi opracować zaawansowany program weryfikacji statystycznej w Pythonie i zinterpretować macierz prawdopodobieństw SAC.
Zadanie 6 - ilustracja
07/10
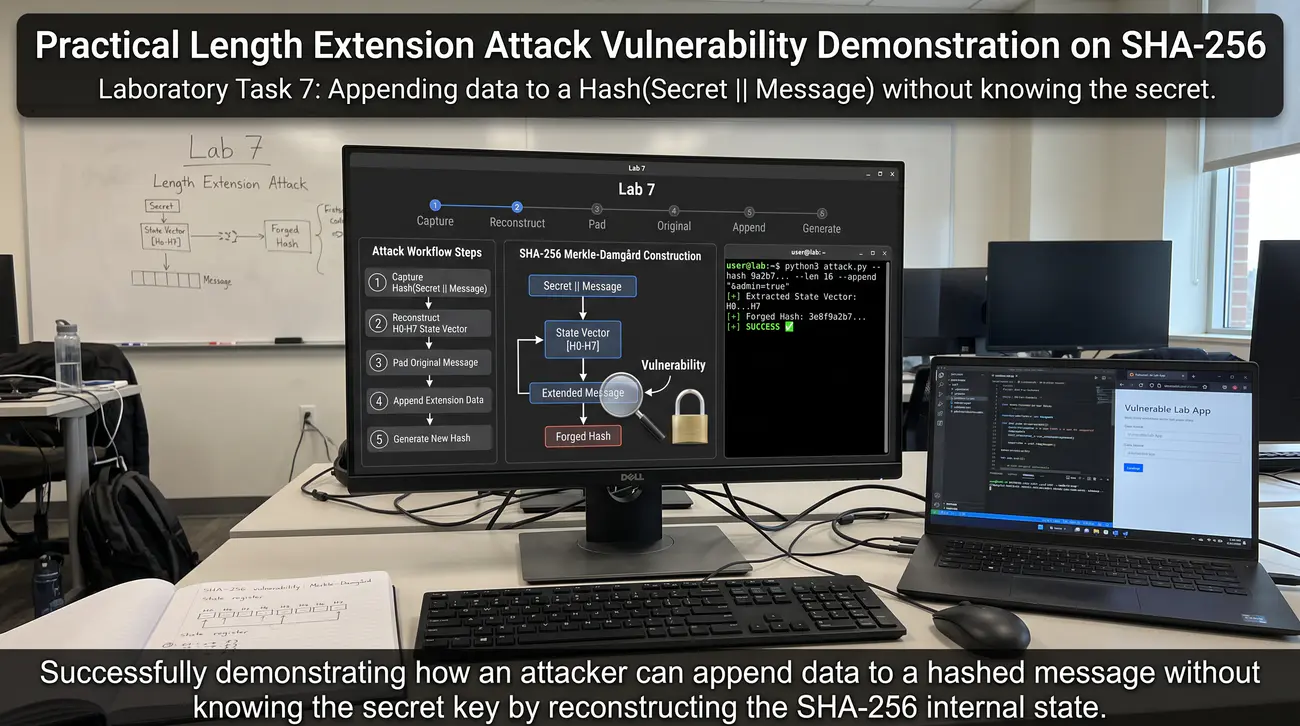
Zadanie 7. Praktyczna demonstracja podatności ataku dołączenia długości na SHA-256
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 41, 42, 44: konstrukcja Merkle-Damgård, podatność Length Extension Attack na schemat Hash(Secret || Message), odporność HMAC i SHA-3, wektor stanu H0-H7.

Cel

Celem zadania jest praktyczne zrozumienie i zademonstrowanie ataku dołączenia długości (Length Extension Attack) na funkcję skrótu SHA-256. Student bada, dlaczego naiwny podpis autoryzacyjny Hash(Klucz || Komunikat) jest podatny na sfałszowanie przez stronę trzecią bez znajomości klucza tajnego oraz wykazuje, dlaczego HMAC i SHA-3 są całkowicie odporne na ten atak.

Scenariusz – opis

Funkcje skrótu z rodziny SHA-2 (w tym SHA-256) oparte są na klasycznej konstrukcji iteracyjnej Merkle-Damgård. W konstrukcji tej dane są dzielone na 512-bitowe bloki i przetwarzane kolejno przez funkcję kompresji aktualizującą wewnętrzny rejestr stanu H0..H7. Ostateczny skrót wyjściowy jest niczym innym jak bezpośrednim zrzutem wartości rejestrów stanu po przetworzeniu ostatniego bloku z dopełnieniem. Prowadzi to do poważnej podatności architektonicznej: znając skrót H(Sekret || Wiadomość) oraz długość całego ciągu, atakujący zna stan rejestrów po przetworzeniu tych danych. Może więc zainicjować funkcję kompresji tym stanem i dokleić do wiadomości dowolne dodatkowe dane, obliczając poprawny skrót nowego ciągu bez znajomości Sekretu! W tym laboratorium zaimplementujesz ten atak w Pythonie w JSLinux na podatnej usłudze sieciowej i udowodnisz konieczność stosowania HMAC.

Co ma wykonać student / grupa

W konsoli JSLinux przygotowujesz podatną aplikację autoryzującą żądania HTTP. Aplikacja weryfikuje token uprawnień: serwer oblicza token = sha256(tajny_klucz + zapytanie), gdzie zapytanie to np. 'user=jan&action=read_data'. Tajny klucz serwera ma długość 16 bajtów i nie jest znany użytkownikowi. Jako użytkownik znasz treść swojego zapytania oraz przypisany token autoryzacyjny.

Twoim celem jest uzyskanie uprawnień administratora poprzez dołączenie parametru '&role=admin' i wygenerowanie poprawnego tokenu bez znajomości klucza. W skrypcie Pythona odtwarzasz standaryzowane dopełnienie Merkle-Damgård dla ciągu o łącznej długości (16 bajtów klucza + długość oryginalnego zapytania). Dopełnienie składa się z bajtu 0x80, odpowiedniej liczby bajtów zerowych oraz 64-bitowego zapisu długości w bitach. Wyodrębniasz 8 słów 32-bitowych ze znanego tokenu SHA-256 i inicjalizujesz nimi stan wewnętrzny funkcji kompresji SHA-256.

Przepuszczasz przez tak zainicjalizowaną funkcję kompresji dopisywany fragment '&role=admin' wraz z nowym dopełnieniem. Otrzymujesz nowy, sfałszowany token autoryzacyjny oraz nową spreparowaną treść zapytania zawierającą oryginalne zapytanie, oryginalny padding i doklejony fragment. Przesyłasz spreparowane zapytanie i sfałszowany token do modułu weryfikacyjnego serwera. Serwer łączy swój tajny klucz ze spreparowanym ciągiem, oblicza standardowy SHA-256 i potwierdza pełną zgodność tokenów! Wykazujesz, że atakujący uzyskał uprawnienia administratora bez zgadywania klucza.

Następnie modyfikujesz serwer, zastępując podatny token funkcją hmac.new(klucz, zapytanie, hashlib.sha256). Ponawiasz próbę ataku i udowadniasz, że dwuetapowa konstrukcja HMAC uniemożliwia kontynuację stanu rejestrów. Dokumentujesz zrzutami ekranu przebieg ataku i formułujesz wnioski w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano length_extension_demo.py.
  3. Napisz funkcję serwera generującą token autoryzacyjny: sha256(SECRET + query).hexdigest().
  4. Ustal tajny klucz serwera na 16-bajtowy ciąg nieznany atakującemu.
  5. Zdefiniuj oryginalne zapytanie klienta: 'user=student&role=guest'.
  6. Wygeneruj oryginalny podpis token dla tego zapytania.
  7. Zaimplementuj w Pythonie funkcję md_pad(msg_len_bytes) generującą dopełnienie Merkle-Damgårda (uwaga terminologiczna: to NIE jest PKCS#7 - padding SHA-256 to bajt 0x80, zera i 64-bitowa długość w bitach): def md_pad(L): pad = b'\x80'; pad += b'\x00' * ((55 - L) % 64); return pad + ((L * 8) % 2**64).to_bytes(8, 'big'). Test znanej odpowiedzi przed atakiem: md_pad(16) ma mieć długość 48 bajtów i kończyć się długością 128 bitów (0x80 na końcu); dopiero zgodny test uprawnia do kroku fałszerstwa.
  8. Zaimplementuj uproszczoną funkcję kompresji SHA-256 pozwalającą na wstrzyknięcie stanu początkowego H0..H7.
  9. Rozbij oryginalny 64-znakowy hex tokenu na 8 słów 32-bitowych stanu.
  10. Zainicjuj SHA-256 tym stanem i skompresuj dopisywany fragment '&role=admin'.
  11. Sformułuj zmanipulowaną wiadomość: original_query + padding + '&role=admin'.
  12. Przekaż zmanipulowaną treść i wygenerowany podpis do funkcji weryfikującej serwera.
  13. Wypisz rezultat weryfikacji i potwierdź sukces podrobienia uprawnień.
  14. Zaimplementuj bezpieczną wersję serwera z HMAC-SHA256 i powtórz atak, rejestrując porażkę fałszerstwa.
  15. Wykonaj zrzuty ekranu konsoli JSLinux obrazujące pomyślne przeprowadzenie ataku.
  16. Sformułuj techniczne wnioski wyjaśniające odporność algorytmu SHA-3 (Keccak) oraz mechanizmu HMAC na atak Length Extension.

Kontrola zaliczenia (checklist):

  1. Uruchomiono atak i zachowano log: z Hash(klucz||msg) i znajomości długości klucza sfałszowano ważny podpis dla msg||pad||ext bez znajomości klucza.
  2. Dołączono kod (własne min. 25 linii): rekonstrukcja stanu Merkle-Damgårda, dopisanie paddingu, kuźnia HMAC jako łatki.
  3. Przeprowadzono test pozytywny (fałszerstwo przechodzi na naiwnym weryfikatorze) i negatywny (ten sam trik na HMAC — odrzucony).
  4. Opisano w 3–5 zdaniach: wyciek stanu w skrócie, błąd Hash(klucz||dane), podwójne zagnieżdżenie HMAC jako obrona.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób iteracyjna budowa Merkle-Damgård ujawnia pełny wewnętrzny stan maszyny w wyjściowym skrócie.
  • Dlaczego naiwny schemat podpisu Hash(Klucz || Dane) jest krytycznym błędem programistycznym.
  • W jaki sposób HMAC neutralizuje ten atak poprzez podwójne zagnieżdżenie skrótu z kluczem i zewnętrznym padem.
  • Student potrafi przeprowadzić atak Length Extension w Pythonie oraz wdrożyć bezpieczną alternatywę w oparciu o HMAC.
Zadanie 7 - ilustracja
08/10
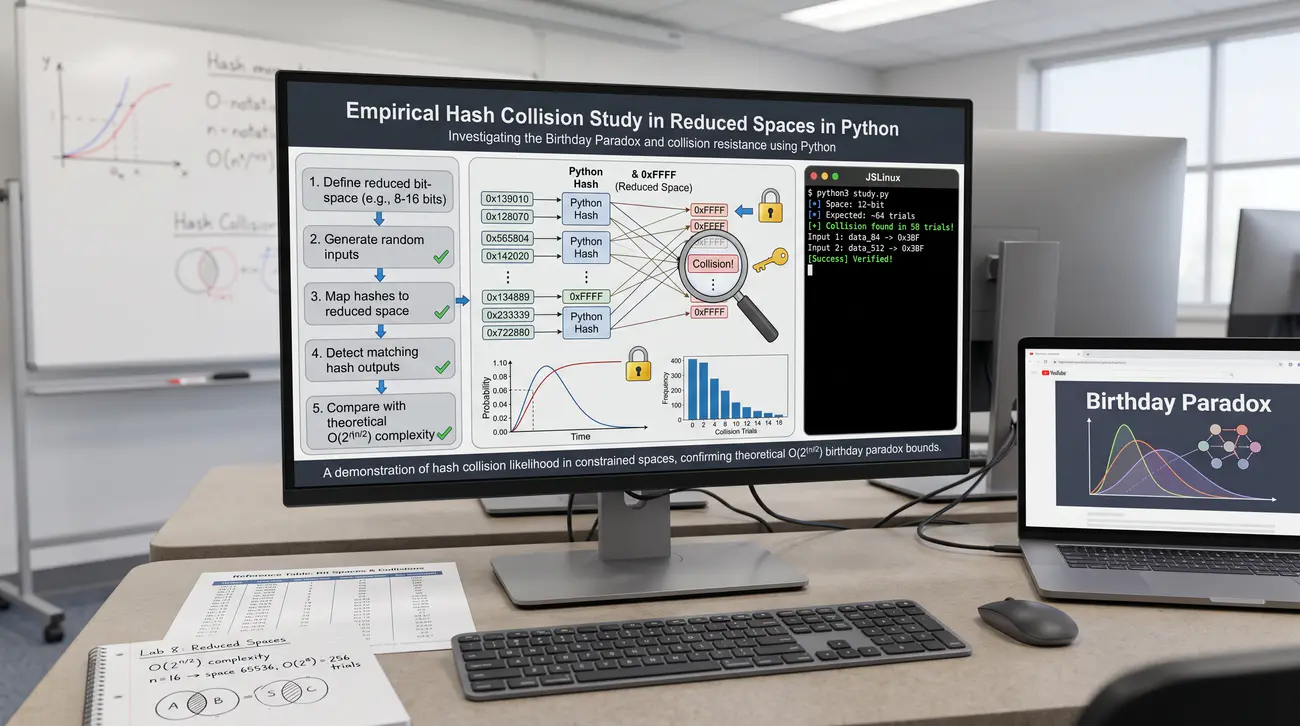
Zadanie 8. Empiryczne badanie kolizji skrótów w przestrzeniach zredukowanych w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 36, 45: własności funkcji skrótu, paradoks dnia urodzin, odporność na kolizje, złożoność ataku O(2^(n/2)), przestrzenie zredukowane, kolizje skrótów.

Cel

Celem zadania jest empiryczne zweryfikowanie paradoksu dnia urodzin w kryptografii poprzez wyszukiwanie kolizji skrótów SHA-256 obciętych do zredukowanych długości bitowych (od 16 do 32 bitów) w języku Python. Student porównuje rzeczywistą liczbę prób potrzebną do znalezienia kolizji z modelem teoretycznym O(2^(n/2)).

Scenariusz – opis

Odporność na kolizje (ang. collision resistance) oznacza trudność znalezienia dwóch dowolnych różnych komunikatów m1 != m2 takich, że H(m1) = H(m2). Zgodnie z zasadą szufladkową Dirichleta i paradoksem dnia urodzin, znalezienie kolizji dla n-bitowej funkcji skrótu wymaga sprawdzenia około 1.25 * 2^(n/2) prób, a nie 2^n prób. Dla pełnego skrótu SHA-256 złożoność ta wynosi 2^128 operacji, co znajduje się daleko poza zasięgiem współczesnej technologii obliczeniowej. Możemy jednak zbadać to zjawisko empirycznie, redukując rozmiar wyjściowy funkcji skrótu do małej liczby bitów (np. 16, 20, 24, 28, 32 bity). W tym laboratorium napiszesz wielopróbkowy program w Pythonie w środowisku JSLinux, który wyszukuje kolizje metodą tablicy haszującej (lub algorytmem żółwia i zająca Floyda). Zgromadzone dane posłużą do wykreślenia krzywej doświadczalnej i skonfrontowania jej z teorią prawdopodobieństwa.

Co ma wykonać student / grupa

W emulatorze JSLinux otwierasz edytor i tworzysz program birthday_attack.py. Implementujesz funkcję pobierającą skrót SHA-256 z zadanego ciągu i obcinającą go do pierwszych N bitów za pomocą maski bitowej. Dla zadanego N (rozpoczynając od N = 16 bitów, czyli przestrzeni zaledwie 65 536 możliwych wartości) tworzysz pusty słownik w Pythonie. W pętli generujesz losowe wiadomości tekstowe, wyliczasz obcięty hash i sprawdzasz, czy wystąpił już w słowniku.

Gdy napotkasz identyczny hash dla nowej wiadomości, zatrzymujesz pętlę, odnotowujesz liczbę wykonanych iteracji i wypisujesz oba kolidujące teksty. Powtarzasz eksperyment 100 razy dla N = 16 i obliczasz średnią liczbę prób potrzebnych do kolizji. Porównujesz średnią empiryczną z wartością teoretyczną: sqrt(pi/2 * 2^16) = sqrt(1.57 * 65536) ~ 321 prób.

Następnie zwiększasz N kolejno do 20 bitów (teoria ~ 1284 próby), 24 bitów (teoria ~ 5138 prób) oraz 28 bitów (teoria ~ 20555 prób). Dla każdego N rejestrujesz średnią liczbę prób, czas wyszukiwania w sekundach oraz zużycie pamięci RAM. Implementujesz wariant algorytmu wykrywania cykli Floyda (żółw i zając) eliminujący zapotrzebowanie na pamięć O(2^(n/2)). Tworzysz w konsoli zestawienie tabelaryczne wyników i porównujesz wzrost liczby prób z funkcją pierwiastkową 2^(N/2). Analizujesz, dlaczego zjawisko to wymusiło wycofanie algorytmu MD5 (128 bitów, atak w 2^64) oraz SHA-1 (160 bitów, atak w 2^80) na rzecz SHA-256. Sporządzasz wykres ASCII lub tabelę weryfikującą zgodność modelu empirycznego z teorią.

Wykonujesz zrzuty ekranu prezentujące znalezione pary kolizji w JSLinux.

Formułujesz wnioski dotyczące doboru długości skrótu w podpisach cyfrowych. Zapisujesz kompletny raport laboratoryjny.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano birthday_attack.py.
  3. Zaimportuj moduły hashlib, os, math i time.
  4. Napisz funkcję get_truncated_hash( data, bits) zwracającą N-bitową liczbę całkowitą ze skrótu SHA-256.
  5. Zaimplementuj funkcję find_collision( bits) zliczającą próby aż do napotkania kolizji w słowniku.
  6. Przeprowadź 100 prób dla N = 16 bitów i wylicz średnią liczbę iteracji.
  7. Przeprowadź 50 prób dla N = 20 bitów i wylicz średnią.
  8. Przeprowadź 20 prób dla N = 24 bitów i wylicz średnią.
  9. Przeprowadź 5 prób dla N = 28 bitów i zarejestruj czas wykonania.
  10. Wypisz przykładową parę znalezionych wiadomości kolidujących wraz z ich identycznym obciętym skrótem hex.
  11. Zaimplementuj algorytm detekcji cyklu Floyda i porównaj zużycie pamięci.
  12. Zestaw w tabeli: Liczba bitów N, Rozmiar przestrzeni 2^N, Średnia empiryczna, Teoria sqrt(pi/2 * 2^N), Błąd względny (%).
  13. Sporządź wykres zależności liczby prób od długości bitowej w konsoli.
  14. Wykonaj zrzuty ekranu z wynikami działania programu w JSLinux.
  15. Przeanalizuj wpływ paradoksu dnia urodzin na bezpieczeństwo podpisów cyfrowych X.509.
  16. Sformułuj wnioski wyjaśniające, dlaczego funkcja o skrócie 128 bitów zapewnia jedynie 64 bity bezpieczeństwa przed kolizjami.
  17. Obowiązkowa ekstrapolacja zamykająca zadanie: przy zmierzonej przez siebie prędkości (hashy/s) wylicz czas kolizji dla pełnych 256 bitów jako 2^128/profil i porównaj z wiekiem wszechświata (~4×10^17 s) - jeżeli iloraz nie wychodzi rzędu 10^21 lub więcej, wróć i sprawdź jednostki prędkości (najczęstszy błąd: hashy/minutę zamiast hashy/sekundę).

Kontrola zaliczenia (checklist):

  1. Uruchomiono skrypt urodzinowy i zachowano log: kolizje dla 16–24 bitów znalezione w ~2^(n/2) próbach, zgodnie z teorią (tabela próby vs teoria).
  2. Dołączono kod (własne min. 20 linii): obcinanie SHA-256, tablica haszująca, pomiar liczby prób, ekstrapolacja do 256 bitów.
  3. Przeprowadzono test pozytywny (16 bitów — szybka kolizja) i negatywny (pełne 256 bitów — przerwanie po limicie z wyliczeniem niewykonalności).
  4. Opisano w 3–5 zdaniach: pierwiastek z paradoksu urodzin, zgodność empirii z modelem, dlaczego podpisy wymagają ≥256 bitów.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób paradoks dnia urodzin redukuje złożoność ataku ze skali O(2^n) do O(2^(n/2)).
  • Zgodność wyników empirycznych uzyskanych w Pythonie z modelem matematycznym rozkładu prawdopodobieństwa.
  • Dlaczego w podpisach cyfrowych odporność na kolizje jest krytyczna, co wymaga stosowania skrótów o długości co najmniej 256 bitów.
  • Student potrafi zaprogramować atak urodzinowy w Pythonie i dokonać rzetelnej analizy statystycznej złożoności obliczeniowej.
Zadanie 8 - ilustracja
09/10
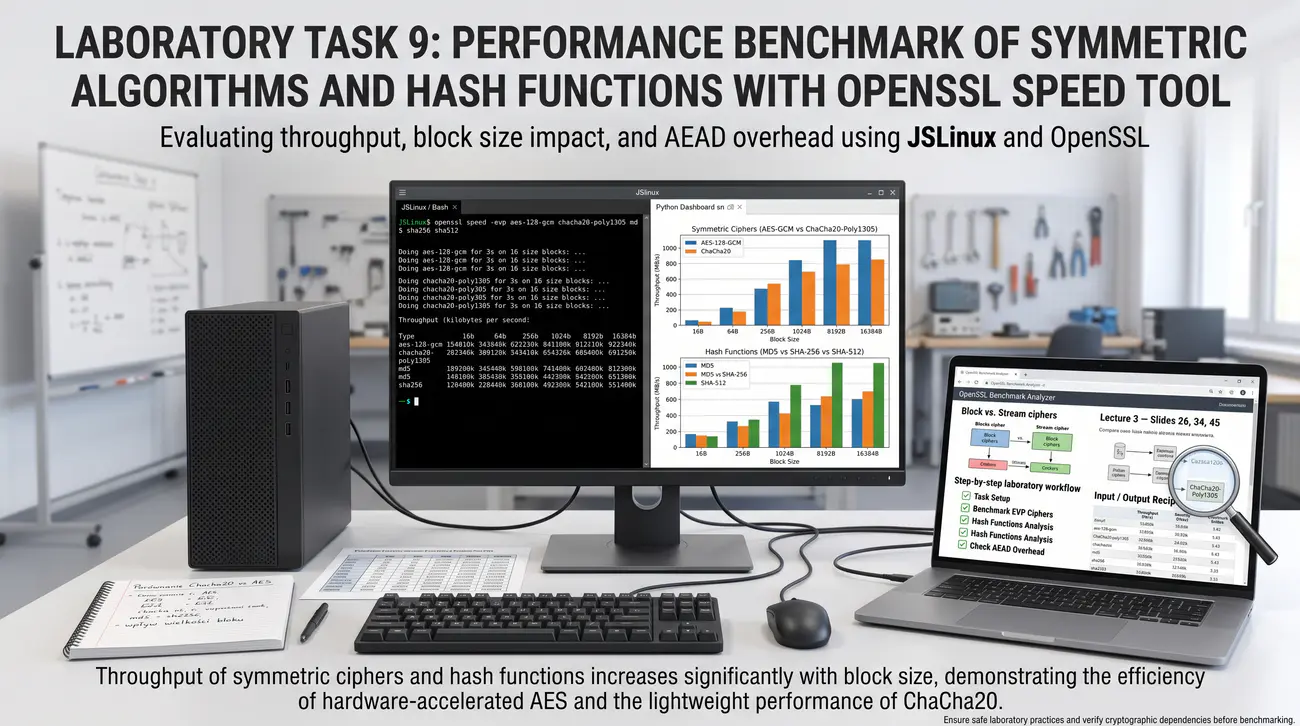
Zadanie 9. Benchmark wydajnościowy algorytmów symetrycznych i funkcji skrótu w narzędziu OpenSSL Speed
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 3 - slajdy 26, 34, 45: porównanie wydajności szyfrów blokowych i strumieniowych, ChaCha20 vs AES, narzut AEAD, przepustowość funkcji skrótu, wpływ wielkości bloku.

Cel

Celem zadania jest przeprowadzenie systematycznych testów porównawczych wydajności i przepustowości (MB/s) szyfrów symetrycznych (AES, 3DES, ChaCha20) oraz funkcji skrótu (MD5, SHA-1, SHA-256, SHA-512, SHA3-256) za pomocą uniksowego narzędzia openssl speed w środowisku Linux. Student bada wpływ wielkości bufora danych oraz obecności akceleracji sprzętowej na parametry pracy algorytmów.

Scenariusz – opis

Wybór algorytmu kryptograficznego w systemach produkcyjnych jest kompromisem pomiędzy gwarantowanym poziomem bezpieczeństwa a kosztem obliczeniowym. Standardowe narzędzie OpenSSL zawiera wbudowany moduł testów wydajnościowych openssl speed, mierzący przepustowość algorytmów dla różnych rozmiarów bufora (16B, 64B, 256B, 1024B, 8192B). Na nowoczesnych procesorach z instrukcjami AES-NI szyfr AES osiąga gigabajtowe przepustowości, jednak w środowiskach wirtualnych lub mobilnych szyfr strumieniowy ChaCha20 może okazać się znacznie szybszy. Ponadto algorytmy operujące na słowach 64-bitowych (takie jak SHA-512) wykazują zupełnie inne charakterystyki na procesorach x86_64 niż algorytmy 32-bitowe (SHA-256). W tym laboratorium przeprowadzisz pełną kampanię pomiarową w emulatorze JSLinux Alpine. Zgromadzone dane przetworzysz za pomocą skryptu w Pythonie i przedstawisz w formie ustrukturyzowanych wykresów i tabel.

Co ma wykonać student / grupa

Uruchamiasz emulator JSLinux Alpine w oknie przeglądarki. Zapoznajesz się ze składnią polecenia openssl speed i dostępnymi opcjami profilowania. Uruchamiasz benchmark szyfrów blokowych: openssl speed aes-128-cbc aes-256-cbc des-ede3-cbc. Rejestrujesz przepustowość w tysiącach bajtów na sekundę dla poszczególnych rozmiarów bufora.

Następnie badasz szyfry uwierzytelnione i strumieniowe: openssl speed -evp aes-128-gcm -evp chacha20-poly1305. Analizujesz narzut obliczeniowy generowania tagu GMAC i Poly1305 w porównaniu z czystym szyfrowaniem.

Przechodzisz do pomiaru wydajności funkcji skrótu: openssl speed md5 sha1 sha256 sha512. Zwracasz uwagę na przepustowość SHA-512 w buforach 8192B i porównujesz ją z SHA-256. Testujesz najnowszy standard SHA-3: openssl speed sha3-256. Piszesz skrypt w Pythonie parsujący wyjście tekstowe OpenSSL i generujący zestawienie tabelaryczne w megabajtach na sekundę (MB/s).

Skrypt wylicza względny spadek lub wzrost wydajności w relacji do bazowego algorytmu AES-128-CBC. Analizujesz, dlaczego historyczny algorytm 3DES (des-ede3) osiąga drastycznie gorsze wyniki wydajnościowe (nawet kilkunastokrotnie wolniejszy od AES). Dyskutujesz wpływ braku natywnych instrukcji AES-NI w maszynie emulowanej JSLinux na rywalizację AES vs ChaCha20. Sporządzasz wykresy porównawcze słupkowe zależności przepustowości od wielkości pakietu danych. Wykonujesz zrzuty ekranu z wykonania testów w JSLinux. Formułujesz wyczerpujące rekomendacje inżynierskie dotyczące doboru algorytmów dla serwerów WWW i urządzeń IoT.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Sprawdź wersję i konfigurację OpenSSL: openssl version -a.
  3. Wykonaj benchmark szyfrów blokowych: openssl speed des-ede3 aes-128-cbc aes-256-cbc > ciphers.txt.
  4. Wykonaj benchmark trybów AEAD: openssl speed -evp aes-128-gcm -evp chacha20-poly1305 > aead.txt.
  5. Wykonaj benchmark funkcji skrótu: openssl speed md5 sha1 sha256 sha512 >hashes.txt.
  6. Wykonaj benchmark SHA-3: openssl speed sha3-256 > sha3.txt.
  7. Napisz w JSLinux skrypt Pythona parse_speed.py przeliczający wyniki na MB/s.
  8. Uruchom skrypt i wygeneruj sformatowaną tabelę przepustowości dla bufora 16B oraz 8192B.
  9. Porównaj wyniki AES-128 i AES-256 (wpływ liczby rund: 10 vs 14).
  10. Porównaj wyniki SHA-256 i SHA-512 dla dużych bloków danych.
  11. Porównaj przepustowość AES-GCM z ChaCha20-Poly1305 w środowisku emulowanym.
  12. Zestaw w tabeli sprawozdania parametry wszystkich 9 przetestowanych algorytmów.
  13. Zinterpretuj przyczyny skrajnie niskiej wydajności 3DES wynikające z 48 cykli Feistela.
  14. Wykonaj zrzuty ekranu konsoli JSLinux z tabelami wynikowymi openssl speed.
  15. Opracuj wykres tekstowy ASCII prezentujący ranking przepustowości algorytmów.
  16. Na początku raportu odnotuj środowisko: wynik openssl version, obecność AES-NI (grep -o aes /proc/cpuinfo | head -1) oraz emulator/natywnie. Wnioski formułuj wyłącznie o krotnościach (np. „3DES ~15× wolniejszy od AES-128 na tym hoście"), nigdy o wartościach bezwzględnych MB/s - liczby z emulatora nie są porównywalne między studentami.
  17. Sformułuj techniczne wnioski dotyczące optymalizacji wydajnościowej stosów kryptograficznych (TLS, VPN).

Kontrola zaliczenia (checklist):

  1. Uruchomiono openssl speed i zachowano log/tabelę: MB/s dla AES/3DES/ChaCha20 i MD5/SHA-1/SHA-256/SHA-512/SHA3 przy blokach 16 B i 8192 B.
  2. Dołączono przetworzone wyniki (własna tabela/wykres): narzut małych bloków, przewaga SHA-512 na 64 bitach, ChaCha20 bez AES-NI.
  3. Przeprowadzono test pozytywny (duże bloki — nasycenie) i negatywny/kontrolny (małe bloki — dominacja narzutu wywołania, powtarzalność 3×).
  4. Opisano w 3–5 zdaniach: architektura vs algorytm, 64-bitowe rejestry, dobór ChaCha20 na mobilne/IoT.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego wielkość bufora danych (16B vs 8192B) ma diametralne znaczenie dla wydajności (minimalizacja narzutu wywołania funkcji).
  • Wpływ architektury 64-bitowej na przewagę wydajnościową SHA-512 nad SHA-256 przy dużych blokach danych.
  • Dlaczego ChaCha20-Poly1305 stanowi doskonałą alternatywę dla AES-GCM na urządzeniach pozbawionych akceleracji AES-NI.
  • Student potrafi posłużyć się narzędziem openssl speed, przetworzyć surowe metryki i wyciągnąć wnioski architektoniczne.
Zadanie 9 - ilustracja
10/10
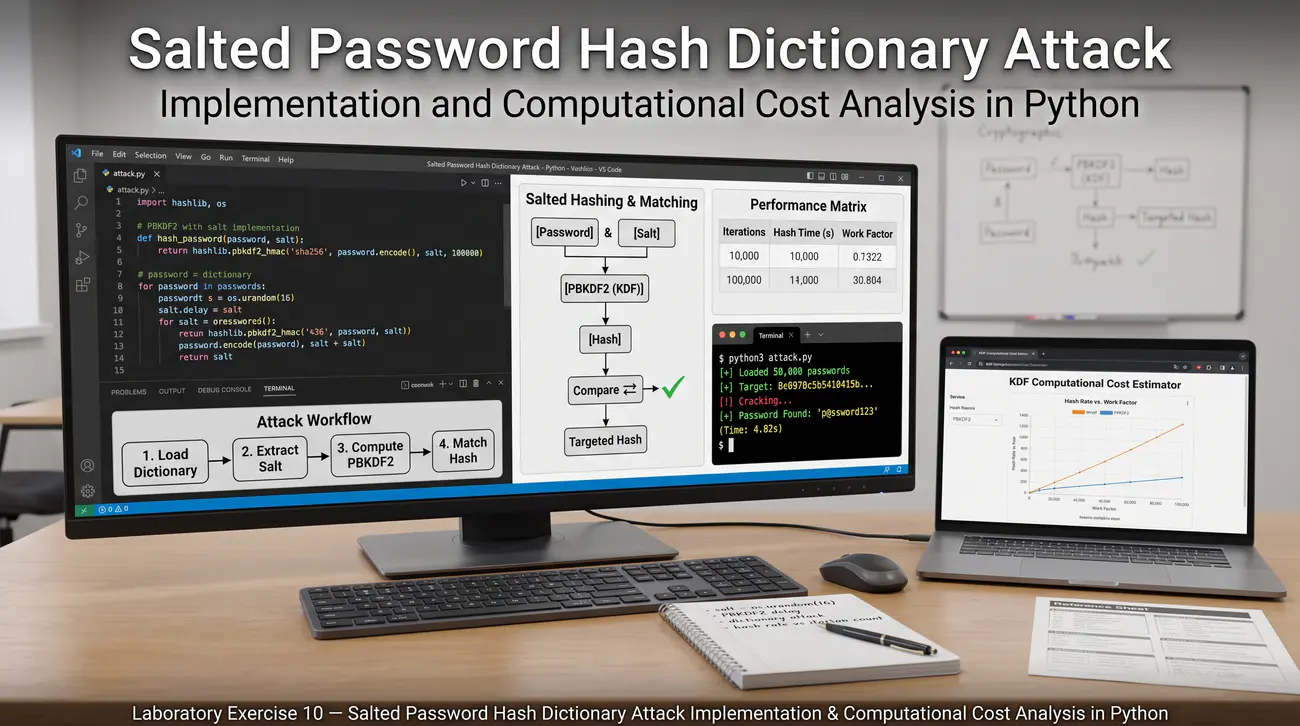
Zadanie 10. Implementacja ataku słownikowego z solą na skróty haseł i analiza kosztu obliczeniowego w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 46, 47, 48: haszowanie haseł, sól (salt), ataki słownikowe, narzut obliczeniowy KDF (PBKDF2), spowalnianie atakującego, analiza kosztu ataku.

Cel

Celem zadania jest zaimplementowanie w języku Python ataku słownikowego na skróty haseł oraz ilościowa analiza porównawcza odporności na łamanie baz haseł chronionych czystym SHA-256 z solą vs funkcją rozciągania klucza PBKDF2 z różną liczbą iteracji. Student modeluje koszt ekonomiczny ataku siłowego na klastrze obliczeniowym.

Scenariusz – opis

W systemach uwierzytelniania powszechnie stosuje się zasadę jednokierunkowego haszowania haseł z kryptograficzną solą. Sól zapobiega atakom z użyciem prekomputowanych tablic tęczowych, zmuszając atakującego do przeliczania słownika od nowa dla każdego użytkownika. Jednak przy użyciu szybkiej funkcji, takiej jak SHA-256, atak słownikowy na pojedynczą sól wciąż wykonuje się w tempie setek milionów prób na sekundę. Aby temu zapobiec, standardy bezpieczeństwa (NIST, OWASP) nakazują stosowanie funkcji KDF o celowo regulowanym koszcie obliczeniowym, takich jak PBKDF2-HMAC-SHA256. Parametr liczby iteracji (np. 10 000, 100 000, 600 000) drastycznie zwiększa koszt ataku po stronie przestępcy, pozostając niemal niezauważalnym dla logującego się użytkownika. W tym laboratorium napiszesz w Pythonie program łamiący hasła i dokonasz matematycznego oszacowania odporności systemów.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine tworzysz plik programu password_cracker.py. Przygotowujesz bazę testową 5 użytkowników z hasłami zabezpieczonymi na dwa sposoby: schematem Salt+SHA256 oraz PBKDF2-HMAC-SHA256 z solą i liczbą iteracji c = 100 000. Tworzysz słownik testowy zawierający 5 000 popularnych haseł oraz kilka haseł trudniejszych. Implementujesz moduł ataku słownikowego dla schematu Salt+SHA256: program iteruje po słowniku, łączy sól z hasłem kandydującym, liczy SHA-256 i porównuje z bazą. Mierzysz dokładny czas wykonania ataku za pomocą modułu time oraz wyliczasz przepustowość w próbach na sekundę.

Następnie implementujesz ten sam atak słownikowy przeciwko bazie PBKDF2 z użyciem funkcji hashlib.pbkdf2_hmac. Obserwujesz drastyczny spadek prędkości testowania haseł (np. z setek tysięcy prób/s do kilkuset prób/s w środowisku procesora). Mierzysz czas potrzebny na sprawdzenie całego słownika dla PBKDF2 z parametrem iteracji równym 1 000, 10 000 oraz 100 000. Opracowujesz matematyczny model ekstrapolacji: obliczasz, ile czasu zajęłoby przeszukanie pełnej przestrzeni 8-znakowych haseł alfanumerycznych (62^8 kombinacji ~ 2.18 * 10^14 haseł).

Porównujesz czas ataku dla czystego SHA-256 vs PBKDF2 przy założeniu użycia klastra 8 kart graficznych RTX 4090. Wykazujesz, że PBKDF2 wydłuża czas ataku z kilku godzin do setek lat, czyniąc go ekonomicznie i praktycznie nierealnym. Analizujesz nowocześniejsze alternatywy, takie jak funkcja pamięciochłonna Argon2id (zwycięzca konkursu PHC). Sporządzasz tabelę zestawień czasów łamania i kosztów sprzętowych.

Wykonujesz zrzuty ekranu z działania skryptu w JSLinux. Kompletujesz sprawozdanie laboratoryjne z wnioskami dotyczącymi zaleceń OWASP Password Storage Cheat Sheet. Sprawdzasz poprawność wszystkich zebranych materiałów badawczych.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano password_cracker.py.
  3. Zaimportuj moduły hashlib, time i binascii.
  4. Zdefiniuj bazę użytkowników z przypisanymi solami i haszami (Salt+SHA256 oraz PBKDF2).
  5. Przygotuj listę słownikową haseł (wbudowaną tablicę lub plik tekstowy).
  6. Zaimplementuj funkcję crack_sha256(user_db, wordlist).
  7. Uruchom atak na SHA-256, zmierz czas i wylicz prędkość (haszy/sekundę).
  8. Zaimplementuj funkcję crack_pbkdf2(user_db, wordlist, iterations).
  9. Uruchom atak na PBKDF2 z parametrem iteracji 1000 i zarejestruj prędkość.
  10. Uruchom atak na PBKDF2 z parametrem iteracji 10 000 oraz 50 000.
  11. Zestaw prędkości ataku dla wszystkich wariantów w tabeli porównawczej.
  12. Napisz funkcję ekstrapolującą czas ataku siłowego na przestrzeń 8-znakową (62^8).
  13. Oblicz czas ataku dla hipotetycznego klastra GPU o wydajności 10 GH/s w SHA-256.
  14. Wykonaj zrzuty ekranu działania skryptu w terminalu JSLinux.
  15. Sporządź raport techniczny zestawiający SHA-256, PBKDF2, bcrypt i Argon2.
  16. Sprawdź aktualne zalecenie OWASP Password Storage Cheat Sheet dla PBKDF2-HMAC-SHA-256 (600 000 iteracji) i dopisz do tabeli wiersz ekstrapolacji dla tej wartości: czas ataku na przestrzeń 62^8 przy zmierzonej przez siebie prędkości PBKDF2 przeskalowanej ×(600 000/100 000). Wniosek ma zawierać zdanie: przy 600 tys. iteracji sama zamiana SHA-256 na PBKDF2 mnoży koszt atakującego ~600 tys. razy - i dopiero Argon2id dokłada do tego koszt pamięci (Zadanie 10 z poziomu 5.0).
  17. Sformułuj wnioski podsumowujące rolę narzutu obliczeniowego w ochronie poświadczeń tożsamości.

Kontrola zaliczenia (checklist):

  1. Uruchomiono atak słownikowy i zachowano log: czas łamania SHA-256 z solą vs PBKDF2 (różne iteracje), przeliczenie na koszt/konto i ekstrapolację.
  2. Dołączono kod (własne min. 25 linii): słownik, sole per konto, pętla PBKDF2 z pomiarem, kalkulator kosztu.
  3. Przeprowadzono test pozytywny (słabe hasło łamane w obu) i negatywny (silne + PBKDF2 wysokie iteracje — niełamane w limicie, koszt oszacowany).
  4. Opisano w 3–5 zdaniach: sól kasuje tęczowe tablice (atak per konto), iteracje mnożą koszt, ekonomia polityki haseł.

Wariant offline (fallback): Brak bibliotek: praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib, struct); openssl speed zastąp pomiarem time w Pythonie; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego obecność soli zmusza atakującego do indywidualnego ataku na każde konto, unieważniając tablice tęczowe.
  • W jaki sposób funkcja PBKDF2 wielokrotnie zwiększa koszt czasowy sprawdzenia każdego hasła w słowniku.
  • Rola modelowania kosztu ekonomicznego ataku w projektowaniu polityki haseł i doborze parametrów KDF.
  • Student potrafi zaimplementować atak słownikowy w Pythonie, zmierzyć przepustowość i dokonać poprawnej ekstrapolacji matematycznej.
Zadanie 10 - ilustracja
Podgląd