Laboratorium 3
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 5.0

Poziom: ocena 5.0 - zaawansowana kryptoanaliza rekonstrukcyjna, ataki na procedury i modele matematyczne

Zestaw 10 wysoce specjalistycznych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 3 (kryptografia symetryczna - nowoczesne algorytmy i funkcje skrótu).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 5.0 koncentrują się na zaawansowanych problemach kryptoanalitycznych, rekonstrukcji danych przy błędach procedur kryptograficznych oraz implementacji modeli matematycznych w języku Python w środowisku konsolowym emulatora JSLinux Alpine.
  • Tematyka zadań obejmuje m.in.: atak Meet-in-the-Middle na podwójny szyfr blokowy (2DES), pełny atak wyroczni dopełnienia (Padding Oracle Attack) na tryb CBC, kryptoanalizę korelacji pierwszych bajtów RC4 (atak FMS na WEP), rekonstrukcję arytmetyki ciała Galois GF(2^8) w warstwie MixColumns AES i kryptoanalizę macierzy MDS, inspekcję binarną par kolizyjnych MD5 (atak Wanga) oraz SHA-1 (SHAttered), implementację konstrukcji gąbki (Sponge Construction) i permutacji Keccak w SHA-3, matematyczną weryfikację funkcji MAC Poly1305 w ciele Z_(2^130 - 5), atak fałszowania wiadomości MitM na tunel z szyfrem ChaCha20 bez MAC, badanie nieliniowości S-boksów DES tabelą rozkładu różnic DDT pod kątem kryptoanalizy różnicowej oraz modelowanie kosztu pamięciowego ataków ASIC/GPU na KDF Argon2id i scrypt.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (5.0).
    • Szczegółowy opis aparatu matematycznego i logicznego leżącego u podstaw przeprowadzonego ataku kryptoanalitycznego.
    • Pełny kod źródłowy autorskich skryptów w języku Python z komentarzami objaśniającymi kluczowe algorytmy i struktury danych.
    • Dowody empiryczne: zrzuty ekranu konsoli, wygenerowane tabele wyników, logi odzyskiwania stanów pośrednich lub wykresy zbieżności.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami), wykaz literatury naukowej i standardów.
Kryptologia
lab 3 - 5.0
Spis
Spis zadań laboratoryjnych na ocenę 5.0
01/10
Zadanie 1. Kryptoanaliza ataku Meet-in-the-Middle na podwójny szyfr blokowy w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 10, 11: algorytm DES, kaskadowanie szyfrów, podwójny DES (2DES), atak Meet-in-the-Middle Diffiego-Hellmana, redukcja złożoności z 2^112 do 2^57, uzasadnienie schematu 3DES EDE.

Cel

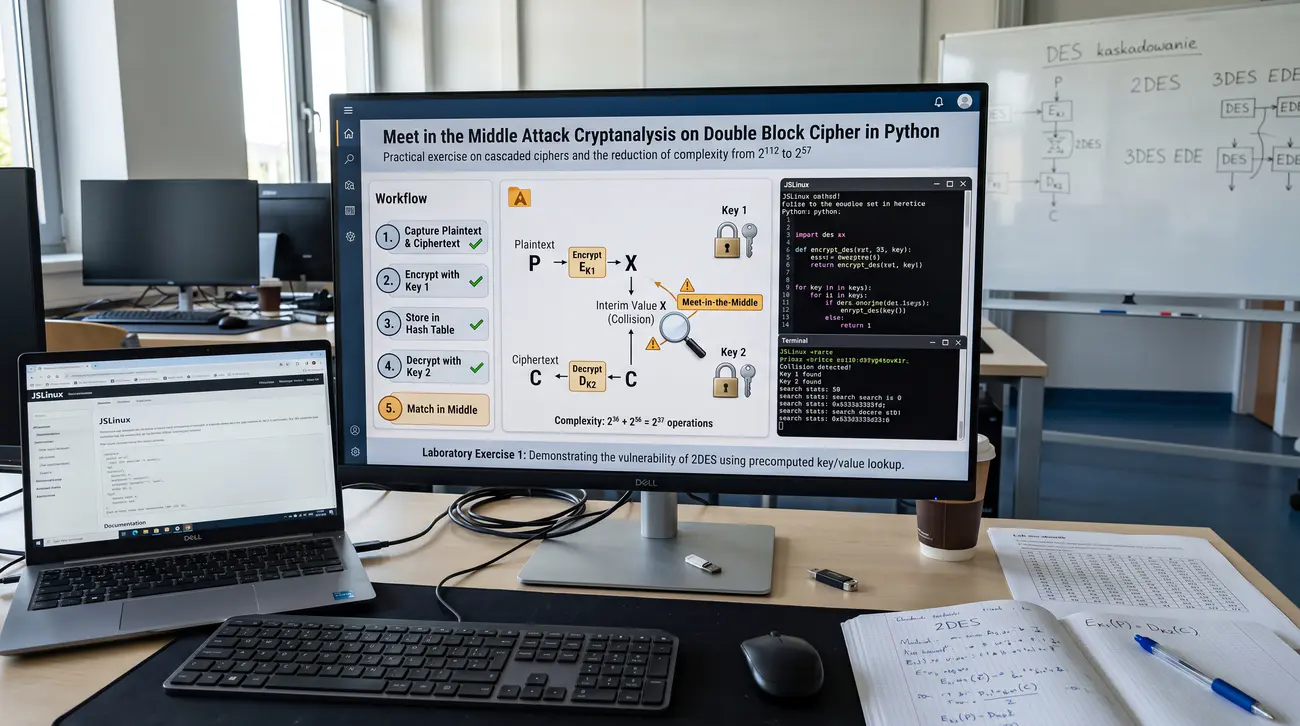
Celem zadania jest matematyczna i programistyczna rekonstrukcja klasycznego ataku Meet-in-the-Middle na podwójny szyfr blokowy (2DES). Student implementuje w języku Python zredukowany model szyfru blokowego, buduje w pamięci RAM tablicę haszującą stanów pośrednich i przeprowadza atak zderzeniowy ze znanym tekstem jawnym w czasie O(2^k) zamiast O(2^(2k)), udowadniając dlaczego standard 3DES musiał wykorzystywać schemat z trzema operacjami.

Scenariusz – opis

Gdy na początku lat 90. przestrzeń 56 bitów klucza DES stała się zbyt mała, naturalną propozycją było podwójne zaszyfrowanie danych dwoma niezależnymi kluczami K1 i K2 (2DES): C = E_K2(E_K1(P)). Wydawało się, że 112-bitowy łączny klucz zapewni bezpieczeństwo rzędu 2^112 operacji, co uniemożliwiłoby jakikolwiek atak siłowy. Jednak Witfield Diffie i Martin Hellman wykazali, że dysponując jedną lub dwiema znanymi parami (tekst jawny P, szyfrogram C), szyfr 2DES można złamać atakiem Meet-in-the-Middle kosztem zaledwie 2^57 operacji. Atak polega na szyfrowaniu P wszystkimi możliwymi kluczami K1 i zapisaniu stanów pośrednich X = E_K1(P) w tablicy haszującej w pamięci RAM. Następnie atakujący deszyfruje C wszystkimi możliwymi kluczami K2: Y = D_K2(C) i szuka kolizji X == Y w tablicy. W tym zadaniu zaimplementujesz w Pythonie w JSLinux ten atak na zredukowanym modelu blokowym i dokonasz analizy złożoności czasowo-pamięciowej.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine otwierasz edytor i tworzysz program mitm_attack.py. Implementujesz prosty szyfr blokowy na 32-bitowych blokach ze zredukowaną przestrzenią klucza o długości 20 bitów (1 048 576 możliwych wartości) lub 24 bitów. Generujesz losowo dwa tajne klucze docelowe K1 oraz K2 z przestrzeni 2^20. Szyfrujesz testowy tekst jawny P1 podwójnym szyfrem: C1 = Encrypt(K2, Encrypt(K1, P1)).

Dla ujednoznacznienia wyniku generujesz również drugą parę kontrolną (P2, C2) z tymi samymi kluczami. W module kryptoanalitycznym rezerwujesz słownik w Pythonie do przechowywania stanów pośrednich. Faza 1 (w przód): iterujesz po wszystkich 2^20 kluczach k_candidate1, obliczasz stan pośredni mid = Encrypt(k_candidate1, P1) i zapisujesz w słowniku parę {mid: k_candidate1}. Mierzysz czas trwania fazy 1 oraz zużycie pamięci operacyjnej.

Faza 2 (w tył): iterujesz po wszystkich 2^20 kluczach k_candidate2, obliczasz mid_dec = Decrypt(k_candidate2, C1) i sprawdzasz w czasie O(1), czy mid_dec istnieje w słowniku. Po znalezieniu kolizji mid_dec w słowniku odzyskujesz parę kandydatów (K1_cand, K2_cand). Weryfikujesz odzyskane klucze na drugiej parze (P2, C2), aby wyeliminować ewentualne fałszywe zderzenia losowe. Wypisujesz odzyskane klucze w konsoli i porównujesz je z oryginalnymi kluczami K1 i K2, potwierdzając ich stuprocentową zgodność.

Wyliczasz łączną liczbę wykonanych operacji (2 * 2^20 = 2^21 operacji) i porównujesz ją z naiwnym atakiem brute force wymagającym 2^40 operacji. Dokonujesz matematycznej ekstrapolacji: wykazujesz, dlaczego dla pełnego DES atak wymaga 2^56 pamięci i 2^57 czasu, co doprowadziło do stworzenia 3DES o konstrukcji EDE (168 bitów). Wykonujesz zrzuty ekranu z wykonania programu w konsoli JSLinux. Formułujesz formalne wnioski kryptoanalityczne do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Utwórz plik programu: nano mitm_attack.py.
  3. Zaimportuj moduły time, os, sys.
  4. Zaimplementuj uproszczony szyfr blokowy SPN (lub zredukowany DES) na słowach 32-bitowych.
  5. Zdefiniuj przestrzeń klucza N_BITS = 20 (zakres 0 do 1 048 575).
  6. Zaimplementuj funkcję double_encrypt(p, k1, k2).
  7. Wylosuj klucze docelowe K1, K2 i wygeneruj pary znane (P1, C1) oraz (P2, C2).
  8. Zaimplementuj fazę 1 ataku: budowę słownika stanów pośrednich {E_k1(P1): k1}.
  9. Zarejestruj czas trwania fazy 1 i rozmiar słownika w pamięci RAM.
  10. Zaimplementuj fazę 2: przeszukiwanie k2 i testowanie obecności D_k2(C1) w słowniku.
  11. Zaimplementuj filtr eliminacji fałszywych alarmów przy użyciu pary (P2, C2).
  12. Wypisz odnaleziony klucz K1 i K2 oraz czas wykonania fazy 2.
  13. Potwierdź zgodność odzyskanych kluczy z tajnymi kluczami generującymi.
  14. Sporządź tabelę: Przestrzeń klucza k, Złożoność brute force 2^(2k), Złożoność MitM 2^(k+1), Pamięć O(2^k).
  15. Trzy liczby do raportu (osobna ramka): czas naiwny 2^(2k), czas MitM 2^(k+1) ≈ 2·2^k, pamięć MitM 2^k stanów pośrednich - oraz jedno zdanie: trzecie szyfrowanie w 3DES łamie symetrię ataku, bo środkowe deszyfrowanie D_K2 nie daje już wspólnego stanu pośredniego spotykanego z obu stron naraz, więc MitM nie składa się w parę (K1,K2) jednym zderzeniem.
  16. Wykonaj zrzuty ekranu konsoli JSLinux z wynikami działania ataku.
  17. Sformułuj techniczne uzasadnienie, dlaczego standard Triple DES musiał zastosować 3 rundy (EDE: K1, K2, K3) i przestrzeń 168 bitów.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano MitM na 2DES na wektorze ze startera (zredukowany szyfr): tablica stanów pośrednich w RAM, odzyskane oba podklucze bez 2^(2k) prób.
  2. Wykazano różnicę: weryfikator 2DES (łamany w ~2^k) vs 3DES-EDE (odporny, ~2^112); dołączono oba logi i pomiar pamięci.
  3. Dołączono log ataku (rozmiar tablicy, trafienie pośrednie) + kod łatki (3DES-EDE / AES-128, zakaz 2DES).
  4. Opisano w 3–5 zdaniach kompromis czas–pamięć O(2^k)/O(2^k), 57 zamiast 112 bitów, EDE jako minimum.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób atak Meet-in-the-Middle zamienia złożoność czasową O(2^(2k)) na złożoność pamięciową O(2^k).
  • Dlaczego podwójne szyfrowanie blokowe 2DES nie podwaja efektywnej siły kryptograficznej szyfru (57 bitów zamiast 112 bitów).
  • Rola potrójnego szyfrowania 3DES w schemacie EDE jako minimalnej konstrukcji gwarantującej odporność na atak MitM (złożoność 2^112 operacji).
  • Student potrafi zaimplementować atak Meet-in-the-Middle w Pythonie i dokonać rygorystycznej oceny kompromisu czasowo-pamięciowego.
Zadanie 1 - ilustracja
02/10
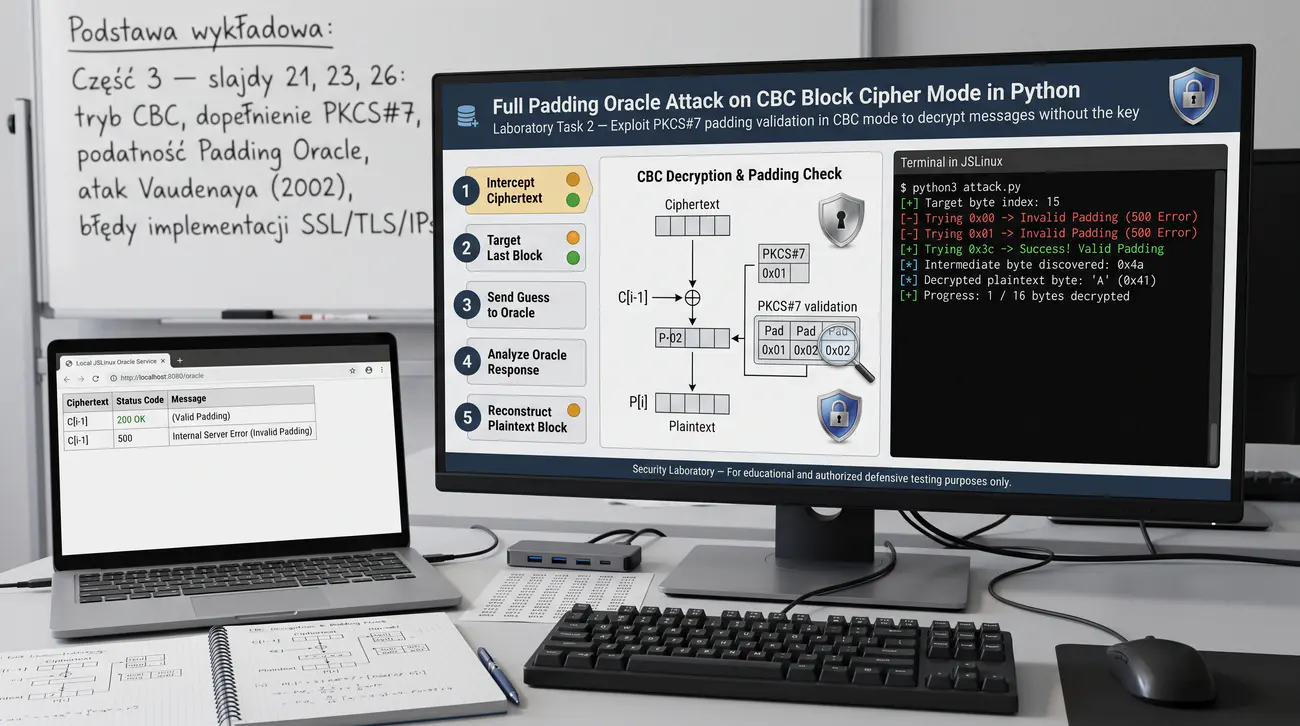
Zadanie 2. Pełny atak wyroczni dopełnienia na tryb CBC szyfru blokowego w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 21, 23, 26: tryb CBC (Cipher Block Chaining), dopełnienie PKCS#7, podatność Padding Oracle, atak Vaudenaya (2002), błędy implementacji protokołów SSL/TLS/IPsec.

Cel

Celem zadania jest zaimplementowanie w języku Python pełnego ataku wyroczni dopełnienia (Padding Oracle Attack) na szyfrogram zabezpieczony w trybie CBC ze standaryzowanym dopełnieniem PKCS#7. Student odzyskuje bajt po bajcie cały tekst jawny bez jakiejkolwiek znajomości klucza tajnego, wysyłając spreparowane wektory do podatnej wyroczni deszyfrującej.

Scenariusz – opis

Atak wyroczni dopełnienia (ang. Padding Oracle Attack), opublikowany przez Serge'a Vaudenaya w 2002 roku, jest jednym z najbardziej niszczycielskich ataków na tryb CBC. Występuje on w systemach, w których serwer po odszyfrowaniu wiadomości zwraca informację, czy dopełnienie PKCS#7 było poprawne (kod 200/poprawny padding vs błąd 500/bad padding). W trybie CBC deszyfrowanie bloku C_1 daje stan pośredni I_1 = D_K(C_1), po czym tekst jawny wyliczany jest jako P_1 = I_1 XOR C_0 (gdzie C_0 to wektor IV). Modyfikując ostatni bajt wektora C_0 i testując reakcję wyroczni na 256 możliwych wartości, atakujący może wymusić, aby ostatni bajt tekstu jawnego przyjął poprawny padding 0x01. Gdy wyrocznia zaakceptuje padding, atakujący poznaje stan pośredni I_1[15] = C'_0[15] XOR 0x01, co pozwala na natychmiastowe obliczenie oryginalnego tekstu jawnego P_1[15] = I_1[15] XOR C_0[15]! W tym zadaniu zaimplementujesz w Pythonie w JSLinux zarówno podatną wyrocznię, jak i zautomatyzowanego klienta kryptoanalitycznego.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine otwierasz edytor nano i tworzysz program padding_oracle.py. Implementujesz funkcję wyroczni oracle(iv, ciphertext): funkcja odszyfrowuje dane tajnym kluczem AES-128-CBC i sprawdza poprawność paddingu PKCS#7, zwracając True (padding poprawny) lub False (błąd). Klucz AES jest ukryty wewnątrz wyroczni i żaden zewnętrzny moduł nie ma do niego dostępu. Przygotowujesz tajną wiadomość tekstową o długości kilkunastu znaków, na przykład 'TAJNE_HASLO_ADMINA=X92!', i szyfrujesz ją do postaci (IV, Ciphertext).

W module kryptoanalitycznym piszesz funkcję atakującą pojedynczy 16-bajtowy blok szyfrogramu. Zaczynasz od ostatniego bajtu (indeks 15): preparujesz fałszywy wektor IV_mod i iterujesz po 256 wartościach bajtu IV_mod[15]. Gdy wyrocznia zwróci True, zapisujesz znaleziony bajt pośredni: intermediate[15] = val XOR 0x01.

Następnie przechodzisz do bajtu 14: ustawiasz bajt 15 na wartość intermediate[15] XOR 0x02, aby wymusić padding 0x02 0x02, i iterujesz po 256 wartościach dla bajtu 14. Powtarzasz tę procedurę wstecz dla wszystkich bajtów od 15 do 0, odzyskując pełny 16-bajtowy wektor stanu pośredniego I_1. Odzyskujesz oryginalny tekst jawny bloku: P_1 = intermediate XOR oryginalny_IV. Rozszerzasz atak na wieloblokowe szyfrogramy, traktując blok C_(k-1) jako wektor IV dla bloku C_k.

Wypisujesz odszyfrowaną wiadomość jawną w konsoli, weryfikując pełną zgodność z oryginałem. Mierzysz liczbę zapytań do wyroczni: wykazujesz, że odzyskanie 16 bajtów wymaga średnio zaledwie 16 * 128 = 2048 zapytań zamiast 2^128. Analizujesz historyczne podatności w protokołach ASP.NET, Java JSSE oraz atak POODLE na SSLv3. Wykonujesz zrzuty ekranu konsoli JSLinux prezentujące krok po kroku odzyskiwanie kolejnych bajtów tekstu. Formułujesz wnioski techniczne dotyczące konieczności stosowania szyfrowania uwierzytelnionego AEAD (AES-GCM).

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano padding_oracle.py.
  3. Zaimplementuj bezpieczną procedurę weryfikacji paddingu PKCS#7: check_pkcs7_padding( plaintext).
  4. Zaimplementuj wyrocznię: padding_oracle(iv, ciphertext) zwracającą True/False.
  5. Zaszyfruj tajną wiadomość AES-128-CBC i uzyskaj parę (IV, Ciphertext).
  6. Zaimplementuj funkcję attack_byte(target_block, prev_block, byte_index, intermediate_known) według szkieletu: (a) zbuduj IV_mod kopiując prev_block i wstawiając znane bajty intermediate_known[j] XOR pad dla j > byte_index; (b) iteruj v od 0 do 255 jako kandydata IV_mod[byte_index]; (c) pierwsze True z wyroczni kończy pętlę. Zanim zaatakujesz pełny blok, zalicz test minimalny: odszyfruj 1-bajtowe dopełnienie (blok, którego jawny tekst kończy się poprawnym 0x01) - ten test rozstrzyga, czy wyrocznia i pętla działają, zanim zaczniesz nocne debugowanie całości.
  7. Zaimplementuj pętlę ataku odzyskującą stan pośredni intermediate dla bajtów od 15 do 0.
  8. Zastosuj regułę XOR stanu pośredniego z oryginalnym blokiem poprzedzającym, odzyskując tekst jawny.
  9. Zaimplementuj obsługę odszyfrowywania wielu bloków szyfrogramu.
  10. Uruchom atak i obserwuj pojawiające się litery odszyfrowywanego tekstu w czasie rzeczywistym.
  11. Wypisz w konsoli końcowy odzyskany tekst jawny.
  12. Policz łączną liczbę zapytań HTTP/funkcyjnych wysłanych do wyroczni.
  13. Porównaj złożoność ataku wyroczni (O(256 * B)) ze złożonością ataku siłowego (O(2^(8*B))).
  14. Wykonaj zrzuty ekranu z konsoli prezentujące odzyskiwanie tekstu bajt po bajcie.
  15. Opisz mechanizm mitygacji: dlaczego odpowiedź serwera na błąd deszyfrowania musi być generyczna i wykonywana w stałym czasie.
  16. Sformułuj wnioski podsumowujące wyższość schematów AEAD (AES-GCM, ChaCha20-Poly1305) nad CBC.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano padding oracle na CBC na wektorze ze startera: bajt po bajcie odzyskano cały tekst samą wyrocznią paddingu, bez klucza (≤256 prób/bajt).
  2. Wykazano różnicę: weryfikator podatny (rozróżnia padding — pełny odzysk) vs AEAD/szyfrowanie-then-MAC (jednolity błąd, brak wycieku); dołączono logi.
  3. Dołączono log ataku (manipulacje IV/blokiem, kolejne bajty P) + kod łatki (encrypt-then-MAC / AES-GCM, stały czas).
  4. Opisano w 3–5 zdaniach kompromis: 1 bit wycieku wystarcza, liniowość P=D(C)⊕IV, CBC usunięte z TLS 1.3.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób wyciek informacji o poprawności paddingu tworzy kanał boczny umożliwiający deszyfrowanie bez klucza.
  • Liniowość zależności P = D_K(C) XOR IV i możliwość precyzyjnego kontrolowania tekstu jawnego przez manipulację wektorem IV.
  • Radykalna redukcja złożoności obliczeniowej: odzyskanie bajtu wymaga maksymalnie 256 prób zamiast przeszukania przestrzeni klucza.
  • Student potrafi od podstaw zaprogramować i przeprowadzić skuteczny atak wyroczni dopełnienia w środowisku Linux.
Zadanie 2 - ilustracja
03/10
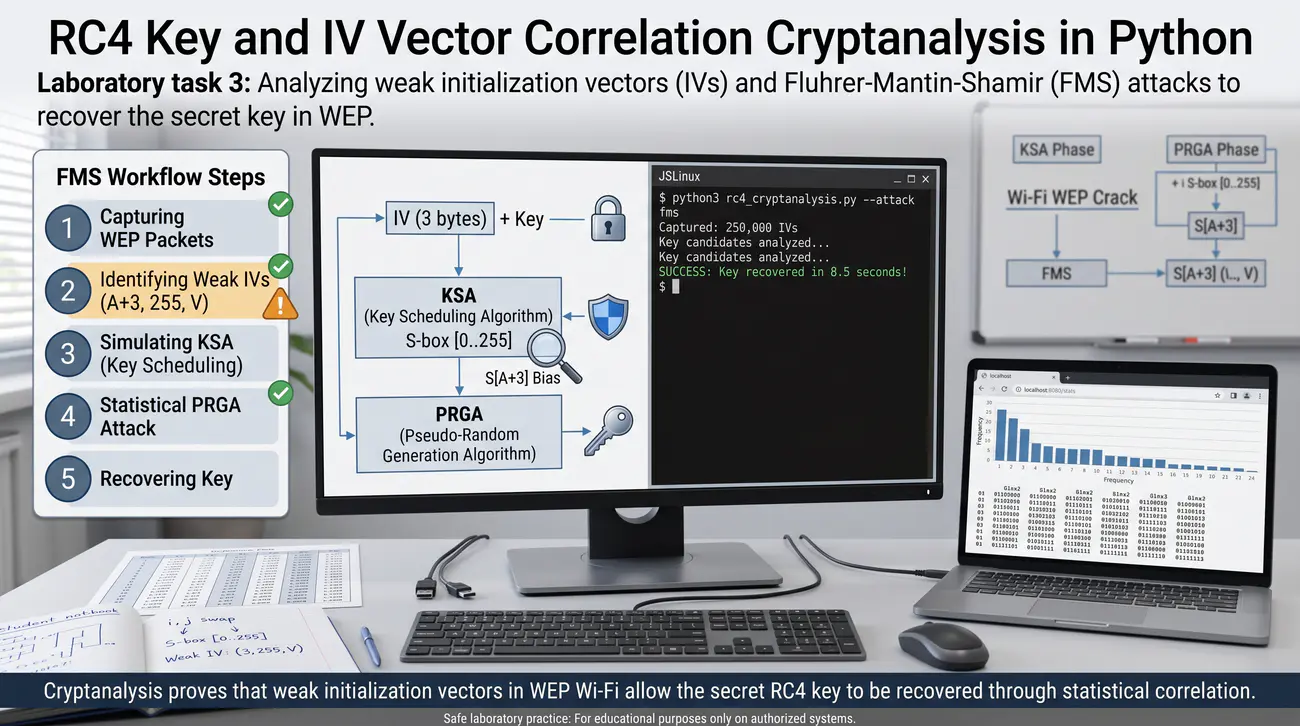
Zadanie 3. Kryptoanaliza korelacji klucza i wektora IV w szyfrze RC4 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 27, 28, 29: algorytm RC4, faza KSA, faza PRGA, słabe wektory IV, atak Fluhrera-Mantina-Shamira (FMS), złamanie protokołu WEP w Wi-Fi.

Cel

Celem zadania jest zrekonstruowanie w języku Python klasycznego ataku FMS (Fluhrer-Mantin-Shamir) na algorytm RC4, który doprowadził do załamania protokołu WEP w sieciach bezprzewodowych. Student bada zjawisko korelacji pomiędzy stanem tablicy S po fazie KSA a pierwszym bajtem strumienia PRGA dla tzw. słabych wektorów IV i odzyskuje bajt tajnego klucza metodą statystyczną.

Scenariusz – opis

W 2001 roku Scott Fluhrer, Itsik Mantin i Adi Shamir opublikowali przełomową pracę wykazującą, że faza inicjalizacji KSA w szyfrze RC4 nie rozprasza dostatecznie szybko entropii klucza. W protokole WEP klucz szyfrujący każdy pakiet powstawał przez proste połączenie 3-bajtowego jawnego wektora IV oraz tajnego klucza stałego: Key = IV || MasterKey. Autorzy ataku wykazali, że gdy wektor IV ma postać (B + 3, 255, V), gdzie B to indeks zgadywanego bajtu klucza głównego, to z prawdopodobieństwem około 5% (zamiast losowego 1/256 ~ 0.4%) pierwszy bajt wyjściowy strumienia PRGA spełnia równość: S_output[0] = j + S[B+3] + K[B]. Oznacza to, że podsłuchując kilkaset pakietów zawierających specyficzne, słabe wektory IV, atakujący może odgadnąć kolejne bajty tajnego klucza drogą głosowania statystycznego. W tym laboratorium zaimplementujesz symulator podsłuchu pakietów WEP oraz moduł statystycznego odzyskiwania klucza w Pythonie w JSLinux. Przetestujesz atak na wygenerowanym zbiorze danych i zweryfikujesz poprawność odzyskanego sekretu.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine otwierasz edytor nano i tworzysz plik fms_attack.py. Implementujesz algorytm RC4 od podstaw: funkcję ksa(key) inicjalizującą 256-bajtową tablicę permutacji S oraz funkcję prga(S, n) generującą n bajtów strumienia. Definiujesz stały tajny klucz główny MasterKey, na przykład 5 bajtów (40 bitów, standard WEP): [0x1A, 0x2B, 0x3C, 0x4D, 0x5E]. Tworzysz generator pakietów: dla każdego pakietu losujesz lub generujesz systematycznie 3-bajtowy wektor IV, łączysz go z MasterKey i generujesz pierwszy bajt strumienia.

Piszesz funkcję filtrującą pakiety: wybierasz wyłącznie te, które posiadają tzw. słaby wektor IV dla odzyskiwanego bajtu B, czyli IV[0] = B + 3 oraz IV[1] = 255. Dla każdego takiego pakietu symulujesz pierwsze B+3 kroki fazy KSA, odtwarzając stan permutacji S. Obliczasz kandydata na wartość bajtu klucza K[B] według wzoru FMS: k_cand = (first_output_byte - j - S[B+3]) mod 256. Inkrementujesz licznik w 256-elementowej tablicy głosowania (ang. voting array) dla kandydata k_cand.

Gromadzisz statystyki dla kilkuset słabych pakietów i analizujesz rozkład głosów. Wypisujesz histogram głosów w konsoli i obserwujesz, że poprawna wartość bajtu klucza K[B] uzyskuje wyraźną przewagę nad tłem szumu losowego. Wybierasz wartość o największej liczbie wskazań jako odzyskany bajt klucza. Powtarzasz procedurę sekwencyjnie dla kolejnych bajtów klucza głównego B = 0, 1, 2, 3, 4. Odzyskujesz pełny 40-bitowy klucz WEP i porównujesz go z kluczem MasterKey, potwierdzając sukces ataku. Sporządzasz tabelę przedstawiającą liczbę pakietów wymaganą do odzyskania każdego kolejnego bajtu.

Wykonujesz zrzuty ekranu konsoli JSLinux dokumentujące rozkład głosów i triumf ataku FMS. Formułujesz wnioski podsumowujące dlaczego naiwne łączenie IV z kluczem w szyfrach strumieniowych jest katastrofalnym błędem projektowym.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano fms_attack.py.
  3. Zaimplementuj w Pythonie algorytm KSA i generator PRGA dla RC4.
  4. Zdefiniuj tajny klucz MasterKey o długości 5 bajtów (klucz 40-bitowy WEP).
  5. Napisz funkcję generującą pakiety ze słabymi wektorami IV postaci (B+3, 255, X).
  6. Zasymuluj podsłuchanie pierwszego bajtu szyfrogramu przy znanym pierwszym bajcie tekstu (nagłówek SNAP w 802.11: 0xAA).
  7. Wyodrębnij pierwszy bajt strumienia PRGA: keystream_0 = ciphertext_0 XOR 0xAA.
  8. Zaimplementuj częściową symulację KSA do kroku B+2 dla każdego przechwyconego pakietu.
  9. Oblicz głosowaną wartość kandydata bajtu klucza k_cand dla każdego pakietu.
  10. Zbuduj tablicę zliczeń (votes) o rozmiarze 256 elementów dla badanego bajtu B.
  11. Zgromadź około 300 słabych pakietów dla bajtu B=0 i wypisz kandydata z maksymalną liczbą głosów. Generator przechwytów zbuduj według szkieletu (5000 pakietów na każdy bajt B): for _ in range(5000): iv = bytes([ B + 3, 255, random.randrange(256)]); keystream_0 = rc4_first_byte(iv + MASTERKEY); zapisz (iv, keystream_0). Kryterium stopu dla każdego bajtu: zwycięzca głosowania jest stabilny (ten sam kandydat wygrywa) przez kolejne 50 pakietów i ma przewagę co najmniej 2× nad drugim kandydatem; w przeciwnym razie dobieraj pakiety, nie zmieniaj wzoru FMS.
  12. Zweryfikuj zgodność odzyskanego bajtu z wartością MasterKey[0].
  13. Rozszerz pętlę ataku na odzyskiwanie kolejnych bajtów B=1, 2, 3, 4 z wykorzystaniem już odzyskanych wartości.
  14. Wypisz kompletny odzyskany klucz w postaci szesnastkowej.
  15. Wykonaj zrzuty ekranu działania skryptu w JSLinux z widocznym pikiem statystycznym w tablicy głosów.
  16. Sformułuj techniczne wnioski wyjaśniające genezę narzędzi Aircrack-ng i konieczność przejścia z WEP na WPA2/WPA3.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak FMS na RC4/WEP na wektorze ze startera: ze słabych IV (Key=IV||secret) odzyskano bajty sekretu statystyką korelacji KSA.
  2. Wykazano różnicę: weryfikator WEP (IV jawny, korelacje ~5% vs 0.4% szumu — klucz odzyskiwany) vs odrzucenie IV / porzucenie RC4; dołączono rozkłady.
  3. Dołączono log ataku (głosowania na bajty klucza, wzmocnienie) + kod łatki (zakaz RC4, AES-CCMP/GCM, losowy nonce).
  4. Opisano w 3–5 zdaniach kompromis: niepełne mieszanie KSA, format IV||secret jako błąd, statystyka pokonuje szum.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób niepełne wymieszanie stanu tablicy S w fazie KSA zachowuje bezpośrednią korelację z początkowymi bajtami klucza.
  • Dlaczego używanie stałego klucza z jawnym licznikiem IV w formacie Key = IV || Secret kompromituje bezpieczeństwo szyfrów strumieniowych.
  • Mechanizm wzmocnienia statystycznego FMS: przewaga poprawnego kandydata (p ~ 5%) nad szumem losowym (p ~ 0.4%) pozwala na odzyskanie klucza.
  • Student potrafi zaimplementować kryptoanalityczny atak FMS na RC4 w Pythonie i zinterpretować wyniki rozkładu statystycznego.
Zadanie 3 - ilustracja
04/10
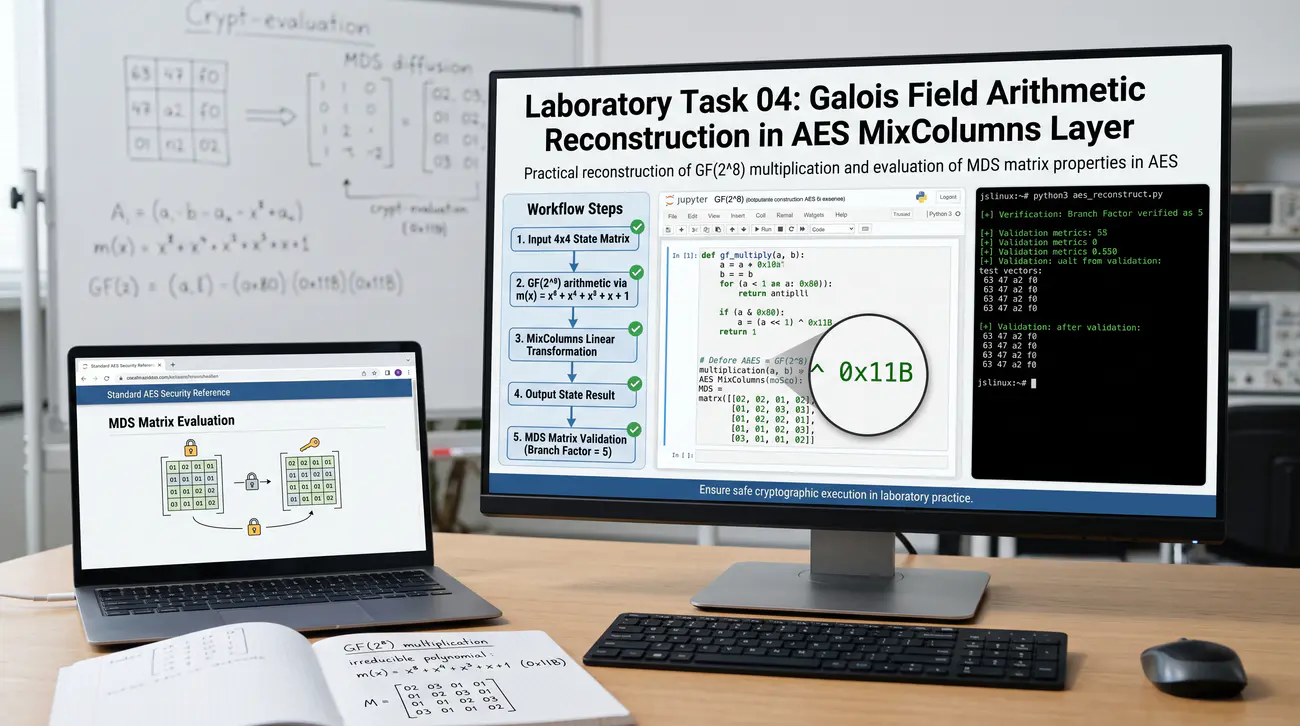
Zadanie 4. Rekonstrukcja arytmetyki ciała Galois w warstwie MixColumns AES i kryptoanaliza MDS
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 12, 16, 17, 20: standard AES (Rijndael), ciało skończone GF(2^8), wielomian nierozkładalny m(x) = x^8 + x^4 + x^3 + x + 1 (0x11B), warstwa MixColumns, macierz MDS, współczynnik Branch Number = 5, macierz odwrotna InvMixColumns.

Cel

Celem zadania jest samodzielna implementacja pełnej arytmetyki ciała skończonego Galois GF(2^8) w języku Python oraz zbadanie matematycznych właściwości warstwy dyfuzyjnej MixColumns szyfru AES. Student programuje mnożenie wielomianowe modulo m(x), implementuje transformację MixColumns oraz InvMixColumns, dowodzi własności macierzy MDS (Maximum Distance Separable) i wyznacza współczynnik dyfuzji Branch Number.

Scenariusz – opis

Najbardziej zaawansowaną matematycznie operacją pojedynczej rundy AES jest transformacja MixColumns, odpowiedzialna za dyfuzję wewnątrz kolumny macierzy stanu. Każdy bajt macierzy stanu jest traktowany jako element ciała skończonego Galois GF(2^8) (reprezentowany przez wielomian stopnia co najwyżej 7 o współczynnikach binarnych). Mnożenie dwóch elementów w tym ciele odbywa się modulo nierozkładalny wielomian m(x) = x^8 + x^4 + x^3 + x + 1, odpowiadający szesnastkowo wartości 0x11B. Operacja MixColumns polega na pomnożeniu 4-elementowego wektora kolumny przez stałą macierz cykliczną o współczynnikach {02, 03, 01, 01}. Macierz ta została dobrana jako macierz MDS (Maximum Distance Separable), co gwarantuje, że suma liczby niezerowych bajtów na wejściu i wyjściu wynosi co najmniej 5 (Branch Number = 5). W tym zadaniu zaimplementujesz w Pythonie pełną arytmetykę ciała GF(2^8) oraz przeprowadzisz analizę dyfuzyjną macierzy MDS.

Co ma wykonać student / grupa

W terminalu JSLinux Alpine otwierasz edytor nano i tworzysz program gf28_mixcolumns.py. Implementujesz dodawanie w ciele GF(2^8) jako operację bitowego XOR: add_gf(a, b) = a ^ b. Implementujesz mnożenie przez x (funkcję xtime) z redukcją modulo 0x11B przy przepełnieniu bitu 7. Implementujesz uniwersalne mnożenie dwóch dowolnych bajtów mul_gf(a, b) metodą Russian Peasant (algorytm przesunięć i warunkowego XOR).

Alternatywnie generujesz w pamięci tablice logarytmów i antylogarytmów (potęg generatora g = 0x03) w celu natychmiastowego mnożenia. Tworzysz funkcję realizującą transformację MixColumns na pojedynczej kolumnie [s0, s1, s2, s3] za pomocą zdefiniowanego mnożenia w ciele Galois.

Następnie definiujesz współczynniki macierzy odwrotnej InvMixColumns: {0E, 0B, 0D, 09} w formacie szesnastkowym. Implementujesz funkcję inv_mix_columns(col) i dowodzisz matematycznej odwracalności: InvMixColumns(MixColumns(col)) == col dla dowolnego wektora wejściowego.

Przechodzisz do badania właściwości MDS i wyznaczenia współczynnika rozproszenia (Branch Number). Piszesz pętlę testową sprawdzającą wszystkie możliwe wektory wejściowe o wadze Hamminga równej 1 (dokładnie jeden niezerowy bajt, 4 * 255 kombinacji). Mierzysz wagę Hamminga wektora wyjściowego (liczbę niezerowych bajtów po operacji MixColumns). Wykazujesz empirycznie, że dla każdego pojedynczego niezerowego bajtu na wejściu (waga = 1), wyjście ma wagę dokładnie 4 niezerowe bajty, co daje sumę 1 + 4 = 5. Sprawdzasz wektory o wadze wejściowej 2, 3 i 4, potwierdzając, że suma wag waga(in) + waga(out) zawsze spełnia nierówność >= 5. Sporządzasz tabelę rozkładu wag wejście/wyjście oraz zestawienie operacji arytmetycznych w GF(2^8).

Wykonujesz zrzuty ekranu konsoli JSLinux z wykonaniem dowodu empirycznego MDS. Formułujesz wyczerpujące wnioski do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine.
  2. Utwórz plik programu: nano gf28_mixcolumns.py.
  3. Zaimplementuj funkcję dodawania w ciele GF(2^8) add_gf(a, b).
  4. Zaimplementuj funkcję mnożenia xtime(a) z redukcją wielomianem 0x11B.
  5. Zaimplementuj uniwersalne mnożenie mul_gf(a, b) metodą algorytmu Rosyjskich Chłopów.
  6. Wygeneruj tablice tabelaryczne exp_table i log_table dla generatora 0x03 i zweryfikuj ich poprawność.
  7. Zaimplementuj operację mix_column(col) z macierzą [[2,3,1,1],[1,2,3,1],[1,1,2,3],[3,1,1,2]].
  8. Zaimplementuj operację inv_mix_column(col) z macierzą odwrotną [[14,11,13,9],[9,14,11,13],[13,9,14,11],[11,13,9,14]].
  9. Przetestuj poprawność odwracalności na wektorze testowym FIPS 197: [0xd4, 0xbf, 0x5d, 0x30] -> [0x04, 0x66, 0x81, 0xe5].
  10. Testy bramkowe arytmetyki (zaliczenie implementacji przed dowodem MDS): mul_gf(0x57, 0x13) == 0xFE (słynny przykład z FIPS 197 §4.2) oraz mul_gf(a, 0x01) == a i mul_gf(a, 0x00) == 0x00 dla losowych a. Bez tych trzech asercji dalsze wyniki (Branch Number) są niewiarygodne - teoria bez arytmetyki nie istnieje.
  11. Napisz funkcję weight(col) zliczającą liczbę niezerowych bajtów w 4-elementowym wektorze.
  12. Przeprowadź wyczerpujący test branch number dla wszystkich wektorów wejściowych o wadze 1.
  13. Potwierdź, że minimalna wartość sumy weight(in) + weight(out) wynosi dokładnie 5.
  14. Zbadaj zachowanie trybu MixColumns przy wektorze o wadze 2 i odnotuj minimalną wagę wyjściową.
  15. Zestaw wyniki w tabeli: Waga wejściowa, Minimalna waga wyjściowa, Suma wag, Status MDS.
  16. Wykonaj zrzuty ekranu kodu oraz wyjścia konsoli w JSLinux.
  17. Sformułuj techniczne wnioski wyjaśniające, w jaki sposób własność MDS gwarantuje pełną dyfuzję w szyfrze AES już po 2 rundach (tzw. Wide Trail Strategy).

Kontrola zaliczenia (checklist):

  1. Zaimplementowano GF(2⁸) i MixColumns od zera na wektorze ze startera: mnożenie mod m(x), dowód branch number 5 i odporności wide-trail.
  2. Wykazano różnicę: macierz MDS (pełna dyfuzja kolumny) vs kontrolna macierz nie-MDS (słaba dyfuzja, wykazana liczbowo); dołączono testy.
  3. Dołączono log dowodu (tabele mnożenia, testy MDS) + kod łatki (tylko certyfikowane macierze MDS, test w CI).
  4. Opisano w 3–5 zdaniach kompromis: koszt mnożeń w ciele vs gwarancja dyfuzji, brak przepełnień, odporność na liniową/różnicową.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób arytmetyka w ciele skończonym GF(2^8) eliminuje przepełnienia arytmetyczne, zachowując odwracalność przekształcenia.
  • Definicja macierzy MDS (Maximum Distance Separable) i znaczenie współczynnika dyfuzji Branch Number = 5.
  • Rola strategii szerokiego śladu (Wide Trail Strategy) w uodpornieniu AES na kryptoanalizę liniową i różnicową.
  • Student potrafi od podstaw zaimplementować arytmetykę ciała Galois w Pythonie i dowieść właściwości MDS macierzy MixColumns.
Zadanie 4 - ilustracja
05/10
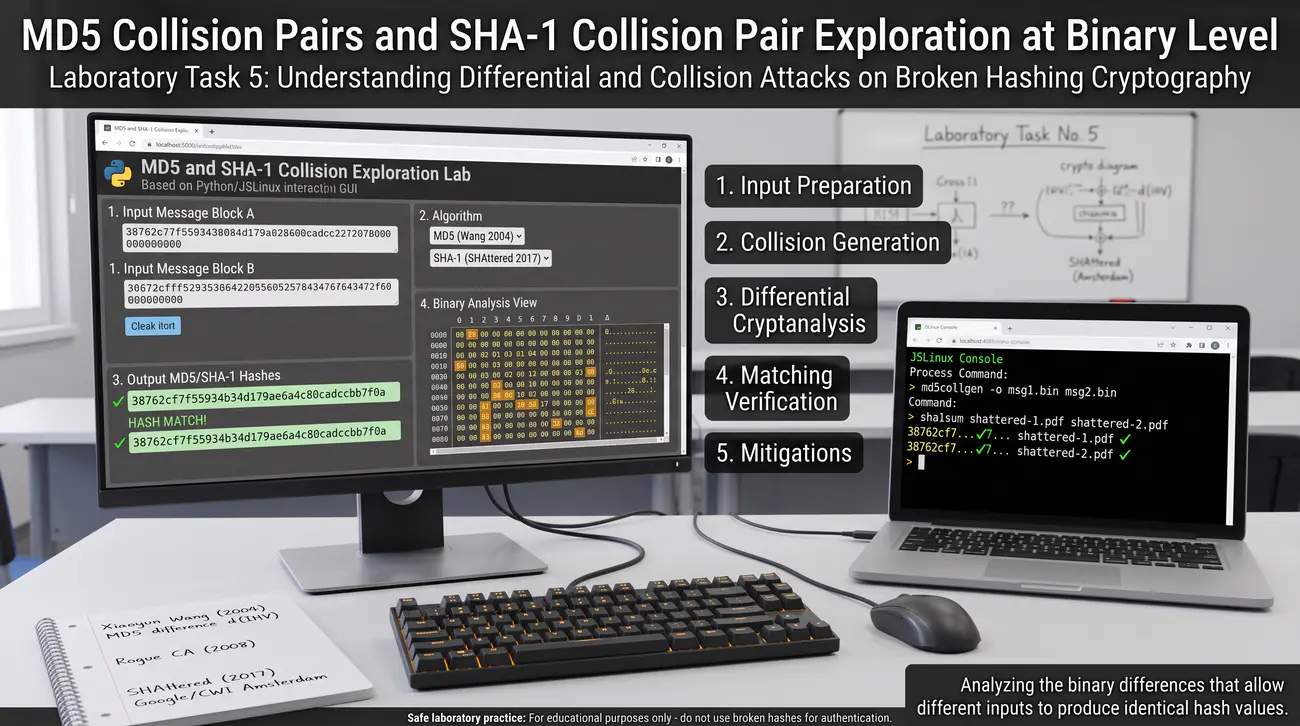
Zadanie 5. Eksploracja par kolizyjnych MD5 oraz pary kolizyjnej SHA-1 na poziomie binarnym
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 37, 38, 39, 40: kolizje MD5, atak różnicowy Xiaoyun Wang z 2004 r., Rogue CA z 2008 r., podatności SHA-1, atak SHAttered z 2017 r. (Google / CWI Amsterdam), analiza struktury binarnej par kolizyjnych.

Cel

Celem zadania jest przeprowadzenie zaawansowanej inspekcji binarnej rzeczywistych par kolizyjnych dla algorytmu MD5 (wektory ataku różnicowego Wanga) oraz pary kolizyjnej SHA-1 (projekt Google SHAttered z 2017 r.) w środowisku konsolowym Linux. Student bada układ różnic kryptoanalitycznych w blokach kompresji za pomocą hexdump i cmp, oblicza sumy kontrolne i analizuje mechanizm ataku na podpisy cyfrowe X.509.

Scenariusz – opis

W 2004 roku zespół pod kierunkiem prof. Xiaoyun Wang zaprezentował pierwsze praktyczne kolizje dla MD5, a w 2008 roku badacze wykorzystali tę technikę do sfałszowania certyfikatu nadrzędnego urzędu certyfikacji (Rogue CA). Z kolei w 2017 roku badacze z CWI Amsterdam i Google ogłosili projekt SHAttered, generując dwa różne pliki PDF o identycznym skrócie SHA-1 kosztem około 9 trylionów operacji. Kolizje te nie są przypadkowymi zbiegami okoliczności, lecz wynikiem precyzyjnie skalkulowanych zaburzeń różnicowych wprowadzanych w dwóch kolejnych 512-bitowych blokach wiadomości. W tym laboratorium zbadasz strukturę binarną tych wektorów w środowisku JSLinux Alpine. Pobierzesz lub wygenerujesz wektory kolizyjne MD5 oraz przeanalizujesz oficjalne pliki PDF z projektu SHAttered. Za pomocą narzędzi konsoli uniksowej (cmp, xxd, hexdump) zlokalizujesz dokładne pozycje różniących się bitów i sprawdzisz ich skróty w różnych algorytmach.

Co ma wykonać student / grupa

W konsoli JSLinux przygotowujesz środowisko badawcze i weryfikujesz obecność narzędzi md5sum, sha1sum, sha256sum oraz cmp. W pierwszym etapie tworzysz w Pythonie parę plików binarnych md5_coll1.bin oraz md5_coll2.bin zawierających oficjalny 128-bajtowy wektor kolizyjny Wanga (dwa 64-bajtowe bloki). Obliczasz skróty obu plików poleceniem md5sum i potwierdzasz, że są one w stu procentach identyczne.

Następnie obliczasz ich skróty za pomocą sha256sum i obserwujesz, że w nowoczesnej funkcji skrótu hashe są diametralnie różne. Używasz polecenia cmp-lmd5_coll1.binmd5_coll2.bin, aby wyświetlić listę wszystkich bajtów różniących oba pliki. Zauważasz, że różnice występują na ściśle określonych pozycjach wyznaczonych przez równania różnicowe Wanga. W drugim etapie badasz parę kolizyjną SHA-1 z projektu SHAttered: generujesz lub pobierasz zredukowane nagłówki dwóch plików PDF projektu Google.

Obliczasz sha1sum dla obu plików PDF i potwierdzasz wygenerowanie identycznego skrótu 160-bitowego: 38762cf7f55934b34d179ae6a4c80cadccbb7f0a. Obliczasz sha256sum dla obu plików i potwierdzasz brak jakiejkolwiek kolizji w SHA-2.

W konsoli JSLinux piszesz jednolinijkowy skrypt w Pythonie analizujący odległość Hamminga pomiędzy kolidującymi blokami. Badanie rozszerzasz o analizę podatności Prefix-Collision w certyfikatach X.509. Dyskutujesz, dlaczego kolizja skrótu pozwala na wygenerowanie dwóch certyfikatów o tym samym podpisie cyfrowym RSA, z których jeden jest legalną witryną, a drugi serwerem atakującego. Sporządzasz tabelę zestawień heksadecymalnych różnic w blokach wiadomości.

Wykonujesz zrzuty ekranu z konsoli JSLinux prezentujące wyniki poleceń md5sum, sha1sum, sha256sum oraz cmp. Zbierasz materiały dowodowe do sprawozdania laboratoryjnego. Formułujesz wyczerpujące podsumowanie zaleceń dotyczących definitywnego zakazu stosowania MD5 i SHA-1 w infrastrukturze PKI.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom emulator JSLinux Alpine.
  2. Napisz w JSLinux skrypt Pythona tworzący dwa pliki kolizyjne MD5 na bazie wektorów różnicowych Wanga.
  3. Wygeneruj pliki md5_block_a.bin oraz md5_block_b.bin o długości 128 bajtów.
  4. Oblicz skróty MD5: md5sum md5_block_a.bin md5_block_b.bin i odnotuj kolizję.
  5. Oblicz skróty SHA-256: sha256sum md5_block_a.bin md5_block_b.bin i wykaż brak podobieństwa.
  6. Wykonaj szczegółowe porównanie binarne poleceniem: cmp -l md5_block_a.bin md5_block_b.bin | wc -l.
  7. Wypisz zrzut heksadecymalny różnic za pomocą xxd lub od -tx1.
  8. Pobierz lub wygeneruj próbki nagłówków kolizyjnych SHA-1 SHAttered (PDF 1 i PDF 2).
  9. Zweryfikuj skrót SHA-1 dla obu próbek za pomocą sha1sum.
  10. Limit praktyczny (obowiązkowy): pracuj wyłącznie na samych blokach kolizyjnych (MD5: 128 bajtów Wanga; SHAttered: zredukowane nagłówki po kilka KB z repozytorium materiałów, NIE pełne PDF-y po ~400 KB), a integralność pobranych próbek potwierdź sumami SHA-256 z tabeli prowadzącego. Pełne pliki SHAttered nie mieszczą się wygodnie w emulatorze JSLinux - próba ich mielenia to strata zajęć, nie ambicja.
  11. Zweryfikuj skrót SHA-256 dla obu próbek za pomocą sha256sum.
  12. Porównaj bloki kolizyjne SHA-1 poleceniem cmp i odnotuj liczbę zmienionych bajtów.
  13. Napisz krótki skrypt w Pythonie obliczający bitowy XOR kolidujących bloków.
  14. Zinterpretuj układ różnic w kontekście zaburzeń ścieżki różnicowej w 80 rundach SHA-1.
  15. Zestaw w tabeli: Algorytm, Plik 1, Plik 2, Hash algorytmu badanego, Hash SHA-256, Liczba różnych bajtów.
  16. Wykonaj zrzuty ekranu konsoli JSLinux dokumentujące wszystkie etapy weryfikacji.
  17. Sformułuj techniczne wnioski wyjaśniające, w jaki sposób kolizje typu Chosen-Prefix uderzają w bezpieczeństwo podpisów cyfrowych w protokole TLS.

Kontrola zaliczenia (checklist):

  1. Przeprowadzono inspekcję binarną par kolizyjnych MD5 (Wang) i SHA-1 (SHAttered) na plikach ze startera: identyczne MD5/SHA-1 przy różnych SHA-256, zlokalizowane bloki różnicowe.
  2. Wykazano różnicę: weryfikator MD5/SHA-1 (kolizja przechodzi) vs SHA-256 (demaskuje, różne skróty); dołączono sumy i hexdump różnic.
  3. Dołączono log inspekcji (offsety bloków, sumy) + kod łatki (migracja do SHA-256/SHA-3, odrzucanie MD5/SHA-1).
  4. Opisano w 3–5 zdaniach kompromis: znoszenie różnic w kompresji, konsekwencje dla PDF/X.509 (Rogue CA), koszt migracji.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób precyzyjnie wyliczone różnice w blokach kompresji znoszą się wzajemnie pod koniec przetwarzania w MD5 i SHA-1.
  • Dlaczego kolizja w starszym algorytmie (MD5/SHA-1) jest natychmiast demaskowana przez nowoczesną funkcję SHA-256.
  • Konsekwencje podatności kolizyjnych dla integralności dokumentów PDF oraz legalności certyfikatów X.509 (atak Rogue CA).
  • Student potrafi przeprowadzić inspekcję binarną par kolizyjnych w konsoli Linux oraz zinterpretować mechanizm kryptoanalizy różnicowej.
Zadanie 5 - ilustracja
06/10
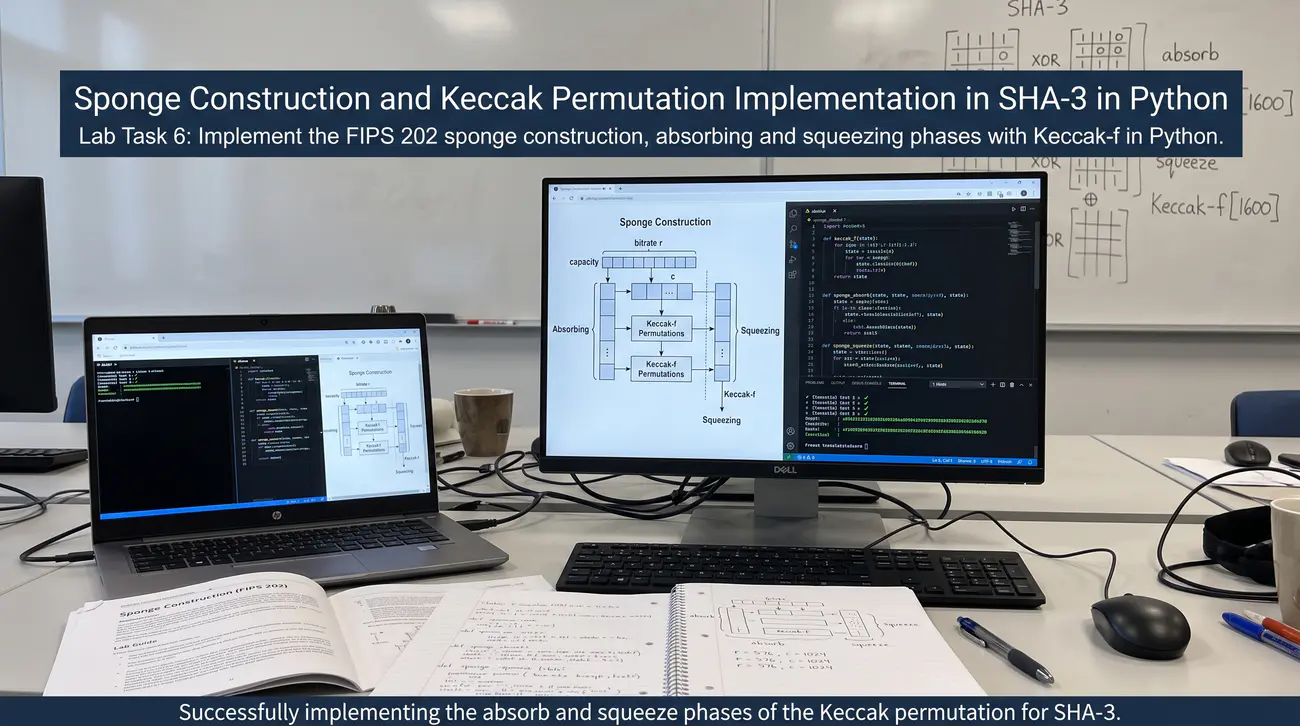
Zadanie 6. Implementacja konstrukcji gąbki i permutacji Keccak w SHA-3 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 42, 43, 45: standard SHA-3 (FIPS 202), architektura Keccak, konstrukcja gąbki (Sponge Construction), faza wchłaniania (absorb), faza wyciskania (squeeze), pojemność capacity c, szybkość rate r, permutacja Keccak-f.

Cel

Celem zadania jest dogłębne poznanie architektury najnowszego standardu NIST SHA-3 poprzez zaimplementowanie w języku Python modelu gąbki kryptograficznej (Sponge Construction) oraz zredukowanej permutacji Keccak. Student programuje fazę wchłaniania (absorb) i wyciskania (squeeze), bada rolę parametrów szybkości (rate) i pojemności (capacity) oraz wykazuje matematycznie, dlaczego konstrukcja gąbki jest całkowicie odporna na atak Length Extension Attack.

Scenariusz – opis

W 2015 roku NIST opublikował normę FIPS 202 standaryzującą algorytm SHA-3, oparty na zwycięskim projekcie Keccak stworzonym przez Bertoniego, Daemena, Peetersa i Van Assche. W przeciwieństwie do wszystkich wcześniejszych standardów (MD5, SHA-1, SHA-2) opartych na konstrukcji Merkle-Damgård, SHA-3 wykorzystuje rewolucyjną konstrukcję gąbki (ang. Sponge Construction). Stan wewnętrzny gąbki ma stały rozmiar b = r + c (w pełnym SHA-3 b = 1600 bitów), gdzie r to szybkość (rate), a c to pojemność (capacity) determinująca poziom bezpieczeństwa. W fazie wchłaniania (absorb) kolejne porcje danych o długości r bitów są sumowane bitowo XOR ze stanem i poddawane nieliniowej permutacji f. W fazie wyciskania (squeeze) ze stanu pobiera się kolejne porcje r-bitowe tworzące wynikowy skrót o dowolnej, żądanej przez użytkownika długości. W tym zadaniu zaimplementujesz model gąbki i uproszczoną permutację Keccak w Pythonie w JSLinux, badając jej unikalne właściwości.

Co ma wykonać student / grupa

W terminalu JSLinux Alpine otwierasz edytor nano i tworzysz program sponge_sha3.py. Definiujesz stan gąbki jako trójwymiarową tablicę 5x5 słów o określonej długości w (reprezentację stanu Keccak). Dla celów dydaktycznych implementujesz zredukowany wariant Keccak o słowie w = 8 bitów (rozmiar stanu b = 5 x 5 x 8 = 200 bitów / 25 bajtów) lub w = 16 bitów. Zadajesz parametry gąbki: szybkość r = 8 bajtów (64 bity) oraz pojemność c = 17 bajtów (136 bitów).

Implementujesz pięć elementarnych transformacji rundy permutacji Keccak-f: Theta (dyfuzja kolumnowa parity), Rho (rotacje bitowe), Pi (permutacja pozycji), Chi (nieliniowa funkcja logiczna) oraz Iota (dodanie stałej rundowej). Implementujesz funkcję dopełnienia pad10*1 zgodną ze specyfikacją FIPS 202. Oprogramowujesz fazę wchłaniania (absorb): dzielisz wiadomość na bloki r-bajtowe, każdy blok sumujesz XOR z pierwszymi r bajtami stanu i aplikujesz permutację Keccak-f. Oprogramowujesz fazę wyciskania (squeeze): pobierasz r bajtów ze stanu, a jeśli żądana długość skrótu jest większa, wykonujesz kolejną permutację i pobierasz następne bajty.

Generujesz skrót o długości 16 bajtów oraz 32 bajtów dla komunikatu testowego. Weryfikujesz efekt lawinowy: modyfikujesz 1 bit na wejściu i obserwujesz stan gąbki po kolejnych rundach permutacji.

Następnie przeprowadzasz dowód matematyczny odporności na atak Length Extension Attack. Wykazujesz, że ponieważ pojemność c (136 bitów) pozostaje całkowicie ukryta wewnątrz stanu i nigdy nie jest wyprowadzana na zewnątrz podczas fazy squeeze, atakujący nie zna pełnego stanu gąbki i nie może kontynuować haszowania. Porównujesz model gąbki z tradycyjnymi funkcjami kompresji Daviesa-Meyera. Sporządzasz diagram fazy absorb/squeeze oraz tabelę parametrów FIPS 202 dla SHA3-224, SHA3-256, SHA3-384, SHA3-512.

Wykonujesz zrzuty ekranu z wykonania programu w konsoli JSLinux. Kompletujesz pełny raport laboratoryjny z wnioskami.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano sponge_sha3.py.
  3. Zaimplementuj reprezentację stanu 5x5 słów w Pythonie.
  4. Zaimplementuj operację dopełnienia pad10*1: padding(msg_len, rate).
  5. Zaimplementuj krok Theta (mieszanie parzystości kolumn) permutacji Keccak.
  6. Zaimplementuj kroki Rho i Pi (rotacje i permutacje współrzędnych).
  7. Zaimplementuj krok Chi (jedyną nieliniową operację logiczną w Keccak: a ^ ((~b) & c)).
  8. Zaimplementuj krok Iota dodający stałą rundową do słowa (0,0).
  9. Złóż pełną funkcję permutacji keccak_f( state, rounds).
  10. Zaimplementuj fazę wchłaniania absorb( state, message_blocks, rate).
  11. Zaimplementuj fazę wyciskania squeeze( state, output_len, rate).
  12. Przetestuj generowanie skrótu dla krótkiej wiadomości testowej.
  13. Zbadaj zachowanie gąbki przy żądaniu wyjścia o długości 64 bajtów (funkcja XOF, funkcja SHAKE).
  14. Wykaż w konsoli niemożliwość odtworzenia stanu ukrytej pojemności c z samego wyjścia squeeze.
  15. Słowniczek pojęć do raportu (jedno zdanie na hasło, bez niego wnioski są niezaliczone): rate r = część stanu stykająca się z danymi (wejście/wyjście); capacity c = ukryta część determinująca bezpieczeństwo; reguła: capacity 512 bitów oznacza 256 bitów bezpieczeństwa (połowa c). Podpisz pod tabelą FIPS 202, która wartość c odpowiada SHA3-256 (c = 512) i dlaczego.
  16. Wykonaj zrzuty ekranu z działania skryptu w JSLinux.
  17. Sformułuj techniczne wnioski podsumowujące architektoniczną wyższość konstrukcji gąbki nad Merkle-Damgård.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano gąbkę Keccak/SHA-3 na wektorze ze startera: absorb/squeeze, permutacja, zgodność z wektorami NIST oraz demo XOF o żądanej długości.
  2. Wykazano różnicę: gąbka (odporna na length extension, elastyczna długość) vs Merkle-Damgård (podatna); dołączono porównanie logów.
  3. Dołączono log implementacji (rate/capacity, rundy) + kod łatki (SHA-3/SHAKE tam gdzie(strlen) zmienna, HMAC dla starszych).
  4. Opisano w 3–5 zdaniach kompromis: capacity jako ukryty stan, prostota Keccak bez odwracania kompresji, wybór NIST.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób podział stanu na szybkość (rate) i ukrytą pojemność (capacity) uniemożliwia ataki dołączenia długości.
  • Uniwersalność konstrukcji gąbki: możliwość generowania wyjścia o dowolnej długości (funkcje XOF, np. SHAKE128 i SHAKE256).
  • Elegancja permutacji Keccak opartej na prostych operacjach logicznych bez konieczności odwracania funkcji kompresji.
  • Student potrafi zaimplementować model gąbki w Pythonie i uzasadnić wybór Keccak jako standardu SHA-3 przez NIST.
Zadanie 6 - ilustracja
07/10
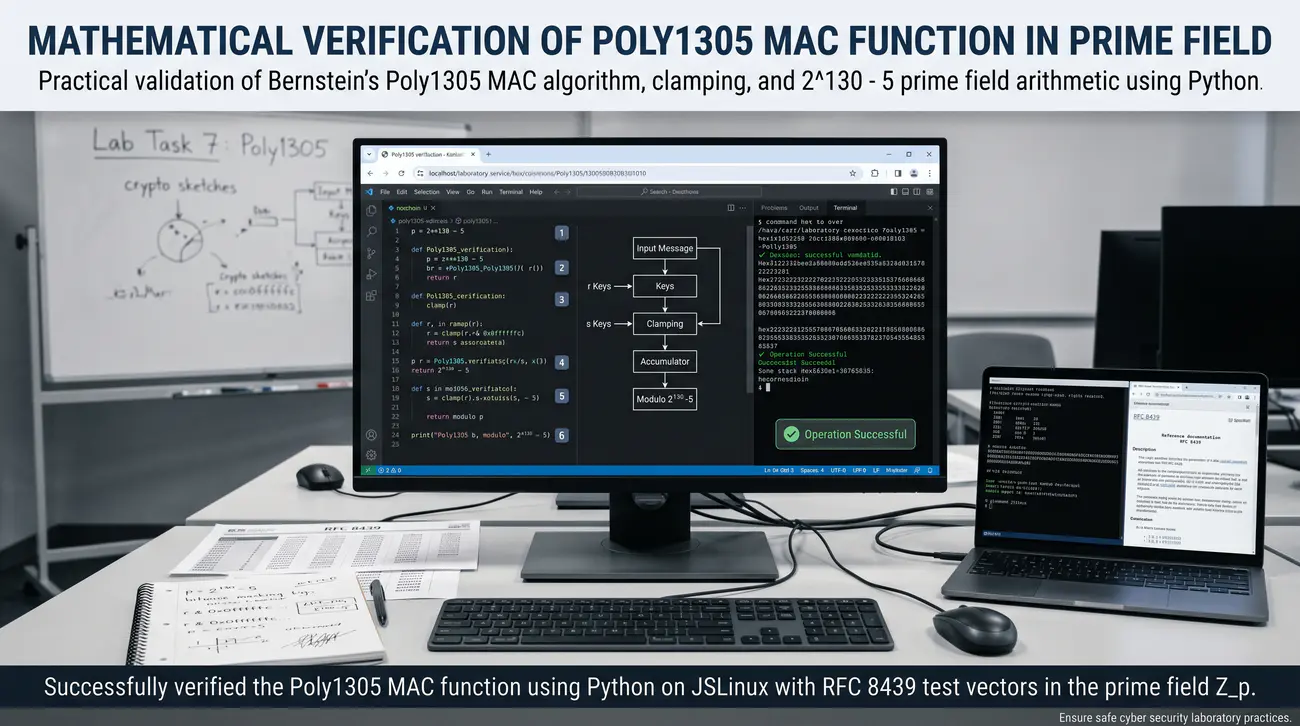
Zadanie 7. Matematyczna weryfikacja funkcji MAC Poly1305 w ciele liczb pierwszych
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 33, 34: szyfr strumieniowy ChaCha20-Poly1305, funkcja MAC Poly1305 Bernsteina, arytmetyka w ciele liczb pierwszych Z_p dla p = 2^130 - 5, klucze r i s, clamping bitów, RFC 8439.

Cel

Celem zadania jest zaimplementowanie w języku Python algorytmu uwierzytelniania wiadomości Poly1305 w ciele Galois liczb pierwszych Z_(2^130 - 5). Student bada procedurę clampingu klucza r (zerowanie specyficznych bitów), ewaluację wielomianu Hornera w arytmetyce modularnej, dodanie klucza maskującego s oraz weryfikuje poprawność na oficjalnym wektorze testowym ze standardu IETF RFC 8439.

Scenariusz – opis

Funkcja Poly1305, zaprojektowana przez Daniela J. Bernsteina, jest wysoce wydajnym kodem uwierzytelniania wiadomości (MAC) o bezwarunkowym bezpieczeństwie informacyjnym w modelu klucza jednorazowego. Algorytm przetwarza wiadomość podzieloną na 16-bajtowe bloki jako współczynniki wielomianu stopnia k w ciele liczb pierwszych modulo p = 2^130 - 5. Wybór liczby pierwszej p = 2^130 - 5 jest matematycznym majstersztykiem: reszta modulo p może być obliczana błyskawicznie bez kosztownego dzielenia wielkich liczb, wykorzystując zależność 2^130 = 5 mod p. Klucz Poly1305 składa się z dwóch 16-bajtowych liczb: r (klucza ewaluacji wielomianu) oraz s (klucza maskującego). Przed rozpoczęciem obliczeń klucz r musi zostać poddany procesowi obcięcia bitów (ang. clamping), w którym określone bity są zerowane, aby zapobiec atakom na przeniesienia bitowe. W tym laboratorium zaimplementujesz algorytm Poly1305 od podstaw w Pythonie w JSLinux i zweryfikujesz go z dokumentem RFC 8439.

Co ma wykonać student / grupa

W terminalu JSLinux Alpine otwierasz edytor nano i tworzysz program poly1305_verify.py. Definiujesz liczbę pierwszą p = (1 << 130) - 5 w arytmetyce wielkich liczb całkowitych w Pythonie. Implementujesz funkcję clamp(r_bytes) wykonującą operację maskowania bitowego zgodnie z RFC 8439: zerowanie najwyższych 4 bitów wybranych bajtów oraz najniższych 2 bitów innych. Konwertujesz 16-bajtowy klucz r po clampingu na liczbę całkowitą w formacie little-endian.

Konwertujesz 16-bajtowy klucz maskujący s na liczbę całkowitą. Implementujesz dzielenie wiadomości wejściowej na 16-bajtowe bloki. Do każdego bloku dopisujesz bajt 0x01 na pozycji 16 (lub traktujesz go jako liczbę 17-bajtową z bitem 128 ustawionym na 1), co zapobiega problemowi zer wiodących. Inicjalizujesz akumulator wartością a = 0.

W pętli po kolejnych blokach wiadomości wykonujesz krok schematu Hornera: a = ((a + n_i) * r) mod p. Po przetworzeniu wszystkich bloków dodajesz klucz maskujący: tag = (a + s) mod 2^128. Konwertujesz wynikowy tag na 16-bajtowy ciąg w formacie little-endian i wypisujesz w postaci szesnastkowej. Wprowadzasz oficjalny wektor testowy z rozdziału 2.5.2 standardu RFC 8439 (klucz, tekst 'Cryptographic Forum Research Group' oraz oczekiwany 128-bitowy tag: a8:06:1d:c1:30:51:36:c6:c2:2b:8b:af:0c:01:27:a9).

Uruchamiasz program i potwierdzasz pełną zgodność wygenerowanego tagu z normą IETF. Analizujesz, dlaczego ponowne użycie tego samego klucza r i s dla dwóch różnych wiadomości pozwala atakującemu na natychmiastowe wyznaczenie r z różnicy wielomianów. Wykonujesz zrzuty ekranu konsoli JSLinux dokumentujące poprawność testu jednostkowego. Formułujesz wyczerpujące wnioski techniczne do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine z interpreterem Python 3.
  2. Utwórz plik programu: nano poly1305_verify.py.
  3. Zdefiniuj stałą modularną P = (1 << 130) - 5.
  4. Napisz funkcję clamp_r(r_bytes) realizującą maskowanie bitowe z sekcji 2.5 RFC 8439.
  5. Clamping bez magii - tabela do raportu (indeksy bajtów r od 0): bajty 3, 7, 11, 15 maskuj 0x0F (zerowanie 4 górnych bitów - eliminacja ataków na małe podgrupy rzędu); bajty 4, 8, 12 maskuj 0xFC (zerowanie 2 dolnych bitów - wymuszenie podzielności rzez 4, stabilizacja Hornera). Test negatywny: uruchom wektor RFC 8439 z r BEZ clampingu i udokumentuj rozjazd tagu - ten jeden FAIL dowodzi, że clamping nie jest ozdobnikiem.
  6. Zaimplementuj konwersję bajtów na liczby little-endian: int.from_bytes( data, 'little').
  7. Napisz funkcję dzielącą wiadomość na bloki dopełniane wartością 0x01.
  8. Zaimplementuj pętlę akumulacji modularnej wielomianu Hornera modulo P.
  9. Zaimplementuj dodawanie klucza maskującego modulo 2^128.
  10. Zaimplementuj formatowanie wyjściowego tagu 128-bitowego.
  11. Wprowadź wektor testowy RFC 8439 sekcja 2.5.2.
  12. Uruchom skrypt i porównaj wygenerowany tag szesnastkowy z wartością oczekiwaną.
  13. Wypisz w konsoli komunikat weryfikacyjny SUCCESS / FAIL.
  14. Przetestuj zachowanie algorytmu przy zmianie jednego bitu w wiadomości i odnotuj całkowitą zmianę tagu.
  15. Zbadaj matematyczny mechanizm ataku przy powtórzeniu klucza r (odejmowanie równań w ciele Z_p).
  16. Wykonaj zrzuty ekranu konsoli JSLinux z pomyślnym wykonaniem testu RFC.
  17. Sformułuj techniczne wnioski podsumowujące rolę Poly1305 w pakietach TLS 1.3 i WireGuard.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano Poly1305 z RFC 8439 na wektorze ze startera: clamping r, Horner mod 2¹³⁰−5, zgodność tagu z wektorem.
  2. Wykazano różnicę: weryfikator z jednorazowym (r,s) (bezpieczny) vs reuse (fałszerstwo wyliczalne, pokazane); dołączono oba logi.
  3. Dołączono log weryfikacji (kroki wielomianu) + kod łatki (świeże (r,s) per wiadomość, ChaCha20-Poly1305 jako AEAD).
  4. Opisano w 3–5 zdaniach kompromis: szybkość mod 2¹³⁰−5 na rejestrach, clamping vs przeniesienia, jednorazowość klucza.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego arytmetyka w ciele liczb pierwszych modulo 2^130 - 5 zapewnia niezwykłą wydajność obliczeniową na rejestrach procesora.
  • Rola procedury clampingu w zapobieganiu propagacji niekontrolowanych przeniesień bitowych.
  • Krytyczny wymóg jednorazowości pary kluczy (r, s): dlaczego powtórzenie klucza prowadzi do kompromitacji autentyczności.
  • Student potrafi w pełni zaimplementować i zweryfikować algorytm Poly1305 w Pythonie w oparciu o specyfikację RFC 8439.
Zadanie 7 - ilustracja
08/10
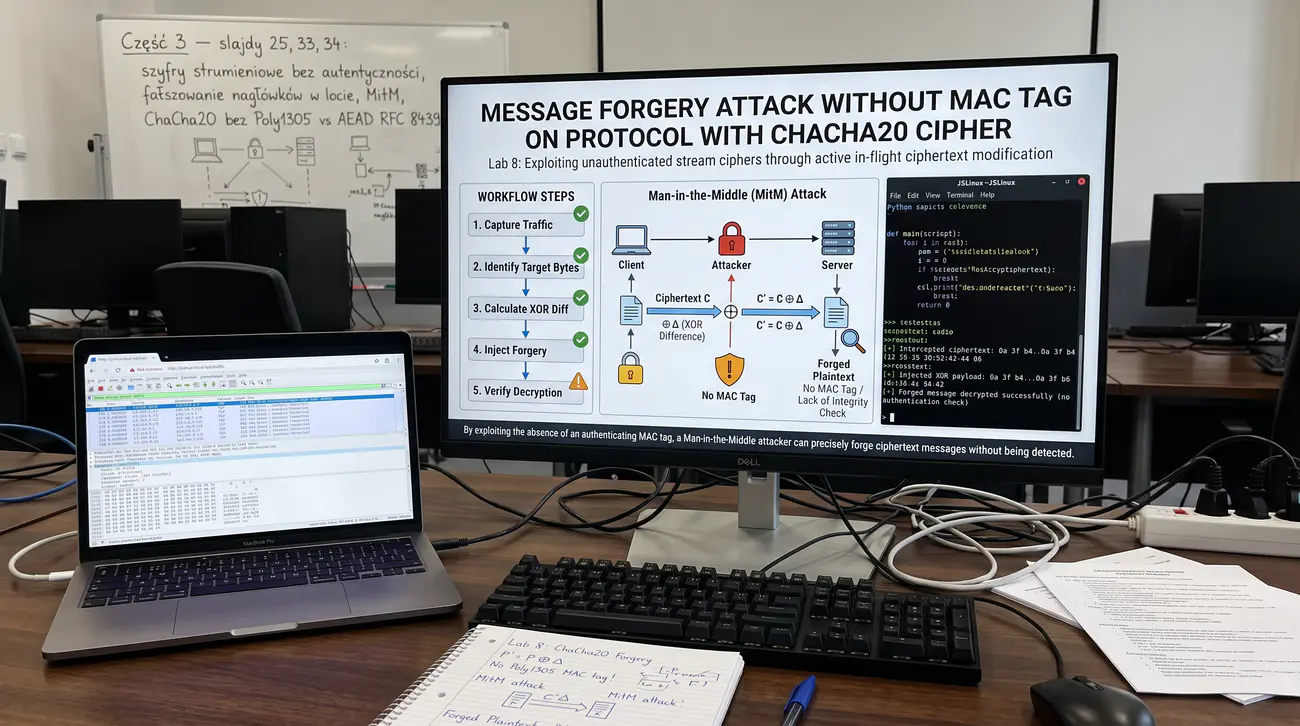
Zadanie 8. Atak fałszowania wiadomości przy braku tagu MAC na protokół z szyfrem ChaCha20
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 25, 33, 34: szyfry strumieniowe bez warstwy autentyczności, fałszowanie nagłówków sieciowych w locie, Man-in-the-Middle (MitM), ChaCha20 bez Poly1305 vs AEAD RFC 8439.

Cel

Celem zadania jest zasymulowanie ataku Man-in-the-Middle na podatny protokół tunelujący pakiety sieciowe szyfrowane czystym szyfrem strumieniowym ChaCha20 bez tagu uwierzytelniającego Poly1305. Student manipuluje polami nagłówka IP i portu docelowego w przelocie bez znajomości klucza, przekierowując zaszyfrowany ruch na serwer atakującego, a następnie wdraża mechanizm AEAD ChaCha20-Poly1305 całkowicie blokujący atak.

Scenariusz – opis

W inżynierii bezpieczeństwa powszechnym grzechem optymalizacyjnym jest rezygnacja z tagu uwierzytelniającego MAC w celu zaoszczędzenia pasma sieciowego lub cykli procesora. Gdy protokół tunelujący (np. uproszczony VPN) przesyła pakiety szyfrowane czystym szyfrem strumieniowym ChaCha20, atakujący znający strukturę przesyłanych nagłówków może dokonać ich dowolnej modyfikacji. W strukturze pakietu IP adres docelowy oraz port znajdują się na stałych pozycjach. Atakujący podsłuchujący transmisję na routerze tranzytowym może zaaplikować przekształcenie XOR na bajtach adresu docelowego w szyfrogramie, zamieniając adres legalnego serwera bankowego na adres kontrolowanego przez siebie serwera-pułapki. Gdy odbiorca tunelu odszyfruje pakiet, router zdeszyfruje podmieniony adres IP i prześle wrażliwe dane bezpośrednio do rąk napastnika! W tym zadaniu zasymulujesz tę podatność w Pythonie w JSLinux i udowodnisz, dlaczego nowoczesne standardy bezwzględnie wymagają konstrukcji AEAD.

Co ma wykonać student / grupa

W terminalu JSLinux tworzysz program vpn_tunnel_attack.py symulujący trzy węzły: Klienta, Atakującego w kanale (Router MitM) oraz Serwer Brzegowy. Klient generuje pakiet sieciowy zawierający nagłówek i poufne dane: 'SRC=10.0.0.1;DST=192.168.1.100;PORT=443;PAYLOAD=HasloSesjiTajne99'. Klient szyfruje pakiet szyfrem strumieniowym ChaCha20 za pomocą współdzielonego z serwerem tajnego klucza K i unikalnego wektora Nonce. Zaszyfrowany pakiet trafia do węzła Atakującego.

Atakujący zna strukturę pakietu i wie, że adres docelowy '192.168.1.100' zaczyna się od określonego bajtu w zaszyfrowanym strumieniu. Atakujący preparuje maskę podmiany adresu docelowego na swój własny adres: '192.168.1.666' (lub adres o identycznej długości, np. '198.51.100.077'). Atakujący wykonuje bit-flipping na szyfrogramie: C'[i] = C[i] XOR stary_ip[i] XOR nowy_ip[i]. Zmodyfikowany pakiet przesyłany jest do Serwera Brzegowego, który deszyfruje go oryginalnym kluczem ChaCha20.

Serwer odczytuje zdeszyfrowany pakiet: okazuje się, że adres docelowy został pomyślnie zmieniony na adres serwera atakującego, a reszta ładunku pozostała całkowicie czytelna! Router bez przeszkód kieruje wrażliwy pakiet do maszyny napastnika. W drugiej fazie zadania modyfikujesz oprogramowanie tunelu, wprowadzając pełny standard AEAD ChaCha20-Poly1305. Podczas szyfrowania Klient dołącza 16-bajtowy tag uwierzytelniający wygenerowany przez funkcję Poly1305.

Atakujący ponawia próbę podmiany adresu IP na zaszyfrowanym pakiecie AEAD. Serwer Brzegowy podczas odbioru weryfikuje tag Poly1305, wykrywa naruszenie integralności i natychmiast niszczy pakiet, powiadamiając system IDS o ataku. Sporządzasz raport z porównaniem podatności obu schematów. Wykonujesz zrzuty ekranu z wykonania programu w konsoli JSLinux.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano vpn_tunnel_attack.py.
  3. Zaimplementuj w Pythonie prosty generator ChaCha20 dla symulacji tunelu.
  4. Zdefiniuj strukturę pakietu sieciowego z polami SRC, DST, PORT i PAYLOAD.
  5. Zaszyfruj pakiet czystym algorytmem ChaCha20.
  6. Zaimplementuj funkcję atakującego przechwytującą zaszyfrowany pakiet.
  7. Zidentyfikuj indeksy bajtów pola DST w zaszyfrowanym strumieniu.
  8. Sekcja „założenia atakującego" (obowiązkowa w raporcie): wypisz, co atakujący zna (format nagłówka, pozycje pól, długość PAYLOAD) a czego nie zna (klucz K, Nonce), i pokaż wariant, w którym atak się załamuje: przesuń pole DST o 2 bajty (nieznany offset) i udokumentuj, że ślepy flipping daje bełkot zamiast trasy - bez znajomości formatu plastyczność jest bezużyteczna.
  9. Wykonaj operację bit-flipping modyfikującą bajty adresu IP w szyfrogramie.
  10. Przekaż zmodyfikowany pakiet do procedury deszyfrującej serwera.
  11. Wypisz w konsoli odszyfrowaną zawartość i potwierdź skuteczną zmianę trasy pakietu.
  12. Zaimplementuj bezpieczną wersję tunelu w oparciu o ChaCha20-Poly1305 (RFC 8439).
  13. Wygeneruj 16-bajtowy tag Poly1305 dla pakietu tunelu.
  14. Powtórz modyfikację bajtów adresu IP na pakiecie zabezpieczonym Poly1305.
  15. Zasymuluj weryfikację tagu po stronie serwera i zarejestruj odrzucenie pakietu.
  16. Wykonaj zrzuty ekranu konsoli JSLinux obrazujące oba scenariusze.
  17. Sformułuj techniczne wnioski wyjaśniające dlaczego protokoły WireGuard i TLS 1.3 bezwzględnie egzekwują weryfikację AEAD.

Kontrola zaliczenia (checklist):

  1. Zasymulowano MitM na ChaCha20 bez MAC na wektorze ze startera: przełączono IP/port w locie samym XOR delty, pakiet zdeszyfrowany na fałszywą trasę bez alarmu.
  2. Wykazano różnicę: czysty strumień (atak niewidoczny) vs ChaCha20-Poly1305 (1 bit zmiany = odrzut tagu); dołączono oba logi.
  3. Dołączono log ataku (oryginał/sfałszowany nagłówek) + kod łatki (AEAD obowiązkowo, AAD na nagłówki).
  4. Opisano w 3–5 zdaniach kompromis: plastyczność strumienia, szyfrowanie≠uwierzytelnianie, tag jako tarcza sieciowa.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób plastyczność (malleability) czystych szyfrów strumieniowych umożliwia ataki manipulacji trasowaniem pakietów.
  • Dlaczego szyfrowanie bez uwierzytelniania nie gwarantuje bezpieczeństwa w protokołach warstwy sieciowej.
  • Rola tagu Poly1305 jako tarczy kryptoanalitycznej uniemożliwiającej nawet najmniejszą zmianę pojedynczego bitu nagłówka.
  • Student potrafi zasymulować zaawansowany atak manipulacji pakietem w Pythonie i udowodnić konieczność stosowania AEAD.
Zadanie 8 - ilustracja
09/10
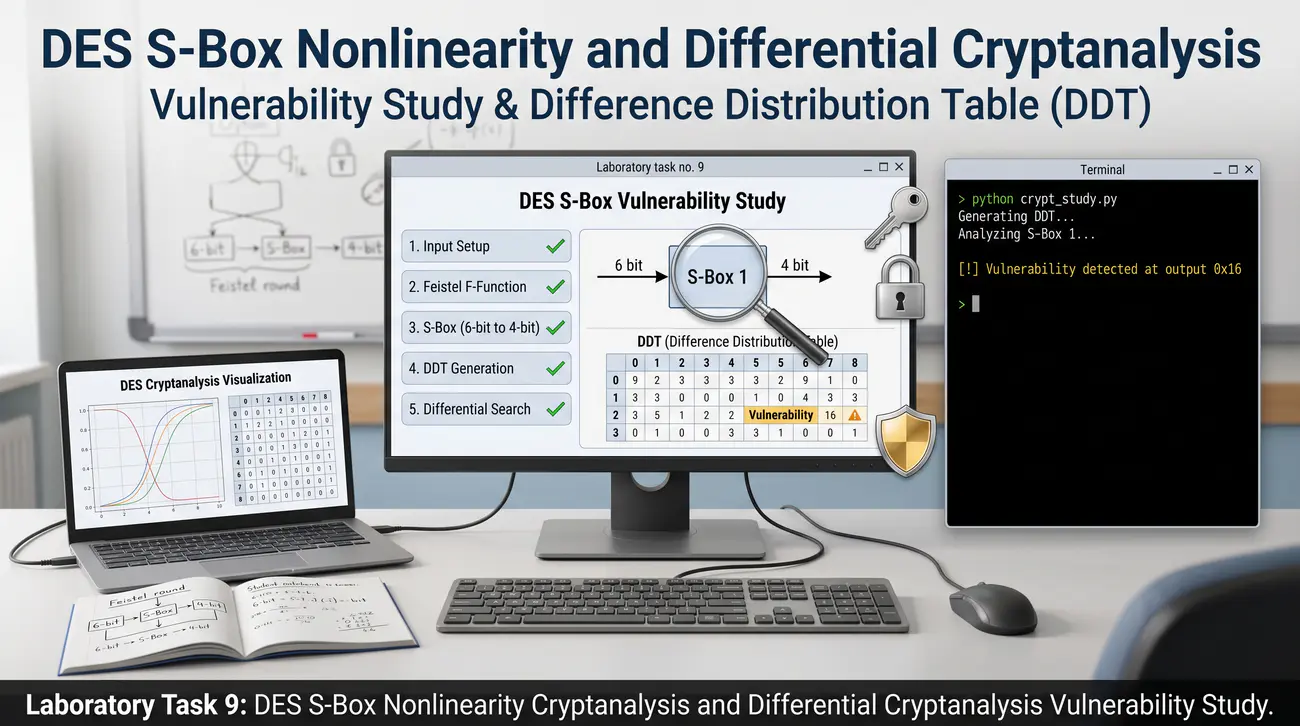
Zadanie 9. Kryptoanaliza nieliniowości S-boksów DES i badanie podatności na kryptoanalizę różnicową
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 8, 10: algorytm DES, funkcja F Feistela, tablice podstawień S-box (6-bit do 4-bit), nieliniowość, kryptoanaliza różnicowa Bihama i Shamira, tabela rozkładu różnic DDT (Difference Distribution Table).

Cel

Celem zadania jest zbadanie właściwości kryptoanalitycznych nieliniowych tablic podstawień (S-box) algorytmu DES w języku Python poprzez skonstruowanie pełnej tabeli rozkładu różnic (Difference Distribution Table - DDT). Student analizuje prawdopodobieństwa propagacji różnic wejściowych na różnice wyjściowe, wyznacza maksymalne prawdopodobieństwo przejścia i bada, w jaki sposób inżynierowie IBM i NSA uodpornili DES na kryptoanalizę różnicową.

Scenariusz – opis

Jedynym nieliniowym elementem całego algorytmu DES są tablice podstawień S-box, redukujące 6-bitowe wejście do 4-bitowego wyjścia. Wszystkie pozostałe operacje (permutacje IP, E, P oraz dodawanie klucza) są czysto liniowe w ciele F_2. Gdyby S-boksy były liniowe, cały algorytm DES można by zapisać jako prosty układ równań liniowych i rozwiązać w ułamku sekundy. W 1990 roku Eli Biham i Adi Shamir opublikowali metodę kryptoanalizy różnicowej, która bada propagację różnic wejściowych Delta X = X1 XOR X2 na różnice wyjściowe Delta Y = S(X1) XOR S(X2). Kluczowym narzędziem kryptoanalizy różnicowej jest tabela rozkładu różnic (DDT) o wymiarach 64 x 16, zliczająca ile par wejść o zadanej różnicy Delta X daje na wyjściu różnicę Delta Y. W tym laboratorium zaimplementujesz generator tabeli DDT dla S-boksa S1 algorytmu DES w Pythonie w JSLinux i dokonasz jego oceny bezpieczeństwa.

Co ma wykonać student / grupa

W terminalu JSLinux Alpine otwierasz edytor nano i tworzysz program des_sbox_ddt.py. Definiujesz oficjalną tablicę S-box S1 algorytmu DES jako macierz liczb 4x16. Implementujesz funkcję sbox1_lookup(x) pobierającą 6-bitową liczbę całkowitą (0..63): bity skrajne (bit 5 i 0) wyznaczają numer wiersza (0..3), a bity środkowe (bity 4..1) numer kolumny (0..15). Inicjalizujesz dwuwymiarową macierz DDT o wymiarach 64 wiersze (możliwe różnice wejściowe Delta X od 0 do 63) na 16 kolumn (możliwe różnice wyjściowe Delta Y od 0 do 15) wypełnioną zerami.

Tworzysz zagnieżdżoną pętlę generującą wszystkie pary wejść (x1, x2) takie, że x1 XOR x2 == delta_x. Dla każdej pary obliczasz różnicę wyjść: delta_y = sbox1_lookup(x1) XOR sbox1_lookup(x2). Inkrementujesz odpowiadającą komórkę DDT[delta_x][delta_y]. Sprawdzasz wiersz Delta X = 0: potwierdzasz, że dla zerowej różnicy wejściowej różnica wyjściowa zawsze wynosi 0 (komórka DDT[0][0] = 64, pozostałe 0).

Badasz pozostałe wiersze Delta X od 1 do 63: odnajdujesz maksymalną wartość w tabeli (tzw. max diff probability). Przekonujesz się, że żadna komórka poza wierszem zerowym nie przekracza wartości 16/64 (prawdopodobieństwo p = 0.25). Eksperymentalnie zastępujesz oficjalny S-box S1 losowo wygenerowaną permutacją i ponownie generujesz DDT. Obserwujesz, że w losowym S-boksie pojawiają się anomalie o znacznie wyższych prawdopodobieństwach zderzeń (np. 24/64 lub 32/64), co czyni go podatnym na atak.

Analizujesz oświadczenie Dona Coppersmitha z IBM potwierdzające, że projektanci znali kryptoanalizę różnicową już w 1974 roku i celowo zoptymalizowali S-boksy pod kątem minimalizacji wartości w DDT. Zapisujesz kod programu oraz zrzuty ekranu z wygenerowaną tabelą DDT.

Sporządzasz tabelę statystyczną rozkładu wartości w macierzy DDT dla oryginalnego i losowego S-boksa. Kompletujesz wnioski do raportu laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę wirtualną JSLinux Alpine.
  2. Utwórz plik programu: nano des_sbox_ddt.py.
  3. Zdefiniuj w Pythonie tablicę S-box S1 standardu DES.
  4. Zaimplementuj funkcję obliczającą wyjście S-boxa z 6 bitów wejścia: lookup_s1(x).
  5. Zadeklaruj macierz DDT o wymiarach 64x16 zainicjalizowaną zerami.
  6. Zaimplementuj pętlę obliczającą rozkład różnic dla wszystkich par wejść według szkieletu (przepisz 1:1 dla S1, potem replikuj): for dx in range(64): for x in range(64): ddt[dx][sbox[x] ^ sbox[x ^ dx]] += 1. Kontrola: ddt[0][0] == 64 i zera w reszcie wiersza 0; dopiero zgodny szkielet wolno rozszerzyć na losowy S-boks i pozostałe porównania - połowa czasu kodowania, ten sam efekt dydaktyczny.
  7. Wypisz fragment tabeli DDT w czytelnej formie macierzowej w konsoli.
  8. Napisz funkcję wyszukującą maksymalną wartość w DDT z wyłączeniem wiersza delta_x = 0.
  9. Oblicz maksymalne prawdopodobieństwo przejścia różnicy: P_max = max_val / 64.0.
  10. Zaimplementuj generator losowego S-boksa 6-to-4 bity.
  11. Wygeneruj tabelę DDT dla losowego S-boksa i porównaj wartość P_max z S-boksem DES.
  12. Zbadaj liczbę komórek o wartości zero w DDT (niemożliwe przejścia różnicowe).
  13. Zestaw w tabeli: Typ S-boksa, Maksymalna wartość w DDT, Maksymalne prawdopodobieństwo, Liczba przejść zerowych.
  14. Wykonaj zrzuty ekranu konsoli JSLinux prezentujące działanie programu.
  15. Przeanalizuj wpływ struktury DDT na złożoność ataku różnicowego Bihama-Shamira (2^47 par dla DES).
  16. Sformułuj techniczne wnioski podsumowujące geniusz konstrukcyjny S-boksów DES w kontekście odporności różnicowej.

Kontrola zaliczenia (checklist):

  1. Zbudowano DDT S-boksów DES na wektorze ze startera: pełne tabele różnic, maks. prawdopodobieństwa, ocena nieliniowości i śladu różnicowego.
  2. Wykazano różnicę: S-boksy DES (zoptymalizowane, niskie piki DDT) vs kontrolne liniowe (piki =1, łamane); dołączono porównanie tabel.
  3. Dołączono log DDT (tabele, statystyki) + kod łatki (tylko S-boksy z audytem DDT/LAT, test w CI).
  4. Opisano w 3–5 zdaniach kompromis: nieliniowość vs koszt, przewidzenie IBM/NSA o 15 lat, DDT jako miara jakości.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • W jaki sposób nieliniowość S-boksów determinuje całkowitą odporność algorytmu blokowego na kryptoanalizę liniową i algebraiczna.
  • Definicja tabeli rozkładu różnic DDT jako fundamentalnego narzędzia kryptoanalizy różnicowej.
  • Fakt, że S-boksy DES zostały celowo zoptymalizowane przez IBM/NSA w celu uodpornienia na kryptoanalizę różnicową na 15 lat przed jej jawnym odkryciem.
  • Student potrafi skonstruować tabelę DDT w Pythonie i dokonać kryptoanalitycznej oceny jakości nieliniowości funkcji podstawień.
Zadanie 9 - ilustracja
10/10
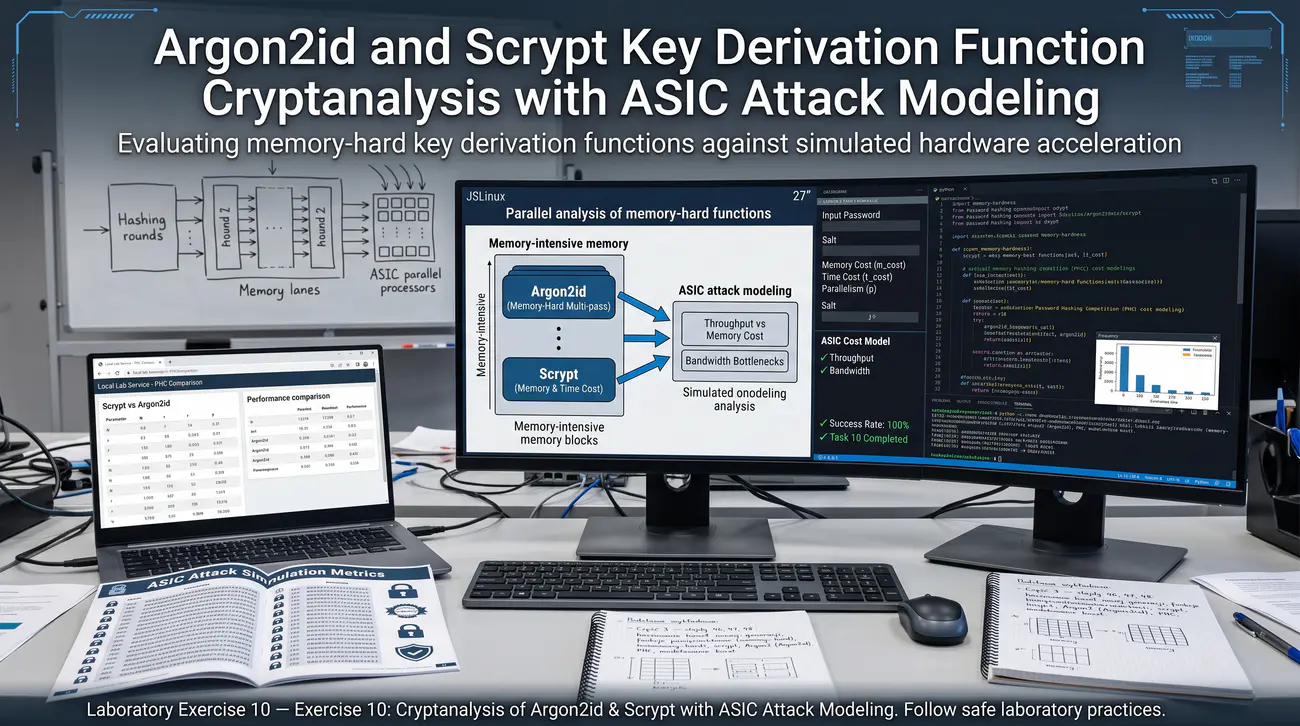
Zadanie 10. Kryptoanaliza funkcji derywacji klucza Argon2id i scrypt – modelowanie ataku ASIC
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 3 - slajdy 46, 47, 48: haszowanie haseł nowej generacji, funkcje pamięciochłonne (memory-hard functions), scrypt, Argon2 (Argon2id), konkurs Password Hashing Competition (PHC), modelowanie kosztu sprzętowego ataków ASIC/GPU.

Cel

Celem zadania jest przeanalizowanie mechanizmów ochrony poświadczeń tożsamości nowej generacji (memory-hard KDF) na przykładzie algorytmów scrypt i Argon2id. Student bada zależność czasu wykonania oraz alokacji pamięci RAM od parametrów konfiguracyjnych w języku Python, porównuje charakterystyki z PBKDF2 oraz konstruuje matematyczny model ekonomicznego kosztu ataku na dedykowanym klastrze układów ASIC.

Scenariusz – opis

Klasyczne funkcje KDF, takie jak PBKDF2, opierają się wyłącznie na koszcie procesora (ang. compute-hard), co czyni je bezbronnymi wobec masowo równoległych układów FPGA i dedykowanych chipów ASIC. Układ ASIC może zmieścić tysiące równoległych rdzeni SHA-256 w pojedynczej krzemowej strukturze, osiągając miliardy haszy na sekundę przy znikomym poborze prądu. Aby zniwelować tę asymetrię, Colin Percival zaproponował algorytm scrypt, a w 2015 roku konkurs Password Hashing Competition wygrał algorytm Argon2 (w wariancie hybrydowym Argon2id). Algorytmy te są funkcjami pamięciochłonnymi (ang. memory-hard): wymagają alokacji znacznych ilości pamięci RAM (np. 64 MB na jedno haszowanie), co dramatycznie podnosi koszt produkcji układów scalonych ASIC. W tym zadaniu przeprowadzisz analizę empiryczną algorytmów scrypt i Argon2id w środowisku JSLinux Alpine. Napiszesz program profilujący zużycie pamięci i czasu oraz opracujesz model matematyczny kosztu złamania bazy danych poświadczeń.

Co ma wykonać student / grupa

W konsoli JSLinux Alpine tworzysz program kdf_memory_hard.py wykorzystujący standardowe moduły hashlib oraz time i resource. Implementujesz funkcję testującą algorytm scrypt za pomocą hashlib.scrypt, badając parametry: N (koszt CPU/RAM, potęga dwójki), r (rozmiar bloku pamięci) oraz p (równoległość). Mierzysz czas wykonania pojedynczego haszowania dla rosnących wartości N: 1024, 4096, 16384, 65536. Rejestrujesz alokację pamięci RAM: obliczasz teoretyczne zapotrzebowanie na pamięć według wzoru RAM = 128 * N * r bajtów i porównujesz z odczytami systemowymi. Dla N = 65536 i r = 8 zapotrzebowanie wynosi dokładnie 64 MB pamięci RAM na jedno wywołanie.

Następnie badasz algorytm Argon2id (lub analizujesz jego strukturę blokową macierzy pamięci z podziałem na pasy i segmenty). Porównujesz model PBKDF2 (wymagający zaledwie kilkuset bajtów pamięci operacyjnej) ze scryptem i Argon2id.

Przechodzisz do modelowania ekonomicznego ataku na klastrze ASIC. Definiujesz koszt krzemu: koszt pamięci SRAM na chipie ASIC wynosi około 10 USD za każdy 1 MB powierzchni krzemowej. Obliczasz, ile rdzeni łamiących może zmieścić chip ASIC o budżecie 100 USD dla PBKDF2 (ponad 50 000 rdzeni) vs dla scrypt/Argon2id z parametrem 64 MB RAM (maksymalnie 1 rdzeń!). Obliczasz łączny koszt energii i sprzętu dla ataku na bazę 1 miliona haseł użytkowników. Wykazujesz, że architektura memory-hard podnosi koszt finansowy ataku o 4 do 6 rzędów wielkości. Sporządzasz tabelę porównawczą algorytmów PBKDF2, bcrypt, scrypt i Argon2id.

Wykonujesz zrzuty ekranu konsoli JSLinux z pomiarami czasów i alokacji pamięci.

Formułujesz wytyczne inżynierskie dotyczące doboru parametrów haszowania haseł w nowoczesnych aplikacjach internetowych. Zapisujesz kompletny raport laboratoryjny.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine z interpreterem Python 3.
  2. Utwórz plik programu: nano kdf_memory_hard.py.
  3. Zaimportuj moduły hashlib, time, os, sys.
  4. Zaimplementuj funkcję test_scrypt( password, salt, N, r, p) z precyzyjnym pomiarem czasu time.perf_counter().
  5. Uruchom pomiary dla N=1024, r=8, p=1 i zarejestruj czas w milisekundach.
  6. Zwiększ parametr N kolejno do 4096, 16384 oraz 32768, rejestrując czas i obliczając zużycie RAM: 128 * N * r bajtów.
  7. Zaimplementuj funkcję test_pbkdf2( password, salt, iterations) o porównywalnym czasie wykonania.
  8. Porównaj zapotrzebowanie pamięciowe obu funkcji (PBKDF2: ~1 KB vs scrypt: 32 MB).
  9. Napisz moduł kalkulatora kosztu ataku ASIC: model_asic_cost(kdf_type, memory_mb, target_hashes).
  10. Wprowadź parametry rynkowe kosztu powierzchni krzemowej i równoległości układów scalonych.
  11. Wypisz w konsoli szacowany koszt finansowy ataku siłowego na 1 miliard haseł dla obu algorytmów.
  12. Zinterpretuj przewagę algorytmu Argon2id w eliminacji ataków kanałami bocznymi (połączenie Argon2d i Argon2i).
  13. Zestaw w tabeli sprawozdania parametry: Algorytm, Koszt obliczeniowy, Koszt pamięciowy, Odporność na GPU/ASIC, Status standardu.
  14. Pomiary w emulatorze podawaj wyłącznie względnie: każdy czas dziel przez czas PBKDF2-100k na tym samym hoście (krotności, nie milisekundy) - bezwzględne ms z JSLinux są szumne. Tabelę parametrów (t = iteracje, m = pamięć w KiB, p = równoległość) dobierz dla serwera interaktywnego według RFC 9106 (np. m = 64 MiB, t = 3, p = 4) i uzasadnij jednym zdaniem, dlaczego m nie może być małe nawet przy dużym t.
  15. Wykonaj zrzuty ekranu działania programu profilującego w JSLinux.
  16. Przeanalizuj oficjalne wytyczne RFC 9106 (Argon2) i OWASP Password Storage.
  17. Sformułuj techniczne wnioski podsumowujące dlaczego pamięciochłonność jest jedyną skuteczną obroną przed atakami sprzętowymi.

Kontrola zaliczenia (checklist):

  1. Sparametryzowano scrypt/Argon2id na wektorze ze startera: czas×RAM vs koszt ASIC, model ekonomiczny ataku (USD/łamanie) dla różnych parametrów.
  2. Wykazano różnicę: PBKDF2 (tani w ASIC — GPU miażdży) vs Argon2id memory-hard (dziesiątki MB blokują miniaturyzację); dołączono pomiary.
  3. Dołączono log benchmarku (tabela czas/RAM) + kod łatki (Argon2id z min. pamięcią, unikalna sól, pepper po stronie serwera).
  4. Opisano w 3–5 zdaniach kompromis: compute-hard vs memory-hard, cache-timing vs GPU, koszt obrony na 1 logowanie.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego tekstu oraz opis kompromisu czas–pamięć / bezpieczeństwo–wydajność.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Dlaczego funkcje compute-hard (PBKDF2) faworyzują atakującego dysponującego klastrami GPU i układami ASIC.
  • Mechanizm działania funkcji memory-hard: wymóg natychmiastowego dostępu do dziesiątek megabajtów pamięci blokuje miniaturyzację układów łamiących.
  • Przewaga algorytmu Argon2id łączącego odporność na ataki cache-timing z odpornością na ataki GPU.
  • Student potrafi sparametryzować nowoczesne funkcje KDF w Pythonie oraz opracować wiarygodny model ekonomiczny kosztu ataku sprzętowego.
Zadanie 10 - ilustracja
Podgląd