Laboratorium 4
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 4.0

Poziom: ocena 4.0 - programistyczna i kryptoanalityczna analiza w środowisku Linux / Python

Zestaw 10 zaawansowanych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 4 (kryptografia asymetryczna - RSA, ECC, Diffie-Hellman i podpisy cyfrowe).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 4.0 wymagają łączenia analizy matematycznej z pisaniem i uruchamianiem autorskich skryptów w języku Python w środowisku konsolowym emulatora JSLinux Alpine (lub lokalnym interpreterze) oraz zaawansowanym posługiwaniem się narzędziami OpenSSL.
  • Zakres zadań obejmuje m.in.: samodzielną implementację silnika RSA z rozszerzonym algorytmem Euklidesa, demonstrację ataku multiplikatywnego i ataku z wybranym szyfrogramem (CCA1) na podręcznikowe RSA, kryptoanalityczny atak Håstada na mały wykładnik publiczny e=3 z użyciem Chińskiego Twierdzenia o Resztach, symulację protokołu DH i atak małej podgrupy, implementację geometrii i arytmetyki punktów na krzywej Weierstrassa (Point Addition, Point Doubling, Double-and-Add), procedurę generowania i weryfikacji podpisów ECDSA, rekonstrukcję ataku na stały nonce k w ECDSA (Sony PS3), dekompozycję struktur dopełnienia PKCS#1 v1.5 i RSA-PSS z funkcją MGF1, modelowanie ataku kolizyjnego ze wspólnym prefiksem na MD5 oraz benchmark i profilowanie wydajnościowe operacji asymetrycznych.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (4.0).
    • Opis konfiguracji środowiska badawczego, wersji interpretera Python oraz wykorzystanych narzędzi internetowych i bibliotek.
    • Pełny kod źródłowy opracowanych skryptów w języku Python opatrzony komentarzami technicznymi i dowodami algebraicznymi.
    • Opis procesu badawczego: zrzuty ekranu konsoli i wygenerowane tabele wyników, obliczone statystyki i wykazane zależności kryptoanalityczne.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami) oraz bibliografia techniczna i źródła internetowe.
Kryptologia
lab 4 - 4.0
Spis
Spis zadań laboratoryjnych na ocenę 4.0
01/10
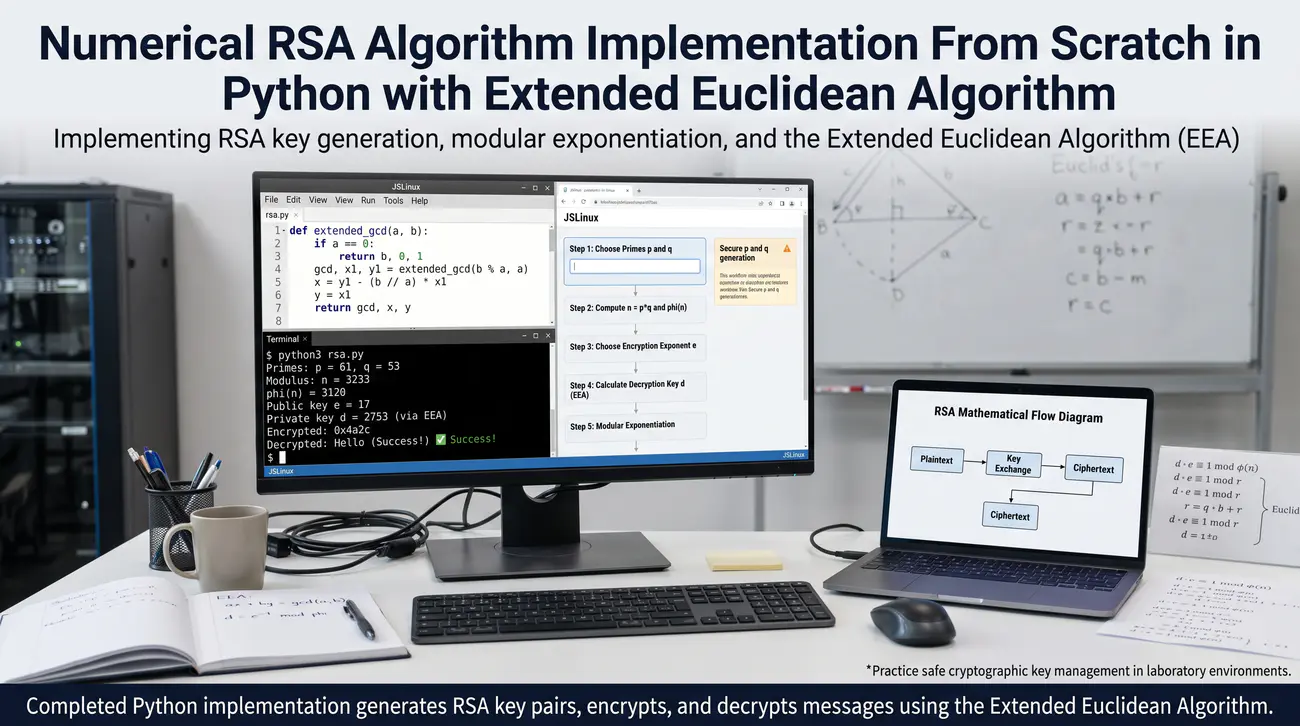
Zadanie 1. Numeryczna implementacja algorytmu RSA od podstaw w Pythonie z rozszerzonym algorytmem Euklidesa
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 7, 8, 9, 48: algorytm RSA, generowanie kluczy p i q, funkcja Eulera fi(n), wykładnik e, rozszerzony algorytm Euklidesa (EEA), potęgowanie modularne.

Cel

Celem zadania jest samodzielna implementacja pełnego matematycznego silnika algorytmu RSA w języku Python bez użycia zewnętrznych bibliotek kryptograficznych. Student implementuje rozszerzony algorytm Euklidesa do wyznaczania odwrotności modularnej d = e^(-1) mod fi(n), szybkie potęgowanie modularne oraz procedury szyfrowania i deszyfrowania bloków znakowych.

Scenariusz – opis

Zadanie rozpoczynasz od przygotowania środowiska uruchomieniowego języka Python w konsoli JSLinux Alpine lub na lokalnej stacji roboczej. Wykład z części 4 przedstawia precyzyjny aparat matematyczny stanowiący fundament algorytmu Rivesta, Shamira i Adlemana (RSA). Kluczowym elementem procedury generowania kluczy jest wyznaczenie wykładnika prywatnego d jako odwrotności modularnej wykładnika publicznego e. Równanie e * d = 1 (mod fi(n)) wymaga rozwiązania tożsamości Bézouta a*x + b*y = NWD(a, b) za pomocą rozszerzonego algorytmu Euklidesa (EEA). Samo szyfrowanie polega na obliczeniu potęgi modularnej c = m^e mod n, a deszyfrowanie na obliczeniu m = c^d mod n. W praktycznych implementacjach potęgowanie modularne musi być realizowane algorytmem potęgowania przez kwadratowanie w czasie O(log e).

Co ma wykonać student / grupa

Tworzysz plik rsa_core.py i definiujesz funkcję extended_gcd(a, b) zwracającą trójkę gcd, x, y spełniającą zależność a*x + b*y = gcd. Na bazie rozszerzonego Euklidesa implementujesz funkcję mod_inverse(e, phi) wyznaczającą poprawną dodatnią odwrotność modularną. Implementujesz algorytm szybkiego potęgowania modularnego mod_exp(base, exp, mod) wykorzystujący reprezentację binarną wykładnika. Dobierasz dydaktyczne liczby pierwsze: najpierw małe p = 61, q = 53, obliczasz n = 3233 oraz fi(n) = 3120.

Ustawiasz publiczny wykładnik e = 17, sprawdzasz warunek gcd(e, fi(n)) = 1 i wyznaczasz wykładnik prywatny d = 2753. Sprawdzasz poprawność matematyczną: obliczasz iloczyn (e * d) mod fi(n) i upewniasz się, że wynosi dokładnie 1. Kodujesz prosty mechanizm konwersji tekstu na liczbę całkowitą (np. bajt po bajcie lub za pomocą metody int.from_bytes). Szyfrujesz liczbę reprezentującą pojedynczą literę lub krótki ciąg m = 65 ('A') i otrzymujesz szyfrogram c.

Deszyfrujesz c za pomocą wykładnika d i potwierdzasz odzyskanie pierwotnej liczby 65. Rozszerzasz skrypt o generowanie większych liczb pierwszych o długości 64 bitów przy użyciu testu pierwszości Millera-Rabina. Szyfrujesz wieloznakową wiadomość 'KRYPTO_LAB4' dzieląc ją na bloki mniejsze od wyznaczonego modułu n. Weryfikujesz odporność algorytmu na błędny klucz prywatny: wprowadzasz d' != d i sprawdzasz, że odzyskane dane są bezużytecznym szumem. Porównujesz czas wykonania autorskiej funkcji potęgowania modularnego z wbudowaną funkcją pow(base, exp, mod) w Pythonie.

Sporządzasz tabelę pośrednich kroków algorytmu Euklidesa dla wyznaczenia d oraz zapisujesz wygenerowane pary kluczy. Wpisujesz do raportu obowiązkowe zdanie: klucz 64-bitowy łamie się faktoryzacją w sekundy, produkcja wymaga minimum 2048 bitów (por. 5.0/zad. 1). Dokumentujesz zrzutami ekranu działanie skryptu i kompletujesz sprawozdanie.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom interpreter Pythona w JSLinux lub w środowisku lokalnym.
  2. Utwórz plik rsa_core.py i zaimplementuj funkcję extended_gcd(a, b).
  3. Zaimplementuj funkcję mod_inverse(e, phi) z obsługą wyjątku braku względnej pierwszości.
  4. Zaimplementuj funkcję potęgowania modularnego power_mod( base, exp, mod) metodą binarną.
  5. Zdefiniuj liczby p=61, q=53 i oblicz n = p*q oraz phi = (p-1)*(q-1).
  6. Wybierz e=17 i wylicz d = mod_inverse(e, phi).
  7. Zweryfikuj tożsamość: (e * d) % phi == 1.
  8. Zaszyfruj wiadomość m = 65 (kod litery 'A'): c = power_mod(m, e, n).
  9. Odszyfruj szyfrogram: m_rec = power_mod(c, d, n) i porównaj z m.
  10. Zaimplementuj funkcję testującą pierwszość liczb metodą Millera-Rabina.
  11. Wygeneruj dwie losowe 64-bitowe liczby pierwsze p_big i q_big.
  12. Oblicz n_big, phi_big oraz wyznacz klucz prywatny d_big dla standardowego e=65537.
  13. Zaszyfruj wiadomość tekstową 'LAB4_RSA_TEST' konwertowaną przez int.from_bytes.
  14. Odszyfruj wiadomość i zdekoduj ją za pomocą to_bytes().decode().
  15. Wykonaj test błędnego klucza (d_fake = d_big + 2) i zarejestruj wynik.
  16. Zapisz kody źródłowe oraz zrzuty ekranu wyników wykonania skryptu do sprawozdania.

Kontrola zaliczenia (checklist):

  1. Uruchomiono silnik RSA i zachowano log: generowanie p,q,n,φ,e,d (Euklides), szyfrowanie/deszyfrowanie Okrągłe dla min. 2 wiadomości, bez bibliotek krypto.
  2. Dołączono kod (własne min. 30 linii): rozszerzony Euklides, szybkie potęgowanie mod, test M^ed = M.
  3. Przeprowadzono test pozytywny (okrągłość działa) i negatywny (e niekoproste z φ — program odmawia zamiast liczyć zły d).
  4. Opisano w 3–5 zdaniach: n=p·q, φ, tożsamość Bézouta, symetria potęg, dlaczego demo to bity dydaktyczne a produkcja to ≥2048 (por. 5.0/z.1).

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Praktyczne zrozumienie matematycznych podstaw RSA: iloczynu n=p*q, funkcji Eulera fi(n) oraz roli tożsamości Bézouta.
  • Umiejętność samodzielnej implementacji rozszerzonego algorytmu Euklidesa oraz szybkiego potęgowania modularnego.
  • Zrozumienie, dlaczego operacje szyfrowania i deszyfrowania są w pełni symetrycznymi przekształceniami potęgowymi modulo n.
  • Świadomość konieczności operowania na liczbach wielokrotnie większych od 64 bitów w zastosowaniach produkcyjnych (64 bity łamane faktoryzacją w sekundy; produkcja minimum 2048 bitów, por. 5.0/zad. 1).
Zadanie 1 - ilustracja
02/10
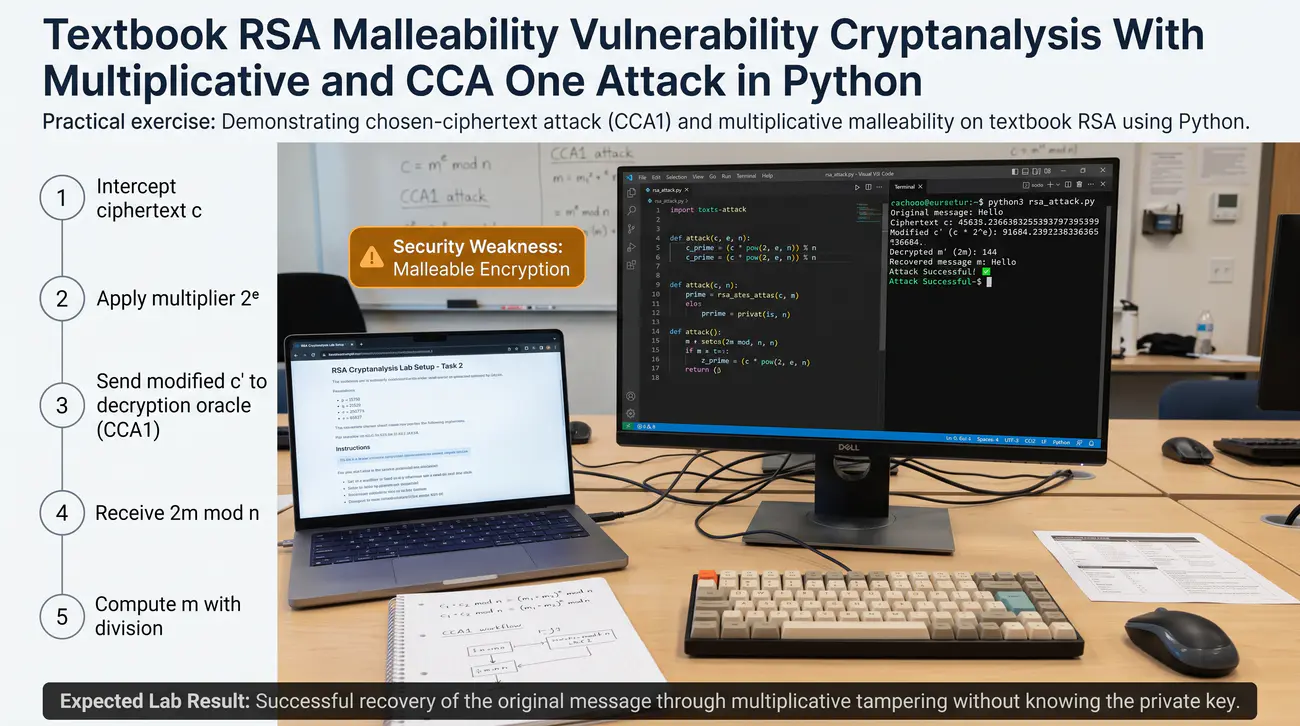
Zadanie 2. Kryptoanaliza podatności podręcznikowego RSA (Textbook RSA) na atak multiplikatywny i CCA1 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 8, 10, 11: właściwość homomorficzna RSA, c1*c2 mod n = (m1*m2)^e mod n, podatność podręcznikowego RSA (Textbook RSA), atak z wybranym szyfrogramem (CCA1).

Cel

Celem zadania jest praktyczne zbadanie i demonstracja słabości podręcznikowej wersji RSA pozbawionej losowego dopełnienia (Textbook RSA). Student implementuje w Pythonie atak multiplikatywny na szyfrogramy oraz atak z wybranym szyfrogramem (Chosen-Ciphertext Attack CCA1), dowodząc, że napastnik może odszyfrować przechwyconą wiadomość bez znajomości klucza prywatnego.

Scenariusz – opis

Podręcznikowa definicja RSA traktuje szyfrowanie jako prostą operację c = m^e mod n na liczbach całkowitych. Taka konstrukcja wykazuje fundamentalną właściwość algebraiczną zwaną homomorfizmem multiplikatywnym. Iloczyn dwóch szyfrogramów c1 = m1^e mod n oraz c2 = m2^e mod n tworzy szyfrogram iloczynu wiadomości: c1 * c2 mod n = (m1 * m2)^e mod n. Właściwość ta pozwala napastnikowi na bezkarną manipulację treścią zaszyfrowanej wiadomości bez znajomości klucza prywatnego d. Co więcej, w scenariuszu ataku Chosen-Ciphertext Attack (CCA1) napastnik może oszukać wyrocznię deszyfrującą. Jeśli wyrocznia odmawia odszyfrowania przechwyconego szyfrogramu c, napastnik mnoży go przez losowy czynnik r^e mod n, uzyskując c' = c * r^e mod n.

Co ma wykonać student / grupa

W środowisku Python przygotowujesz skrypt rsa_homomorphic_attack.py z generatorem kluczy RSA (moduł n o długości 1024 bitów oraz e = 65537). Definiujesz dwie wiadomości numeryczne reprezentujące kwoty transakcji: m1 = 100 oraz m2 = 5. Obliczasz szyfrogramy obu wiadomości: c1 = m1^e mod n oraz c2 = m2^e mod n bez żadnego paddingu. Jako napastnik przechwytujesz c1 oraz c2 i obliczasz sfałszowany szyfrogram c_fake = (c1 * c2) mod n.

Przekazujesz c_fake do procedury deszyfrującej i sprawdzasz wynik: odszyfrowana wartość wynosi dokładnie 500 (100 * 5). Wykazujesz, że napastnik pomnożył kwotę przelewu pięciokrotnie bez konieczności łamania klucza prywatnego d. W drugiej części zadania implementujesz atak CCA1 na poufną wiadomość m_secret zaszyfrowaną do szyfrogramu c_target. Zakładasz obecność wyroczni deszyfrującej, która odszyfrowuje dowolny nadesłany szyfrogram za wyjątkiem zastrzeżonego c_target.

Losujesz liczbę r względnie pierwszą z n (2 <= r < n) i obliczasz zamaskowany szyfrogram c_blind = (c_target * pow(r, e, n)) mod n. Przesyłasz c_blind do wyroczni deszyfrującej: ponieważ c_blind != c_target, wyrocznia wykonuje deszyfrowanie i zwraca m_blind = c_blind^d mod n. Wykazujesz analitycznie, że m_blind = m_secret * r mod n. Odzyskujesz ściśle tajną wiadomość: obliczasz r_inv = pow(r, -1, n) (Python 3.8+; w starszym/JSLinux użyj fallbacku własną mod_inverse(r, n) z zad.

1) i wyznaczasz m_secret = (m_blind * r_inv) mod n. Sprawdzasz tożsamość odzyskanej wiadomości z oryginałem, potwierdzając 100% skuteczność ataku. Modyfikujesz procedurę dodając bezpieczne dopełnienie OAEP i dowodzisz, że atak całkowicie przestaje działać (wyrocznia odrzuca c_blind). Sporządzasz sprawozdanie z dowodami algebraicznymi oraz zrzutami ekranu przebiegu ataku.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik rsa_homomorphic_attack.py w katalogu roboczym.
  2. Wygeneruj parę kluczy RSA-1024 (n, e, d) przy użyciu Pythona.
  3. Zdefiniuj funkcję szyfrowania podręcznikowego: encrypt_raw(m, e, n) = pow(m, e, n).
  4. Zdefiniuj funkcję deszyfrowania podręcznikowego: decrypt_raw(c, d, n) = pow(c, d, n).
  5. Zaszyfruj wiadomości m1=250 oraz m2=4: c1 = encrypt_raw(m1, e, n), c2 = encrypt_raw(m2, e, n).
  6. Oblicz c_mult = (c1 * c2) % n.
  7. Odszyfruj c_mult kluczem prywatnym d i potwierdź, że wynik równa się m1 * m2 = 1000.
  8. Zdefiniuj tajną wiadomość tekstową i przekształć ją na liczbę m_secret.
  9. Zaszyfruj wiadomość docelową: c_target = encrypt_raw(m_secret, e, n).
  10. Zaimplementuj wyrocznię oracle_decrypt(c, c_forbidden, d, n), która zgłasza błąd dla c == c_forbidden.
  11. Wylosuj liczbę maskującą r względnie pierwszą z n.
  12. Oblicz zamaskowany szyfrogram: c_blind = (c_target * pow(r, e, n)) % n.
  13. Wyślij c_blind do wyroczni i odbierz odszyfrowany wynik m_blind = oracle_decrypt(c_blind, c_target, d, n).
  14. Oblicz odwrotność r modulo n: r_inv = pow(r, -1, n) (wymaga Pythona 3.8+; sprawdź python3 --version, fallback: własna mod_inverse(r, n) z zad. 1).
  15. Odzyskaj tajną wiadomość: m_recovered = (m_blind * r_inv) % n.
  16. Przekształć m_recovered na tekst i potwierdź pełną zgodność z m_secret.

Kontrola zaliczenia (checklist):

  1. Uruchomiono atak i zachowano log: z C1,C2 wyliczono C1·C2 odpowiadające M1·M2 oraz pełny CCA1 z blindingiem odszyfrował C bez klucza na wyroczni.
  2. Dołączono kod (własne min. 25 linii): mnożenie szyfrogramów mod n, blinding r^e, zapytanie wyroczni, unblinding.
  3. Przeprowadzono test pozytywny (atak działa na textbook) i negatywny (ten sam atak na RSA-OAEP — wyrocznia odrzuca, brak wycieku).
  4. Opisano w 3–5 zdaniach: homomorfizm multiplikatywny, plastyczność, OAEP jako obowiązek.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie zjawiska homomorfizmu multiplikatywnego w podręcznikowym algorytmie RSA.
  • Empiryczny dowód na podatność czystego RSA na manipulację szyfrogramem (malleability).
  • Praktyczna realizacja ataku z wybranym szyfrogramem (CCA1) z wykorzystaniem techniki maskowania (blinding).
  • Zrozumienie, dlaczego losowy padding OAEP jest bezwzględnie wymagany we wszystkich bezpiecznych wdrożeniach RSA.
Zadanie 2 - ilustracja
03/10
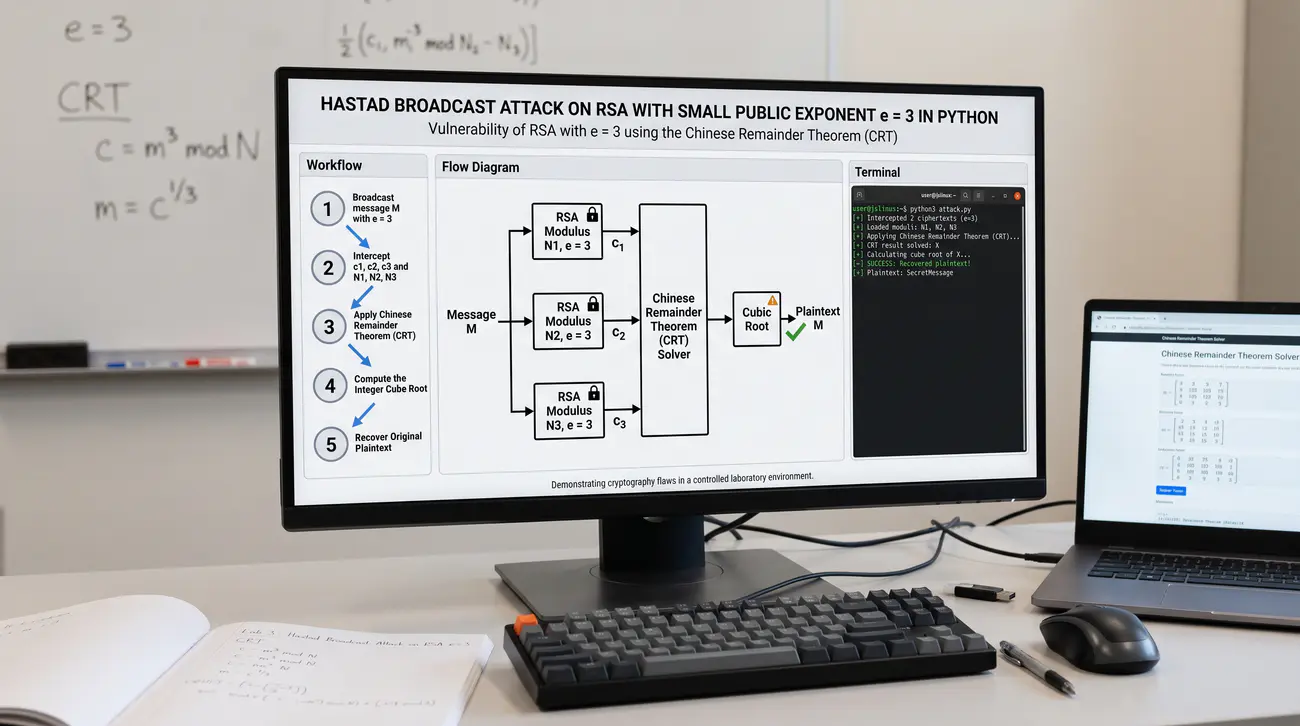
Zadanie 3. Kryptoanalityczny atak Håstada na RSA z małym wykładnikiem publicznym e=3 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 7, 10, 11: wybór wykładnika publicznego e, dlaczego historycznie wybierano e=3, atak rozgłoszeniowy Håstada (Broadcast Attack), Chińskie Twierdzenie o Resztach (CRT).

Cel

Celem zadania jest praktyczna rekonstrukcja i kryptoanaliza ataku rozgłoszeniowego Håstada (Håstad's Broadcast Attack) na algorytm RSA z małym wykładnikiem publicznym e=3. Student implementuje w Pythonie Chińskie Twierdzenie o Resztach (CRT) i udowadnia, że przechwycenie tej samej wiadomości wysłanej do trzech różnych odbiorców pozwala na natychmiastowe odzyskanie tekstu jawnego.

Scenariusz – opis

W początkowym okresie wdrażania RSA powszechnie stosowano bardzo mały wykładnik publiczny e=3 w celu drastycznego przyspieszenia szyfrowania. Operacja c = m^3 mod n wymaga jedynie dwóch mnożeń modularnych, co zapewniało znakomitą wydajność procesorów. Wykładnik e=3 niesie jednak ze sobą śmiertelne zagrożenie kryptoanalityczne w scenariuszu transmisji rozgłoszeniowej. Wyobraźmy sobie nadawcę wysyłającego ten sam komunikat m do trzech różnych odbiorców o publicznych modułach n1, n2 oraz n3. Zakładamy, że moduły są względnie pierwsze, a wiadomość m nie posiadała losowego dopełnienia (paddingu). Napastnik podsłuchujący kanał rejestruje trzy szyfrogramy: c1 = m^3 mod n1, c2 = m^3 mod n2 oraz c3 = m^3 mod n3.

Co ma wykonać student / grupa

Tworzysz skrypt hastad_attack.py w środowisku Python do symulacji ataku rozgłoszeniowego. Generujesz trzy niezależne moduły RSA n1, n2, n3 o długości 1024 bitów z ustalonym wykładnikiem e = 3.

Upewniasz się, że moduły są parami względnie pierwsze (NWD(ni, nj) == 1 dla każdego i != j). Wymagasz w skrypcie testu gcd(n_i,n_j)==1 przed atakiem i dopisujesz wniosek: ten sam atak pada po dodaniu OAEP nawet z e = 3. Definiujesz poufną wiadomość tekstową m, na przykład haslo_autoryzacyjne_systemu_2026. Konwertujesz tekst m na liczbę całkowitą i sprawdzasz warunek wstępny ataku: m < min(n1, n2, n3).

Obliczasz trzy szyfrogramy: c1 = pow(m, 3, n1), c2 = pow(m, 3, n2) oraz c3 = pow(m, 3, n3). Jako napastnik posiadasz wyłącznie wartości publiczne: (n1, c1), (n2, c2) oraz (n3, c3) i wiesz, że e = 3. Implementujesz algorytm Chińskiego Twierdzenia o Resztach (CRT) dla układu trzech kongruencji: x = c1 mod n1, x = c2 mod n2, x = c3 mod n3. Obliczasz iloczyn modułów N = n1 * n2 * n3 oraz składowe N1 = N // n1, N2 = N // n2, N3 = N // n3.

Wyznaczasz odwrotności modularne u1 = N1^(-1) mod n1, u2 = N2^(-1) mod n2 oraz u3 = N3^(-1) mod n3 za pomocą rozszerzonego Euklidesa. Składasz rozwiązanie kongruencji CRT: C = (c1*N1*u1 + c2*N2*u2 + c3*N3*u3) mod N. Wykazujesz kluczowy fakt matematyczny: ponieważ m < n1, m < n2 i m < n3, to m^3 <n1*n2*n3 = N. Oznacza to, że wartość C w ciele liczb całkowitych jest dokładnie równa m^3 bez żadnej redukcji modulo N.

Obliczasz zwykły pierwiastek sześcienny z C nad liczbami całkowitymi za pomocą metody bisekcji (binary search). Odzyskujesz liczbę m, konwertujesz ją na ciąg bajtów i odczytujesz oryginalną tajną wiadomość. Dokumentujesz matematyczne uzasadnienie ataku, logi skryptu oraz powody, dla których standardem stało się e = 65537.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik hastad_attack.py w edytorze kodu.
  2. Zaimplementuj generator kluczy RSA generujący moduły n z wykładnikiem e=3.
  3. Wygeneruj trzy moduły n1, n2, n3 o długości 1024 bitów.
  4. Sprawdź względną pierwszość modułów: math.gcd(n1, n2) == 1 itd.
  5. Zdefiniuj wiadomość tekstową i przekształć ją na liczbę m.
  6. Zaszyfruj wiadomość dla trzech odbiorców: c1 = pow(m, 3, n1), c2 = pow(m, 3, n2), c3 = pow(m, 3, n3).
  7. Zaimplementuj funkcję solve_crt( congruences) realizującą Chińskie Twierdzenie o Resztach.
  8. Oblicz N = n1 * n2 * n3.
  9. Oblicz czynniki Ni = N // ni oraz ich odwrotności ui = pow(Ni, -1, ni).
  10. Wylicz połączony szyfrogram C_crt = sum(ci * Ni * ui) % N.
  11. Zaimplementuj funkcję integer_cube_root(n) znajdującą dokładny pierwiastek sześcienny metodą binarną.
  12. Wylicz m_cracked = integer_cube_root(C_crt).
  13. Zweryfikuj tożsamość: pow(m_cracked, 3) == C_crt.
  14. Przekształć m_cracked na tekst za pomocą to_bytes().decode().
  15. Potwierdź pełne odzyskanie wiadomości m_cracked == m bez znajomości jakiegokolwiek klucza prywatnego d.
  16. Wykonaj zrzut ekranu działania skryptu i sporządź wnioski do sprawozdania.

Kontrola zaliczenia (checklist):

  1. Uruchomiono atak Håstada i zachowano log: 3 szyfrogramy tego samego M pod e=3, CRT na N=N1·N2·N3, pierwiastek sześcienny = M bez redukcji mod.
  2. Dołączono kod (własne min. 25 linii): CRT dla 3 modułów, icbrt, weryfikacja M^3 < N.
  3. Przeprowadzono test pozytywny (broadcast bez paddingu — odzysk) i negatywny (OAEP/losowy padding — CRT daje śmieć, atak nie działa).
  4. Opisano w 3–5 zdaniach: brak redukcji przez małe M^e, rola CRT, e=65537 + OAEP jako lekcja branży.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie ataku rozgłoszeniowego Håstada na mały wykładnik publiczny RSA.
  • Praktyczna umiejętność implementacji i zastosowania Chińskiego Twierdzenia o Resztach (CRT) w kryptoanalizie.
  • Zrozumienie, w jaki sposób brak redukcji modularnej pozwala na wyznaczenie tekstu jawnego zwykłym pierwiastkowaniem całkowitym.
  • Uzasadnienie historycznego przejścia branży IT na wykładnik Fermata e=65537 (2^16 + 1) oraz stosowanie losowego paddingu OAEP.
Zadanie 3 - ilustracja
04/10
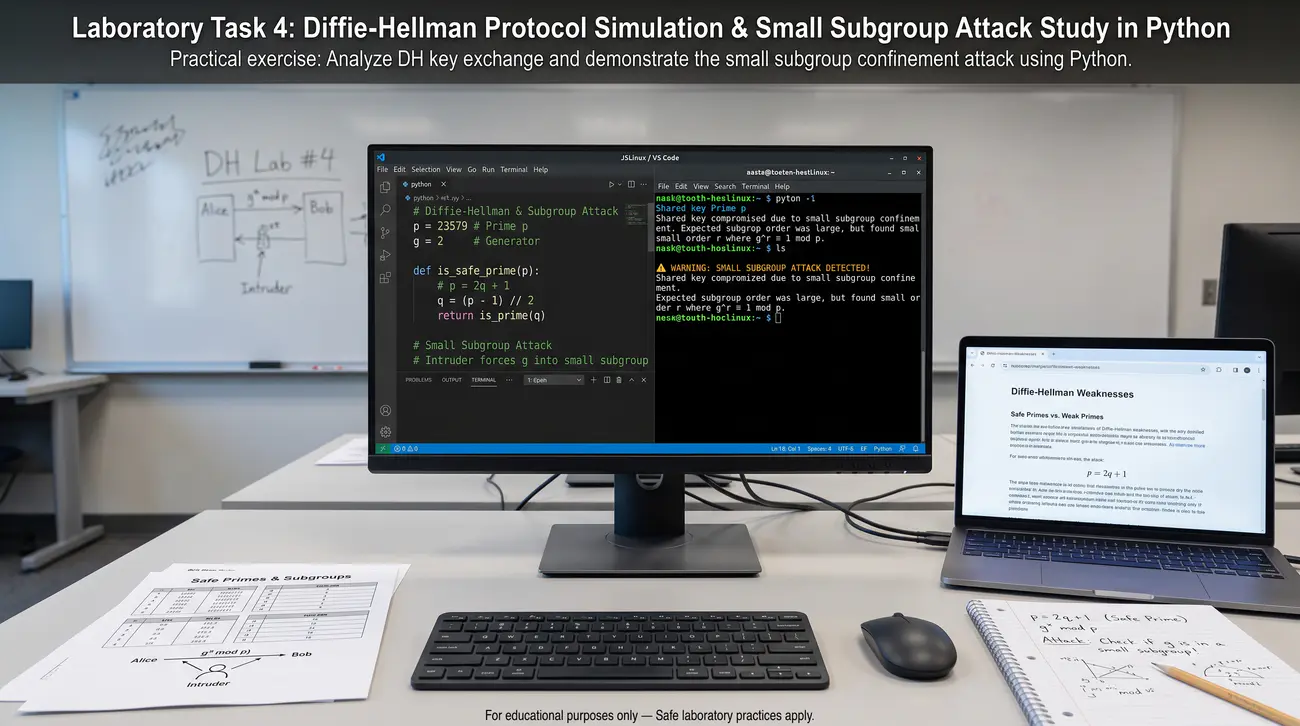
Zadanie 4. Symulacja protokołu Diffiego-Hellmana i badanie ataku małej podgrupy w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 13, 14, 15, 49: protokół Diffiego-Hellmana, dobór grupy Z_p^*, bezpieczne liczby pierwsze (Safe Primes) p=2q+1, atak małej podgrupy (Small Subgroup Confinement Attack).

Cel

Celem zadania jest programistyczna analiza bezpieczeństwa protokołu Diffiego-Hellmana pod kątem struktury algebraicznej grupy multiplikatywnej. Student implementuje protokół DH w Pythonie, porównuje działanie bezpiecznych liczb pierwszych Sophie Germain z liczbami o słabej strukturze dzielników p-1 oraz demonstruje atak wymuszenia małej podgrupy (Small Subgroup Confinement Attack).

Scenariusz – opis

Bezpieczeństwo protokołu Diffiego-Hellmana zależy krytycznie od właściwości grupy cyklicznej, w której wykonywane są obliczenia. Rząd grupy multiplikatywnej Z_p^* wynosi p-1, a na mocy twierdzenia Lagrange'a rząd każdej podgrupy musi dzielić p-1. Jeśli liczba p-1 posiada wiele małych czynników pierwszych, napastnik może wymusić, aby uzgodniony sekret wpadł do małej podgrupy. W ataku małej podgrupy aktywny adwersarz przesyła spreparowany element publiczny o bardzo małym rzędzie d (np. d=2 lub d=3). W rezultacie obliczony przez ofiarę wspólny sekret K może przyjąć jedynie d różnych wartości, co pozwala na natychmiastowe odgadnięcie klucza. Z tego względu standardy kryptograficzne wymagają stosowania bezpiecznych liczb pierwszych (ang. Safe Primes), gdzie p = 2*q + 1, a q jest liczbą pierwszą.

Co ma wykonać student / grupa

W środowisku Python tworzysz skrypt dh_group_analysis.py modelujący wymianę kluczy Diffiego-Hellmana. Definiujesz bezpieczną liczbę pierwszą p_safe = 2*q + 1 (np. wygenerowaną lub z wektorów RFC 3526) oraz generator g = 2. Implementujesz standardową procedurę wymiany: Alice losuje a i wylicza A = g^a mod p, Bob losuje b i wylicza B = g^b mod p. Weryfikujesz, że obie strony uzgadniają ten sam sekret K = pow(B, a, p) == pow(A, b, p).

W kolejnym kroku definiujesz 'słabą' liczbę pierwszą p_weak taką, że p_weak - 1 rozkłada się na iloczyn małych liczb pierwszych. Wyznaczasz element h o rzędzie r = 2 w grupie Z_p^* (elementem tym jest h = p - 1, ponieważ (-1)^2 = 1 mod p). Symulujesz atak na Boba: napastnik Mallory przechwytuje sesję i zamiast prawdziwego klucza publicznego A przesyła Bobowi wartość A_malicious = p - 1. Bob, nie weryfikując poprawności otrzymanego klucza publicznego, oblicza sekret: K_bob = pow(A_malicious, b, p).

Analizujesz uzyskany wynik: w zależności od tego, czy tajny wykładnik b Boba jest parzysty czy nieparzysty, K_bob wynosi 1 lub p - 1. Mallory testuje obie możliwości: jeśli K_bob == 1, poznaje najmniej znaczący bit klucza prywatnego Boba i natychmiast deszyfruje sesję. Rozszerzasz atak na podgrupę o rzędzie r = 3 i r=5, dowodząc zawężenia przestrzeni sekretu do zaledwie kilku wartości. Implementujesz mechanizm obronny: procedurę walidacji klucza publicznego sprawdzającą warunki 2 <= Y <= p - 2 oraz Y^q mod p == 1. Weryfikujesz, że poprawnie zaimplementowana walidacja natychmiast wykrywa i odrzuca spreparowane klucze Mallory'ego. Sporządzasz zestawienie tabelaryczne wyników ataków dla różnych rzędów podgrup. Formułujesz wnioski dotyczące konieczności rygorystycznej walidacji parametrów wejściowych w protokołach kryptograficznych.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik dh_group_analysis.py w środowisku roboczym.
  2. Zaimplementuj podstawowe funkcje wymiany DH: gen_keypair(p, g) oraz derive_secret( priv, pub, p).
  3. Przeprowadź symulację poprawnej wymiany kluczy dla bezpiecznej liczby pierwszej p.
  4. Zbadaj strukturę grupy Z_p^*: znajdź dzielniki liczby p - 1.
  5. Zaimplementuj generator elementów o zadanym rzędzie r dzielącym p - 1 (szkielet: gotowa funkcja element_order_n(p, r) w karcie).
  6. Skonstruuj złośliwy klucz publiczny o rzędzie r = 2: pub_malicious = p - 1.
  7. Wykonaj test bramkowy ze szkieletu: wstrzyknij rząd 2 i rząd 3, pokaż obie redukcje sekretu, zanim student ruszy własną walidację.
  8. Przekaż złośliwy klucz do funkcji derywacji Boba: secret_bob = derive_secret(b, pub_malicious, p).
  9. Sprawdź wartość secret_bob: powinna wynosić 1 (dla parzystego b) lub p - 1 (dla nieparzystego b).
  10. Zaimplementuj procedurę Mallory'ego odgadującą sekret Boba w maksymalnie 2 próbach.
  11. Skonstruuj element o małym rzędzie r = 3 lub r = 4 i powtórz eksperyment.
  12. Oceń liczbę operacji wymaganych do odgadnięcia klucza sesyjnego.
  13. Zaimplementuj funkcję validate_public_key(pub, p, q) odrzucającą klucze z małych podgrup.
  14. Przetestuj działanie walidacji na złośliwym kluczu pub_malicious i zarejestruj wyjątek bezpieczeństwa.
  15. Przetestuj działanie walidacji na poprawnym kluczu Alice i potwierdź jego akceptację.
  16. Wykonaj zrzuty ekranu prezentujące przebieg ataku i skuteczne działanie walidacji.
  17. Opracuj raport laboratoryjny z matematycznym uzasadnieniem twierdzenia Lagrange'a.

Kontrola zaliczenia (checklist):

  1. Uruchomiono symulację DH i zachowano log: Sophie Germain (bezpieczna) vs gładkie p−1, confinement sekretu do małej podgrupy przy złośliwym A.
  2. Dołączono kod (własne min. 25 linii): generowanie grup, detekcja rzędu, demo wycieku bitów sekretu.
  3. Przeprowadzono test pozytywny (gładka grupa — sekret w małej podgrupie) i negatywny (Sophie Germain + walidacja A^q=1 — atak odparty).
  4. Opisano w 3–5 zdaniach: Lagrange/podgrupy, confinement, walidacja klucza w podgrupie q.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie algebraicznej budowy grupy Z_p^* oraz roli twierdzenia Lagrange'a w bezpieczeństwie DH.
  • Praktyczna demonstracja ataku Small Subgroup Confinement Attack drastycznie redukującego entropię sekretu.
  • Zrozumienie przewagi bezpiecznych liczb pierwszych Sophie Germain (p = 2q+1) nad liczbami o gładkim p-1.
  • Znajomość i umiejętność implementacji reguł walidacji klucza publicznego (sprawdzanie podgrup rzędu q).
Zadanie 4 - ilustracja
05/10
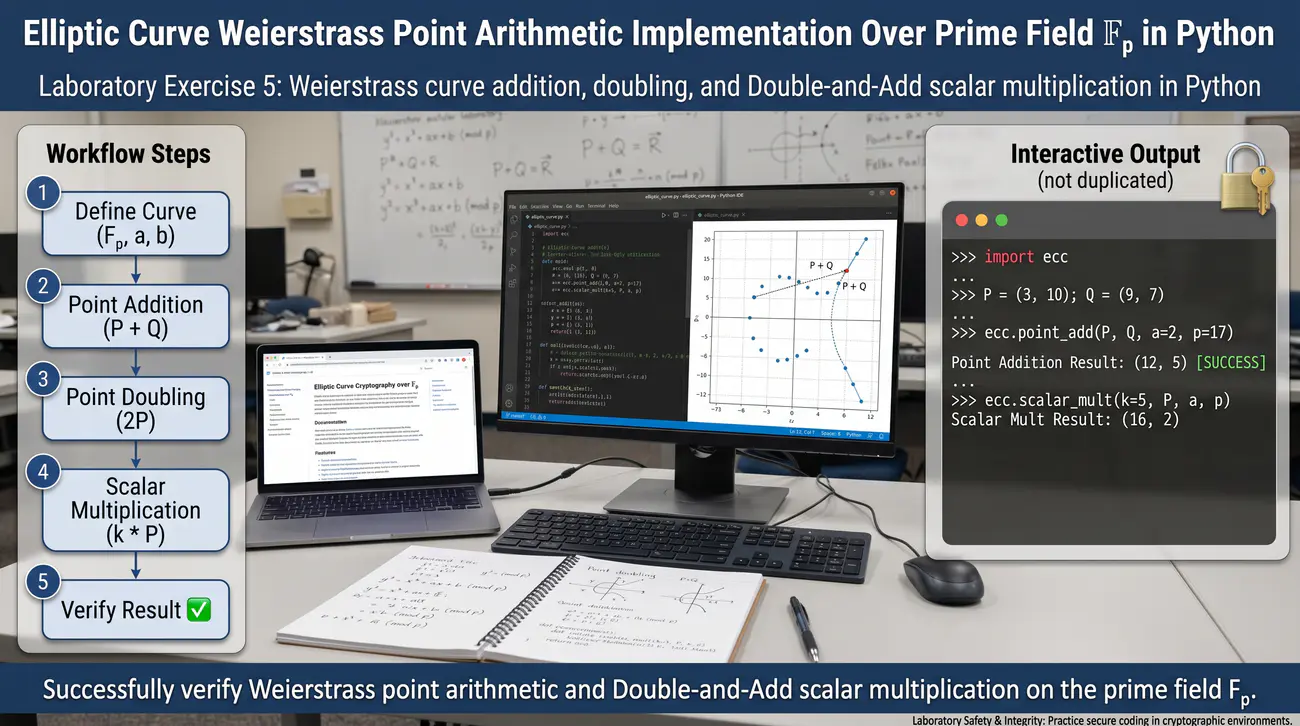
Zadanie 5. Matematyczna implementacja arytmetyki punktów na krzywej eliptycznej Weierstrassa w ciele F_p w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 18, 19, 20: równanie Weierstrassa y^2 = x^3 + ax + b mod p, prawo grupowe, dodawanie punktów (Point Addition), podwajanie (Point Doubling), mnożenie skalarne Double-and-Add.

Cel

Celem zadania jest samodzielna implementacja geometrii i algebry krzywych eliptycznych nad ciałami skończonymi F_p w języku Python. Student implementuje klasę reprezentującą punkty na krzywej Weierstrassa, wzory algebraiczne na dodawanie punktów P + Q, podwajanie 2*P, punkt w nieskończoności O oraz algorytm Double-and-Add do mnożenia skalarnego k*P.

Scenariusz – opis

Kryptografia krzywych eliptycznych opiera się na strukturze grupy abelowej utworzonej przez zbiór punktów spełniających równanie Weierstrassa. Równanie przyjmuje postać y^2 = x^3 + a*x + b (mod p), gdzie parametr wyróżnika 4*a^3 + 27*b^2 != 0 (mod p) zapewnia gładkość krzywej. Elementem neutralnym grupy jest abstrakcyjny punkt w nieskończoności O, pełniący rolę zera w operacji dodawania. Dodawanie dwóch różnych punktów P i Q polega na poprowadzeniu przez nie prostej siecznej o nachyleniu s = (y2 - y1) / (x2 - x1) mod p. W przypadku dodawania punktu do samego siebie (podwajanie P + P = 2P) wyznacza się nachylenie prostej stycznej s = (3*x1^2 + a) / (2*y1) mod p. Mnożenie punktu przez skalar k*P realizuje się za pomocą wydajnego algorytmu Double-and-Add, będącego odpowiednikiem potęgowania binarnego.

Co ma wykonać student / grupa

Tworzysz plik ecc_math.py i definiujesz strukturę danych lub klasę EllipticCurve przechowującą parametry ciała p oraz współczynniki a i b. Korzystasz ze szkieletu klasy Point z karty (obsługa O oraz P+(-P)=O) i testujesz bramkowo: P=(3, 10), Q=(9, 7) muszą leżeć na krzywej, inaczej korygujesz wzory. Implementujesz klasę Point ze współrzędnymi (x, y) oraz specjalną reprezentacją punktu w nieskończoności (np. x = None, y = None). Tworzysz metodę is_on_curve(point) sprawdzającą tożsamość y^2 == x^3 + a*x + b (mod p).

Dobierasz dydaktyczną małą krzywą: p = 23, a = 1, b=1 (równanie y^2 = x^3 + x + 1 mod 23). Wypisujesz wszystkie punkty należące do wybranej krzywej za pomocą prostej pętli i zliczasz ich liczbę (rząd grupy na mocy twierdzenia Hassego). Implementujesz metodę point_add(P, Q) obsługującą wszystkie przypadki brzegowe: dodawanie punktu O, P + (-P) = O, P != Q oraz P == Q. Testujesz dodawanie punktów na konkretnych parach (np. P=(3, 10), Q=(9, 7)) i sprawdzasz, czy wynikowy punkt również leży na krzywej.

Implementujesz metodę point_double(P) wyznaczającą styczną modularną z wykorzystaniem odwrotności modularnej pow(2*y, -1, p). Implementujesz algorytm mnożenia skalarnego scalar_mult(k, P) techniką Double-and-Add o złożoności O(log k). Wyznaczasz rząd punktu bazowego G=(3, 10), znajdując najmniejszą liczbę całkowitą n taką, że n*G = O. Przenosisz zaimplementowaną logikę na parametry oficjalnej 256-bitowej krzywej NIST secp256k1 (używanej w Bitcoinie) lub secp256r1 (P-256).

Generujesz przykładowy klucz prywatny jako losowy skalar d i obliczasz klucz publiczny Q = d * G na dużej krzywej. Sprawdzasz, że obliczony punkt Q spełnia równanie krzywej P-256. Porównujesz czas wykonania mnożenia skalarnego z wbudowanymi bibliotekami. Sporządzasz pełną dokumentację matematyczną z wykresami dydaktycznymi i tabelami punktów w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik ecc_math.py w środowisku roboczym.
  2. Zaimplementuj klasę EllipticCurve(a, b, p).
  3. Zaimplementuj klasę Point(x, y, is_infinity).
  4. Napisz funkcję find_all_points( curve) i znajdź wszystkie punkty krzywej y^2 = x^3 + x + 1 mod 23.
  5. Zanotuj liczbę znalezionych punktów i porównaj z ograniczeniem twierdzenia Hassego |N - (p+1)| <= 2*sqrt(p).
  6. Zaimplementuj funkcję point_add(P, Q, curve) z obsługą siecznej i elementu neutralnego.
  7. Zaimplementuj funkcję point_double(P, curve) z obsługą stycznej modularnej.
  8. Przetestuj dodawanie punktów P=(3, 10) i Q=(9, 7) i potwierdź, że punkt wynikowy leży na krzywej.
  9. Zaimplementuj algorytm mnożenia skalarnego scalar_mult(k, P, curve) metodą Double-and-Add.
  10. Oblicz wielokrotności punktu G=(3, 10): 2G, 3G, 4G aż do n*G = O.
  11. Wyznacz rząd punktu G i sprawdź czy dzieli liczbę punktów krzywej.
  12. Zdefiniuj parametry krzywej secp256k1 (p, a=0, b=7, G_x, G_y, n).
  13. Wygeneruj losowy 256-bitowy klucz prywatny: priv_key = secrets.randbelow(n).
  14. Oblicz klucz publiczny pub_point = scalar_mult(priv_key, G, curve_secp256k1).
  15. Sprawdź tożsamość punktu publicznego na krzywej secp256k1.
  16. Wykonaj zrzuty ekranu wyników obliczeń i dołącz kody źródłowe do raportu.

Kontrola zaliczenia (checklist):

  1. Uruchomiono arytmetykę EC i zachowano log: P+Q, 2P, k·G (double-and-add) na krzywej testowej nad Fp, w tym przypadki P+O, P+(−P), styczna pionowa.
  2. Dołączono kod (własne min. 30 linii): klasa Punktu, nachylenia siecznej/stycznej mod p, mnożenie skalarne.
  3. Przeprowadzono test pozytywny (Q=d·G, asocjacyjność na próbkach) i negatywny (punkt spoza krzywej — odrzucony walidacją).
  4. Opisano w 3–5 zdaniach: grupa punktów, Double-and-Add, ECDLP jako fundament ECC.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie geometrycznej i algebraicznej konstrukcji grupy punktów na krzywej eliptycznej.
  • Opanowanie wzorów na nachylenie siecznej i stycznej modularnej w ciele skończonym F_p.
  • Zrozumienie algorytmu Double-and-Add jako podstawy wydajnego wyznaczania klucza publicznego Q = d*G.
  • Praktyczna świadomość, dlaczego odwrócenie mnożenia skalarnego (problem ECDLP) stanowi fundament bezpieczeństwa ECC.
Zadanie 5 - ilustracja
06/10
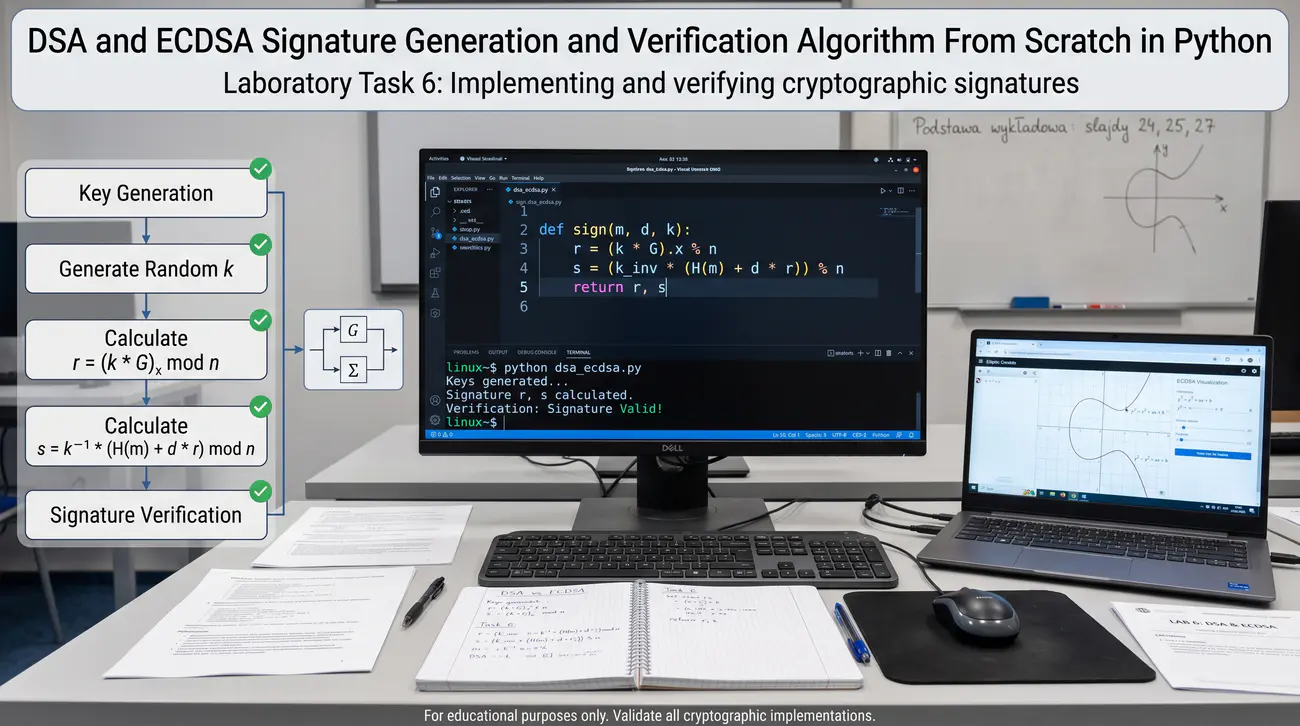
Zadanie 6. Algorytm weryfikacji i generowania podpisów DSA oraz ECDSA od podstaw w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 24, 25, 27: algorytmy DSA i ECDSA, parametry rzędu q/n, losowa wartość jednorazowa k, wyliczanie r = (k*G)_x mod n oraz s = k^(-1)*(H(m) + d*r) mod n, procedura weryfikacji.

Cel

Celem zadania jest programistyczna rekonstrukcja algorytmu podpisu cyfrowego ECDSA w języku Python. Student implementuje procedurę generowania podpisu (para r i s) dla zadanego skrótu wiadomości oraz procedurę weryfikacji sygnatury w oparciu o arytmetykę krzywych eliptycznych, badając matematyczne powiązanie składowych podpisu z kluczem publicznym.

Scenariusz – opis

Algorytm ECDSA (Elliptic Curve Digital Signature Algorithm) stanowi standard FIPS 186 definiujący podpis cyfrowy na krzywych eliptycznych. Procedura opiera się na wykorzystaniu efemerycznej, tajnej liczby losowej k wybieranej niezależnie dla każdego podpisywanego dokumentu. Nadawca oblicza punkt krzywej R = k * G i przyjmuje jego współrzędną r = R.x mod n jako pierwszą składową podpisu. Druga składowa podpisu s jest obliczana ze wzoru s = k^(-1) * (e + d * r) mod n, gdzie e jest numeryczną wartością skrótu dokumentu, a d kluczem prywatnym. Weryfikator nie zna wartości k ani d, ale zna klucz publiczny Q = d * G oraz składowe sygnatury (r, s). Oblicza on wagi w = s^(-1) mod n, u1 = e * w mod n, u2 = r * w mod n, a następnie punkt weryfikujący V = u1 * G + u2 * Q.

Co ma wykonać student / grupa

W pliku ecdsa_implementation.py importujesz zaimplementowaną w poprzednim zadaniu arytmetykę krzywej Weierstrassa (lub definiujesz ją lokalnie). Konfigurujesz parametry krzywej eliptycznej (p, a, b, punkt bazowy G oraz jego rząd n). Generujesz klucz prywatny nadawcy d jako losową liczbę 1 <= d < n oraz obliczasz klucz publiczny Q = d * G. Definiujesz wiadomość tekstową i obliczasz jej 256-bitowy skrót SHA-256 za pomocą wbudowanego modułu hashlib.

Konwertujesz bajty skrótu na liczbę całkowitą e = int.from_bytes(hash_bytes, 'big') mod n. Implementujesz funkcję ecdsa_sign(msg_hash, priv_key, k): losujesz liczbę k względnie pierwszą z n (ścisła dydaktyka - produkcyjnie k musi pochodzić z RFC 6979 / HMAC-DRBG, por. 4.0/zad. 7 i 5.0/zad.

5). Obliczasz punkt R = k * G i wyznaczasz r = R.x % n (upewniając się, że r != 0). Obliczasz k_inv = pow(k, -1, n) oraz składową s = (k_inv * (e + priv_key * r)) % n (upewniając się, że s != 0). Zwracasz sygnaturę jako parę liczb całkowitych (r, s).

Implementujesz funkcję ecdsa_verify(msg_hash, signature, pub_key): pobierasz r, s i sprawdzasz warunki 1 <= r, s < n. Obliczasz w = pow(s, -1, n), u1 = (e * w) % n oraz u2 = (r * w) % n. Wyznaczasz punkt weryfikujący V = point_add(scalar_mult(u1, G), scalar_mult(u2, pub_key)). Weryfikujesz warunek poprawności podpisu: V nie może być punktem O oraz V.x % n musi być równe r.

Testujesz algorytm: potwierdzasz poprawność weryfikacji dla oryginalnej wiadomości. Modyfikujesz treść wiadomości (inny skrót e') lub składową podpisu r' i sprawdzasz, że funkcja weryfikująca poprawnie odrzuca sfałszowany podpis. Zapisujesz dowód matematyczny równości V.x == r i kompletujesz sprawozdanie.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik ecdsa_implementation.py.
  2. Skonfiguruj krzywą secp256k1 lub NIST P-256 z punktem bazowym G i rzędem n.
  3. Wygeneruj parę kluczy: priv_d oraz pub_Q = priv_d * G.
  4. Napisz funkcję przygotowującą skrót e = hash_message(msg).
  5. Zaimplementuj generator efemerycznego nonce k.
  6. Zaimplementuj obliczanie punktu R = k * G i składowej r = R.x % n.
  7. Zaimplementuj obliczanie składowej s = pow(k, -1, n) * (e + priv_d * r) % n.
  8. Podpisz przykładowy dokument 'Zatwierdzam transakcje numer 4891'.
  9. Zanotuj wygenerowane wartości r i s w postaci szesnastkowej.
  10. Zaimplementuj funkcję weryfikacji ecdsa_verify(e, r, s, pub_Q).
  11. Oblicz współczynniki w = pow(s, -1, n), u1 = (e * w) % n, u2 = (r * w) % n.
  12. Oblicz punkt sprawdzający V = u1*G + u2*pub_Q.
  13. Zweryfikuj tożsamość V.x % n == r i wyświetl wynik testu (Sukces weryfikacji).
  14. Wykonaj test fałszerstwa: zmień w wiadomości jedno słowo i zweryfikuj ponownie (Odrzucenie podpisu).
  15. Wykonaj test uszkodzenia sygnatury: zmień wartość s o 1 i sprawdź wynik.
  16. Wykonaj zrzuty ekranu konsoli i przygotuj sprawozdanie.

Kontrola zaliczenia (checklist):

  1. Uruchomiono ECDSA i zachowano log: generowanie (r,s) dla hasha, weryfikacja OK oraz odrzucenie po zmianie 1 bitu msg/podpisu.
  2. Dołączono kod (własne min. 30 linii): R=k·G, r,s, odwrotność k, weryfikacja u1,u2 bez ujawniania k,d.
  3. Przeprowadzono test pozytywny (poprawny podpis przechodzi) i negatywny (zły hash / s=0 — odrzut z komunikatem).
  4. Opisano w 3–5 zdaniach: rola R, elegancja weryfikacji, integralność hasha i (r,s); ostrzeżenie: random-k tylko dydaktycznie, produkcyjnie RFC 6979 (por. z.7, 5.0/z.5).

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznej konstrukcji podpisu ECDSA i roli punktu efemerycznego R = k*G.
  • Zrozumienie elegancji procedury weryfikacji eliminującej potrzebę ujawniania tajnych wartości k i d.
  • Umiejętność samodzielnej implementacji algorytmu generowania i weryfikacji podpisów na krzywych eliptycznych.
  • Świadomość krytycznego znaczenia integralności skrótu wiadomości oraz parametrów r i s dla ważności podpisu.
  • Ostrzeżenie: losowanie k zwykłym random to tylko dydaktyka - produkcyjnie obowiązuje RFC 6979 / HMAC-DRBG (por. 4.0/zad. 7, 5.0/zad. 5).
Zadanie 6 - ilustracja
07/10
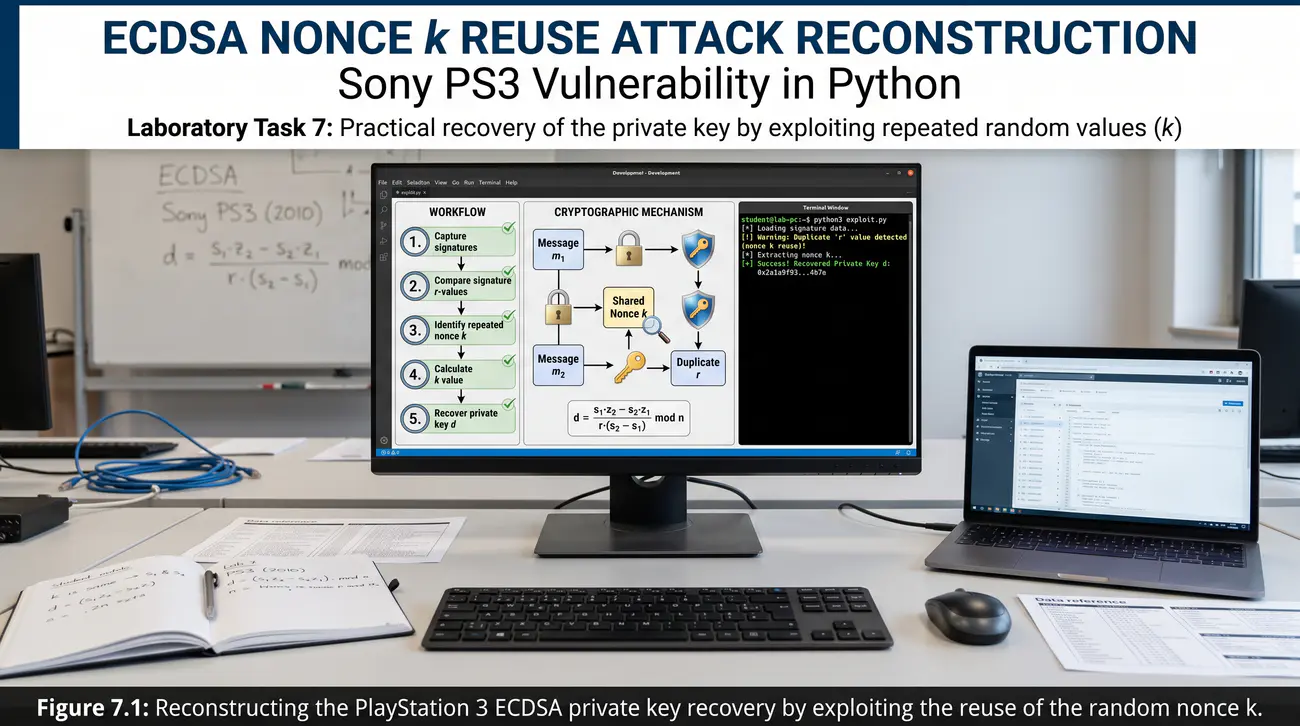
Zadanie 7. Rekonstrukcja ataku na ponowne użycie wartości nonce k w podpisach ECDSA (podatność Sony PS3) w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 28, 50: podatności podpisów cyfrowych, katastrofa bezpieczeństwa Sony PlayStation 3 (2010), ponowne użycie wartości losowej k (Nonce Reuse), odzyskanie klucza prywatnego.

Cel

Celem zadania jest praktyczna rekonstrukcja słynnego ataku kryptoanalitycznego na podatność ponownego użycia wartości losowej k (Nonce Reuse Attack) w algorytmie ECDSA, który doprowadził do złamania zabezpieczeń konsoli Sony PlayStation 3 w 2010 roku. Student implementuje w Pythonie procedurę wyliczania tajnego nonce k oraz natychmiastowego odzyskania klucza prywatnego d z dwóch podpisów.

Scenariusz – opis

W algorytmie ECDSA każda operacja podpisywania wymaga wygenerowania ściśle tajnej, kryptograficznie losowej liczby k. W 2010 roku grupa hakerska fail0verflow odkryła, że inżynierowie Sony w oprogramowaniu konsoli PlayStation 3 zaimplementowali stałą wartość k. Użycie tej samej wartości k do podpisania dwóch różnych wiadomości m1 i m2 stanowi śmiertelny błąd kryptoanalityczny. Ponieważ k jest stałe, punkt R = k * G jest identyczny, co powoduje, że w obu podpisach wartość r1 jest równa r2 = r. Otrzymujemy układ dwóch równań: s1 = k^(-1)*(e1 + d*r) mod n oraz s2 = k^(-1)*(e2 + d*r) mod n. Odejmując stronami te równania, napastnik eliminuje niewiadomy klucz prywatny d i wylicza bezpośrednio tajną wartość k = (e1 - e2) / (s1 - s2) mod n.

Co ma wykonać student / grupa

W pliku ps3_ecdsa_exploit.py konfigurujesz parametry krzywej secp256k1 oraz generujesz klucz prywatny d_victim reprezentujący klucz główny Sony. Obliczasz powiązany klucz publiczny Q_victim = d_victim * G. Definiujesz dwie różne wiadomości: 'Aktualizacja firmware v3.50 autoryzowana' oraz 'Instalacja gry oficjalnej autoryzowana'. Obliczasz ich skróty SHA-256 e1 oraz e2 jako liczby całkowite modulo n (krok obowiązkowy: e = int(sha256(m)) % n z asercją, inaczej kongruencje się rozjadą).

Symulujesz błąd implementacyjny programistów: wybierasz jedną stałą wartość k_fixed i podpisujesz obie wiadomości tym samym k. Symulujesz błąd implementacyjny programistów: wybierasz jedną stałą wartość k_fixed i podpisujesz obie wiadomości tym samym k. Generujesz pierwszy podpis (r1, s1) oraz drugi podpis (r2, s2) i potwierdzasz, że r1 == r2.

Przechodzisz do roli zewnętrznego analityka/napastnika posiadającego jedynie wiadomości (e1, e2), podpisy (r, s1) i (r, s2) oraz klucz publiczny Q. Sprawdzasz, że warunek ataku jest spełniony: r1 == r2 oraz s1 != s2. Obliczasz mianownik diff_s = (s1 - s2) mod n oraz licznik diff_e = (e1 - e2) mod n. Wyznaczasz odzyskane k: k_recovered = (diff_e * pow(diff_s, -1, n)) mod n.

Porównujesz k_recovered z tajnym k_fixed i potwierdzasz 100% zgodność. Mając odzyskane k, wyznaczasz klucz prywatny: d_recovered = ((s1 * k_recovered - e1) * pow(r, -1, n)) mod n. Weryfikujesz sukces ataku: porównujesz d_recovered z d_victim oraz sprawdzasz, czy d_recovered * G == Q_victim. Demonstrujesz sfałszowanie podpisu: używasz odzyskanego klucza d_recovered do podpisania złośliwego pakietu 'Uruchomienie homebrew i nieautoryzowanego kodu'.

Weryfikujesz nowo podpisany pakiet oryginalnym kluczem publicznym Sony i uzyskujesz status Verified OK. Badany problem zestawiasz ze standardem RFC 6979 definiującym deterministyczne generowanie k i sporządzasz raport.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik ps3_ecdsa_exploit.py w środowisku roboczym.
  2. Zdefiniuj parametry krzywej eliptycznej (p, a, b, G, n).
  3. Wylosuj klucz prywatny ofiary: d_secret.
  4. Oblicz klucz publiczny ofiary: Q_pub = d_secret * G.
  5. Zdefiniuj dwie odmienne wiadomości msg1 i msg2.
  6. Oblicz skróty e1 i e2 za pomocą hashlib.sha256().
  7. Zdefiniuj stałą wartość k_static (symulacja błędu PS3).
  8. Wygeneruj podpis 1: (r1, s1) przy użyciu k_static.
  9. Wygeneruj podpis 2: (r2, s2) przy użyciu tego samego k_static.
  10. Upewnij się, że r1 == r2.
  11. Napisz funkcję ataku recover_private_key(e1, s1, e2, s2, r, n).
  12. Oblicz k_cracked = ((e1 - e2) * pow(s1 - s2, -1, n)) % n.
  13. Oblicz d_cracked = ((s1 * k_cracked - e1) * pow(r, -1, n)) % n.
  14. Porównaj d_cracked z d_secret (potwierdź równość liczb).
  15. Pokaż twardy dowód przejęcia klucza: sprawdź d_cracked * G == Q_pub.
  16. Użyj d_cracked do podpisania dowolnego nieautoryzowanego komunikatu.
  17. Sprawdź poprawność sfałszowanego podpisu kluczem Q_pub i udokumentuj wyniki w sprawozdaniu.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano atak nonce-reuse (Sony PS3) na wektorze ze startera: z dwóch podpisów na tym samym k wyliczono k oraz klucz d i podrobiono 3. podpis.
  2. Wykazano różnicę: signer losujący (bezpieczny) vs stałe k (pełny wyciek d); dołączono oba logi.
  3. Dołączono log ataku (r1=r2, wzory na k i d) + kod łatki (RFC 6979 HMAC-DRBG, k z klucza+hasha).
  4. Opisano w 3–5 zdaniach kompromis: losowość vs determinizm, katastrofa PS3 2010, audyt generatora.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie krytycznej roli generatora liczb losowych i parametru nonce k w algorytmie ECDSA.
  • Praktyczna umiejętność matematycznej rekonstrukcji klucza prywatnego z dwóch podpisów ze stałym k.
  • Zrozumienie mechanizmu katastrofy bezpieczeństwa konsoli Sony PlayStation 3 z 2010 roku.
  • Znajomość standardu RFC 6979 eliminującego podatność poprzez deterministyczne wyznaczanie k z klucza i skrótu wiadomości (HMAC-DRBG).
Zadanie 7 - ilustracja
08/10
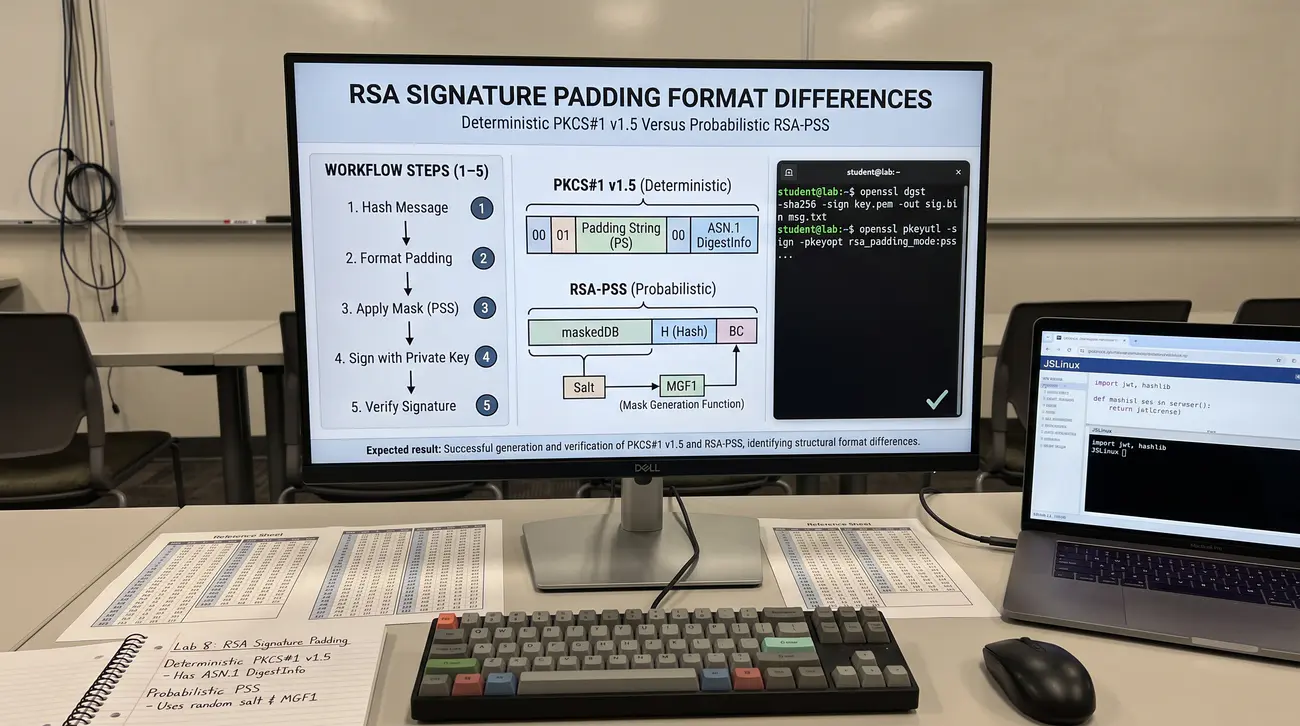
Zadanie 8. Badanie różnic formatów dopełnienia podpisów RSA: deterministyczny PKCS#1 v1.5 a probabilistyczny RSA-PSS w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 4 - slajdy 12, 23, 27: schematy dopełnienia podpisów RSA, struktura ASN.1 DigestInfo w PKCS#1 v1.5, maskowanie MGF1 i losowa sól w RSA-PSS, bezpieczeństwo redukcyjne.

Cel

Celem zadania jest programistyczna i binarna dekompozycja formatów dopełnienia podpisów RSA: klasycznego PKCS#1 v1.5 oraz probabilistycznego RSA-PSS (Probabilistic Signature Scheme). Student implementuje w Pythonie kodowanie bloków podpisu dla obu schematów, analizuje strukturę bajtową DigestInfo oraz działanie funkcji maskującej MGF1 i losowej soli w RSA-PSS.

Scenariusz – opis

Przed wykonaniem operacji s = m^d mod n skrót wiadomości musi zostać odpowiednio sformatowany i uzupełniony w bloku o długości równej modułowi. W standardzie PKCS#1 v1.5 blok ma sztywną postać: 0x00 || 0x01 || PS (bajty 0xFF) || 0x00 || DigestInfo. Struktura DigestInfo zawiera nagłówek ASN.1 z identyfikatorem OID funkcji skrótu oraz właściwy skrót kryptograficzny. Format PKCS#1 v1.5 jest w pełni deterministyczny, co historycznie doprowadziło do groźnych podatności (m.in. atak Bleichenbachera na weryfikację podpisów). Standard RSA-PSS wprowadzony przez Bellare'a i Rogawaya stanowi rozwiązanie z dowodzonym matematycznie bezpieczeństwem w modelu wyroczni losowej. W RSA-PSS do skrótu wiadomości dołącza się losową sól (salt), a całość podlega maskowaniu za pomocą funkcji MGF1 opartej na funkcji skrótu.

Co ma wykonać student / grupa

W pliku rsa_padding_analysis.py przygotowujesz środowisko do dekompozycji bloków podpisów RSA o rozmiarze 2048 bitów (256 bajtów). Implementujesz funkcję encode_pkcs1_v15(hash_bytes, hash_algo, mod_len) budującą surowy 256-bajtowy blok. Wprowadzasz prefiks ASN.1 DigestInfo dla algorytmu SHA-256 (sekwencja 19 bajtów zaczynająca się od 30 31 30 0d 06 09...). Korzystasz z tabeli prefiksów DigestInfo z karty dla SHA-256/SHA-384/SHA-512 i wymagasz testu: blok PKCS#1 musi mieć dokładnie mod_len bajtów.

Wypełniasz wolną przestrzeń bajtami dopełnienia 0xFF i zamykasz bajtem 0x00 przed DigestInfo. Weryfikujesz determinizm: dla zadanego skrótu blok PKCS#1 v1.5 jest zawsze identyczny co do bitu. W drugiej części skryptu implementujesz funkcję maskującą MGF1(mgf_seed, mask_len, hash_func) opartą na iteracyjnym haszowaniu z licznikiem. Implementujesz procedurę kodowania RSA-PSS: generujesz losową sól o długości 32 bajtów (sLen = hLen).

Formujesz blok M' = 0x00*8 || mHash || salt i obliczasz H = SHA-256(M'). Budujesz blok DB = PS || 0x01 || salt, generujesz maskę dbMask = MGF1(H, len(DB)) i obliczasz zamaskowany blok maskedDB = DB XOR dbMask. Składasz ostateczny blok PSS: maskedDB || H || 0xbc o łącznej długości 256 bajtów. Porównujesz dwa bloki PSS wygenerowane dla tego samego skrótu i odnotowujesz ich całkowitą odmienność spowodowaną solą.

Implementujesz procedurę dekodowania i weryfikacji bloku PSS: wyodrębniasz H, odtwarzasz DB przez odmaskowanie, wyciągasz sól i weryfikujesz H. Generujesz podpisy w OpenSSL z flagami -sigopt rsa_padding_mode:pss oraz PKCS#1 v1.5 i porównujesz ich zrzuty szesnastkowe.

Sporządzasz tabelę porównawczą obu schematów pod kątem odporności na ataki algebraiczne i elastyczności. Kompletujesz materiały dowodowe do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik rsa_padding_analysis.py w środowisku Python.
  2. Zdefiniuj stałe ASN.1 DigestInfo dla SHA-256 (tabela w karcie: SHA-256/SHA-384/SHA-512).
  3. Zaimplementuj funkcję pkcs1_v15_encode(msg_hash, key_bytes=256) z asercją len( block)==mod_len.
  4. Wygeneruj blok PKCS#1 dla testowej wiadomości i wyświetl jego zrzut szesnastkowy.
  5. Sprawdź pozycję i liczbę bajtów dopełnienia 0xFF.
  6. Zaimplementuj funkcję maskującą mgf1( seed, mask_len, hash_func=hashlib.sha256).
  7. Zaimplementuj funkcję pss_encode(msg_hash, key_bytes=256, salt_len=32).
  8. Wygeneruj dwa niezależne bloki PSS dla tego samego skrótu.
  9. Zweryfikuj, że bloki PSS różnią się w każdym bajcie z wyjątkiem końcowego 0xBC.
  10. Zaimplementuj funkcję pss_verify(encoded_block, msg_hash, key_bytes=256, salt_len=32).
  11. Sprawdź poprawność weryfikacji dla poprawnego bloku PSS (sukces).
  12. Zmodyfikuj 1 bit w zamaskowanym bloku i potwierdź wykrycie uszkodzenia przez procedurę weryfikującą.
  13. W konsoli JSLinux wygeneruj podpis pliku w OpenSSL z opcją rsa_padding_mode:pss.
  14. Wykonaj inspekcję zrzutu hexdump podpisu wygenerowanego przez OpenSSL.
  15. Wykonaj zrzuty ekranu struktur bajtowych PKCS#1 v1.5 oraz PSS.
  16. Opracuj raport zestawiający bezpieczeństwo redukcyjne obu standardów.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano oba paddingi i zachowano log: blok v1.5 (00 01 FF…00 DigestInfo) vs PSS (sól losowa, MGF1, 0xBC) — dwa podpisy PSS tego samego pliku różne, v1.5 identyczne.
  2. Dołączono kod (własne min. 25 linii): kodowanie EMSA-PKCS1 i EMSA-PSS, parser DigestInfo, MGF1.
  3. Przeprowadzono test pozytywny (oba weryfikują) i negatywny (podmiana soli / zły hash — PSS odrzuca).
  4. Opisano w 3–5 zdaniach: determinizm vs probabilizm, rola soli/MGF1, dowody ROM dla PSS.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie budowy bloku dopełnienia PKCS#1 v1.5 i roli deskryptorów ASN.1 DigestInfo.
  • Zrozumienie architektury RSA-PSS: roli losowej soli, funkcji maskującej MGF1 oraz bajtu końcowego 0xBC.
  • Praktyczna umiejętność implementacji i dekompozycji obu formatów paddingu w języku Python.
  • Świadomość przewagi probabilistycznego schematu PSS w kontekście dowodów bezpieczeństwa w modelu ROM.
Zadanie 8 - ilustracja
09/10
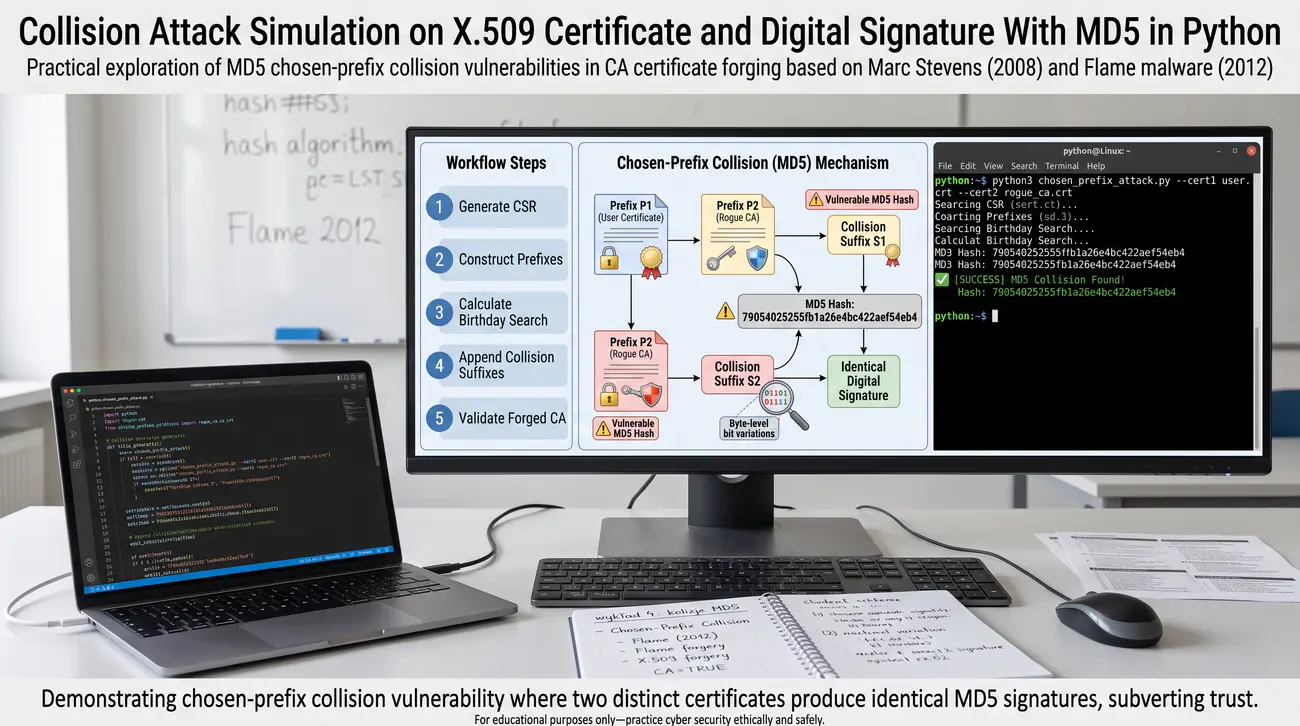
Zadanie 9. Symulacja ataku kolizyjnego na certyfikat X.509 i podpis cyfrowy z funkcją MD5 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 29, 30: bezpieczeństwo funkcji skrótu dla podpisów, kolizje MD5, atak z wybranym prefiksem (Chosen-Prefix Collision), fałszowanie certyfikatu CA (Stevens 2008, robak Flame 2012).

Cel

Celem zadania jest programistyczna demonstracja i analiza ataku kolizyjnego z wybranym prefiksem (Chosen-Prefix Collision) na podpisy cyfrowe z funkcją skrótu MD5. Student bada w Pythonie, jak dwa dokumenty o zupełnie różnych prefiksach i uprawnieniach (np. certyfikat zwykłego użytkownika oraz fałszywy certyfikat Root CA) uzyskują ten sam skrót i identyczny podpis cyfrowy.

Scenariusz – opis

Przez wiele lat funkcja skrótu MD5 była powszechnie wykorzystywana do tworzenia podpisów cyfrowych pod certyfikatami X.509. W 2008 roku zespół badawczy pod kierunkiem Alexandra Stevensa przeprowadził spektakularny atak Chosen-Prefix Collision na MD5. Atak ten pozwolił na utworzenie fałszywego certyfikatu pośredniego centrum certyfikacji (Rogue CA) zaakceptowanego przez przeglądarki. W ataku ze wspólnym prefiksem dwie wiadomości m1 i m2 mają różne początki P1 i P2, po których dokleja się specjalnie wyliczone bloki kolizyjne C1 i C2. W rezultacie, pomimo różnic w treści, zachodzi równość skrótów: MD5(P1 || C1 || S) == MD5(P2 || C2 || S). Podpis wystawiony przez nadrzędne CA pod bezpiecznym dokumentem m1 staje się natychmiast formalnie ważny dla złośliwego dokumentu m2.

Co ma wykonać student / grupa

W środowisku Python tworzysz skrypt md5_collision_poc.py modelujący atak na autoryzację dokumentów lub certyfikatów. Definiujesz dwa odmienne prefiksy: dokument legalny P1 ('Zwykly uzytkownik: Jan Kowalski, Rola: Klient') oraz złośliwy P2 ('Zwykly uzytkownik: Jan Kowalski, Rola: Glowny Administrator'). Wykorzystujesz gotowe zbadane wektory kolizyjne z bazy Stevensa lub generujesz uproszczoną parę bloków kolizyjnych MD5. Pracujesz wyłącznie na dostarczonej parze bloków kolizyjnych (kilka kB + SHA-256 do weryfikacji); zabrania się generowania kolizji od zera - zadanie testuje transfer podpisu, nie łamanie MD5.

Weryfikujesz w Pythonie, że skróty MD5 obu połączonych wiadomości są identyczne co do bitu: hashlib.md5(doc1).hexdigest() == hashlib.md5(doc2).hexdigest(). Generujesz parę kluczy RSA-2048 reprezentującą centrum certyfikacji (CA) za pomocą modułu Pythona. Podpisujesz legalny dokument doc1 kluczem prywatnym CA z użyciem skrótu MD5: sig = rsa_sign(hashlib.md5(doc1).digest(), ca_priv_key). Weryfikujesz podpis pod dokumentem legalnym kluczem publicznym CA i odnotowujesz status Poprawny.

Następnie weryfikujesz ten sam podpis sig pod złośliwym dokumentem doc2 z uprawnieniami administratora. Stwierdzasz sukces ataku: podpis jest matematycznie ważny dla drugiego dokumentu, mimo że CA nigdy go nie autoryzowało. Badany problem zestawiasz z realnym przypadkiem złośliwego oprogramowania Flame z 2012 roku, które fałszowało podpisy aktualizacji Windows Update. Modyfikujesz procedurę zastępując funkcję MD5 bezpiecznym algorytmem SHA-256.

Wykazujesz, że w przypadku SHA-256 skróty doc1 i doc2 różnią się całkowicie, a fałszerstwo podpisu zostaje natychmiast udaremnione. Dokumentujesz zrzutami ekranu przebieg eksperymentu oraz wygenerowane skróty heksadecymalne.

Sporządzasz tabelę podsumowującą podatności MD5, SHA-1 oraz status bezpieczeństwa SHA-2 i SHA-3. Kompletujesz sprawozdanie z realizacji zadania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik md5_collision_poc.py w środowisku roboczym.
  2. Zdefiniuj treść dwóch dokumentów o różnych prawach dostępu (User vs Admin).
  3. Załaduj parę zbadanych wektorów kolizyjnych MD5 (gotowe bloki Stevensa z karty, kilka kB + SHA-256 do weryfikacji; nie generuj kolizji od zera).
  4. Połącz prefiksy dokumentów z odpowiadającymi im blokami kolizyjnymi do doc_legit i doc_malicious.
  5. Oblicz skróty MD5 obu dokumentów: h1 = hashlib.md5(doc_legit).hexdigest(), h2 = hashlib.md5(doc_malicious).hexdigest().
  6. Zweryfikuj tożsamość skrótów: assert h1 == h2.
  7. Oblicz skróty SHA-256 obu dokumentów i potwierdź ich całkowitą odmienność.
  8. Zaimplementuj generator kluczy RSA i wygeneruj klucze CA.
  9. Zaimplementuj funkcję podpisującą hash: sign_hash(h, priv_key).
  10. Podpisz skrót legalnego dokumentu: signature = sign_hash(h1, ca_priv).
  11. Zaimplementuj funkcję weryfikacji podpisu: verify_signature(doc, signature, ca_pub, algo='md5').
  12. Sprawdź weryfikację legalnego dokumentu: potwierdź wynik pozytywny.
  13. Sprawdź weryfikację złośliwego dokumentu z tym samym podpisem: potwierdź udane fałszerstwo.
  14. Przeprowadź weryfikację obu dokumentów z użyciem algorytmu SHA-256 i potwierdź odrzucenie fałszerstwa.
  15. Wykonaj zrzuty ekranu konsoli prezentujące skróty oraz wyniki weryfikacji.
  16. Opracuj podsumowanie opisujące wpływ ataku Stevensa na wycofanie MD5 z certyfikacji X.509.

Kontrola zaliczenia (checklist):

  1. Zademonstrowano chosen-prefix MD5 na wektorze ze startera: dwa certyfikaty/uprawnienia o różnych prefiksach i identycznym MD5, fałszywy podpis przechodzi na MD5.
  2. Wykazano różnicę: weryfikator MD5 (fałszerstwo przechodzi) vs SHA-256 (odrzuca); dołączono sumy i logi.
  3. Dołączono log demo (prefiksy, bloki kolizyjne) + kod łatki (zakaz MD5 w podpisach, SHA-256+, weryfikacja CA).
  4. Opisano w 3–5 zdaniach kompromis: chosen-prefix vs zwykła kolizja, Flame/fałszywe CA, koszt migracji.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Praktyczne zrozumienie ataku kolizyjnego z wybranym prefiksem (Chosen-Prefix Collision) na funkcje skrótu.
  • Empiryczny dowód na możliwość sfałszowania certyfikatu lub uprawnień przy użyciu kolizji MD5.
  • Zrozumienie, dlaczego funkcja skrótu w podpisie cyfrowym musi bezwzględnie spełniać warunek odporności na kolizje.
  • Świadomość historycznego znaczenia ataków na MD5 (tworzenie fałszywych certyfikatów CA i robak Flame).
Zadanie 9 - ilustracja
10/10
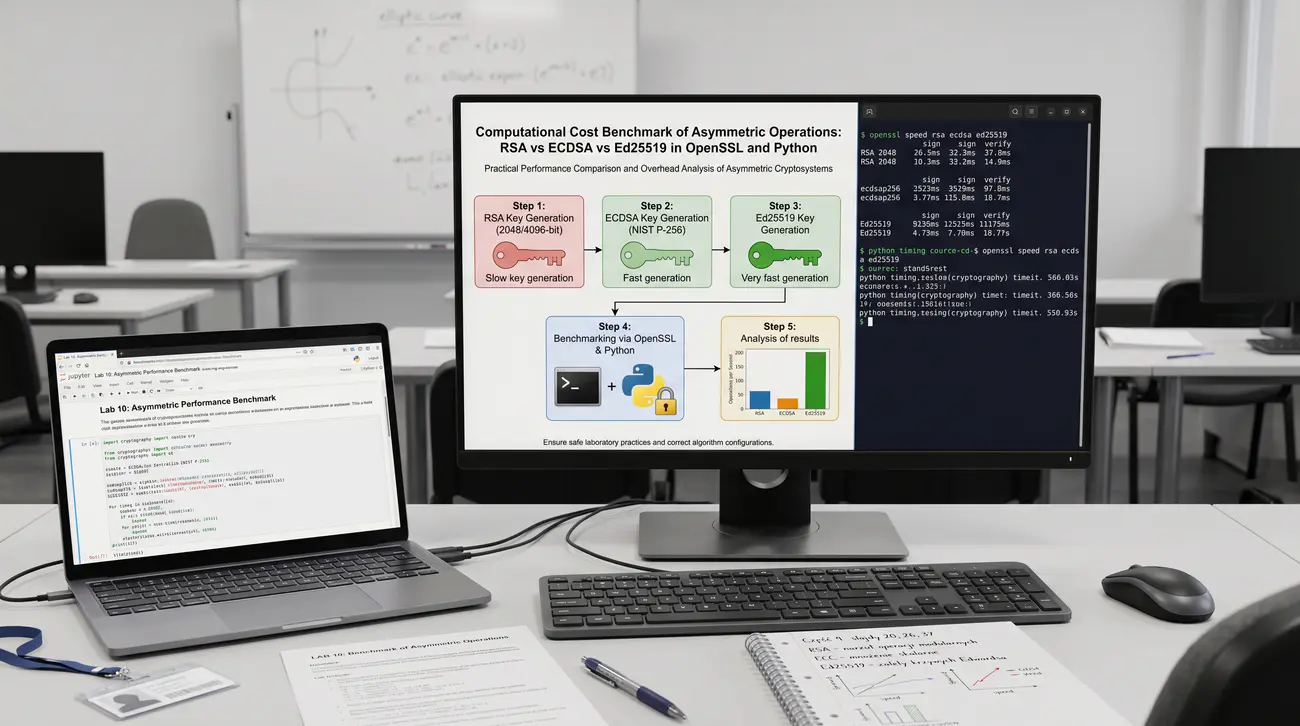
Zadanie 10. Benchmark i profilowanie kosztu obliczeniowego operacji asymetrycznych: RSA vs ECDSA vs Ed25519 w OpenSSL i Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 4 - slajdy 20, 26, 37: porównanie wydajności kryptosystemów asymetrycznych, narzut operacji modularnych RSA, mnożenie skalarne w ECC, zalety wydajnościowe krzywych Edwardsa Ed25519.

Cel

Celem zadania jest przeprowadzenie wszechstronnego benchmarku wydajnościowego oraz profilowania czasu wykonania kluczowych operacji kryptografii asymetrycznej: generowania kluczy, podpisywania oraz weryfikacji podpisów dla algorytmów RSA-2048, RSA-4096, ECDSA P-256 oraz Ed25519 przy użyciu narzędzia OpenSSL Speed oraz autorskiego skryptu w języku Python.

Scenariusz – opis

Wybór algorytmu asymetrycznego w architekturze systemów IT wymaga kompromisu pomiędzy poziomem bezpieczeństwa a narzutem obliczeniowym. Tradycyjny algorytm RSA opiera się na arytmetyce modularnej wielkich liczb, gdzie weryfikacja (z małym wykładnikiem e=65537) jest bardzo szybka, ale podpisywanie i generowanie kluczy wymaga olbrzymiej mocy procesora. Kryptografia krzywych eliptycznych (ECDSA P-256) oferuje znacznie mniejsze klucze i symetryczny rozkład czasów operacji. Nowoczesny standard Ed25519 optymalizuje obliczenia dzięki krzywym Edwardsa i arytmetyce bez rozgałęzień, zapewniając bezkonkurencyjną szybkość. W ramach laboratorium student mierzy liczbę operacji na sekundę oraz czas jednostkowy poszczególnych faz cyklu życia klucza. Uzyskane wyniki stanowią podstawę do świadomego projektowania bezpiecznych i skalowalnych systemów sieciowych.

Co ma wykonać student / grupa

W terminalu JSLinux uruchamiasz oficjalny benchmark biblioteki OpenSSL za pomocą polecenia openssl speed rsa2048 rsa4096. Zapisujesz uzyskane wyniki: liczbę operacji generowania kluczy, podpisywania (sign/s) oraz weryfikacji (verify/s) na sekundę. Uruchamiasz benchmark dla podpisów na krzywych eliptycznych poleceniem openssl speed ecdsap256 oraz openssl speed ed25519. Porównujesz wyniki: zauważasz ogromną dysproporcję pomiędzy czasem podpisywania RSA-4096 a Ed25519.

W kolejnym kroku tworzysz skrypt asym_benchmark.py w języku Python do precyzyjnego pomiaru czasu operacji w pętli 100 powtórzeń. Wykorzystujesz moduł time.perf_counter_ns() do pomiaru czasu generowania par kluczy dla badanych czterech algorytmów. Mierzysz średni czas operacji podpisywania 1-kilobajtowej wiadomości oraz średni czas weryfikacji podpisu. Wyliczasz stosunek czasu podpisywania do weryfikacji (sign/verify ratio) dla każdego badanego algorytmu.

Zauważasz charakterystyczną cechę RSA: operacja weryfikacji jest od kilkunastu do kilkudziesięciu razy szybsza od podpisywania ze względu na mały wykładnik publiczny e = 65537. Dla algorytmów ECC i Ed25519 stwierdzasz znacznie bardziej zrównoważony bilans operacji przy wielokrotnie wyższej sumarycznej przepustowości. Analizujesz narzut pamięciowy i pasmowy: mierzysz rozmiary kluczy publicznych i podpisów w bajtach.

Sporządzasz zbiorczą tabelę porównawczą zawierającą metryki: bity bezpieczeństwa NIST, rozmiar klucza publicznego, rozmiar podpisu, czas generowania klucza, operacje sign/s oraz verify/s. Tworzysz wykres słupkowy lub zestawienie tekstowe ilustrujące przewagę algorytmu Ed25519. Raportujesz środowisko (emulator/natywnie, openssl version) i wyciągasz wnioski wyłącznie o krotnościach, nie o wartościach bezwzględnych ms/ops.

Formułujesz rekomendacje inżynierskie dla systemów o wysokim obciążeniu (np. serwery TLS, systemy IoT, blockchain). Kompletujesz pełne sprawozdanie laboratoryjne z realizacji zadania.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom maszynę JSLinux Alpine.
  2. Uruchom benchmark OpenSSL dla RSA: openssl speed rsa2048 rsa4096.
  3. Zanotuj liczbę operacji na sekundę dla 'sign' i 'verify' dla obu rozmiarów klucza RSA.
  4. Uruchom benchmark OpenSSL dla ECDSA: openssl speed ecdsap256.
  5. Uruchom benchmark OpenSSL dla Ed25519: openssl speed ed25519.
  6. Utwórz plik skryptu asym_benchmark.py w Pythonie.
  7. Zaimplementuj pętlę testową mierzącą czas 50 generacji kluczy RSA-2048, RSA-4096, P-256 i Ed25519.
  8. Zaimplementuj pomiar czasu podpisywania 500 wiadomości dla każdego algorytmu.
  9. Zaimplementuj pomiar czasu weryfikacji 500 podpisów dla każdego algorytmu.
  10. Oblicz średni czas pojedynczej operacji w milisekundach i mikrosekundach.
  11. Oblicz współczynnik asymetrii kosztu: czas podpisu / czas weryfikacji.
  12. Zmierz rozmiary binarne kluczy publicznych oraz generowanych sygnatur w bajtach.
  13. Wyświetl sformatowane podsumowanie tabelaryczne w konsoli.
  14. Porównaj wyniki uzyskane ze skryptu Pythona z danymi z openssl speed.
  15. Wykonaj zrzuty ekranu wyników obu benchmarków.
  16. Opracuj raport końcowy z rekomendacjami technologicznymi.

Kontrola zaliczenia (checklist):

  1. Uruchomiono benchmark i zachowano tabelę: keygen/sign/verify dla RSA-2048, RSA-4096, ECDSA P-256, Ed25519 (śr. z 3 serii na tym samym hoście, względnie).
  2. Dołączono kod/skrypt pomiarowy (własne min. 20 linii) + surowe logi openssl speed / time.
  3. Przeprowadzono pomiar pozytywny (pełna tabela) i kontrolny (powtórka — rozrzut opisany, bez porównań między hostami).
  4. Opisano w 3–5 zdaniach: asymetria RSA (szybka weryfikacja, drogi podpis/keygen), dominacja Ed25519, dobór do IoT/serwerów.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (bez cryptography — czysta arytmetyka modułowa); OpenSSL tylko do kontroli; dołącz kod i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie charakterystyki wydajnościowej algorytmów RSA, ECDSA oraz Ed25519.
  • Identyfikacja silnej asymetrii kosztu RSA (błyskawiczna weryfikacja vs bardzo kosztowne podpisywanie i generowanie kluczy).
  • Potwierdzenie dominacji algorytmu Ed25519 pod względem przepustowości podpisywania oraz kompaktowości kluczy.
  • Umiejętność doboru optymalnego algorytmu asymetrycznego do wymagań środowiska (urządzenia IoT, serwery WWW).
Zadanie 10 - ilustracja
Podgląd