Laboratorium 4
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 5.0

Poziom: ocena 5.0 - zaawansowana kryptoanaliza rekonstrukcyjna, ataki faktoryzacyjne i era PQC

Zestaw 10 wysoce specjalistycznych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 4 (kryptografia asymetryczna - RSA, ECC, Diffie-Hellman i podpisy cyfrowe).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 5.0 koncentrują się na zaawansowanych problemach kryptoanalitycznych, rekonstrukcji danych przy błędach procedur kryptograficznych oraz implementacji zaawansowanych modeli matematycznych w języku Python w środowisku konsolowym emulatora JSLinux Alpine (lub lokalnym interpreterze).
  • Tematyka zadań obejmuje m.in.: faktoryzację modułów RSA metodą Fermata i metodą rho Pollarda z detekcją cyklu Floyda, kryptoanalizę ataku Wienera na mały wykładnik prywatny d przy użyciu ułamków łańcuchowych, algorytm Baby-step Giant-step dla problemu logarytmu dyskretnego (DLP), pełną rekonstrukcję ataku wyroczni paddingu Bleichenbachera na RSA PKCS#1 v1.5, atak na częściowy wyciek nonce w ECDSA z wykorzystaniem redukcji kratowej LLL (Hidden Number Problem), pełną implementację standardu szyfrowania hybrydowego ECIES (Curve25519 + HKDF + AES-256-GCM), implementację podpisu Schnorra i wielopodpisu (MuSig), inspekcję binarną par kolizyjnych SHA-1 (SHAttered) na poziomie rejestrów funkcji kompresji, modelowanie algorytmu kwantowego Shora i kalkulację kubitów logicznych oraz konstrukcję postkwantowego schematu KEM opartego na problemie Learning With Errors (LWE / ML-KEM).
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (5.0).
    • Szczegółowy opis aparatu matematycznego i logicznego leżącego u podstaw przeprowadzonego ataku kryptoanalitycznego lub modelu postkwantowego.
    • Pełny kod źródłowy autorskich skryptów w języku Python z komentarzami objaśniającymi kluczowe algorytmy i struktury danych.
    • Dowody empiryczne: zrzuty ekranu konsoli, wygenerowane tabele wyników, logi odzyskiwania stanów pośrednich lub wykresy zbieżności.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami), wykaz literatury naukowej i standardów.
Kryptologia
lab 4 - 5.0
Spis
Spis zadań laboratoryjnych na ocenę 5.0
01/10
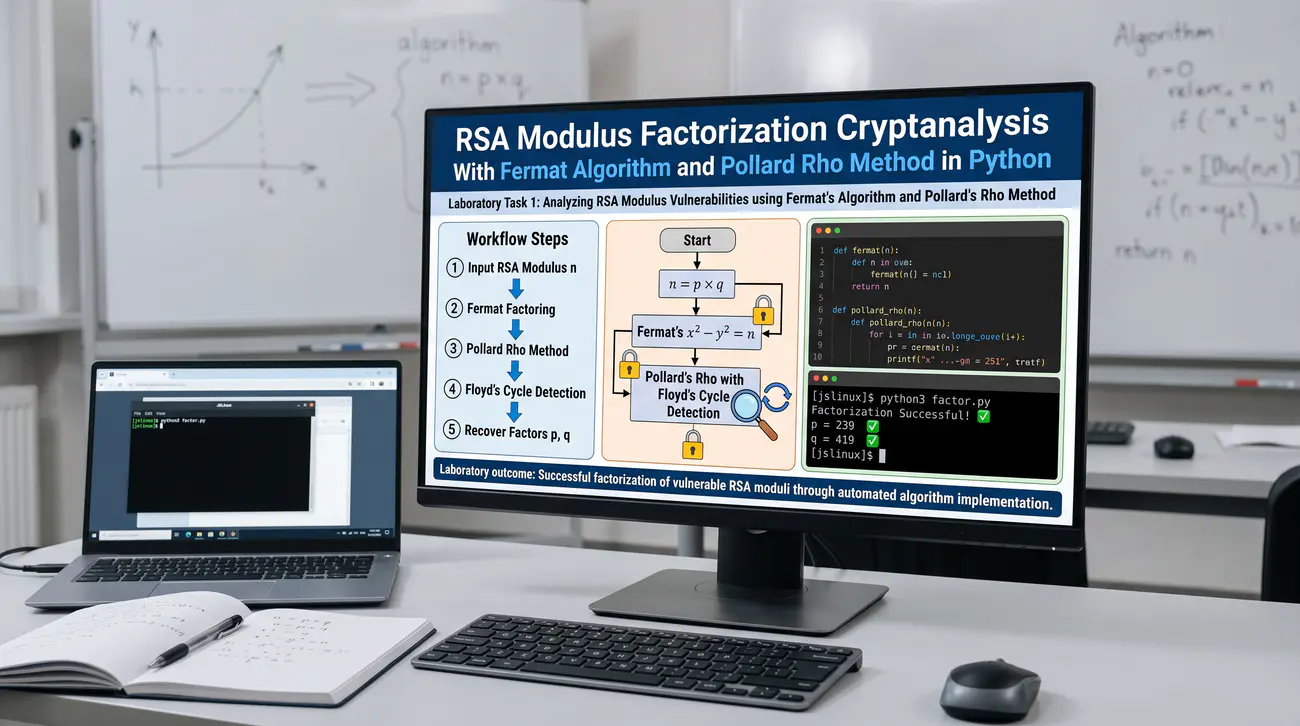
Zadanie 1. Kryptoanaliza faktoryzacyjna modułu RSA: implementacja algorytmu Fermata oraz metody rho Pollarda w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 5, 7, 10: problem faktoryzacji wielkich liczb n = p*q, słabość zbyt bliskich liczb pierwszych (faktoryzacja Fermata), metoda rho Pollarda z detekcją cyklu Floyda.

Cel

Celem zadania jest praktyczna implementacja i analiza zaawansowanych algorytmów faktoryzacji modułów RSA w języku Python. Student implementuje metodę faktoryzacji Fermata demonstrującą podatność modułów o zbyt bliskich czynnikach pierwszych oraz algorytm rho Pollarda z algorytmem wykrywania cyklu Floyda (żółw i zając) dla modułów posiadających małe dzielniki p-1.

Scenariusz – opis

Bezpieczeństwo kryptosystemu RSA opiera się na założeniu trudności faktoryzacji wielkiego modułu n = p * q. Jeśli napastnik zdoła rozłożyć moduł n na czynniki pierwsze p i q, natychmiast wylicza funkcję Eulera fi(n) = (p - 1) * (q - 1). Mając fi(n), napastnik oblicza klucz prywatny d = e^(-1) mod fi(n), co prowadzi do całkowitego złamania bezpieczeństwa. Błędy w generatorach liczb losowych mogą sprawić, że wylosowane liczby pierwsze p i q znajdą się zbyt blisko siebie. W takiej sytuacji algorytm Fermata, poszukujący liczb a i b takich, że n = a^2 - b^2 = (a - b)*(a + b), rozkłada moduł w zaledwie ułamku sekundy. Innym potężnym narzędziem jest algorytm rho Pollarda oparty na paradoksie dnia urodzin w ciągach pseudolosowych x_(i+1) = (x_i^2 + c) mod n.

Co ma wykonać student / grupa

W pliku rsa_factorization.py implementujesz metodę faktoryzacji Fermata: startujesz od a = ceil(sqrt(n)) i iteracyjnie sprawdzasz, czy b2 = a^2 - n jest kwadratem liczby całkowitej. Generujesz 1024-bitowy podatny moduł n_close, w którym różnica pomiędzy liczbami pierwszymi wynosi mniej niż 2^20. Na zajęciach demo Fermata obniżasz do 512 bitów z różnicą <2^20 (mierzalne ms) i dokładasz tabelę kroki-rho vs rozmiar najmniejszego czynnika. Uruchamiasz funkcję Fermata mierząc czas wykonania i odzyskujesz czynniki p oraz q w czasie poniżej 10 milisekund. Obliczasz fi(n), wyznaczasz tajny wykładnik d_cracked dla standardowego e = 65537 i deszyfrujesz testowy szyfrogram.

Następnie w tym samym skrypcie implementujesz algorytm rho Pollarda z optymalizacją wykrywania cykli Floyda. Wykorzystujesz funkcję wielomianową f(x) = (x^2 + 1) mod n oraz sekwencję dwóch wskaźników poruszających się z różną prędkością: żółwia (x) i zająca (y = f(f(y))). W każdym kroku obliczasz NWD(|x - y|, n) za pomocą algorytmu Euklidesa, szukając nietrywialnego dzielnika modułu n. Testujesz metodę rho Pollarda na modułach o wielkości 64, 80 oraz 96 bitów z niesymetrycznymi czynnikami pierwszymi.

Sporządzasz wykres lub tabelę zależności liczby kroków algorytmu od wielkości najmniejszego czynnika pierwszego p. Weryfikujesz ograniczenie O(sqrt(p)) wynikające z paradoksu dnia urodzin w przestrzeni stanów. Porównujesz skuteczność metody Fermata i metody rho Pollarda dla różnych klas słabych kluczy RSA. Analizujesz współczesne wymagania standaryzacyjne (NIST SP 800-56B) nakazujące, aby |p - q| > 2^(nlen/2 - 100). Wykonujesz zrzuty ekranu konsoli z pomiarami czasów faktoryzacji oraz zrekonstruowanymi kluczami prywatnymi.

Formułujesz wnioski kryptoanalityczne dotyczące właściwego doboru liczb pierwszych w architekturze PKI. Kompletujesz pełne sprawozdanie laboratoryjne z realizacji zadania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik rsa_factorization.py w środowisku roboczym.
  2. Zaimplementuj funkcję is_square(n) sprawdzającą, czy liczba jest dokładnym kwadratem.
  3. Zaimplementuj algorytm Fermata fermat_factor(n) znajdujący czynniki p i q.
  4. Do demo laboratoryjnego wygeneruj moduł 512-bitowy z różnicą <2^20 (szybkie ms w czystym Pythonie; pełne 1024 bity za ciężkie na zajęcia).
  5. Wygeneruj 512-bitową liczbę pierwszą p_base i ustaw p = next_prime(p_base), q = next_prime(p + 1000).
  6. Oblicz n_vuln = p * q (moduł o bardzo bliskich czynnikach).
  7. Uruchom faktoryzację Fermata dla n_vuln i zmierz dokładny czas wykonania w milisekundach.
  8. Potwierdź natychmiastowe odzyskanie p i q oraz wyznacz fi(n) i klucz prywatny d.
  9. Zaszyfruj wiadomość modułem n_vuln i odszyfruj ją odzyskanym kluczem d.
  10. Zaimplementuj algorytm rho Pollarda pollard_rho(n) z wskaźnikami Floyda x i y.
  11. Wprowadź zabezpieczenie przed zapętleniem oraz obsługę wielokrotnych wartości NWD.
  12. Przetestuj rho Pollarda na modułach z małym dzielnikiem: p=1000003, q=300000000007.
  13. Zmierz liczbę iteracji wymaganych do znalezienia dzielnika przez metodę rho Pollarda.
  14. Porównaj uzyskane wyniki ze złożonością teoretyczną O(p^(1/4)) operacji modularnych.
  15. Zaimplementuj funkcję weryfikującą odległość |p - q| zgodnie z zaleceniem NIST.
  16. Wykonaj zrzuty ekranu logów wykonania obu algorytmów faktoryzacyjnych.
  17. Opracuj raport laboratoryjny z dowodami algebraicznymi poprawności metod.

Kontrola zaliczenia (checklist):

  1. Złamano słabe moduły RSA na wektorze ze startera: Fermata (bliskie p,q) i rho Pollarda (mały czynnik) — odzyskane p,q,d i odszyfrowany tekst.
  2. Wykazano różnicę: generator słaby (łamany w sekundach) vs silny (losowe, odległe p,q — brak faktoryzacji w limicie); dołączono logi czasów.
  3. Dołączono log ataku (iteracje Fermata, cykl Floyda) + kod łatki (silne pierwsze, test odległości, min. 2048 bitów).
  4. Opisano w 3–5 zdaniach kompromis: koszt generowania vs separacja czynników, pierwiastek paradoksu urodzin, standardy branżowe.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie podatności modułów RSA o zbyt bliskich czynnikach pierwszych na faktoryzację Fermata.
  • Opanowanie implementacji algorytmu rho Pollarda i techniki detekcji cyklu Floyda w ciałach skończonych.
  • Zrozumienie, w jaki sposób paradoks dnia urodzin redukuje złożoność faktoryzacji do pierwiastka z rzędu dzielnika.
  • Świadomość standardów przemysłowych gwarantujących odpowiednią separację czynników pierwszych w procedurach generowania kluczy.
Zadanie 1 - ilustracja
02/10
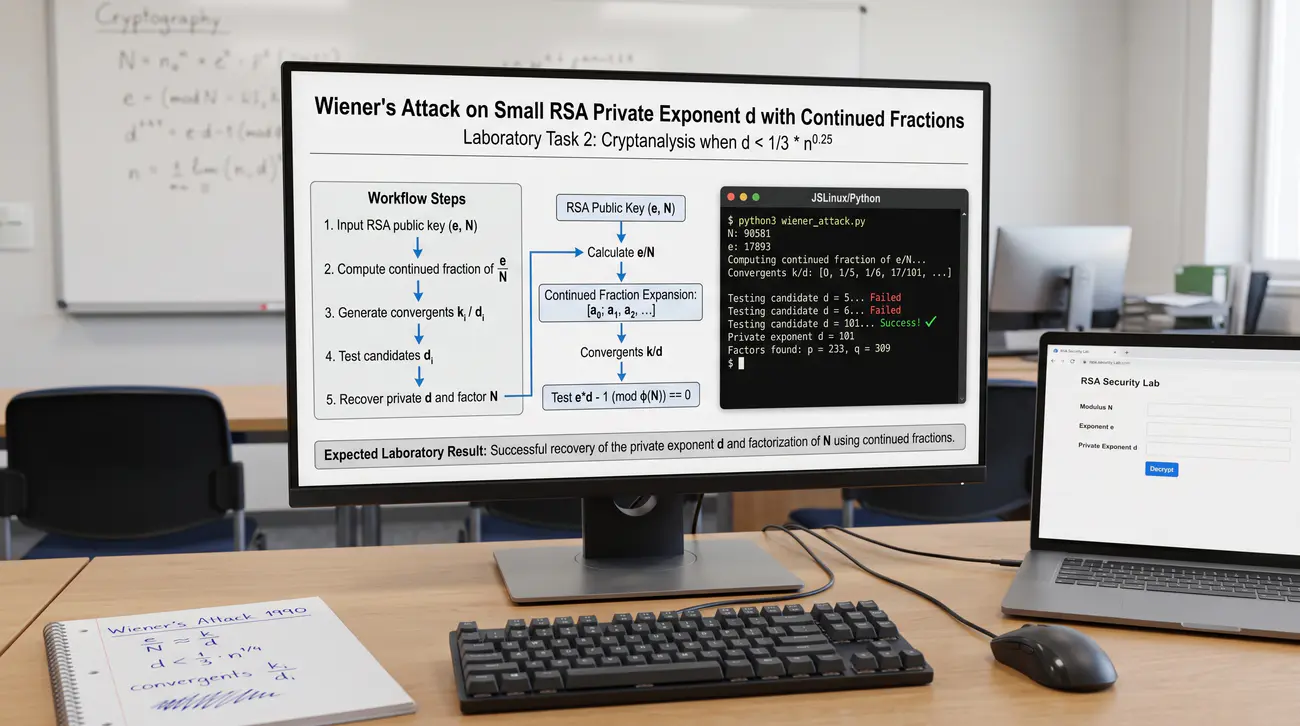
Zadanie 2. Kryptoanaliza ataku Wienera na mały prywatny wykładnik d w RSA przy użyciu ułamków łańcuchowych
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 10, 11: bezpieczeństwo RSA, atak Wienera (1990), mały prywatny wykładnik d < 1/3 * n^(1/4), rozwinięcie w ułamek łańcuchowy liczby e/n, redukty k/d.

Cel

Celem zadania jest praktyczna implementacja i analiza ataku Wienera na kryptosystem RSA z małym prywatnym wykładnikiem d w języku Python. Student implementuje algorytm rozwinięcia ilorazu e/n w ułamek łańcuchowy, generuje kolejne redukty ułamkowe k/d i dowodzi, że gdy d < 1/3 * n^(1/4), klucz prywatny oraz czynniki pierwsze p i q mogą zostać zrekonstruowane w czasie wielomianowym.

Scenariusz – opis

W celu optymalizacji prędkości deszyfrowania lub tworzenia podpisów programiści bywali kuszeni wyborem małego wykładnika prywatnego d. W 1990 roku Michael J. Wiener opublikował przełomowy atak kryptoanalityczny oparty na teorii aproksymacji diofantycznej. Twierdzenie Wienera głosi, że jeśli d < (1/3) * n^(1/4), to ułamek k/d jest jednym z reduktów rozwinięcia liczby e/n w ułamek łańcuchowy. Z równania e*d - k*fi(n) = 1 wynika, że e/fi(n) - k/d = 1/(d*fi(n)), a ponieważ n jest bliskie fi(n), ułamek k/d stanowi doskonałe przybliżenie e/n. Liczba reduktów ułamka łańcuchowego wynosi O(log n), co pozwala napastnikowi na przetestowanie wszystkich kandydatów w czasie ułamka sekundy. Dla każdego kandydata k/d napastnik wyznacza potencjalne fi(n) = (e*d - 1) // k i rozwiązuje równanie kwadratowe na czynniki p i q.

Co ma wykonać student / grupa

W pliku rsa_wiener_attack.py tworzysz generator kluczy RSA dobierający mały wykładnik prywatny d spełniający warunek Wienera d < (1/3) * n^(0.25) (szkielet: gotowy generator gen_weak_rsa(bits, d_bits) z karty). Dokładasz test negatywny: dla d > n^0.25 żaden redukt nie spełnia równania (kontrast z progiem Boneha-Durfee n^0.292 we wnioskach). Wyznaczasz publiczny wykładnik e = d^(-1) mod fi(n), który z natury przyjmuje wielkość rzędu modułu n. Zapisujesz parę publiczną (e, n) o długości 1024 bitów oraz tajną wartość d do celów weryfikacji sukcesu.

Implementujesz algorytm rozwinięcia liczby wymiernej e/n w skończony ułamek łańcuchowy [a0; a1, a2, ..., am]. Implementujesz generator reduktów (convergents) wyliczający ciąg ułamków nieskracalnych k_i / d_i ze wzorów rekurencyjnych. Dla każdego reduktu k_i / d_i sprawdzasz warunki wstępne: k_i != 0 oraz czy (e * d_i - 1) jest podzielne przez k_i. Jeśli podzielność zachodzi, przyjmujesz kandydata na funkcję Eulera: phi_cand = (e * d_i - 1) // k_i.

Konstruujesz równanie kwadratowe x^2 - (n - phi_cand + 1)*x + n = 0, którego pierwiastkami muszą być liczby pierwsze p i q. Obliczasz wyróżnik delta = (n - phi_cand + 1)^2 - 4*n i sprawdzasz, czy delta > 0 oraz czy jest dokładnym kwadratem liczby całkowitej. Gdy warunek jest spełniony, wyznaczasz pierwiastki x1 i x2: odzyskujesz czynniki pierwsze p i q. Weryfikujesz, że p * q == n: w tym momencie atak zostaje w 100% zakończony sukcesem, a odnaleziony mianownik d_i jest kluczem prywatnym d.

Testujesz odporność: zwiększasz długość d powyżej granicy n^(0.25) i potwierdzasz, że żaden redukt nie spełnia równania kwadratowego. Badany atak zestawiasz z uogólnieniem Boneha-Durfee rozszerzającym granicę podatności do d < n^0.292. Dokumentujesz proces odzyskiwania klucza zrzutami ekranu konsoli oraz wypisaniem ciągu reduktów. Przygotowujesz pełne sprawozdanie laboratoryjne z analizą matematyczną aproksymacji diofantycznej.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik rsa_wiener_attack.py w katalogu roboczym.
  2. Zaimplementuj procedurę generowania ułamka łańcuchowego continued_fraction( numerator, denominator).
  3. Zaimplementuj generator reduktów get_convergents(fraction_coeffs).
  4. Wygeneruj 1024-bitowy moduł RSA ze sztucznie dobranym małym d: d < (1/3) * (n**0.25).
  5. Wylicz e = pow(d, -1, phi) i opublikuj parę publiczną (e, n).
  6. Rozwiń e/n w ułamek łańcuchowy i wypisz pierwsze 20 współczynników.
  7. Rozpocznij pętlę iteracyjną po wygenerowanych reduktach (k, d_cand).
  8. Pomiń przypadki gdzie k == 0 lub (e * d_cand - 1) % k != 0.
  9. Oblicz potencjalne phi = (e * d_cand - 1) // k.
  10. Oblicz wyróżnik równania kwadratowego delta = (n - phi + 1)**2 - 4*n.
  11. Sprawdź, czy delta jest kwadratem za pomocą is_square( delta).
  12. Wylicz pierwiastki p_cand i q_cand ze wzorów na równanie kwadratowe.
  13. Sprawdź czy p_cand * q_cand == n.
  14. Po potwierdzeniu tożsamości wyświetl komunikat o odzyskaniu klucza prywatnego d_cand.
  15. Zweryfikuj tożsamość d_cand == d i zmierz czas trwania całego ataku.
  16. Wykonaj zrzuty ekranu i sformułuj wnioski kryptoanalityczne w sprawozdaniu.

Kontrola zaliczenia (checklist):

  1. Złamano RSA z małym d atakiem Wienera na wektorze ze startera: e/n w ułamek łańcuchowy, redukty k/d, test φ i pierwiastki p,q.
  2. Wykazano różnicę: małe d< N^0.25/3 (odzyskane) vs pełne d (brak reduktu, atak staje); dołączono log reduktów.
  3. Dołączono log ataku (konwergenty, weryfikacja) + kod łatki (d pełnej długości, e=65537, OAEP, audyt parametrów).
  4. Opisano w 3–5 zdaniach kompromis: szybkość deszyfrowania vs Wiener, φ z równania kwadratowego, granica ułamków.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie teoretycznych i praktycznych aspektów ataku Wienera na RSA z małym wykładnikiem d.
  • Opanowanie implementacji ułamków łańcuchowych i generowania reduktów w kryptoanalizie.
  • Zrozumienie algebraicznego powiązania funkcji Eulera phi(n) ze współczynnikami równania kwadratowego sumy i iloczynu p i q.
  • Świadomość konieczności dobierania klucza prywatnego d o pełnej długości modularnej (zbliżonej do rozmiaru n).
Zadanie 2 - ilustracja
03/10
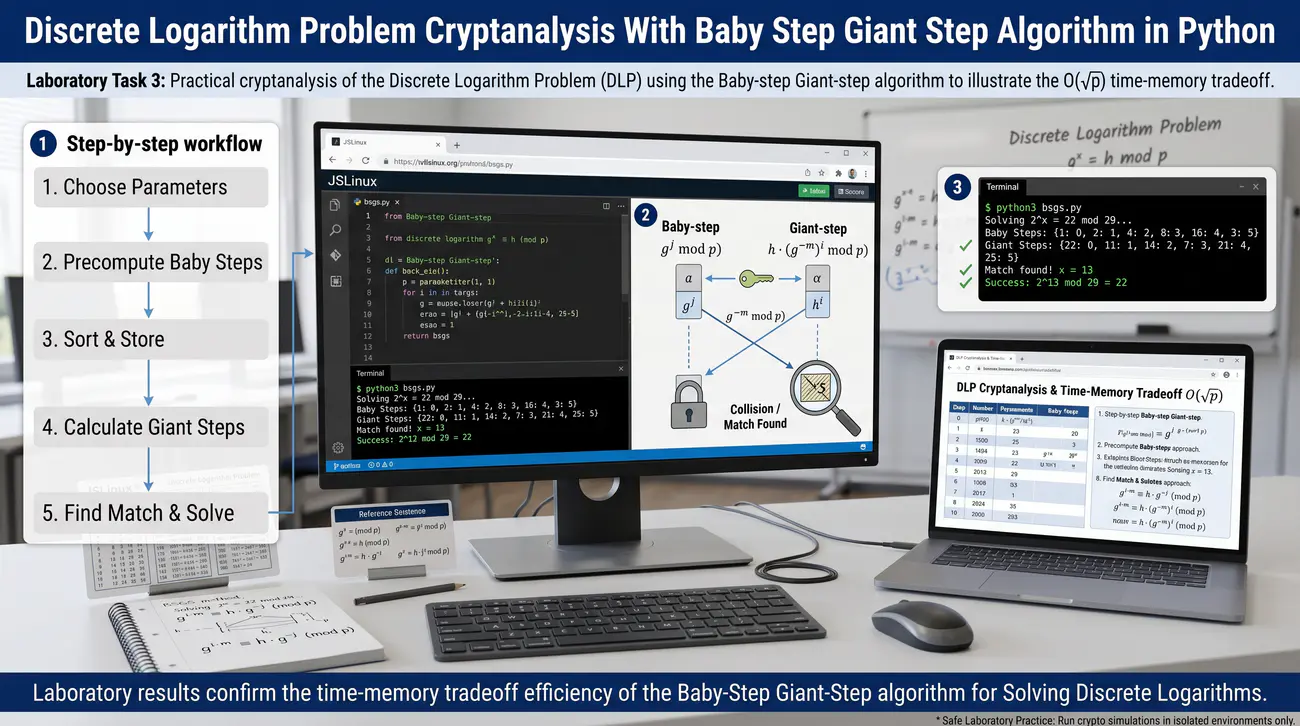
Zadanie 3. Kryptoanaliza problemu logarytmu dyskretnego (DLP): algorytm Baby-step Giant-step w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 5, 13, 15: problem logarytmu dyskretnego (DLP), równanie g^x = h mod p, algorytm Baby-step Giant-step Shanka, kompromis czasowo-pamięciowy O(sqrt(p)).

Cel

Celem zadania jest praktyczna implementacja algorytmu Baby-step Giant-step (BSGS) Daniela Shanka w języku Python do rozwiązywania problemu logarytmu dyskretnego (DLP). Student implementuje kryptoanalityczny atak na protokół Diffiego-Hellmana w grupach zredukowanych, wyznaczając tajny wykładnik x z podsłuchanego klucza publicznego h = g^x mod p przy złożoności czasowo-pamięciowej O(sqrt(p)).

Scenariusz – opis

Trudność odwrócenia potęgowania modularnego w ciele liczb pierwszych, czyli wyznaczenie x z równania g^x = h (mod p), stanowi fundament protokołu DH i kryptosystemu ElGamala. Naiwny atak siłowy (brute-force) wymaga sprawdzenia do p-1 wartości, co dla dużych liczb pierwszych jest niewykonalne. W 1971 roku Daniel Shanks zaprojektował algorytm Baby-step Giant-step oparty na kompromisie czasowo-pamięciowym (Time-Memory Trade-Off). Niech m = ceil(sqrt(n)), gdzie n jest rzędem grupy. Tajny wykładnik można przedstawić w postaci x = i*m + j, gdzie 0 <= i, j < m. Równanie g^x = h przyjmuje postać g^(i*m + j) = h, co po przekształceniu daje g^j = h * (g^(-m))^i (mod p). Napastnik w fazie Baby-step tworzy tablicę par (g^j mod p, j) dla wszystkich 0 <= j < m, a w fazie Giant-step poszukuje kolizji w tablicy dla kolejnych wartości i.

Co ma wykonać student / grupa

W pliku bsgs_dlp_solver.py implementujesz procedurę rozwiązania problemu logarytmu dyskretnego algorytmem Shanka. Konfigurujesz parametry testowej grupy Diffiego-Hellmana: liczbę pierwszą p o długości 40-48 bitów oraz generator g. Zakres laboratoryjny ograniczasz do 32-36 bitów (40-48 bitów zjada pamięć JSLinux) i dokładasz tabelę czas x pamięć 24->44 bity z wnioskiem, dlaczego DH wymaga 2048 bitów (256 w ECC). Alice losuje tajny klucz prywatny x z zakresu [1, p-1] i oblicza swój publiczny klucz h = pow(g, x, p).

Jako napastnik przechwytujesz wartości p, g oraz h i przystępujesz do fazy przygotowawczej ataku. Obliczasz optymalną długość kroku: m = math.isqrt(p) + 1. Faza Baby-step: tworzysz słownik (hash table) w Pythonie przechowujący wartości g^j mod p jako klucze oraz j jako wartości dla j od 0 do m-1. Mierzysz zużycie pamięci tablicy i odnotowujesz, że wymaga ona dokładnie m wpisów.

Obliczasz mnożnik wielkiego kroku: wyznaczasz g^(-m) mod p za pomocą odwrotności modularnej pow(g, -m, p) lub pow(pow(g, m, p), -1, p). Faza Giant-step: inicjalizujesz zmienną cur = h i w pętli dla i od 0 do m sprawdzasz, czy cur znajduje się w słowniku Baby-step. Gdy wystąpi trafienie (kolizja w tablicy haszującej), odczytujesz powiązaną wartość j. Wyznaczasz rozwiązanie logarytmu dyskretnego: x_recovered = i * m + j.

Sprawdzasz poprawność matematyczną: weryfikujesz tożsamość pow(g, x_recovered, p) == h. Potwierdzasz, że odzyskane x_recovered jest dokładnie równe tajnemu kluczowi prywatnemu Alice x. Porównujesz czas wykonania algorytmu BSGS z naiwnym przeszukaniem liniowym, rejestrując setki tysięcy razy wyższą prędkość. Sporządzasz tabelę zależności czasu wykonania i zużycia pamięci od długości bitowej p (od 24 do 44 bitów). Formułujesz podsumowanie wyjaśniające, dlaczego współczesne standardy DH wymagają grup o rozmiarze co najmniej 2048 bitów (lub 256 bitów w ECC).

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik bsgs_dlp_solver.py w środowisku roboczym.
  2. Zaimplementuj generator parametrów małej grupy DH (p, g) o zadanym rozmiarze bitowym.
  3. Wygeneruj 40-bitową liczbę pierwszą p oraz generator g.
  4. Uwaga laboratoryjna: docelowo testuj na 32-36 bitach (większe zjadają pamięć tablicy BSGS w JSLinux); sporządź tabelę czas x pamięć 24->44 bity.
  5. Wylosuj tajny klucz prywatny x i oblicz klucz publiczny h = pow(g, x, p).
  6. Zaimplementuj funkcję shanks_bsgs(g, h, p) rozwiązującą równanie g^x = h mod p.
  7. Oblicz m = math.isqrt(p) + 1.
  8. Zbuduj tablicę Baby-step: baby_steps = {pow(g, j, p): j for j in range(m)}.
  9. Oblicz czynnik wielkiego kroku: factor = pow(pow(g, m, p), -1, p).
  10. Zainicjalizuj cur = h i rozpocznij pętlę Giant-step dla i in range(m).
  11. Sprawdź czy cur in baby_steps: jeśli tak, zwróć i*m + baby_steps[cur].
  12. Zaktualizuj cur = (cur * factor) % p w kolejnych iteracjach.
  13. Uruchom atak na wygenerowanym kluczu h i zmierz czas trwania fazy Baby i Giant.
  14. Zweryfikuj tożsamość odzyskanego klucza: assert pow(g, x_rec, p) == h.
  15. Wykonaj test porównawczy z przeszukaniem naiwnym brute-force dla małego p (32 bity).
  16. Wykonaj zrzuty ekranu konsoli prezentujące zbieżność algorytmu i odzyskany sekret.
  17. Opracuj raport laboratoryjny z analizą kompromisu czasowo-pamięciowego.

Kontrola zaliczenia (checklist):

  1. Złamano DH/DLA atakiem BSGS na wektorze ze startera: tablica baby-steps w RAM, giant-steps do kolizji, odzyskany sekret bez O(p).
  2. Wykazano różnicę: mała grupa (łamana w O(√p)) vs grupa 2048+ (niewykonalne, ekstrapolacja); dołączono czasy i pamięć.
  3. Dołączono log ataku (rozmiar tablicy, trafienie) + kod łatki (grupy ≥2048 / krzywe 256-bit, walidacja podgrup).
  4. Opisano w 3–5 zdaniach kompromis czas–pamięć, granice RAM dla BSGS, rho bezpamięciowe jako następny krok.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie algorytmu Baby-step Giant-step Shanka i jego roli w kryptoanalizie DLP.
  • Opanowanie techniki kolizyjnej w tablicach haszujących do radykalnego przyspieszenia poszukiwania sekretu.
  • Empiryczne potwierdzenie redukcji złożoności obliczeniowej z O(p) do O(sqrt(p)).
  • Zrozumienie ograniczeń pamięciowych ataku BSGS i konieczności stosowania algorytmów bezpamięciowych (np. rho Pollarda dla DLP).
Zadanie 3 - ilustracja
04/10
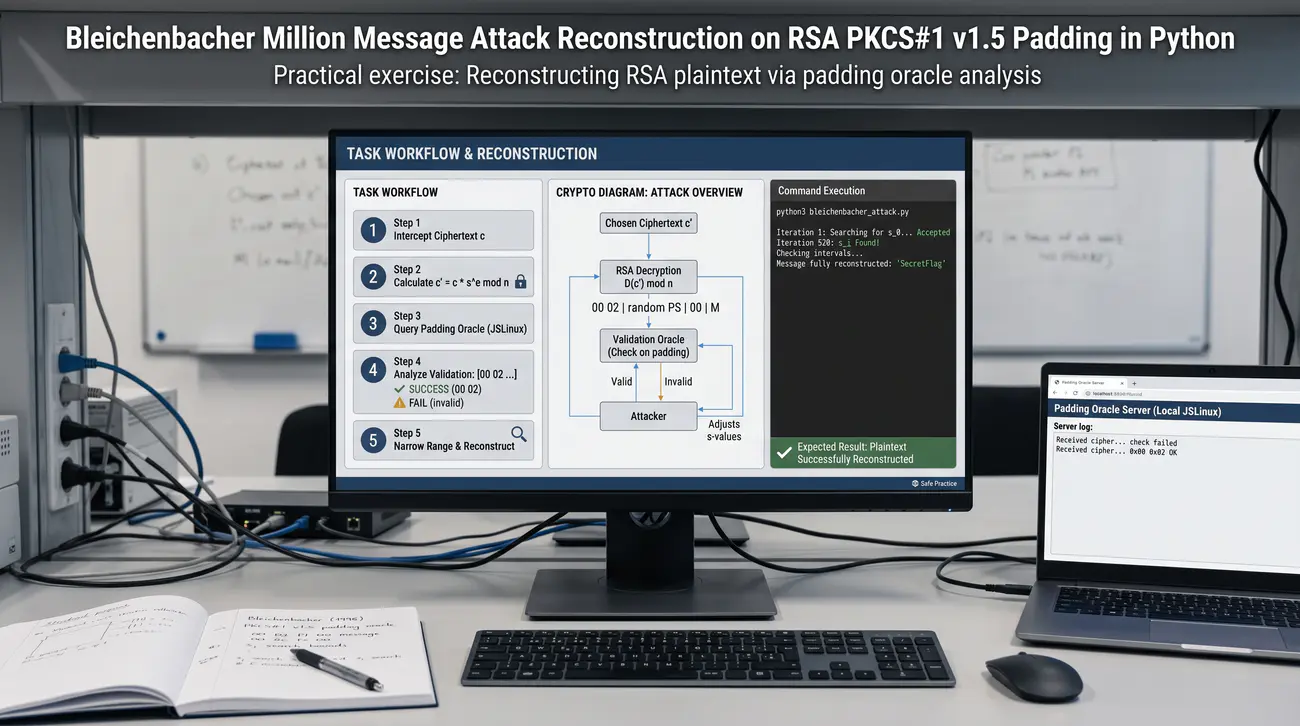
Zadanie 4. Rekonstrukcja ataku Bleichenbachera 'Million Message Attack' na padding RSA PKCS#1 v1.5 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 11, 12: podatności RSA, słynny atak Bleichenbachera (1998, Million Message Attack / Adaptive Chosen-Ciphertext Attack), wyrocznia dopełnienia (Padding Oracle) w standardzie PKCS#1 v1.5.

Cel

Celem zadania jest praktyczna rekonstrukcja i symulacja przełomowego ataku Bleichenbachera na standard dopełnienia RSA PKCS#1 v1.5 w języku Python. Student modeluje działanie wyroczni paddingu (odpowiadającej czy zdeszyfrowany blok zaczyna się od bajtów 0x00 0x02), implementuje adaptacyjny dobór mnożników s_i oraz procedurę zawężania przedziałów poszukiwanego tekstu jawnego aż do pełnego odzyskania sekretu.

Scenariusz – opis

W 1998 roku Daniel Bleichenbacher opublikował niszczycielski atak adaptacyjny CCA2 na serwery SSL wykorzystujące szyfrowanie RSA PKCS#1 v1.5. Standard ten wymaga, aby odszyfrowany blok o długości B bajtów zaczynał się od prefiksu 0x00 || 0x02, po którym następuje niezerowy padding. Wiele serwerów w przypadku błędu formatu paddingu zwracało odmienny komunikat błędu niż przy innych awariach, stając się wyrocznią paddingu. Wyrocznia odpowiada wyłącznie jednym bitem informacji: PRAWDA (wiadomość jest PKCS-zgodna) lub FAŁSZ. Bleichenbacher udowodnił, że ten pojedynczy bit wystarcza do pełnego odszyfrowania dowolnego przechwyconego szyfrogramu. Atak polega na mnożeniu szyfrogramu c przez s^e mod n i iteracyjnym zawężaniu przedziałów liczbowych [2B, 3B - 1], w których może znajdować się m.

Co ma wykonać student / grupa

W pliku bleichenbacher_sim.py konfigurujesz środowisko z kluczami RSA (dydaktycznie mały moduł 256-384 bity, aby ~1M zapytań pełnej skali zmieścić w 90 minutach). Korzystasz ze szkieletu z karty: gotowe padding_oracle() i update_intervals() - student implementuje tylko dobór s_i i log zbieżności. Definiujesz stałą graniczną B = 2^(8*(k-2)), gdzie k jest rozmiarem modułu w bajtach. Wiadomość jest poprawna w sensie PKCS#1 v1.5, jeśli jej wartość numeryczna mieści się w przedziale [2*B, 3*B - 1].

Implementujesz funkcję wyroczni padding_oracle(c_test, d, n, B): odszyfrowuje c_test i sprawdza czy 2*B <= (c_test^d mod n) < 3*B. Szyfrujesz tajną wiadomość m_secret poprawnie sformatowaną według schematu PKCS#1 v1.5, uzyskując szyfrogram docelowy c_0. Implementujesz Krok 1 ataku: upewniasz się, że c_0 jest PKCS-zgodne. Implementujesz Krok 2 ataku: wyszukiwanie pierwszego mnożnika s_1 startując od ceil(n / (3*B)), aż wyrocznia zwróci PRAWDA dla c_0 * (s_1)^e mod n.

Implementujesz Krok 3 ataku: zawężanie zbioru przedziałów [a, b] na podstawie odnalezionego mnożnika s_i. Implementujesz Krok 4 ataku: gdy w zbiorze pozostaje tylko jeden przedział, dynamicznie dobierasz mnożnik s_(i+1) ze wzorów analitycznych Bleichenbachera. Rejestrujesz proces kurczenia się przedziału poszukiwań z każdym zapytaniem do wyroczni. Gdy przedział zbiega się do pojedynczego punktu [a, a], odzyskujesz dokładną liczbę całkowitą m = a.

Konwertujesz m na bajty, weryfikujesz prefiks 0x00 0x02 i odczytujesz odzyskany tekst jawny. Zliczasz łączną liczbę zapytań wysłanych do wyroczni i analizujesz tempo zbieżności. Badany atak zestawiasz z nowoczesnymi atakami na TLS (ROBOT Attack z 2017 roku) oraz zaleceniami przejścia na standard RSA-OAEP. Dokumentujesz zrzutami ekranu przebieg ataku i kompletujesz sprawozdanie laboratoryjne.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik bleichenbacher_sim.py w środowisku Python.
  2. Zdefiniuj generator klucza RSA o rozmiarze 256 lub 512 bitów.
  3. Oblicz stałą B = 2**(8*(k - 2)).
  4. Zaimplementuj wyrocznię oracle(c, d, n, B) zwracającą bool.
  5. Przygotuj wiadomość z poprawnym prefiksem PKCS#1 v1.5 i zaszyfruj do c0.
  6. Zaimplementuj zbiór przedziałów M = [[2*B, 3*B - 1]].
  7. Napisz pętlę wyszukującą pierwszy mnożnik s1.
  8. Zaimplementuj funkcję aktualizującą zbiór przedziałów update_intervals(M, s, B, n).
  9. Zaimplementuj procedurę wyszukiwania s dla pojedynczego przedziału (wzory z kroku 2c publikacji Bleichenbachera).
  10. Uruchom pełną pętlę ataku i wyświetlaj liczbę przedziałów oraz ich szerokość w każdej iteracji.
  11. Zatrzymaj pętlę w momencie gdy przedział redukuje się do postaci [m_found, m_found].
  12. Potwierdź, że m_found == m_secret.
  13. Usuń bajty paddingu i wyodrębnij oryginalną treść tekstową.
  14. Zanotuj liczbę wywołań wyroczni i porównaj z teoretycznymi estymacjami.
  15. Wykonaj zrzuty ekranu logów zbieżności przedziałów w konsoli.
  16. Opracuj raport ze szczegółową analizą dlaczego podatność ta wymusiła wycofanie PKCS#1 v1.5 w TLS 1.3.

Kontrola zaliczenia (checklist):

  1. Zrekonstruowano Bleichenbachera na wektorze ze startera: wyrocznia 00 02 odzyskuje M zawężaniem przedziałów (log przedziałów, ~1M zapytań w modelu).
  2. Wykazano różnicę: PKCS#1 v1.5 z wyciekiem (pełny odzysk) vs OAEP/jednolity błąd (brak wycieku); dołączono oba logi.
  3. Dołączono log ataku (iteracje przedziałów) + kod łatki (OAEP, stały czas, jeden komunikat błędu, TLS 1.3 bez RSA-key-exchange).
  4. Opisano w 3–5 zdaniach kompromis: 1 bit wycieku wystarcza, adaptacyjny CCA, koszt audytu paddingu.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie mechanizmu działania adaptacyjnego ataku z wybranym szyfrogramem Bleichenbachera.
  • Opanowanie techniki zawężania przedziałów w oparciu o wyrocznię jednobitową (Padding Oracle).
  • Zrozumienie, dlaczego nawet subtelne wycieki informacji o błędach formatowania prowadzą do całkowitej kompromitacji poufności.
  • Świadomość konieczności stosowania schematu OAEP lub algorytmów KEM o konstrukcji uniemożliwiającej ataki wyroczniowe.
Zadanie 4 - ilustracja
05/10
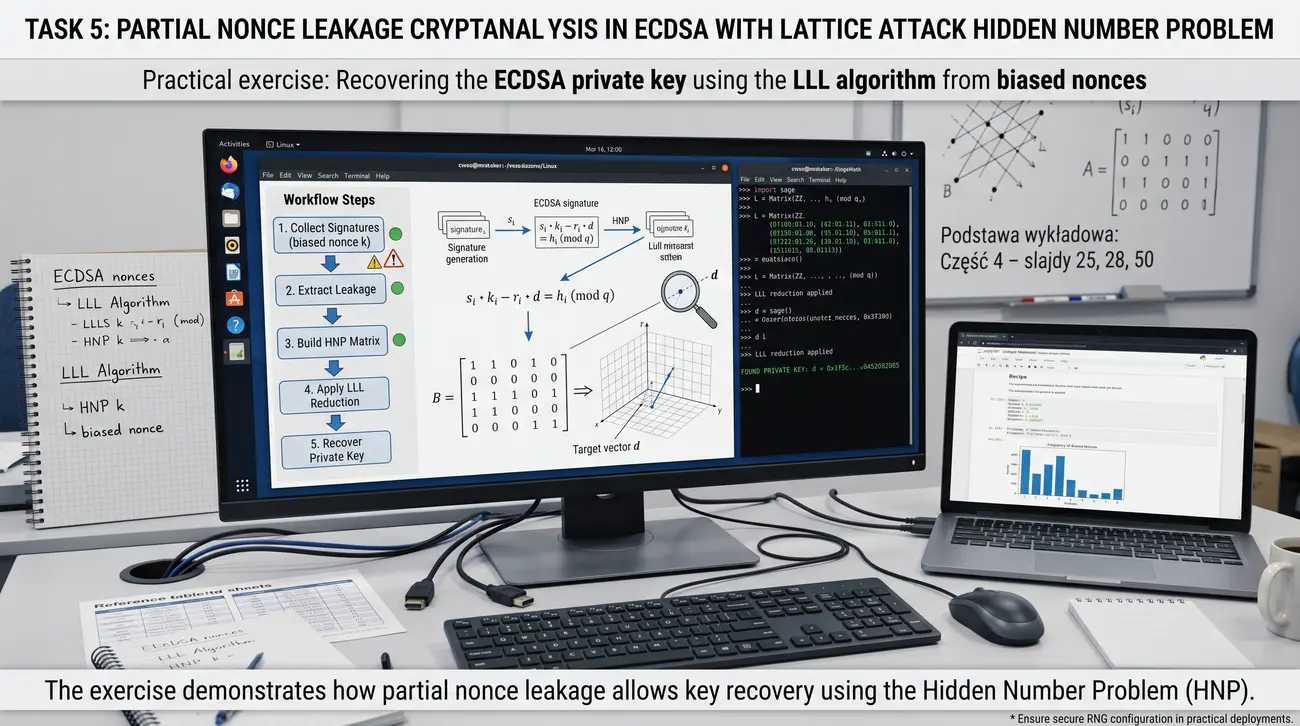
Zadanie 5. Kryptoanaliza częściowego wycieku nonce w ECDSA techniką krat (Lattice Attack / Hidden Number Problem)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 25, 28, 50: podatności ECDSA, częściowy wyciek bitów losowości nonce k (Biased Nonce), problem ukrytej liczby (Hidden Number Problem - HNP), redukcja kratowa LLL.

Cel

Celem zadania jest zbadanie zaawansowanego ataku kryptoanalitycznego na podpisy ECDSA w sytuacji, gdy generator liczb losowych wykazuje skazę (bias) i ujawnia kilka najmniej znaczących bitów wartości nonce k. Student modeluje problem ukrytej liczby HNP (Hidden Number Problem) za pomocą macierzy kraty i bada odzyskanie klucza prywatnego d przy użyciu zredukowanej bazy wektorów.

Scenariusz – opis

W klasycznym ataku na ECDSA powtórzenie dokładnie tej samej wartości k natychmiast ujawnia klucz prywatny. Co jednak w sytuacji, gdy k jest za każdym razem inne, ale generator liczb losowych jest lekko zniekształcony (ang. biased nonce)? Przykładowo, jeśli generator w wyniku błędu implementacji lub ataku czasowego produkuje k, którego 4 lub 8 najmniej znaczących bitów to zawsze zera. W 1996 roku Boneh i Venkatesan sformułowali problem ukrytej liczby HNP (Hidden Number Problem). Okazuje się, że zbierając kilkadziesiąt podpisów z lekko obciążonym k, można sformułować układ nierówności modularnych. Układ ten redukuje się do problemu znalezienia najkrótszego wektora (SVP) lub najbliższego wektora (CVP) w wielowymiarowej kracie, rozwiązywalnego algorytmem LLL.

Co ma wykonać student / grupa

W pliku ecdsa_lattice_hnp.py przygotowujesz środowisko badawcze z krzywą eliptyczną secp256k1 lub małą dydaktyczną krzywą modularną. Generujesz klucz prywatny ofiary d i odpowiadający klucz publiczny Q = d * G. Implementujesz wadliwy generator liczb losowych biased_rng(bits_leak=6, n): generuje k takie, że pierwsze 6 bitów jest zawsze zerami (k < n / 2^6). Podpisujesz m różnych wiadomości (np. m = 15 lub m=20) przy użyciu wadliwego generatora, zbierając pary sygnatur (r_i, s_i) oraz skróty e_i.

Wyprowadzasz zależność HNP: z równania s_i = k_i^(-1)*(e_i + d*r_i) mod n wynika, że k_i = s_i^(-1)*e_i + d * s_i^(-1)*r_i mod n. Definiujesz parametry t_i = (s_i^(-1) * r_i) mod n oraz u_i = (s_i^(-1) * e_i) mod n. Zapisujesz kongruencję: d * t_i - k_i = -u_i (mod n), gdzie niewiadome k_i są bardzo małe w porównaniu z n. Konstruujesz macierz kraty Kanaia-Kannan o wymiarach (m+2) x (m+2) w Pythonie reprezentującą układ bazowych wektorów.

Wypełniasz macierz współczynnikami t_i, modułem n oraz wagami skalującymi dla małych wartości k_i. Wykorzystujesz bibliotekę numeryczną lub zaimplementowaną procedurę redukcji baz LLL (Lenstra-Lenstra-Lovász) w Pythonie. Dozwalasz gotową bibliotekę LLL (lub uproszczoną redukcję 2D Gaussa na małej krzywej - implementacja LLL od zera nierealna w 90 minut) i dokładasz tabelę sukces vs liczba podpisów m i stałych bitów l. W zredukowanej bazie poszukujesz wektora o najmniejszej normie euklidesowej.

Wyodrębniasz współczynniki zredukowanego wektora i odzyskujesz wartość klucza prywatnego d. Weryfikujesz odzyskany klucz: potwierdzasz tożsamość d_recovered * G == Q. Sporządzasz zestawienie wymaganej liczby podpisów m w zależności od liczby znanych/stałych bitów wycieku l.

Formułujesz podsumowanie wyjaśniające, dlaczego nawet ułamek bitu asymetrii losowości w atakach bocznych (Side-Channel) wystarcza do złamania ECDSA. Kompletujesz materiały dowodowe do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik ecdsa_lattice_hnp.py w środowisku roboczym.
  2. Zdefiniuj parametry krzywej eliptycznej (p, a, b, G, n).
  3. Wygeneruj klucz prywatny ofiary d.
  4. Zaimplementuj wadliwy generator biased_k(n, leak_bits).
  5. Wygeneruj m podpisów (m=15) dla losowych skrótów wiadomości e_i.
  6. Zbuduj wektory t_i = (pow(s_i, -1, n) * r_i) % n oraz u_i = (pow(s_i, -1, n) * e_i) % n.
  7. Zbuduj macierz kraty B o wymiarach (m+2) x (m+2) według konstrukcji Kannana.
  8. Uzupełnij macierz wartościami n na diagonali, wektorem t_i oraz wagami 2^leak_bits.
  9. Zaimplementuj lub zaimportuj algorytm redukcji kraty LLL (Gram-Schmidt + redukcja rozmiaru).
  10. Wykonaj redukcję LLL na skonstruowanej macierzy bazowej.
  11. Zbadaj wektory zredukowanej bazy i zidentyfikuj kandydata na wektor k_i.
  12. Odzyskaj klucz prywatny d ze współczynników zredukowanego wektora.
  13. Sprawdź czy d_recovered == d.
  14. Zbadaj wpływ liczby zebranych sygnatur m na sukces redukcji kratowej.
  15. Wykonaj zrzuty ekranu prezentujące konstrukcję macierzy i odzyskany klucz.
  16. Opracuj raport laboratoryjny opisujący problem HNP i ataki kanałami bocznymi na ECDSA.

Kontrola zaliczenia (checklist):

  1. Złamano ECDSA przy stronniczym k kratami na wektorze ze startera: z wycieków LSB zbudowano HNP, LLL odzyskała d.
  2. Wykazano różnicę: stronnicze k (pełny wyciek d) vs RFC 6979 (brak wycieku, atak staje); dołączono log redukcji.
  3. Dołączono log ataku (nierówności, baza kraty, wektor LLL) + kod łatki (RFC 6979, stały czas, brak biasu, HSM).
  4. Opisano w 3–5 zdaniach kompromis: kilka bitów wystarcza, side-channel jako źródło, koszt ochrony implementacji.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie problemu ukrytej liczby (Hidden Number Problem) i teorii krat w kryptoanalizie.
  • Opanowanie techniki redukcji LLL do rozwiązywania układów nierówności modularnych z małym szumem.
  • Zrozumienie, że nawet częściowy wyciek kilku bitów nonce k prowadzi do całkowitego złamania klucza prywatnego ECDSA.
  • Świadomość konieczności rygorystycznej ochrony implementacji przed wyciekami czasowymi i kanałami bocznymi (Side-Channel Attacks).
Zadanie 5 - ilustracja
06/10
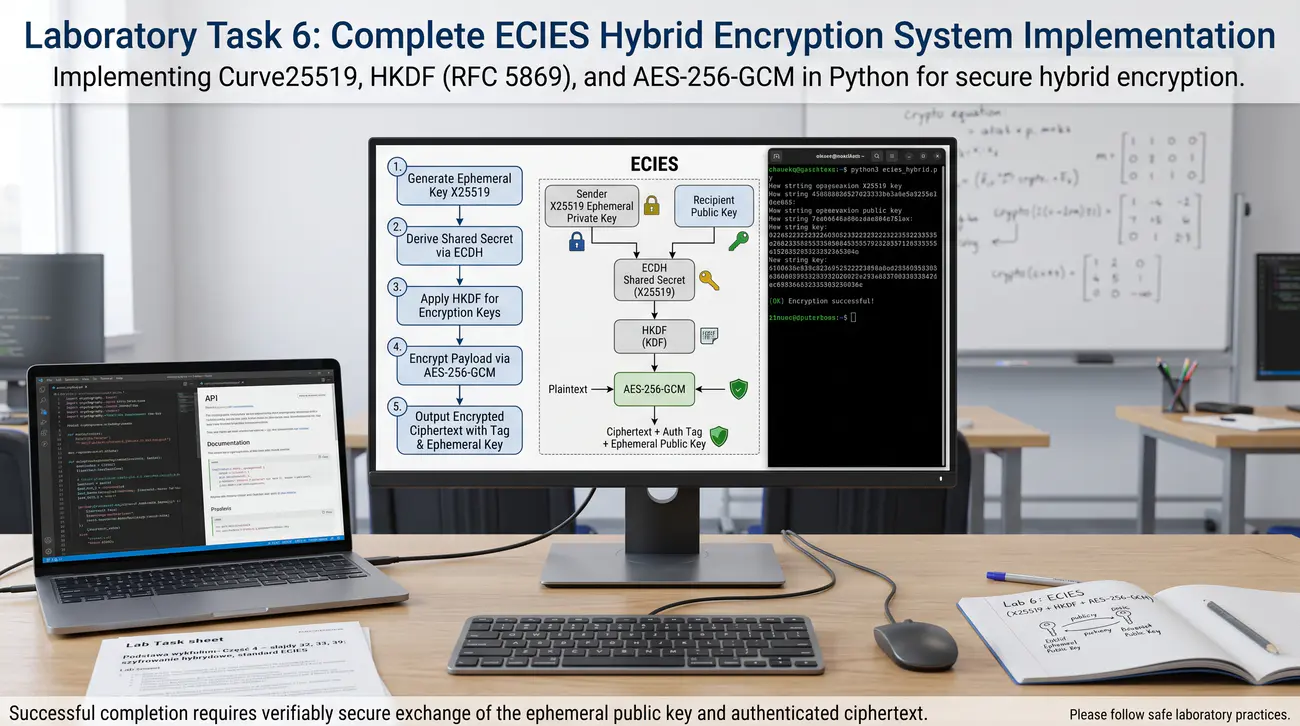
Zadanie 6. Implementacja kompletnego systemu szyfrowania hybrydowego ECIES w Pythonie (Curve25519 + HKDF + AES-256-GCM)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 32, 33, 39: szyfrowanie hybrydowe, standard ECIES (Elliptic Curve Integrated Encryption Scheme), wymiana klucza X25519, funkcja derywacji HKDF (RFC 5869), uwierzytelniony szyfr symetryczny AES-GCM.

Cel

Celem zadania jest samodzielna implementacja produkcyjnego standardu szyfrowania hybrydowego ECIES (Elliptic Curve Integrated Encryption Scheme) w języku Python. Student łączy asymetryczną wymianę klucza na nowoczesnej krzywej Curve25519, zaawansowaną funkcję derywacji klucza HKDF (RFC 5869) oraz symetryczny szyfr uwierzytelniony AES-256-GCM, tworząc bezpieczny kontener kryptograficzny.

Scenariusz – opis

Standard ECIES stanowi wiodący paradygmat asymetrycznego szyfrowania wiadomości o dowolnej długości w oparciu o krzywe eliptyczne. Ponieważ na krzywych eliptycznych nie wykonuje się bezpośredniego szyfrowania danych (w przeciwieństwie do RSA), konieczne jest podejście hybrydowe KEM/DEM. W fazie KEM nadawca generuje jednorazową parę kluczy efemerycznych (r, R = r*G) na krzywej Curve25519. Nadawca wykonuje operację ECDH z kluczem publicznym odbiorcy Q_B, uzyskując wspólny punkt współdzielony S = r * Q_B. Współrzędna punktu S jest przetwarzana przez funkcję HKDF (HMAC-based Extract-and-Expand Key Derivation Function) w celu wyprowadzenia silnego klucza symetrycznego. W fazie DEM dane są szyfrowane za pomocą AES-256-GCM, a odbiorca otrzymuje pakiet złożony z efemerycznego klucza R, wektora IV, szyfrogramu i tagu uwierzytelniającego.

Co ma wykonać student / grupa

W pliku ecies_system.py przygotowujesz kompletną strukturę klas: ECIESEncryptor oraz ECIESDecryptor. X25519/AES-GCM realizujesz biblioteką cryptography (nie piszesz X25519 od zera); własny kod to tylko HKDF i format pakietu plus diagram pól binarnych w raporcie. Wykorzystujesz moduł biblioteki cryptography lub autorską arytmetykę X25519 do generowania kluczy. Generujesz stałą parę kluczy odbiorcy Boba: klucz prywatny sk_bob oraz klucz publiczny pk_bob.

Implementujesz funkcję hkdf_derive(shared_secret, salt, info, length = 32) ściśle według specyfikacji RFC 5869 (etap Extract z HMAC-SHA256 oraz Expand). Implementujesz procedurę ecies_encrypt(pk_recipient, plaintext, associated_data = b''): losujesz klucz efemeryczny ek_priv, wyznaczasz ek_pub = ek_priv * G. Obliczasz sekret ECDH S = ek_priv * pk_recipient i wyprowadzasz 256-bitowy klucz AES za pomocą HKDF z solą losową. Generujesz 12-bajtowy losowy nonce dla AES-GCM i szyfrujesz dane, uzyskując szyfrogram ciphertext oraz 16-bajtowy tag uwierzytelniający tag.

Formujesz binarny pakiet kryptograficzny: MAGIC (4 bajty) || len(R) (2B) || R (32B) || Salt (16B) || IV (12B) || Tag (16B) || Ciphertext. Implementujesz procedurę ecies_decrypt(sk_recipient, encrypted_package, associated_data = b''): parsujesz nagłówek i wyodrębniasz komponenty. Odtwarzasz sekret S = sk_recipient * R, wyprowadzasz identyczny klucz symetryczny funkcją HKDF i deszyfrujesz dane AES-GCM. Testujesz system na wiadomości o rozmiarze 1 MB i potwierdzasz pełną tożsamość odszyfrowanego pliku.

Wykonujesz test naruszenia integralności: modyfikujesz 1 bajt w polu Ciphertext lub Tag i weryfikujesz, że AES-GCM natychmiast zgłasza błąd InvalidTag. Testujesz wymianę z danymi stowarzyszonymi (AAD) zawierającymi identyfikator nadawcy i odbiorcy.

Sporządzasz specyfikację formatu binarnego kontenera ECIES z diagramem rozkładu pól. Kompletujesz pełne sprawozdanie laboratoryjne z realizacji zadania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik ecies_system.py w środowisku Python.
  2. Zaimportuj niezbędne komponenty kryptograficzne (X25519, AES-GCM, HKDF, hashlib, secrets).
  3. Zaimplementuj generator kluczy stałych dla Boba (sk_bob, pk_bob).
  4. Napisz funkcję realizującą algorytm HKDF-Extract oraz HKDF-Expand z RFC 5869.
  5. Zaimplementuj funkcję ecies_encrypt(recipient_pubkey, data, aad).
  6. Wygeneruj parę efemeryczną: ephemeral_private, ephemeral_public.
  7. Wyprowadź wspólny sekret ECDH shared_point.
  8. Wyprowadź klucz aes_key funkcją HKDF z użyciem losowej soli.
  9. Zaszyfruj wiadomość algorytmem AES-256-GCM i uzyskaj ciphertext oraz tag.
  10. Zbuduj ustandaryzowany ciąg bajtów pakietu ECIES.
  11. Zaimplementuj funkcję ecies_decrypt(recipient_privkey, package, aad).
  12. Przetestuj szyfrowanie i deszyfrowanie dużego pliku testowego.
  13. Zweryfikuj integralność: cmp odszyfrowanego tekstu z oryginałem.
  14. Zmodyfikuj 1 bajt tagu i zarejestruj rzucenie wyjątku InvalidTag.
  15. Wykonaj zrzuty ekranu struktury binarnej pakietu oraz testów bezpieczeństwa.
  16. Opracuj raport ze schematem blokowym architektury ECIES.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano ECIES (X25519+HKDF+AES-256-GCM) na wektorze ze startera: pełna paczka binarna, poprawne odpakowanie, odrzut po 1 bicie.
  2. Wykazano różnicę: ECIES-AEAD (manipulacja wykryta tagiem) vs wariant bez MAC (plastyczny, pokazany); dołączono oba logi.
  3. Dołączono log pakietu (ephemeral, salt/info, nonce, tag) + kod łatki (HKDF RFC 5869, świeży ephemeral, AEAD obowiązkowo).
  4. Opisano w 3–5 zdaniach kompromis: koszt ECDH+KDF vs bezpieczeństwo koperty, format binarny, produkcyjna higiena kluczy.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie nowoczesnej architektury szyfrowania hybrydowego ECIES łączącej KEM i DEM.
  • Opanowanie standardu HKDF (RFC 5869) jako bezpiecznego mostu pomiędzy surowym sekretem ECDH a szyfrem symetrycznym.
  • Zrozumienie krytycznej roli szyfrowania uwierzytelnionego AEAD (AES-GCM) w wykrywaniu manipulacji szyfrogramem.
  • Umiejętność projektowania i implementacji bezpiecznych binarnych pakietów kryptograficznych.
Zadanie 6 - ilustracja
07/10
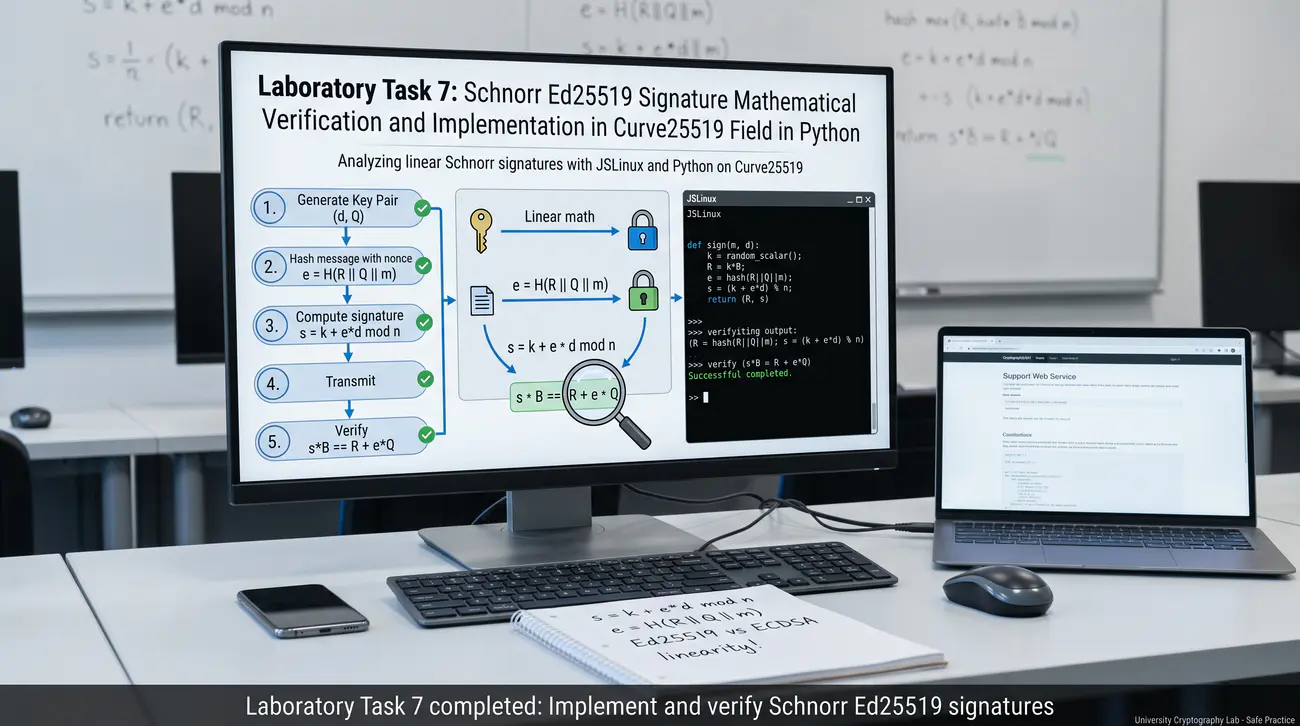
Zadanie 7. Matematyczna weryfikacja i implementacja podpisu Schnorra / Ed25519 w ciele Curve25519 w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 26, 27: podpisy Schnorra, algorytm EdDSA (Ed25519), liniowość sygnatury Schnorra s = k + e*d mod n, wyzwanie e = H(R || Q || m), przewagi nad ECDSA.

Cel

Celem zadania jest praktyczna implementacja i matematyczna weryfikacja algorytmu podpisu Schnorra oraz standardu Ed25519 w języku Python. Student implementuje deterministyczną procedurę wyznaczania nonce k, obliczanie wyzwania Fiat-Shamir e = H(R || Q || m), generowanie podpisu liniowego s = k + e*d mod L oraz weryfikację równości s*G == R + e*Q, badając wyższość architektury Schnorra nad ECDSA.

Scenariusz – opis

Podpis Schnorra opatentowany przez Clausa Schnorra w 1989 roku uchodzi za najbardziej elegancki i czysty matematycznie schemat podpisu cyfrowego. Po wygaśnięciu patentu w 2008 roku stał się on podstawą nowoczesnych standardów kryptograficznych, w tym Ed25519 oraz aktualizacji Taproot w Bitcoinie. W przeciwieństwie do skomplikowanej nieliniowej formuły ECDSA s = k^(-1)*(e + d*r), podpis Schnorra wykorzystuje prostą relację liniową s = k + e * d mod L. Wartość e jest wyzwaniem kryptograficznym (Fiat-Shamir heuristic) wyliczanym jako skrót punktu zaangażowania R, klucza publicznego Q oraz treści wiadomości m. Dzięki liniowości podpis Schnorra umożliwia prostą agregację wielu podpisów (MuSig) oraz odporność na podatności związane z odwracaniem modularnym w s. W wersji EdDSA (Ed25519) wartość k jest wyprowadzana w 100% deterministycznie jako skrót klucza prywatnego i wiadomości, eliminując ryzyko ataku Sony PS3.

Co ma wykonać student / grupa

W pliku schnorr_signature.py implementujesz model podpisu Schnorra na krzywej eliptycznej (secp256k1 lub Curve25519). Konfigurujesz parametry grupy: punkt bazowy G, rząd grupy n oraz generator liczb losowych/funkcję haszującą. Generujesz klucz prywatny nadawcy d oraz obliczasz klucz publiczny Q = d * G. Implementujesz deterministyczne wyznaczanie nonce k = SHA-256(d || msg) mod n zgodnie z paradygmatem EdDSA.

Obliczasz punkt zaangażowania (commitment) R = k * G. Wyliczasz wyzwanie e = SHA-256(R.x || Q.x || msg) mod n za pomocą funkcji skrótu. Obliczasz składową s sygnatury: s = (k + e * d) mod n. Sygnaturą Schnorra jest para (R, s) lub (R.x, s).

Implementujesz procedurę weryfikacji verify_schnorr(msg, R, s, Q): odtwarzasz wyzwanie e = SHA-256(R.x || Q.x || msg) mod n. Obliczasz lewą stronę tożsamości weryfikującej: LHS = s * G. Obliczasz prawą stronę tożsamości weryfikującej: RHS = R + e * Q. Weryfikujesz matematyczną tożsamość: s*G = (k + e*d)*G = k*G + e*(d*G) = R + e*Q.

Sprawdzasz, że LHS == RHS, potwierdzając ważność podpisu bez konieczności odwracania modularnego jak w ECDSA. Implementujesz demonstrację agregacji podpisów: dwóch użytkowników podpisuje tę samą wiadomość, a ich podpisy sumują się do jednego podpisu weryfikowanego sumą kluczy publicznych Q1 + Q2. Dopisz ostrzeżenie rogue-key i sekcję założeń agregacji (ten sam komunikat, uczciwi współsygnatariusze; pełne bezpieczeństwo daje dopiero MuSig) - naiwna agregacja bez współczynników jest podatna. Porównujesz właściwości podpisu Schnorra z ECDSA pod kątem podatności na zniekształcenia nonce oraz kosztu obliczeniowego. Kompletujesz pełne sprawozdanie laboratoryjne z dowodami algebraicznymi.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik schnorr_signature.py w środowisku roboczym.
  2. Zdefiniuj parametry krzywej eliptycznej (krzywa Weierstrassa lub Edwardsa).
  3. Wygeneruj parę kluczy: priv_d oraz pub_Q = priv_d * G.
  4. Zaimplementuj deterministyczne wyznaczanie k: deterministic_k(priv_d, msg).
  5. Zaimplementuj obliczanie punktu zobowiązania R = k * G.
  6. Zaimplementuj wyznaczanie wyzwania e = hash_challenge(R, pub_Q, msg).
  7. Zaimplementuj równanie podpisu Schnorra: s = (k + e * priv_d) % n.
  8. Podpisz testowy dokument 'Protokol zatwierdzenia zmian Schnorr 2026'.
  9. Zaimplementuj procedurę weryfikacji verify_schnorr(msg, R, s, pub_Q).
  10. Oblicz LHS = s * G oraz RHS = point_add(R, e * pub_Q).
  11. Potwierdź równość LHS == RHS (sukces weryfikacji).
  12. Wykonaj test modyfikacji treści wiadomości i zarejestruj odrzucenie podpisu.
  13. Zaimplementuj prostą agregację podpisów dwóch stron (2-of-2 multisig).
  14. Zweryfikuj zagregowany podpis sumarycznym kluczem publicznym Q_agg = Q1 + Q2.
  15. Wykonaj zrzuty ekranu działania skryptu i wypisanych składowych sygnatury.
  16. Opracuj raport zestawiający zalety podpisu Schnorra/Ed25519 z tradycyjnym ECDSA.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano Schnorra/Ed25519 na Curve25519 na wektorze ze startera: e=H(R||Q||m), s=k+e·d, weryfikacja, test agregacji 2 podpisów.
  2. Wykazano różnicę: liniowe s (agregacja działa, rozmiar stały) vs ECDSA (brak agregacji, DER zmienny); dołączono logi.
  3. Dołączono log weryfikacji i agregacji + kod łatki (deterministyczne k, audyt hasha, multisig zamiast wielu podpisów).
  4. Opisano w 3–5 zdaniach kompromis: prostota Fiat-Shamir, multisig Taproot, migracja ECDSA→Schnorr.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznej elegancji podpisu Schnorra opartego na heurystyce Fiata-Szamira.
  • Zrozumienie zalet liniowości s = k + e*d w stosunku do nieliniowej formuły ECDSA.
  • Opanowanie techniki agregacji podpisów i kluczy publicznych (multisignature) bez powiększania rozmiaru sygnatury.
  • Świadomość przyczyn migracji współczesnych protokołów (Ed25519, Taproot) na podpisy typu Schnorra.
Zadanie 7 - ilustracja
08/10
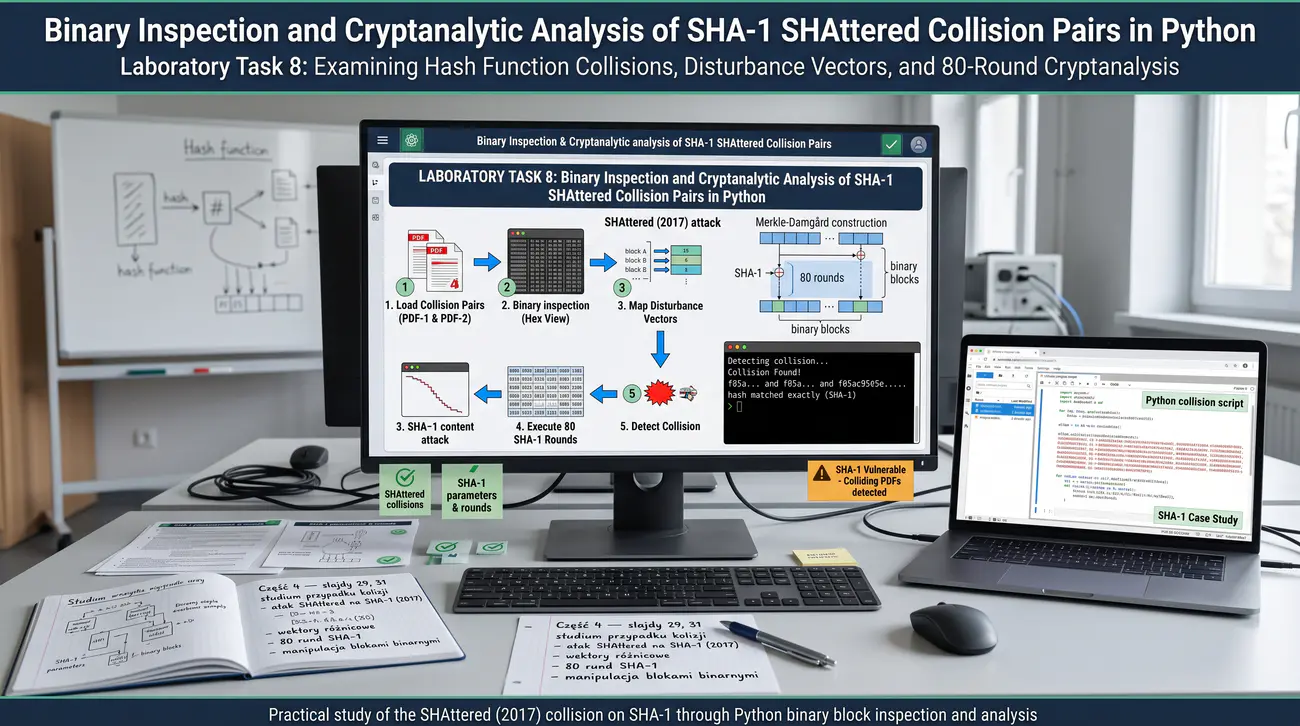
Zadanie 8. Inspekcja binarna i analiza kryptoanalityczna par kolizyjnych SHA-1 (SHAttered) w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 29, 31: studium przypadku kolizji funkcji skrótu, atak SHAttered na SHA-1 (2017), wektory różnicowe (Disturbance Vectors), 80 rund SHA-1, manipulacja blokami binarnymi.

Cel

Celem zadania jest głęboka binarna i programistyczna kryptoanaliza pierwszej praktycznej kolizji funkcji skrótu SHA-1 (atak SHAttered z 2017 roku). Student pisze w Pythonie narzędzie do inspekcji binarnej pary kolizyjnych plików PDF, lokalizuje dwa 64-bajtowe bloki różnicowe (message blocks), analizuje wektory różnicowe oraz śledzi propagację stanów wewnętrznych rejestrów SHA-1 aż do eliminacji różnic po 80 rundach.

Scenariusz – opis

W 2017 roku zespół z CWI i Google dokonał historycznego przełomu kryptoanalitycznego, generując kolizję SHA-1 kosztem 9 trylionów operacji. Atak SHAttered wykorzystał technikę identycznych prefiksów (Identical-Prefix Collision) z dwublokową strategią różnicową. Oznacza to, że pliki posiadają identyczny nagłówek, po którym następują dwa kolejne 64-bajtowe bloki danych o ściśle skalkulowanych różnicach bitowych. Pierwszy blok różnicowy wprowadza kontrolowane zaburzenie do wewnętrznych rejestrów SHA-1 (A, B, C, D, E). Drugi blok różnicowy kompensuje i całkowicie neutralizuje powstałe zaburzenie, doprowadzając rejestry do identycznego stanu końcowego. W rezultacie, pomimo różnic w zawartości obu plików, funkcja skrótu po przetworzeniu 80 rund kompresji generuje dokładnie ten sam 160-bitowy wynik.

Co ma wykonać student / grupa

W pliku shattered_binary_analyzer.py implementujesz kryptoanalityczny skaner binarny dla pary plików kolizyjnych SHAttered. Pobierasz lub wczytujesz binarne reprezentacje plików shattered-1.pdf oraz shattered-2.pdf. Sprawdzasz rozmiar plików i upewniasz się, że są identyczne co do bajta (dokładnie 422 435 bajtów). Obliczasz ich skróty MD5, SHA-1 oraz SHA-256, potwierdzając kolizję wyłącznie dla SHA-1.

Implementujesz procedurę byte_diff_scanner(file1, file2) lokalizującą dokładne offsety bajtowe, na których pliki się różnią. Odnajdujesz dwa odrębne 64-bajtowe bloki różnicowe (odpowiadające blokom kompresji SHA-1 o rozmiarze 512 bitów). Wypisujesz zrzut szesnastkowy (hexdump) obu bloków różnicowych i obliczasz operację XOR pomiędzy nimi. Identyfikujesz wektor różnicowy (disturbance vector) i analizujesz, które bity zostały odwrócone przez badaczy.

W drugiej części skryptu implementujesz uproszczony model 80-rundowej funkcji kompresji SHA-1 z dostępem do stanów pośrednich rejestrów (A, B, C, D, E). Korzystasz z gotowej funkcji sha1_compress(block, h) ze szkieletu (zwraca stany po każdej rundzie) z kryterium stopu delta==0 po bloku 2 - student robi tylko skaner różnic i wykres zbieżności. Wstrzykujesz pierwszy blok różnicowy i rejestrujesz powiększającą się różnicę modularną w rejestrach w rundach 1-40. Wstrzykujesz drugi blok różnicowy i obserwujesz proces konwergencji: różnice w rejestrach ulegają stopniowej redukcji.

Po rundzie 80 stwierdzasz całkowite wyzerowanie różnicy: stany wewnętrzne SHA-1 stają się identyczne. Analizujesz konstrukcję struktury pliku PDF: w jaki sposób różnice w blokach binarnych sterują parserem obiektów PDF, wyświetlając odmienne obrazy. Sporządzasz zestawienie tabelaryczne offsetów, zrzutów XOR oraz stanów rejestrów. Formułujesz wyczerpujące podsumowanie kryptoanalityczne w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik shattered_binary_analyzer.py w środowisku roboczym.
  2. Wczytaj pliki binarne shattered-1.pdf oraz shattered-2.pdf.
  3. Wylicz i wyświetl skróty MD5, SHA-1 oraz SHA-256 obu plików.
  4. Zaimplementuj funkcję scan_differences(bytes1, bytes2) porównującą dane bajt po bajcie.
  5. Zlokalizuj początek pierwszego bloku różnicowego (offset 0x600 / 1536 bajt).
  6. Wyodrębnij 64-bajtowy blok różnicowy 1 z obu plików.
  7. Wyodrębnij 64-bajtowy blok różnicowy 2 z obu plików.
  8. Oblicz i wyświetl zrzut szesnastkowy maski XOR (diff1 ^ diff2) dla obu bloków.
  9. Zlicz liczbę różniących się bitów (wagę Hamminga różnicy).
  10. Zaimplementuj podgląd stanów rejestrów SHA-1 (A, B, C, D, E) w pętli 80 rund.
  11. Śledź różnicę modularną rejestrów delta = (A1 - A2, ..., E1 - E2) po przetworzeniu bloku 1.
  12. Śledź eliminację różnicy delta po przetworzeniu bloku 2.
  13. Potwierdź osiągnięcie stanu delta == (0, 0, 0, 0, 0) po zakończeniu bloku 2.
  14. Zbadaj strukturę obiektów PDF i wyjaśnij jak ukryto dwa różne obrazy w strumieniu JPEG.
  15. Wykonaj zrzuty ekranu hexdumpa bloków różnicowych oraz wykresu zbieżności rejestrów.
  16. Opracuj raport kryptoanalityczny podsumowujący anatomię ataku SHAttered.

Kontrola zaliczenia (checklist):

  1. Przeprowadzono binarną kryptoanalizę SHAttered na plikach ze startera: zlokalizowane 64-B bloki różnicowe, wektory zaburzeń, różne PDF przy tym samym SHA-1.
  2. Wykazano różnicę: SHA-1 (kolizja przechodzi) vs SHA-256 (demaskuje); dołączono offsety, hexdump, sumy.
  3. Dołączono log inspekcji (parser PDF/bin) + kod łatki (zakaz SHA-1 w podpisach/X.509, SHA-256+, weryfikacja łańcucha).
  4. Opisano w 3–5 zdaniach kompromis: 2-blokowa różnicówka, neutralizacja zaburzeń w 80 rundach, koszt format-tricków PDF.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie dwublokowej kryptoanalizy różnicowej na funkcję kompresji SHA-1.
  • Praktyczna umiejętność lokalizacji i analizy wektorów różnicowych (Disturbance Vectors) w plikach binarnych.
  • Zrozumienie procesu wprowadzania i neutralizacji zaburzeń w 80-rundowej pętli kompresji Merkle-Damgårda.
  • Świadomość zaawansowanych technik manipulacji formatami binarnymi (PDF) w celu wizualizacji fałszerstwa.
Zadanie 8 - ilustracja
09/10
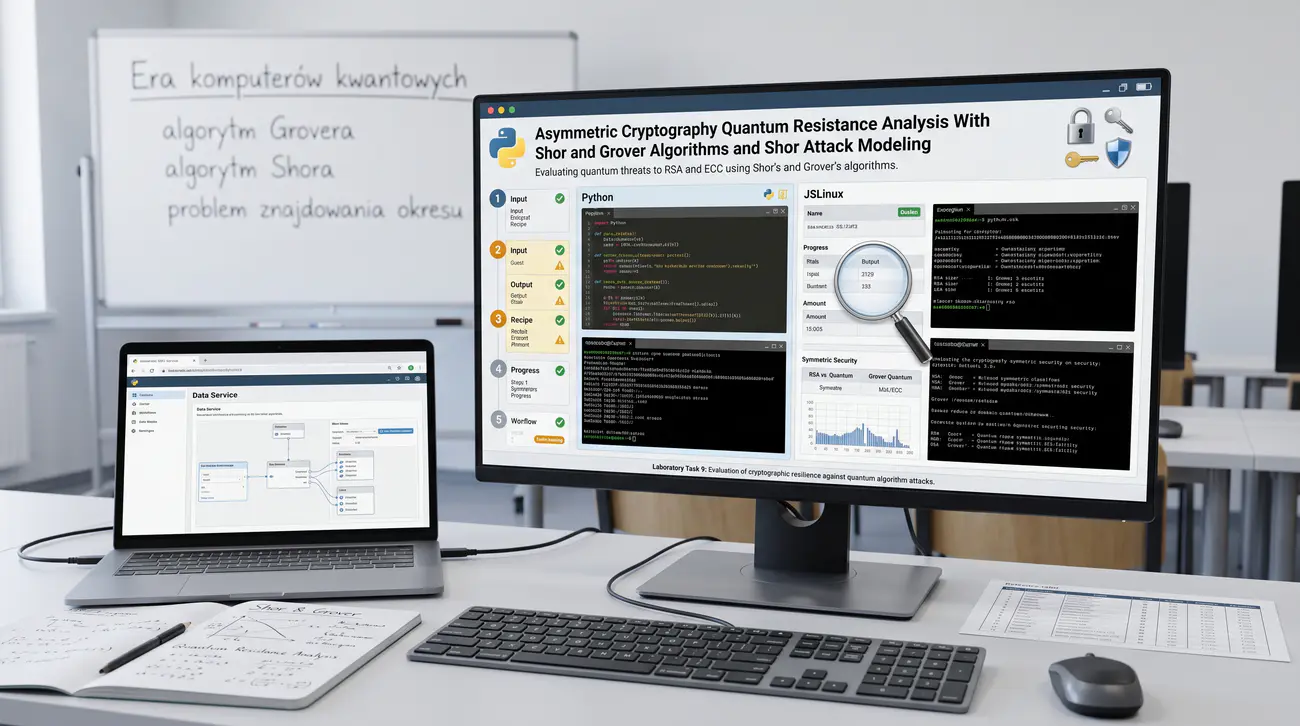
Zadanie 9. Analiza odporności kryptografii asymetrycznej na algorytmy kwantowe (Shor i Grover) oraz modelowanie ataku Shora w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 4 - slajdy 34, 35: era komputerów kwantowych, algorytm Grovera (redukcja bezpieczeństwa symetrycznego o połowę), algorytm Shora (wielomianowe łamanie RSA i ECC), problem znajdowania okresu funkcji (Order Finding).

Cel

Celem zadania jest matematyczna i programistyczna analiza zagrożenia komputerami kwantowymi dla kryptografii klucza publicznego. Student implementuje w Pythonie klasyczną część algorytmu Shora redukującą problem faktoryzacji RSA oraz logarytmu dyskretnego do problemu wyznaczania okresu funkcji r (Order Finding), modeluje kwantową transformację Fouriera (QFT) oraz oblicza zapotrzebowanie na logiczne kubity do złamania RSA-2048 i ECC P-256.

Scenariusz – opis

Pojawienie się skalowalnych komputerów kwantowych stanowi egzystencjalne zagrożenie dla współczesnej kryptografii asymetrycznej. Podczas gdy algorytm Grovera przyspiesza przeszukiwanie przestrzeni kluczy symetrycznych z O(2^n) do O(2^(n/2)), algorytm Shora z 1994 roku całkowicie niszczy RSA i ECC. Algorytm Shora rozwiązuje problem faktoryzacji oraz logarytmu dyskretnego w czasie wielomianowym O((log n)^3). Istotą algorytmu Shora jest redukcja faktoryzacji do problemu znajdowania okresu funkcji modularnej f(x) = a^x mod n. Komputer kwantowy wykorzystuje kwantową transformację Fouriera (QFT) do równoległego wyznaczenia okresu r funkcji f(x). Mając parzysty okres r, klasyczny procesor natychmiast wyznacza czynniki pierwsze n jako NWD(a^(r/2) - 1, n) oraz NWD(a^(r/2) + 1, n).

Co ma wykonać student / grupa

W pliku shor_quantum_model.py tworzysz symulator klasycznej i algebraicznej części algorytmu Shora. Wybierasz dydaktyczny moduł RSA n = 15, 21, 33, 77 lub większy 64-bitowy moduł. Implementujesz algorytm Shora: losujesz liczbę a względnie pierwszą z n (1 < a < n). Sprawdzasz czy NWD(a, n) > 1: jeśli tak, dzielnik został znaleziony trywialnie.

W przeciwnym razie definiujesz funkcję modularną f(x) = pow(a, x, n). Symulujesz procedurę znajdowania okresu r (w komputerze kwantowym realizowaną przez rejestr kubitów i QFT): wyznaczasz najmniejsze dodatnie r takie, że pow(a, r, n) == 1. Zapisujesz uczciwą ramkę: skrypt symuluje klasycznie część, którą kwantowo robi QFT - to nie jest uruchomienie Shora - i wyliczasz wiek wszechświata dla brute-force 256 bitów jako punkt odniesienia. Weryfikujesz warunki sukcesu ataku: r musi być liczbą parzystą oraz pow(a, r // 2, n) != -1 mod n.

Gdy warunki są spełnione, obliczasz dwóch kandydatów na czynniki pierwsze: factor1 = math.gcd(pow(a, r // 2, n) - 1, n) oraz factor2 = math.gcd(pow(a, r // 2, n) + 1, n). Potwierdzasz, że factor1 * factor2 == n, co kończy udaną faktoryzację modułu.

W kolejnym module skryptu implementujesz model aproksymacji fazy za pomocą ułamków łańcuchowych, symulując odczyt pomiaru rejestru QFT. Przeprowadzasz precyzyjne kalkulacje zasobów kwantowych: wyliczasz liczbę logicznych kubitów i bramek kwantowych potrzebnych do złamania RSA-2048 (ok. 4098 kubitów logicznych) oraz ECC P-256 (ok. 2330 kubitów logicznych).

Zauważasz paradoksalny fakt: algorytm ECC o kluczu 256-bitowym wymaga MNIEJ kubitów do złamania niż RSA-2048, co czyni go bardziej podatnym na wczesne komputery kwantowe. Zestawiasz wpływ algorytmu Grovera na AES-128 (redukcja do 64 bitów, konieczność przejścia na AES-256). Dokumentujesz wyniki symulacji faktoryzacji oraz tabelę zasobów kwantowych. Kompletujesz sprawozdanie laboratoryjne z wnioskami dotyczącymi pilności wdrożenia kryptografii postkwantowej.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik shor_quantum_model.py w środowisku Python.
  2. Zaimplementuj funkcję find_period_classical(a, n) symulującą kwantowe poszukiwanie r.
  3. Zaimplementuj pełną procedurę faktoryzacji shor_factor(n).
  4. Wybierz testowy moduł n = 55 (5 * 11) i wylosuj bazę a = 7.
  5. Znajdź okres r dla a=7 i n=55 (potwierdź pow(7, r, 55) == 1).
  6. Sprawdź czy r jest parzyste i oblicz potęgę połówkową x_half = pow(a, r // 2, n).
  7. Wylicz czynniki p = math.gcd(x_half - 1, n) oraz q = math.gcd(x_half + 1, n).
  8. Potwierdź poprawność: p == 5 i q == 11.
  9. Zaimplementuj symulację odczytu fazy QFT z użyciem aproksymacji ułamkami łańcuchowymi.
  10. Napisz funkcję szacującą zasoby kwantowe calculate_quantum_resources(key_type, key_size).
  11. Oblicz wymagane kubity logiczne dla RSA-1024, RSA-2048, RSA-4096.
  12. Oblicz wymagane kubity logiczne dla ECDSA P-256, P-384, P-521.
  13. Zestaw wyniki w sformatowanej tabeli konsolowej.
  14. Wyjaśnij asymetrię podatności ECC vs RSA na algorytm Shora.
  15. Wykonaj zrzuty ekranu działania symulatora oraz tabeli zasobów.
  16. Opracuj raport opisujący konieczność migracji do standardów PQC NIST.

Kontrola zaliczenia (checklist):

  1. Zamierzono atak Shora (część klasyczna) na wektorze ze startera: redukcja faktoryzacji/DLP do okresu, symulacja QFT/estymacji fazy, odzyskany okres dla małych n.
  2. Wykazano różnicę: RSA/ECC/DH (klasycznie twarde, kwantowo łamane okresem) vs AES/SHA (tylko Grover √, podwójny klucz); dołączono tabelę kubitów.
  3. Dołączono log symulacji (okres, konwergenty) + kod łatki (inwentaryzacja asymetryczności, plan migracji PQC, hybrydy).
  4. Opisano w 3–5 zdaniach kompromis: QFT jako detektor okresu, całkowita kompromitacja asymetryczności, zasoby logicznych kubitów.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznej zasady redukcji faktoryzacji do problemu znajdowania okresu funkcji w algorytmie Shora.
  • Zrozumienie roli kwantowej transformacji Fouriera (QFT) w wykrywaniu okresowości.
  • Świadomość, że kryptografia asymetryczna (RSA, ECC, DH) zostaje całkowicie skompromitowana przez komputery kwantowe.
  • Wiedza o zasobach sprzętowych (liczba kubitów logicznych) niezbędnych do przeprowadzenia ataku na systemy produkcyjne.
Zadanie 9 - ilustracja
10/10
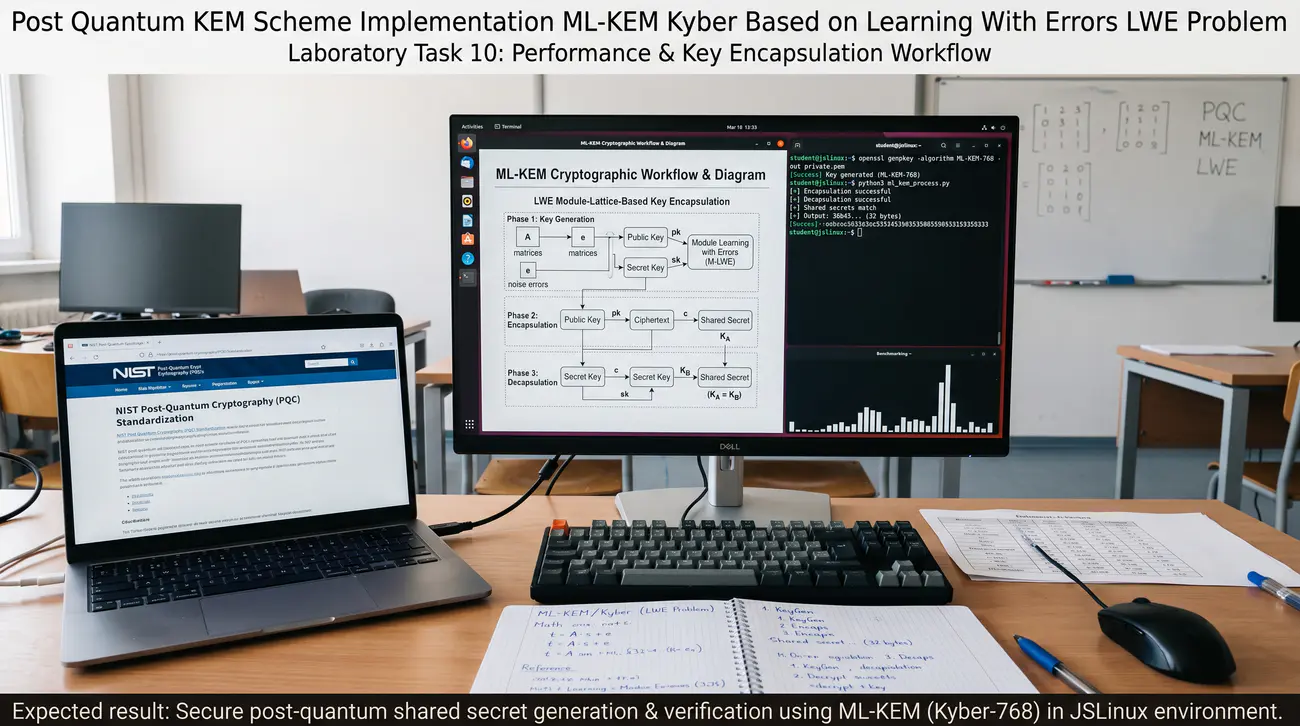
Zadanie 10. Implementacja i analiza schematów postkwantowych KEM (ML-KEM / Kyber) w oparciu o problem Learning With Errors (LWE)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Alpine (Python 3)
Oprogramowanie: przeglądarka + OpenSSL + Python 3
Podstawa wykładowa: Część 4 - slajdy 34, 35, 37: kryptografia postkwantowa (PQC), standaryzacja NIST, kryptografia oparta na kratach (Lattice-based cryptography), problem uczenia się z błędami (Learning With Errors - LWE / Module-LWE), standard ML-KEM (CRYSTALS-Kyber).

Cel

Celem zadania jest praktyczna implementacja i analiza algebraiczna mechanizmu kapsułkowania klucza postkwantowego (PQC KEM) opartego na problemie Learning With Errors (LWE) w języku Python. Student modeluje arytmetykę pierścieni wielomianów, implementuje mechanizm wprowadzania i usuwania szumu gaussowskiego (error rounding), bada konstrukcję kapsułkowania klucza oraz testuje hybrydowy mechanizm wymiany kluczy (X25519 + Post-Quantum) w bibliotece OpenSSL 3.x.

Scenariusz – opis

W sierpniu 2024 roku NIST opublikował oficjalne standardy kryptografii postkwantowej, w tym FIPS 203 definiujący ML-KEM (oparty na algorytmie CRYSTALS-Kyber). ML-KEM opiera się na twardości problemu Learning With Errors w modułach krat (Module Learning With Errors - M-LWE). W odróżnieniu od RSA i ECC opartych na teorii liczb, kryptografia kratowa wykorzystuje geometrię wielowymiarowych struktur dyskretnych. W uproszczonym modelu LWE publiczna macierz A jest mnożona przez tajny wektor s, a do wyniku dodaje się mały wektor szumu e: b = A*s + e mod q. Znalezienie s na podstawie (A, b) bez znajomości szumu e jest obliczeniowo niewykonalne zarówno dla komputerów klasycznych, jak i kwantowych. Kapsułkowanie klucza polega na przesłaniu zaszyfrowanego komunikatu z kolejną porcją szumu, który odbiorca usuwa dzięki znajomości tajnego wektora s.

Co ma wykonać student / grupa

W pliku pqc_lwe_kem.py tworzysz dydaktyczną, w pełni funkcjonalną implementację mechanizmu kapsułkowania klucza opartego na LWE/Ring-LWE. Definiujesz parametry pierścienia: moduł q = 3329 (zgodny ze standardem Kyber), stopień wielomianu n = 256 oraz rozkład szumu binarnego/dwumianowego. Zamrażasz parametry labu (q=3329, n = 64, eta = 2); parametry NIST FIPS 203 (ML-KEM-512/768/1024) trzymasz w osobnej tabeli bez mieszania z n = 64. Implementujesz procedurę mnożenia wielomianów w pierścieniu R_q = Z_q[X] / (X^n + 1) lub uproszczoną algebrę wektorową LWE modulo q.

Implementujesz funkcję próbkowania małego szumu sample_noise() losującą współczynniki z dyskretnego rozkładu Gaussa lub rozkładu dwumianowego z małą wariancją. Faza generowania kluczy (KeyGen): generujesz losową macierz publiczną A, tajny wektor s oraz mały wektor szumu e. Obliczasz publiczny komponent b = (A * s + e) mod q. Kluczem publicznym jest para (A, b), a kluczem prywatnym jest s.

Faza kapsułkowania (Encaps): nadawca wybiera 1-bitowy lub N-bitowy sekret m, losuje efemeryczny wektor r oraz szumy e1 i e2. Oblicza wektory u = (A^T * r + e1) mod q oraz v = (b^T * r + e2 + round(q/2) * m) mod q. Kapsułą przesyłaną do odbiorcy jest para c = (u, v). Faza dekapsułkowania (Decaps): odbiorca oblicza różnicę d = (v - s^T * u) mod q.

Wykazujesz algebraicznie, że d = round(q/2)*m + szum_wypadkowy, gdzie szum_wypadkowy jest pomijalnie mały w stosunku do q/2. Stosujesz funkcję zaokrąglania (rounding decoder) i odzyskujesz pierwotny bitowy sekret m bezbłędnie. Weryfikujesz odporność: zwiększasz sztucznie wariancję szumu e i rejestrujesz błąd dekodowania (Decryption Failure). W terminalu JSLinux lub lokalnym OpenSSL 3.x badasz obsługę nowoczesnych grup hybrydowych (np. X25519MLKEM768 w OpenSSL/TLS 1.3).

Sporządzasz tabelę porównawczą rozmiarów kluczy i szyfrogramów RSA-2048, ECC P-256 oraz ML-KEM-512/768/1024. Kompletujesz pełne sprawozdanie laboratoryjne z realizacji zadania.

Przykładowe kroki do wykonania jako sugestia

  1. Utwórz plik pqc_lwe_kem.py w środowisku roboczym.
  2. Zdefiniuj parametry modularne LWE: n=64 (wymiar), q=3329 (zamrożone dla labu; nie mieszaj z n=256 Kybera).
  3. Zaimplementuj generator szumu gaussowskiego/dwumianowego centered_binomial(eta=2).
  4. Zaimplementuj operacje algebry liniowej modulo q (mnożenie macierzy przez wektor).
  5. Zaimplementuj procedurę keygen(): wygeneruj A, tajne s, szum e i wylicz b = (A*s + e) % q.
  6. Zaimplementuj procedurę encaps(A, b): wylosuj r, e1, e2 oraz zdefiniuj sekret m in {0, 1}.
  7. Zakoduj sekret m: dodaj round(q / 2) * m do v.
  8. Wygeneruj szyfrogram kapsuły c = (u, v).
  9. Zaimplementuj procedurę decaps(s, u, v): oblicz d = (v - dot_product(s, u)) % q.
  10. Zaimplementuj dekoder progowy: jeśli d jest bliższe q/2 niż 0, zwróć 1, w przeciwnym razie 0.
  11. Przeprowadź 100 prób kapsułkowania i dekapsułkowania losowych bitów, weryfikując brak błędów.
  12. Zmierz failure rate vs eta (test 100 enkapsulacji) i zestaw z osobną tabelą parametrów NIST FIPS 203.
  13. Zwiększ parametr eta szumu i zbadaj częstotliwość występowania błędów dekodowania.
  14. Rozszerz model na wektor 256 bitów (przesyłanie pełnego 256-bitowego klucza symetrycznego).
  15. W OpenSSL 3.2+ lub JSLinux sprawdź dostępne algorytmy PQC poleceniem openssl list -kem-algorithms.
  16. Wykonaj zrzuty ekranu działania skryptu LWE oraz zestawienia parametrów NIST FIPS 203.
  17. Opracuj raport podsumowujący architekturę kryptografii kratowej i standardu ML-KEM.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano ML-KEM/Kyber-toy na wektorze ze startera: pierścień wielomianów, szum LWE, enkapsulacja/dekapsulacja OK, pomiar failure rate.
  2. Wykazano różnicę: ML-KEM (odporny kwantowo, duże klucze/ciphertexty) vs X25519 (małe, lecz SNDL); dołączono tabelę rozmiarów i czasów.
  3. Dołączono log KEM (szum, kompresja) + kod łatki (hybryda X25519+ML-KEM-768, FIPS 203, fragmentacja MTU ogarnięta).
  4. Opisano w 3–5 zdaniach kompromis: szum jako bezpieczeństwo, decryption failure, klucze ×30 większe niż ECC.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 bez sieci; dołącz kod ataku, log odzyskanego klucza/tekstu oraz opis kompromisu bezpieczeństwo–wydajność i wytyczne doboru parametrów.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Głębokie zrozumienie problemu Learning With Errors (LWE) jako fundamentu kryptografii postkwantowej.
  • Opanowanie mechanizmu dodawania i eliminacji szumu modularnego w procedurze KEM.
  • Zrozumienie zjawiska błędu deszyfrowania (Decryption Failure Probability) w kryptografii kratowej.
  • Świadomość kompromisów architektonicznych standardu NIST ML-KEM (znacznie większe klucze i szyfrogramy niż w ECC, ale odporność na atak kwantowy).
Zadanie 10 - ilustracja
Podgląd