Laboratorium 6
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 3.0

Poziom: ocena 3.0 - podstawy systemów składowania, macierzy RAID i ochrony magazynów

Zestaw 10 praktycznych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 6 (sieciowe systemy składowania danych: SAN, NAS i macierze RAID).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 3.0 skupiają się na praktycznym zrozumieniu mechanizmów przechowywania i ochrony danych w spoczynku: budowy programowych macierzy RAID 1 narzędziem mdadm, analizy kompromisów pojemności i wydajności poziomów RAID 0, 1, 5, 6 i 10, diagnostyki stanu nośników SMART programem smartctl, szyfrowania wolumenów blokowych dm-crypt / LUKS, konfiguracji blokowego magazynu iSCSI z uwierzytelnianiem CHAP, badania spójności metadanych i kroniki w systemach ext4/ext2, projektowania strefowania (Zoning) i maskowania LUN w sieciach SAN, wdrażania reguły kopii zapasowych 3-2-1 z rsync i sumami SHA-256, bezpiecznego niszczenia danych zgodnie z NIST SP 800-88 oraz konfiguracji udziału NAS Samba z szyfrowaniem SMB3.
  • Wszystkie zadania są w pełni wykonalne bez praw administratora na systemie Windows - wymagają wyłącznie nowoczesnej przeglądarki internetowej i darmowych narzędzi online (kalkulatory RAID, CyberChef) oraz konsoli linuksowej z pakietami narzędziowymi w emulatorze JSLinux Fedora 33 (Linux) Console. W tym laboratorium stosujemy wersję systemu „Fedora 33 (Linux) Console” ze strony https://bellard.org/jslinux/ (start: vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256, CPU riscv64, 256 MB RAM, Console — nie X Window). Nie stosujemy tu Alpine Linux: minimalny Alpine w JSLinux nie zawiera pakietu mdadm ani pełnych narzędzi RAID/SMART/iSCSI i zadania 1, 3–6, 9–10 nie dają się w nim wykonać. Fedora 33 udostępnia je przez menedżer dnf (mdadm, smartmontools, cryptsetup, e2fsprogs, iscsi-initiator-utils, rsync, samba). Uwaga: Fedora riscv64 bootuje wyraźnie dłużej niż Alpine — po starcie poczekaj na login, zaloguj się jako root i sprawdź wersję (cat /etc/fedora-release; uname -a).
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (3.0).
    • Opis konfiguracji środowiska badawczego, adresów serwisów WWW oraz wykorzystanych poleceń.
    • Szczegółowy opis wykonanych czynności, uzasadnienie wyboru narzędzi, zrzuty ekranu oraz wklejone fragmenty danych wejściowych i wyjściowych dokumentujące rzetelne wykonanie pracy.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami) oraz wykaz źródeł literaturowych i internetowych.
Kryptologia
lab 6 - 3.0
Spis
Spis zadań laboratoryjnych na ocenę 3.0
01/10
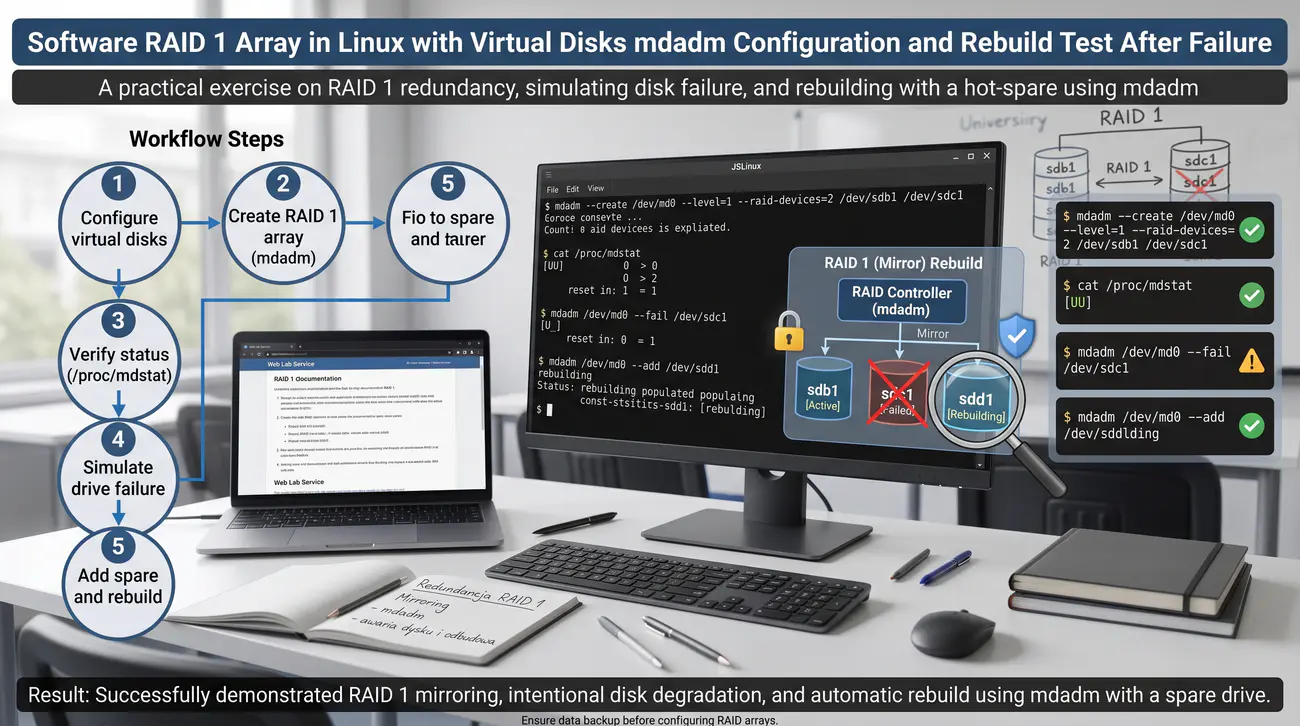
Zadanie 1. Programowa macierz RAID 1 w systemie Linux: tworzenie wirtualnych dysków, konfiguracja narzędziem mdadm i test odbudowy po awarii
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 12, 13, 15, 22, 23: pojęcie redundancji RAID, technika mirroringu, macierz RAID 1, kontroler programowy mdadm, degradacja macierzy i odbudowa z dysku zapasowego hot spare.

Cel

Celem zadania jest praktyczne opanowanie konfiguracji programowej macierzy RAID 1 (lustro dyskowe) w środowisku linuksowym za pomocą narzędzia mdadm. Student tworzy wirtualne urządzenia blokowe na bazie plików obrazów, buduje macierz nadmiarową, zakłada system plików, symuluje awarię jednego z napędów, a następnie przeprowadza procedurę wymiany uszkodzonego dysku i monitoruje proces automatycznej odbudowy (rebuild).

Scenariusz – opis

Macierz RAID 1 polega na jednoczesnym zapisywaniu identycznych danych na co najmniej dwóch niezależnych nośnikach fizycznych. W architekturze tej kluczową cechą jest pełna redundancja informacji kosztem utraty połowy sumarycznej pojemności zainstalowanych dysków. W przypadku fizycznego uszkodzenia jednego z napędów macierz przechodzi w stan zdegradowany, lecz system operacyjny zachowuje pełną ciągłość pracy.

W środowisku serwerowym Linux do zarządzania programowymi macierzami wielodyskowymi powszechnie wykorzystuje się moduł jądra Multiple Device oraz narzędzie mdadm. Narzędzie to pozwala na dynamiczne tworzenie wolumenów RAID, monitorowanie ich stanu w czasie rzeczywistym oraz wymianę uszkodzonych dysków bez zatrzymywania systemu. W warunkach sali laboratoryjnej brak fizycznych dysków twardych zastępuje się urządzeniami pętli zwrotnej loop powiązanymi z plikami obrazów surowych.

Zastosowanie urządzeń loopdev umożliwia bezpieczne odwzorowanie rzeczywistych operacji kontrolera macierzy dyskowej w pamięci masowej lub wirtualnym systemie plików. Podczas pracy administrator musi stale kontrolować plik konfiguracyjny mdadm.conf oraz wirtualny system plików /proc/mdstat raportujący postęp operacji. Bardzo ważnym elementem strategii wysokiej dostępności jest obecność dysku zapasowego hot spare, który automatycznie przejmuje zadania zepsutego napędu. Zrozumienie zachowania macierzy w momencie degradacji i resynchronizacji pozwala uniknąć przestojów krytycznych usług w infrastrukturze przedsiębiorstwa.

W tym ćwiczeniu wykonasz pełną ścieżkę wdrożenia wolumenu lustrzanego, celowo wywołasz awarię i samodzielnie doprowadzisz macierz do pełnej spójności.

Co ma wykonać student / grupa

Pracę rozpoczynasz od otwarcia terminala w emulatorze JSLinux Fedora 33 (Linux) Console i utworzenia katalogu roboczego dla wirtualnych dysków macierzy. Za pomocą polecenia dd tworzysz trzy pliki binarne o stałym rozmiarze 100 megabajtów każdy, które posłużą jako wirtualne dyski twarde. Wykorzystujesz narzędzie losetup, aby skojarzyć przygotowane pliki z kolejnymi urządzeniami pętli zwrotnej loop0, loop1 oraz loop2. Weryfikujesz poprawne podłączenie wirtualnych urządzeń blokowych za pomocą polecenia lsblk lub losetup -a.

Przy użyciu programu mdadm tworzysz nową dwudyskową macierz RAID 1 oznaczoną jako md0 z jednym dodatkowym dyskiem w roli hot spare. Inspekcjonujesz stan tworzonej macierzy poprzez odczyt zawartości /proc/mdstat oraz polecenie mdadm --detail dla urządzenia md0. Zakładasz system plików ext4 na wirtualnym wolumenie md0, montujesz go w dedykowanym punkcie montowania i zapisujesz plik testowy z sumą kontrolną sha256sum. Symulujesz awarię pierwszego dysku poprzez programowe oznaczenie go jako uszkodzony za pomocą przełącznika --fail w narzędziu mdadm.

Obserwujesz natychmiastowe zachowanie jądra systemu, które automatycznie inicjuje proces odbudowy macierzy na przygotowanym dysku zapasowym. Po zakończeniu resynchronizacji usuwasz uszkodzony dysk z macierzy za pomocą flagi --remove i weryfikujesz integralność wcześniej zapisanego pliku testowego. Na koniec dodajesz nowy, sprawny wirtualny dysk do macierzy w celu odtworzenia puli zapasowej i zapisujesz kompletną konfigurację do pliku mdadm.conf.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom w przeglądarce terminal JSLinux Fedora 33 (Linux) Console (bellard.org/jslinux/vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256). Poczekaj na pełny boot (riscv64 bootuje dłużej), zaloguj się jako root. Sprawdź narzędzie mdadm (w Alpine go brak — dlatego tu Fedora): mdadm --version || dnf install -y mdadm.
  2. Utwórz katalog roboczy i przejdź do niego: mkdir -p ~/raid_lab && cd ~/raid_lab.
  3. Utwórz trzy pliki obrazów dysków po 100 MB: for i in 1 2 3; do dd if=/dev/zero of= disk$i.img bs=1M count=100; done.
  4. Skojarz pliki z urządzeniami loop: losetup /dev/loop0 disk1.img && losetup /dev/loop1 disk2.img && losetup /dev/loop2 disk3.img.
  5. Sprawdź listę aktywnych urządzeń loop w systemie za pomocą polecenia: losetup -a.
  6. Utwórz macierz RAID 1 z dyskiem hot spare: mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/loop0 /dev/loop1 --spare-devices=1 /dev/loop2.
  7. Sprawdź natychmiastowy stan macierzy w systemie: cat /proc/mdstat.
  8. Wyświetl szczegółowe informacje o stanie macierzy: mdadm --detail /dev/md0.
  9. Utwórz system plików ext4 na urządzeniu macierzy: mkfs.ext4 /dev/md0.
  10. Utwórz katalog montowania i zamontuj macierz: mkdir -p /mnt/raid && mount /dev/md0 /mnt/raid.
  11. Utwórz plik testowy z danymi i wygeneruj sumę kontrolną: echo 'Dane krytyczne uczelni' > /mnt/raid/dane.txt && sha256sum /mnt/raid/dane.txt > /mnt/raid/dane.txt.sha256.
  12. Zasymuluj awarię pierwszego dysku macierzy: mdadm --manage /dev/md0 --fail /dev/loop0.
  13. Sprawdź w czasie rzeczywistym automatyczny start odbudowy (rebuild) na dysku /dev/loop2: cat /proc/mdstat.
  14. Po zakończeniu odbudowy zweryfikuj stan macierzy: mdadm --detail /dev/md0 (status clean/active).
  15. Sprawdź integralność danych po awarii za pomocą sumy kontrolnej: sha256sum -c /mnt/raid/dane.txt.sha256.
  16. Usuń trwale uszkodzony dysk z macierzy: mdadm --manage /dev/md0 --remove /dev/loop0.
  17. Wygeneruj plik konfiguracyjny macierzy: mdadm --detail --scan > /etc/mdadm.conf.
  18. Wykonaj zrzuty ekranu prezentujące stan macierzy przed awarią, w trakcie rebuild oraz po dołączeniu nowego nośnika.

Kontrola zaliczenia (checklist):

  1. Zbudowano macierz RAID 1 i zachowano log: mdadm --create z 2 dyskami loop + hot spare, system plików, zapis pliku, symulowana awaria (fail/remove) i rebuild z monitorowaniem.
  2. Dołączono 2–3 zrzuty z podpisami: mdadm --detail, /proc/mdstat podczas degradacji i odbudowy oraz odczyt pliku po awarii.
  3. Opisano w 2–3 zdaniach wybór narzędzi (mdadm, loop) i rolę hot spare w automatycznej resynchronizacji.
  4. Zapisano wnioski (3–5 zdań): mirroring 50% pojemności, dostęp bezprzerwowy, SHA-256 pliku przed/po jako dowód integralności.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie zasady działania mirroringu w RAID 1 oraz kompromisu 50% efektywnej pojemności na rzecz niezawodności.
  • Praktyczna umiejętność konfiguracji programowej macierzy za pomocą narzędzia mdadm i wirtualnych dysków loop.
  • Znajomość roli dysku zapasowego hot spare w automatyzacji procesu resynchronizacji danych bez udziału operatora.
  • Weryfikacja integralności danych za pomocą sum SHA-256 potwierdzająca bezprzerwowy dostęp do plików podczas degradacji macierzy.
Zadanie 1 - ilustracja
02/10
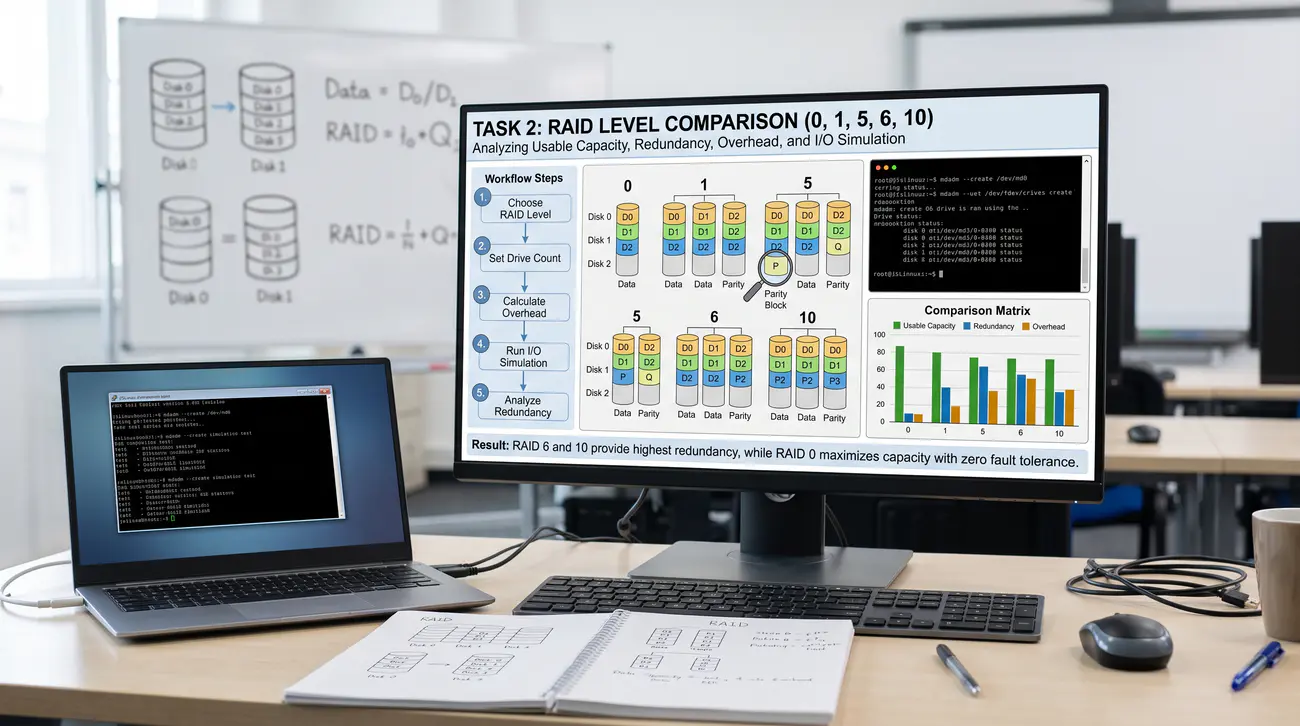
Zadanie 2. Porównanie poziomów RAID (RAID 0, 1, 5, 6, 10): obliczanie pojemności użytkowej, narzutu redundancji i symulacja wydajności I/O
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 13, 14, 15, 16, 17, 18, 20, 21: podstawowe techniki paskowania, lustrowania i parzystości, poziomy RAID 0, 1, 5, 6, 10, kompromisy pojemności i wydajności, dobór poziomu do zastosowań.

Cel

Celem ćwiczenia jest empiryczna i analityczna analiza kompromisów architektonicznych w macierzach RAID. Student bada relację pomiędzy liczbą dysków, pojemnością surową a przestrzenią użyteczną dla poziomów RAID 0, RAID 1, RAID 5, RAID 6 oraz RAID 10, weryfikuje odporność na awarie pojedynczych i podwójnych dysków, a także mierzy przepustowość zapisu i odczytu sekwencyjnego w środowisku laboratoryjnym.

Scenariusz – opis

Dobór odpowiedniego poziomu macierzy RAID jest jedną z najważniejszych decyzji projektowych podczas budowy pamięci masowej w przedsiębiorstwie. Każdy z poziomów RAID implementuje odmienną kombinację trzech elementarnych technik: paskowania danych, lustrzanego powielania oraz obliczania parzystości. Paskowanie w RAID 0 zapewnia maksymalną wydajność i stuprocentowe wykorzystanie pojemności, lecz nie oferuje żadnej odporności na awarie sprzętowe. Z kolei RAID 1 podwaja koszty przechowywania danych na gigabajt, gwarantując jednak prostą i szybką odbudowę po uszkodzeniu nośnika.

Poziomy z rozproszoną parzystością, takie jak RAID 5 oraz RAID 6, stanowią kompromis inżynierski dedykowany do magazynowania dużych wolumenów danych. RAID 5 poświęca pojemność dokładnie jednego dysku na bloki parzystości wyliczane operacją XOR i toleruje awarię tylko jednego nośnika. RAID 6 dodaje drugi niezależny blok parzystości oparty na kodach Reeda-Solomona, co pozwala przetrwać jednoczesną utratę dwóch dysków fizycznych. Kaskadowy poziom RAID 10 łączy zalety wysokiej wydajności paskowania ze zwiększoną odpornością lustrowania, wymagając minimum czterech dysków.

W praktyce inżynier musi uwzględnić narzut obliczeniowy związany z aktualizacją parzystości podczas małych losowych operacji zapisu (tzw. RAID write penalty). Niewłaściwa kalkulacja pojemności lub błędna ocena ryzyka utraty danych podczas wielogodzinnej odbudowy może doprowadzić do katastrofy organizacyjnej. Dodatkowo należy uwzględnić koszty zakupu nośników oraz ograniczenia fizyczne kontrolerów sprzętowych.

W tym zadaniu przeanalizujesz teoretyczne i praktyczne parametry macierzy przy użyciu kalkulatorów online oraz własnych pomiarów w konsoli linuksowej.

Co ma wykonać student / grupa

Rozpoczynasz ćwiczenie od zebrania założeń projektowych dla hipotetycznego klastra pamięci masowej wyposażonego w 8 dysków twardych o pojemności 4 TB każdy. Otwierasz w przeglądarce internetowej darmowy kalkulator macierzy RAID (np. wintelguy.com/raidcalc.pl lub kalkulator RAID firmy Synology). Dla konfiguracji ośmiu dysków obliczasz kolejno pojemność użytkową, pojemność utraconą na ochronę oraz wskaźnik efektywności dla RAID 0, 1, 5, 6 i 10. Zestawiasz uzyskane wyniki w szczegółowej tabeli porównawczej, uwzględniając maksymalną dopuszczalną liczbę równoczesnych awarii dysków w każdym wariancie.

W terminalu JSLinux Fedora 33 (Linux) Console przygotowujesz środowisko testowe do empirycznego badania wydajności zapisu sekwencyjnego za pomocą programu dd. Tworzysz w pamięci RAM wirtualne urządzenie ramdysku tmpfs, aby wyeliminować wpływ fizycznego nośnika stacji roboczej na wynik pomiaru. Przeprowadzasz serię testów zapisu próbki danych o rozmiarze 64 megabajtów przy różnych wielkościach bloków (4 KB, 64 KB, 1 MB). Rejestrujesz uzyskane czasy trwania operacji oraz raportowaną przepustowość transferu w megabajtach na sekundę dla każdej próby.

Analizujesz wpływ wielkości bloku (stripe size) na szybkość zapisu danych, odnosząc obserwacje do mechanizmu paskowania w macierzach RAID. Dokonujesz krytycznej analizy zjawiska kary zapisu dla poziomów z parzystością, wyjaśniając konieczność wykonania czterech operacji wejścia-wyjścia w RAID 5. Porównujesz uzyskane charakterystyki przepustowości z parametrami deklarowanymi w dokumentacjach technicznych macierzy enterprise. Formułujesz rekomendację techniczną wyboru poziomu RAID dla dwóch scenariuszy biznesowych: transakcyjnej bazy danych oraz serwera archiwizacji wideo.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz stronę kalkulatora RAID (np. https://www.wintelguy.com/raidcalc.pl lub kalkulator RAID Synology w przeglądarce).
  2. Zdefiniuj parametry macierzy: liczba dysków n = 8, pojemność pojedynczego dysku = 4 TB (SATA Enterprise).
  3. Oblicz pojemność użyteczną i narzut redundancji dla wariantu RAID 0 (8 dysków).
  4. Oblicz parametry dla wariantu RAID 1/10 (grupy lustrzane, 4 pary dysków).
  5. Oblicz parametry dla wariantu RAID 5 (7 dysków danych + 1 dysk parzystości równoważnej).
  6. Oblicz parametry dla wariantu RAID 6 (6 dysków danych + 2 dyski podwójnej parzystości P+Q).
  7. Sporządź tabelę porównawczą zawierającą: poziom RAID, pojemność netto (TB), procent wykorzystania, odporność na awarie (liczba dysków).
  8. Otwórz terminal JSLinux Fedora 33 (Linux) Console (bellard.org/jslinux/vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256).
  9. Utwórz katalog w pamięci ramdyskowej tmpfs: mkdir -p /tmp/benchmark.
  10. Wykonaj pomiar zapisu sekwencyjnego małym blokiem (4 KB): dd if=/dev/zero of=/tmp/benchmark/test_4k.dat bs=4k count=16384 conv= fdatasync.
  11. Zanotuj czas operacji oraz przepustowość (MB/s) zaraportowaną przez dd.
  12. Wykonaj pomiar zapisu średnim blokiem odpowiadającym typowemu paskowi RAID (64 KB): dd if=/dev/zero of=/tmp/benchmark/test_64k.dat bs=64k count=1024 conv= fdatasync.
  13. Zanotuj uzyskaną przepustowość i porównaj ją z wynikiem dla bloku 4 KB.
  14. Wykonaj pomiar zapisu dużym blokiem (1 MB): dd if=/dev/zero of=/tmp/benchmark/test_1m.dat bs=1M count=64 conv= fdatasync.
  15. Porównaj uzyskane prędkości transferu i wyjaśnij przyczyny wzrostu wydajności wraz z rozmiarem bloku I/O.
  16. Usuń pliki testowe z ramdysku: rm -f /tmp/benchmark/*.dat.
  17. Wykonaj zrzut ekranu kalkulatora RAID oraz wyników pomiarów programu dd w konsoli.
  18. Opracuj pisemną rekomendację doboru poziomu RAID dla serwera bazodanowego OLTP oraz serwera backupu.

Kontrola zaliczenia (checklist):

  1. Zachowano tabelę: dla tej samej puli dysków wyliczona pojemność użyteczna i narzut dla RAID 0/1/5/6/10 + log symulacji awarii 1 i 2 dysków.
  2. Dołączono 2–3 zrzuty z podpisami: obliczenia/kalkulator, symulator I/O oraz wskazanie write penalty w RAID 5/6.
  3. Opisano w 2–3 zdaniach wybór narzędzi i dobór stripe unit do profilu (losowe vs sekwencyjne).
  4. Zapisano wnioski (3–5 zdań): RAID 6 vs 5 przy dyskach >4 TB (URE), RAID 10 jako wydajność+mirror, pojemność vs odporność.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznych zależności pomiędzy liczbą nośników a efektywną przestrzenią w poziomach RAID 0, 1, 5, 6 i 10.
  • Identyfikacja zjawiska kary zapisu (write penalty) w macierzach parzystościowych obniżającego wydajność małych losowych I/O.
  • Świadomość przewagi RAID 6 nad RAID 5 w dobie dysków o pojemnościach przekraczających 4 TB z uwagi na ryzyko błędów URE.
  • Umiejętność doboru optymalnej geometrii paska (stripe unit size) pod kątem profilu obciążenia aplikacji serwerowych.
Zadanie 2 - ilustracja
03/10
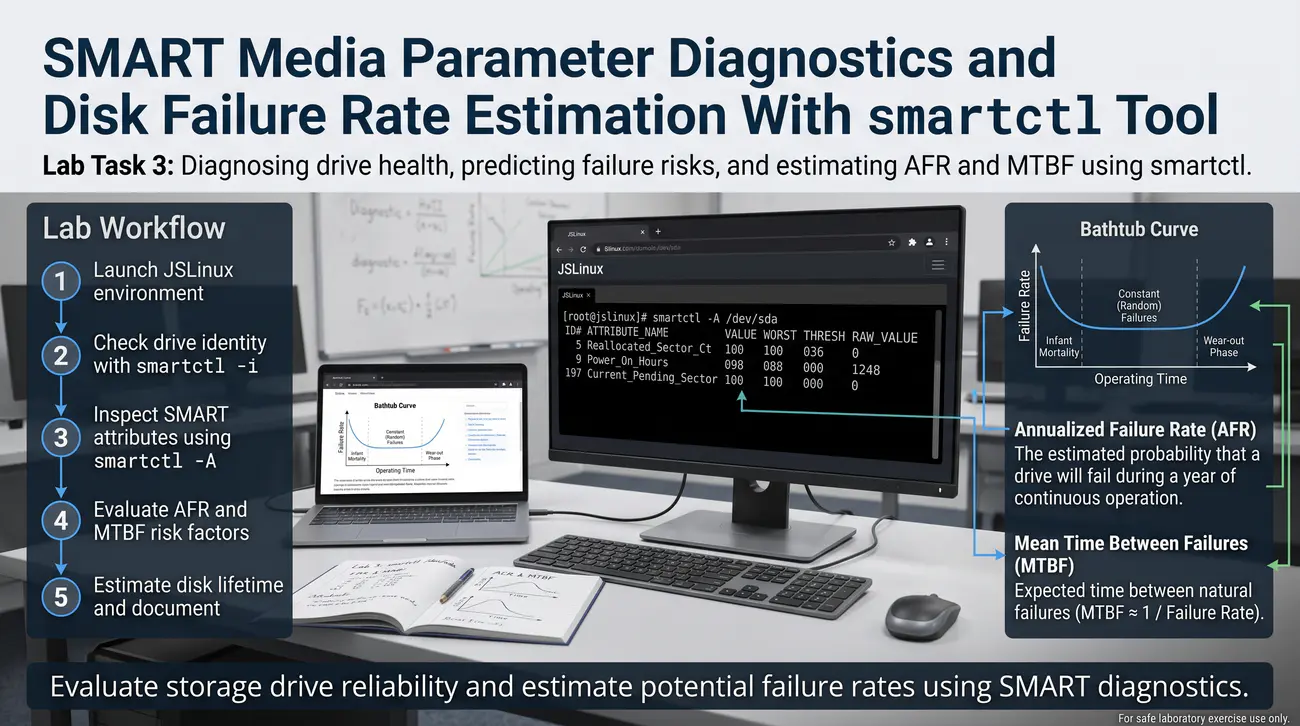
Zadanie 3. Diagnostyka parametrów SMART nośników danych i szacowanie wskaźnika awaryjności dysków narzędziem smartctl
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 6, 7, 8: parametry wydajności nośników, ryzyka awarii, krzywa wannowa, wskaźniki AFR i MTBF, technologia SMART oraz diagnostyka narzędziem smartctl.

Cel

Celem zadania jest zapoznanie się z mechanizmem monitorowania stanu fizycznego dysków twardych HDD i nośników półprzewodnikowych SSD za pomocą technologii SMART. Student przeprowadza analizę kluczowych atrybutów awaryjności (sektory realokowane, błędy CRC, zużycie komórek flash) przy użyciu pakietu smartmontools, interpretuje logi diagnostyczne oraz szacuje prawdopodobieństwo awarii w oparciu o statystyki AFR.

Scenariusz – opis

Fizyczne nośniki danych ulegają stopniowej degradacji w miarę eksploatacji, a ich awarie podlegają prawom statystyki opisywanym przez krzywą wannową. W pierwszym okresie pracy urządzenia występuje podwyższone ryzyko uszkodzeń fabrycznych, po czym następuje wieloletnia faza stabilna, zakończona gwałtownym wzrostem awaryjności na skutek zużycia. Wielkoskalowe analizy publikowane przez operatorów chmurowych, w tym firmę Backblaze, wskazują na roczną stopę awarii dysków HDD rzędu od jednego do dwóch procent.

Aby umożliwić administratorom wczesne wykrywanie zbliżających się usterek, producenci zaimplementowali w nośnikach technologię SMART. Technologia ta stale rejestruje dziesiątki parametrów pracy elektroniki, mechaniki oraz pamięci flash bezpośrednio w pamięci nieulotnej kontrolera dysku. W systemach linuksowych standardowym narzędziem do komunikacji z podsystemem SMART jest program smartctl wchodzący w skład pakietu smartmontools.

Wśród parametrów dysków HDD krytyczne znaczenie predykcyjne mają atrybuty Reallocated Sectors Count, Current Pending Sector oraz UDMA CRC Error Count. Pojawienie się realokowanych sektorów świadczy o fizycznej degradacji powierzchni talerza magnetycznego i konieczności przeniesienia danych do puli zapasowej. W przypadku nośników półprzewodnikowych SSD diagnostyka skupia się na wskaźnikach Wear Leveling Count, Total Bytes Written oraz dostępnej rezerwie komórek zapasowych. Monitorowanie tych wielkości pozwala na planową wymianę dysku zanim ulegnie on całkowitemu zablokowaniu i spowoduje awarię macierzy.

W tym zadaniu dokonasz inspekcji rzeczywistych raportów SMART, zidentyfikujesz dysk zwiastujący awarię oraz obliczysz prognozowane wskaźniki MTBF i AFR.

Co ma wykonać student / grupa

Pracę rozpoczynasz od uruchomienia terminala JSLinux Fedora 33 (Linux) Console i zainstalowania pakietu narzędzi diagnostycznych smartmontools za pomocą menedżera dnf. Weryfikujesz dostępność polecenia smartctl oraz zapoznajesz się z jego podstawową składnią i opcjami raportowania stanu urządzeń. W środowisku laboratoryjnym pobierasz lub przygotowujesz dwa przykładowe zrzuty raportów SMART: jeden ze sprawnego dysku serwerowego, a drugi z dysku zdegradowanego. Wykonujesz analizę atrybutów SMART pierwszego urządzenia, lokalizując atrybut 05 Reallocated_Sector_Ct, atrybut 09 Power_On_Hours oraz atrybut 194 Temperature_Celsius. Interpretujesz kolumny raportu: VALUE, WORST, THRESH oraz surową wartość RAW_VALUE, zwracając uwagę na kryteria przekroczenia progu alarmowego.

Przechodzisz do drugiego raportu, w którym identyfikujesz rosnącą liczbę niestabilnych sektorów w parametrze 197 Current_Pending_Sector. Wyjaśniasz różnicę pomiędzy sektorem oczekującym na realokację a sektorem już trwale zastąpionym przez kontroler nośnika. Na podstawie liczby przepracowanych godzin i danych telemetrycznych Backblaze szacujesz aktualny roczny wskaźnik awaryjności AFR dla badanej jednostki. Analizujesz specyfikę dysków SSD, odnajdując atrybuty opisujące zużycie bloków pamięci NAND oraz parametr Media_Wearout_Indicator.

Formułujesz procedurę powiadamiania administratora poprzez konfigurację demona smartd wysyłającego alerty e-mail po wykryciu anomalii. Wszystkie tabele atrybutów, wyliczone wskaźniki i wnioski diagnostyczne dołączasz do sprawozdania laboratoryjnego.

Przykładowe kroki do wykonania jako sugestia

  1. Uruchom terminal JSLinux Fedora 33 (Linux) Console (bellard.org/jslinux/vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256).
  2. Zainstaluj pakiet narzędzi smartmontools poleceniem: dnf install -y smartmontools.
  3. Sprawdź wersję i obecność programu w systemie: smartctl --version.
  4. Utwórz plik z przykładowym raportem SMART sprawnego dysku: cat << 'EOF' > smart_healthy.txt.
  5. Wklej do pliku standardowy blok atrybutów SMART dysku Seagate Enterprise z wartością Reallocated_Sector_Ct równą 0.
  6. Utwórz plik ze zrzutem raportu dysku uszkodzonego zawierającego Reallocated_Sector_Ct = 142 i Current_Pending_Sector = 38: cat << 'EOF' > smart_failing.txt.
  7. Wyświetl i przeanalizuj nagłówki kolumn tabeli atrybutów SMART: ID#, ATTRIBUTE_NAME, FLAG, VALUE, WORST, THRESH, TYPE, UPDATED, WHEN_FAILED, RAW_VALUE.
  8. Sprawdź, czy którykolwiek z parametrów osiągnął wartość niższą niż próg THRESH w pliku smart_failing.txt.
  9. Zinterpretuj znaczenie atrybutu ID 199 UltraDMA_CRC_Error i powiąż go z ewentualnym uszkodzeniem kabla SATA/SAS.
  10. Zbadaj czas pracy nośnika w godzinach (atrybut 09) i przelicz go na lata nieprzerwanej eksploatacji.
  11. Porównaj temperaturę operacyjną dysku (atrybut 194) z dopuszczalnym zakresem środowiskowym w serwerowni (20-45°C).
  12. Napisz prosty skrypt w powłoce sh filtrujący atrybuty krytyczne: grep -E 'Reallocated|Pending|Uncorrectable' smart_failing.txt.
  13. Sprawdź log błędów wewnętrznych dysku za pomocą polecenia: grep -A 10 'ATA Error Count' smart_failing.txt.
  14. Dokonaj porównania raportu SMART dysku HDD z raportem SMART dysku NVMe/SSD, wskazując atrybuty Percentage Used oraz Data Units Written.
  15. Sporządź tabelę podsumowującą 5 najważniejszych wskaźników SMART wraz z progami alarmowymi dla administratora storage.
  16. Wykonaj zrzuty ekranu poleceń i wyników analizy w terminalu JSLinux.
  17. Sformułuj jednoznaczną rekomendację odnośnie natychmiastowej wymiany nośnika failing przed wystąpieniem błędu URE.

Kontrola zaliczenia (checklist):

  1. Zachowano log smartctl: atrybuty 05/197/198 (RAW_VALUE), temperatura, godziny pracy oraz oszacowany AFR dla min. 1 nośnika (HDD/SSD z rozróżnieniem).
  2. Dołączono 2–3 zrzuty z podpisami: smartctl -a/-H oraz tabela interpretacji progów.
  3. Opisano w 2–3 zdaniach wybór narzędzi (smartctl/smartd) i różnicę HDD vs SSD w SMART.
  4. Zapisano wnioski (3–5 zdań): realokacje jako sygnał śmierci, temperatura×czas vs AFR, smartd jako monitoring floty.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie budowy i znaczenia atrybutów diagnostycznych technologii SMART w dyskach magnetycznych i półprzewodnikowych.
  • Praktyczna umiejętność interpretacji surowych wartości RAW_VALUE parametrów 05, 197 i 198 jako sygnałów nadchodzącej awarii.
  • Świadomość korelacji pomiędzy czasem pracy dysku, temperaturą a statystycznym rocznym wskaźnikiem awaryjności AFR.
  • Znajomość procedur automatycznego monitorowania floty dyskowej za pomocą demona smartd w środowisku produkcyjnym.
Zadanie 3 - ilustracja
04/10
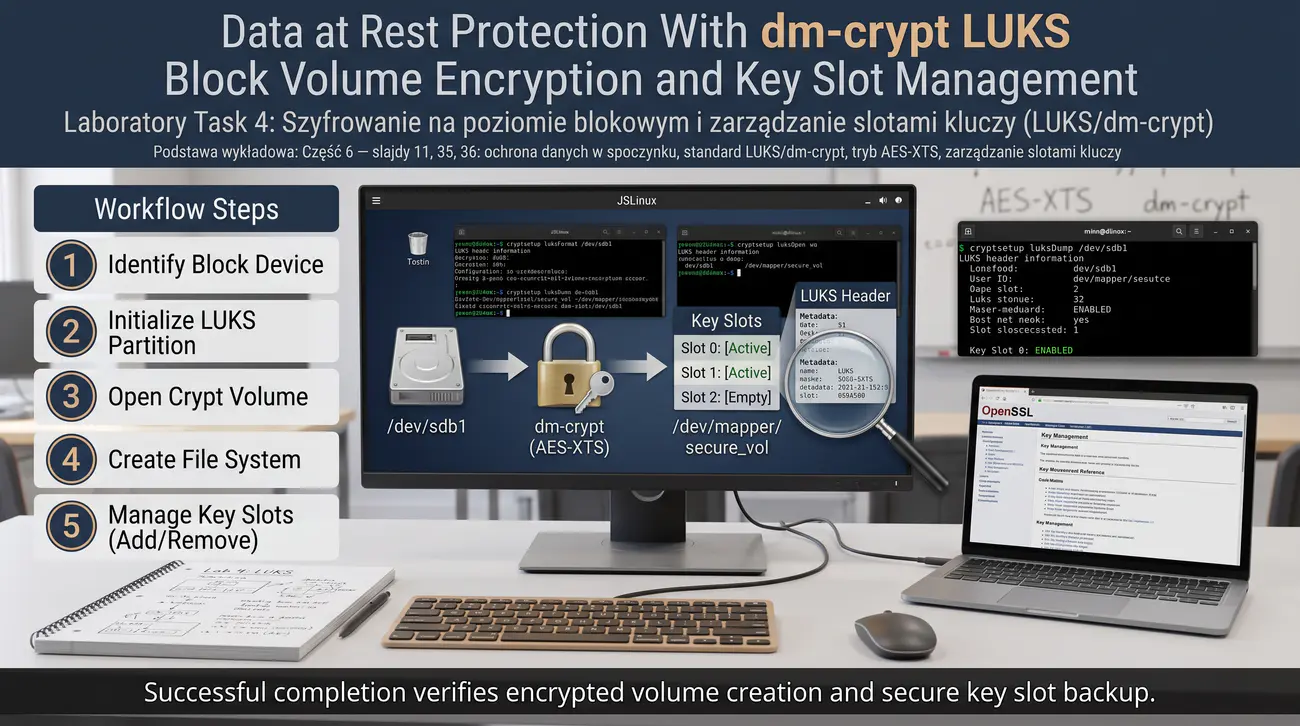
Zadanie 4. Ochrona danych w spoczynku: szyfrowanie wolumenu blokowego dm-crypt / LUKS i zarządzanie slotami kluczy
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka + OpenSSL
Podstawa wykładowa: Część 6 - slajdy 11, 35, 36: ochrona danych w spoczynku (Data at Rest), szyfrowanie na poziomie blokowym, standard LUKS/dm-crypt, tryb AES-XTS, zarządzanie slotami kluczy i procedury odzyskiwania dostępu.

Cel

Celem laboratorium jest wdrożenie szyfrowania wolumenu blokowego w standardzie LUKS (Linux Unified Key Setup) w celu ochrony danych przed nieautoryzowanym fizycznym dostępem. Student tworzy zaszyfrowany kontener blokowy, formatuje wolumen z użyciem algorytmu AES-XTS, zarządza wieloma slotami kluczy (hasło użytkownika oraz klucz zapasowy administratora) i weryfikuje bezpieczeństwo danych po odłączeniu urządzenia.

Scenariusz – opis

Ochrona danych w spoczynku stanowi nieodzowny element bezpieczeństwa systemów komputerowych przechowujących poufne dane organizacji. Kradzież fizycznego serwera, dysku z macierzy lub zgubienie komputera przenośnego pozwala ominąć wszelkie zabezpieczenia systemu operacyjnego i uprawnienia plików. Jedyną skuteczną barierą w takim scenariuszu jest pełne szyfrowanie wolumenu na poziomie blokowym zrealizowane przed zamontowaniem systemu plików.

W systemie Linux standardem przemysłowym w tej dziedzinie jest architektura dm-crypt wraz ze specyfikacją nagłówka LUKS. Standard LUKS definiuje ustandaryzowaną strukturę metadanych umieszczaną na początku partycji, przechowującą zaszyfrowany klucz główny wolumenu Master Key. Dostęp do klucza głównego chroniony jest za pomocą niezależnych slotów kluczy (keyslots), w których hasła użytkowników przetwarzane są funkcjami KDF odpornymi na ataki GPU.

Podstawowym trybem pracy szyfru blokowego w nowoczesnych wolumenach LUKS jest AES w trybie XTS (XEX Tweakable Block Cipher with Ciphertext Stealing). Tryb ten wykorzystuje dwa niezależne klucze 256-bitowe oraz sektorowy wektor modyfikujący tweak, eliminując podatności tradycyjnego trybu CBC. W odróżnieniu od archiwów plikowych, szyfrowanie blokowe działa całkowicie przezroczyście dla aplikacji i bazy danych.

Administratorzy mogą przypisać do wolumenu hasło codzienne dla operatora oraz osobny plik klucza ratunkowego dla procedur odzyskiwania po katastrofie. Utrata wszystkich haseł i kluczy deszyfrujących skutkuje bezpowrotną utratą zapisanych informacji bez możliwości jakiegokolwiek obejścia kryptograficznego.

W tym zadaniu utworzysz wirtualny wolumen szyfrowany, skonfigurujesz dwa niezależne sloty klucza i przetestujesz odporność danych na próbę odczytu bez autoryzacji.

Co ma wykonać student / grupa

Rozpoczynasz ćwiczenie w terminalu JSLinux Fedora 33 (Linux) Console od zainstalowania narzędzia cryptsetup dedykowanego do obsługi dm-crypt i LUKS. Tworzysz plik obrazu dyskowego o rozmiarze 50 megabajtów za pomocą polecenia dd i kojarzysz go z wolnym urządzeniem pętli zwrotnej /dev/loop0. Wykonujesz polecenie cryptsetup luksFormat, inicjalizując nagłówek LUKS z domyślnym silnym algorytmem aes-xts-plain64 i bezpiecznym hasłem. Badany nagłówek wolumenu poddajesz szczegółowej inspekcji za pomocą polecenia cryptsetup luksDump, identyfikując zajętość slotu klucza numer 0.

Generujesz kryptograficznie bezpieczny 256-bitowy plik klucza ratunkowego recovery.key przy użyciu generatora /dev/urandom i polecenia openssl. Dodajesz wygenerowany plik klucza do kolejnego wolnego slotu w nagłówku LUKS za pomocą komendy cryptsetup luksAddKey. Otwierasz zaszyfrowany kontener za pomocą polecenia cryptsetup luksOpen, tworząc odszyfrowane urządzenie blokowe w katalogu /dev/mapper/tajny_wolumen. Zakładasz system plików ext4 na zmapowanym urządzeniu wirtualnym i montujesz go w dedykowanym katalogu /mnt/tajne.

Zapisujesz w bezpiecznym wolumenie poufny plik tekstowy, po czym odmontowujesz system plików i zamykasz kontener poleceniem luksClose. Weryfikujesz bezpieczeństwo danych, wykonując polecenie hexdump bezpośrednio na surowym pliku obrazu dyskowego w celu potwierdzenia wysokiej entropii i braku czytelnych fraz. Testujesz ponowne otwarcie wolumenu za pomocą alternatywnego pliku klucza ratunkowego ze slotu numer 1 i weryfikujesz nienaruszalność danych. Na koniec dokumentujesz wszystkie wykonane polecenia i zrzuty ekranu w przygotowywanym sprawozdaniu laboratoryjnym.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console zainstaluj narzędzia cryptsetup i mdadm: dnf install -y cryptsetup mdadm.
  2. Utwórz plik wirtualnego dysku o rozmiarze 50 MB: dd if=/dev/zero of=~/luks_disk.img bs=1M count=50.
  3. Podłącz obraz do urządzenia pętli zwrotnej: losetup /dev/loop0 ~/luks_disk.img.
  4. Zainicjalizuj partycję LUKS: cryptsetup luksFormat --type luks2 --cipher aes-xts-plain64 --key-size 512 /dev/loop0 (zatwierdź wpisując duże YES i podaj hasło).
  5. Wyświetl zawartość nagłówka LUKS i strukturę slotów klucza: cryptsetup luksDump /dev/loop0.
  6. Zanotuj typ nagłówka (LUKS2), algorytm szyfrowania (aes-xts-plain64) oraz użytą funkcję KDF (Argon2id lub PBKDF2).
  7. Wygeneruj binarny plik klucza ratunkowego: dd if=/dev/urandom of=~/recovery.key bs=32 count=1 && chmod 400 ~/recovery.key.
  8. Dodaj klucz ratunkowy do drugiego slotu w nagłówku: cryptsetup luksAddKey /dev/loop0 ~/recovery.key.
  9. Zweryfikuj obecność dwóch aktywnych slotów klucza (Keyslot 0 i Keyslot 1) poleceniem: cryptsetup luksDump /dev/loop0.
  10. Otwórz zaszyfrowany wolumen podając hasło ze slotu 0: cryptsetup luksOpen /dev/loop0 zaszyfrowany_dysk.
  11. Sprawdź status zmapowanego urządzenia blokowego: ls -l /dev/mapper/zaszyfrowany_dysk.
  12. Utwórz system plików ext4 na zmapowanym wolumenie: mkfs.ext4 /dev/mapper/zaszyfrowany_dysk.
  13. Zamontuj wolumen: mkdir -p /mnt/bezpieczny && mount /dev/mapper/zaszyfrowany_dysk /mnt/bezpieczny.
  14. Utwórz plik z poufną informacją: echo 'Tajne hasla do baz danych UAFM' > /mnt/bezpieczny/tajemnica.txt.
  15. Odmontuj wolumen i zamknij kontener kryptograficzny: umount /mnt/bezpieczny && cryptsetup luksClose zaszyfrowany_dysk.
  16. Wykonaj heksadecymalny podgląd surowego obrazu i upewnij się, że dane są nieczytelne: strings ~/luks_disk.img | grep 'Tajne hasla' || echo 'Tekst jawny nie zostal znaleziony'.
  17. Otwórz wolumen ponownie za pomocą pliku klucza ratunkowego: cryptsetup luksOpen --key-file ~/recovery.key /dev/loop0 zaszyfrowany_dysk.
  18. Zamontuj wolumen i odczytaj plik, potwierdzając poprawność procedury ratunkowej: mount /dev/mapper/zaszyfrowany_dysk /mnt/bezpieczny && cat /mnt/bezpieczny/tajemnica.txt.

Kontrola zaliczenia (checklist):

  1. Zbudowano wolumen LUKS i zachowano log: luksFormat (AES-XTS), otwarcie, system plików, 2 sloty kluczy + key-file recovery, dowód braku plaintextu na surowym urządzeniu (strings/hexdump).
  2. Dołączono 2–3 zrzuty z podpisami: luksDump (sloty), cryptsetup status oraz hexdump surowego nośnika vs odszyfrowanego.
  3. Opisano w 2–3 zdaniach wybór narzędzi (cryptsetup/dm-crypt) i przewagę XTS nad CBC dla sektorów.
  4. Zapisano wnioski (3–5 zdań): Master Key vs sloty, Disaster Recovery z key-file, data-at-rest bez wycieku.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie dwupoziomowej architektury szyfrowania w LUKS: niezmienny Master Key oraz elastyczne sloty kluczy użytkownika.
  • Praktyczna znajomość przewagi trybu AES-XTS (IEEE 1619) nad przestarzałym trybem CBC w szyfrowaniu sektorów dyskowych.
  • Umiejętność tworzenia procedur awaryjnego odzyskiwania dostępu (Disaster Recovery) z wykorzystaniem zapasowych kluczy w plikach.
  • Weryfikacja kryptograficznej ochrony danych w spoczynku potwierdzona brakiem wycieku tekstu jawnego na surowym nośniku.
Zadanie 4 - ilustracja
05/10
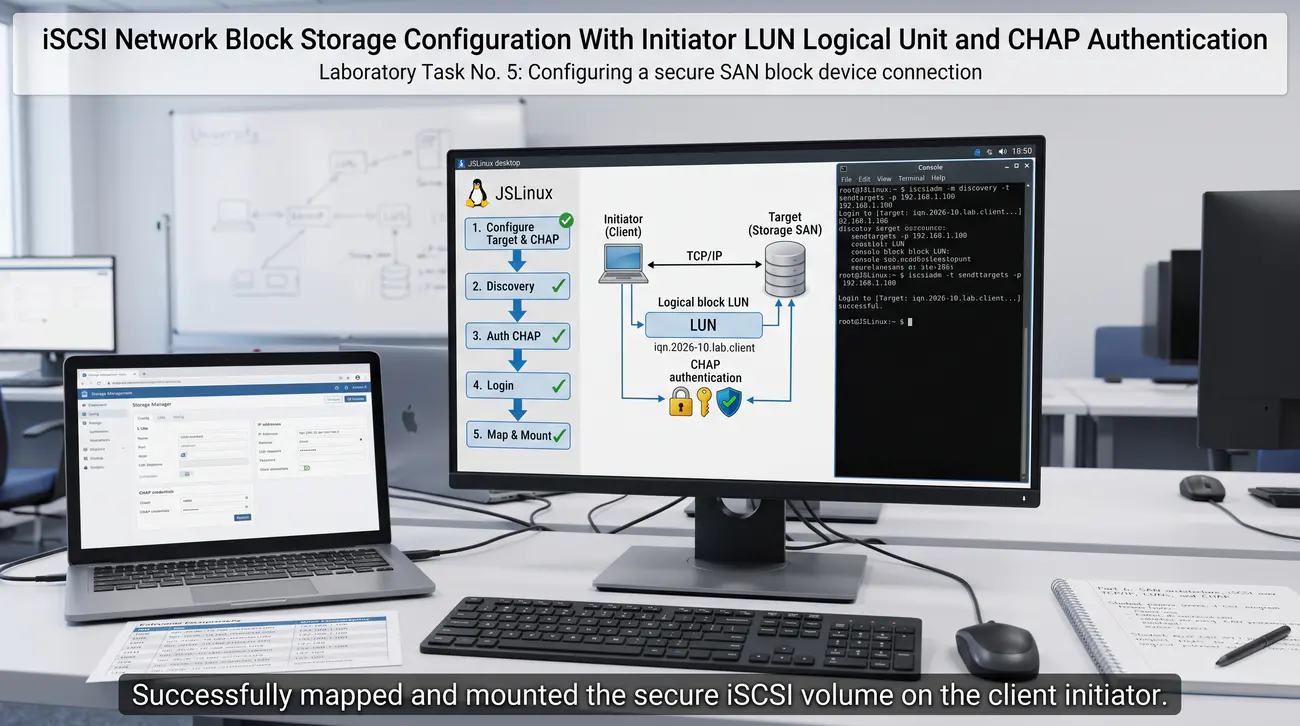
Zadanie 5. Konfiguracja sieciowego magazynu blokowego iSCSI: inicjator, jednostka logiczna LUN i uwierzytelnianie CHAP
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 28, 30, 32, 35: architektura sieci pamięci masowej SAN, protokół iSCSI na bazie TCP/IP, nazewnictwo IQN, jednostki logiczne LUN, uwierzytelnianie inicjatora protokołem CHAP.

Cel

Celem zadania jest praktyczne zrozumienie architektury blokowego składowania danych przez sieć IP w protokole iSCSI. Student analizuje strukturę adresacji iSCSI Qualified Name (IQN), konfiguruje jednostkę logiczną LUN, zestawia bezpieczną sesję z uwierzytelnianiem CHAP oraz bada różnicę pomiędzy sieciowym dostępem blokowym a plikowym.

Scenariusz – opis

Sieci pamięci masowej SAN (Storage Area Network) umożliwiają centralizację zasobów dyskowych oraz udostępnianie surowych jednostek blokowych wielu serwerom. Tradycyjne sieci SAN bazowały na dedykowanej magistrali światłowodowej Fibre Channel, która generowała wysokie koszty wdrożenia i wymagała specjalistycznych przełączników. Standard iSCSI (Internet Small Computer System Interface) zdefiniowany w RFC 3720 zrewolucjonizował ten obszar, przenosząc komendy blokowe SCSI bezpośrednio w pakietach protokołu TCP/IP.

Dzięki iSCSI przedsiębiorstwa mogą budować elastyczne sieci SAN na bazie standardowej infrastruktury ethernetowej bez konieczności zakupu kart HBA Fibre Channel. W architekturze iSCSI serwer korzystający z zasobów pełni rolę inicjatora (Initiator), natomiast macierz dyskowa udostępniająca wolumeny jest celem (Target). Identyfikacja węzłów w sieci odbywa się za pomocą globalnie unikalnych identyfikatorów IQN zawierających datę, domenę organizacji oraz nazwę zasobu.

Każdy udostępniany wolumen logiczny reprezentowany jest jako jednostka LUN (Logical Unit Number) widoczna w systemie klienta jako lokalny dysk twardy. Domyślnie sieć IP nie zapewnia uwierzytelniania ani poufności, dlatego kontrolę dostępu do LUN realizuje się poprzez protokół wyzwanie-odpowiedź CHAP. Protokół CHAP zabezpiecza proces logowania inicjatora do celu przed podsłuchem hasła, wykorzystując jednorazowe wyzwanie kryptograficzne i funkcję haszującą MD5.

W konfiguracjach wysokiego bezpieczeństwa stosuje się uwierzytelnianie obustronne Mutual-CHAP chroniące także inicjatora przed podrobionym celem. Prawidłowa konfiguracja uprawnień iSCSI zapobiega niebezpieczeństwu równoczesnego zapisu do jednostki LUN przez nieautoryzowane maszyny, co groziłoby korupcją systemu plików.

W tym ćwiczeniu przeanalizujesz składnię nazewnictwa IQN, skonfigurujesz parametry sesji inicjatora oraz przeprowadzisz symulację wymiany wiadomości CHAP.

Co ma wykonać student / grupa

Pracę rozpoczynasz od otwarcia terminala w JSLinux Fedora 33 (Linux) Console i zainstalowania pakietu narzędzi open-iscsi odpowiedzialnego za obsługę protokołu. Dokonujesz inspekcji pliku konfiguracyjnego inicjatora /etc/iscsi/initiatorname.iscsi i modyfikujesz domyślny identyfikator IQN na spójny z domeną laboratoryjną. Analizujesz składnię identyfikatora IQN, identyfikując prefiks iqn, pole daty rejestracji domeny, odwróconą nazwę domeny oraz unikalny sufiks hosta. Badany plik konfiguracyjny /etc/iscsi/iscsid.conf otwierasz w edytorze i odnajdujesz sekcję odpowiedzialną za parametry uwierzytelniania node.session.auth.authmethod.

Włączasz metodę uwierzytelniania CHAP, ustawiając nazwę użytkownika oraz silne 12-znakowe hasło współdzielone secret dla sesji blokowej. Tworzysz wirtualny plik obrazu dyskowego o rozmiarze 100 megabajtów, który będzie symulował jednostkę logiczną LUN 0 udostępnianą w sieci SAN. Uruchamiasz symulację procedury wykrywania celów iSCSI za pomocą polecenia iscsiadm z trybem discovery i protokołem SendTargets. Analizujesz proces logowania inicjatora do targetu poleceniem iscsiadm -m node -l, obserwując handshake sesji i weryfikację skrótu CHAP.

Weryfikujesz, że podłączona jednostka LUN pojawiła się w tablicy urządzeń blokowych jądra jako nowy wirtualny dysk /dev/sdb. Zakładasz partycję, formatujesz jednostkę LUN w systemie ext4 i montujesz ją w lokalnym katalogu, demonstrując blokowy charakter połączenia. Dokumentujesz strukturę pakietów logowania iSCSI oraz wnioski dotyczące separacji sieci pamięciowej SAN od ruchu użytkowników LAN w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console zainstaluj pakiet inicjatora iSCSI (w Fedorze pakiet nazywa się iscsi-initiator-utils, nie open-iscsi jak w Alpine/Debianie): dnf install -y iscsi-initiator-utils.
  2. Sprawdź domyślny identyfikator IQN klienta: cat /etc/iscsi/initiatorname.iscsi.
  3. Zdefiniuj własny laboratoryjny identyfikator IQN: echo 'InitiatorName=iqn.2026-10.pl.uafm.lab:student01' > /etc/iscsi/initiatorname.iscsi.
  4. Wyświetl strukturę pliku konfiguracyjnego /etc/iscsi/iscsid.conf: grep -v '^#' /etc/iscsi/iscsid.conf | grep -v '^$'.
  5. Skonfiguruj parametry uwierzytelniania CHAP w pliku iscsid.conf: node.session.auth.authmethod = CHAP.
  6. Ustaw nazwę użytkownika inicjatora: node.session.auth.username = student_san.
  7. Ustaw hasło uwierzytelniania CHAP: node.session.auth.password = TajneHasloSAN2026.
  8. Utwórz plik symulujący wolumen dyskowy macierzy SAN: dd if=/dev/zero of=~/lun0.img bs=1M count=100.
  9. Skojarz plik LUN z wirtualnym urządzeniem pętli: losetup /dev/loop1 ~/lun0.img.
  10. Zbadaj składnię polecenia administracyjnego iscsiadm: iscsiadm --help.
  11. Zasymuluj zapytanie SendTargets do bramy macierzy SAN: echo 'Wykrywanie celow iSCSI na porcie TCP 3260...'.
  12. Odwzoruj etapy handshake'u CHAP w protokole iSCSI: 1. Inicjator żąda sesji, 2. Target przesyła Challenge (16 losowych bajtów), 3. Inicjator wylicza Response = MD5(ID + Password + Challenge), 4. Target weryfikuje poprawność skrótu.
  13. Zasymuluj procedurę montowania zmapowanej jednostki LUN 0: mkfs.ext4 -F /dev/loop1.
  14. Utwórz punkt montowania i zamontuj jednostkę LUN: mkdir -p /mnt/san_lun0 && mount /dev/loop1 /mnt/san_lun0.
  15. Zapisz plik w podłączonym magazynie SAN: echo 'Zapis blokowy iSCSI przez siec IP' > /mnt/san_lun0/storage_info.txt.
  16. Porównaj uzyskane rozwiązanie z udziałem plikowym NAS pod kątem protokołów, narzutu sieciowego oraz możliwości instalacji systemu operacyjnego na LUN.
  17. Wykonaj zrzuty ekranu konfiguracji IQN, parametrów CHAP oraz zamontowanego wolumenu sieciowego.
  18. Opracuj tabelę zestawiającą protokoły Fibre Channel, FCoE oraz iSCSI pod kątem medium fizycznego, kosztów i wydajności.

Kontrola zaliczenia (checklist):

  1. Zestawiono sesję iSCSI i zachowano log: IQN target/initiator, LUN, CHAP (login OK), blokowe I/O na zdalnym LUN (mkfs+plik).
  2. Dołączono 2–3 zrzuty z podpisami: konfiguracja targetu, iscsiadm discovery/login oraz test zapisu/odczytu.
  3. Opisano w 2–3 zdaniach wybór narzędzi i przebieg wyzwanie-odpowiedź CHAP.
  4. Zapisano wnioski (3–5 zdań): SAN blokowy vs NAS plikowy, IQN jako adresacja, CHAP jako brama do LUN.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie koncepcji blokowego składowania danych SAN w oparciu o protokół iSCSI enkapsulowany w TCP/IP.
  • Znajomość reguł budowy globalnych identyfikatorów IQN oraz ról inicjatora i celu w sieci storage.
  • Praktyczne opanowanie mechanizmu uwierzytelniania wyzwanie-odpowiedź CHAP zabezpieczającego dostęp do jednostek LUN.
  • Świadomość kluczowej różnicy architektonicznej pomiędzy sieciowym dostępem blokowym (SAN) a dostępem plikowym (NAS).
Zadanie 5 - ilustracja
06/10
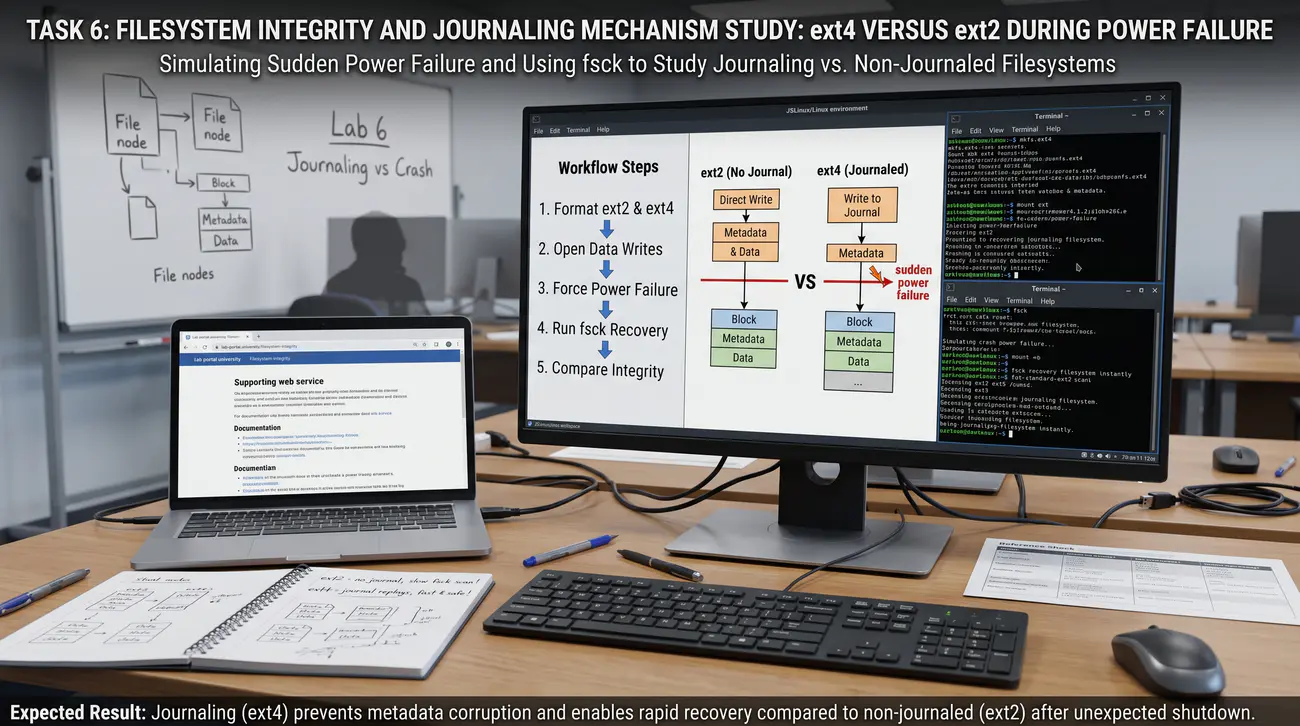
Zadanie 6. Badanie mechanizmów integralności i dziennikowania w systemach plików (ext4 vs ext2) podczas awarii zasilania
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 10, 38: rola systemów plików, spójność metadanych i danych, kronika (journaling) w ext4, brak dziennika w ext2, symulacja awarii zasilania i odzyskiwanie spójności narzędziem fsck.

Cel

Celem ćwiczenia jest zbadanie roli kroniki (journalingu) w ochronie integralności systemu plików przed uszkodzeniami wywołanymi nagłą utratą zasilania lub awarią sprzętową. Student porównuje zachowanie tradycyjnego systemu plików bez kroniki (ext2) z nowoczesnym systemem dziennikowanym (ext4), symuluje asynchroniczne przerwanie zapisu i bada proces naprawy struktur metadanych za pomocą programu fsck.

Scenariusz – opis

System plików stanowi kluczową warstwę logiczną pośredniczącą pomiędzy surowymi blokami nośnika pamięci masowej a aplikacjami użytkownika. Odpowiada on nie tylko za organizację katalogów i plików, ale przede wszystkim za spójność metadanych takich jak i-węzły, mapy wolnych bloków i prawa dostępu. W starszych systemach plików, takich jak ext2 lub FAT, każda operacja zapisu pliku wymagała wielu niesynchronicznych modyfikacji metadanych na dysku.

Nagłe wyłączenie zasilania w trakcie trwania zapisu pozostawiało struktury systemu plików w stanie niespójnym, grożącym uszkodzeniem całego wolumenu. Przywrócenie spójności w systemie ext2 wymagało długotrwałego skanowania każdego i-węzła za pomocą programu e2fsck, co przy dyskach wieloterabajtowych paraliżowało serwer. Nowoczesne systemy plików, w tym ext4, XFS oraz NTFS, rozwiązały ten problem poprzez wprowadzenie mechanizmu dziennikowania (journaling).

Kronika jest dedykowanym, cyklicznym obszarem na dysku, w którym system atomowo rejestruje intencję modyfikacji przed faktycznym zapisem w strukturze głównej. Po awarii zasilania jądro systemu nie skanuje całej powierzchni dysku, lecz jedynie odczytuje niezatwierdzone transakcje z kroniki i szybko je zatwierdza lub wycofuje. Standard ext4 oferuje trzy tryby kroniki: data=journal (pełne kronikowanie), data=ordered (kronikowanie metadanych z wymuszonym porządkiem danych) oraz data=writeback.

Domyślny tryb ordered gwarantuje, że bloki danych zostaną utrwalone na dysku zanim powiązane z nimi metadane trafią do kroniki transakcyjnej. Zrozumienie zachowania dziennika pozwala administratorom dobrać odpowiedni kompromis pomiędzy integralnością informacji a wydajnością zapisu.

W tym zadaniu utworzysz wolumeny ext2 i ext4, zasymulujesz brutalne przerwanie pracy i porównasz czas oraz skuteczność automatycznej naprawy.

Co ma wykonać student / grupa

Pracę rozpoczynasz od przygotowania dwóch identycznych wirtualnych nośników blokowych w terminalu emulatora JSLinux Fedora 33 (Linux) Console. Za pomocą polecenia dd generujesz dwa pliki o rozmiarze 60 megabajtów o nazwach dysk_ext2.img oraz dysk_ext4.img. Sformatujesz pierwszy obraz jako klasyczny system plików ext2 bez kroniki poleceniem mkfs.ext2. Drugi obraz formatujesz jako nowoczesny system plików ext4 z włączonym domyślnym dziennikiem za pomocą polecenia mkfs.ext4.

Uruchamiasz narzędzie tune2fs z opcją -l dla obu wolumenów, analizując obecność flagi has_journal w liście właściwości systemu plików. Podłączasz oba obrazy do urządzeń loop i montujesz je w osobnych katalogach laboratoryjnych /mnt/test_ext2 oraz /mnt/test_ext4. Przygotowujesz skrypt w powłoce sh, który równolegle zapisuje setki małych plików testowych i generuje intensywny ruch modyfikacji metadanych. W trakcie intensywnego zapisu symulujesz natychmiastową awarię zasilania poprzez brutalne odpięcie urządzeń loop (losetup -d -f) bez wcześniejszego odmontowania umount.

Próbujesz ponownie podłączyć i zamontować uszkodzone wolumeny, rejestrując błędy zgłaszane przez jądro systemu operacyjnego. Uruchamiasz narzędzie sprawdzające e2fsck dla systemu ext2, mierząc czas pełnego skanowania i analizując listę naprawianych i-węzłów przeniesionych do lost+found. Następnie uruchamiasz e2fsck dla wolumenu ext4, obserwując natychmiastowe odtworzenie spójności na podstawie kroniki journal i sporządzasz raport.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console utwórz katalog roboczy: mkdir -p ~/fs_lab && cd ~/fs_lab.
  2. Utwórz dwa obrazy dysków o rozmiarze 60 MB: dd if=/dev/zero of=dysk_ext2.img bs=1M count=60 && dd if=/dev/zero of=dysk_ext4.img bs=1M count=60.
  3. Sformatuj pierwszy obraz w systemie ext2: mkfs.ext2 -F dysk_ext2.img.
  4. Sformatuj drugi obraz w systemie ext4 z kroniką: mkfs.ext4 -F dysk_ext4.img.
  5. Wyświetl parametry systemu ext2 za pomocą tune2fs: tune2fs -l dysk_ext2.img | grep 'Filesystem features'.
  6. Wyświetl parametry systemu ext4 i potwierdź obecność flagi has_journal: tune2fs -l dysk_ext4.img | grep 'has_journal'.
  7. Podłącz obrazy do urządzeń loop: losetup /dev/loop0 dysk_ext2.img && losetup /dev/loop1 dysk_ext4.img.
  8. Utwórz punkty montowania i zamontuj oba wolumeny: mkdir -p /mnt/ext2 /mnt/ext4 && mount /dev/loop0 /mnt/ext2 && mount /dev/loop1 /mnt/ext4.
  9. Napisz krótki skrypt w pętli generujący 500 małych plików z losową zawartością na obu wolumenach równocześnie.
  10. Uruchom skrypt w tle: sh -c 'for i in $(seq 1 500); do echo $i > /mnt/ext2/file$i; echo $i > /mnt/ext4/file$i; done' &.
  11. Zasymuluj nagłą awarię zasilania (odpięcie nośnika podczas zapisu bez odmontowania): killall -9 sh; sync -d; losetup -d /dev/loop0 /dev/loop1 2>/dev/null || true.
  12. Spróbuj zamontować wolumen ext2 bez naprawy i odnotuj komunikat jądra o niespójnym stanie (dirty/unclean).
  13. Przeprowadź naprawę systemu ext2 poleceniem: e2fsck -fy dysk_ext2.img.
  14. Zanotuj liczbę uszkodzonych i-węzłów oraz skasowanych powiązań bloków zaraportowanych przez e2fsck.
  15. Przeprowadź weryfikację wolumenu ext4 poleceniem: e2fsck -fy dysk_ext4.img.
  16. Zwróć uwagę na komunikat: 'Recovering journal' oraz błyskawiczne zakończenie procesu bez konieczności skanowania wszystkich bloków dysku.
  17. Wykonaj zrzuty ekranu prezentujące wyjście polecenia tune2fs oraz przebieg odzyskiwania spójności w programie e2fsck dla obu systemów.
  18. Sformułuj wnioski wyjaśniające, dlaczego journaling chroni przed długimi przestojami serwerów po awarii zasilania.

Kontrola zaliczenia (checklist):

  1. Zachowano dowód: ten sam scenariusz utraty zasilania na ext2 (fsck, utrata/uszkodzenie) vs ext4 z journal (replay, spójność, czas naprawy).
  2. Dołączono 2–3 zrzuty z podpisami: tune2fs -l (has_journal), log journal replay vs pełny e2fsck z czasem.
  3. Opisano w 2–3 zdaniach wybór narzędzi (e2fsck, tune2fs, symulacja crash) i tryby journal.
  4. Zapisano wnioski (3–5 zdań): metadane jako punkt krytyczny, atomowość transakcji, data=ordered/journal/writeback a wydajność.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie krytycznej roli metadanych w strukturze systemu plików oraz podatności systemów bezkronikowych na awarie zasilania.
  • Praktyczna znajomość mechanizmu transakcyjnego w dzienniku ext4 (has_journal) zapewniającego atomowość operacji.
  • Empiryczne wykazanie przewagi czasowej mechanizmu journal replay nad pełnym skanowaniem drzewa i-węzłów w e2fsck.
  • Świadomość kompromisów wydajnościowych pomiędzy trybami data=journal, data=ordered oraz data=writeback.
Zadanie 6 - ilustracja
07/10
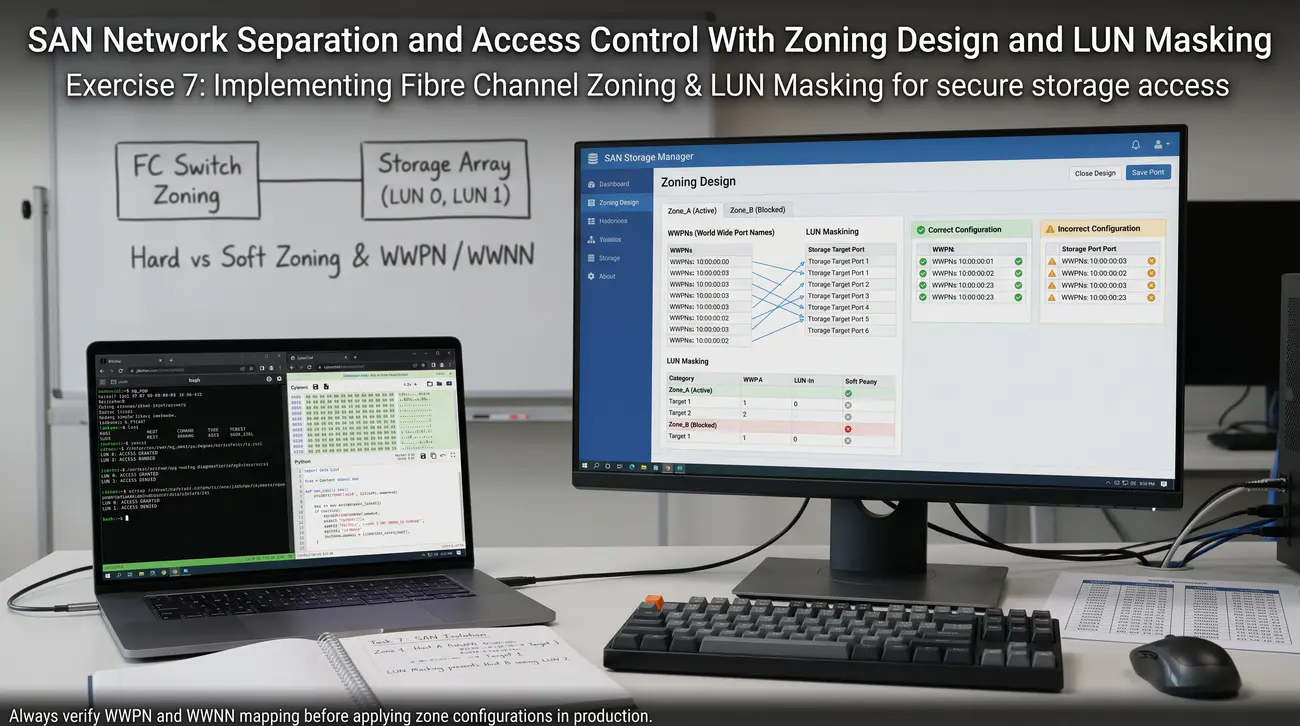
Zadanie 7. Separacja i kontrola dostępu w sieciach SAN: projektowanie strefowania (Zoning) oraz maskowania jednostek LUN
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka + CyberChef + Python 3
Podstawa wykładowa: Część 6 - slajdy 28, 29, 32, 33, 35: technologia Fibre Channel SAN, identyfikatory WWNN i WWPN, separacja ruchu poprzez strefowanie (Hard Zoning vs Soft Zoning) oraz ochrona jednostek pamięci poprzez LUN Masking.

Cel

Celem zadania jest opanowanie technik bezpiecznej izolacji zasobów dyskowych w sieciach pamięci masowej SAN. Student projektuje schemat strefowania (Zoning) na poziomie przełączników Fibre Channel, definiuje reguły maskowania LUN (LUN Masking) w macierzy dyskowej, zabezpieczając serwery przed nieuprawnionym dostępem do obcych wolumenów i konfliktami wielodostępu.

Scenariusz – opis

W rozległych środowiskach korporacyjnych infrastruktura sieci pamięci masowej SAN (Storage Area Network) jest współdzielona przez setki serwerów i macierzy. Brak mechanizmów ścisłej separacji ruchu mógłby doprowadzić do sytuacji, w której serwer bazodanowy uzyska dostęp do dysków klastra wirtualizacji i nadpisze jego dane. Podstawowym mechanizmem bezpieczeństwa i segmentacji na poziomie sieci przełączników Fibre Channel (FC fabric) jest strefowanie (Zoning).

Strefowanie dzieli sieć SAN na logiczne, izolowane strefy, wewnątrz których dozwolona jest bezpośrednia komunikacja pomiędzy określonymi portami N_Port. W praktyce inżynierskiej rozróżnia się strefowanie sprzętowe (Hard Zoning oparte na numerach fizycznych portów przełącznika) oraz programowe (Soft Zoning bazujące na unikalnych adresach WWPN). Adres WWPN (World Wide Port Name) jest 64-bitowym unikalnym identyfikatorem interfejsu HBA nadawanym fabrycznie przez producenta, analogicznie do adresu MAC.

Złotą zasadą projektowania SAN jest reguła Single-Initiator Zoning, zgodnie z którą każda strefa zawiera dokładnie jeden port inicjatora oraz porty docelowe macierzy. Taki podział eliminuje niepotrzebny ruch rozgłoszeniowy RSCN (Registered State Change Notification) pomiędzy różnymi serwerami aplikacyjnymi. Uzupełnieniem strefowania realizowanym bezpośrednio na kontrolerze macierzy dyskowej jest mechanizm maskowania jednostek LUN (LUN Masking).

LUN Masking polega na precyzyjnym przypisaniu konkretnych numerów LUN wyłącznie do autoryzowanych adresów WWPN serwerów aplikacji. Połączenie strefowania na przełącznikach z maskowaniem w macierzy tworzy dwuwarstwową barierę chroniącą infrastrukturę przed błędami ludzkimi i atakami wewnątrz sieci.

W tym zadaniu zaprojektujesz kompletną mapę stref SAN dla klastra dwuwęzłowego, przeanalizujesz heksadecymalną strukturę WWPN i zweryfikujesz poprawność separacji.

Co ma wykonać student / grupa

Pracę rozpoczynasz od zapoznania się ze specyfikacją środowiska SAN obejmującego dwa serwery aplikacyjne (App1, App2) oraz jedną macierz dwukontrolerową (CtrlA, CtrlB). Analizujesz format 64-bitowych adresów WWPN urządzeń, zapisanych jako osiem dwuznakowych bajtów szesnastkowych oddzielonych dwukropkami. Wklejasz przykładowe identyfikatory WWPN do narzędzia CyberChef, dekodując prefiks OUI (Organizationally Unique Identifier) i weryfikując producenta karty HBA. Projektujesz schemat strefowania zgodnie z zasadą Single-Initiator Zoning, tworząc cztery odrębne strefy zapewniające pełną redundancję ścieżek dostępu. Definiujesz konfigurację stref w dedykowanym formacie składniowym przełączników Brocade Fabric OS / Cisco MDS.

W kolejnym kroku przechodzisz do warstwy macierzy dyskowej i projektujesz reguły maskowania LUN (LUN Masking). Przypisujesz wolumen LUN 10 (baza danych) wyłącznie do inicjatorów serwera App1, a wolumen LUN 20 (magazyn plików) do inicjatorów serwera App2. Weryfikujesz, że serwer App2 w żadnych warunkach nie otrzyma rozkazu SCSI Inquiry dla jednostki LUN 10. Symulujesz próbę ataku polegającego na podszyciu się pod obcy adres WWPN (WWPN spoofing) i wskazujesz konieczność stosowania uwierzytelniania FC-SP (Fibre Channel Security Protocol). W terminalu JSLinux Fedora 33 (Linux) Console tworzysz skrypt w języku Python weryfikujący poprawność zdefiniowanych stref i wykrywający naruszenia zasady Single-Initiator. Sporządzasz pełną dokumentację projektu z diagramem logicznym, tabelą adresów WWPN oraz zestawieniem reguł kontroli dostępu do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. Otwórz w przeglądarce serwis CyberChef (gchq.github.io/CyberChef).
  2. Wklej do panelu Input przykładowy adres WWPN inicjatora HBA: 21:00:00:24:ff:5b:12:34.
  3. Zbadaj strukturę 8 bajtów WWPN: bajty 0-1 (rezerwa/typ IEEE), bajty 2-4 (identyfikator producenta OUI), bajty 5-7 (unikalny numer seryjny karty).
  4. Otwórz terminal JSLinux Fedora 33 (Linux) Console (bellard.org/jslinux/vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256).
  5. Zdefiniuj dane wejściowe infrastruktury: 2 serwery z dwoma portami HBA każdy (SRV1_HBA1, SRV1_HBA2, SRV2_HBA1, SRV2_HBA2) oraz macierz z 2 portami (SAN_SPA, SAN_SPB).
  6. Opracuj nazewnictwo stref wg standardu enterprise: np. ZN_SRV1_HBA1_MACIERZ.
  7. Zbuduj plik konfiguracyjny strefowania dla przełącznika SAN (składnia Brocade): zoneCreate 'ZN_SRV1_HBA1', '21:00:00:24:ff:5b:12:34; 50:06:01:60:c6:00:aa:01'.
  8. Zdefiniuj strefę dla drugiego portu serwera 1: zoneCreate 'ZN_SRV1_HBA2', '21:00:00:24:ff:5b:12:35; 50:06:01:60:c6:00:aa:02'.
  9. Zdefiniuj analogiczne strefy Single-Initiator dla drugiego serwera aplikacji (SRV2).
  10. Połącz strefy w aktywny zbiór konfiguracyjny: cfgCreate 'CFG_PROD_FABRIC_A', 'ZN_SRV1_HBA1; ZN_SRV2_HBA1'.
  11. Zasymuluj aktywację konfiguracji poleceniem: cfgEnable 'CFG_PROD_FABRIC_A'.
  12. Przejdź do definicji maskowania LUN: utwórz Storage Group 'SG_DATABASE' dla SRV1 zawierającą LUN 1, LUN 2.
  13. Utwórz Storage Group 'SG_FILESHARE' dla SRV2 zawierającą LUN 3, LUN 4.
  14. Napisz krótki skrypt w Pythonie (walidator_san.py), który sprawdza, czy żaden LUN nie jest przypisany do obu grup równocześnie.
  15. Uruchom skrypt walidacyjny w JSLinux i upewnij się, że nie wykryto nakładania się uprawnień wielodostępu.
  16. Przeanalizuj zagrożenia wynikające z Soft Zoning (podatność na podszycie WWPN) w porównaniu do Hard Zoning na fizycznych portach przełącznika.
  17. Wykonaj zrzuty ekranu konfiguracji stref, wyników walidatora w Pythonie i schematu macierzy.
  18. Sformułuj podsumowanie opisujące rolę strefowania i maskowania LUN w zapobieganiu katastrofom w sieci SAN.

Kontrola zaliczenia (checklist):

  1. Zachowano projekt: schemat zoningu (min. 2 strefy, single-initiator) + tabela LUN maskingu per host z regułą deny-by-default.
  2. Dołączono 2–3 zrzuty/schematy z podpisami: diagram stref FC oraz tabela maskingowa kontrolera.
  3. Opisano w 2–3 zdaniach wybór metody (hard/soft zoning) i zasadę jednego inicjatora na strefę.
  4. Zapisano wnioski (3–5 zdań): zoning (transport) + masking (zasoby) jako dwie klamry, izolacja awarii i podsłuchu.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie kluczowej roli strefowania (Zoning) w segmentacji ruchu i izolacji awarii w sieciach Fibre Channel SAN.
  • Znajomość bezwzględnej reguły Single-Initiator Zoning jako standardu eliminującego niepożądany ruch rozgłoszeniowy między hostami.
  • Praktyczna umiejętność projektowania maskowania jednostek logicznych (LUN Masking) na poziomie kontrolera macierzy.
  • Świadomość konieczności łączenia mechanizmów warstwy transportowej (Zoning) z warstwą zasobów (LUN Masking) dla pełnej ochrony danych.
Zadanie 7 - ilustracja
08/10
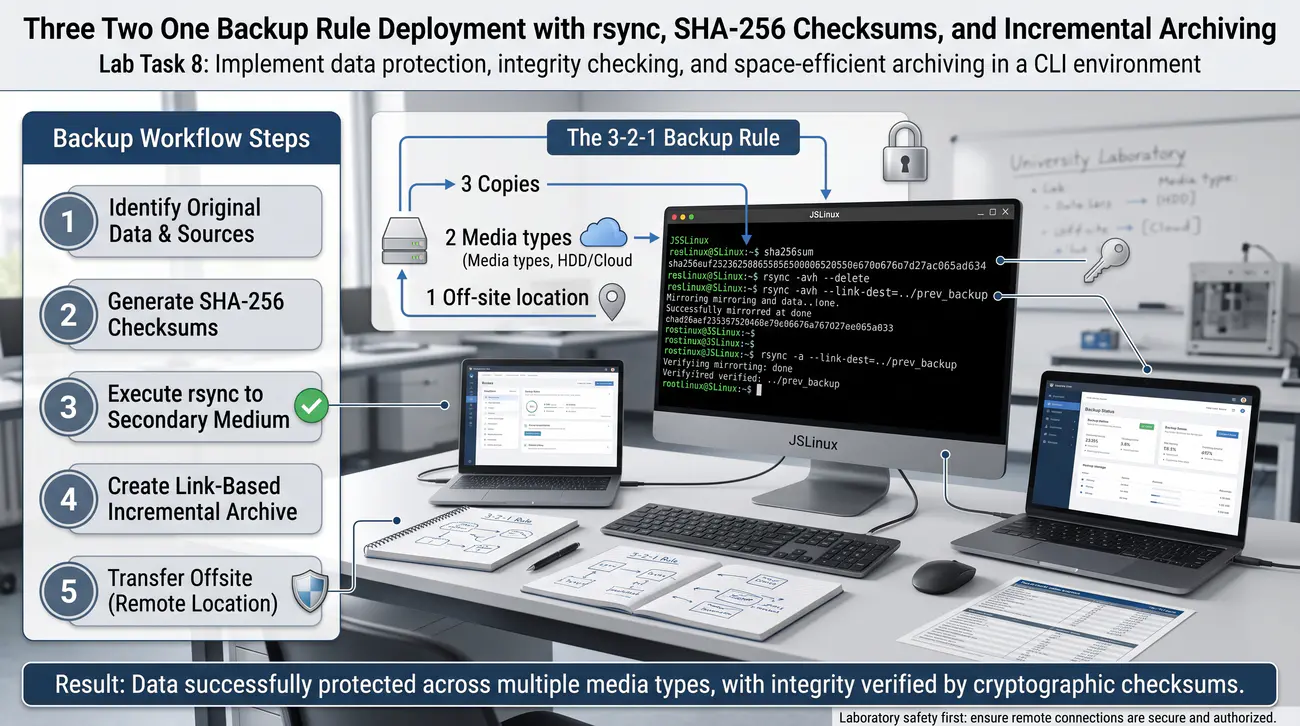
Zadanie 8. Wdrażanie reguły kopii zapasowych 3-2-1 z wykorzystaniem rsync, sum kontrolnych SHA-256 i archiwizacji przyrostowej
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 4, 12, 37, 38, 40: ochrona danych przed katastrofą, zasada RAID to nie backup, strategia 3-2-1, narzędzie synchronizacji rsync, sumy kontrolne SHA-256 i kopie przyrostowe z dowiązaniami twardymi.

Cel

Celem laboratorium jest praktyczne wdrożenie kanonicznej strategii bezpieczeństwa danych 3-2-1 (3 kopie, 2 różne nośniki, 1 lokalizacja zdalna). Student projektuje procedurę automatycznej synchronizacji katalogów narzędziem rsync, buduje mechanizm kopii przyrostowych z wykorzystaniem twardych dowiązań (hard links) oraz weryfikuje integralność zarchiwizowanych zbiorów za pomocą skrótów SHA-256.

Scenariusz – opis

Nawet najbardziej zaawansowana macierz dyskowa RAID nie chroni danych przed przypadkowym usunięciem, atakiem złośliwego oprogramowania ransomware czy pożarem serwerowni. Prawdziwe bezpieczeństwo informacji wymaga wdrożenia przemyślanej polityki tworzenia kopii zapasowych, której uniwersalnym standardem jest reguła 3-2-1. Zgodnie z tą regułą organizacja musi posiadać co najmniej trzy egzemplarze ważnych danych: oryginał roboczy oraz dwie niezależne kopie zapasowe.

Kopie te powinny spoczywać na co najmniej dwóch różnych typach nośników (np. macierz dyskowa i taśma magnetyczna LTO lub nośnik chmurowy). Co najmniej jeden egzemplarz danych musi znajdować się poza głównym ośrodkiem przetwarzania (off-site), chroniąc firmę przed skutkami katastrofy fizycznej. W systemach linuksowych podstawowym narzędziem do realizacji wydajnych kopii zapasowych jest uniksowy program rsync.

Program rsync wykorzystuje algorytm delta-transfer, przesyłając wyłącznie zmienione bloki plików, co drastycznie redukuje obciążenie łączy sieciowych. Wykorzystując mechanizm twardych dowiązań (--link-dest), rsync umożliwia tworzenie pozornych kopii pełnych, które fizycznie zajmują przestrzeń jedynie dla plików zmodyfikowanych. Każda wykonana kopia zapasowa jest bezużyteczna, jeśli nie zostanie zweryfikowana pod kątem integralności zapisanych danych. Okresowe obliczanie i porównywanie skrótów kryptograficznych SHA-256 gwarantuje, że pliki w archiwum nie uległy cichej degradacji ani złośliwej modyfikacji.

W tym zadaniu zbudujesz skrypt realizujący strategię 3-2-1, zasymulujesz zmiany w plikach i przeprowadzisz pełną weryfikację odtworzeniową.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia struktury katalogów symulującej środowisko produkcyjne w terminalu emulatora JSLinux Fedora 33 (Linux) Console. Tworzysz katalog źródłowy /dane_produkcyjne oraz dwa niezależne katalogi docelowe: /backup_lokalny oraz /backup_zdalny_offsite. W katalogu źródłowym generujesz zestaw plików testowych zawierających dokumenty tekstowe, binarne oraz bazy danych. Wykonujesz pierwszą pełną kopię zapasową do katalogu lokalnego za pomocą polecenia rsync z zachowaniem uprawnień, czasów modyfikacji i sum kontrolnych.

Generujesz bazę skrótów SHA-256 dla wszystkich plików źródłowych i zapisujesz ją do pliku manifest.sha256. Kopiujesz archiwum pełne wraz z plikiem sum do katalogu symulującego lokalizację zdalną off-site (kopia numer 3).

Następnie symulujesz normalny dzień pracy w organizacji: modyfikujesz treść jednego pliku, dodajesz nowy dokument oraz usuwasz plik archiwalny. Uruchamiasz rsync w trybie kopii przyrostowej z parametrem --link-dest wskazującym na wczorajszy katalog backupu. Sprawdzasz za pomocą polecenia ls-l i stat, że niezmienione pliki posiadają identyczne numery i-węzłów (twarde dowiązania), nie zużywając nowej przestrzeni dyskowej. Zasymulujesz awarię polegającą na uszkodzeniu danych produkcyjnych (nadpisanie pliku przypadkowymi danymi) i weryfikujesz usterkę poleceniem sha256sum-c. Przeprowadzasz procedurę odtworzenia utraconych danych z kopii zapasowej (Disaster Recovery), potwierdzając powrót do pełnej spójności operacyjnej.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console zainstaluj rsync: dnf install -y rsync.
  2. Utwórz strukturę katalogów roboczych: mkdir -p ~/lab_backup/{prod,repo_lokalne,repo_zdalne} && cd ~/lab_backup.
  3. Wygeneruj pliki produkcyjne: echo 'Projekt poufny v1' > prod/projekt.docx && dd if=/dev/urandom of=prod/baza.db bs=1k count=50.
  4. Utwórz sumy kontrolne SHA-256 danych źródłowych: cd prod &&sha256sum * >../manifest_v1.sha256 && cd ..
  5. Wykonaj pierwszą pełną kopię lokalną: rsync -av --checksum prod/ repo_lokalne/kopia_dostepna_v1/.
  6. Zasymuluj przesłanie kopii do lokalizacji zdalnej off-site: rsync -av repo_lokalne/kopia_dostepna_v1/ repo_zdalne/kopia_offsite_v1/.
  7. Wprowadź zmiany w środowisku produkcyjnym: echo 'Wprowadzono poprawki bezpieczenstwa' >> prod/projekt.docx && echo 'Nowy plik' > prod/nowy.txt.
  8. Wykonaj kopię przyrostową z wykorzystaniem mechanizmu hard-links: rsync -av --link-dest=../kopia_dostepna_v1 prod/ repo_lokalne/kopia_przyrostowa_v2/.
  9. Sprawdź numery i-węzłów pliku baza.db w obu kopiach: ls -i repo_lokalne/kopia_dostepna_v1/baza.db repo_lokalne/kopia_przyrostowa_v2/baza.db.
  10. Potwierdź, że oba pliki współdzielą ten sam i-węzeł (brak duplikacji danych na dysku).
  11. Sprawdź plik projekt.docx i upewnij się, że posiada odrębny i-węzeł ze względu na modyfikację treści.
  12. Zasymuluj incydent utraty danych produkcyjnych: rm -f prod/projekt.docx && echo 'ZASZYFROWANO' > prod/baza.db.
  13. Wykryj uszkodzenie danych poleceniem weryfikacji sum kontrolnych: sha256sum -c manifest_v1.sha256 || echo 'Wykryto niezgodnosc integralnosci!'.
  14. Przeprowadź odtworzenie danych ze zdrowej kopii lokalnej: rsync -av repo_lokalne/kopia_przyrostowa_v2/ prod/.
  15. Sprawdź ponownie integralność odzyskanych danych: test -f prod/projekt.docx && echo 'Odtwarzanie zakonczone sukcesem'.
  16. Zbuduj prosty skrypt backup_auto.sh automatyzujący tworzenie katalogów z datą i sumowaniem SHA-256.
  17. Wykonaj zrzuty ekranu prezentujące dowiązania twarde i-węzłów oraz proces wykrycia niezgodności sumy SHA-256.
  18. Sformułuj wnioski wyjaśniające, dlaczego macierze RAID nie eliminują konieczności wdrożenia reguły 3-2-1.

Kontrola zaliczenia (checklist):

  1. Wdrożono 3-2-1 i zachowano log: 3 kopie (prod + lokalna + zdalna), rsync przyrostowy z hard-linkami, manifest SHA-256 każdej kopii.
  2. Dołączono 2–3 zrzuty z podpisami: rsync -a --link-dest, porównanie manifestów oraz test odtworzenia 1 pliku.
  3. Opisano w 2–3 zdaniach wybór narzędzi (rsync, sha256sum) i harmonogram przyrostowych.
  4. Zapisano wnioski (3–5 zdań): RAID to nie backup, 3-2-1 vs ransomware/pożar, hard-linki jako tanie wersjonowanie.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie fundamentalnej zasady architektury bezpieczeństwa: RAID to nie backup.
  • Praktyczna znajomość reguły 3-2-1 gwarantującej odporność na lokalne awarie, ransomware i katastrofy fizyczne.
  • Opanowanie techniki wydajnych kopii przyrostowych w oparciu o narzędzie rsync i mechanizm twardych dowiązań (hard links).
  • Umiejętność walidacji integralności kopii archiwalnych za pomocą kryptograficznych sum kontrolnych SHA-256.
Zadanie 8 - ilustracja
09/10
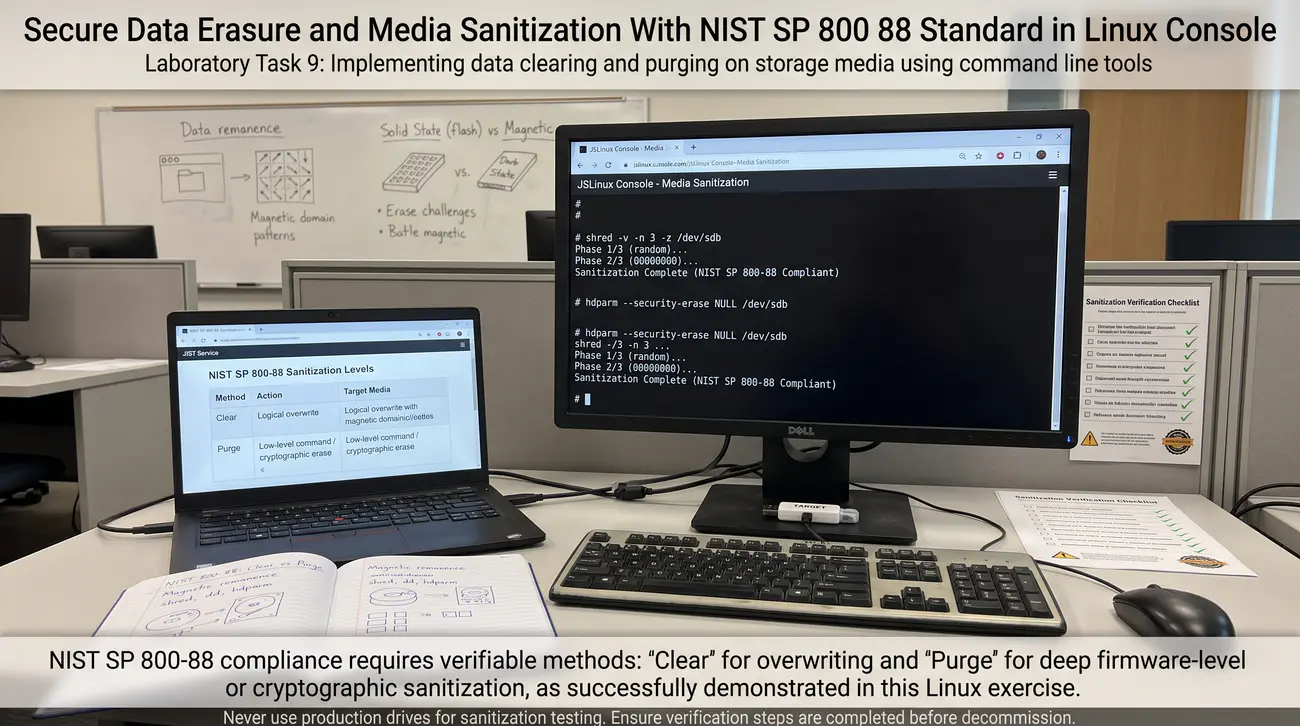
Zadanie 9. Bezpieczne kasowanie danych i czyszczenie nośników (data wiping, standard NIST SP 800-88) w konsoli Linux
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 6, 11, 35, 40: trwałość danych na nośnikach magnetycznych i półprzewodnikowych, zjawisko remanencji danych, wytyczne oczyszczania nośników NIST SP 800-88 (Clear vs Purge), narzędzia dd i shred.

Cel

Celem zadania jest zbadanie zjawiska remanencji danych oraz opanowanie procedur trwałego niszczenia informacji na wycofywanych nośnikach zgodnie z zaleceniami normy NIST SP 800-88 Rev. 1. Student analizuje pozostałości danych po standardowym usunięciu pliku (unlink), implementuje procedury nadpisywania zerami oraz wzorcami pseudolosowymi za pomocą narzędzi dd i shred, a także weryfikuje skuteczność czyszczenia za pomocą heksadecymalnego podglądu sektorów.

Scenariusz – opis

Wycofanie serwera z eksploatacji, zwrot dysku w ramach gwarancji lub przekazanie komputera innemu działowi wiąże się z ryzykiem wycieku danych. Zwykłe usunięcie pliku za pomocą polecenia rm lub sformatowanie dysku usuwa jedynie wskaźniki w systemie plików, pozostawiając zawartość nienaruszoną. Zjawisko pozostawania danych na nośnikach fizycznych określa się mianem remanencji danych (Data Remanence). Dowolna osoba posiadająca darmowe narzędzia do odzyskiwania danych (takie jak TestDisk czy photorec) może bez trudu odzyskać usunięte informacje.

Standard amerykańskiego instytutu standaryzacji NIST SP 800-88 Rev. 1 definiuje trzy formalne poziomy oczyszczania nośników: Clear, Purge oraz Destroy. Poziom Clear polega na logicznym nadpisaniu wszystkich dostępnych sektorów nośnika standardowymi komendami zapisu (np. pojedynczy przebieg zerami). Poziom Purge wymaga zastosowania zaawansowanych poleceń wewnętrznych kontrolera (np.

ATA Secure Erase lub NVMe Crypto Erase) usuwających również sektory zablokowane i realokowane. Poziom Destroy oznacza fizyczną destrukcję nośnika poprzez mechaniczne zmielenie (shredding), spalenie lub demagnetyzację w degausserze. W środowiskach linuksowych do procedur poziomu Clear wykorzystuje się narzędzia dd oraz wyspecjalizowany program shred. Zrozumienie różnic pomiędzy nośnikami HDD a SSD jest tu kluczowe, gdyż mechanizm Wear Leveling w pamięciach flash utrudnia celowane nadpisywanie sektorów.

W tym zadaniu sprawdzisz pozostałości po usunięciu plików, przeprowadzisz wielokrotne nadpisywanie narzędziem shred i potwierdzisz czystość nośnika.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia wirtualnego dysku laboratoryjnego w emulatorze JSLinux Fedora 33 (Linux) Console za pomocą polecenia dd. Tworzysz obraz o rozmiarze 20 megabajtów o nazwie dysk_tajny.img i podłączasz go jako urządzenie blokowe /dev/loop0. Zakładasz na nim system plików ext4, montujesz go w katalogu /mnt/czyszczenie i zapisujesz plik zawierający wrażliwe dane tekstowe. Usuwasz plik standardowym poleceniem rm i odmontowujesz system plików.

Uruchamiasz narzędzie hexdump lub strings bezpośrednio na surowym urządzeniu /dev/loop0, wykazując, że poufny tekst jawny nadal spoczywa na dysku. Przeprowadzasz procedurę czyszczenia poziomu Clear zgodnie z NIST SP 800-88 za pomocą jednokrotnego nadpisania całego wolumenu zerami z /dev/zero. Ponownie przeszukujesz urządzenie hexdumpem, weryfikując, że wszystkie bajty przyjęły wartość 0x00 i odzyskanie pliku stało się niemożliwe.

W kolejnym kroku zapisujesz na nowo spreparowany wolumen i uruchamiasz program shred z opcją 3 przebiegów pseudolosowych oraz końcowego zerowania (-u -z -n 3). Analizujesz narzut czasowy operacji kryptograficznego nadpisywania w porównaniu z pojedynczym zerowaniem dysku. Omawiasz specyfikę bezpiecznego niszczenia danych na dyskach półprzewodnikowych SSD, wyjaśniając działanie komendy TRIM oraz techniki Crypto-Erase. Dokumentujesz zrzuty ekranu podglądu heksadecymalnego przed i po czyszczeniu oraz sporządzasz protokół utylizacji nośnika do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console sprawdź/uzupełnij niezbędne narzędzia (w Fedorze są domyślnie): dnf install -y coreutils util-linux.
  2. Utwórz wirtualny wolumen o rozmiarze 20 MB: dd if=/dev/zero of=~/tajny_dysk.img bs=1M count=20.
  3. Podłącz obraz do wolnego urządzenia loop: losetup /dev/loop0 ~/tajny_dysk.img.
  4. Sformatuj wolumen w systemie ext4: mkfs.ext4 /dev/loop0.
  5. Zamontuj urządzenie w katalogu testowym: mkdir -p /mnt/wipe && mount /dev/loop0 /mnt/wipe.
  6. Zapisz poufny plik tekstowy: echo 'DANE OSOBOWE PESEL: 99010112345 TAJNE HASLA BANKOWE' > /mnt/wipe/poufne.txt.
  7. Wymuś synchronizację buforów z dyskiem: sync.
  8. Wykonaj standardowe skasowanie pliku: rm -f /mnt/wipe/poufne.txt.
  9. Odmontuj wolumen: umount /mnt/wipe.
  10. Wyszukaj skasowany tekst na surowym urządzeniu blokowym: strings /dev/loop0 | grep 'PESEL'.
  11. Odnotuj, że dane są wciąż w pełni czytelne mimo ich skasowania w systemie operacyjnym.
  12. Zastosuj procedurę NIST SP 800-88 Clear (zerowanie nośnika): dd if=/dev/zero of=/dev/loop0 bs=1M status= progress || true.
  13. Sprawdź ponownie obecność danych: strings /dev/loop0 | grep 'PESEL' || echo 'Tekst nie istnieje - sukces'.
  14. Zweryfikuj zawartość pierwszych sektorów dysku: hexdump -C -n 512 /dev/loop0 (same zera 0x00).
  15. Zapisz nowy wzorzec danych na dysku i przetestuj narzędzie shred z 3 przebiegami losowymi i zerowaniem: shred -v -n 3 -z /dev/loop0.
  16. Przeanalizuj logi programu shred raportujące kolejne fazy nadpisywania (losowe bity, inwersja, zerowanie).
  17. Wykonaj zrzuty ekranu wyjścia polecenia strings potwierdzającego wyciek danych po rm oraz efektu końcowego po shred.
  18. Sporządź wzorcowy formularz 'Protokołu zniszczenia danych na nośniku cyfrowym' dla uczelnianego działu IT.

Kontrola zaliczenia (checklist):

  1. Wykonano czyszczenie i zachowano log: unlink vs shred/dd (przed/po, próba odzysku strings/foremost) z klasyfikacją NIST 800-88 (Clear/Purge/Destroy).
  2. Dołączono 2–3 zrzuty z podpisami: shred -v / dd if=/dev/urandom oraz weryfikacja braku odzysku.
  3. Opisano w 2–3 zdaniach wybór narzędzi i metody dla HDD vs SSD (FTL/over-provisioning).
  4. Zapisano wnioski (3–5 zdań): remanencja, rm nie chroni, SSD wymaga purge/destroy (szyfrowanie+niszczenie klucza).

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie zjawiska remanencji danych i nieskuteczności standardowego usuwania plików (unlink/rm) w ochronie poufności.
  • Praktyczna znajomość standardu NIST SP 800-88 Rev. 1 i podziału metod niszczenia na Clear, Purge i Destroy.
  • Umiejętność skutecznego stosowania narzędzi dd oraz shred do logicznego oczyszczania wolumenów blokowych.
  • Świadomość ograniczeń programowego nadpisywania na dyskach SSD wynikających z kontrolerów FTL i buforów Over-Provisioning.
Zadanie 9 - ilustracja
10/10
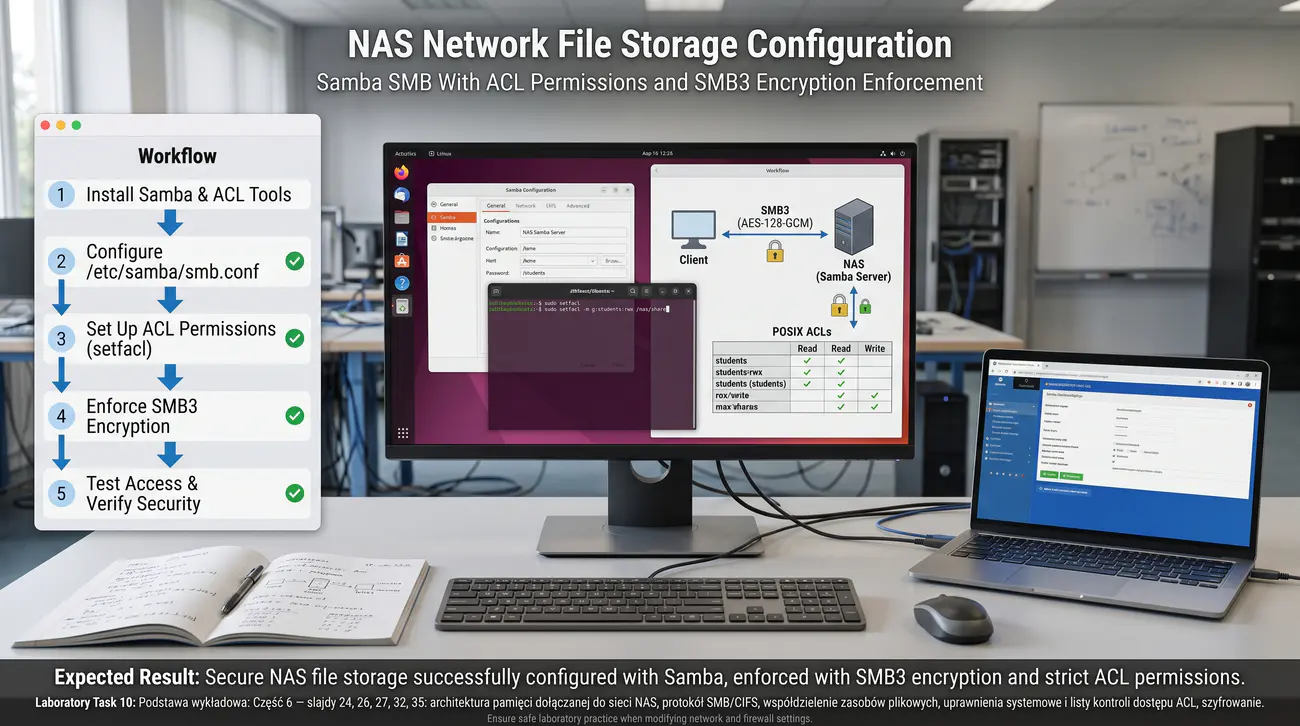
Zadanie 10. Konfiguracja sieciowego magazynu plikowego NAS (Samba / SMB) z uprawnieniami ACL i wymuszeniem szyfrowania SMB3
🖥️ Wymagane środowisko:
System: Windows (bez praw administratora) + JSLinux Fedora 33 (Linux) Console w przeglądarce
Oprogramowanie: przeglądarka
Podstawa wykładowa: Część 6 - slajdy 24, 26, 27, 32, 35: architektura pamięci dołączanej do sieci NAS, protokół SMB/CIFS, współdzielenie zasobów plikowych, uprawnienia systemowe i listy kontroli dostępu ACL, szyfrowanie transmisji SMBv3.

Cel

Celem zadania jest wdrożenie i zabezpieczenie serwera pamięci dołączanej do sieci (NAS) opartego na protokole SMB za pomocą pakietu Samba. Student konfiguruje bezpieczne udziały sieciowe z kontrolą uprawnień na poziomie użytkowników i grup, bada działanie list ACL oraz wymusza szyfrowanie transmisji w protokole SMBv3 w celu ochrony przesyłanych plików przed podsłuchem w sieci lokalnej.

Scenariusz – opis

Systemy pamięci dołączanej do sieci NAS (Network Attached Storage) stanowią najpopularniejsze rozwiązanie współdzielenia plików w sieciach lokalnych. W przeciwieństwie do sieci SAN operujących na surowych blokach, urządzenia NAS udostępniają zasoby na poziomie abstrakcji plików i katalogów. Klienci komunikują się z serwerem NAS za pomocą protokołów sieciowych systemów plików, takich jak NFS w środowiskach uniksowych lub SMB/CIFS w sieciach Windows.

W systemach linuksowych serwerem protokołu SMB kompatybilnym ze środowiskiem Microsoft Active Directory jest pakiet oprogramowania Samba. Współczesne wdrożenia NAS wymagają precyzyjnej polityki bezpieczeństwa łączącej uprawnienia udziału (share permissions) z uprawnieniami systemu plików. Standardowe uprawnienia POSIX (odczyt, zapis, wykonanie dla właściciela, grupy i innych) są niewystarczające w złożonych strukturach organizacyjnych.

Dlatego nowoczesne serwery NAS wykorzystują rozszerzone listy kontroli dostępu POSIX ACL, pozwalające definiować uprawnienia dla wielu użytkowników i grup. Tradycyjne wersje protokołu SMB (SMBv1 oraz SMBv2) przesyłały pliki otwartym tekstem, narażając organizację na ataki podsłuchu i modyfikacji w locie. Wprowadzony w systemie Windows 8 i Samba 4 protokół SMBv3 wprowadził natywne, wydajne szyfrowanie całej sesji za pomocą algorytmów AES-CCM oraz AES-GCM. Wymuszenie parametru server smb encrypt = mandatory gwarantuje, że żaden niezaszyfrowany pakiet danych nie opuści serwera NAS.

W tym ćwiczeniu skonfigurujesz bezpieczny plik smb.conf, utworzysz użytkowników i grupy, nadasz uprawnienia ACL oraz zweryfikujesz wymuszenie szyfrowania sesji.

Co ma wykonać student / grupa

Rozpoczynasz ćwiczenie w terminalu JSLinux Fedora 33 (Linux) Console od zainstalowania pakietu serwera Samba oraz narzędzi list kontroli dostępu acl. Tworzysz w systemie strukturę katalogów dla dwóch działów: /magazyn_nas/kadry oraz /magazyn_nas/ogolny. Definiujesz w systemie operacyjnym konta użytkowników laboratoryjnych jan_kowalski oraz anna_nowak, przypisując ich do odpowiednich grup roboczych. Dodajesz utworzonych użytkowników do wewnętrznej bazy haseł serwera Samba za pomocą polecenia smbpasswd.

Przystępujesz do edycji głównego pliku konfiguracyjnego /etc/samba/smb.conf, definiując parametry globalne [global] oraz dwa udziały [kadry] i [publiczny]. W sekcji globalnej wymuszasz minimalny protokół SMB3 (server min protocol = SMB3) oraz obowiązkowe szyfrowanie (server smb encrypt = required). Dla udziału kadry konfigurujesz restrykcyjną listę dopuszczonych użytkowników valid users = @kadry oraz blokujesz dostęp anonimowy. Wykorzystujesz narzędzie setfacl, aby nadać precyzyjne uprawnienia do podkatalogów na poziomie systemu plików, wykraczające poza standardowe maski chmod.

Sprawdzasz poprawność składni pliku konfiguracyjnego za pomocą dedykowanego narzędzia testparm. Zasymulujesz proces połączenia klienta za pomocą smbclient, testując odmowę dostępu nieautoryzowanego użytkownika oraz poprawne uwierzytelnienie. Wszystkie fragmenty plików konfiguracyjnych smb.conf, polecenia setfacl oraz raporty narzędzia testparm włączasz do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu JSLinux Fedora 33 (Linux) Console zainstaluj serwer Samba i narzędzia ACL: dnf install -y samba acl.
  2. Utwórz strukturę folderów dla zasobów NAS: mkdir -p /srv/nas/{kadry,publiczny}.
  3. Utwórz grupy systemowe (składnia Fedory, nie Alpine addgroup): groupadd kadry &&groupadd pracownicy.
  4. Utwórz użytkowników laboratoryjnych (składnia Fedory, nie Alpine adduser -D): useradd -m -G kadry jan_kadry && useradd -m -G pracownicy piotr_stażysta.
  5. Dodaj użytkowników do bazy danych Samba z hasłami: smbpasswd -a jan_kadry && smbpasswd -a piotr_stażysta.
  6. Utwórz plik konfiguracyjny /etc/samba/smb.conf z sekcją [global].
  7. W sekcji [global] wymuś protokół SMB3 i szyfrowanie: server min protocol = SMB3_00, server smb encrypt = required.
  8. Zdefiniuj udział [kadry] z prawem dostępu wyłącznie dla grupy kadry: valid users = @kadry, read only = no.
  9. Zdefiniuj udział [publiczny] dostępny dla wszystkich pracowników w trybie do odczytu.
  10. Ustaw uprawnienia POSIX na katalogach: chmod 770 /srv/nas/kadry && chown root:kadry /srv/nas/kadry.
  11. Ustaw rozszerzoną listę kontroli dostępu ACL na katalogu kadry: setfacl -m u:jan_kadry:rwx /srv/nas/kadry.
  12. Sprawdź nadane uprawnienia rozszerzone poleceniem: getfacl /srv/nas/kadry.
  13. Zweryfikuj poprawność składni pliku konfiguracyjnego: testparm -s.
  14. Uruchom demony serwera Samba w Fedorze (systemd, nie Alpine rc-service): systemctl start smb nmb (lub awaryjnie w tle: smbd -D).
  15. Przetestuj listowanie udziałów jako klient: smbclient -L localhost -U jan_kadry.
  16. Sprawdź odmowę dostępu dla użytkownika piotr_stażysta przy próbie połączenia z zasobem kadry: smbclient //localhost/kadry -U piotr_stażysta.
  17. Wykonaj zrzuty ekranu pliku smb.conf, wyniku testparm oraz poleceń getfacl i smbclient.
  18. Sporządź tabelę porównawczą protokołów NAS (NFSv4 vs SMBv3) ze szczególnym uwzględnieniem mechanizmów kryptograficznych.

Kontrola zaliczenia (checklist):

  1. Zbudowano udział NAS i zachowano log: Samba SMB3 z użytkownikami/grupami, ACL POSIX, wymuszone szyfrowanie (smbstatus pokazuje AES-CCM/GCM), testparm bez błędów.
  2. Dołączono 2–3 zrzuty z podpisami: smb.conf (udział), setfacl/getfacl oraz sesja klienta z szyfrowaniem.
  3. Opisano w 2–3 zdaniach wybór narzędzi (Samba, testparm) i mapowanie uprawnień udziału na FS.
  4. Zapisano wnioski (3–5 zdań): NAS plikowy vs SAN, ACL jako druga klamra, SMB3 szyfruje podsłuch.

Wariant offline (fallback): Brak JSLinux/mdadm: symulacja na plikach-obrazie w lokalnym Linux/WSL lub opis z cache + obliczenia pojemności na kalkulatorze; dołącz log komend, pliki .img i zrzuty smartctl/mdadm/rsync.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie architektury plikowego magazynu danych NAS i roli protokołu SMB w sieciach lokalnych.
  • Umiejętność łączenia uprawnień udziału sieciowego z uprawnieniami systemu plików i listami kontroli dostępu POSIX ACL.
  • Praktyczna znajomość konfiguracji wymuszonego szyfrowania sesji SMBv3 (AES-CCM/AES-GCM) eliminującego podsłuch ruchu.
  • Świadomość roli narzędzia testparm w audycie bezpieczeństwa i weryfikacji reguł dostępu do serwera Samba.
Zadanie 10 - ilustracja
Podgląd