Laboratorium 6
Zadania laboratoryjne dla studentów 7 semestru IT - ocena 4.0

Poziom: ocena 4.0 - programowanie algorytmów macierzy, deduplikacja i kryptografia dyskowa

Zestaw 10 praktycznych zadań laboratoryjnych do wykonania w trakcie zajęć (90–100 minut).
Kierunek: Informatyka, semestr 7, przedmiot: Kryptologia.
Podstawa materiałowa: wykład część 6 (sieciowe systemy składowania danych: SAN, NAS i macierze RAID).

Wskazówki dla studenta i zasady realizacji:

  • Zadania na ocenę 4.0 wymagają samodzielnej implementacji algorytmów oraz niskopoziomowej analizy struktur danych w języku Python: programowej implementacji RAID 5 z operacją XOR i rotacją parzystości left-symmetric, wyliczania podwójnej parzystości P+Q macierzy RAID 6 z wykorzystaniem ciał Galois GF(2^8) i kodów Reeda-Solomona, binarnego parsowania nagłówków wolumenów LUKS1/LUKS2 za pomocą modułu struct i dekodowania JSON, algorytmów krojenia danych FSC/CDC oraz deduplikacji blokowej z sumami SHA-256, zbieżnego szyfrowania (Convergent Encryption) umożliwiającego deduplikację w chmurze, wykrywania cichej degradacji (Bit Rot) i weryfikacji drzewa Merkle Tree, symulacji migawek Copy-on-Write (CoW) z translacją wskaźników bloków, dekonstrukcji handshake'u uwierzytelniania CHAP/Mutual-CHAP w iSCSI, matematycznego modelowania niezawodności MTTDL i ryzyka błędu URE podczas odbudowy RAID 5 oraz implementacji trybu szyfrowania dyskowego IEEE 1619 AES-XTS z wektorem tweak w GF(2^128) i demonstracją braku integralności.
  • Wszystkie zadania są w pełni wykonalne bez praw administratora na systemie Windows - wymagają standardowego środowiska Python 3 z bibliotekami standardowymi oraz opcjonalnie pakietem cryptography/pycryptodome w konsoli JSLinux Fedora 33 (Linux) Console lub na lokalnej stacji roboczej. W tym laboratorium stosujemy wersję systemu „Fedora 33 (Linux) Console” ze strony https://bellard.org/jslinux/ (start: vm.html?cpu=riscv64&url=fedora33-riscv.cfg&mem=256, CPU riscv64, 256 MB RAM, Console). Dla spójności z częścią 3.0 nie stosujemy tu Alpine Linux. Uwaga: Fedora riscv64 bootuje dłużej — poczekaj na login i pracuj jako root.
  • Każde zadanie realizowane jest w czasie 90–100 minut w trakcie zajęć laboratoryjnych.
  • Wymagania formalne sprawozdania laboratoryjnego:
    • Strona tytułowa zawierająca: imię i nazwisko studenta, numer albumu, kierunek, semestr, grupę laboratoryjną, rok akademicki, numer i temat laboratorium, numer oraz nazwę realizowanego zadania, deklarowaną ocenę (4.0).
    • Opis konfiguracji środowiska badawczego, wersji bibliotek oraz wykorzystanych poleceń.
    • Szczegółowy opis wykonanych czynności, uzasadnienie wyboru narzędzi, kod źródłowy autorskich skryptów w Pythonie, zrzuty ekranu oraz wklejone fragmenty danych wejściowych i wyjściowych dokumentujące rzetelne wykonanie pracy.
    • Struktura raportu: spis treści, spis ilustracji (z numerami i podpisami), spis tabel (z numerami i podpisami) oraz wykaz źródeł literaturowych i internetowych.
Kryptologia
lab 6 - 4.0
Spis
Spis zadań laboratoryjnych na ocenę 4.0
01/10
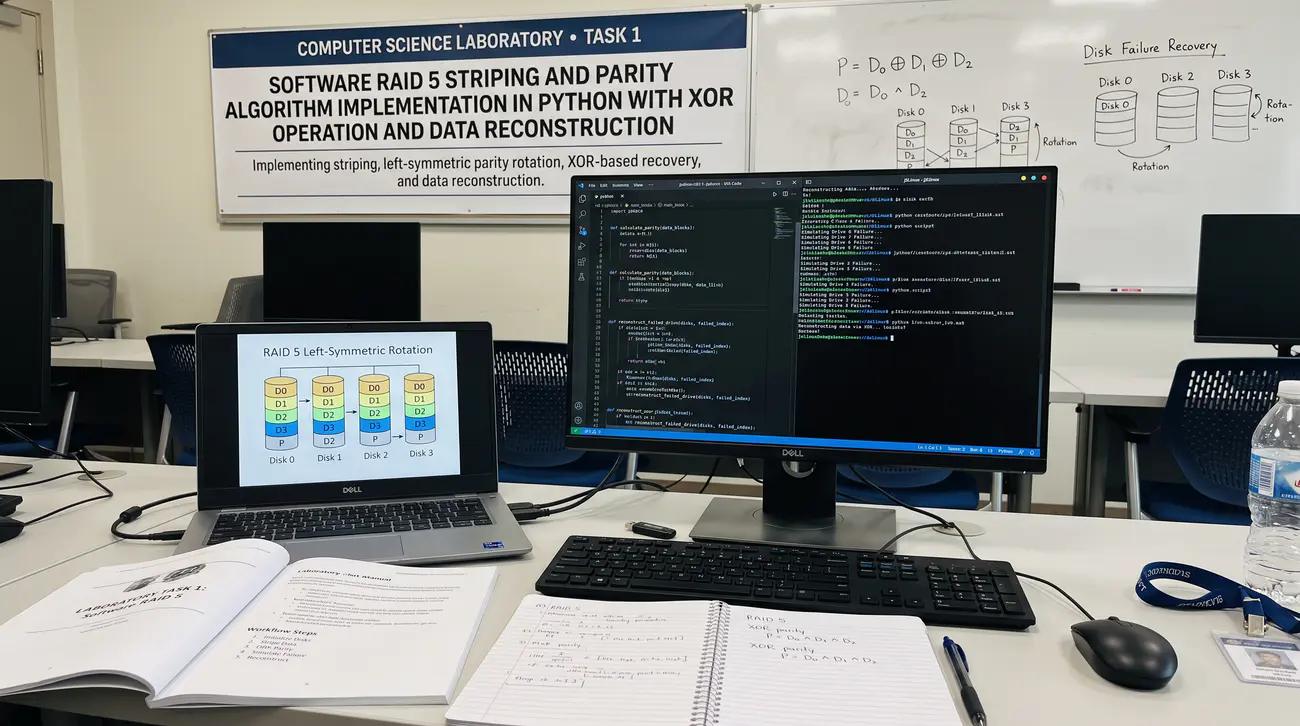
Zadanie 1. Programowa implementacja algorytmu paskowania i parzystości RAID 5 w Pythonie (operacja XOR i rekonstrukcja danych)
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 13, 16, 20, 23: poziom RAID 5, rotacja bloków parzystości (left-symmetric), funkcja sumy kontrolnej XOR, obliczanie bloku parzystości P, odzyskiwanie uszkodzonego bloku z pozostałych dysków, implementacja w Pythonie.

Cel

Celem zadania jest samodzielne zaimplementowanie w języku Python programowego symulatora macierzy RAID 5. Student tworzy mechanizm podziału strumienia bajtów na paski (striping), implementuje wyliczanie bloków parzystości za pomocą operacji bitowej XOR z rotacją lewostronną (left-symmetric), symuluje utratę dowolnego dysku oraz programowo rekonstruuje utracone dane.

Scenariusz – opis

Macierz RAID 5 stanowi jeden z najważniejszych kamieni milowych w rozwoju architektur pamięci masowych wysokiej dostępności. Jej konstrukcja opiera się na rozproszeniu bloków parzystości pomiędzy wszystkie fizyczne nośniki tworzące grupę macierzową. Dzięki wyeliminowaniu pojedynczego dedykowanego dysku parzystości znanego z RAID 4 uniknięto wąskiego gardła podczas operacji zapisu.

Matematyczną podstawą generowania bloku parzystości P jest operacja alternatywy rozłącznej XOR wykonywana na odpowiadających sobie blokach danych. Właściwość inwolucji i łączności operacji XOR sprawia, że mając dany blok parzystości oraz n minus jeden bloków danych, brakujący blok odzyskuje się natychmiastowo. W implementacjach produkcyjnych standardem jest rotacja lewostronna symetryczna określana w dokumentacji jądra Linux jako left-symmetric.

W układzie tym w każdym kolejnym pasku logicznym (stripe) blok parzystości przesuwa się cyklicznie o jeden dysk w lewo. Zrozumienie niskopoziomowego formatu ułożenia danych pozwala programistom diagnozować uszkodzenia systemów plików i budować narzędzia odzyskiwania danych. Programowa symulacja takiego podsystemu w języku Python pozwala prześledzić każdy krok operacji wejścia-wyjścia na poziomie pojedynczych bajtów. Student poznaje mechanizm przetwarzania tablic bajtowych bytearray oraz symulacji wirtualnych nośników pamięci jako plików binarnych.

W tym zadaniu zbudujesz w pełni funkcjonalny skrypt implementujący logikę zapisu, odczytu oraz procedurę rekonstrukcji po awarii w architekturze RAID 5.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia katalogu roboczego raid5_python w środowisku roboczym lub emulatorze JSLinux Fedora 33 (Linux) Console. Tworzysz skrypt raid5_engine.py i definiujesz w nim klasę wirtualnej macierzy parametryzowaną liczbą dysków oraz rozmiarem paska stripe_size. Inicjalizujesz cztery wirtualne pliki dyskowe dysk_0.bin, dysk_1.bin, dysk_2.bin oraz dysk_3.bin wypełnione zerami binarnymi. Implementujesz funkcję pomocniczą xor_blocks, która przyjmuje listę obiektów bytes o identycznej długości i zwraca ich sumę bitową XOR.

Tworzysz metodę zapisu write_data, która dzieli wejściowy bufor danych na fragmenty o rozmiarze stripe_size i wyznacza dysk parzystości wg schematu left-symmetric. Dla każdego paska obliczasz blok parzystości P i zapisujesz odpowiednie fragmenty do skojarzonych plików dyskowych. Przygotowujesz plik testowy o objętości kilku kilobajtów, zapisujesz go do wirtualnej macierzy i weryfikujesz poprawność odczytu w normalnym trybie pracy.

Następnie symulujesz fizyczne zniszczenie jednego z nośników poprzez celowe usunięcie lub nadpisanie zerami pliku dysk_1.bin. Uruchamiasz napisaną procedurę rekonstrukcji rebuild_disk, która iteruje po wszystkich paskach macierzy i odzyskuje zawartość uszkodzonego dysku operacją XOR. Porównujesz odtworzony plik dysk_1.bin z pierwotną zawartością przed awarią za pomocą funkcji hashlib.sha256 w Pythonie. Dokumentujesz poprawność odzyskania danych z dokładnością do pojedynczego bajtu oraz dołączasz kod źródłowy skryptu do sprawozdania.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/raid5_dev && cd ~/raid5_dev.
  2. Utwórz plik skryptu w języku Python: nano raid5_engine.py.
  3. Zaimportuj niezbędne moduły standardowe: os, sys, hashlib.
  4. Zdefiniuj funkcję xor_blocks( blocks) wykonującą operację bajt po bajcie za pomocą bytearray.
  5. Zdefiniuj klasę VirtualRAID5 z parametrami num_disks=4 i stripe_size=64.
  6. Zaimplementuj metodę init_disks() tworzącą 4 pliki binarne o stałej pojemności w podkatalogu disks/.
  7. Zaimplementuj metodę write_stream( data) dzielącą strumień na fragmenty po 3 bloki danych (dla 4 dysków) i 1 blok parzystości.
  8. Zaimplementuj rotację parzystości left-symmetric: parity_disk = (num_disks - 1) - (stripe_index % num_disks).
  9. Zapisz dane i parzystość do odpowiednich plików dyskowych.
  10. Zaimplementuj metodę read_stream( length) odczytującą i składającą strumień danych z pominięciem bloków parzystości.
  11. Zapisz w macierzy próbkę danych: 'Projekt bezpiecznego repozytorium kryptograficznego semestr 7 UAFM'.
  12. Oblicz skrót SHA-256 wprowadzonych danych i zapamiętaj wartość wzorcową.
  13. Zasymuluj awarię: os.remove('disks/dysk_1.bin') (usunięcie dysku numer 1).
  14. Zaimplementuj metodę recover_disk(failed_disk_id) odtwarzającą brakujący plik z pozostałych 3 dysków za pomocą funkcji xor_blocks.
  15. Uruchom proces odbudowy i potwierdź utworzenie nowego pliku disks/dysk_1_reconstructed.bin.
  16. Zweryfikuj tożsamość zrekonstruowanych danych: hashlib.sha256( odczyt).hexdigest() == sha_wzorcowe.
  17. Przetestuj działanie skryptu z różnymi rozmiarami paska stripe_size (16, 64, 512 bajtów).
  18. Wykonaj zrzuty ekranu kodu źródłowego, logów działania symulatora oraz weryfikacji sumy SHA-256.

Kontrola zaliczenia (checklist):

  1. Uruchomiono symulator RAID 5 i zachowano log: striping z rotacją left-symmetric, parzystość XOR, pełna rekonstrukcja po utracie 1 dysku (porównanie hash).
  2. Dołączono kod (własne 20–40 linii): mapowanie paska, XOR, rebuild brakującego bloku.
  3. Przeprowadzono test pozytywny (1 dysk — odzysk 100%) i negatywny (2 dyski — sygnalizowana nieodwracalność).
  4. Opisano w 3–5 zdaniach: elegancja XOR, geometria paska, granica 1 dysku.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznej elegancji operacji XOR w konstrukcji rozproszonej parzystości RAID 5.
  • Praktyczna umiejętność programowania geometrii paska (stripe mapping) z rotacją lewostronną left-symmetric.
  • Potwierdzenie zdolności macierzy RAID 5 do pełnej rekonstrukcji danych po utracie dokładnie jednego nośnika.
  • Świadomość braku możliwości odzyskania informacji w przypadku jednoczesnej utraty dwóch dysków w RAID 5.
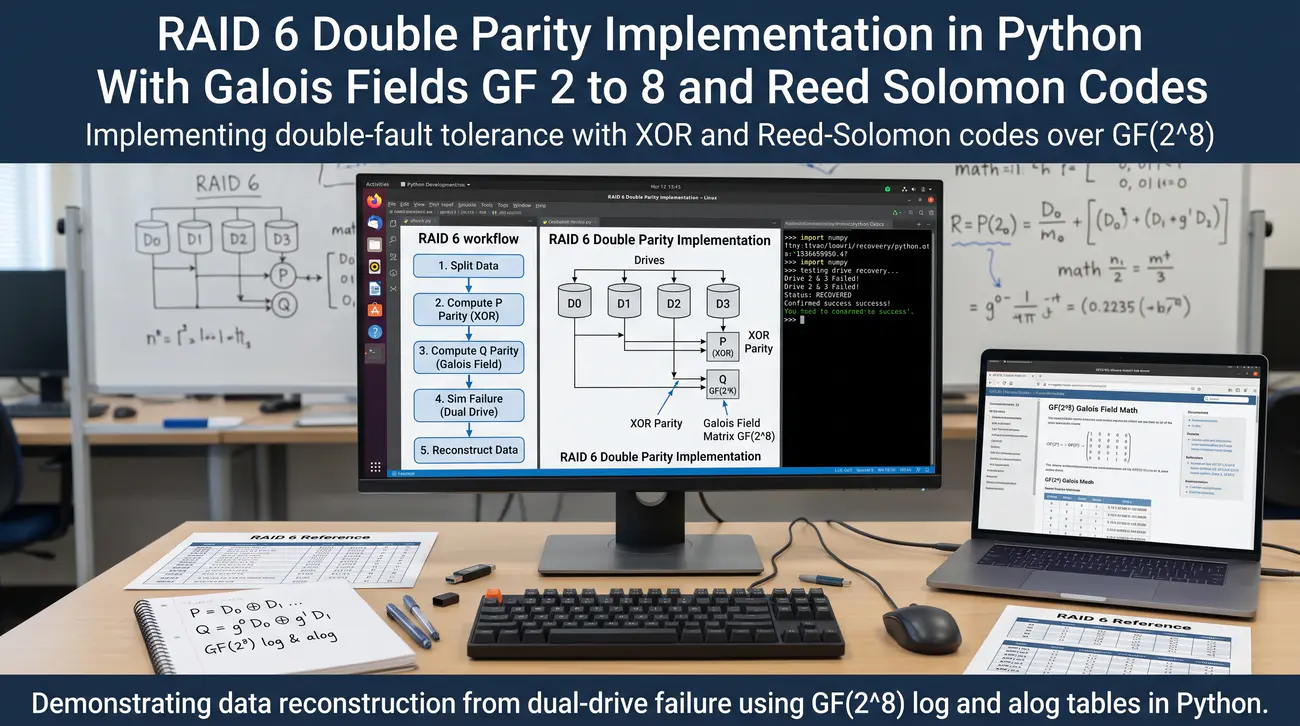
Zadanie 1 - ilustracja
02/10
Zadanie 2. Implementacja podwójnej parzystości RAID 6 w Pythonie z wykorzystaniem ciał Galois GF(2^8) i kodów Reeda-Solomona
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 17, 20, 23: poziom RAID 6, ochrona przed dwiema awariami równoczesnymi, parzystość P (XOR) oraz parzystość Q (kod Reeda-Solomona nad ciałem Galois GF(2^8)), tablice log i alog, macierz Vandermonde'a, odbudowa w Pythonie.

Cel

Celem laboratorium jest implementacja zaawansowanego algorytmu podwójnej parzystości P+Q macierzy RAID 6 w języku Python. Student implementuje arytmetykę ciała skończonego Galois GF(2^8) z wielomianem pierwotnym x^8 + x^4 + x^3 + x^2 + 1 (0x11d), wylicza wektory parzystości P oraz Q, symuluje równoczesną awarię dwóch nośników i przeprowadza matematyczną rekonstrukcję brakujących bloków.

Scenariusz – opis

Współczesne dyski twarde o pojemnościach przekraczających kilkanaście terabajtów wymagają kilkunastu godzin na proces odbudowy macierzy RAID 5. W trakcie tak długiego czasu obciążenia prawdopodobieństwo wystąpienia błędu na drugim dysku lub jego całkowitej awarii drastycznie rośnie. Z tego względu standardem bezpieczeństwa w macierzach enterprise stał się poziom RAID 6, gwarantujący odporność na awarię dwóch dowolnych dysków.

O ile pierwszy blok parzystości P jest klasyczną sumą XOR, o tyle drugi blok parzystości Q nie może być wyliczony prostym XOR-em. Wyznaczenie niezależnego drugiego syndromu ochronnego Q wymaga zastosowania algebry liniowej nad ciałem skończonym Galois GF(2^8). Ciało Galois GF(2^8) to zbiór 256 elementów odpowiadających pojedynczym bajtom, na których operacje dodawania i mnożenia zachowują własności ciała.

Dodawanie w GF(2^8) realizowane jest operacją XOR, natomiast mnożenie wymaga redukcji modulo wielomian nierozkładalny, np. 0x11d. W celu optymalizacji wydajności mnożenie w ciele wykonuje się przy użyciu wstępnie wygenerowanych tablic logarytmów i eksponentów (log/alog tables).

Syndrom Q oblicza się jako sumę iloczynów kolejnych bloków danych pomnożonych przez potęgi generatora ciała g równego dwa. Utrata dwóch dysków prowadzi do układu dwóch równań liniowych z dwiema niewiadomymi w GF(2^8), który rozwiązuje się wyznacznikami macierzy.

W tym zadaniu zaimplementujesz pełną arytmetykę GF(2^8) oraz algorytm generowania i rekonstrukcji parzystości P+Q w języku Python.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia pliku raid6_galois.py w katalogu roboczym środowiska Python. Definiujesz klasę GaloisField256 inicjalizującą tablice logarytmiczne exp_table oraz log_table o długości 256 elementów z wielomianem 0x11d. Implementujesz metody mnożenia gf_mul(a, b) oraz dzielenia gf_div(a, b) wykorzystujące sumowanie i odejmowanie indeksów logarytmicznych modulo 255. Sprawdzasz poprawność arytmetyki na testach jednostkowych (np. potwierdzenie, że a pomnożone przez odwrotność daje jeden).

Tworzysz klasę RAID6Simulator z parametrem 6 dysków (4 dyski danych D0, D1, D2, D3 oraz 2 dyski parzystości P i Q). Implementujesz funkcję wyliczania syndromu P jako standardowej sumy XOR wszystkich bloków danych. Implementujesz funkcję wyliczania syndromu Q jako sumy iloczynów: Q = (D0 * g^0) XOR (D1 * g^1) XOR (D2 * g^2) XOR (D3 * g^3). Generujesz zestaw testowych bloków danych i zapisujesz je do macierzy, weryfikując poprawność obu wektorów kontrolnych P i Q.

Symulujesz najgroźniejszy scenariusz: równoczesną awarię dwóch dysków danych (np. D1 oraz D2). Implementujesz moduł kryptoanalityczny rozwiązujący układ równań z wyznacznikami w GF(2^8) i odzyskujący zawartość obu uszkodzonych dysków. Porównujesz odzyskane bloki z oryginałami za pomocą operacji assert, wykazując matematyczną niezawodność kodu Reeda-Solomona.

Przykładowe kroki do wykonania jako sugestia

  1. W katalogu roboczym utwórz plik: nano raid6_galois.py.
  2. Zaimplementuj generator tablic Galois GF(2^8): wielomian pierwotny POLYNOMIAL = 0x11D.
  3. Wypełnij tablice exp_table i log_table wartościami generatora g = 0x02 dla potęg 0 do 254.
  4. Zaimplementuj funkcję mnożenia w ciele: gf_mul(a, b) = exp_table[(log_table[ a] + log_table[b]) % 255] (z obsługą zera).
  5. Zaimplementuj funkcję dzielenia: gf_div(a, b) = exp_table[(log_table[ a] - log_table[b] + 255) % 255].
  6. Przetestuj właściwości ciała: gf_mul(0x53, 0xCA) oraz upewnij się, że gf_div(x, x) == 1 dla x != 0.
  7. Zdefiniuj funkcję compute_p( blocks) zwracającą sumę XOR bloków bajtowych.
  8. Zdefiniuj funkcję compute_q( blocks) mnożącą bajty bloku i przez g^i w ciele GF(2^8) i sumującą wyniki operacją XOR.
  9. Przygotuj 4 bloki danych D0, D1, D2, D3 o rozmiarze 16 bajtów każdy (np. fragmenty tekstu).
  10. Wylicz wektory parzystości P i Q dla przygotowanych danych wejściowych.
  11. Zasymuluj podwójną awarię: skasuj bloki D1 oraz D2, traktując je jako utracone.
  12. Wyprowadź macierz równań: DeltaP = P XOR D0 XOR D3 = D1 XOR D2 oraz DeltaQ = Q XOR (D0*g^0) XOR (D3*g^3) = (D1*g^1) XOR (D2*g^2).
  13. Rozwiąż układ równań liniowych z użyciem wyznacznika det = (g^1 XOR g^2) w ciele GF(2^8).
  14. Wyznacz odzyskany blok D2 = gf_div((DeltaQ XOR (DeltaP * g^1)), det).
  15. Wyznacz odzyskany blok D1 = DeltaP XOR D2.
  16. Sprawdź programowo zgodność: assert D1 == D1_oryginalne and D2 == D2_oryginalne.
  17. Przetestuj przypadek awarii jednego dysku danych oraz dysku parzystości P (odzyskanie z Q).
  18. Wykonaj zrzuty ekranu kodu algorytmu, tablicy logarytmów oraz pomyślnej rekonstrukcji obu dysków.

Kontrola zaliczenia (checklist):

  1. Uruchomiono RAID 6 i zachowano log: syndromy P+Q w GF(2⁸) (0x11d), rekonstrukcja 2 dysków układem równań, tabele exp/log.
  2. Dołączono kod (własne 25–40 linii): arytmetyka Galois, generowanie Q, solver 2×2.
  3. Przeprowadzono test pozytywny (2 dyski — odzysk) i negatywny (3 dyski — odrzut z diagnozą).
  4. Opisano w 3–5 zdaniach: niezależność P/Q, koszt obliczeń vs bezpieczeństwo, RAID 6 na duże dyski.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie konieczności wykorzystania ciał Galois GF(2^8) do budowy liniowo niezależnych syndromów parzystości w RAID 6.
  • Praktyczna umiejętność implementacji tablic logarytmicznych exp/log dla przyspieszenia operacji mnożenia w ciele skończonym.
  • Opanowanie procedury rekonstrukcji dwóch równocześnie utraconych dysków poprzez rozwiązanie układu równań liniowych.
  • Świadomość przewagi bezpieczeństwa RAID 6 w nowoczesnych środowiskach pamięci masowych pomimo wyższego narzutu obliczeniowego.
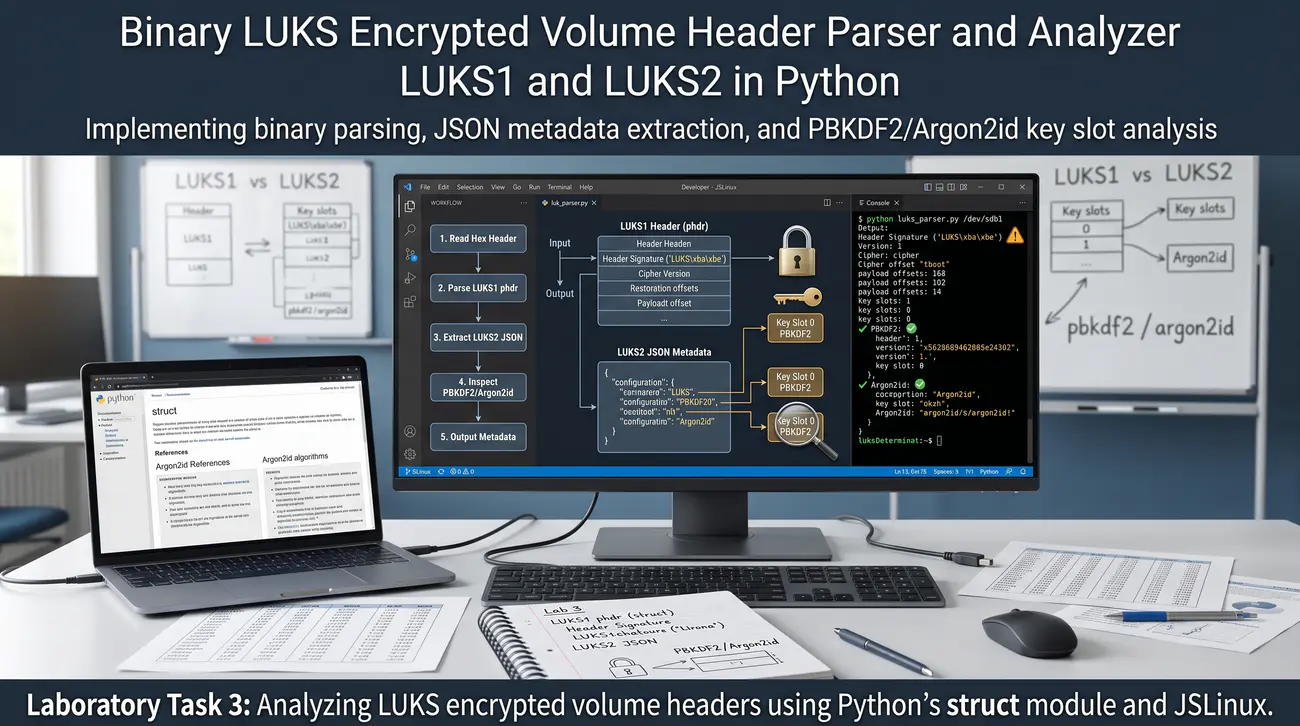
Zadanie 2 - ilustracja
03/10
Zadanie 3. Binarny parser i analizator nagłówków wolumenu szyfrowanego LUKS (LUKS1 i LUKS2) w języku Python
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 11, 35, 36: struktura binarna nagłówka LUKS1 (phdr) z modułem struct, metadane JSON w LUKS2, sloty kluczy, funkcje wyprowadzania klucza PBKDF2/Argon2id, ochrona przed atakami na hasła.

Cel

Celem zadania jest napisanie w języku Python niskopoziomowego parsera binarnego analizującego nagłówki wolumenów szyfrowanych LUKS1 i LUKS2. Student odczytuje surowe struktury nagłówka za pomocą modułu struct, ekstrahuje metadane JSON w LUKS2, analizuje parametry pamięciowe funkcji KDF (Argon2id / PBKDF2), odczytuje wektory soli i weryfikuje status aktywności slotów kluczy.

Scenariusz – opis

Standard LUKS (Linux Unified Key Setup) jest fundamentem bezpieczeństwa danych w spoczynku w ekosystemie linuksowym. Początkowe sektory wolumenu szyfrowanego zawierają ustandaryzowany nagłówek, który definiuje parametry kryptograficzne i przechowuje zaszyfrowany klucz główny. W wersji LUKS1 nagłówek miał ściśle określoną binarną strukturę C struct o stałym rozmiarze pól i ograniczeniu do 8 slotów kluczy.

Wprowadzony standard LUKS2 zrewolucjonizował ten format, wprowadzając elastyczne metadane kodowane w formacie JSON oraz redundantne nagłówki zapobiegające uszkodzeniu. LUKS2 wprowadził również wsparcie dla nowoczesnej funkcji wyprowadzania klucza Argon2id, odpornej na kryptoanalityczne ataki sprzętowe ASIC i GPU. Zrozumienie binarnego i tekstowego układu nagłówka LUKS jest kluczowe w informatyce śledczej oraz audycie bezpieczeństwa pamięci masowej.

Audytor analizujący surowy obraz dysku potrafi wyodrębnić liczbę skonfigurowanych haseł, zastosowany algorytm (np. aes-xts-plain64) oraz koszt obliczeniowy KDF. Niewłaściwa konfiguracja parametrów KDF (zbyt niska liczba iteracji lub mały przydział pamięci RAM) drastycznie obniża odporność hasła na atak słownikowy. Moduł struct w języku Python stanowi doskonałe narzędzie do rozpakowywania surowych struktur bajtowych zdefiniowanych w języku C.

W tym zadaniu przeanalizujesz strukturę binarną nagłówka LUKS1 oraz zdekodujesz hierarchię JSON nagłówka LUKS2 z poziomu autorskiego skryptu. Pozwoli ci to w praktyce zrozumieć, w jaki sposób metadane partycji organizują proces bezpiecznego uwierzytelniania wolumenu blokowego.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia środowiska badawczego w terminalu JSLinux Fedora 33 (Linux) Console lub na lokalnej stacji z interpreterem Python 3. Za pomocą narzędzia cryptsetup tworzysz dwa małe testowe wolumeny blokowe: jeden sformatowany jako luks1, a drugi jako luks2. W obu wolumenach konfigurujesz hasło testowe oraz dodajesz dodatkowy slot klucza z alternatywnym poświadczeniem. Za pomocą polecenia dd wyodrębniasz początkowe 4 megabajty każdego z wolumenów do plików luks1_hdr.bin oraz luks2_hdr.bin.

Tworzysz skrypt luks_parser.py w języku Python i definiujesz format rozpakowywania nagłówka LUKS1 za pomocą modułu struct. Ekstrahujesz pola nagłówka LUKS1: magiczne bajty ('LUKS\xba\xbe'), numer wersji, nazwę szyfru cipher_name, tryb cipher_mode, algorytm haszujący hash_spec oraz payload_offset. Analizujesz tablicę ośmiu struktur keyslotów w LUKS1, raportując sloty aktywne (oznaczone wartością 0x00ac71f3) oraz nieaktywne (0x0000dac7).

W kolejnym kroku implementujesz moduł obsługi LUKS2: odnajdujesz magiczne bajty 'LUKS\xba\xb2', odczytujesz offset metadanych JSON i parsujesz strukturę json.loads. Wypisujesz z drzewa JSON parametry slotów kluczy: typ KDF (argon2id vs pbkdf2), parametry pamięciowe (memory), czasowe (time) oraz liczbę wątków (cpus). Przeprowadzasz analizę bezpieczeństwa wykrytych parametrów KDF pod kątem zaleceń OWASP oraz wytycznych NIST dotyczących ochrony przed atakami brute-force. Zapisujesz wyniki działania parsera w czytelnej tabeli w sprawozdaniu laboratoryjnym wraz z komentarzem technicznym.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/luks_parser && cd ~/luks_parser.
  2. Utwórz dwa pliki obrazów po 20 MB: dd if=/dev/zero of=vol1.img bs=1M count=20 && dd if=/dev/zero of=vol2.img bs=1M count=20.
  3. Sformatuj pierwszy wolumen w formacie LUKS1: cryptsetup luksFormat --type luks1 --batch-mode vol1.img (hasło: TestHaslo1).
  4. Sformatuj drugi wolumen w formacie LUKS2: cryptsetup luksFormat --type luks2 --batch-mode vol2.img (hasło: TestHaslo2).
  5. Dodaj drugi slot klucza w wolumenie LUKS2: cryptsetup luksAddKey --batch-mode vol2.img (nowe hasło: DodatkowyKlucz2).
  6. Wyodrębnij surowe nagłówki: dd if=vol1.img of=luks1_hdr.bin bs=1M count=2 && dd if=vol2.img of=luks2_hdr.bin bs=1M count=4.
  7. Utwórz skrypt parsera w Pythonie: nano parse_luks.py.
  8. W skrypcie otwórz plik luks1_hdr.bin w trybie binarnym rb i odczytaj pierwsze 592 bajty.
  9. Użyj formatu struct.unpack('>6sH32s32s32sII32s32sII', data[:208]) do zdekodowania pól nagłówka bazowego phdr LUKS1.
  10. Sprawdź sygnaturę magiczną: upewnij się, że data[:6] == b'LUKS\xba\xbe'.
  11. Wyświetl wersję, szyfr (aes), tryb (xts-plain64) oraz przesunięcie danych payload_offset.
  12. Przejdź do analizy pliku luks2_hdr.bin: sprawdź sygnaturę b'LUKS\xba\xb2' i odczytaj nagłówek binarny o rozmiarze 4096 bajtów.
  13. Zlokalizuj obszar tekstowy JSON (zaczynający się od klamry '{') w kolejnych sektorach nagłówka LUKS2.
  14. Zdekoduj tekst UTF-8 i załaduj obiekt za pomocą biblioteki json: metadata = json.loads(json_string).
  15. Przeanalizuj sekcję metadata['keyslots']: wypisz identyfikatory aktywnych slotów, użytą funkcję KDF (argon2id), sól w Base64 oraz przydział pamięci.
  16. Przeanalizuj sekcję metadata['segments']: zidentyfikuj sektor początkowy zaszyfrowanych danych (offset).
  17. Wykonaj zrzuty ekranu kodu parsera w Pythonie oraz sformatowanego wyjścia konsolowego prezentującego parametry obu wersji LUKS.
  18. Sformułuj wnioski porównujące odporność schematu LUKS1 (PBKDF2) i LUKS2 (Argon2id) na ataki z użyciem klastrów GPU.

Kontrola zaliczenia (checklist):

  1. Uruchomiono parser LUKS i zachowano log: LUKS1 (nagłówek binarny structem) i LUKS2 (JSON), parametry Argon2id, sloty.
  2. Dołączono kod (własne 20–40 linii): struct, parsowanie JSON, tabela parametrów KDF.
  3. Przeprowadzono test pozytywny (obrazy z startera parsują) i negatywny (uszkodzona magia — odrzut).
  4. Opisano w 3–5 zdaniach: LUKS1 vs LUKS2, memory-hard jako obrona, higiena slotów.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie niskopoziomowej organizacji nagłówków kryptograficznych w standardach LUKS1 i LUKS2.
  • Praktyczna umiejętność ekstrakcji i parsowania struktur binarnych C za pomocą modułu struct w Pythonie.
  • Umiejętność odczytu i interpretacji rozszerzonych metadanych JSON w nowoczesnym standardzie LUKS2.
  • Świadomość krytycznego znaczenia parametrów pamięciożernych funkcji KDF (Argon2id) w obronie przed atakami siłowymi.
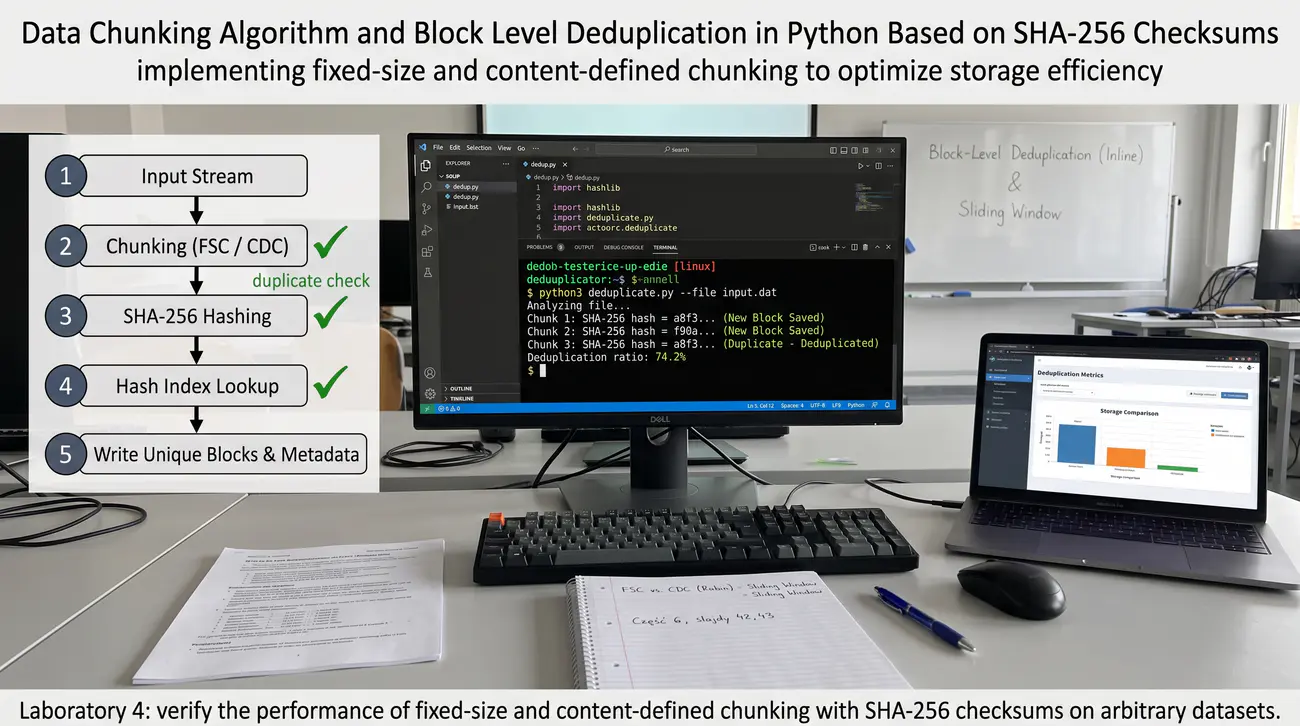
Zadanie 3 - ilustracja
04/10
Zadanie 4. Algorytm krojenia danych (Chunking) i deduplikacja blokowa w Pythonie w oparciu o sumy kontrolne SHA-256
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 42, 43: techniki redukcji objętości danych, deduplikacja blokowa (inline deduplication), algorytm Fixed-Size Chunking vs Content-Defined Chunking (okno przesuwne Rabina), tablica skrótów SHA-256, kalkulacja współczynnika deduplikacji.

Cel

Celem laboratorium jest implementacja silnika deduplikacji danych w języku Python w oparciu o kryptograficzne sumy kontrolne SHA-256. Student porównuje skuteczność deduplikacji ze stałym rozmiarem bloku (Fixed-Size Chunking) z algorytmem krojenia zależnego od treści (Content-Defined Chunking), bada zachowanie przy przesunięciach bajtowych w plikach oraz wylicza współczynnik kompresji i deduplikacji magazynu.

Scenariusz – opis

Deduplikacja danych to kluczowa technologia optymalizacji przestrzeni dyskowej we współczesnych systemach pamięci masowych i kopiach zapasowych. Jej istotą jest identyfikacja powtarzających się segmentów danych i przechowywanie tylko jednego fizycznego egzemplarza każdego unikalnego bloku. Wszystkie pozostałe odwołania do identycznej zawartości zastępowane są kompaktowymi wskaźnikami logicznymi w strukturach metadanych.

Najprostsze podejście, Fixed-Size Chunking (FSC), dzieli strumień wejściowy na sztywne bloki o stałej długości (np. 4 KB lub 8 KB). Metoda FSC cierpi jednak na tzw. problem przesunięcia bajtów (boundary shift problem) - wstawienie pojedynczego bajtu na początku pliku zmienia granice wszystkich kolejnych bloków.

Rozwiązaniem tej wady jest algorytm Content-Defined Chunking (CDC), w którym granice bloków wyznaczane są dynamicznie na podstawie samej zawartości danych. Klasyczny CDC wykorzystuje okno przesuwne i haszowanie wielomianowe Rabina lub funkcję Gear, deklarując granicę bloku, gdy dolne bity skrótu osiągają zadaną wartość. Każdy wycięty blok jest następnie haszowany kryptograficzną funkcją SHA-256, która służy jako unikalny identyfikator w tablicy indeksowej.

Prawdopodobieństwo kolizji w 256-bitowej przestrzeni SHA-256 jest pomijalnie małe, co czyni to podejście bezpiecznym dla integralności danych. Implementacja obu algorytmów w języku Python pozwala empirycznie ocenić współczynnik redukcji danych (deduplication ratio) dla różnych typów obciążeń.

W tym zadaniu zbudujesz prototypowy silnik deduplikacji, przetestujesz podatność na boundary shift i wyznaczysz statystyki zysku pojemnościowego.

Co ma wykonać student / grupa

Pracę rozpoczynasz od przygotowania środowiska skryptowego w katalogu deduplication_lab w emulatorze JSLinux Fedora 33 (Linux) Console lub stacji roboczej. Tworzysz zbiór danych testowych składający się z pliku bazowego dokumentu tekstowego o rozmiarze około 100 kilobajtów. Generujesz drugi plik, dodając na samym początku 5 dodatkowych znaków, symulując zjawisko przesunięcia granic w strumieniu danych. Tworzysz trzeci plik, będący połączeniem zduplikowanych kopii dokumentu bazowego z drobnymi modyfikacjami w środku tekstu.

W pliku deduplicator.py implementujesz metodę chunk_fsc dzielącą dane wejściowe na równe fragmenty po 1024 bajty. Dla każdego bloku obliczasz skrót hashlib.sha256 i rejestrujesz go w globalnym słowniku bloków unikalnych chunk_store. Mierzysz liczbę unikalnych bloków oraz wyliczasz współczynnik deduplikacji dla zbioru testowego w metodzie FSC.

Następnie implementujesz uproszczony algorytm CDC z oknem przesuwnym o szerokości 16 bajtów i maską podziału bitowego (np. hasz % 1024 == 0). Dzielisz te same pliki testowe za pomocą algorytmu CDC i wprowadzasz ich bloki do dedykowanego magazynu indeksowego. Porównujesz wyniki obu metod, wykazując, że CDC rozpoznało identyczne bloki w pliku ze wstawionymi na początku znakami, podczas gdy FSC poniosło porażkę. Sporządzasz wykres lub tabelę podsumowującą rozmiar surowy, rozmiar zdeduplikowany oraz procent oszczędności dyskowej dla obu podejść.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/dedup_lab && cd ~/dedup_lab.
  2. Utwórz plik testowy bazowy: python3 -c 'with open("doc1.txt", "w") as f: f.write("To jest testowy akapit z powtarzajacymi sie danymi uczelni.\n" * 1000)'.
  3. Utwórz plik ze wstawką na początku (boundary shift): python3 -c 'with open("doc2.txt", "w") as f: f.write("START" + open("doc1.txt").read())'.
  4. Utwórz skrypt w języku Python: nano dedupe_engine.py.
  5. Zaimplementuj magazyn bloków: chunk_store = {} (przechowujący hash -> treść_bloku).
  6. Zaimplementuj funkcję fsc_chunk( data, chunk_size=1024) zwracającą listę bloków o stałej długości.
  7. Zaimplementuj funkcję cdc_chunk( data, min_sz=256, max_sz=2048, mask=0x1FF) z ruchomym oknem i prostym haszem rolling sum.
  8. Dla algorytmu CDC zdefiniuj warunek granicy: gdy rolling_hash & mask == 0 lub rozmiar bloku osiągnie max_sz.
  9. Przetwórz plik doc1.txt oraz doc2.txt za pomocą algorytmu FSC: zarejestruj hasze SHA-256 bloków w słowniku.
  10. Oblicz całkowity rozmiar wejściowy vs rozmiar unikalnych bloków w FSC: dedupe_ratio_fsc = total_bytes / unique_bytes.
  11. Odnotuj, jak niska jest efektywność FSC z powodu przesunięcia granic o 5 bajtów.
  12. Wyczyść magazyn i przetwórz te same pliki algorytmem CDC.
  13. Oblicz współczynnik deduplikacji dla CDC: zaobserwuj radykalny wzrost liczby rozpoznanych wspólnych bloków.
  14. Zaimplementuj funkcję odtwarzania oryginalnego pliku na podstawie listy skrótów SHA-256 (rekonstrukcja strumienia).
  15. Sprawdź zgodność sumy kontrolnej SHA-256 odtworzonego pliku z oryginałem.
  16. Zbadaj odporność na kolizje haszy i wyjaśnij, dlaczego SHA-256 gwarantuje brak kolizji w systemach storage.
  17. Wykonaj zrzuty ekranu działania programu, tabeli statystyk bloków oraz dowodu poprawnej rekonstrukcji.
  18. Sformułuj rekomendacje wyboru algorytmu chunkingu dla magazynu kopii zapasowych baz danych i maszyn wirtualnych.

Kontrola zaliczenia (checklist):

  1. Uruchomiono deduplikację i zachowano log: FSC vs CDC (SHA-256), wykazany boundary shift, odzyskany plik z indeksu unikalnych.
  2. Dołączono kod (własne 20–40 linii): chunker stały i content-defined, indeks haszy, rekonstrukcja.
  3. Przeprowadzono test pozytywny (wstawka 1 bajtu — CDC wciąż deduplikuje, FSC nie) i negatywny (dane losowe — brak duplikatów, raport).
  4. Opisano w 3–5 zdaniach: hasz jako tożsamość bloku, koszty indeksu, CDC jako odporność na przesunięcia.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie mechanizmu blokowej deduplikacji danych opartej na kryptograficznych haszach SHA-256.
  • Praktyczna identyfikacja problemu przesunięcia granic (boundary shift) w metodzie stałego bloku (FSC).
  • Potwierdzenie empirycznej przewagi algorytmu Content-Defined Chunking (CDC) w wykrywaniu duplikatów przy modyfikacjach strumienia.
  • Opanowanie procedury rekonstrukcji plików z indeksu bloków unikalnych z gwarancją integralności.
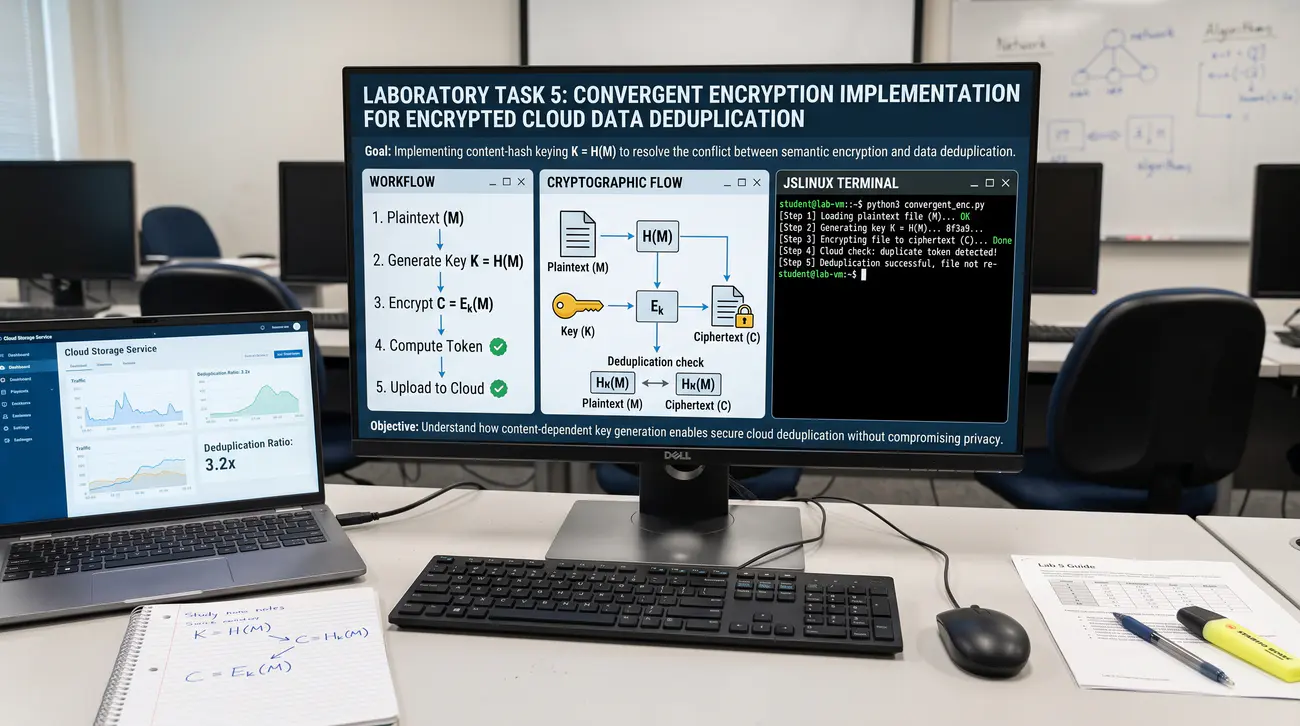
Zadanie 4 - ilustracja
05/10
Zadanie 5. Implementacja zbieżnego szyfrowania (Convergent Encryption) dla deduplikacji zaszyfrowanych danych w chmurze
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 11, 36, 41, 42, 43: konflikt pomiędzy szyfrowaniem semantycznym a deduplikacją danych, zbieżne szyfrowanie (Convergent Encryption / Content-Hash Keying), klucz K = H(M), szyfr blokowy AES-CTR/CBC, tag weryfikacji, bezpieczeństwo w chmurze wielodzierżawnej.

Cel

Celem ćwiczenia jest rozwiązanie fundamentalnego konfliktu pomiędzy prywatnością szyfrowania a efektywnością deduplikacji w chmurze poprzez implementację zbieżnego szyfrowania (Convergent Encryption) w Pythonie. Student implementuje schemat, w którym klucz szyfrujący jest deterministycznie wyprowadzany ze skrótu kryptograficznego zawartości bloku, co pozwala różnym użytkownikom generować identyczne szyfrogramy dla identycznych plików bez ujawniania ich treści dostawcy chmury.

Scenariusz – opis

W erze chmury obliczeniowej dostawcy pamięci masowych masowo stosują deduplikację danych w celu obniżenia kosztów infrastruktury. Równocześnie świadomi użytkownicy i regulacje prawne (np. RODO) wymagają szyfrowania danych przed ich wysłaniem do chmury (klient-side encryption).

W tradycyjnej kryptografii symetrycznej każdy użytkownik stosuje własny, losowy klucz oraz losowy wektor inicjalizujący IV. W efekcie dwa identyczne pliki zaszyfrowane przez dwóch różnych użytkowników stają się całkowicie odmiennymi ciągami pseudolosowych bajtów. Uniemożliwia to dostawcy chmury jakąkolwiek deduplikację, prowadząc do marnotrawstwa przestrzeni dyskowej i wyższych kosztów usługi.

Odpowiedzią na ten dylemat jest technika zbieżnego szyfrowania (Convergent Encryption, CE). W technice tej klucz szyfrujący K wyprowadzany jest w sposób deterministyczny ze skrótu kryptograficznego samej wiadomości: K = SHA256(M). Szyfrowanie realizowane jest algorytmem symetrycznym AES (np. w trybie CTR lub GCM) z wektorem IV również wyliczonym ze skrótu danych.

W rezultacie dowolny użytkownik posiadający dokładnie ten sam plik wygeneruje identyczny klucz oraz identyczny szyfrogram C. Dostawca chmury może bezpiecznie zdeduplikować szyfrogramy na poziomie bloków, nie mając wglądu w tekst jawny bez znajomości danych.

W tym zadaniu zaimplementujesz procedurę zbieżnego szyfrowania, zamodelujesz wielodostęp użytkowników i przeanalizujesz kompromis bezpieczeństwa.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia katalogu convergent_lab w terminalu środowiska z pakietem pycryptodome lub biblioteką cryptography. Tworzysz skrypt convergent_storage.py modelujący wielodzierżawny magazyn chmurowy oraz dwóch niezależnych klientów Alice i Boba. Implementujesz funkcję convergent_encrypt(plaintext), która w pierwszym kroku wylicza 256-bitowy skrót SHA-256 z danych wejściowych. Wygenerowany skrót traktowany jest bezpośrednio jako symetryczny klucz AES-256, natomiast pierwsze 16 bajtów drugiego hasza służy jako deterministyczny wektor IV.

Wykonujesz szyfrowanie bloku za pomocą algorytmu AES w trybie CTR, uzyskując deterministyczny szyfrogram ciphertext. Implementujesz funkcję convergent_decrypt(ciphertext, key), która odwraca operację i odzyskuje oryginalny tekst jawny. Generujesz wspólny plik testowy zawierający poufny raport finansowy i symulujesz jego przesłanie do chmury najpierw przez Alice, a następnie przez Boba. Weryfikujesz, że szyfrogram wygenerowany przez Boba jest identyczny co do bajta z szyfrogramem Alice, co pozwala chmurze zapisać blok tylko raz.

Zapisujesz klucz K w lokalnym bezpiecznym portfelu użytkownika zaszyfrowanym jego prywatnym hasłem głównym (Master Password). Analizujesz podatność zbieżnego szyfrowania na atak słownikowy (confirmation-of-a-file attack), gdy atakujący zgaduje zawartość znanego pliku. Wykazujesz w sprawozdaniu, w jaki sposób schemat DupLESS z serwerem KSF ogranicza tę podatność, oraz dokumentujesz działanie kodu.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/convergent_lab && cd ~/convergent_lab.
  2. Upewnij się o dostępności biblioteki kryptograficznej w Pythonie: python3 -c 'import cryptography' || dnf install -y python3-cryptography.
  3. Utwórz plik skryptu: nano convergent_engine.py.
  4. Zaimportuj moduły: os, hashlib, json z pakietu cryptography.hazmat.primitives.ciphers (AES, CTR).
  5. Zaimplementuj funkcję derive_keys( plaintext): key = hashlib.sha256( plaintext).digest(), iv = hashlib.sha256(key).digest()[:16].
  6. Zaimplementuj funkcję ce_encrypt( plaintext): wyprowadź klucz i IV, zaszyfruj dane AES-CTR, zwróć (ciphertext, key).
  7. Zaimplementuj funkcję ce_decrypt( ciphertext, key): wyprowadź deterministyczny IV, odszyfruj dane AES-CTR, zwróć plaintext.
  8. Zdefiniuj klasę CloudStorage ze słownikiem deduplikacji: storage = {} (mapującym hash_szyfrogramu -> ciphertext).
  9. Przygotuj poufny dokument wspólny: doc = b'Raport audytu bezpieczenstwa infrastruktury storage UAFM 2026'.
  10. Zasymuluj działanie Klienta 1 (Alice): zaszyfruj dokument, wyślij szyfrogram do chmury, zapisz klucz w lokalnym magazynie Alice.
  11. Chmura rejestruje nowy unikalny blok i zwiększa licznik alokacji o 1.
  12. Zasymuluj działanie Klienta 2 (Bob): zaszyfruj ten sam dokument metodą CE, wyślij szyfrogram do chmury.
  13. Chmura wykrywa duplikat szyfrogramu: deduplication_hit = True, przestrzeń fizyczna nie ulega zwiększeniu.
  14. Sprawdź, czy Bob może bez przeszkód odszyfrować plik ze swojego lokalnego klucza: assert ce_decrypt(szyfrogram_z_chmury, klucz_boba) == doc.
  15. Zasymuluj próbę ataku podsłuchiwacza chmury: wykaż, że bez znajomości tekstu jawnego chmura widzi jedynie losowy szyfrogram.
  16. Przetestuj podatność Dictionary Attack: sprawdź, jak atakujący znający skończony zbiór dokumentów może potwierdzić obecność pliku.
  17. Wykonaj zrzuty ekranu kodu źródłowego, symulacji wielodostępnej oraz weryfikacji deduplikacji zaszyfrowanych bloków.
  18. Sformułuj wnioski opisujące kompromis pomiędzy semantycznym bezpieczeństwem CPA a deduplikowalnością w chmurze.

Kontrola zaliczenia (checklist):

  1. Uruchomiono convergent encryption i zachowano log: K=H(M), ten sam blok → ten sam szyfrogram (dedup działa), serwer bez plaintextu.
  2. Dołączono kod (własne 20–40 linii): KDF z bloku, szyfrowanie deterministyczne, indeks serwerowy.
  3. Przeprowadzono test pozytywny (duplikat deduplikowany) i negatywny (atak potwierdzenia wykazany i opisany + mitygacja DupLESS).
  4. Opisano w 3–5 zdaniach: konflikt prywatność vs dedup, CE jako kompromis, granice (confirmation attack).

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie fundamentalnego konfliktu pomiędzy semantycznym szyfrowaniem a globalną deduplikacją w chmurze.
  • Praktyczna umiejętność implementacji zbieżnego szyfrowania (Convergent Encryption) z kluczami deterministycznymi K = H(M).
  • Weryfikacja zachowania deduplikacji blokowej po stronie serwera chmurowego przy braku dostępu do tekstu jawnego.
  • Świadomość ograniczeń bezpieczeństwa CE (podatność na atak potwierdzenia pliku) oraz znajomość metod mitygacji (DupLESS).
Zadanie 5 - ilustracja
06/10
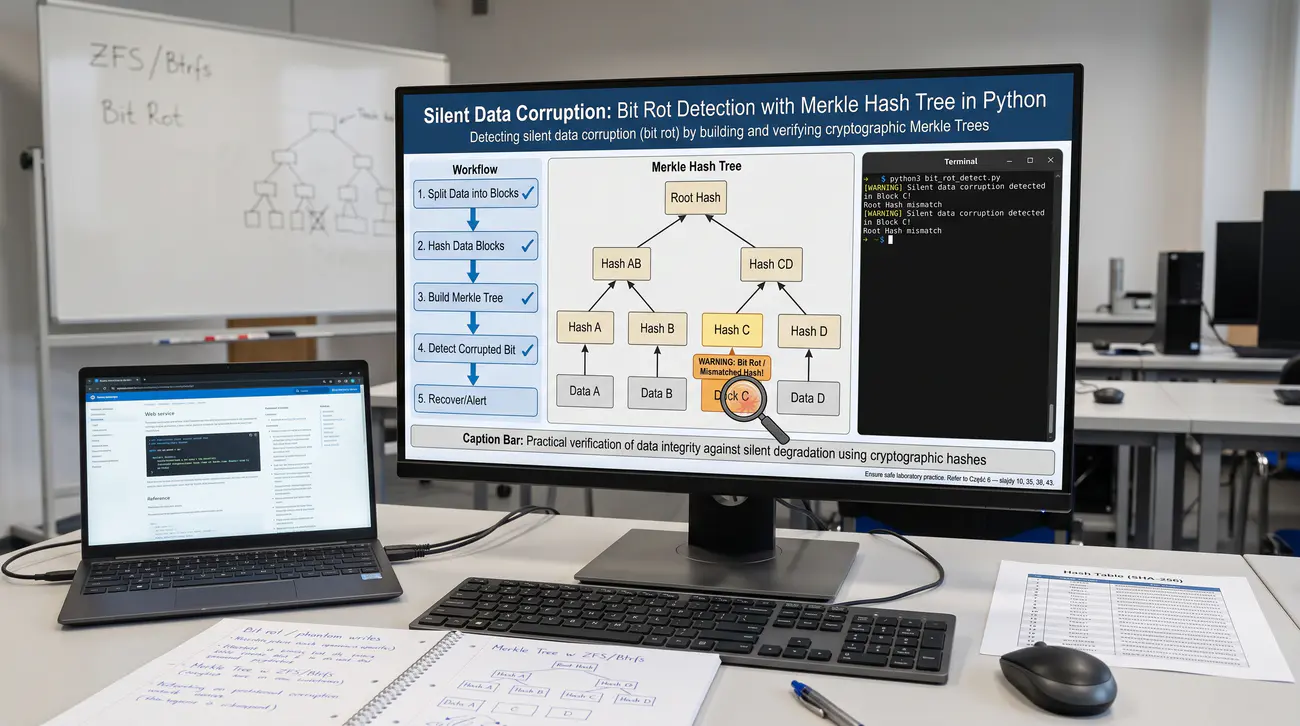
Zadanie 6. Wykrywanie cichej degradacji danych (Silent Data Corruption / Bit Rot) z użyciem drzewa haszy Merkle w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 10, 35, 38, 43: zjawisko cichej degradacji danych (bit rot / phantom writes), wady tradycyjnych systemów plików bez sum kontrolnych, architektura drzewa skrótów Merkle Tree w ZFS/Btrfs, weryfikacja integralności bloków, automatyczne scrubbing i samonaprawa.

Cel

Celem zadania jest zbudowanie w języku Python mechanizmu wykrywania i lokalizowania cichej korupcji danych (bit rot) za pomocą kryptograficznego drzewa haszy Merkle Tree. Student symuluje magazyn blokowy z sumami kontrolnymi dla każdego liścia, oblicza korzeń drzewa (Merkle Root), symuluje przypadkową zmianę pojedynczego bitu w losowym bloku danych oraz demonstruje procedurę lokalizacji uszkodzenia w czasie logarytmicznym O(log n).

Scenariusz – opis

Wielkoskalowe badania nad nośnikami pamięci masowej dowodzą istnienia zjawiska cichej degradacji danych (Silent Data Corruption / Bit Rot). Polega ono na samoistnym przekłamaniu bitów na magnetycznym talerzu HDD lub w komórkach flash SSD pod wpływem promieniowania kosmicznego lub błędów firmware. Tradycyjne systemy plików (takie jak ext4 czy NTFS) ufają, że nośnik zwróci błąd I/O, jeśli dane są uszkodzone.

Tymczasem przy cichej korupcji kontroler dysku bez ostrzeżenia zwraca przekłamane dane, co prowadzi do trwałego uszkodzenia baz danych i archiwów. Nowoczesne systemy pamięci masowej nowej generacji, w tym ZFS oraz Btrfs, rozwiązują ten problem za pomocą hierarchicznych sum kontrolnych. Kryptograficzną strukturą idealnie modelującą ten mechanizm jest drzewo skrótów Merkle Tree zaproponowane przez Ralpha Merkle.

W drzewie Merkle każdy blok danych na najniższym poziomie reprezentowany jest przez kryptograficzny skrót (liść drzewa). Węzły wyższego poziomu powstają poprzez haszowanie konkatenacji skrótów swoich węzłów potomnych, aż do pojedynczego korzenia Merkle Root. Jakakolwiek modyfikacja nawet pojedynczego bitu w dowolnym bloku danych powoduje kaskadową zmianę korzenia drzewa. Dzięki strukturze drzewiastej zlokalizowanie uszkodzonego bloku w zbiorze milionów elementów wymaga zaledwie logarytmicznej liczby porównań.

W tym zadaniu zaimplementujesz pełne drzewo Merkle w języku Python, zasymulujesz bit rot i zademonstrujesz automatyczną naprawę uszkodzonego bloku.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia pliku merkle_storage.py w dedykowanym katalogu roboczym. Definiujesz klasę MerkleTree przechowującą listę bloków danych oraz węzły poszczególnych poziomów drzewa. Implementujesz metodę budowania drzewa build_tree, która przyjmuje listę N bloków danych i rekurencyjnie oblicza hasze nadrzędne za pomocą SHA-256. Wyznaczasz korzeń Merkle Root i zapisujesz go jako zaufaną kotwicę integralności magazynu danych.

Tworzysz wirtualny wolumen złożony z 16 bloków danych o rozmiarze 256 bajtów każdy, wypełnionych losową treścią. Implementujesz funkcję verify_storage(), która ponownie przelicza całe drzewo i porównuje aktualny korzeń ze stanem referencyjnym.

Następnie symulujesz zjawisko cichej korupcji (Bit Rot): w bloku numer 7 zmieniasz dokładnie jeden losowy bit (operacja negacji bitowej XOR 0x01). Uruchamiasz proces okresowego skanowania nośnika (odpowiednik operacji zpool scrub w systemie ZFS). Algorytm wykrywa niezgodność korzenia Merkle Root i schodzi w dół drzewa, porównując pary haszy na każdym poziomie w celu precyzyjnego wskazania bloku 7. Implementujesz procedurę samonaprawy (Self-Healing), odzyskując oryginalny blok z kopii lustrzanej i aktualizując drzewo Merkle do stanu poprawnego. Sporządzasz pełny raport dokumentujący przebieg ścieżki audytowej (audit path) oraz logi procedury naprawczej w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/merkle_lab && cd ~/merkle_lab.
  2. Utwórz plik skryptu: nano merkle_engine.py.
  3. Zaimportuj moduły standardowe: hashlib, math, os.
  4. Zdefiniuj funkcję sha256( data) zwracającą heksadecymalny skrót ciągu bajtów.
  5. Zaimplementuj klasę MerkleNode przechowującą hash, referencje do lewego i prawego dziecka oraz indeks bloku.
  6. Zaimplementuj metodę budowania drzewa build_tree( blocks) tworzącą poziomy od liści do korzenia.
  7. Wygeneruj 16 bloków danych testowych (D0 do D15) po 128 bajtów każdy.
  8. Zbuduj drzewo Merkle i wyświetl referencyjny Merkle Root: print('Poczatkowy Merkle Root:', tree.root_hash).
  9. Zaimplementuj funkcję get_proof(block_index) generującą ścieżkę uwierzytelniającą (ścieżkę Merkle'a) dla wybranego bloku.
  10. Zaimplementuj weryfikację poprawności pojedynczego bloku względem korzenia przy użyciu ścieżki O(log n).
  11. Zasymuluj zjawisko cichej korupcji Bit Rot: blocks[7] = bytearray( blocks[7]); blocks[7][10] ^= 0x01 (odwrócenie bitu w bloku 7).
  12. Uruchom procedurę scrub(): wykryj natychmiastową niezgodność nowego Merkle Root z wartością referencyjną.
  13. Zaimplementuj algorytm lokalizacji błędu: schodź w dół drzewa, sprawdzając, który podwęzeł zmienił skrót, wskazując uszkodzony indeks 7.
  14. Zasymuluj samonaprawę (Self-Healing Storage): pobierz zdrowy blok D7 z kopii lustrzanej (mirror) i zastąp nim uszkodzony blok.
  15. Przebuduj drzewo Merkle po naprawie i upewnij się, że Merkle Root powrócił do wartości początkowej.
  16. Przetestuj skalowalność algorytmu dla 1024 bloków danych i porównaj liczbę operacji weryfikacji ze skanowaniem liniowym O(n).
  17. Wykonaj zrzuty ekranu kodu drzewa Merkle, struktury węzłów oraz logów wykrycia i usunięcia błędu bit rot.
  18. Sformułuj wnioski wyjaśniające, dlaczego architektury ZFS i Btrfs opierają się na drzewach haszy w walce z degradacją nośników.

Kontrola zaliczenia (checklist):

  1. Uruchomiono Merkle tree i zachowano log: korzeń, ścieżka O(log n) lokalizuje uszkodzony liść (bit rot wstrzyknięty).
  2. Dołączono kod (własne 20–40 linii): drzewo SHA-256, proof path, weryfikacja.
  3. Przeprowadzono test pozytywny (1 uszkodzony blok — trafiona lokalizacja) i negatywny (2 uszkodzenia — oba wykryte, naprawa z repliki).
  4. Opisano w 3–5 zdaniach: cicha korupcja vs FS, logarytmiczny dowód, scrubbing/ZFS.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie natury zjawiska cichej degradacji danych (Bit Rot) niewykrywalnej przez tradycyjne systemy plików.
  • Praktyczna umiejętność implementacji kryptograficznego drzewa haszy Merkle Tree w języku Python.
  • Znajomość logarytmicznej złożoności O(log n) lokalizacji uszkodzeń i generowania ścieżek uwierzytelniających.
  • Świadomość roli mechanizmu scrubbing i samonaprawy w nowoczesnych systemach składowania klasy enterprise (ZFS).
Zadanie 6 - ilustracja
07/10
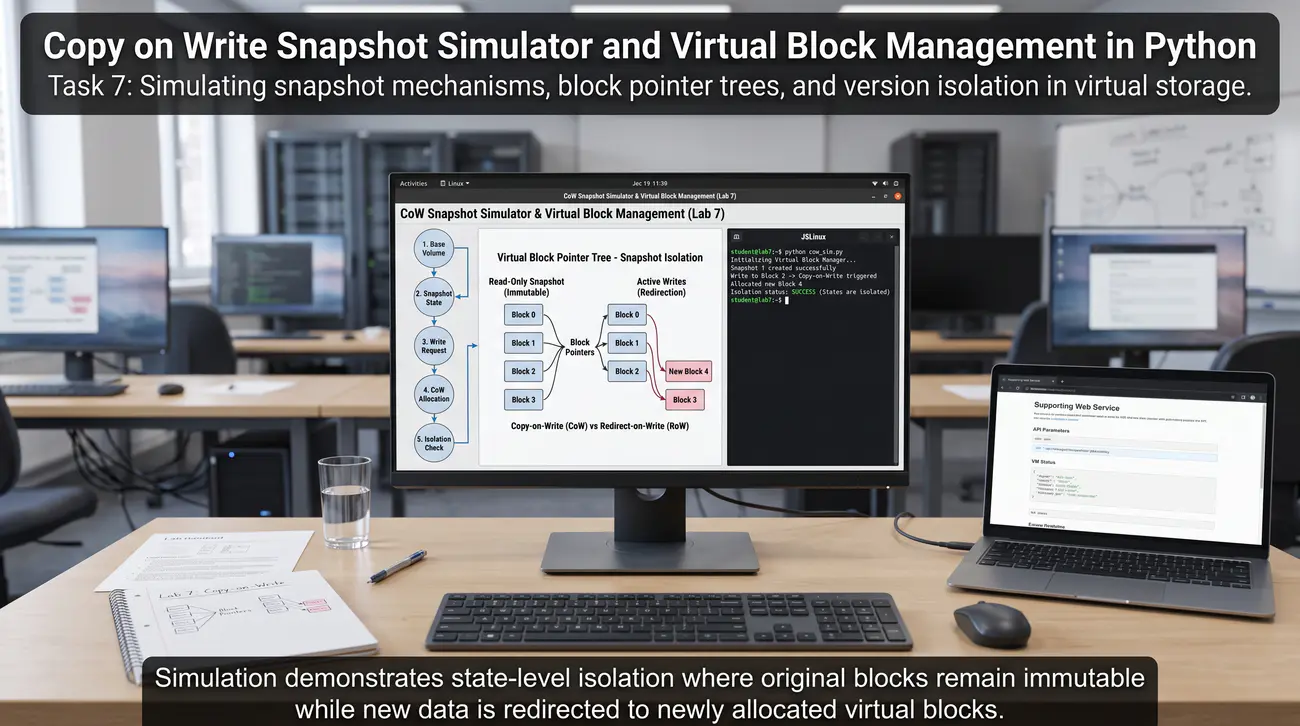
Zadanie 7. Programowy symulator migawek Copy-on-Write (CoW) i zarządzania blokami wirtualnymi w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 10, 39, 41: mechanizm migawek (snapshots), technika Copy-on-Write (CoW) vs Redirect-on-Write (RoW), drzewa wskaźników bloków, izolacja wersji danych, niemutowalność historycznych stanów, pomiar narzutu pamięciowego.

Cel

Celem ćwiczenia jest programowa rekonstrukcja działania migawek bazujących na technice Copy-on-Write (CoW) znanej z systemów plików ZFS i Btrfs. Student pisze w języku Python symulator przestrzeni adresowej bloków, implementuje tablicę translacji wskaźników, tworzy migawki w czasie rzeczywistym, modyfikuje wybrane bloki danych w wolumenie roboczym i dowodzi, że stan w migawce pozostaje nienaruszony przy minimalnym alokowaniu nowej przestrzeni.

Scenariusz – opis

Tradycyjne tworzenie kopii zapasowych poprzez fizyczne powielanie całych dysków jest operacją czasochłonną i drastycznie marnuje przestrzeń. Rewolucją w zarządzaniu danymi stały się migawki (snapshots) wykonywane w ułamku sekundy bez przerywania pracy systemu. Fundamentem nowoczesnych migawek jest architektura Copy-on-Write (kopiowanie przy zapisie) oraz Redirect-on-Write.

W systemie typu CoW bloki danych raz zapisane na dysku są niemutowalne - żadna operacja modyfikacji nie nadpisuje oryginalnego sektora w miejscu. Zamiast tego zmieniony blok zapisywany jest w nowo zaalokowanym wolnym obszarze pamięci masowej, po czym aktualizowany jest jedynie wskaźnik w metadanych. Wykonanie migawki polega wyłącznie na skopiowaniu wskaźnika do korzenia drzewa metadanych i zamrożeniu stanu logicznego wolumenu.

Dopóki wolumen roboczy nie podlega zmianom, migawka nie zajmuje żadnej dodatkowej przestrzeni fizycznej na nośnikach. Dopiero gdy użytkownik zmodyfikuje określony plik, technika CoW alokuje nowe bloki dla nowej wersji, podczas gdy migawka nadal wskazuje na bloki pierwotne. Zapewnia to całkowitą izolację wersji historycznych oraz błyskawiczny powrót do poprzedniego stanu (rollback) w przypadku awarii lub ataku ransomware. Zrozumienie wskaźnikowej natury migawek pozwala optymalizować retencję danych i planować pojemność magazynów pamięci masowej.

W tym zadaniu zaimplementujesz wirtualny menedżer bloków CoW w Pythonie, wykonasz serię migawek i zmierzysz przyrost zużycia pamięci.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia skryptu cow_simulator.py w dedykowanym katalogu laboratoryjnym. Definiujesz klasę BlockStorage modelującą fizyczną pulę bloków dyskowych z mechanizmem zliczania referencji (reference counting). Implementujesz tablicę translacji wirtualnej przestrzeni adresowej na fizyczne indeksy bloków w pamięci masowej. Tworzysz wolumen roboczy o rozmiarze 8 bloków logicznych i inicjalizujesz go danymi początkowymi (wersja v1 dokumentu).

Zaimplementujesz metodę create_snapshot(name), która zapamiętuje kopię tablicy wskaźników i inkrementuje liczniki referencji powiązanych bloków. Weryfikujesz, że wykonanie migawki snap1 odbywa się w czasie stałym O(1) i nie alokuje ani jednego nowego bloku w fizycznej puli.

Następnie symulujesz modyfikację danych w wolumenie roboczym poprzez nadpisanie bloku numer 2 oraz bloku numer 5 nową zawartością. Mechanizm CoW alokuje dwa nowe fizyczne bloki dla wolumenu roboczego, aktualizuje wskaźniki i dekrementuje referencje, pozostawiając snap1 nienaruszoną. Odczytujesz dane z migawki snap1 oraz z wolumenu roboczego, potwierdzając niezależność obu stanów logicznych. Zaimplementujesz procedurę rollback(name), przywracając wolumen roboczy do stanu zapisanego w migawce snap1. Testujesz usunięcie migawki delete_snapshot(name) i weryfikujesz poprawne zwalnianie bloków fizycznych o zerowym liczniku referencji.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/cow_lab && cd ~/cow_lab.
  2. Utwórz plik skryptu w języku Python: nano cow_simulator.py.
  3. Zdefiniuj klasę PhysicalPool przechowującą słownik blocks = {} oraz ref_counts = {}.
  4. Zdefiniuj klasę VirtualVolume zawierającą mapowanie logical_to_physical = {} oraz referencję do puli fizycznej.
  5. Zaimplementuj metodę write_block(lba, data): jeśli ref_counts[pba] >1, zaalokuj nowy fizyczny blok i zaktualizuj wskaźnik (zasada CoW).
  6. Zaimplementuj metodę read_block(lba) zwracającą zawartość wskazywanego bloku fizycznego.
  7. Zaimplementuj menedżer migawek SnapshotManager przechowujący kopie mapowań logicznych z unikalnymi nazwami.
  8. Zainicjalizuj wolumen z 8 blokami logicznymi: wpisz do każdego bloku treść 'Wersja_1_Blok_X'.
  9. Sprawdź zużycie fizyczne puli: 8 bloków w pamięci, każdy o liczniku referencji równym 1.
  10. Wykonaj migawkę snap_poczatkowa: skopiuj mapowanie wskaźników i zwiększ ref_counts wszystkich 8 bloków do 2.
  11. Zmierz narzut pamięciowy migawki: potwierdź, że liczba fizycznych bloków nie wzrosła (wciąż wynosi 8).
  12. Zmodyfikuj bloki logiczne 1 i 3 w wolumenie roboczym: wpisz 'Wersja_2_Zmieniona'.
  13. Zaobserwuj działanie CoW: pula alokuje bloki fizyczne 8 i 9 dla wolumenu roboczego; bloki 1 i 3 w snap_poczatkowa pozostają nienaruszone.
  14. Wyświetl zawartość logiczną bloku 1 z wolumenu roboczego oraz z migawki snap_poczatkowa i porównaj różnice.
  15. Wykonaj drugą migawkę snap_druga i wprowadź kolejną modyfikację w bloku 1.
  16. Zaimplementuj funkcję rollback('snap_poczatkowa') i potwierdź natychmiastowe przywrócenie pierwotnego stanu całego wolumenu.
  17. Zaimplementuj usuwanie migawki i zweryfikuj zwalnianie bloków o ref_count == 0 (garbage collection).
  18. Wykonaj zrzuty ekranu kodu, mapowania wskaźników bloków oraz logów demonstracyjnych mechanizmu CoW.

Kontrola zaliczenia (checklist):

  1. Uruchomiono symulator CoW i zachowano log: migawka jako kopia wskaźników (natychmiastowa), zapis kopiuje blok, refcount bez wycieków, rollback działa.
  2. Dołączono kod (własne 20–40 linii): tablica translacji, refcount, migawki, GC.
  3. Przeprowadzono test pozytywny (rollback po ransomware-toy odtwarza) i negatywny (usunięcie migawki zwalnia tylko unikalne).
  4. Opisano w 3–5 zdaniach: niemutowalność, tanie migawki, obrona przed ransomware.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie fundamentalnej zasady niemutowalności i kopiowania przy zapisie (Copy-on-Write).
  • Praktyczna znajomość mechanizmu tworzenia natychmiastowych migawek poprzez kopiowanie wskaźników metadanych.
  • Opanowanie techniki śledzenia referencji bloków fizycznych (reference counting) gwarantującej brak wycieków pamięci.
  • Świadomość roli migawek CoW w strategii ochrony przed atakami ransomware i błyskawicznym odzyskiwaniu spójności.
Zadanie 7 - ilustracja
08/10
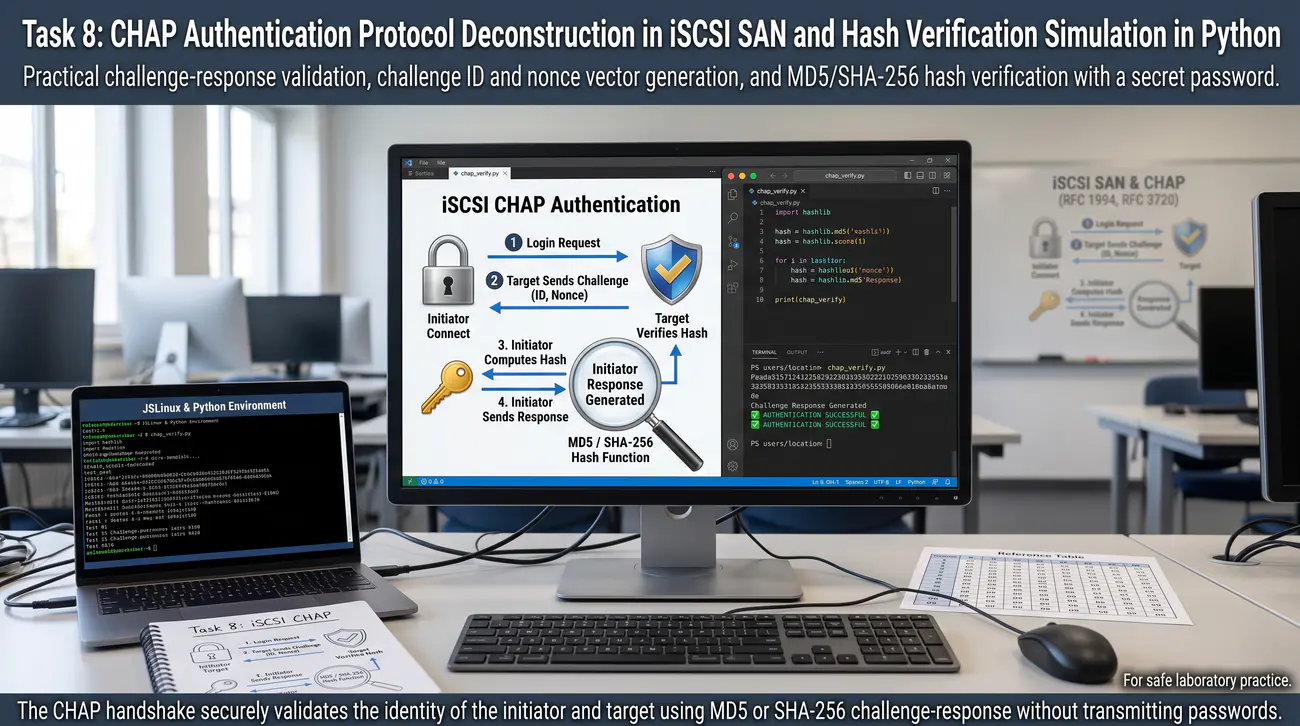
Zadanie 8. Dekonstrukcja protokołu uwierzytelniania CHAP w sieci iSCSI SAN i symulacja weryfikacji hasza w Pythonie
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 30, 35: protokół wyzwanie-odpowiedź CHAP w iSCSI (RFC 1994, RFC 3720), generowanie identyfikatora wyzwania i wektora nonce, funkcja MD5/SHA-256 z tajnym hasłem, uwierzytelnianie dwustronne Mutual-CHAP, zabezpieczenie przed atakiem powtórzenia (replay attack).

Cel

Celem laboratorium jest stworzenie w języku Python pełnej symulacji protokołu uwierzytelniania wyzwanie-odpowiedź CHAP (Challenge Handshake Authentication Protocol) stosowanego w sieciach iSCSI SAN. Student implementuje węzły Inicjatora i Celu, modeluje bezpieczną wymianę pakietów uwierzytelniających, symuluje próbę podsłuchania transmisji oraz atak powtórzenia (replay attack), wykazując matematyczne podstawy odporności protokołu CHAP.

Scenariusz – opis

W sieciach pamięci masowej iSCSI SAN dane blokowe przesyłane są przez ogólnodostępną infrastrukturę protokołu TCP/IP. Brak mechanizmów weryfikacji tożsamości pozwoliłby dowolnemu nieautoryzowanemu hostowi w sieci podłączyć się do jednostki LUN i odczytać poufne bazy danych. Podstawowym standardem uwierzytelniania węzłów iSCSI zdefiniowanym w RFC 3720 jest protokół CHAP (Challenge Handshake Authentication Protocol).

Protokół ten eliminuje konieczność przesyłania hasła jawnym tekstem przez sieć, opierając się na schemacie kryptograficznym wyzwanie-odpowiedź. W trakcie fazy logowania (iSCSI Login Phase) cel (Target) generuje unikalny identyfikator wyzwania oraz losowy wektor bajtowy (Challenge). Inicjator (klient) łączy otrzymane wyzwanie ze wspólnym sekretem (hasłem) i oblicza kryptograficzny skrót odpowiedzi (Response) przy użyciu funkcji haszującej.

Po odebraniu odpowiedzi cel wykonuje niezależnie to samo obliczenie i porównuje uzyskany wynik ze skrótem nadesłanym przez klienta. Ponieważ wektor wyzwania jest unikalny dla każdej sesji, potencjalny podsłuchujący nie może ponownie użyć przechwyconej odpowiedzi (ochrona przed Replay Attack). W środowiskach wysokiego bezpieczeństwa stosuje się rozszerzenie Mutual-CHAP, w którym cel musi w analogiczny sposób dowieść swojej tożsamości przed inicjatorem. Zrozumienie szczegółów wymiany komunikatów CHAP pozwala administratorom diagnozować błędy negocjacji sesji i wykrywać anomalie sieciowe.

W tym zadaniu zaimplementujesz symulator protokołu CHAP i Mutual-CHAP w Pythonie oraz przetestujesz odporność na próby fałszerstwa poświadczeń.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia pliku iscsi_chap_sim.py w środowisku roboczym terminala. Definiujesz klasę ISCSITarget modelującą macierz pamięci masowej oraz klasę ISCSIInitiator modelującą serwer aplikacyjny. Konfigurujesz wspólny sekret laboratoryjny (hasło) o wysokiej entropii znany obu stronom, lecz nieprzesyłany przez łącze. Implementujesz etap 1 handshake'u: Inicjator wysyła pakiet Login Request ze swoim identyfikatorem IQN.

Implementujesz etap 2: Target generuje jednobajtowy identyfikator sesji ID oraz 16-bajtowe kryptograficznie losowe wyzwanie Challenge z os.urandom. Implementujesz etap 3: Inicjator odbiera wyzwanie i oblicza odpowiedź Response = MD5(ID + Secret + Challenge) lub SHA256. Implementujesz etap 4: Target przeprowadza weryfikację skrótu i podejmuje decyzję o zaakceptowaniu (Login Accept) lub odrzuceniu (Login Reject) sesji. Zasymulujesz atak podsłuchu pasywnego: rejestrujesz wszystkie transmitowane pakiety i dowodzisz, że wyliczenie sekretu z Response jest obliczeniowo niewykonalne.

Zasymulujesz atak powtórzenia (Replay Attack): intruz wysyła przechwyconą odpowiedź Response w nowej sesji logowania z nowym wyzwaniem, kończąc się natychmiastowym odrzuceniem. Rozbudowujesz skrypt o mechanizm Mutual-CHAP, w którym Inicjator rzuca wyzwanie Targetowi w celu potwierdzenia autentyczności macierzy. Dokumentujesz zrzuty ekranu przebiegu handshake'u, logi odmowy dostępu przy błędnym haśle oraz analizę kryptograficzną w sprawozdaniu.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/chap_lab && cd ~/chap_lab.
  2. Utwórz plik skryptu w Pythonie: nano chap_simulator.py.
  3. Zaimportuj moduły: os, hashlib, hmac, secrets.
  4. Zdefiniuj tożsamości IQN: target_iqn = 'iqn.2026.pl.uafm:storage.target1', init_iqn = 'iqn.2026.pl.uafm:client.srv1'.
  5. Zdefiniuj tajny sekret: shared_secret = b'BardzoTajneHasloSAN2026!'.
  6. Zaimplementuj metodę Target.generate_challenge(): id_pkt = secrets.randbelow(256), challenge = os.urandom(16).
  7. Zaimplementuj metodę Initiator.compute_response(id_pkt, secret, challenge): hash_obj = hashlib.md5(bytes([ id_pkt]) + secret + challenge); return hash_obj.digest().
  8. Zaimplementuj weryfikację w Target.verify_response(id_pkt, secret, challenge, received_response).
  9. Uruchom udany handshake CHAP i wyświetl logi: 'Handshake zakonczony sukcesem: Sesja iSCSI zestawiona'.
  10. Zasymuluj próbę logowania z niepoprawnym hasłem: upewnij się, że Target zwraca błąd Authentication Failure.
  11. Zasymuluj atak typu Replay: zarejestruj poprawny pakiet Response z sesji 1 i wyślij go w sesji 2 z nowym wyzwaniem.
  12. Wykaż, że Target odrzuca podrobioną sesję, ponieważ nowe wyzwanie wymaga innego skrótu Response.
  13. Zaimplementuj dwustronne uwierzytelnianie Mutual-CHAP: Inicjator generuje drugie wyzwanie, a Target odpowiada skrótem potwierdzającym tożsamość macierzy.
  14. Porównaj bezpieczeństwo funkcji MD5 w tradycyjnym CHAP ze współczesnym wariantem CHAP opartym na SHA-256.
  15. Zaimplementuj wersję CHAP wykorzystującą SHA-256 zgodnie z zaleceniami RFC 7143.
  16. Wykonaj zrzuty ekranu kodu, symulacji handshake'u oraz wyników testów odporności na replay attack.
  17. Sformułuj wnioski wyjaśniające, dlaczego sam protokół CHAP nie chroni danych przed podsłuchem po zestawieniu sesji (konieczność IPsec).

Kontrola zaliczenia (checklist):

  1. Uruchomiono symulację CHAP i zachowano log: challenge→response (hash z sekretu), weryfikacja OK, replay starego odrzucony przez świeży nonce.
  2. Dołączono kod (własne 20–40 linii): initiator/target, generowanie nonce, weryfikacja skrótu.
  3. Przeprowadzono test pozytywny (poprawny sekret przechodzi) i negatywny (zły sekret / replay — odrzut).
  4. Opisano w 3–5 zdaniach: wyzwanie-odpowiedź bez wysyłki hasła, nonce vs replay, brak szyfrowania danych (IPsec potrzebny).

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie zasady działania kryptograficznego protokołu wyzwanie-odpowiedź CHAP w sieciach blokowych iSCSI.
  • Praktyczna umiejętność modelowania i implementacji procedury obliczania i weryfikacji skrótów odpowiedzi w Pythonie.
  • Empiryczne potwierdzenie odporności mechanizmu jednorazowych wyzwań nonce na ataki powtórzenia (Replay Attack).
  • Świadomość ograniczeń protokołu CHAP (brak szyfrowania transmisji danych użytkownika) i konieczności stosowania tuneli IPsec.
Zadanie 8 - ilustracja
09/10
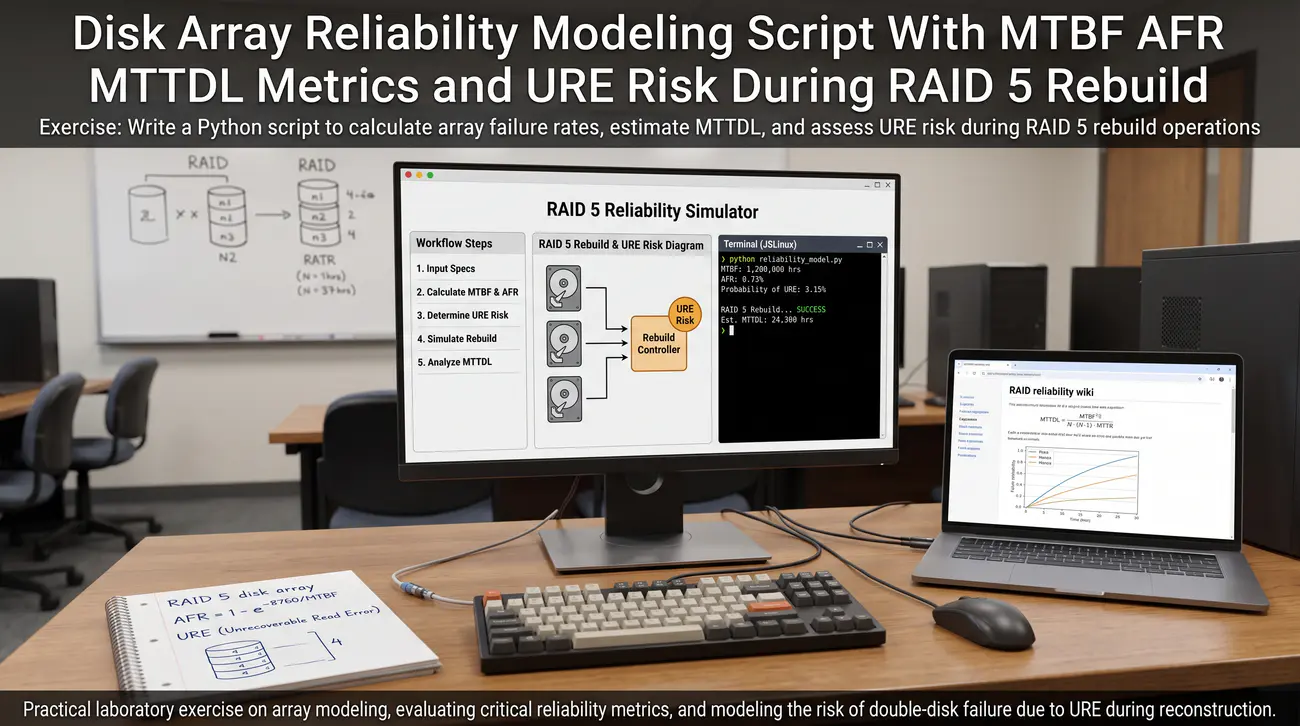
Zadanie 9. Modelowanie niezawodności macierzy dyskowej: skrypt kalkulujący wskaźniki MTBF, AFR, MTTDL i ryzyko błędu URE podczas odbudowy RAID 5
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 7, 8, 16, 20, 23: wskaźniki niezawodności nośników MTBF i AFR, czas średni do utraty danych MTTDL (Mean Time to Data Loss), błąd nieodwracalnego odczytu URE (Unrecoverable Read Error rzędu 10^14 bitów), model probabilistyczny awarii drugiego dysku podczas rebuild RAID 5 w Pythonie.

Cel

Celem zadania jest stworzenie symulatora probabilistycznego w języku Python modelującego niezawodność macierzy wielodyskowych. Student implementuje wzory na roczną stopę awaryjności AFR, oblicza wskaźnik MTTDL dla RAID 0, 1, 5 i 6 oraz przeprowadza matematyczną symulację prawdopodobieństwa wystąpienia błędu URE podczas wielogodzinnej odbudowy dysków o pojemności powyżej 8 TB, uzasadniając konieczność migracji do RAID 6.

Scenariusz – opis

W projektowaniu systemów pamięci masowej intuicja inżynierska bywa zawodna, a decyzje architektoniczne muszą opierać się na rachunku prawdopodobieństwa. Podstawowymi wskaźnikami niezawodności pojedynczego dysku są średni czas bezawaryjnej pracy MTBF (Mean Time Between Failures) oraz roczna stopa awaryjności AFR. Pomiędzy tymi parametrami zachodzi ścisła relacja matematyczna: AFR jest w przybliżeniu równe liczbie godzin w roku podzielonej przez MTBF.

Dla całej macierzy dyskowej kluczową miarą odporności jest wskaźnik MTTDL (Mean Time to Data Loss) określający statystyczny czas do całkowitej utraty danych. O ile macierz RAID 5 skutecznie chroni przed całkowitą awarią pojedynczego dysku, o tyle jej słabym punktem jest proces odbudowy (rebuild). W trakcie resynchronizacji macierzy kontroler musi odczytać każdy sektor ze wszystkich pozostałych dysków, generując gigantyczne obciążenie wejścia-wyjścia.

W tym momencie krytycznym zagrożeniem staje się zjawisko błędu nieodwracalnego odczytu URE (Unrecoverable Read Error). Dla konsumenckich dysków SATA specyfikacja producenta określa prawdopodobieństwo URE na poziomie jednego błędu na 10^14 odczytanych bitów (około 12,5 TB danych). Oznacza to, że przy odbudowie macierzy złożonej z dysków 8 TB lub 16 TB prawdopodobieństwo napotkania błędu URE i katastrofalnej utraty całej macierzy przekracza 50%. Matematyczne modelowanie tego zjawiska pozwala administratorom udowodnić konieczność wdrożenia podwójnej parzystości RAID 6 w nowoczesnych magazynach.

W tym zadaniu napiszesz skrypt analityczny w Pythonie obliczający MTTDL oraz symulujący ryzyko błędu URE metodą Monte Carlo.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia pliku raid_reliability.py w dedykowanym katalogu roboczym. Implementujesz funkcje konwersji pomiędzy wskaźnikami MTBF (podawanym w godzinach) a roczną stopą awaryjności AFR (w procentach). Definiujesz parametry grupy dyskowej: macierz złożona z N dysków o pojemności C terabajtów każdy, z czasem odbudowy MTTR (Mean Time to Repair). Implementujesz analityczne formuły wyznaczania wskaźnika MTTDL dla macierzy RAID 0, RAID 1, RAID 5 oraz RAID 6.

W kolejnym kroku implementujesz model prawdopodobieństwa wystąpienia błędu URE podczas odbudowy: P(sukces) = (1 - P_ure) do potęgi równej liczbie odczytywanych bitów. Przeprowadzasz serię obliczeń dla dysków SATA (stopa URE = 10^-14) oraz dysków SAS klasy Enterprise (stopa URE = 10^-15) dla pojemności od 2 TB do 20 TB. Wyznaczasz krytyczną pojemność dysku, powyżej której ryzyko utraty danych podczas odbudowy RAID 5 przekracza akceptowalny poziom 10%. Implementujesz symulację Monte Carlo weryfikującą analityczne wzory probabilistyczne poprzez symulację losowych awarii w horyzoncie 5 lat eksploatacji. Generujesz czytelne zestawienie tabelaryczne wyników prezentujące MTTDL oraz prawdopodobieństwo katastrofy dla różnych poziomów macierzy. Formułujesz techniczne wnioski uzasadniające wycofanie RAID 5 na rzecz RAID 6 w macierzach dysków o dużej gęstości zapisu.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/reliability_lab && cd ~/reliability_lab.
  2. Utwórz plik skryptu w języku Python: nano raid_reliability.py.
  3. Zaimportuj moduły standardowe: math, random, sys.
  4. Zaimplementuj funkcję mtbf_to_afr(mtbf_hours): afr = (8760 / mtbf_hours) * 100; return afr.
  5. Zaimplementuj wzór na MTTDL dla RAID 0: MTTDL_0 = MTBF / N.
  6. Zaimplementuj wzór na MTTDL dla RAID 1 (2 dyski): MTTDL_1 = (MTBF^2) / (2 * N * MTTR).
  7. Zaimplementuj wzór na MTTDL dla RAID 5: MTTDL_5 = (MTBF^2) / (N * (N - 1) * MTTR).
  8. Zaimplementuj wzór na MTTDL dla RAID 6: MTTDL_6 = (MTBF^3) / (N * (N - 1) * (N - 2) * MTTR^2).
  9. Zaimplementuj funkcję prob_ure(num_disks, capacity_tb, ure_rate=1e-14): bits_read = (num_disks - 1) * capacity_tb * 8 * 10^12; return 1.0 - math.exp(-bits_read * ure_rate).
  10. Oblicz ryzyko błędu URE dla macierzy 5 dysków SATA (10^-14) o pojemnościach: 2 TB, 4 TB, 8 TB, 12 TB, 16 TB.
  11. Zanotuj drastyczny wzrost prawdopodobieństwa awarii: dla 8 TB ryzyko URE wynosi ponad 35%, dla 16 TB przekracza 60%.
  12. Oblicz analogiczne prawdopodobieństwa dla dysków SAS Enterprise (ure_rate = 1e-15) i porównaj wyniki.
  13. Napisz symulator Monte Carlo (10 000 prób) losujący momenty uszkodzeń sektorów i potwierdzający zgodność z modelem analitycznym.
  14. Sformatuj wyniki do estetycznej tabeli konsolowej: Poziom RAID, Pojemnosc dysku, MTBF, MTTDL (lata), Ryzyko URE (%).
  15. Wykaż, że dla dysków 16 TB wskaźnik MTTDL macierzy RAID 5 jest w praktyce zdominowany przez zjawisko URE, a nie drugą awarię fizyczną.
  16. Wykonaj zrzuty ekranu kodu skryptu, tabeli wyników oraz analizy porównawczej.
  17. Sformułuj oficjalną rekomendację architektoniczną dla dyrektora IT dotyczącą zakazu stosowania RAID 5 dla dysków o pojemności >4 TB.

Kontrola zaliczenia (checklist):

  1. Uruchomiono kalkulator niezawodności i zachowano tabelę: AFR z MTBF, MTTDL dla RAID 0/1/5/6, ryzyko URE przy rebuildzie (dysków >4 TB).
  2. Dołączono kod (własne 20–40 linii): wzory AFR/MTTDL, model URE, wykres ryzyka vs rozmiar.
  3. Przeprowadzono test pozytywny (liczby dla profilu) i kontrolny (RAID 5 vs 6 — ilościowy dowód przewagi 6).
  4. Opisano w 3–5 zdaniach: MTBF→AFR→MTTDL, URE jako zabójca RAID 5, dobór poziomu do pojemności.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie matematycznych zależności pomiędzy wskaźnikami niezawodności MTBF, AFR oraz MTTDL.
  • Świadomość zjawiska błędu nieodwracalnego odczytu URE jako głównego czynnika ryzyka w macierzach parzystościowych.
  • Praktyczna umiejętność modelowania probabilistycznego awarii podsystemów dyskowych w języku Python.
  • Krytyczna ocena przydatności RAID 5 i dowód konieczności wdrożenia RAID 6 w nowoczesnych środowiskach dyskowych.
Zadanie 9 - ilustracja
10/10
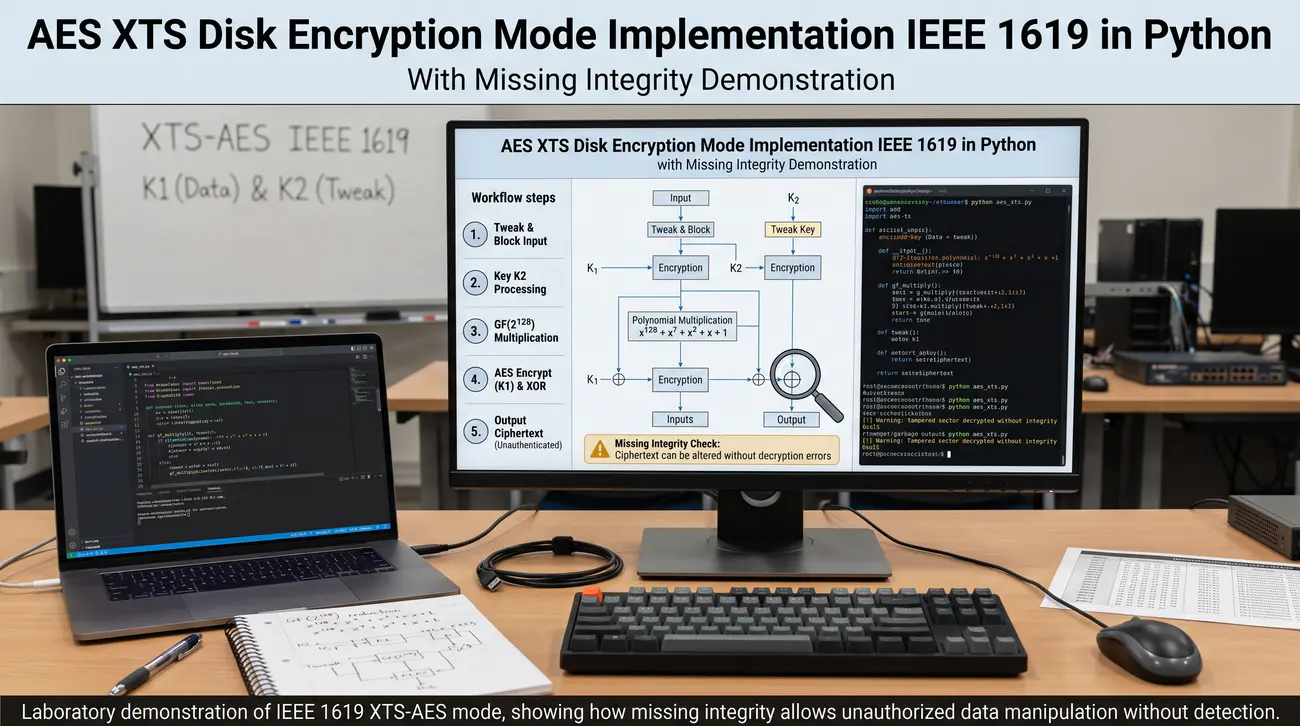
Zadanie 10. Implementacja i analiza trybu szyfrowania dyskowego AES-XTS (IEEE 1619) w Pythonie oraz demonstracja braku integralności
🖥️ Wymagane środowisko:
System: Windows + JSLinux Fedora 33 (Linux) Console (Python 3)
Oprogramowanie: przeglądarka + Python 3
Podstawa wykładowa: Część 6 - slajdy 11, 36, 43: standard IEEE 1619, szyfr dyskowy XTS-AES, dwa klucze K1 (dane) i K2 (tweak), mnożenie wielomianowe w ciele GF(2^128) z wielomianem redukcyjnym x^128 + x^7 + x^2 + x + 1, demonstracja plastyczności (malleability) i braku uwierzytelnienia (brak MAC).

Cel

Celem ćwiczenia jest programowa implementacja trybu szyfrowania dyskowego AES-XTS w języku Python oraz zbadanie jego właściwości kryptograficznych. Student implementuje wyprowadzanie wektora modyfikującego tweak dla kolejnych sektorów z mnożeniem wielomianowym przez alfa w ciele GF(2^128), szyfruje przykładowy 512-bajtowy sektor dyskowy, a następnie przeprowadza demonstrację ataku modyfikacji bitów w szyfrogramie (bit-flipping), dowodząc braku ochrony integralności w standardzie XTS.

Scenariusz – opis

Szyfrowanie pamięci masowych na poziomie sektorów blokowych narzuca specyficzne rygory niespotykane w szyfrowaniu transmisji sieciowej. Podstawowym ograniczeniem jest wymóg braku ekspansji danych: zaszyfrowany sektor 512-bajtowy lub 4096-bajtowy musi mieć dokładnie taki sam rozmiar fizyczny na dysku. Wyklucza to stosowanie tradycyjnych trybów uwierzytelnionych, takich jak AES-GCM, które dodają 16-bajtowy tag uwierzytelniający MAC do każdego bloku.

W odpowiedzi na te wyzwania instytut IEEE opracował standard IEEE 1619 definiujący tryb XTS-AES jako oficjalny standard szyfrowania dysków. Tryb XTS wykorzystuje dwa niezależne klucze AES-256 (łączny klucz 512-bitowy): klucz K1 do szyfrowania danych oraz klucz K2 do szyfrowania numeru sektora (tweak). Wewnątrz sektora wartość wektora tweak jest mnożona przez kolejne potęgi elementu pierwotnego alfa w ciele skończonym GF(2^128).

Mnożenie przez alfa w ciele GF(2^128) zdefiniowane jest operacją przesunięcia bitowego w lewo i warunkowej redukcji z wielomianem 0x87 (reprezentującym x^128 + x^7 + x^2 + x + 1). Taka konstrukcja zapobiega kopiowaniu bloków pomiędzy różnymi sektorami dysku oraz wewnątrz tego samego sektora. Jednak brak tagu integralności MAC oznacza, że tryb XTS jest podatny na manipulacje bitowe (malleability) - modyfikacja szyfrogramu niszczy jeden blok 16-bajtowy, ale nie unieważnia całego sektora.

W tym zadaniu zaimplementujesz procedurę XTS w Pythonie, zaszyfrujesz sektor dyskowy i zademonstrujesz podatność bit-flipping na strukturach systemu plików.

Co ma wykonać student / grupa

Pracę rozpoczynasz od utworzenia pliku xts_engine.py w środowisku roboczym z biblioteką cryptography lub pycryptodome. Implementujesz funkcję mnożenia w ciele GF(2^128) przez alfa gf128_mul_alpha(tweak_bytes) realizującą 128-bitowe przesunięcie w lewo i redukcję z 0x87. Implementujesz procedurę szyfrowania sektora XTS-AES-256 przyjmującą 512-bajtowy bufor danych, numer sektora LBA oraz 64-bajtowy klucz K1||K2. Obliczasz początkowy wektor T = AES_ECB(K2, LBA) zakodowany jako 16-bajtowy blok w porządku little-endian.

Dla każdego z 32 kolejnych 16-bajtowych bloków sektora obliczasz szyfrogram C_i = AES_ECB(K1, P_i XOR T_i) XOR T_i, aktualizując T_i operacją mnożenia przez alfa. Zaszyfrowujesz przykładowy sektor zawierający strukturę nagłówka systemu plików (np. superblock ext4 lub rekord MBR). Implementujesz procedurę deszyfrowania XTS i potwierdzasz pełną zgodność odszyfrowanego sektora z oryginałem.

Następnie przeprowadzasz kontrolowany atak manipulacji bitowej: modyfikujesz określone bity w szyfrogramie bloku 0 i odszyfrowujesz sektor. Analizujesz wynik: zmodyfikowany blok 0 przekształcił się w pseudolosowy szum, lecz pozostałe 31 bloków sektora odszyfrowało się w 100% poprawnie. Wykazujesz, dlaczego brak uwierzytelnienia w XTS jest akceptowany w architekturze storage oraz jak ataki bit-flipping mogą manipulować flagami w systemie plików. Kompletujesz kod źródłowy, analizę arytmetyki GF(2^128) oraz zrzuty ekranu w sprawozdaniu laboratoryjnym.

Przykładowe kroki do wykonania jako sugestia

  1. W terminalu utwórz katalog roboczy: mkdir -p ~/xts_lab && cd ~/xts_lab.
  2. Utwórz plik skryptu w języku Python: nano xts_engine.py.
  3. Zaimportuj moduły: os, struct z cryptography.hazmat.primitives.ciphers (AES, ECB).
  4. Zdefiniuj klucz 512-bitowy (64 bajty): key_512 = os.urandom(64); K1 = key_512[:32]; K2 = key_512[32:].
  5. Zaimplementuj operację mnożenia przez alfa w ciele GF(2^128): gf128_mul_alpha( tweak).
  6. W funkcji mnożenia zaimplementuj przesunięcie w lewo o 1 bit z uwzględnieniem bitu przeniesienia (carry) i redukcji xor z 0x87 na najmłodszym bajcie.
  7. Zaimplementuj szyfrowanie sektora: xts_encrypt_sector(sector_data, sector_num, K1, K2).
  8. Wylicz początkowy tweak T_0: zaszyfruj 16-bajtową reprezentację sector_num kluczem K2 w trybie ECB.
  9. W pętli po 32 blokach (po 16 bajtów) oblicz: PP = XOR(P_i, T_i); CC = AES_Encrypt(K1, PP); C_i = XOR(CC, T_i); T_{i+1} = gf128_mul_alpha(T_i).
  10. Zaimplementuj procedurę symetryczną deszyfrowania: xts_decrypt_sector( ciphertext, sector_num, K1, K2).
  11. Przygotuj 512-bajtowy sektor testowy: pierwsze 16 bajtów to flaga 'STATUS=ADMIN_NO;', kolejne 496 bajtów to dane neutralne.
  12. Zaszyfruj sektor numer 100 i upewnij się, że szyfrogram ma dokładnie 512 bajtów (brak narzutu).
  13. Odszyfruj sektor i potwierdź poprawność odzyskania tekstu jawnego.
  14. Zasymuluj atak manipulacji bitowej: zmień 2 bity w szyfrogramie bloku 0 (bajt 5 i bajt 6).
  15. Odszyfruj zmodyfikowany szyfrogram: zaobserwuj, że blok 0 uległ zniszczeniu, lecz bloki 1-31 pozostały idealnie czytelne i nieuszkodzone.
  16. Wyjaśnij zjawisko lokalności uszkodzenia w trybie XTS i brak mechanizmu odmowy autoryzacji.
  17. Wykonaj zrzuty ekranu kodu algorytmu XTS, procedury mnożenia w GF(2^128) oraz demonstracji ataku bit-flipping.
  18. Sformułuj wnioski oceniające kompromis pomiędzy brakiem narzutu przestrzennego a brakiem integralności w standardzie IEEE 1619.

Kontrola zaliczenia (checklist):

  1. Zaimplementowano AES-XTS i zachowano log: tweak per sektor (×α w GF(2¹²⁸), redukcja 0x87), zgodność z wektorem, demo plastyczności (flip bitu).
  2. Dołączono kod (własne 20–40 linii): dwa klucze, mnożenie tweak, szyfrowanie sektorów.
  3. Przeprowadzono test pozytywny (wektor przechodzi) i negatywny (flip — deszyfracja cicha, brak alarmu, pokazane).
  4. Opisano w 3–5 zdaniach: XTS bez ekspansji, tweak jako pozycja, brak MAC = plastyczność.

Wariant offline (fallback): Praca w pełni offline na wektorach ze startera w lokalnym Pythonie 3 (hashlib/struct); mdadm/smartctl zastąp logiem skryptu; dołącz kod (szkielet + własne 20–40 linii) i log z konsoli.

Sugerowane wnioski i podsumowanie - co student ma osiągnąć

Sprawozdanie z realizacji zadania musi zawierać następujące kluczowe wnioski i osiągnięcia:

  • Zrozumienie założeń projektowych standardu IEEE 1619 dla szyfrowania pamięci masowych bez ekspansji danych.
  • Praktyczna znajomość dwukluczowej architektury XTS-AES oraz roli wektora tweak w ciele GF(2^128).
  • Umiejętność implementacji niskopoziomowego mnożenia wielomianowego przez alfa z redukcją modulo 0x87.
  • Świadomość braku ochrony integralności (plastyczności) w trybie XTS i podatności na ukierunkowane ataki bit-flipping.
Zadanie 10 - ilustracja
Podgląd