Kryptologia i bezpieczna wymiana informacji
Część 2 – Szyfrowanie konwencjonalne: techniki klasyczne
Część 2 poświęcona jest technikom szyfrowania nazywanym konwencjonalnymi, czyli takim, w których nadawca i odbiorca posługują się wspólnym, tajnym kluczem. Materiał rozpoczyna się od modelu działania takiego szyfrowania, a następnie przechodzi przez kolejne klasy algorytmów: podstawienie, przestawienie oraz ich kombinacje. Każda z tych klas ma inną historię, inne mechanizmy matematyczne i inne metody łamania, dlatego omówienie ich w oddzielnych sekcjach ułatwia systematyczne opanowanie materiału.
Znajomość szyfrów klasycznych nie jest tylko ciekawostką historyczną, ponieważ wiele pojęć z tej epoki przetrwało w niezmienionej formie do dzisiaj. Pojęcie permutacji, tablice podstawień, analiza statystyczna czy idea klucza powtarzanego cyklicznie pojawiają się bowiem w nowoczesnych algorytmach, choć w znacznie bardziej rozbudowanej postaci. Zrozumienie prostych przypadków pozwala wyrobić sobie intuicję, która ułatwi później analizę szyfrów blokowych i strumieniowych.
Warto zwracać uwagę na sposób myślenia kryptoanalityka, który stara się wykorzystać każdą strukturę tekstu widoczną w szyfrogramie. Ta sama postawa przydaje się później podczas oceny bezpieczeństwa systemów, ponieważ projektanci często powtarzają błędy znane już od stuleci. Równie istotna jest umiejętność weryfikacji własnych obliczeń, którą można ćwiczyć na prostych przykładach ręcznie oraz z użyciem narzędzi programistycznych.
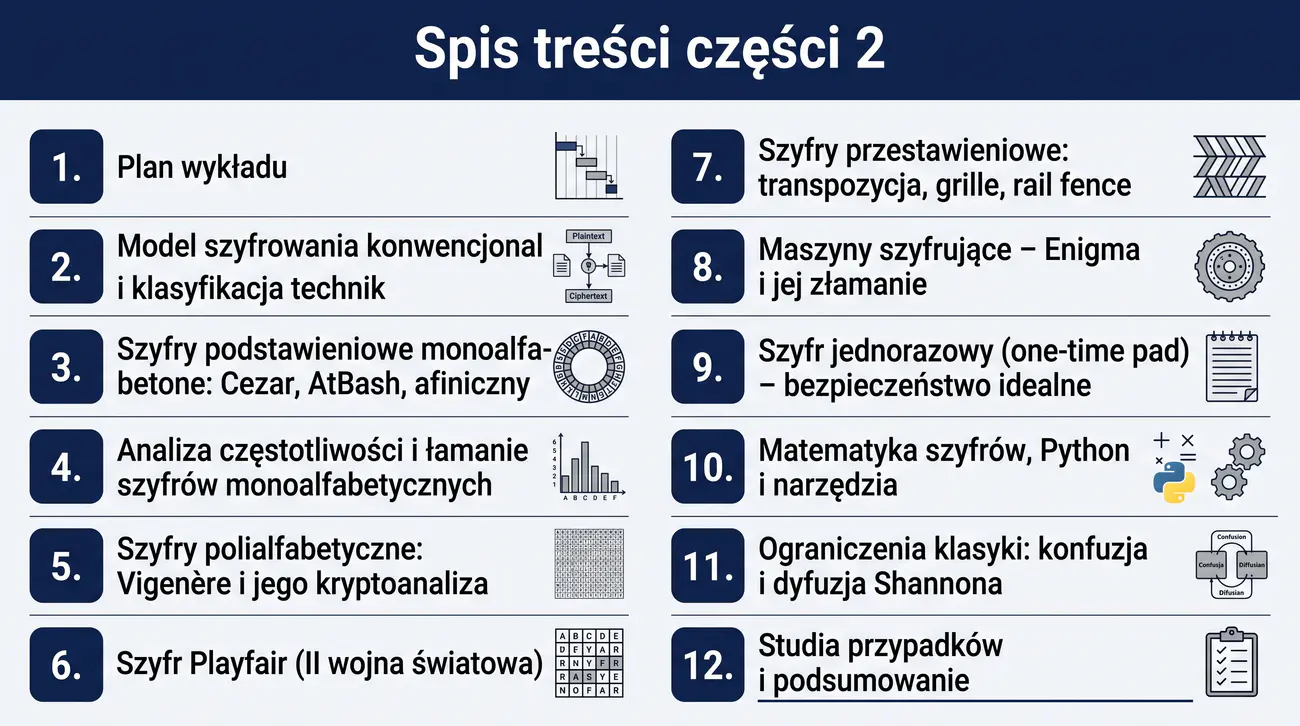
Spis treści porządkuje przebieg całego materiału i pokazuje, że materiał tworzy logiczny ciąg od pojedynczych liter do całych maszyn szyfrujących. Kolejność omawianych zagadnień nie jest przypadkowa, gdyż każde kolejne pojęcie odwołuje się do umiejętności zdobytych wcześniej. Kto rozumie, dlaczego podstawienie monoalfabetyczne zawodzi, łatwiej zrozumie motywację stojącą za szyframi polialfabetycznymi.
Przydatnym nawykiem podczas samodzielnej nauki jest śledzenie, w której części spisu znajduje się aktualnie omawiane zagadnienie i jak łączy się ono z poprzednimi oraz następnymi. Takie mapowanie wiedzy pomaga dostrzec, że problemy praktyczne, takie jak dystrybucja kluczy czy szybkość działania, przewijają się przez wiele tematów. Warto też zauważyć, że późniejsze slajdy, poświęcone matematyce i narzędziom, mają charakter wspomagający i można do nich wracać wielokrotnie.
Układ materiału obejmuje także studia przypadków i podsumowanie, co pozwala utrwalić poznawane treści w kontekście realistycznych scenariuszy. Przed rozpoczęciem nauki dobrze jest przejrzeć cały spis i zaznaczyć partie, które wymagają najwięcej pracy. Dzięki temu można zaplanować czas przeznaczony na praktyczne ćwiczenia ręczne i programistyczne, które stanowią istotną część praktyki kryptograficznej.
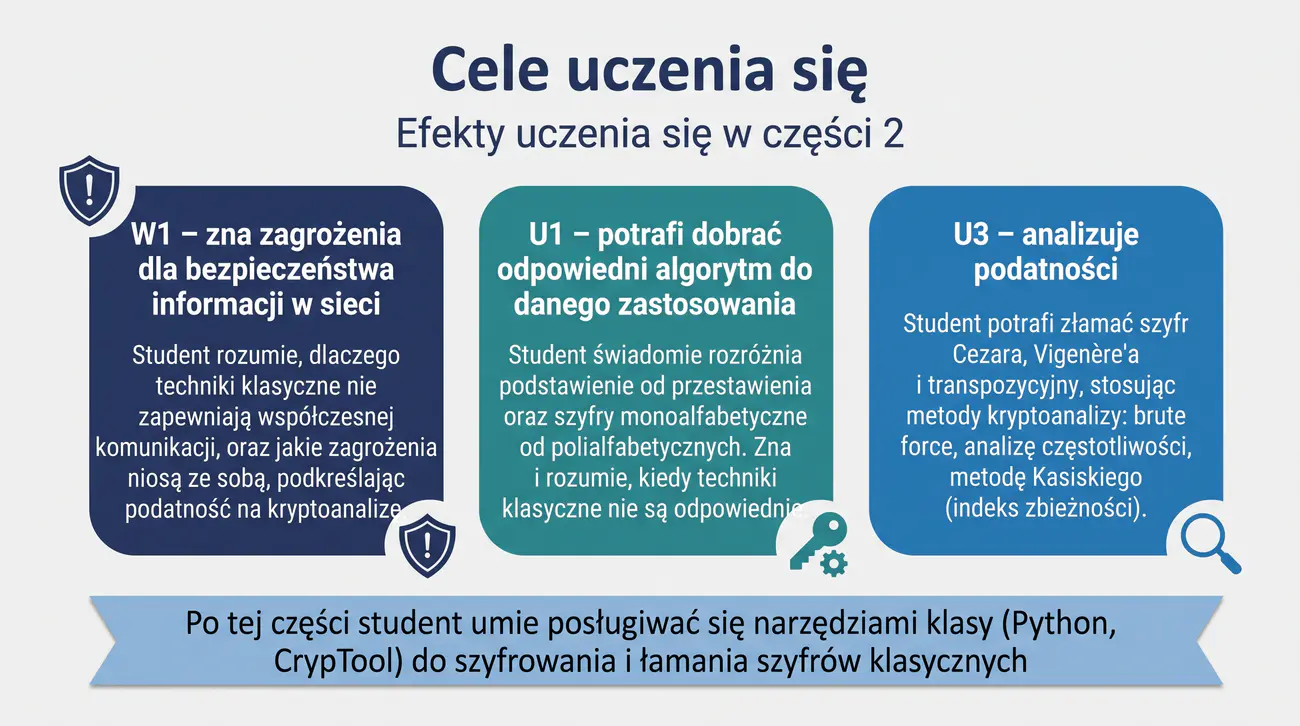
Zakres materiału ujęto w trzech grupach odpowiadających różnym poziomom opanowania zagadnień: wiedzy, umiejętnościom oraz rozumieniu zagrożeń. Wiedza dotyczy świadomości, dlaczego klasyczne techniki nie nadają się do współczesnej komunikacji, natomiast umiejętności obejmują praktyczne stosowanie oraz łamanie wybranych szyfrów. Takie ujęcie wymaga nie tylko pamięciowego opanowania definicji, lecz także umiejętnego zastosowania ich w konkretnych zadaniach.
Dobór techniki do zastosowania oznacza w praktyce zawodowej umiejętność uzasadnienia wyboru przed zespołem projektowym. Należy umieć wskazać, że szyfr monoalfabetyczny nie zapewni poufności nawet przy krótkich komunikatach, oraz wyjaśnić, dlaczego w danym przypadku lepiej sprawdzi się algorytm strumieniowy. Tego rodzaju argumentacja opiera się na cechach strukturalnych algorytmów, takich jak sposób przetwarzania bloków czy odporność na analizę statystyczną.
Trzecia grupa dotyczy kryptoanalizy, czyli metodycznego łamania szyfrów zgodnie z opisanymi procedurami. Opanowanie tych metod wymaga praktyki, dlatego na kolejnych slajdach zestawiono zadania do wykonania ręcznie oraz z użyciem Pythona i narzędzi typu CrypTool. Warto traktować te zadania jak trening umiejętności rozwiązywania problemów.
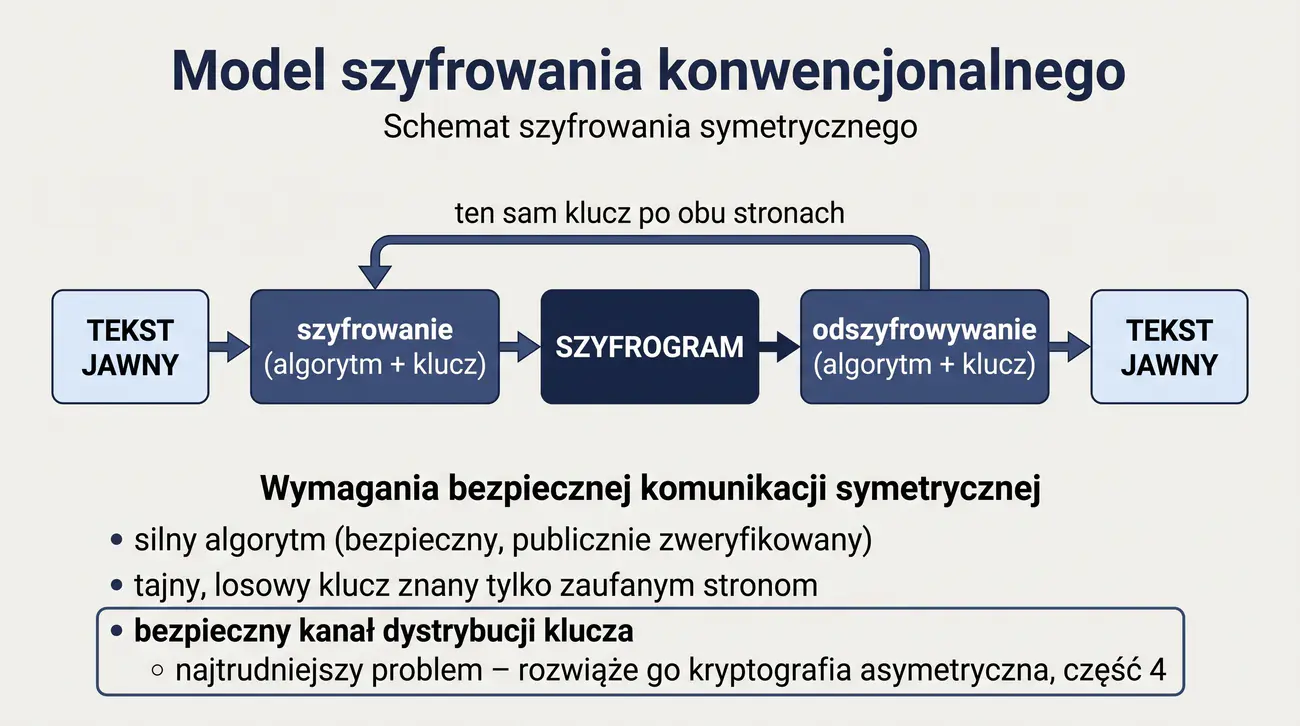
W kryptografii konwencjonalnej (symetrycznej) obie strony używają tego samego klucza:
Model szyfrowania konwencjonalnego zakłada istnienie dwóch stron komunikujących się za pomocą jednego wspólnego klucza, który musi pozostać tajny przez cały czas. W tym schemacie sam algorytm może być jawny i publicznie analizowany, natomiast cała siła ochrony wynika z zachowania poufności klucza. Taki podział odpowiedzialności odzwierciedla znaną zasadę, zgodnie z którą nie należy polegać na sekrecie samej procedury szyfrującej.
W praktyce realizacja modelu wymaga rozwiązania dodatkowych problemów, z których najbardziej fundamentalny dotyczy dostarczenia klucza obu stronom bez ryzyka jego przechwycenia. Kanał wykorzystywany do dystrybucji klucza musi być bezpieczny, co w warunkach rzeczywistych bywa trudniejsze niż samo szyfrowanie wiadomości. Ta właśnie trudność stanowi główną wadę kryptografii symetrycznej i będzie motywacją do wprowadzenia kryptografii asymetrycznej w dalszych częściach materiału.
Uzupełnieniem schematu jest świadomość, że szyfrowanie i odszyfrowywanie są operacjami wzajemnie odwrotnymi, przy czym obie wykorzystują identycznie skonfigurowany klucz. Dobra praktyka inżynierska wymaga, aby algorytm był poddany publicznej weryfikacji i analizie, zanim zostanie zastosowany do ochrony ważnych danych. Należy zatem rozróżniać niezawodność standardów uznanych przez środowisko od rozwiązań nieprzetestowanych, które mimo pozornej siły mogą zawierać błędy projektowe.
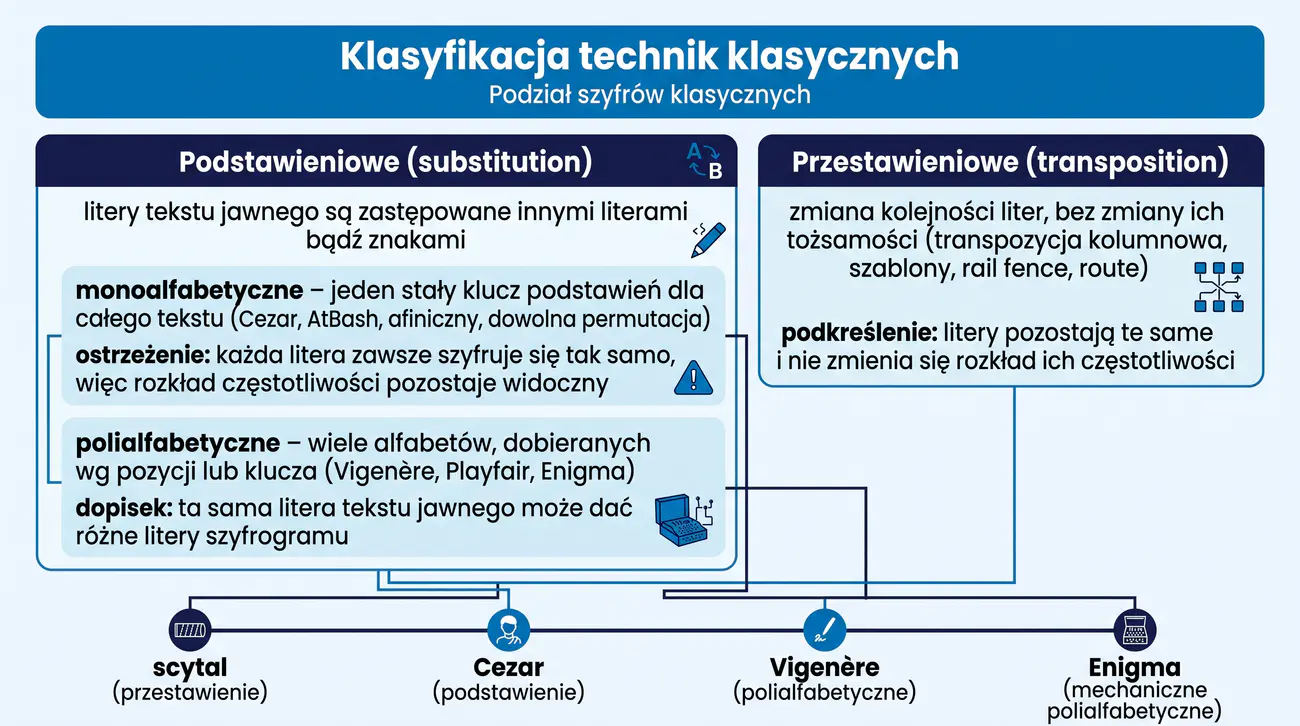
Przegląd historyczny: skytale (scytale – przestawienie), Cezar (podstawienie), Vigenère (polialfabetyczne), Enigma (mechaniczne polialfabetyczne).
Podstawowa klasyfikacja technik klasycznych rozróżnia podstawienie od przestawienia, a kryterium rozstrzygającym jest to, co dzieje się z literami tekstu jawnego. W podstawieniu litery zmieniają swoją tożsamość, natomiast w przestawieniu pozostają te same, a zmienia się wyłącznie ich kolejność. Ta różnica ma bezpośrednie konsekwencje dla metod kryptoanalizy, ponieważ podstawienie zachowuje rozkład częstotliwości, a przestawienie pozostawia naturalne statystyki jednoliterowe.
Odrębny podział wewnątrz szyfrów podstawieniowych dotyczy liczby używanych alfabetów: monoalfabetyczne stosują jeden stały klucz, natomiast polialfabetyczne dobierają alfabet na podstawie pozycji lub klucza. Rozróżnienie to pozwala ocenić, z jakim poziomem odporności mamy do czynienia, zanim jeszcze przystąpimy do analizy szyfrogramu. Warto pamiętać, że szyfry przestawieniowe potrafią być łączone z podstawieniowymi, tworząc systemy o znacznie większej sile, co wykorzystują już nowoczesne algorytmy budowane z wielu rund.
Przegląd historyczny umieszczony na slajdzie pokazuje, że rozwój technik szyfrowania przebiegał wzdłuż dwóch równoległych ścieżek: coraz bardziej złożonych podstawień i coraz wymyślniejszych przestawień. Znajomość takich kamieni milowych, jak skytale (scytale), szyfr Cezara czy maszyna Enigma, ułatwia umiejscowienie poznawanych algorytmów w czasie i kulturze ich powstania. Zrozumienie tego kontekstu ułatwia zapamiętanie technicznych szczegółów, bo wiąże je z odpowiedzią na konkretne potrzeby epoki.
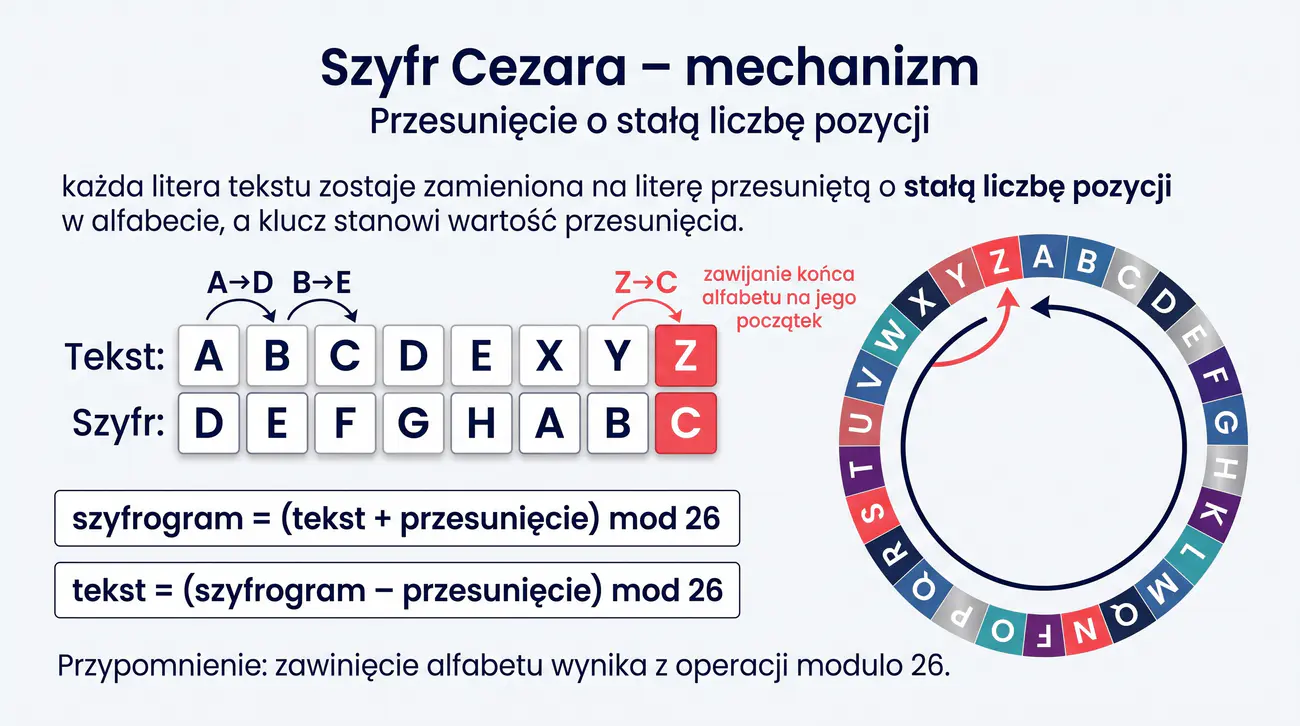
Tabela szyfrująca dla przesunięcia 3 (alfabet łaciński):
| Tekst: | A | B | C | D | E | X | Y | Z |
|---|---|---|---|---|---|---|---|---|
| Szyfr: | D | E | F | G | H | A | B | C |
Szyfr Cezara opiera się na przesunięciu liter w alfabecie o stałą liczbę pozycji, a operację powtarzaną dowolną liczbę cykli opisuje arytmetyka modulo. Wzór z użyciem operacji modulo sprawia, że po dotarciu do końca alfabetu następuje zawinięcie do jego początku, dzięki czemu obserwowany jest efekt kołowego przesuwania. Takie matematyczne ujęcie jest ważne, ponieważ znajduje zastosowanie w wielu innych, znacznie nowocześniejszych algorytmach.
Warto zauważyć, że szyfr działa poprawnie wyłącznie wtedy, gdy nadawca i odbiorca stosują ten sam alfabet i to samo przesunięcie, a wszelkie rozbieżności skutkują bełkotliwym wynikiem. W kontekście języka polskiego należy pamiętać o literach ze znakami diakrytycznymi, które nie mieszczą się w klasycznym alfabecie łacińskim; w ćwiczeniach stosuje się zazwyczaj ich transliterację lub bardziej rozbudowany alfabet. Praktyka ta uczy, że wybór alfabetu i sposobu kodowania znaków to nieodłączny element specyfikacji każdego systemu kryptograficznego.
Z matematycznego punktu widzenia istotne jest, że przesunięcie jest operacją odwracalną, dlatego odszyfrowanie wykonuje się przez zastosowanie przesunięcia odwrotnego. Złudna prostota mechanizmu nie powinna zatem sugerować, że konstrukcja takich szyfrów nie wymaga staranności przy ustalaniu zakresu działania. Umiejętność precyzyjnego opisu operacji szyfrującej w terminach arytmetyki modularnej przełoży się później na swobodne czytanie definicji algorytmów współczesnych.
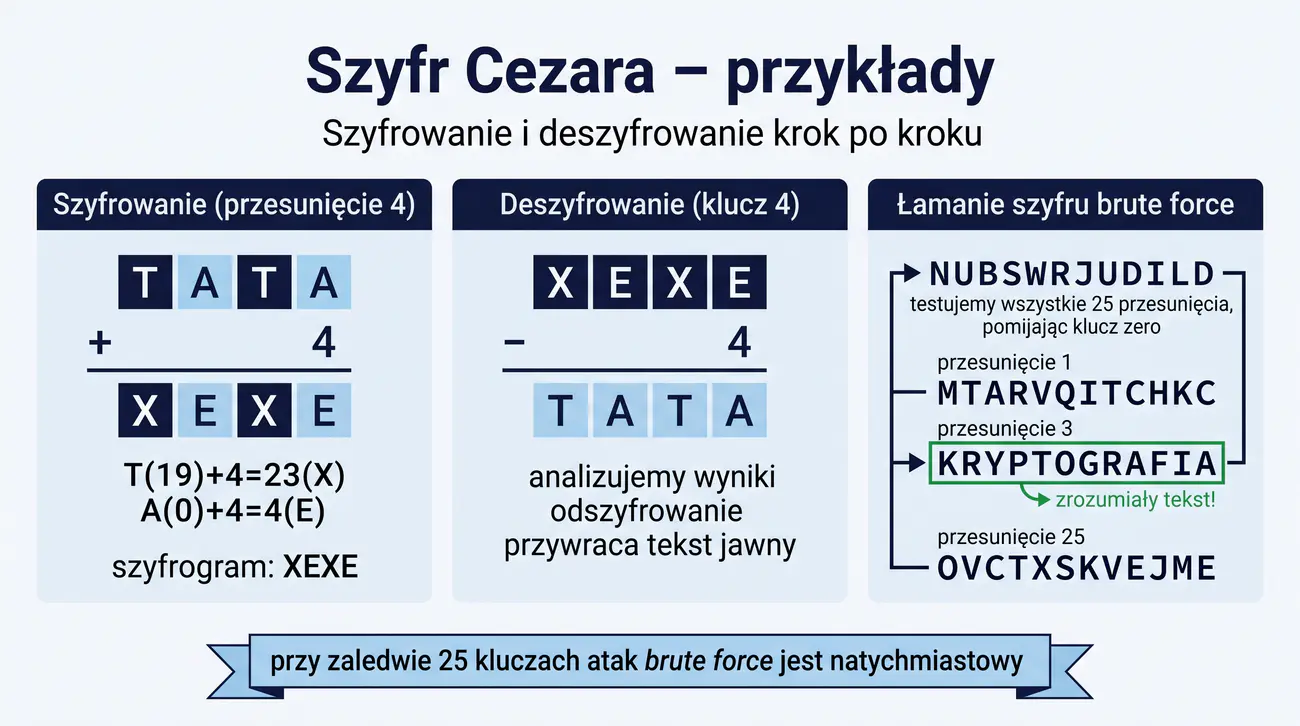
Szyfrowanie (przesunięcie 4):
Deszyfrowanie (klucz 4):
Łamanie szyfru brute force: wystarczy przetestować wszystkie 25 możliwych przesunięć (pomijając klucz 0):
$ for shift in 1..25: deszyfruj NUBSWRJUDILD i sprawdź sensowność 1: MTARVQITCHKC ... 3: KRYPTOGRAFIA <-- zrozumiały tekst! ... 25: OVCTXSKVEJME Wnioski: przy zaledwie 25 kluczach atak brute force jest natychmiastowy.
Przykłady krok po kroku pokazują, jak wygląda praktyczne zastosowanie wzoru szyfru Cezara na konkretnych literach, co pozwala oswoić się z konwencją numerowania liter od zera. Zacienienie tych samych liter w tekście jawnym i szyfrogramie podkreśla, że każda litera jest przetwarzana niezależnie, a klucz pozostaje stały w trakcie całej operacji. Takie ręczne obliczenia warto powtórzyć samodzielnie na kilku słowach, aby wyrobić pewność w posługiwaniu się tabelą.
Łamanie metodą prób polega na sprawdzeniu wszystkich dopuszczalnych przesunięć i poszukaniu wśród wyników tekstu o naturalnej strukturze językowej. Ta procedura dobrze ilustruje, czym jest atak brute force przeprowadzany bez znajomości klucza, i uzmysławia, jak niewielka przestrzeń kluczy prowadzi do natychmiastowego rozwiązania. Warto przy tym zauważyć, że dla krótkich komunikatów wynik bywa niejednoznaczny, ponieważ kilka przesunięć może przypadkowo tworzyć fragmenty podobne do słów.
Praktyczna wskazówka polega na sprawdzaniu sensowności wyniku nie tylko pojedynczymi słowami, lecz całymi frazami, uwzględniając typowe dla języka zakończenia. Automatyzację takiej weryfikacji można oprzeć na słowniku lub na wartościach prawdopodobieństwa wystąpień dwuznaków i trójznaków. Dzięki takiemu podejściu widać, że nawet prosty szyfr można analizować metodami ilościowymi, a nie tylko przez subiektywną ocenę czytelności.
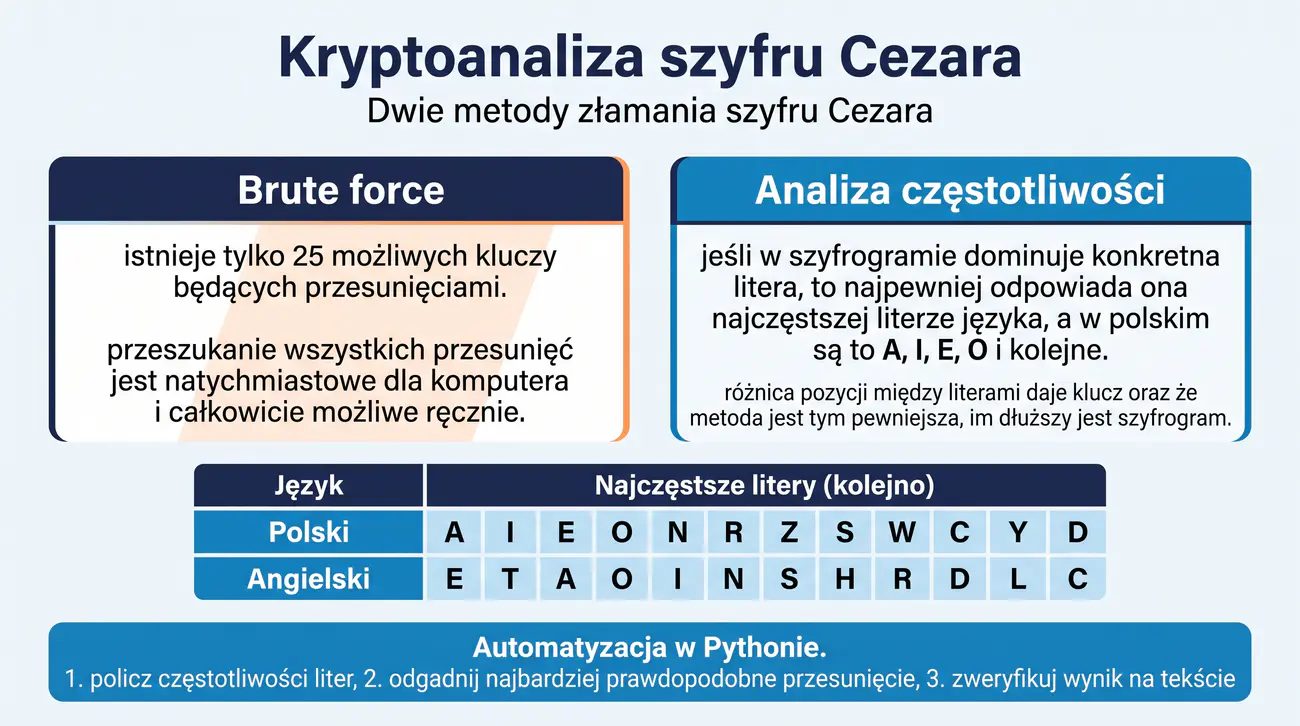
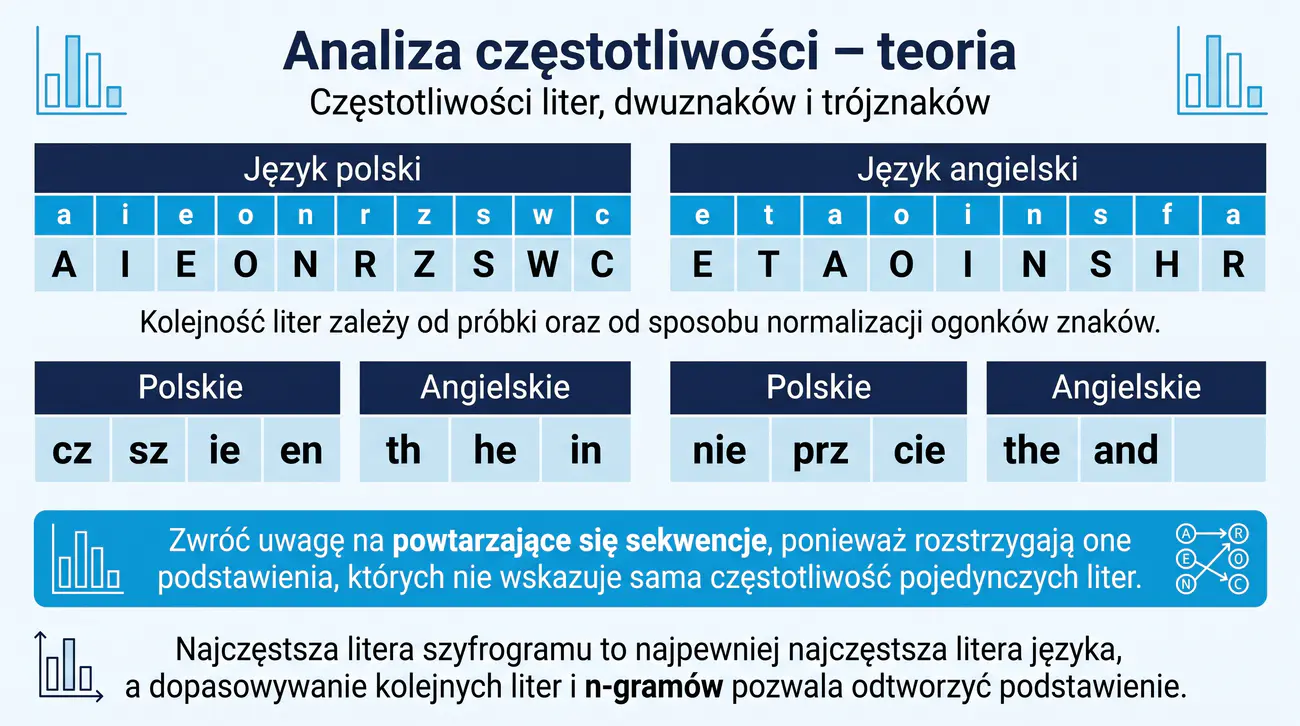
Porównanie częstotliwości – język polski i angielski:
| Język | Najczęstsze litery (kolejno) |
|---|---|
| polski | A I E O N R Z S W C Y D |
| angielski | E T A O I N S H R D L C |
Kryptoanaliza szyfru Cezara jest elementarnym przykładem zderzenia dwóch ogólnych strategii ataku: przeszukiwania wyczerpującego i wnioskowania statystycznego. Metoda pierwsza wykorzystuje fakt, że liczba możliwych kluczy jest śmiesznie mała, natomiast druga opiera się na charakterystycznej strukturze języka, w którym niektóre litery występują znacznie częściej od innych. Obie techniki można stosować niezależnie, a ich wynik można sprawdzić na podstawie czytelności otrzymanego tekstu.
Analiza częstotliwości wymaga znajomości rozkładu liter w danym języku, a rozkłady dla polskiego i angielskiego różnią się na tyle, że posłużenie się rozkładem niewłaściwego języka prowadzi do błędnego odczytu. W tekście polskim najczęstszymi literami są zwykle samogłoski, natomiast w angielskim dominuje litera E, co wynika z różnic w fonetyce i pisowni obu języków. Przy krótkich wiadomościach rozkład obserwowany w próbce bywa jednak mylący, dlatego statystyce towarzyszy zawsze sprawdzenie sensowności całych wyrazów.
Umiejętność przeprowadzenia automatycznej analizy częstotliwości w Pythonie łączy w sobie zliczanie wystąpień, porządkowanie wyników i formułowanie hipotez o kluczu. Należy pamiętać, że jednoznaczne odgadnięcie przesunięcia możliwe jest dopiero po zweryfikowaniu hipotezy na tekście, najlepiej na jego dłuższym fragmencie. Taki tok postępowania uczuli na fundamentalną zasadę, że każdą hipotezę kryptoanalityczną należy potwierdzić zgodnością wyniku z regułami języka.
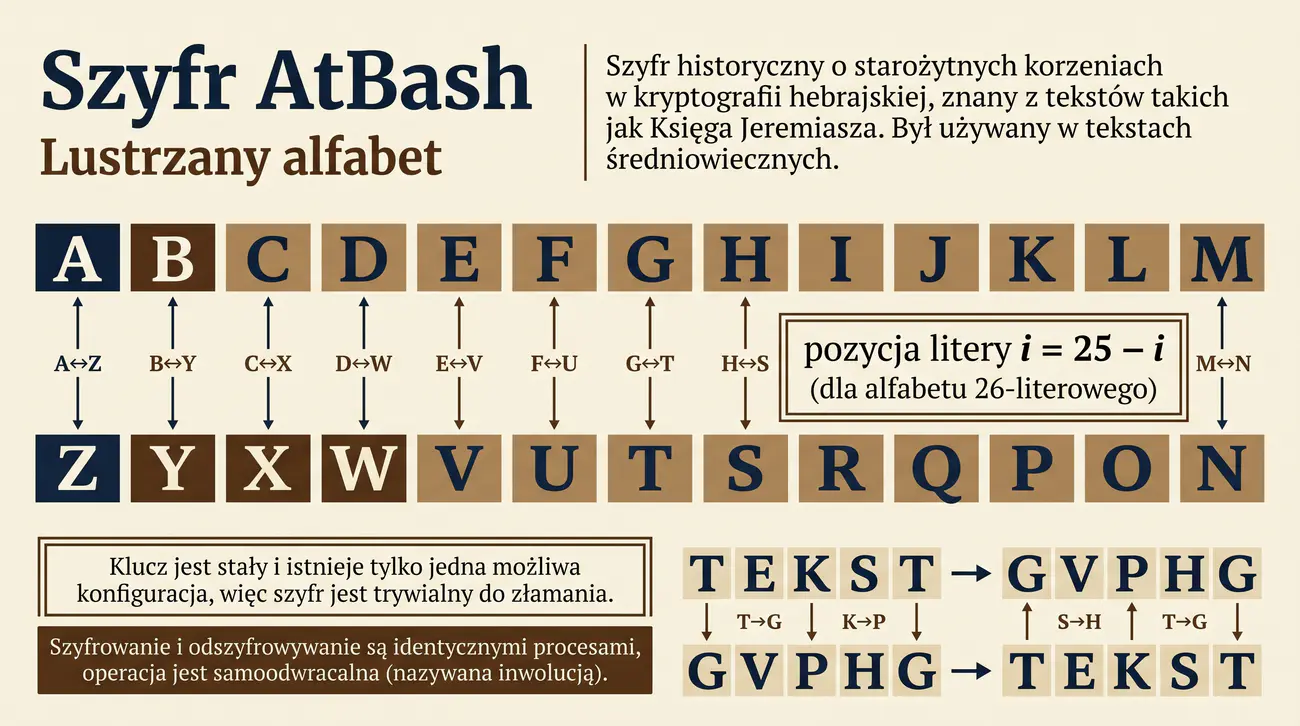
Szyfr AtBash to najbardziej elementarny przykład podstawienia lustrzanego, w którym obie strony alfabetu są zamieniane miejscami względem jego osi symetrii. Nazwa szyfru pochodzi od hebrajskich liter oznaczających w uproszczeniu pierwszą i ostatnią literę alfabetu, co oddaje istotę operacji odwracającej porządek. Ze względu na swój mechanizm szyfr ten działa identycznie zarówno podczas szyfrowania, jak i odszyfrowywania, gdyż dwukrotne zastosowanie przekształcenia przywraca tekst wyjściowy.
Historycznie AtBash wykorzystywano w kryptografii hebrajskiej, między innymi w tekstach biblijnych, co czyni z niego jeden z najstarszych opisanych szyfrów podstawieniowych. W średniowieczu podobne techniki lustrzane pojawiały się w różnych kręgach kulturowych, często jako ozdoba literacka lub forma ukrycia treści przed przypadkowym czytelnikiem. Z dzisiejszego punktu widzenia istotne jest jednak, że szyfr ma dokładnie jedno możliwe ustawienie, a zatem brak w nim jakiegokolwiek klucza w ścisłym tego słowa znaczeniu.
Naukowa wartość AtBash polega na tym, że uwidacznia on rolę liczby możliwych konfiguracji w ocenie bezpieczeństwa systemu. Skoro podstawienie realizujące odwrócenie alfabetu ma zero stopni swobody, jego złamanie nie wymaga żadnych obliczeń, wystarczy bowiem znać mechanizm. Analiza tego skrajnego przypadku pomaga zrozumieć, dlaczego w mocnych szyfrach klucz musi wprowadzać wystarczająco dużą liczbę możliwych wariantów działania.
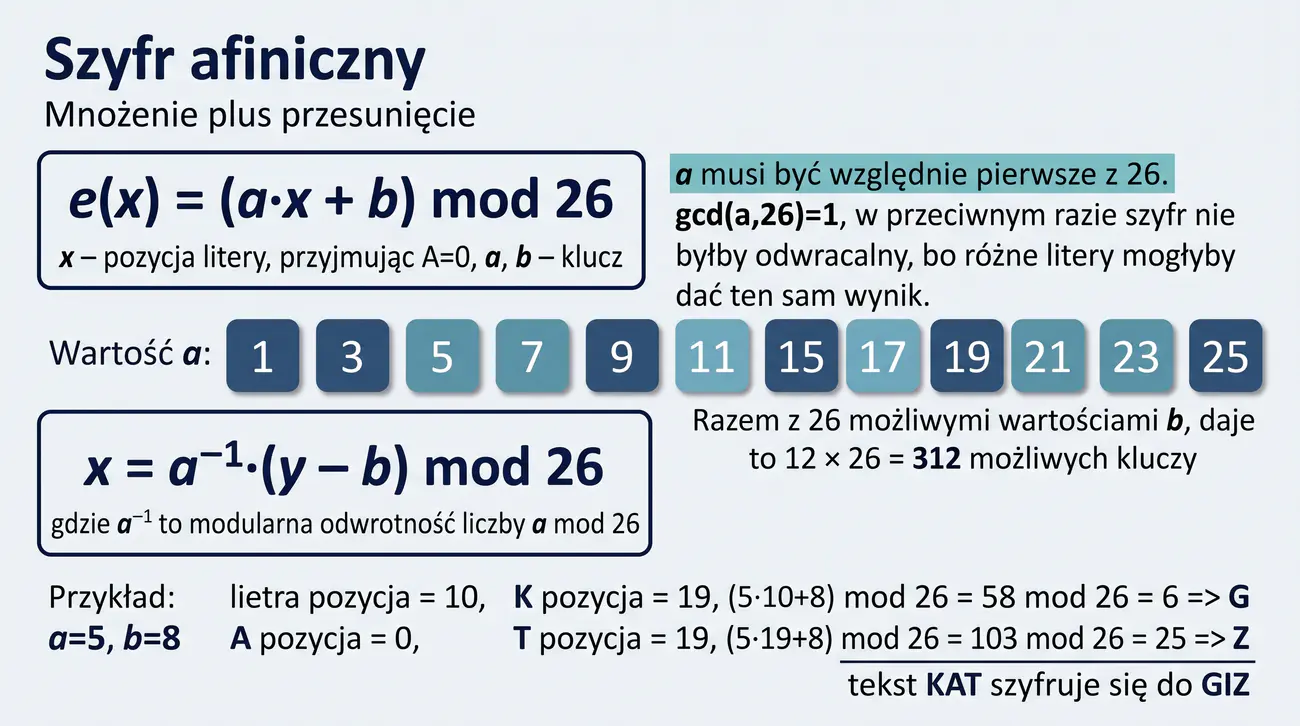
Szyfr afiniczny stanowi połączenie dwóch przekształceń arytmetycznych: mnożenia współczynnika przez numer litery oraz dodawania składnika przesunięcia, a obie wartości tworzą parametr klucza. Dzięki mnożeniu litery rozproszenie podstawień nie jest już jednorodnym przesunięciem, co sprawia, że kolejność liter w szyfrogramie ulega bardziej zróżnicowanym zmianom. Warunkiem poprawnego działania jest jednak, aby mnożnik był względnie pierwszy z liczbą liter alfabetu, w przeciwnym razie funkcja przestaje być jednoznacznie odwracalna.
Warunek odwracalności wynika z tego, że mnożenie modulo wymaga istnienia odwrotności modularnej współczynnika, a liczba ta istnieje tylko wtedy, gdy dzielnik i moduł są względnie pierwsze. Zbiór dozwolonych wartości współczynnika zawiera zaledwie dwanaście liczb, co po połączeniu z dwudziestoma sześcioma możliwymi przesunięciami daje w sumie trzysta dwanaście kluczy. Liczba ta, choć większa niż w przypadku szyfru Cezara, wciąż jest niemal trywialna dla współczesnej analizy komputerowej.
Warto zauważyć, że przykłady takie jak zaszyfrowanie tekstu KAT do GIZ ilustrują konieczność uważnego wykonywania działań w arytmetyce modularnej. Wyznaczanie odszyfrowania wymaga natomiast znajomości odwrotności modularnej, której można poszukiwać metodą prób lub za pomocą rozszerzonego algorytmu Euklidesa. Opanowanie tych obliczeń przygotowuje do pracy ze znacznie bardziej złożonymi konstrukcjami, w których arytmetyka modularna odgrywa podstawową rolę.
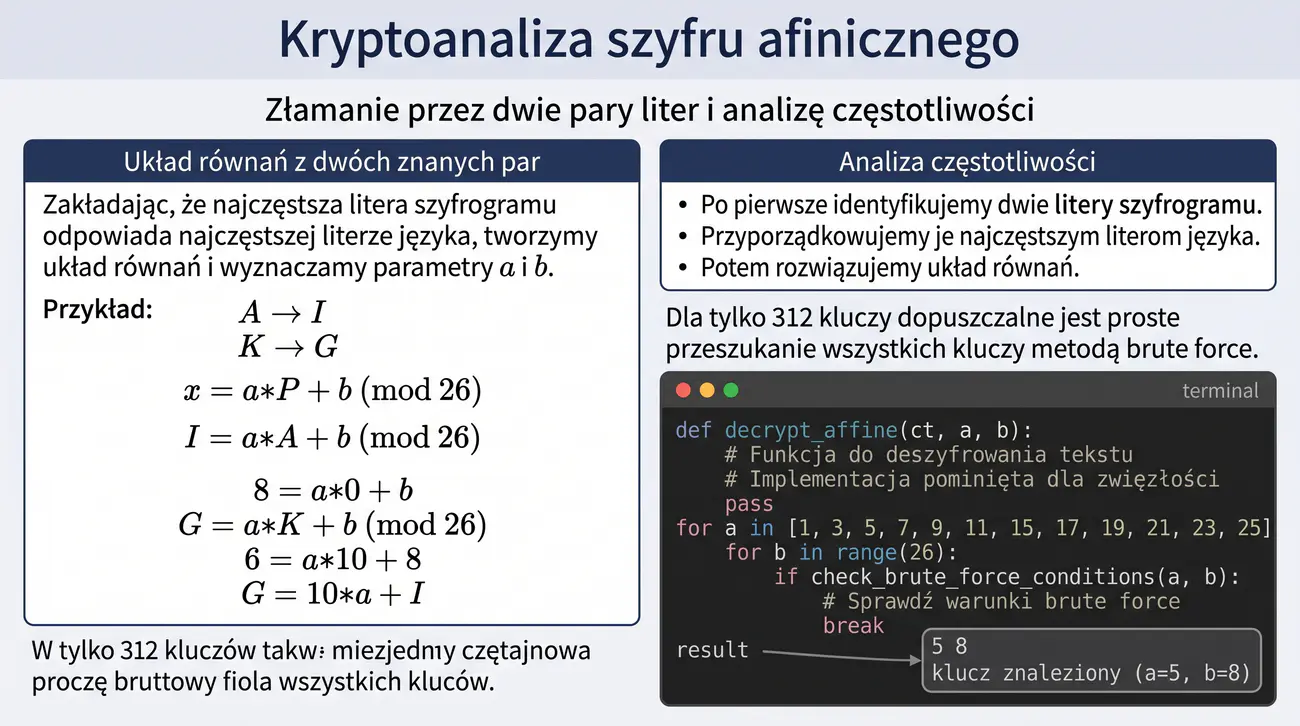
$ python3 -c " A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' def aff(x,a,b): return (a*x+b)%26 # pary: jawna A->szyfr I, jawna K->szyfr G # szukaj a,b: for a in [1,3,5,7,9,11,15,17,19,21,23,25]: for b in range(26): if aff(0,a,b)==8 and aff(10,a,b)==6: print(a,b)" 5 8 # -> klucz znaleziony: a=5, b=8 (KAT -> GIZ)
Kryptoanaliza szyfru afinicznego wykorzystuje fakt, że znajomość dwóch par liter jawnych i zaszyfrowanych pozwala ułożyć układ dwóch równań z dwiema niewiadomymi, którymi są współczynnik i przesunięcie. Kluczowa trudność sprowadza się zatem do pozyskania wiarygodnych par, a dostarcza ich analiza częstotliwości, która nadaje najczęstszym literom szyfrogramu wartości najczęstszych liter języka. Po rozwiązaniu układu równań weryfikuje się wynik na dalszych fragmentach tekstu, aby upewnić się, że hipoteza jest poprawna.
Rozwiązanie układu równań wymaga sprawnej arytmetyki modularnej, w tym wyznaczania odwrotności współczynnika, którą najwygodniej obliczyć rozszerzonym algorytmem Euklidesa. W sytuacji, gdy poprawne pary nie są oczywiste, analityk musi przetestować również alternatywne przypuszczenia, co w praktyce sprowadza się do przeglądu ograniczonej liczby kombinacji. Solidność wyników ocenia się przez próbne odszyfrowanie całego tekstu i sprawdzenie jego spójności językowej.
Dla zautomatyzowania czynności można przygotować skrypt, który przegląda wszystkie dozwolone pary współczynnika i przesunięcia, filtrując te, które spełniają warunki wynikające z zaobserwowanych par liter. Ponieważ przestrzeń kluczy liczy zaledwie trzysta dwanaście elementów, prosty przegląd wszystkich możliwości jest w pełni wykonalny niemal natychmiast. Taki przykład dobrze pokazuje, że łączenie wnioskowania statystycznego z szybkim przeszukiwaniem programu ułatwia pracę kryptoanalityka nawet nad prostymi szyframi.
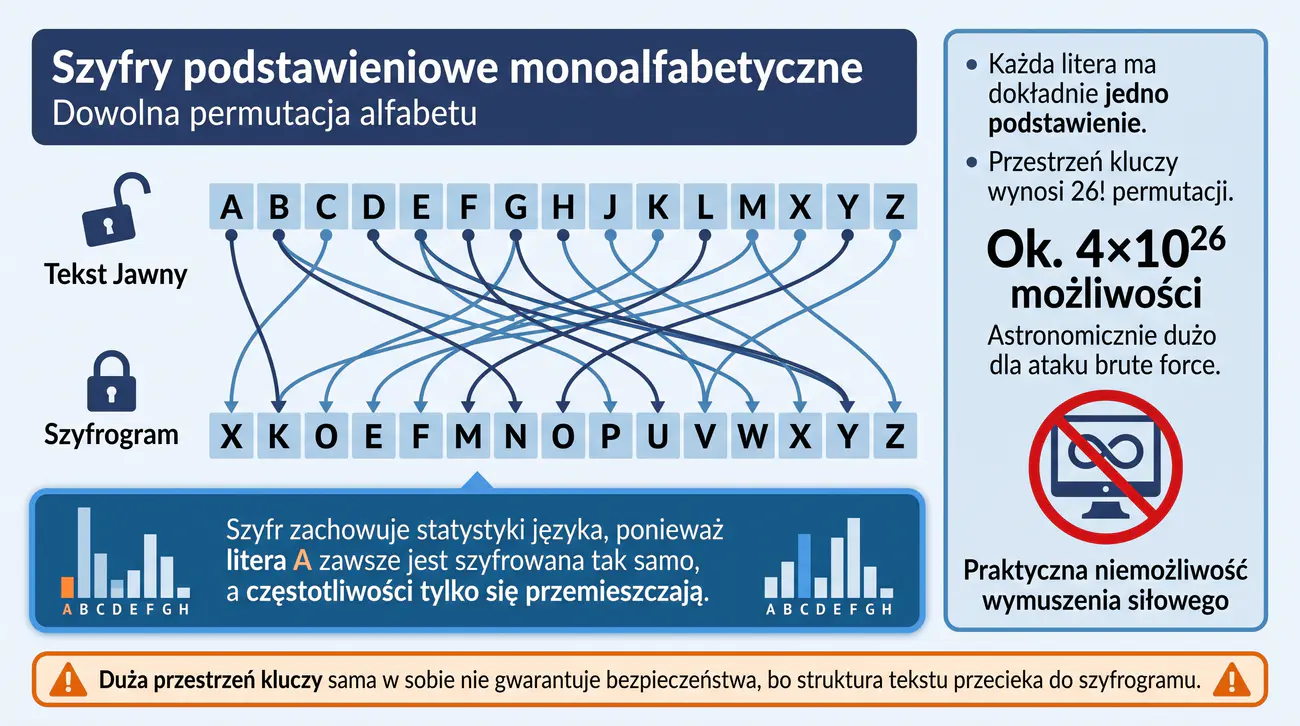
Rozważanie dowolnej permutacji alfabetu to najbardziej ogólny przypadek podstawienia monoalfabetycznego, w którym każda litera otrzymuje stałe, unikalne odwzorowanie. Liczba możliwych kluczy, równa silni długości alfabetu, osiąga wartości astronomiczne, co mogłoby sugerować wyjątkową odporność takiej konstrukcji. W rzeczywistości jednak bezpieczeństwo nie wynika z liczby kluczy, lecz z zachowania się struktury języka po zastosowaniu podstawienia.
Ponieważ podstawienie jest stałe, każda litera języka jest odwzorowywana zawsze na tę samą literę szyfrogramu, przez co rozkład częstotliwości zostaje zachowany, jedynie przemieszczony między literami. Kryptoanalityk może zatem odtworzyć podstawienie, porównując statystykę szyfrogramu z oczekiwanymi częstościami liter oraz wspierając się wzorcami słów i n-gramami. Ten przykład jest jedną z najważniejszych lekcji kryptografii, gdyż pokazuje, że ogromna przestrzeń kluczy nie gwarantuje odporności na ataki statystyczne.
Z praktycznego punktu widzenia złamanie permutacji wymaga dokładnej znajomości charakterystyk języka, w szczególności najczęstszych liter, dwuznaków i trójznaków. Stopniowe uzupełnianie podstawienia odbywa się metodą hipotez i ich weryfikacji, przy czym każda nowo odkryta zależność musi współgrać z pozostałymi częściami tekstu. Warto też mieć świadomość, że im dłuższy przechwycony szyfrogram, tym statystyka jest wierniejsza i tym pewniejszy przebieg odtwarzania podstawienia.
Wynik analizy obliczono dla reprezentatywnych próbek tekstów:
Dwuznaki (digramy) – w polskim np. „cz”, „sz”, „ie”, „en”; w angielskim „th”, „he”, „in”. Trójznaki (trigramy) – pol. „nie”, „prz”, „cie”; ang. „the”, „and”.
Warto zwracać uwagę na powtarzające się sekwencje, bo rozstrzygają one podstawienia, których nie wskazuje sama częstotliwość pojedynczych liter.
Analiza częstotliwości w swojej teoretycznej postaci opiera się na charakterystycznych, stosunkowo stabilnych rozkładach liter w tekstach danego języka, które można wyznaczyć na podstawie obszernych próbek. Uzyskane tabele nie są jednak uniwersalne, gdyż zależą od stylu tekstu, gatunku wypowiedzi oraz sposobu potraktowania liter ze znakami diakrytycznymi. Dlatego poważne narzędzia pozwalają użytkownikowi na dobór języka i trybu normalizacji przed przystąpieniem do analizy.
Równolegle do rozkładów pojedynczych liter istotne są statystyki dwuznaków i trójznaków, które niosą dodatkową informację o strukturze języka i pozwalają rozstrzygać przypadki niejednoznaczne. Kombinacje takie jak polskie cz czy sz, a angielskie th czy he, występują z bardzo różnymi częstościami, co umożliwia odtworzenie podstawienia znacznie pewniej niż przy samej analizie liter. W praktyce dopasowanie częstotliwości n-gramów bywa nawet skuteczniejsze od porównywania pojedynczych liter.
Wnioskowanie kryptoanalityczne polega na hierarchicznym wykorzystaniu tych statystyk: najpierw liter najczęstszych, potem dwuznaków, a na końcu całych wyrazów i ich wzorców. Każdy kolejny poziom wnioskowań ogranicza zbiór dopuszczalnych podstawień i pozwala wykryć ewentualne błędy wcześniejszych hipotez. Uporządkowanie to nadaje analizie charakter metodyczny i daje powtarzalną procedurę postępowania zamiast przypadkowych prób.
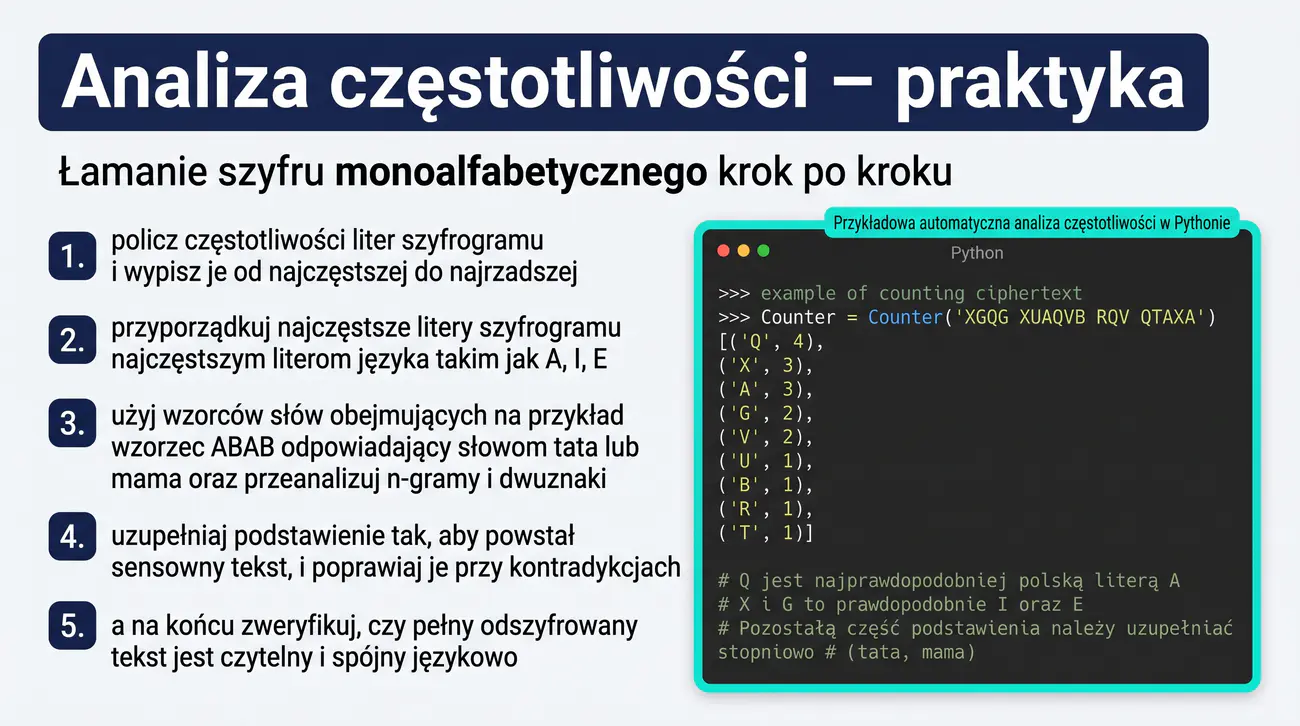
$ python3 -c " from collections import Counter c='DKJWZ IKEUQ HOJZTK JLYZBYKR DKJWZVQ LYZEYKRK' print(Counter(c.replace(' ','')).most_common(6)) # [('K',7),('Z',5),('J',4),('Y',4),('D',2),('W',2)] # K -> 'A', Z -> 'E', J -> 'Z', Y -> 'I' (najczestsze litery polskie) # fragment DKJWZ wystepuje 2x -> slowo KAZDE; reszta z kontekstu"
Praktyczna analiza częstotliwości zaczyna się od utworzenia rankingu liter w szyfrogramie, który od razu wskazuje najbardziej prawdopodobne podstawienia najczęstszych liter języka. Kolejnym etapem jest odgadywanie podstawień na podstawie struktury wyrazów, gdzie wzorce powtarzających się liter, takie jak schemat ABAB, sugerują konkretne słowa języka. Taki sposób pracy łączy w sobie wnioskowanie statystyczne z wiedzą o typowych formach językowych.
Podczas uzupełniania podstawienia analityk musi być przygotowany na sprzeczności, które pojawiają się, gdy wstępne przypuszczenia nie pasują do kolejnych fragmentów tekstu. W takich sytuacjach należy cofnąć błędną hipotezę i zastąpić ją inną, zachowując spójność całego układu przypisań. Systematyczne notowanie aktualnie odkrytych par liter w tabeli podstawień znacząco ułatwia pracę i zmniejsza ryzyko pomyłki.
Końcowa weryfikacja polega na odczytaniu pełnego tekstu i sprawdzeniu jego spójności językowej, przy czym poprawny wynik powinien być czytelny bez żadnych przeróbek. Cennym narzędziem są tu rzadkie litery, które często jednoznacznie wskazują konkretne rozwiązanie, oraz znaki interpunkcyjne ułatwiające podział na wyrazy. Warto ćwiczyć całą procedurę na przygotowanych zadaniach warstwowych, aby nabrać wprawy w szybkim formułowaniu i testowaniu hipotez.
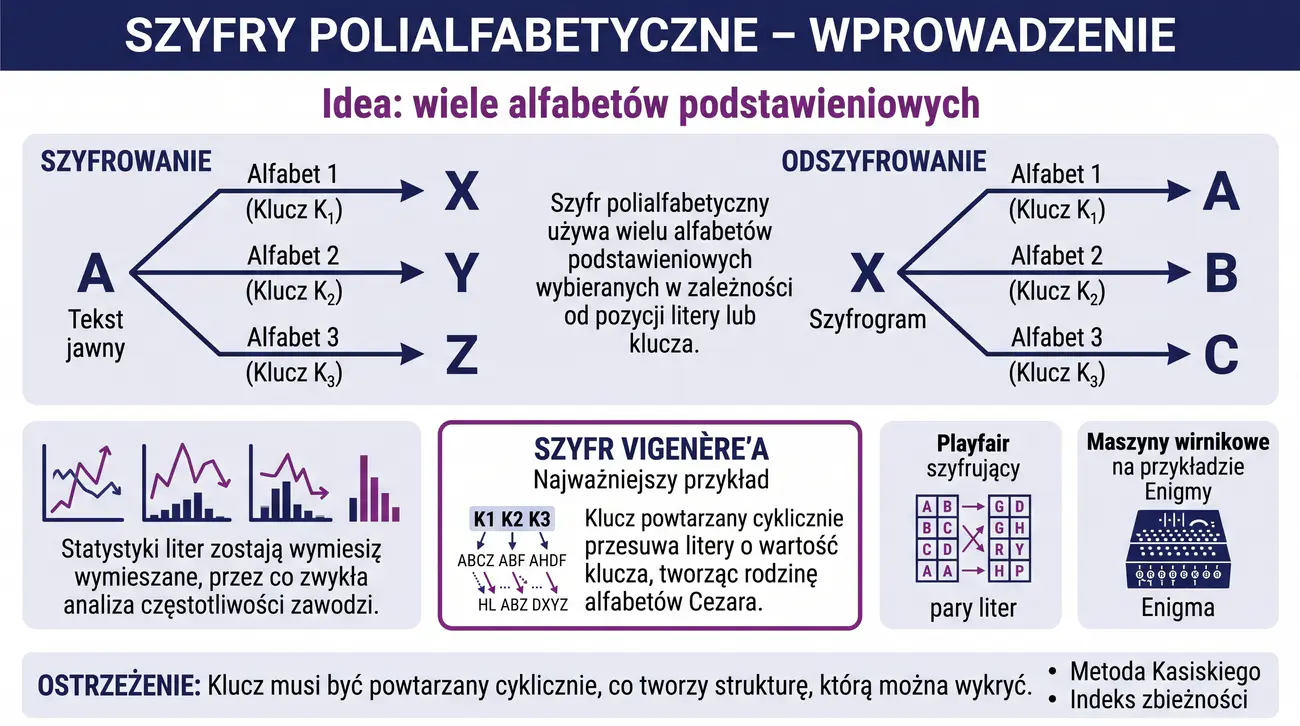
Szyfry polialfabetyczne wywodzą się z trafnej obserwacji, że najsłabszym punktem podstawienia monoalfabetycznego jest stałość odwzorowania liter. Zmiana alfabetu w zależności od pozycji znaku sprawia, że ta sama litera tekstu jawnego może być reprezentowana przez różne litery szyfrogramu, a statystyka jednoliterowa przestaje być wiarygodnym źródłem informacji. Dzięki temu udaje się zatrzeć najbardziej oczywiste ślady języka, które tak ułatwiają łamanie prostszych szyfrów.
Wzorcowym przykładem rodziny polialfabetycznej jest szyfr Vigenère’a, w którym kolejne litery klucza wyznaczają odrębne przesunięcia, a klucz powtarza się cyklicznie. Naturalną konsekwencją cyklicznego powtarzania klucza jest jednak pojawienie się periodycznej struktury w szyfrogramie, co stanowi podstawę ataków wykorzystujących tę regularność. Inne rozwinięcia tej idei, takie jak maszyna Enigma, przenoszą polialfabetyczną zasadę na zestawy wirników. Szyfr Playfair idzie inną drogą: jest podstawieniem digramów, a nie szyfrem polialfabetycznym, ponieważ zawsze używa jednego, ustalonego alfabetu podstawienia.
Warto dostrzec, że polialfabetyczność jest koncepcyjnym przodkiem nowoczesnych szyfrów strumieniowych, w których klucz generuje pozornie losowy ciąg przeznaczony do wymieszania z tekstem. O ile jednak nowoczesne algorytmy strumieniowe dbają o nieprzewidywalność ciągu kluczowego, o tyle klasyczne warianty opierają się na rozsądnym choć rozpoznawalnym powtarzaniu. Zrozumienie tej różnicy wyjaśnia, dlaczego od własności klucza, a nie tylko od liczby użytych alfabetów, zależy faktyczna odporność systemu.
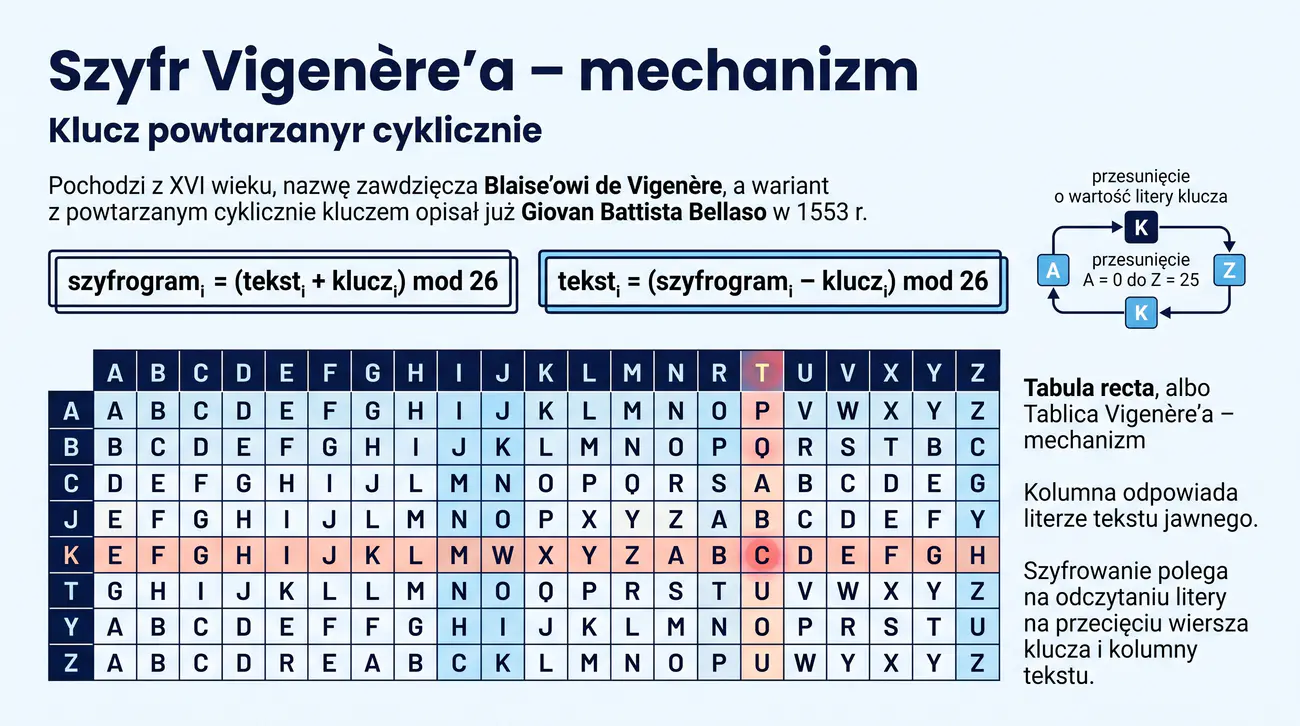
Szyfr Vigenère’a opiera się na serii alfabetów Cezara, z których każdy jest używany przez jedną literę wiadomości, po czym następuje powrót do pierwszego alfabetu wraz z kolejnym przebiegiem klucza. Działanie systemu najwygodniej śledzić w tablicy nazywanej tabula recta, w której wiersze odpowiadają kolejnym literom klucza, a kolumny literom tekstu jawnego. Taka graficzna reprezentacja ukazuje w jednym miejscu wszystkie możliwe przesunięcia i ułatwia wyznaczenie wyniku bez rachunków.
Historycznie wariant z cyklicznie powtarzanym kluczem opisano już w szesnastym wieku, jednak nazwisko Vigenère’a przetrwało w nazwie szyfru dzięki jego późniejszej szerokiej propagacji w Europie. Warto pamiętać o tym rozróżnieniu, gdyż trafia ono w sedno kwestii autorstwa i przypisywania nazw w historii kryptologii. Istotne jest natomiast, że w każdej swej odmianie szyfr pozostaje systemem periodycznym o ściśle określonej długości powtórzenia.
Matematyczny opis działania pozwala łatwo przejść od rachunków ręcznych do implementacji programistycznych, gdyż operacja sprowadza się do dodawania modulo długości alfabetu. Odszyfrowanie wymaga wykonania działania odwrotnego, czyli odjęcia wartości odpowiedniej litery klucza, przy zachowaniu tego samego cyklu. Opanowanie tej zależności jest niezbędne przed przejściem do metod wykrywania długości klucza oraz odtwarzania samego klucza.
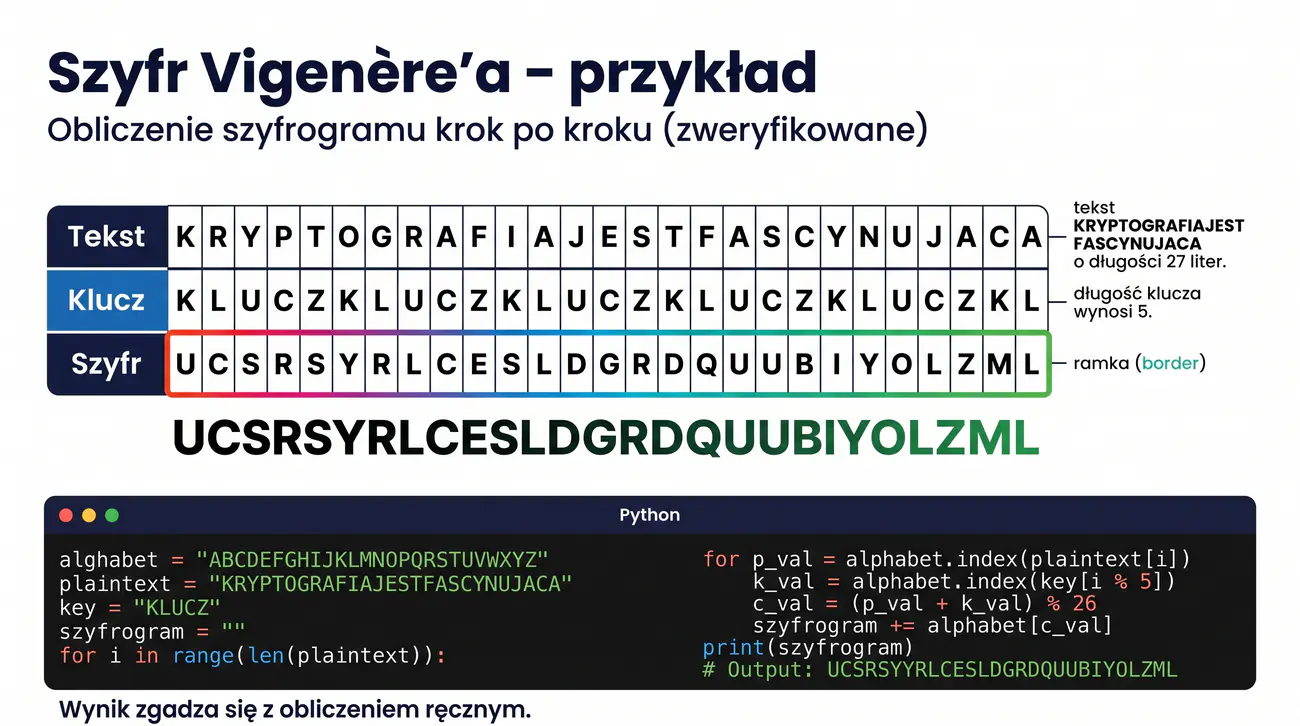
Tekst jawny: KRYPTOGRAFIAJESTFASCYNUJACA (27 liter), klucz KLUCZ (długość 5).
| Tekst: | K | R | Y | P | T | O | G | R | A | F | I | A | J | E | S | T | F | A | S | C | Y | N | U | J | A | C | A |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Klucz: | K | L | U | C | Z | K | L | U | C | Z | K | L | U | C | Z | K | L | U | C | Z | K | L | U | C | Z | K | L |
| Szyfr: | U | C | S | R | S | Y | R | L | C | E | S | L | D | G | R | D | Q | U | U | B | I | Y | O | L | Z | M | L |
Wynikowy szyfrogram: UCSRSYRLCESLDGRDQUUBIYOLZML
$ python3 -c " A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' t='KRYPTOGRAFIAJESTFASCYNUJACA'; k='KLUCZ' c=''.join(A[(A.index(x)+A.index(k[i%len(k)]))%26] for i,x in enumerate(t)) print(c)" UCSRSYRLCESLDGRDQUUBIYOLZML
Przykład szyfrowania tekstu KRYPTOGRAFIAJESTFASCYNUJACA kluczem KLUCZ pozwala prześledzić krok po kroku, jak kolejne litery klucza są dopasowywane do kolejnych liter wiadomości. W każdym takcie litery tekstu i klucza są zamieniane na liczby, sumowane modulo długość alfabetu, a wynikowa liczba jest ponownie zamieniana na literę. Takie zestawienie warto samodzielnie powtórzyć dla kilku pierwszych liter, aby upewnić się, że uzyskany rezultat zgadza się z tabelą prezentowaną na slajdzie.
Obserwacja, że ta sama litera tekstu jawnego, na przykład A, pojawia się w szyfrogramie w różnych postaciach, doskonale ilustruje najważniejszą zaletę systemów polialfabetycznych. Jednocześnie widoczny jest koszt, jaki ponosi nadawca: długość klucza musi być wiadoma obu stronom, a każdy błąd w dopasowaniu kolejności klucza natychmiast psuje całą wiadomość. Dobrą praktyką jest zapisywanie klucza pod tekstem w osobnych wierszach, co ułatwia kontrolę obliczeń i wykrywanie pomyłek.
Porównanie wyniku uzyskanego przy użyciu skryptu w języku Python z wynikiem ręcznym stanowi również sprawdzian poprawności przygotowanego kodu. To podejście, polegające na porównywaniu wyników z już zweryfikowanym przykładem, jest rekomendowaną metodą testowania programów implementujących algorytmy kryptograficzne. Takie samo podejście stosuje się w późniejszych zadaniach obejmujących funkcje odszyfrowywania i procedury złamania szyfru.
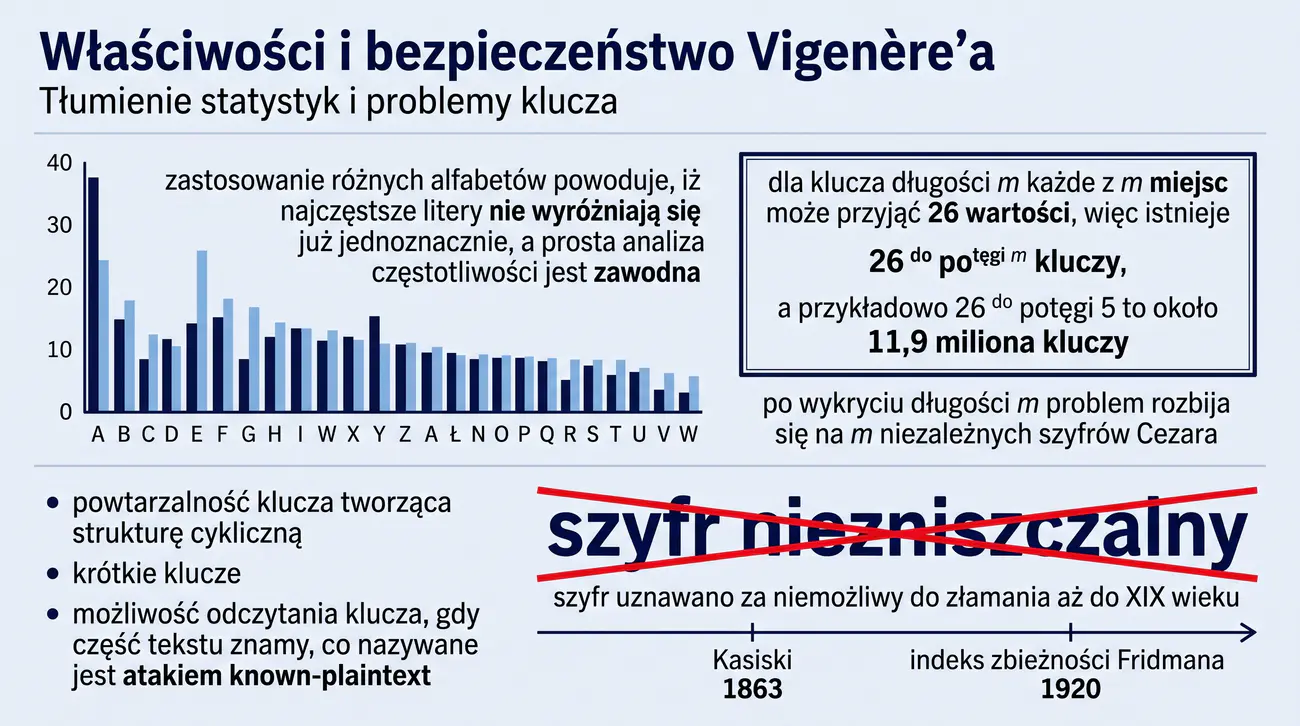
Analiza właściwości szyfru Vigenère’a ujawnia paradoks, że duża liczba możliwych kluczy nie przekłada się automatycznie na wysoki poziom bezpieczeństwa. Problem leży w cyklicznym charakterze klucza, który po pewnym czasie zaczyna się powtarzać, co pozwala atakującemu sprowadzić problem do szeregu niezależnych, prostszych szyfrów Cezara. Im krótszy klucz w stosunku do długości wiadomości, tym więcej cykli jest obserwowalnych i tym łatwiej odtworzyć jego strukturę.
Drugi słaby punkt wynika z faktu, że znając fragment tekstu jawnego, można z niego bezpośrednio wyprowadzić odpowiadający mu fragment klucza, a stąd wnioskować o dalszych jego fragmentach. Taki atak z ograniczoną wiedzą o tekście jawnym jest szczególnie groźny w sytuacjach, gdy przewidywana treść wiadomości jest w znacznym stopniu znana. Dlatego projektanci systemów komunikacyjnych unikają stereotypowych nagłówków, które ułatwiałyby atakującemu zgadywanie początków depesz.
Historia pokazuje, że szyfr Vigenère’a przez stulecia uchodził za niezniszczalny, a jego możliwość złamania wykazano dopiero w dziewiętnastym wieku. Rozwój metod wyznaczania długości klucza, zapoczątkowany pracami Friedricha Kasiskiego, oraz narzędzi statystycznych, takich jak indeks zbieżności, całkowicie zmienił tę ocenę. Ten przykład stanowi przestrogę przed zbyt pochopnym uznawaniem systemów kryptograficznych za bezpieczne bez dogłębnej analizy ich struktury.
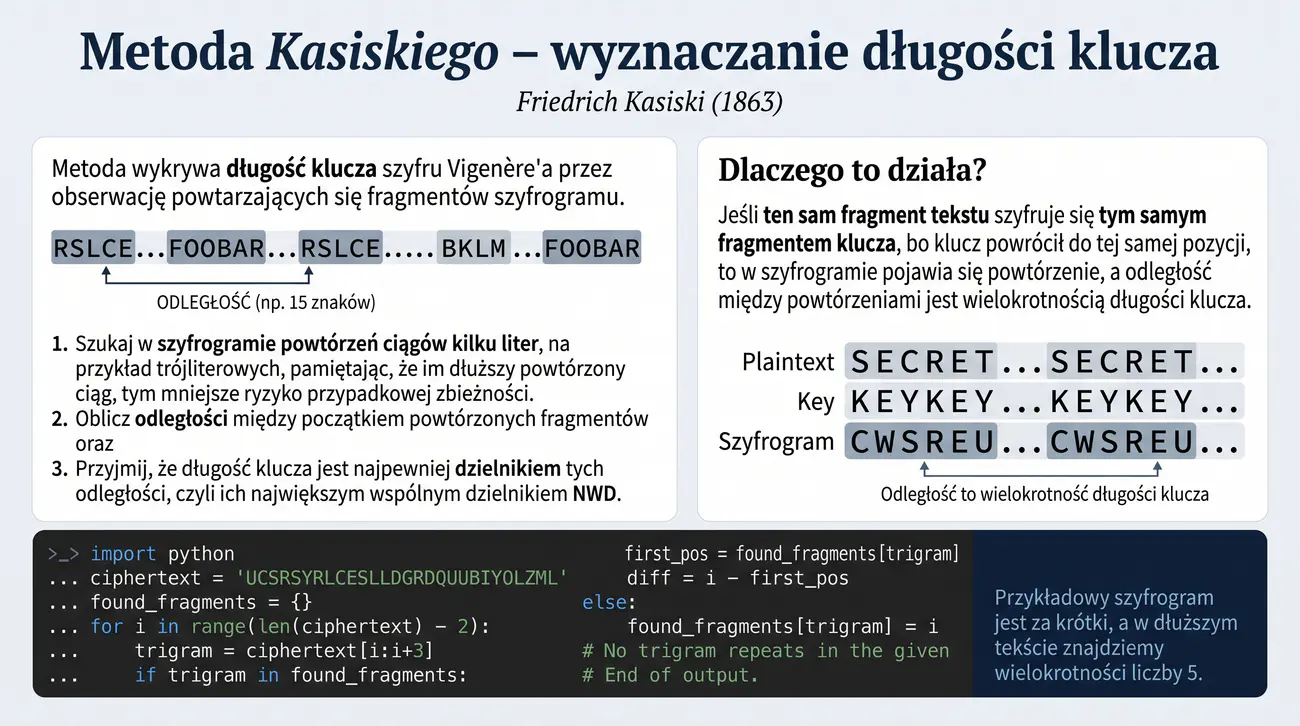
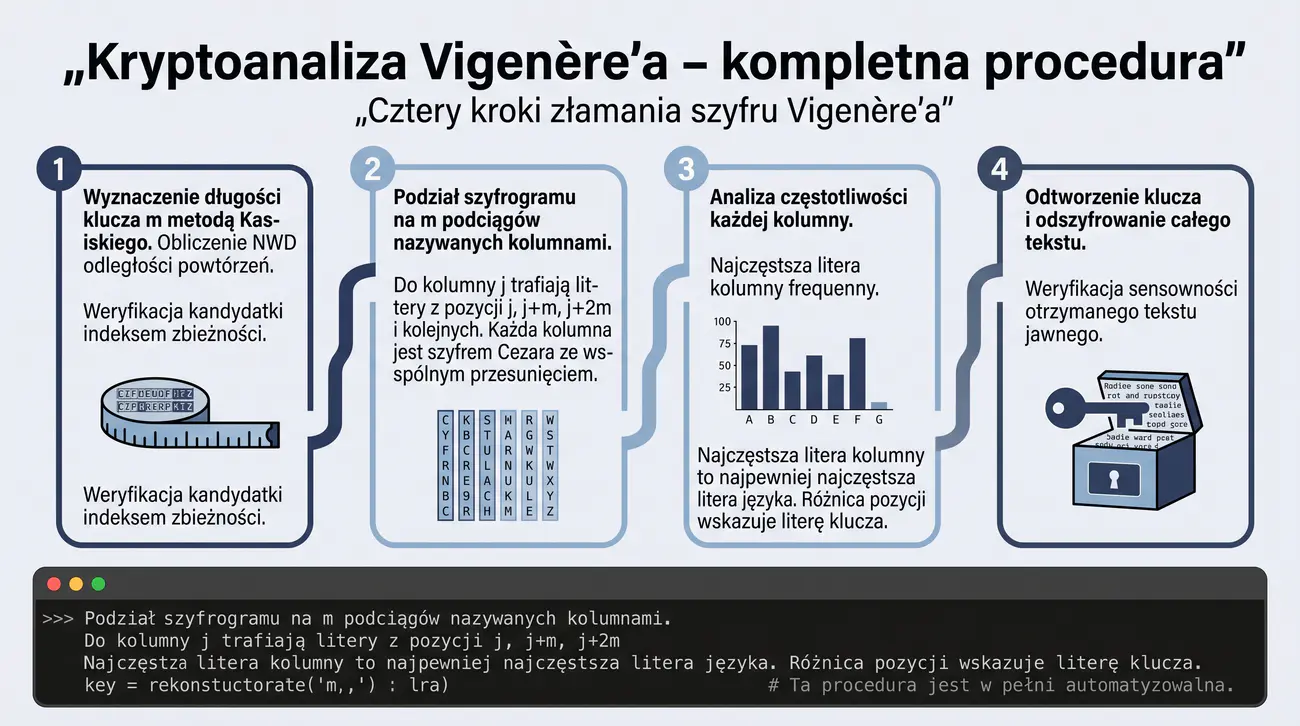
Dlaczego to działa? Jeżeli ten sam fragment tekstu szyfruje się tym samym fragmentem klucza (klucz powrócił do tej samej pozycji), to szyfrogram pokaże powtórzenie; odległość między powtórzeniami jest wielokrotnością długości klucza. Uwaga: nie licz ślepo NWD wszystkich odległości – jedno przypadkowe powtórzenie o odległości względnie pierwszej z długością klucza (np. 47 przy kluczu 10) obniża NWD do 1. Wariant licznikowy metody Kasiskiego polega właśnie na zliczaniu dzielników.
$ python3 -c " from collections import Counter c=open('szyfrogram.txt').read().strip() pos={}; dist=[] for i in range(len(c)-2): g=c[i:i+3] if g in pos: dist.append(i-pos[g]) else: pos[g]=i print('powtorzenia:', len(dist)) dz=Counter(m for d in dist for m in range(2,21) if d%m==0) print('najczestsze dzielniki:', dz.most_common(3))" # powtorzenia: 80 # najczestsze dzielniki: [(2, 74), (3, 72), (6, 69)] # male dzielniki sa niejednoznaczne - dlatego patrzymy na odleglosci # 240=12*20, 120=12*10, 96=12*8 -> dlugosc klucza m=12
Metoda Kasiskiego opiera się na spostrzeżeniu, że w długim szyfrogramie Vigenère’a pojawiają się powtórzenia ciągów liter powstałe w wyniku powrotu klucza do tej samej pozycji. Kiedy ten sam fragment tekstu jawnego zostanie zaszyfrowany tym samym fragmentem klucza, wynikowy odcinek szyfrogramu również będzie identyczny, a odległość między takimi powtórzeniami będzie wielokrotnością długości klucza. Analiza wielu takich powtórzeń i zliczenie, który dzielnik odległości powtarza się najczęściej, prowadzi zatem do oszacowania okresu klucza. Wyliczanie NWD wszystkich odległości bywa mylące, bo wystarczy jedno przypadkowo powtórzone i względnie pierwsze z długością klucza, by obniżyć wynik do 1.
W praktyce rzadziej zdarza się, aby wszystkie powtórzenia miały naturalne pochodzenie, dlatego wyniki obliczeń traktuje się jako kandydatów na długość klucza, a nie jako dowód. Dodatkowo przypadkowe zbieżności mogą generować mylące odległości, które nie są wielokrotnościami właściwego okresu, co wymaga ostrożnej interpretacji zebranych danych. Zwykle przegląda się pewien zbiór potencjalnych długości klucza i dopiero dalsze narzędzia, przede wszystkim indeks zbieżności, rozstrzygają, która z nich jest poprawna.
Zaletą metody jest jej prostota, która pozwala na przeprowadzenie obliczeń nawet bez oprogramowania, zwłaszcza dla krótkich wiadomości. W długich szyfrogramach, jakie spotyka się w realnych zastosowaniach, procedura ta jest z powodzeniem wykonywana automatycznie przez skrypty. Znajomość metody Kasiskiego jest nieodzownym elementem pełnej procedury łamania szyfru Vigenère’a i stanowi punkt wyjścia dla kolejnych etapów analizy.
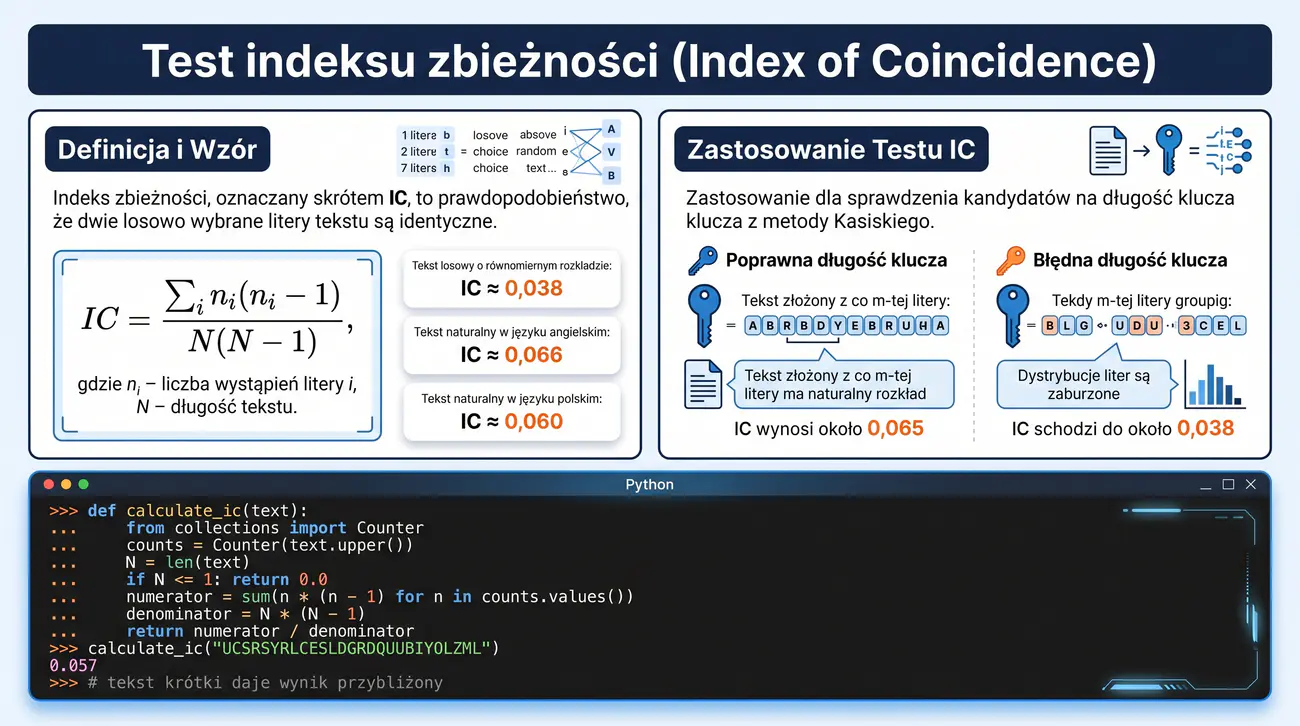
$ python3 -c " from collections import Counter def ic(s): n=len(s); t=Counter(s) return sum(v*(v-1) for v in t.values())/(n*(n-1)) c=open('szyfrogram.txt').read().strip() for m in (6,10,12,15): print(m, round(sum(ic(c[i::m]) for i in range(m))/m,4))" # 6 0.0516 # 10 0.0412 # 12 0.0597 <- maksimum: poprawna dlugosc klucza # 15 0.0471
Indeks zbieżności jest miarą prawdopodobieństwa, że dwie losowo wybrane litery z danego tekstu są identyczne, a jego wartość zależy wyłącznie od rozkładu liter w badanym zbiorze. Dla tekstu o rozkładzie równomiernym prawdopodobieństwo to jest niskie, natomiast dla naturalnego języka, w którym występują litery dominujące, wartość indeksu wyraźnie rośnie. Dzięki temu indeks stanowi obiektywne kryterium odróżniania tekstów o strukturze językowej od ciągów praktycznie losowych.
Zastosowanie indeksu zbieżności w łamaniu szyfru Vigenère’a polega na testowaniu kandydatów na długość klucza wskazanych metodą Kasiskiego. Jeśli założona długość klucza jest poprawna, to litery zebrane z pozycji oddalonych o tę długość tworzą tekst zaszyfrowany pojedynczym przesunięciem, którego rozkład jest zbliżony do naturalnego, a indeks osiąga wysoką wartość. Przy błędnej długości zbiory takie składają się z liter pochodzących z różnych alfabetów, co spłaszcza rozkład i obniża indeks do poziomu tekstu losowego.
Warto również pamiętać o różnicach między językami, ponieważ wartości referencyjne dla polskiego, angielskiego czy niemieckiego nie są identyczne ze względu na odmienne rozkłady liter; dlatego kryterium poprawności ma charakter względny – porównujemy wynik z wartością zmierzoną dla tego samego języka. W obliczeniach należy uwzględnić normalizację znaków diakrytycznych, aby uniknąć zaburzeń wynikających z polskich znaków. Opanowanie tej miary statystycznej daje narzędzie wiarygodnego, ilościowego potwierdzania hipotez wyznaczonych przez metody heurystyczne.
$ python3 -c " from collections import Counter A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' # częstotliwości liter w tekście polskim (A-Z, w %; wartości zaokrąglone, suma 100,4 - kod normalizuje) F=[10.3,1.1,5.1,3.1,8.8,0.6,1.3,1.3,7.4,2.3,3.1,3.1,2.6,6.5,8.4,3.2,0.1,5.0,4.6,4.5,2.4,0.1,4.5,0.1,4.5,6.4] c=open('szyfrogram.txt').read().strip(); m=12 def shift(s): n=len(s); t=Counter(s); e=[max(f*n/sum(F),0.5) for f in F] return min(range(26), key=lambda k: sum( (t.get(A[(A.index(x)+k)%26],0)-p)**2/p for x,p in zip(A,e))) k=''.join(A[shift(c[i::m])] for i in range(m)) print('klucz:', k) print('tekst:', ''.join(A[(A.index(x)-A.index(k[i%m]))%26] for i,x in enumerate(c))[:60]) # klucz: TROJSZYKLUCZ # tekst: DOBRYSZYFRNIEJESTTYLKOKROKIEMWALGORYTMIEKAZDYUZYTKOWNIKPOWIN"
Pełna procedura złamania szyfru Vigenère’a składa się z czterech powiązanych etapów, z których każdy opiera się na wyniku poprzedniego. Pierwszy krok, polegający na wyznaczeniu długości klucza, jest najważniejszy, ponieważ jego pomyłka uniemożliwia poprawny podział szyfrogramu na kolumny. Z kolei weryfikacja wskazanej długości za pomocą indeksu zbieżności pozwala uniknąć przyjęcia błędnego kandydata.
Drugi krok przenosi analizę do podziału szyfrogramu na podciągi, z których każdy odpowiada jednemu przesunięciu klucza, czyli w istocie szyfrowi Cezara. Dzięki temu kolejny etap, polegający na analizie częstotliwości każdej kolumny, można wykonać dokładnie tak samo jak przy łamaniu najprostszych szyfrów podstawieniowych. Przy dłuższych kolumnach, liczących kilkadziesiąt litery, szybkim przybliżeniem jest dopasowanie najczęstszej litery kolumny do najczęstszej litery języka; przy krótkich kolumnach stosuje się dopasowanie chi-kwadrat z kroku 3. Założenie „najczęstsza litera kolumny = najczęstsza litera języka” zawodzi wtedy, gdy kolumna ma tylko kilkanaście liter.
Ostatni etap zamyka procedurę odtworzeniem całego klucza i próbnym odszyfrowaniem wiadomości, którego wynik musi być czytelny dla człowieka. W przypadku polskich tekstów należy pamiętać o zastosowaniu jednolitej zasady transliteracji znaków, aby analiza kolumn była spójna. Całą procedurę warto opisać w formie skryptu, który najpierw bada kandydatów na długość klucza, a następnie proponuje najbardziej prawdopodobny klucz i tekst jawny.
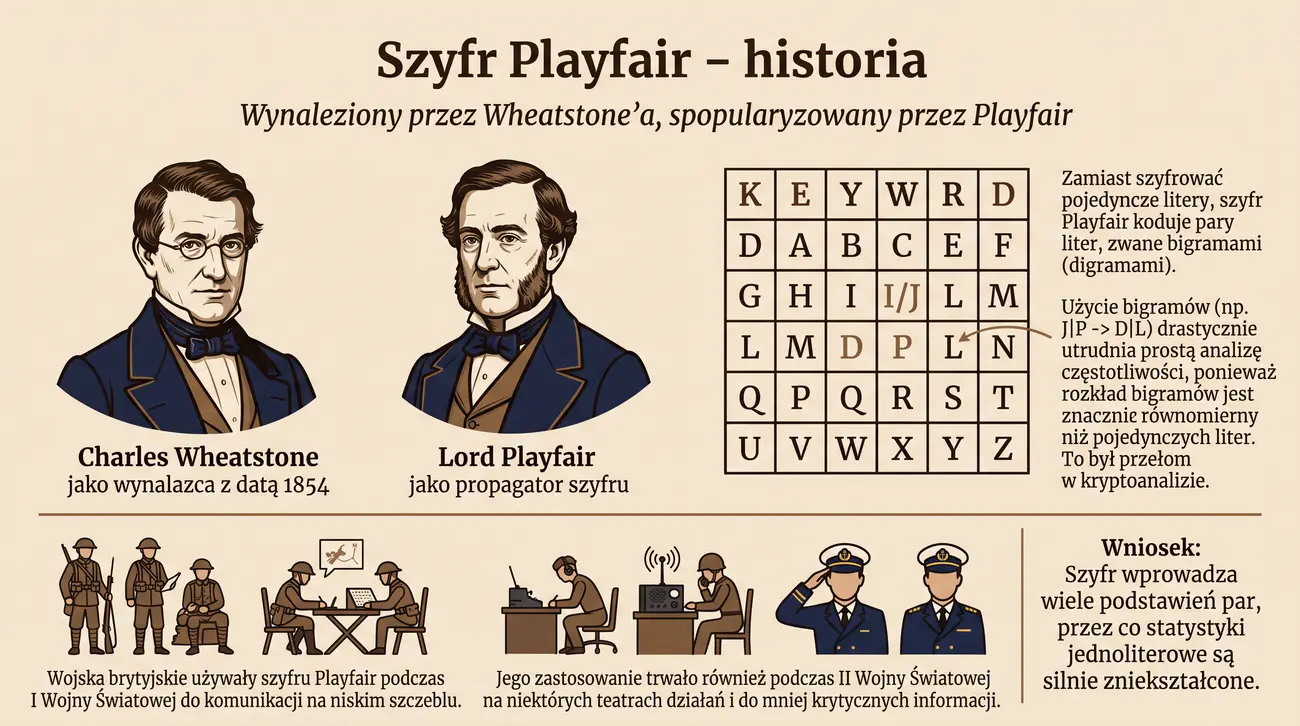
Szyfr Playfair powstał w połowie dziewiętnastego wieku jako próba zbudowania systemu, który byłby trudniejszy do przełamania niż proste podstawienia jednoliterowe. Wprowadzenie szyfrowania parami liter stanowiło istotny krok naprzód, ponieważ wyeliminowało najbardziej oczywiste zależności pomiędzy częstotliwością pojedynczych liter a ich podstawieniami. O ile bowiem monogramy stają się przez to mniej przydatne dla atakującego, o tyle analiza przesuwa się na poziom par liter.
Nazwa szyfru pochodzi od lorda Playfair, który promował wynalazek Charlesa Wheatstone'a, podczas gdy sam autor pozostawał w jego cieniu. Historia powstania i rozpowszechniania systemu ilustruje, że znaczenie wynalazku bywa przypisywane osobom, które najbardziej przyczyniły się do jego upowszechnienia, a niekoniecznie jego twórcy. W praktyce wojskowej szyfr Playfair był stosowany przez siły brytyjskie jeszcze podczas pierwszej wojny światowej, co świadczy o jego ówczesnej popularności.
Z punktu widzenia dydaktyki szyfr ten jest wyjątkowo cennym przykładem, gdyż pokazuje, jak zmiana jednostki przetwarzania wpływa na możliwości kryptoanalizy. Widać, że nawet prosty system oparty na macierzy pięciu na pięć wprowadza niestandardowe rozproszenie podstawień w obrębie par. Zrozumienie tej konstrukcji przygotowuje do analizy bardziej zaawansowanych algorytmów, które również operują na blokach znaków, choć w znacznie większej skali.
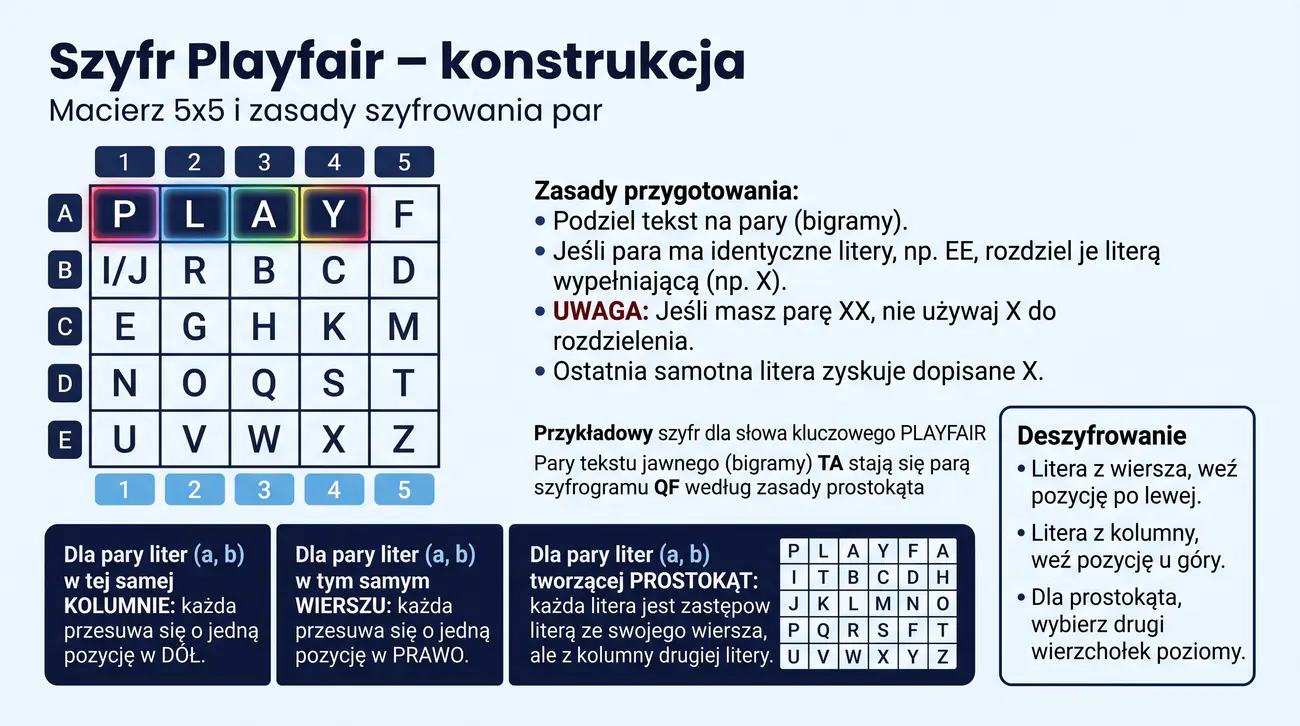
Konstrukcja szyfru Playfair rozpoczyna się od utworzenia macierzy pięciu na pięć, w której najpierw umieszcza się litery klucza bez powtórzeń, a następnie pozostałe litery alfabetu. Ze względu na ograniczoną pojemność macierzy dwie litery, najczęściej I oraz J, są traktowane jako jeden znak, co jest wyraźnym uproszczeniem zmniejszającym liczbę możliwych symboli. Klucz decyduje więc o rozłożeniu liter w macierzy, a tym samym o wszystkich podstawieniach realizowanych przez szyfr.
Operacje szyfrowania dotyczą wyłącznie par liter, które najpierw należy przygotować, dzieląc tekst jawny i usuwając powtórzenia w obrębie pary. Wstawienie litery wypełniającej w miejscu, gdzie w parze występują dwa identyczne znaki, oraz dołączenie jej na końcu tekstu o nieparzystej długości ma na celu zapewnienie, że każda para składa się z dwóch różnych liter. Dopiero po takiej normalizacji można zastosować reguły zamiany wynikające z położenia liter w macierzy.
Sposób podstawienia zależy od wzajemnego położenia liter: w tym samym wierszu stosuje się przesunięcie w prawo, w tej samej kolumnie przesunięcie w dół, a w pozostałych przypadkach regułę prostokąta. Odszyfrowanie wymaga wykonania operacji odwrotnych, co jest możliwe dzięki symetrii budowy macierzy. Należy pamiętać, że poprawne przygotowanie tekstu jest tak samo ważne jak same reguły, gdyż błąd w normalizacji powoduje nieodwracalne zniekształcenie komunikatu.
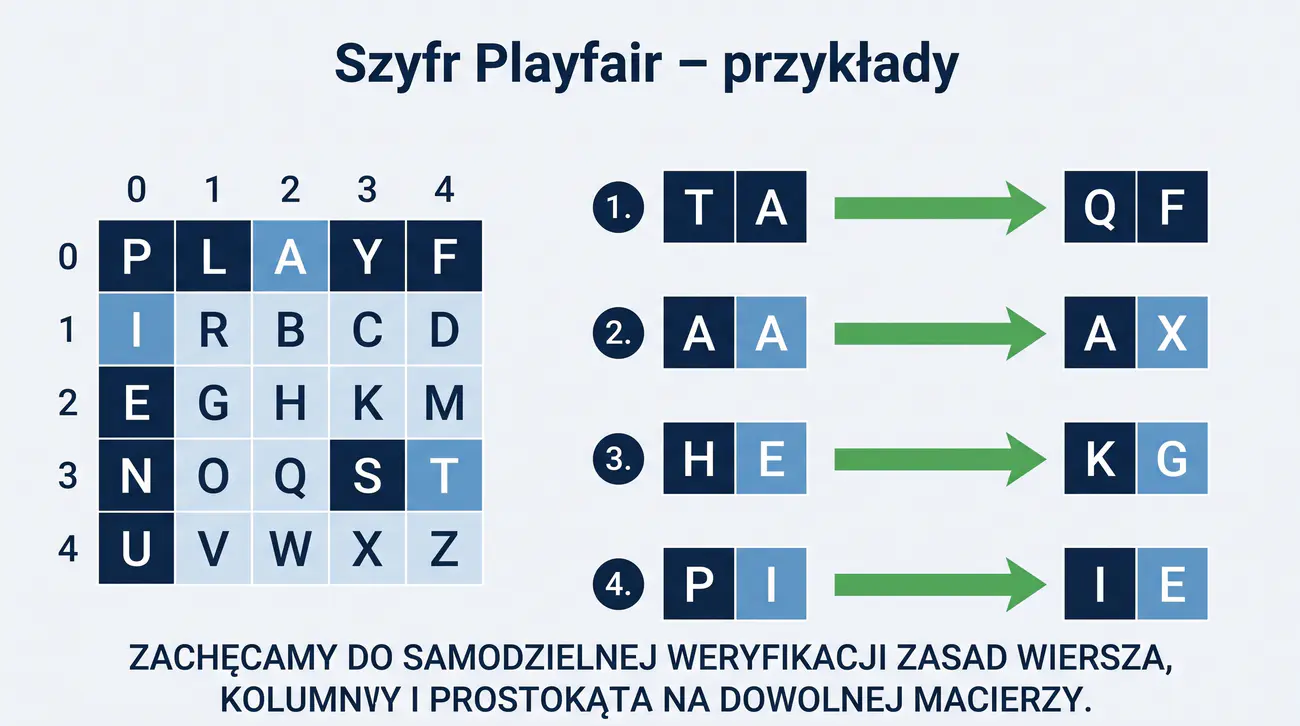
Dla macierzy z klucza PLAYFAIR (P L A Y F / I R B C D / E G H K M / N O Q S T / U V W X Z):
Rozważane na slajdzie przykłady poszczególnych par liter pozwalają utrwalić wszystkie trzy podstawowe reguły szyfrowania występujące w systemie Playfair. Przykład pary TA pokazuje działanie reguły prostokąta, w której litery położone po przekątnej macierzy wymieniają się wzdłuż własnych wierszy. Z kolei pary HE oraz PI ilustrują kolejno regułę wiersza i regułę kolumny, a każde z tych wyznaczeń można łatwo sprawdzić na macierzy.
Samodzielne powtórzenie tych obliczeń jest zalecane, ponieważ pozwala przekonać się, że wyniki są w pełni zgodne z pozycjami liter w macierzy wskazanymi na slajdzie. Należy przy tym pamiętać o specyficznym traktowaniu liter I oraz J, które w konstrukcji dzielą jedną komórkę, oraz o rozbijaniu par złożonych z tych samych liter. Tego rodzaju kontrola rozwija umiejętność weryfikacji krok po kroku, kluczową w pracy z algorytmami kryptograficznymi.
Wyraźne rozróżnienie trzech przypadków położenia liter jest fundamentem poprawnego stosowania wszystkich późniejszych przykładów operujących na macierzy. Warto ćwiczyć zarówno szyfrowanie, jak i odszyfrowywanie, korzystając z tych samych reguł odwróconych. Dzięki takiemu treningowi nabywa się wprawy w szybkim lokalizowaniu liter w macierzy i poprawnym wyznaczaniu wyników pary.
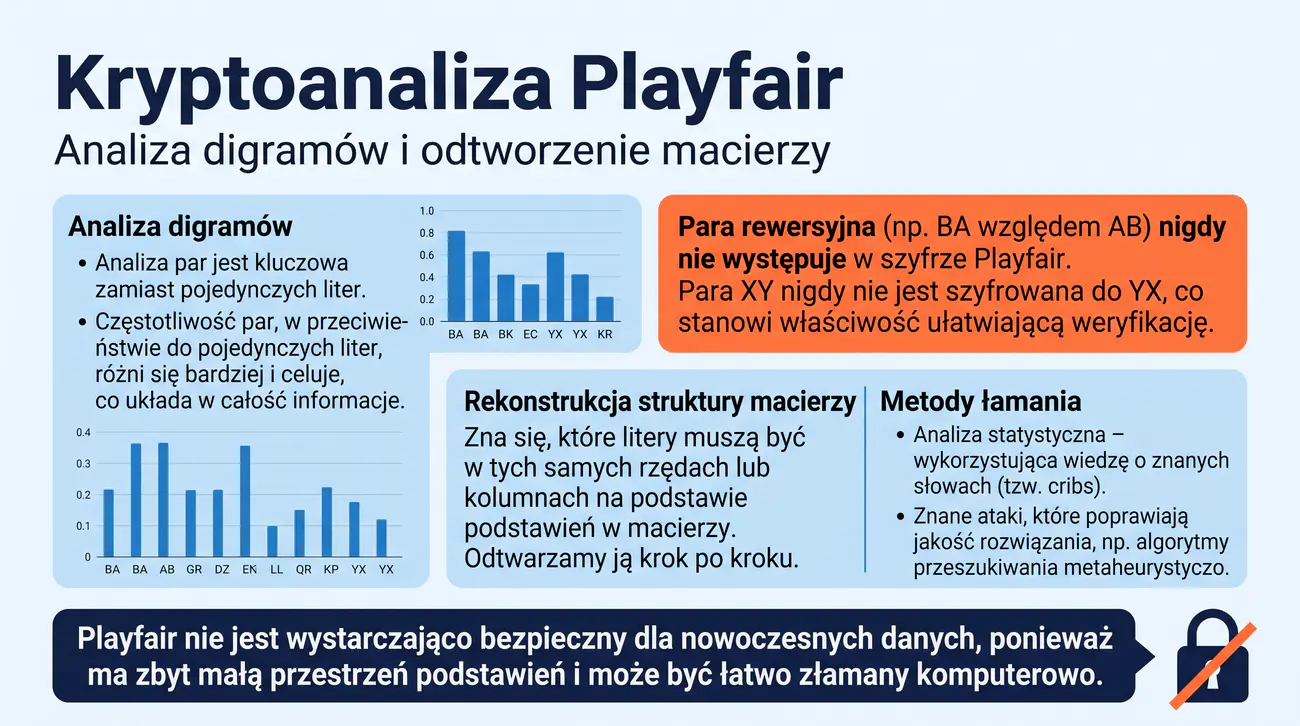
Kryptoanaliza szyfru Playfair opiera się na analizie statystyki par liter, zwanych digramami, których rozkład w naturalnym języku różni się od rozkładu przypadkowych zestawień. Ważną właściwością systemu jest fakt, że para XY nigdy nie jest szyfrowana jako YX, co pozwala odrzucać nieprawidłowe odszyfrowania już na etapie wstępnego wnioskowania. Takie szczególne własności matematyczne stanowią cenne wskazówki dla metodycznej pracy kryptoanalityka, gdyż zawężają przestrzeń dopuszczalnych rozwiązań.
Do odtworzenia macierzy stosuje się wiedzę o współzależnościach między literami, które występują w tych samych wierszach lub kolumnach, wynikającą z obserwowanych podstawień par. W przypadku dostępności znanego fragmentu tekstu jawnego proces wnioskowania staje się znacznie szybszy, a informacje o konkretnych podstawieniach pozwalają układać macierz fragmentami. Współczesne techniki łamania wspomagane są dodatkowo algorytmami przeszukiwania, które próbują ulepszyć wstępne przybliżenia struktury macierzy.
Mimo że szyfr Playfair w swojej epoce stanowił wyraźny postęp w stosunku do szyfrów jednoliterowych, jego odporność jest zdecydowanie zbyt niska jak na potrzeby współczesne. Niewielka liczba możliwych podstawień oraz regularność reguł czynią system podatnym na ataki komputerowe wykonywane w milisekundach. Warto przy tym zauważyć, że zasada szyfrowania bloków powiązana z dyfuzją w obrębie bloku jest prototypem idei, które później rozwinęły algorytmy nowoczesnych generacji.
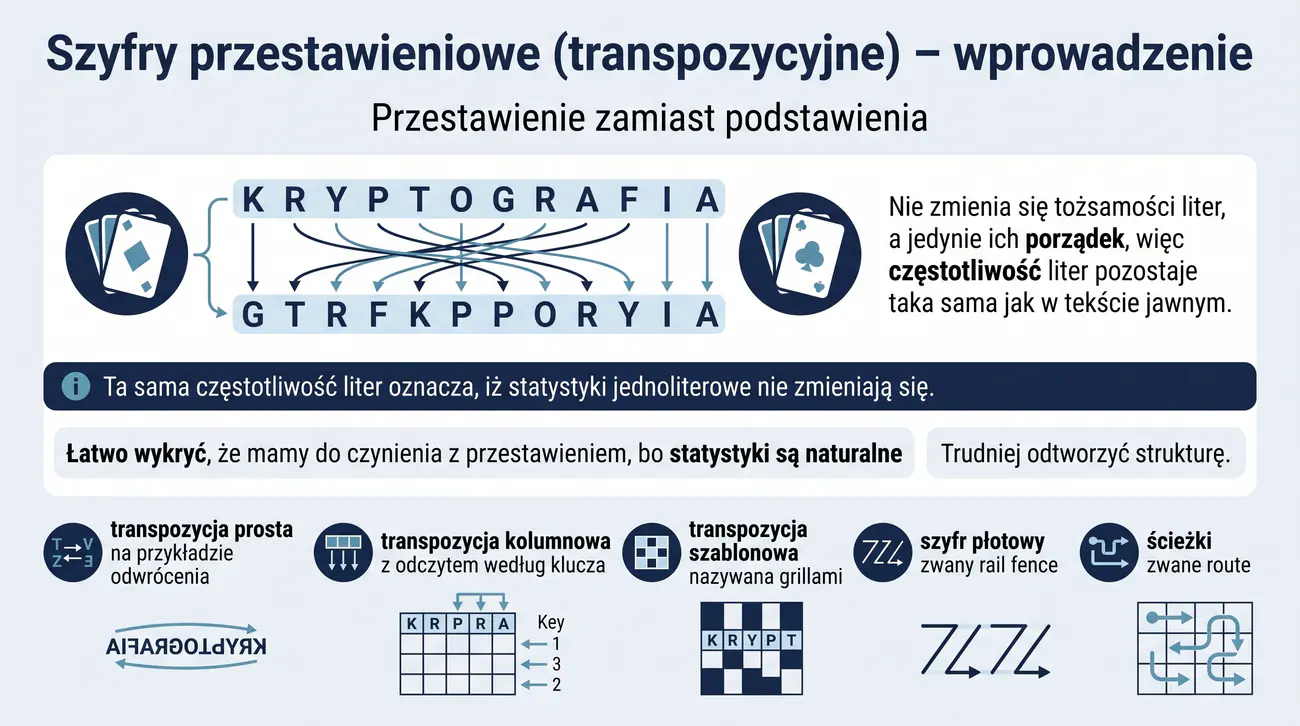
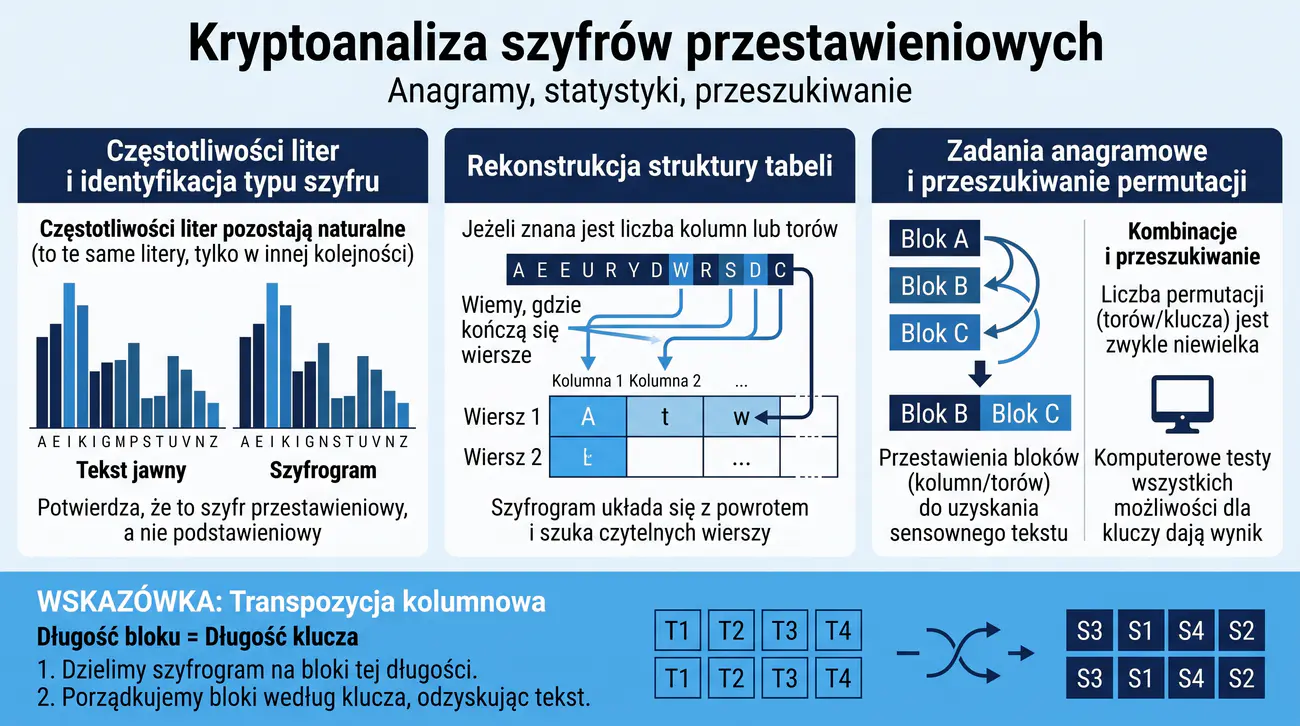
Szyfry przestawieniowe reprezentują drugą wielką rodzinę technik klasycznych, której fundamentem jest zmiana kolejności liter, a nie ich tożsamości. Dzięki temu litery tekstu jawnego pozostają rozpoznawalne w szyfrogramie, co oznacza, że rozkład częstości liter pozostaje nienaruszony. Ta właściwość stanowi jednocześnie element rozpoznawczy, pozwalający natychmiast odróżnić przestawienie od podstawienia, oraz zasadniczą słabość systemu.
Zaburzona zostaje natomiast struktura wyrazów i związków między literami, co utrudnia odtworzenie oryginalnej kolejności bez znajomości klucza. Tradycja takich szyfrów sięga starożytności, a jednym z najbardziej znanych przykładów są skytale (scytale) używane przez Spartan do przesyłania rozkazów wojskowych. Nowożytne odmiany, takie jak transpozycja kolumnowa, szablony czy szyfr płotowy, rozwijają tę samą ideę w coraz bogatsze formy.
Warto podkreślić, że przestawienie bywa również składnikiem nowoczesnych algorytmów, choć w nich stanowi jedynie część bardziej złożonej konstrukcji. Kiedy przestawienie wykonuje się na poziomie bitów lub bajtów zamiast liter, uzyskujemy mechanizm rozpraszania zmian, będący istotą pojęcia dyfuzji. Z tego względu zrozumienie klasycznych szyfrów przestawieniowych przygotowuje do analizy wewnętrznej struktury współczesnych szyfrów blokowych.
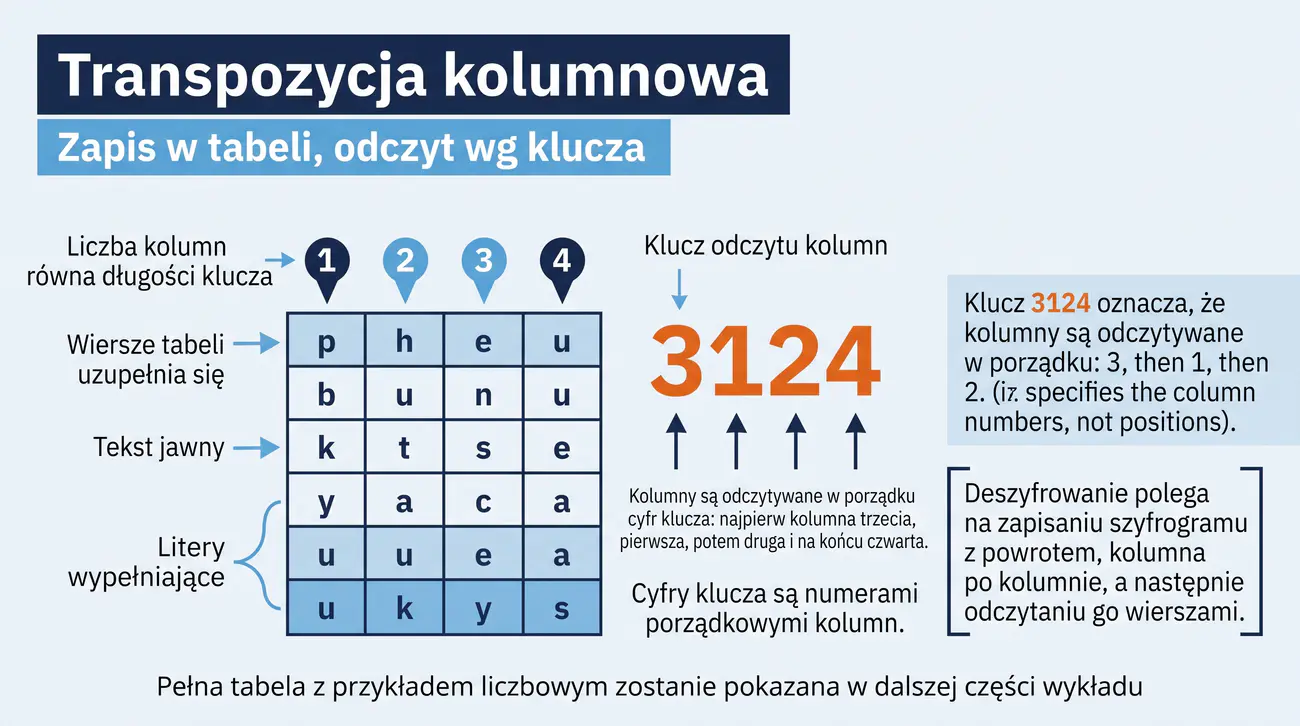
Transpozycja kolumnowa należy do najczęściej przywoływanych przykładów szyfrów przestawieniowych, ponieważ łączy prostotę opisu z wyraźnie zdefiniowanym mechanizmem klucza. Tekst jawny jest wpisywany do prostokątnej tabeli, w której liczba kolumn odpowiada długości klucza, a następnie odczytywana jest sekwencja kolumn zgodnie z porządkiem ustalonym przez klucz. Klucz wyrażony ciągiem cyfr pełni rolę permutacji, która jednoznacznie określa kolejność odczytu.
Działanie systemu najwygodniej prześledzić przez utworzenie tabeli roboczej, gdzie każda kolumna gromadzi kolejne litery tekstu zapisanego wierszami. Po odczytaniu kolumn w kolejności wskazanej przez klucz powstaje szyfrogram, w którym porządek liter podlega dwuwymiarowemu przetasowaniu. W trakcie odszyfrowywania procedura jest dokładnie odwracana: szyfrogram zapisujemy kolumnami, a odczytujemy wierszami po przywróceniu kolejności kolumn.
W praktyce konieczne jest uzupełnienie ostatniego wiersza literami wypełniającymi, gdyż tekst jawny nie zawsze dzieli się równomiernie przez liczbę kolumn. Te dodatkowe znaki są usuwane po odszyfrowaniu, a ich wybór musi być uzgodniony, aby nie prowadzić do niejednoznaczności wyników. Taka dbałość o szczegóły procedury uczy, że w kryptografii istotne są nie tylko główne reguły, ale również drobne uzgodnienia techniczne między stronami komunikacji.
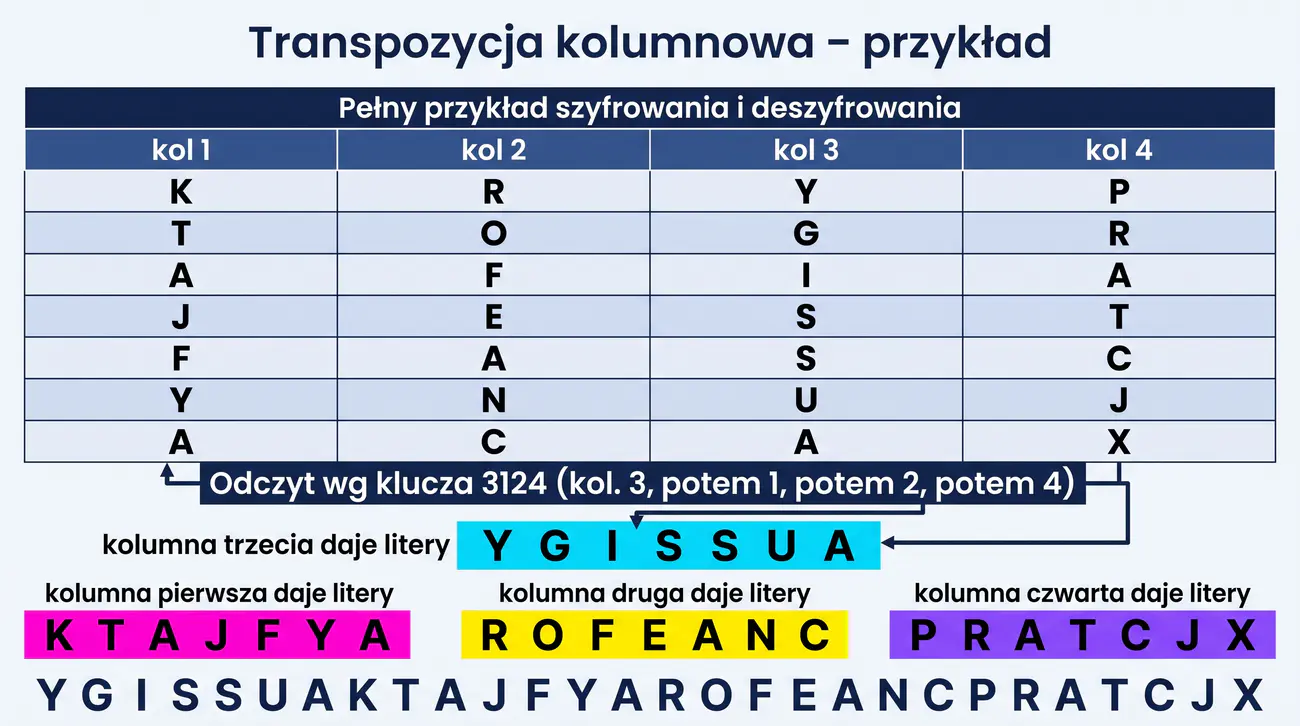
Szyfrowanie (tekst jawny: KRYPTOGRAFIAJESTFASCYNUJACA, klucz 3124, 4 kolumny):
| kol 1 | kol 2 | kol 3 | kol 4 |
|---|---|---|---|
| K | R | Y | P |
| T | O | G | R |
| A | F | I | A |
| J | E | S | T |
| F | A | S | C |
| Y | N | U | J |
| A | C | A | X |
Odczyt wg klucza 3124 (kol. 3, potem 1, potem 2, potem 4):
Y G I S S U A K T A J F Y A R O F E A N C P R A T C J X
Szyfrogram: YGISSUAKTAJFYAROFEANCPRATCJX
Pełny przykład transpozycji kolumnowej pokazuje, że samo wpisanie tekstu do tabeli nie tworzy jeszcze szyfrogramu, a kluczową rolę odgrywa sekwencja odczytu kolumn. W przedstawionym zadaniu klucz 3124 nakazuje odczytanie najpierw trzeciej, potem pierwszej, następnie drugiej i na końcu czwartej kolumny. Łącząc kolejno zawartości tych kolumn, otrzymuje się szyfrogram, w którym rozmieszczenie liter na pozór nie zachowuje żadnych śladów pierwotnej kolejności.
Wyraźnie widać także potrzebę uzupełnienia tabeli literą wypełniającą, ponieważ dwadzieścia siedem liter tekstu jawnego nie daje się rozmieścić równo w czterech kolumnach. Znak ten, umieszczony w ostatnim wierszu, przechodzi przez cały proces szyfrowania i jest usuwany dopiero po odszyfrowaniu. Nadawca i odbiorca muszą zatem uzgodnić, że końcowy znak o umownym charakterze ma być pominięty przy odczytywaniu wyniku.
Przy odszyfrowywaniu szyfrogram zapisuje się z powrotem kolumnami w kolejności zgodnej z kluczem, a tekst jawny odczytuje wierszami, co pozwala poprawnie odtworzyć wiadomość. Ważne jest ścisłe przestrzeganie symetrii tych dwóch operacji, gdyż naruszenie kolejności przełoży się natychmiast na nieczytelny wynik. Dzięki pracy nad takim przykładem uczymy się projektować poprawne, odwracalne procedury, co przydaje się przy budowie własnych implementacji.
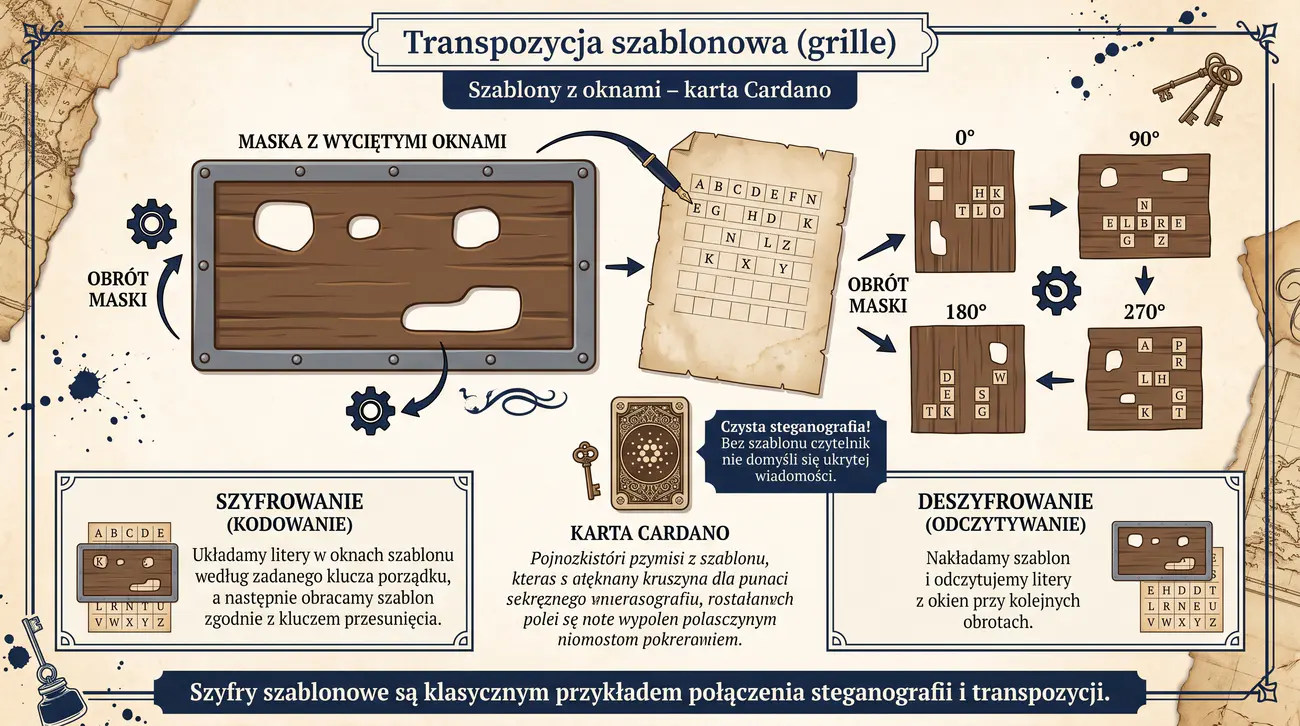
Szyfry szablonowe, zwane również grillami, wykorzystują fizyczną maskę z wyciętymi oknami, przez które zapisywany jest tekst wiadomości, a reszta powierzchni wypełniana jest tekstem-przykrywką. Operacja odwracania szablonu pozwala kolejno umieszczać fragmenty wiadomości w różnych miejscach, co sprawia, że układ liter nie zdradza bezpośrednio treści. Po złożeniu wszystkich liter zgodnie z kluczem otrzymuje się literowy opis wiadomości wymagający nałożenia szablonu do odczytu.
Historycznym przykładem takiej techniki jest karta Cardano, w której tajny tekst wpisywano przez otwory szablonu położone nad pozornie niewinnym listem. Otaczające pole wypełniano swobodnym tekstem, który miał odwrócić uwagę niepożądanego czytelnika, dzięki czemu technika łączy elementy transpozycji i ukrywania treści. Tego rodzaju konstrukcje stanowią jednocześnie przykład steganografii, ponieważ oprócz zmiany kolejności liter starają się ukryć samo istnienie tajnej wiadomości.
Z dzisiejszej perspektywy szyfry szablonowe mają przede wszystkim wartość dydaktyczną i historyczną, gdyż ich bezpieczeństwo jest bardzo ograniczone. Ciekawym nawiązaniem jest jednak koncepcja przemieszczania liter zgodnie z kluczem i ukrywania informacji w wyglądzie dokumentu, która znajduje swoje analogie we współczesnych technikach cyfrowych. Warto dostrzec, jak wszechstronnie technologie kryptograficzne potrafią łączyć się z technikami ukrywania danych.
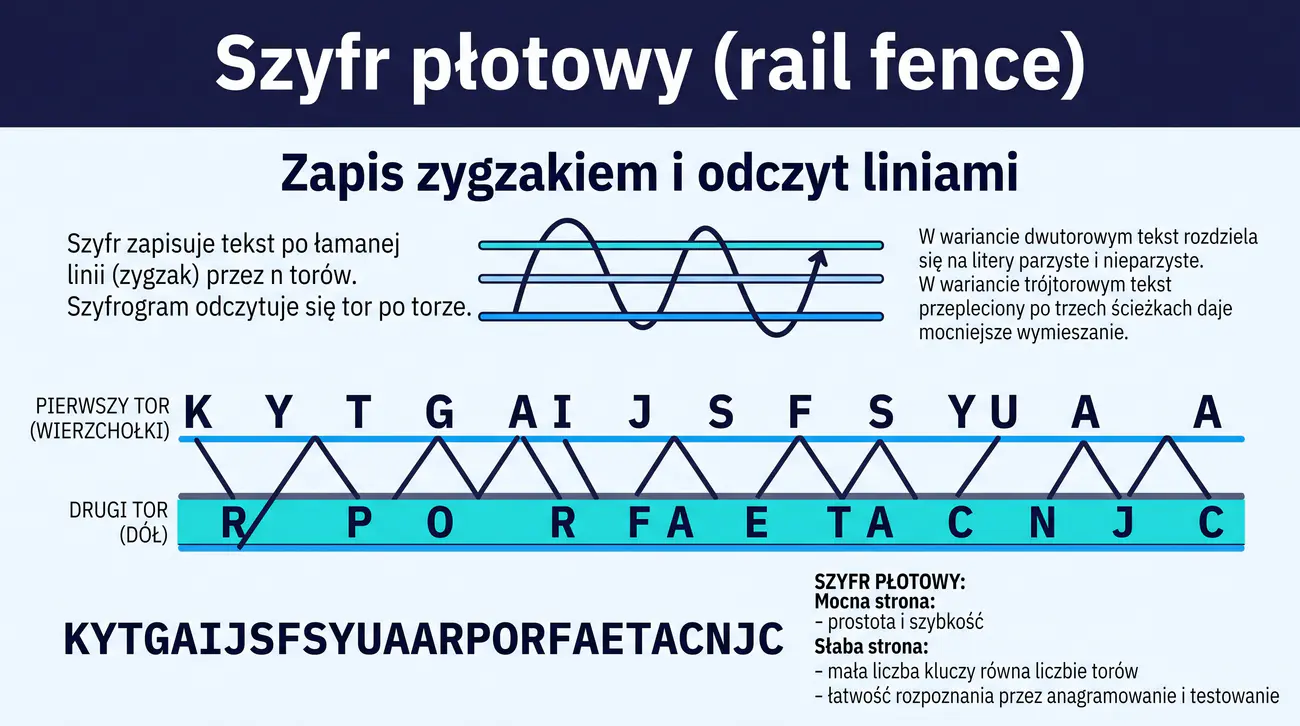
tor1 (wierzchołki zigzaga): K Y T G A I J S F S Y U A A tor2 (dolny rząd): R P O R F A E T A C N J C szyfrogram (2 tory): KYTGAIJSFSYUAARPORFAETACNJC
Siła: prosta, szybka. Słabość: mało kluczy (liczba torów), łatwe do rozpoznania przez anagramowanie i testowanie.
Szyfr płotowy, określany w literaturze anglosaskiej mianem rail fence, należy do najprostszych przykładów przestawienia, w którym tekst wpisuje się zygzakiem na kilka równoległych torów. Liczba torów pełni rolę klucza, a szyfrogram powstaje przez odczytanie kolejnych torów jeden po drugim. W najprostszym wariancie dwutorowym algorytm sprowadza się do rozdzielenia znaków na pozycje parzyste i nieparzyste, co można wykonać nawet bez rysowania tabeli.
Choć operacja poprawnego odczytu przestawienia jest łatwa do opisania, liczba możliwych ustawień pozostaje wyjątkowo niewielka. Wystarczy bowiem wypróbować różną liczbę torów oraz rozważyć ewentualne warianty kolejności ich odczytu, aby sprowadzić całą analizę do przeszukania ograniczonej przestrzeni. Dlatego też szyfr płotowy nie jest stosowany jako samodzielne zabezpieczenie, lecz raczej jako element ćwiczeń pokazujących mechanikę transpozycji.
Poznanie tego algorytmu ma wartość przede wszystkim dydaktyczną, ponieważ w czytelny sposób ukazuje zależność między kształtem zapisu a wynikowym szyfrogramem. Poprawność odszyfrowania łatwo zweryfikować, porównując odtworzone litery z tekstem źródłowym. Pod koniec takiej analizy warto też połączyć szyfr płotowy z prostym podstawieniem, aby zobaczyć, jak złożenie dwu odrębnych technik zwiększa siłę całości.
Kryptoanaliza szyfrów przestawieniowych rozpoczyna się od rozpoznania, że rozkład liter w szyfrogramie jest naturalny, co wyklucza szyfr homofoniczny lub wielorządzikowy - ale nie podstawienie, które przecież zachowuje częstotliwości liter. Kolejnym krokiem jest odtworzenie struktury tabeli lub torów, którą można wywnioskować z długości tekstu i ewentualnych uzupełnień wypełniających. Po ustaleniu liczby kolumn lub torów szyfrogram dzieli się na odpowiednie fragmenty i sortuje w myśl przypuszczalnego klucza.
Zadania polegające na składaniu bloków tekstu w różne porządki, zwane anagramowaniem, sprawdzają się szczególnie dobrze przy krótkich wiadomościach. Przy większej liczbie bloków liczba kombinacji rośnie, jednak dla małych kluczy pozostaje na tyle ograniczona, że przeszukanie wszystkich porządków jest wykonalne. Automatyczne sprawdzanie pomaga rozstrzygnąć, która kombinacja daje najbardziej prawdopodobny tekst, na przykład dzięki ocenie zgodności ze słownikiem.
Właściwość zachowywania częstotliwości liter umożliwia liczbową weryfikację wstępnych hipotez na dużych próbkach, zwiększając pewność wnioskowania. Należy jednak pamiętać, że przy bardzo krótkich wiadomościach wiele różnych porządków może prowadzić do pozornie sensownych wyników, dlatego ostateczna ocena zawsze wymaga czytania całego tekstu. Taka łączona analiza statystyczna i językowa jest wzorcem postępowania również w przypadku bardziej złożonych systemów.
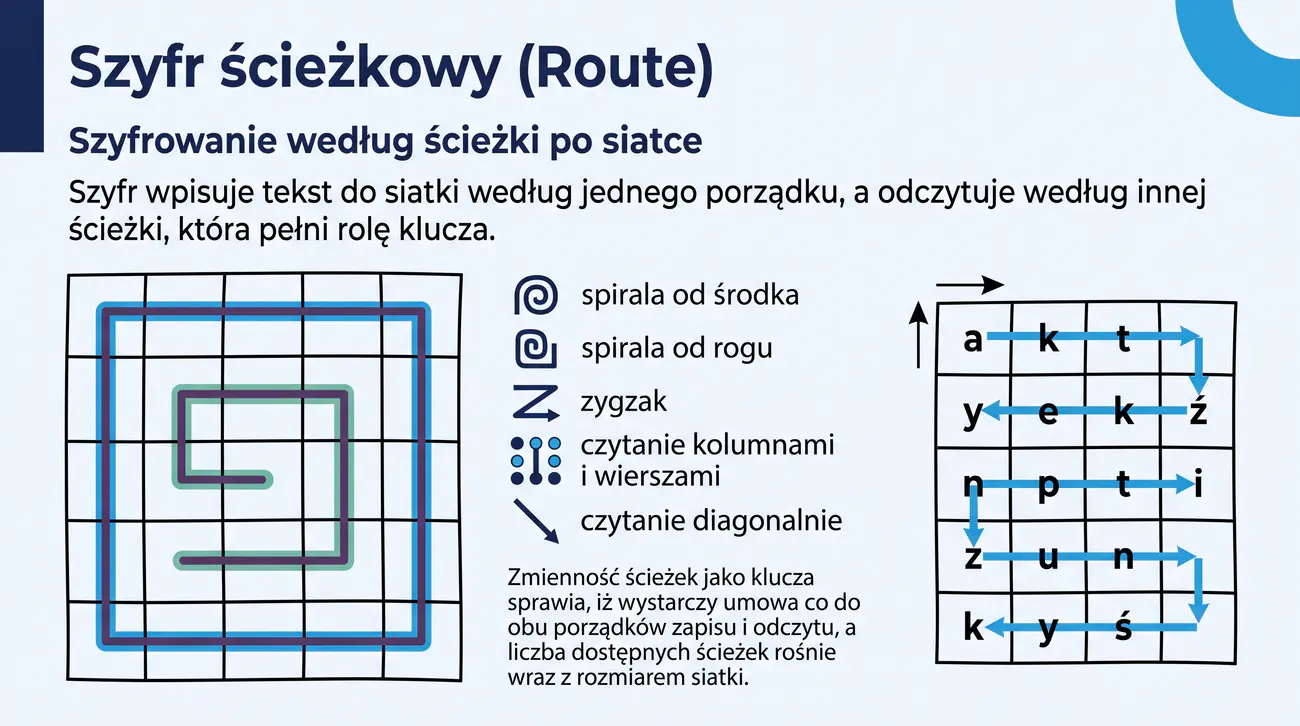
Szyfr ścieżkowy opiera się na założeniu, że litery tekstu wpisywane są do siatki w pewnym, uzgodnionym porządku, a następnie odczytywane według zupełnie innego przebiegu. Kluczem jest zatem para uporządkowanych ścieżek, przy czym zmiana jednej z nich prowadzi do całkowicie odmiennego szyfrogramu. Różnorodność możliwych tras, takich jak spirala od środka czy zygzak, sprawia, że opis systemu bywa myląco złożony mimo prostoty pojedynczych operacji.
Historyczne zastosowania szyfrów ścieżkowych sięgają okresu wojny secesyjnej w Stanach Zjednoczonych, gdzie używano ich do ukrycia treści przed wrogimi operatorami telegrafu. W takim scenariuszu kluczowy problem sprowadzał się do zachowania ustalonej konwencji zapisu i odczytu, gdyż jej naruszenie uniemożliwiało odczytanie wiadomości. Sama odwracalność operacji pozostawała natomiast tak prosta, że system nie wymagał żadnych przyrządów obliczeniowych.
Analiza tego rodzaju szyfru wymaga rozwinięcia umiejętności wyobrażania sobie przepływu danych w przestrzeni siatki. Po złamaniu mechanizmu i zidentyfikowaniu wymiarów siatki odtwarzanie ścieżki polega na systematycznym śledzeniu ruchu wg zadanego porządku. Tego rodzaju ćwiczenia rozwijają zdolności przestrzenne i analityczne, przydatne także w innych dziedzinach informatyki.
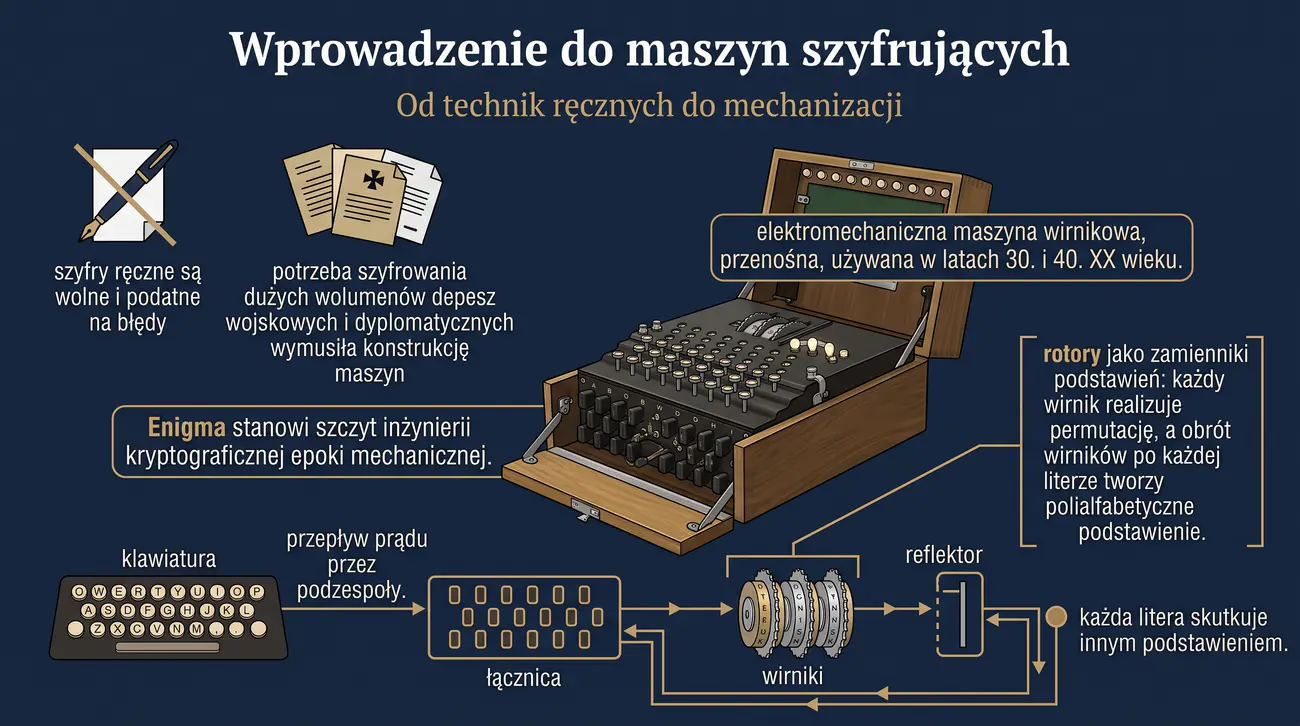
Rozwój maszyn szyfrujących był bezpośrednią odpowiedzią na potrzeby komunikacji wojskowej, w której ręczne szyfrowanie okazywało się zbyt wolne i nazbyt podatne na pomyłki. Wzrost objętości depesz oraz wymóg szybkiego dotarcia rozkazów sprawiły, że zaczęto poszukiwać urządzeń zdolnych do automatycznego wykonywania rachunków szyfrujących. Przenoszenie pracy z człowieka na maszynę umożliwiło jednocześnie stosowanie procedur, których ręczne wykonanie byłoby niepraktycznie czasochłonne.
Maszyny elektromechaniczne, z których najbardziej znaną jest Enigma, realizowały podstawienie za pomocą obwodów elektrycznych prowadzących prąd przez zestaw wirników i reflektor. Kolejne naciśnięcie klawisza zmieniało stan maszyny, dzięki czemu każda litera tekstu otrzymywała inne podstawienie zależne od aktualnej konfiguracji. Taki mechanizm realizuje w praktyce zasadę polialfabetyczności, lecz jej skala znacznie przekracza możliwości konstrukcji opartych na tabelach.
Z inżynierskiego punktu widzenia istotne jest rozróżnienie pomiędzy niezawodnością mechaniczną urządzenia a kryptograficzną siłą jego konstrukcji. Nawet sprawnie działająca i solidnie zbudowana maszyna może bowiem okazać się podatna na ataki, jeśli jej tryby działania są zbyt regularne lub słabo przemyślane. Historia Enigmy uczy, że należy analizować nie tylko matematyczny opis algorytmu, lecz również całe środowisko jego zastosowania, w tym procedury obsługi i uzgodnień kluczy.
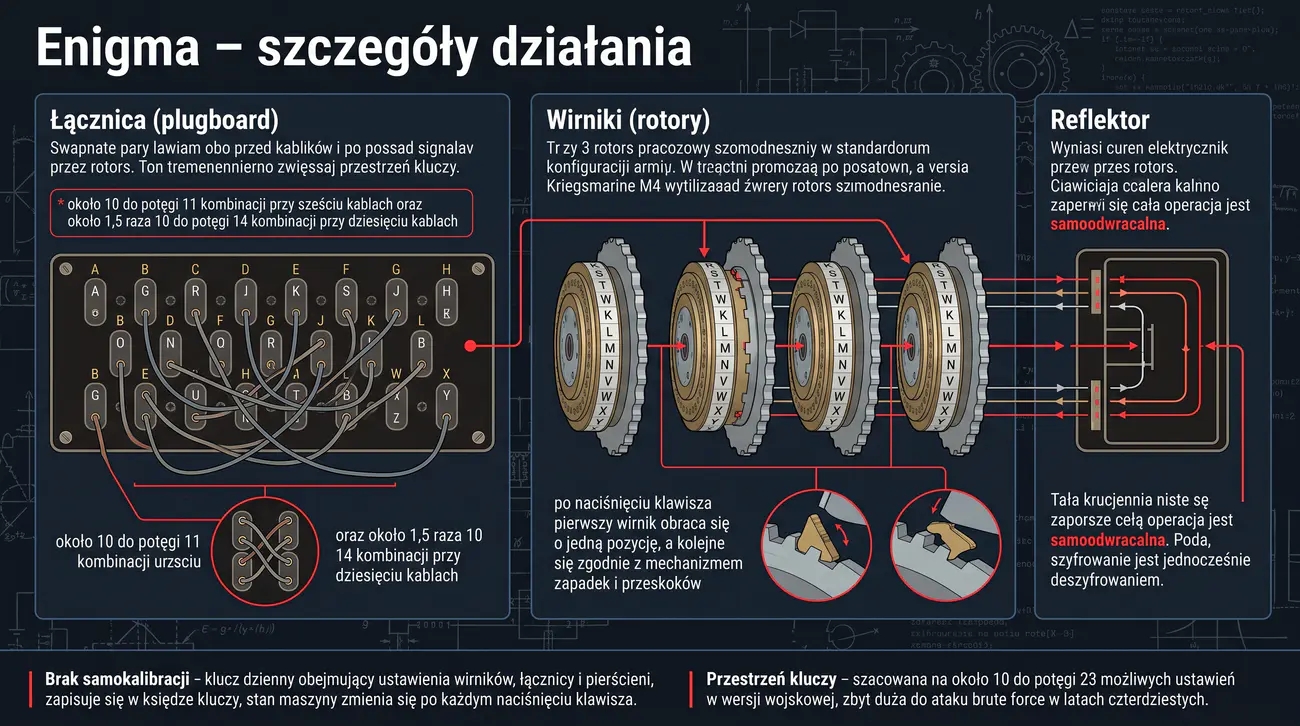
Enigma składała się z trzech głównych elementów: łącznicy, zestawu wirników oraz reflektora, a współdziałanie tych części tworzyło ogromną liczbę możliwych konfiguracji - rzędu 3×10114 dla całej przestrzeni ustawień maszyny. Łącznica realizowała zamianę par liter zanim sygnał trafił do wirników i po jego powrocie, co dodatkowo zwiększało liczbę podstawień widocznych dla operatora. Reflektor natomiast kierował prąd z powrotem przez wirniki, dzięki czemu maszyna szyfrowała i odszyfrowywała tą samą operacją, co ułatwiało obsługę w warunkach polowych.
Obrót wirników po każdym naciśnięciu klawisza sprawiał, że stan maszyny ulegał nieustannej zmianie, co realizowało polialfabetyczne podstawienie o bardzo długim okresie. Mechanizm zapadkowy powodował przy tym, że wirniki przechodziły dalej w sposób przypominający działanie licznika, a rozmieszczenie wycięć czyniło całość trudniejszą do przewidzenia. Przygotowanie maszyny do pracy wymagało ustalenia klucza dziennego, obejmującego wybór wirników, ich ustawień, położenia pierścieni oraz połączeń łącznicy.
Oszacowanie wielkości przestrzeni kluczy Enigmy prowadzi do liczb rzędu 3×10114 kombinacji dla całej przestrzeni ustawień maszyny (praktyczna przestrzeń dziennego klucza była rzędu 1,07×10²³), co w latach czterdziestych przekraczało możliwości jakiejkolwiek systematycznej próby bez narzędzi pomocniczych. Z tego względu złamanie maszyny wymagało inteligentnych metod, które wykorzystywały znajomość procedur i regularności w nadawanych depeszach. Zrozumienie roli każdego elementu urządzenia jest niezbędne, aby prawidłowo interpretować późniejsze sukcesy polskiego i brytyjskiego wywiadu kryptologicznego.
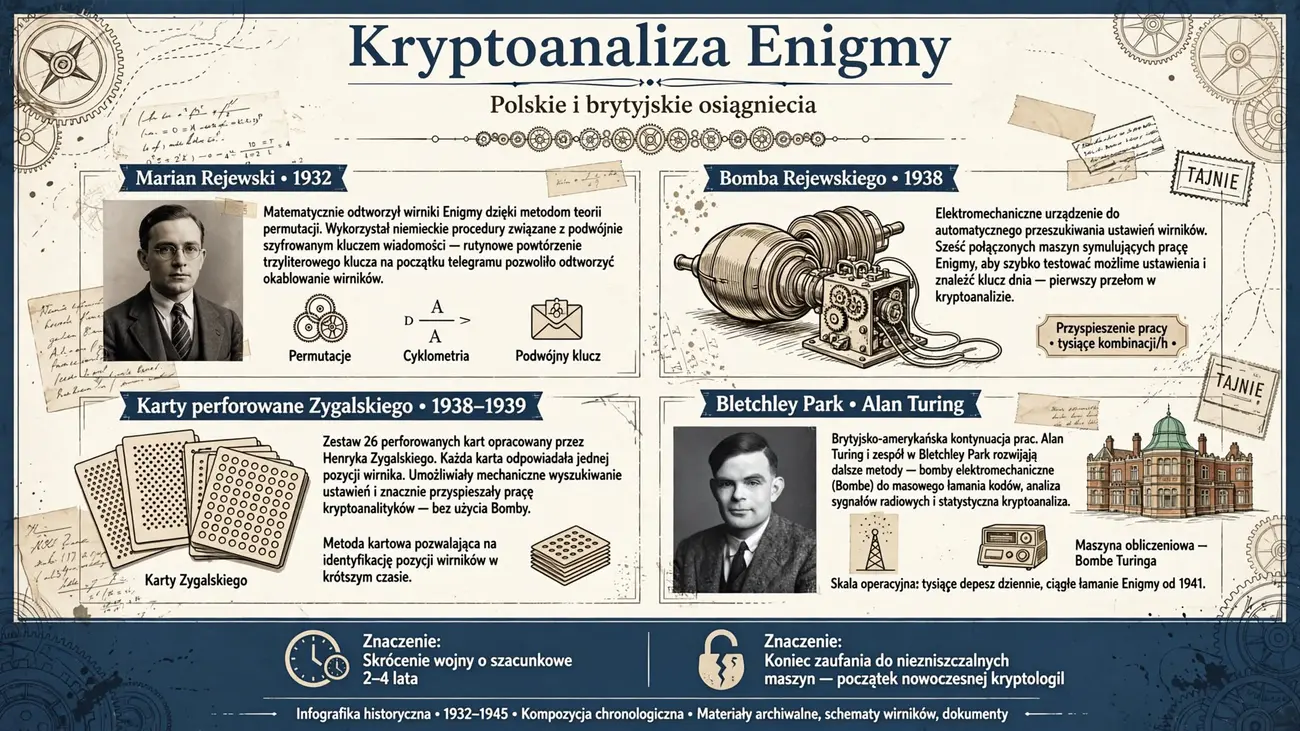
Kryptoanaliza Enigmy należy do najbardziej spektakularnych osiągnięć historii kryptologii, a jej początek wiąże się z pracami polskich matematyków w dwudziestoleciu międzywojennym. Marian Rejewski rozpoznał strukturę matematyczną maszyny i wykorzystał zdobyte informacje wywiadowcze, aby odtworzyć wewnętrzną budowę wirników. Jego metody opierały się na analizie permutacji generowanych przez maszynę i wykorzystywały regularności w procedurach szyfrowania stosowanych przez niemieckich operatorów.
Praktyczne narzędzia, takie jak bomba kryptologiczna oraz karty perforowane Zygalskiego, znacznie przyspieszyły poszukiwanie ustawień, zawężając liczbę sprawdzanych konfiguracji. Po 1939 roku praca została przekazana brytyjskiemu ośrodkowi w Bletchley Park, gdzie Alan Turing i jego zespół rozwinęli ją do skali operacyjnej. Dzięki tym wysiłkom alianci uzyskiwali regularny wgląd w treść niemieckich szyfrogramów, co miało bezpośredni wpływ na przebieg działań wojennych.
Skutki tego sukcesu, szacowane na skrócenie wojny o kilka lat, pokazują, jak ogromne znaczenie mogą mieć osiągnięcia kryptologiczne dla całości polityki państwa. Historia Enigmy uczy również, że o bezpieczeństwie systemu decyduje nie tylko sama matematyka, lecz także procedury, dyscyplina operatorów i sposób zarządzania kluczami. Złamanie urządzenia uznawanego powszechnie za niezniszczalne stanowi przestrogę, którą warto pamiętać przy projektowaniu współczesnych systemów.
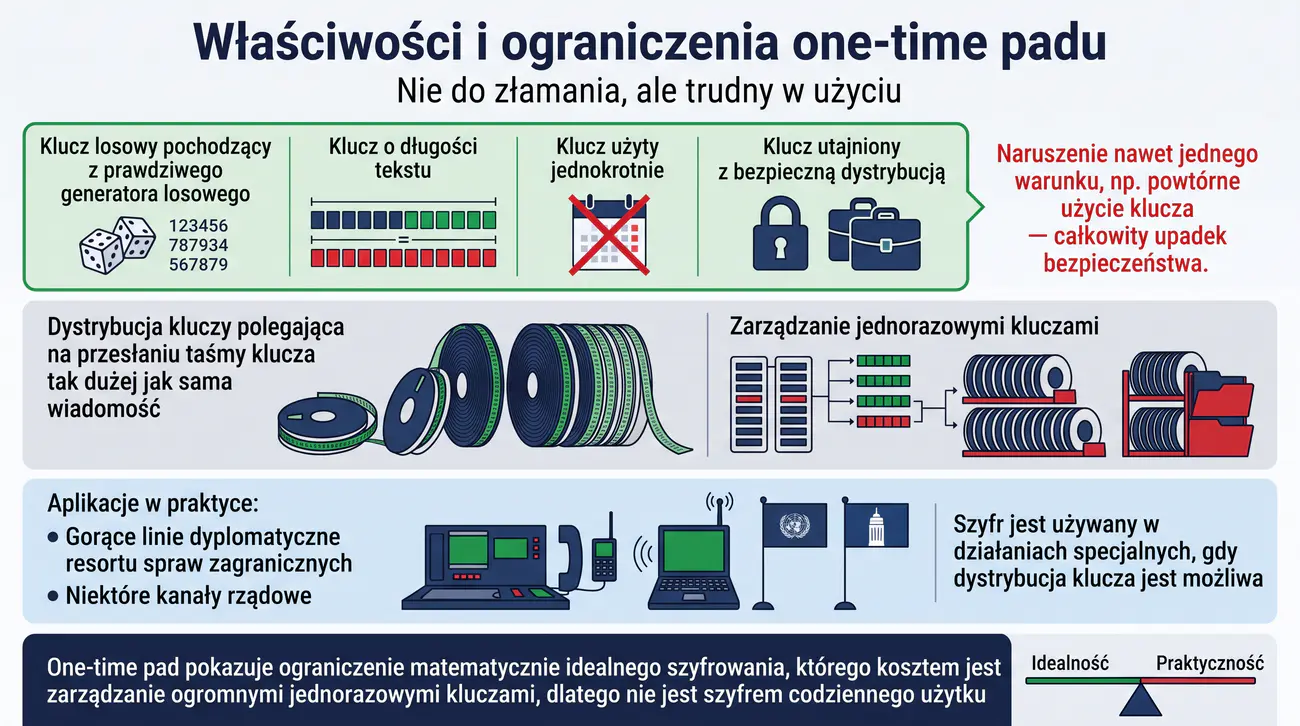
Szyfr jednorazowy zajmuje szczególne miejsce w kryptografii, ponieważ jako jedyny oferuje matematycznie udowodnioną idealną tajność, co odróżnia go od wszystkich innych systemów klasycznych. Jego działanie polega na połączeniu każdego bitu lub litery tekstu z odpowiednim bitem lub literą klucza za pomocą operacji XOR, która jest prostą i szybką operacją bitową. Jedynym sensownym warunkiem skuteczności jest absolutna losowość klucza, który nie może być w żaden sposób przewidywalny dla atakującego.
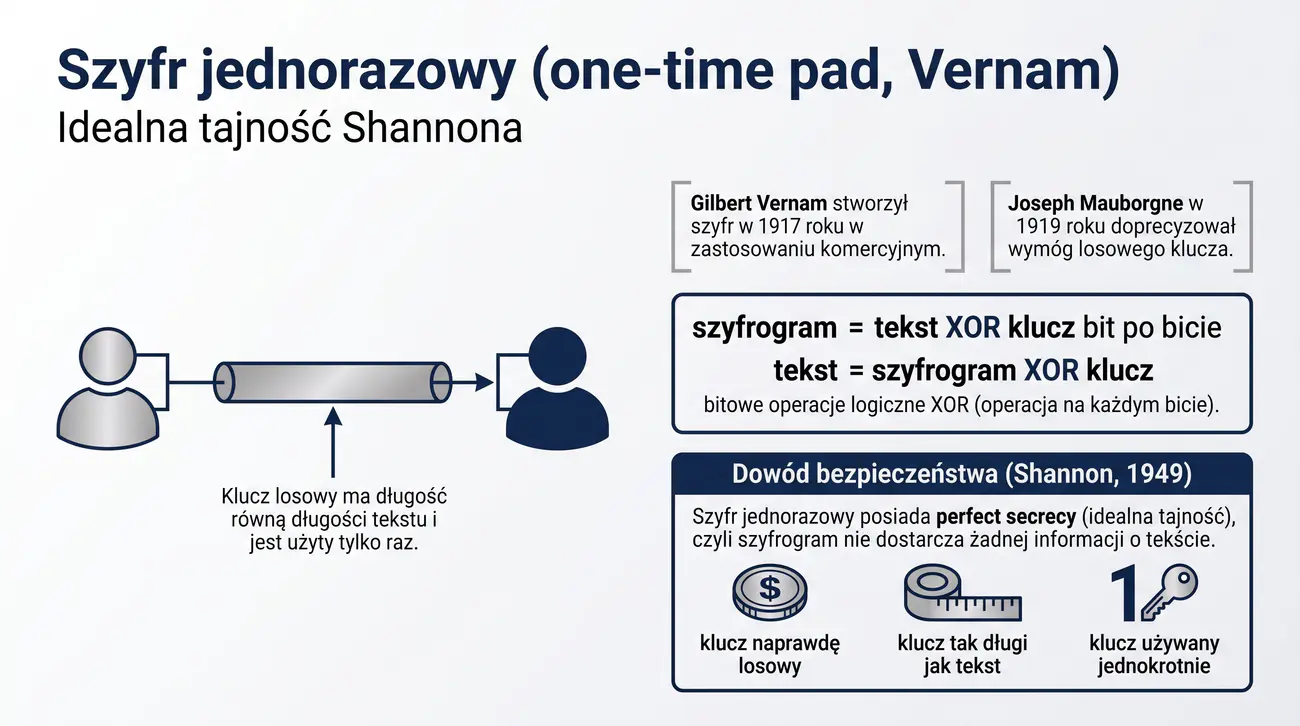
Konstrukcję szyfru opracował Gilbert Vernam, a koncepcję losowego, jednorazowego klucza udoskonalił Joseph Mauborgne, co wspólnie dało podwaliny pod systemy wykorzystywane w komunikacji elektronicznej. Formalnego dowodu bezpieczeństwa dostarczył Claude Shannon, który wykazał, że jeśli klucz jest losowy, ma długość tekstu i nigdy nie jest użyty ponownie, to szyfrogram nie zdradza żadnej informacji o treści. Dzięki temu pomiędzy kluczem a tekstem nie powstaje żadna statystyczna zależność, a każde zaszyfrowanie jest nieodróżnialne od losowego ciągu.
Z dowodu Shannona wynika, że idealna tajność jest osiągalna, lecz warunki jej zapewnienia są na tyle rygorystyczne, że w codziennych zastosowaniach zwykle rezygnuje się z tej konstrukcji. Dystrybucja klucza o długości wiadomości wymaga bowiem przesyłania ogromnych ilości sekretu, co bywa niepraktyczne w skali masowej komunikacji. Znaczenie OTP dla teorii kryptografii pozostaje jednak ogromne, gdyż wyznacza ono najwyższą możliwą granicę odporności, do której dążą wszystkie inne systemy.
Mimo matematycznej doskonałości one-time pad w praktyce napotyka poważne trudności logistyczne, które wykluczają jego powszechne stosowanie w komunikacji elektronicznej. Podstawowa przeszkoda dotyczy dystrybucji i przechowywania kluczy, które muszą być tak duże jak chronione wiadomości i muszą trafić do odbiorcy bezpiecznym kanałem. Druga, równie istotna trudność wiąże się z zarządzaniem stanem klucza, który po użyciu musi zostać bezwzględnie odrzucony, co wymaga rygorystycznej dyscypliny organizacyjnej.
Naruszenie któregokolwiek z warunków, w szczególności ponowne użycie tego samego klucza, pozbawia system idealnej tajności, gdyż powstająca wówczas struktura może być badana metodami statystycznymi (dwa teksty zaszyfrowane tym samym kluczem dają szyfrogramy różniące się tak samo, jak różniły się same teksty). Historyczne przypadki pomyłek tego typu pokazują, że nawet najsilniejszy szyfr staje się bezbronny, gdy jego użytkownicy nie przestrzegają przyjętych procedur. Właśnie z tego powodu techniki jednorazowych kluczy są zarezerwowane dla wąskich zastosowań, w których koszt dystrybucji sekretu jest do przyjęcia.
Realne użycie one-time padu obejmuje między innymi linie dyplomatyczne oraz wybrane kanały rządowe, gdzie poufność ma najwyższy priorytet, a wymiana kluczy odbywa się przez kurierów lub inne bezpieczne środki. W takim modelu klucze bywają przygotowywane z wyprzedzeniem i dostarczane w formie materiałów fizycznych, co odsuwa problem kanału elektronicznego. Rozważenie tych ograniczeń pomaga zrozumieć, że w projektowaniu systemów bezpieczeństwa liczy się równowaga między siłą teoretyczną a wykonalnością operacyjną.
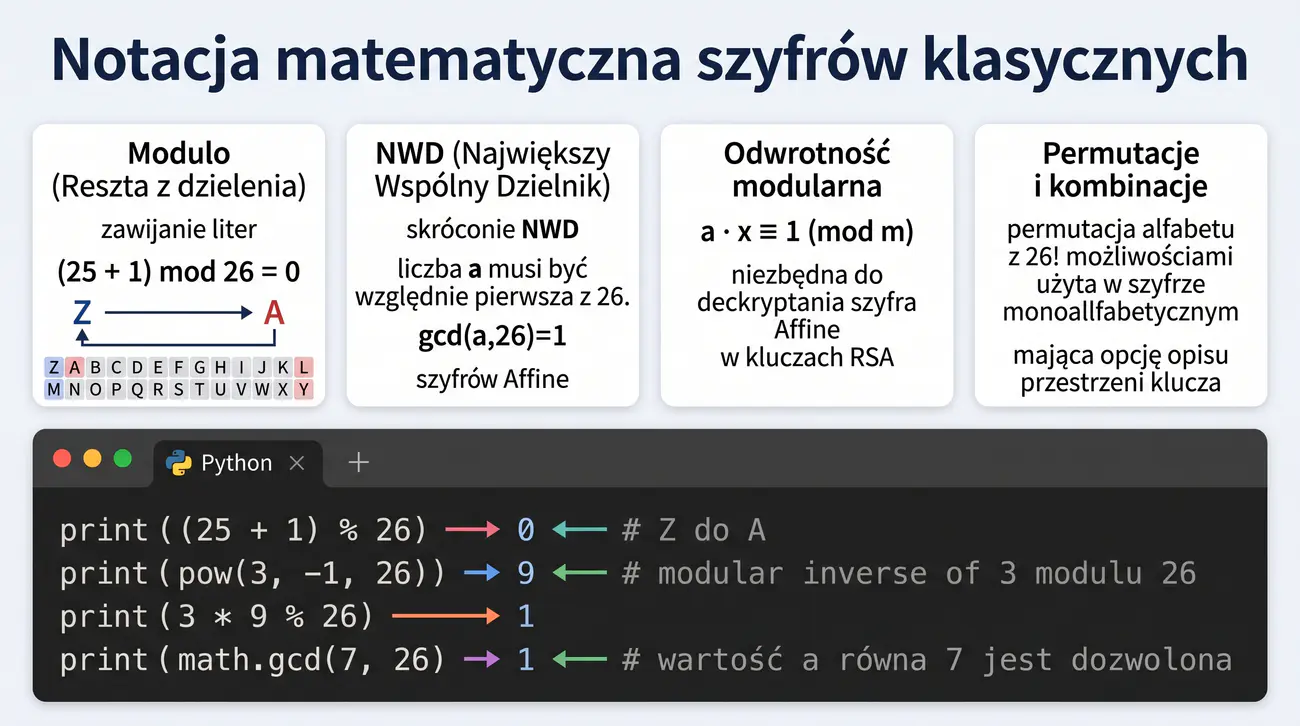
$ python3 -c " print((25+1)%26) # 0 (Z->A) print(pow(3,-1,26)) # 9 (odwrotność 3 mod 26) print(3*9%26) # 1 (potwierdzenie) import math; print(math.gcd(7,26)) # 1 -> a=7 dozwolony"
Matematyka szyfrów klasycznych opiera się na kilku podstawowych pojęciach algebry, które mimo swej prostoty powracają we wszystkich współczesnych algorytmach. Arytmetyka modulo definiuje sposób zawijania wyników działań do zakresu alfabetu, co w przypadku ruchów po literach daje naturalny model przesunięć cyklicznych. Pojęcie największego wspólnego dzielnika pojawia się z kolei przy ocenie, czy dany współczynnik może być użyty jako mnożnik odwracalny.
Kluczowe znaczenie dla wielu szyfrów ma odwrotność modularna, czyli liczba, która pomnożona przez daną wartość daje wynik jeden w działaniu modulo. Bez tego pojęcia nie jest możliwe poprawne odszyfrowanie szyfru afinicznego, a w szerszym kontekście znajduje ono zastosowanie także w algorytmach klucza publicznego. Umiejętność wyznaczania odwrotności modularnej, na przykład algorytmem Euklidesa lub wbudowaną funkcją języka Python, stanowi zatem niezbędne narzędzie pracy z kryptografią.
Oprócz arytmetyki modularnej w analizie stosuje się pojęcia kombinatoryczne, zwłaszcza permutacje, które opisują możliwe porządki i układy alfabetu. Liczba permutacji rośnie niezwykle szybko wraz z wielkością zbioru, co ilustruje choćby proste zestawienie permutacji alfabetu. Rozumienie tych pojęć stanowi podstawę do oszacowania przestrzeni kluczy, a tym samym do uczciwej oceny bezpieczeństwa dowolnego systemu kryptograficznego.
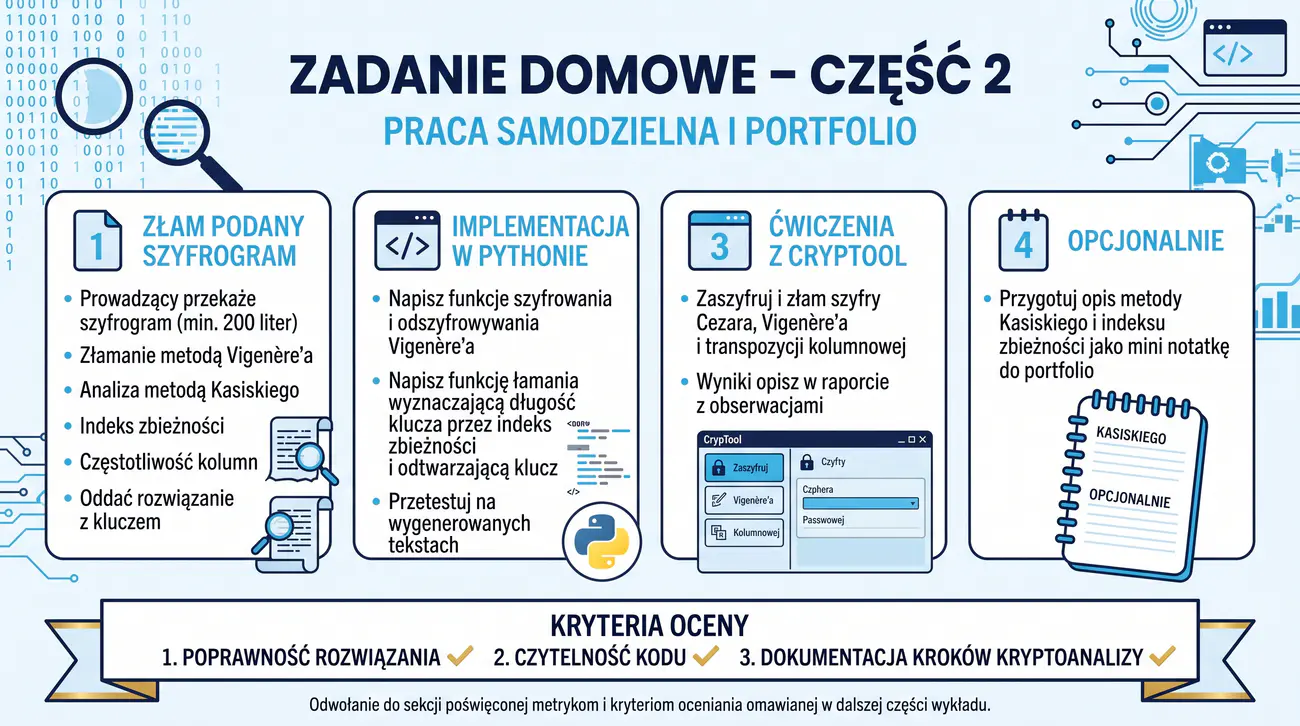
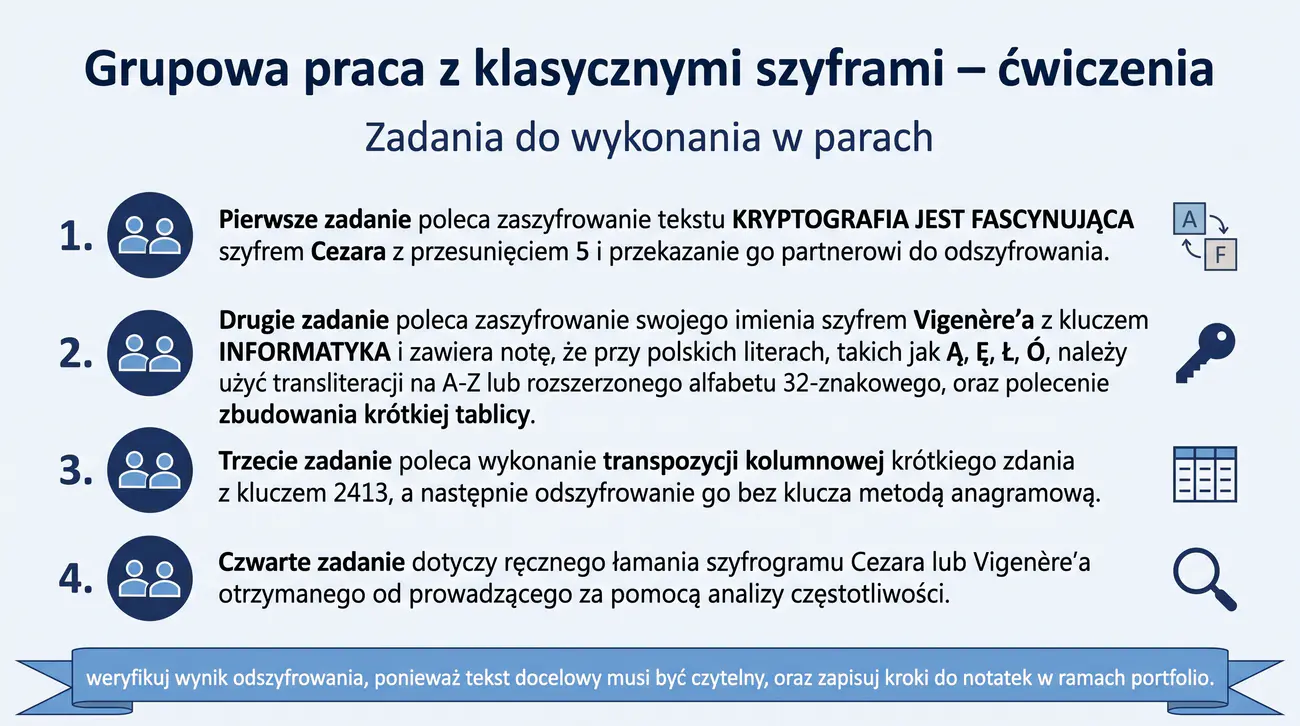
Zadania mają na celu wykształcenie umiejętności niezbędnych do samodzielnej pracy z kryptografią, w tym poprawnego szyfrowania i odszyfrowywania. Uzgadnianie jawnej konwencji – przesunięcia, klucza, schematu transliteracji – uczy przekazywania parametrów algorytmu, co zbliża do realiów pracy zespołowej. Błędy popełnione podczas ćwiczeń stają się cennym materiałem, gdyż pozwalają lepiej zrozumieć specyfikację algorytmu.
Zadania obejmują zarówno proste obliczenia ręczne, jak i krótkie implementacje, dzięki czemu poznaje się różne poziomy abstrakcji opisu algorytmu. W przypadku liter ze znakami diakrytycznymi konieczne jest ustalenie spójnej reguły, czy zastosować transliterację na zwykły alfabet łaciński, czy też alfabet rozszerzony. Takie uzgodnienia są doskonałą lekcją standardyzacji, która w inżynierii oprogramowania bywa nie mniej istotna niż sam algorytm.
Po zakończeniu ćwiczeń warto zapisać w notatkach zarówno poprawne wyniki, jak i popełnione błędy oraz sposób ich naprawy. Umiejętność dokumentowania przebiegu analizy przydaje się przy każdym kolejnym zadaniu, a systematyczne prowadzenie notatek rozwija nawyk metodycznej pracy, ceniony w środowisku zawodowym.
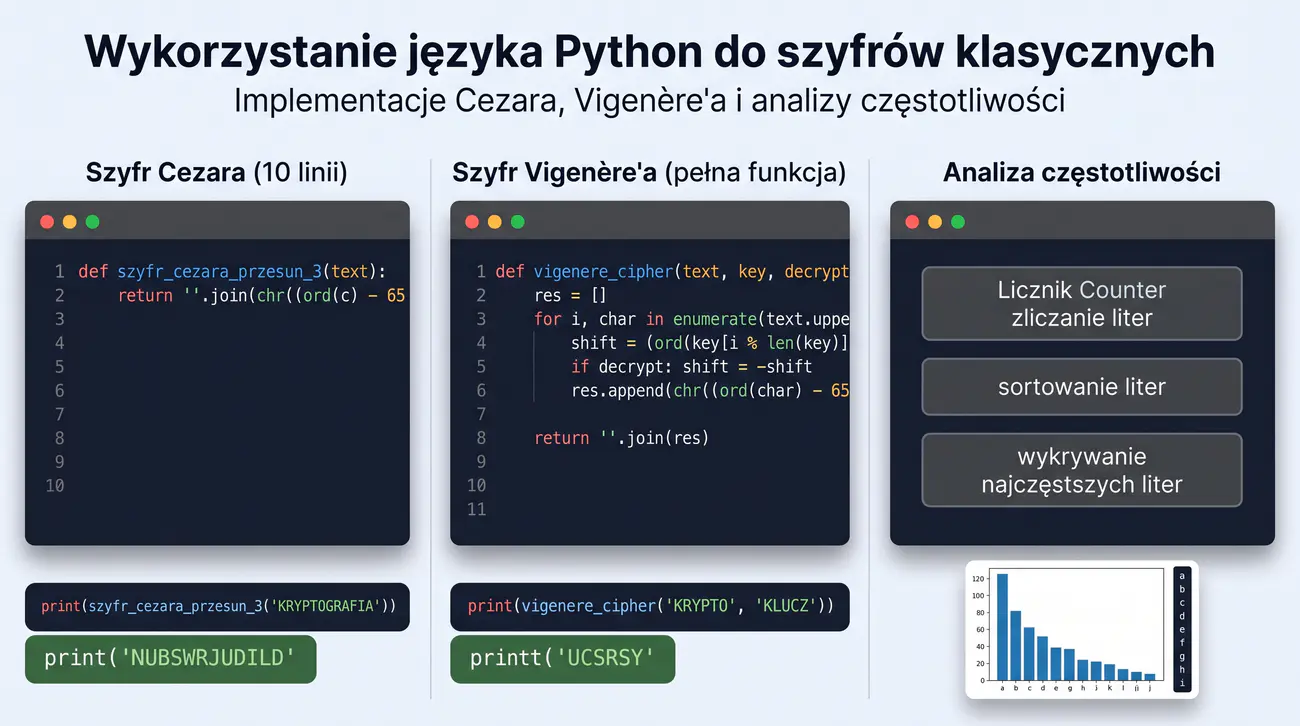
Szyfr Cezara (10 linii):
$ python3 -c " A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' def cae(t,k): return ''.join(A[(A.index(c)+k)%26] for c in t) print(cae('KRYPTOGRAFIA',3)) # NUBSWRJUDILD"
Szyfr Vigenère’a (pełna funkcja):
$ python3 -c " A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' def vig(t,k,dec=False): r=''; ki=0 for c in t: p=A.index(c); s=A.index(k[ki%len(k)]); ki+=1 r+=A[(p-s)%26] if dec else A[(p+s)%26] return r print(vig('KRYPTO','KLUCZ')) # UCSRSY"
Analiza częstotliwości: licznik Counter, sortowanie liter, wykrywanie najczęstszych liter.
Język Python od lat stanowi podstawowe narzędzie do nauki i eksperymentowania z algorytmami kryptograficznymi, dzięki prostocie składni i bogatemu zestawowi bibliotek. Krótkie implementacje, które mieszczą się w kilku liniach, pozwalają szybko powiązać wzory matematyczne z działającym kodem, co znacznie ułatwia przyswojenie materiału. Dla poprawnej realizacji szyfrów opartych na alfabecie konieczne jest konsekwentne stosowanie jednej konwencji numerowania liter oraz operacji modulo.
Tworząc funkcje szyfrujące i odszyfrowujące, należy zwracać uwagę na spójność parametrów i jasność nazw zmiennych, gdyż czytelność kodu ułatwia późniejsze debugowanie i modyfikacje. Porównywanie wyników implementacji z ręcznie obliczonymi przykładami stanowi zalecaną metodę testowania, szczególnie na zbiorach danych przygotowanych na slajdach. Analiza częstotliwości, oparta na prostym zliczaniu wystąpień liter, pozwala od razu zbudować podstawowe narzędzia do zadania łamania szyfrów.
Warto od początku organizować kod w postaci osobnych funkcji, co ułatwia ponowne użycie w kolejnych zadaniach, takich jak procedury łamania szyfru Vigenère’a. Dobrą praktyką jest również przygotowanie testów sprawdzających, czy znane szyfrogramy są poprawnie odkodowywane, co chroni przed drobnymi błędami logicznymi. Tak ujęta praca programistyczna buduje umiejętności inżynierskie przydatne również w pracy zawodowej.
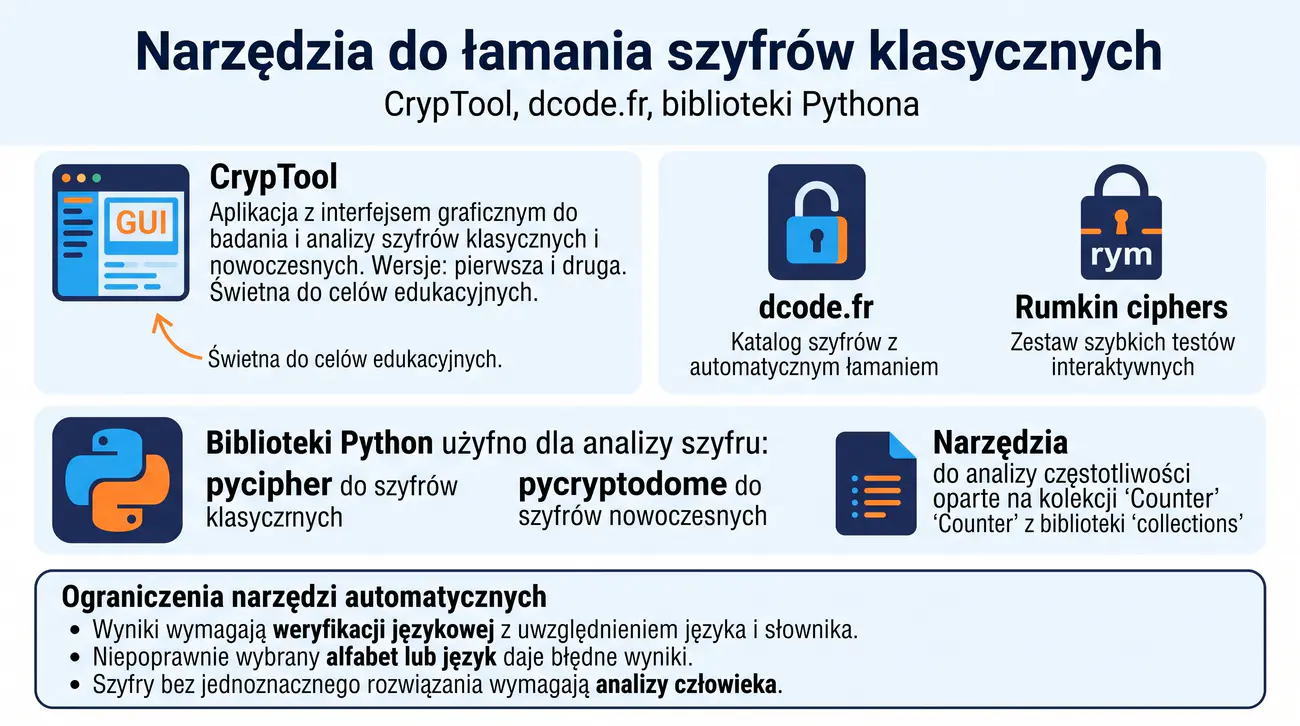
Narzędzia wspomagające kryptoanalizę szyfrów klasycznych mają różny charakter, od programów graficznych takich jak CrypTool, przez serwisy internetowe, aż po biblioteki języka Python. Rozwiązania graficzne sprawdzają się szczególnie w edukacji, gdyż pozwalają wizualnie śledzić kolejne etapy szyfrowania i łamania bez pisania kodu. Serwisy przeglądarkowe oferują natomiast szybkie sprawdzenie pojedynczych przypadków, co bywa wygodne podczas rozwiązywania zadań.
Ważne jest jednak, aby wyniki otrzymane z narzędzi automatycznych traktować krytycznie, ponieważ program może błędnie rozpoznać język lub zastosować niewłaściwą konwencję alfabetu. W szczególności polskie znaki diakrytyczne wymagają jawnie wybranego sposobu transliteracji, a jego brak prowadzi do błędnych propozycji odszyfrowania. Zawsze należy weryfikować sensowność wyniku przez ręczne odczytanie tekstu i porównanie z własnym tokiem rozumowania.
Biblioteki języka Python pozwalają na większą elastyczność, umożliwiając budowę własnych, powtarzalnych procedur analizy dopasowanych do konkretnego zadania. Tego rodzaju środowiska dają również możliwość dociekliwego zrozumienia wewnętrznego działania każdego kroku, czego nie zapewniają czarne skrzynki. W praktyce inżynierskiej łączy się narzędzia szybkiego sprawdzania z samodzielnie pisanym kodem, aby mieć pełną kontrolę nad procesem kryptoanalizy.
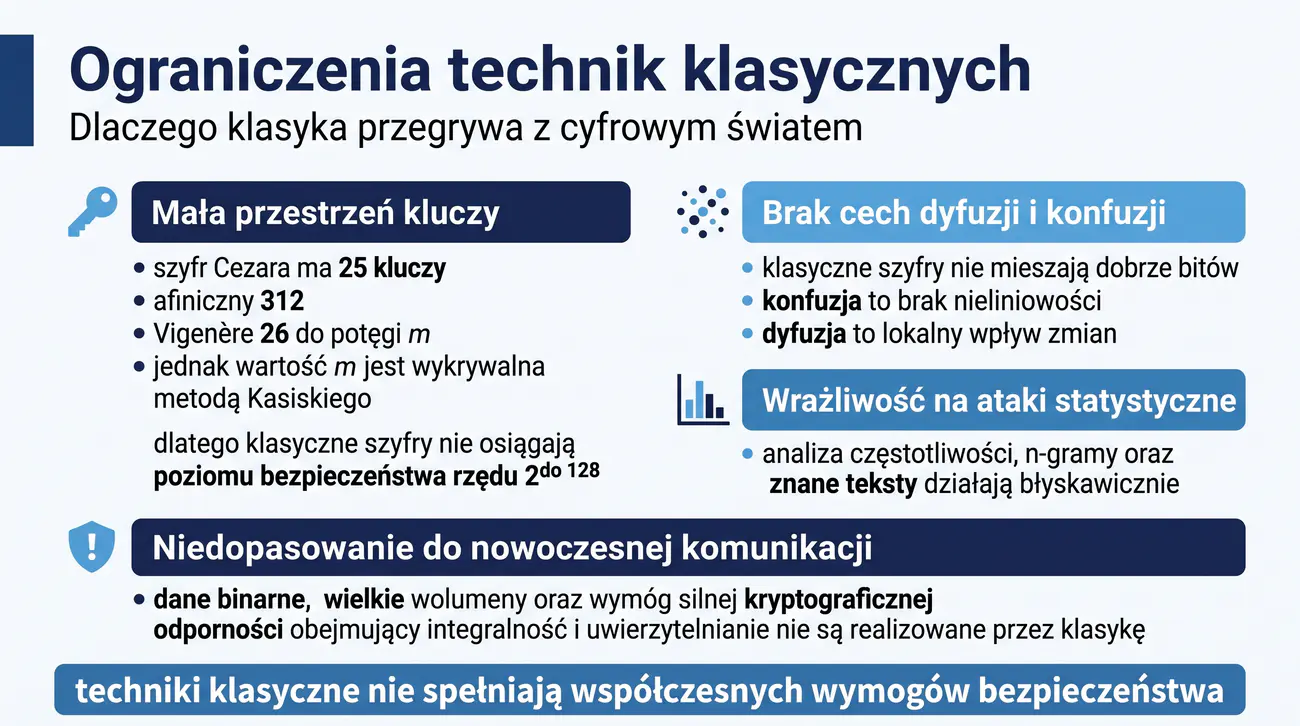
Ograniczenia technik klasycznych wynikają z kilku fundamentalnych cech, które uniemożliwiają ich zastosowanie do ochrony współczesnej komunikacji cyfrowej. Przede wszystkim przestrzenie kluczy nawet najrozleglejszych szyfrów ręcznych pozostają bez porównania mniejsze niż wymagane bezpieczeństwo rzędu 2128, które zapewniają nowoczesne algorytmy. Ponadto klasyczne konstrukcje nie mieszają informacji w sposób wystarczająco głęboki, przez co w szyfrogramie pozostają widoczne ślady struktury tekstu.
Współczesne systemy muszą również sprostać wymogom, które nie mają odpowiednika w świecie szyfrów literowych, takim jak ochrona danych binarnych, weryfikacja integralności czy uwierzytelnianie stron komunikacji. Same szyfry klasyczne nie oferują mechanizmów gwarantujących autentyczność przekazu ani wykrywania modyfikacji, co w środowisku sieciowym jest niezbędne. Ich działanie na poziomie pojedynczych liter dodatkowo nie przystaje do sposobu przetwarzania danych przez komputery, które operują na blokach bitów i bajtów.
Analiza przyczyn słabości klasyki prowadzi do wniosku, że bezpieczeństwo systemu wymaga zarówno dużej przestrzeni kluczy, jak i odpowiedniego rozproszenia zmian, zwanych konfuzją i dyfuzją. Dopiero połączenie tych elementów w wielokrotne rundy przekształceń tworzy szyfry, które wydają się opierać atakom statystycznym. Z tego względu część druga zamyka się przejściem do nowoczesnych konstrukcji, które stanowią rozwinięcie, a zarazem przezwyciężenie ograniczeń epoki klasycznej.
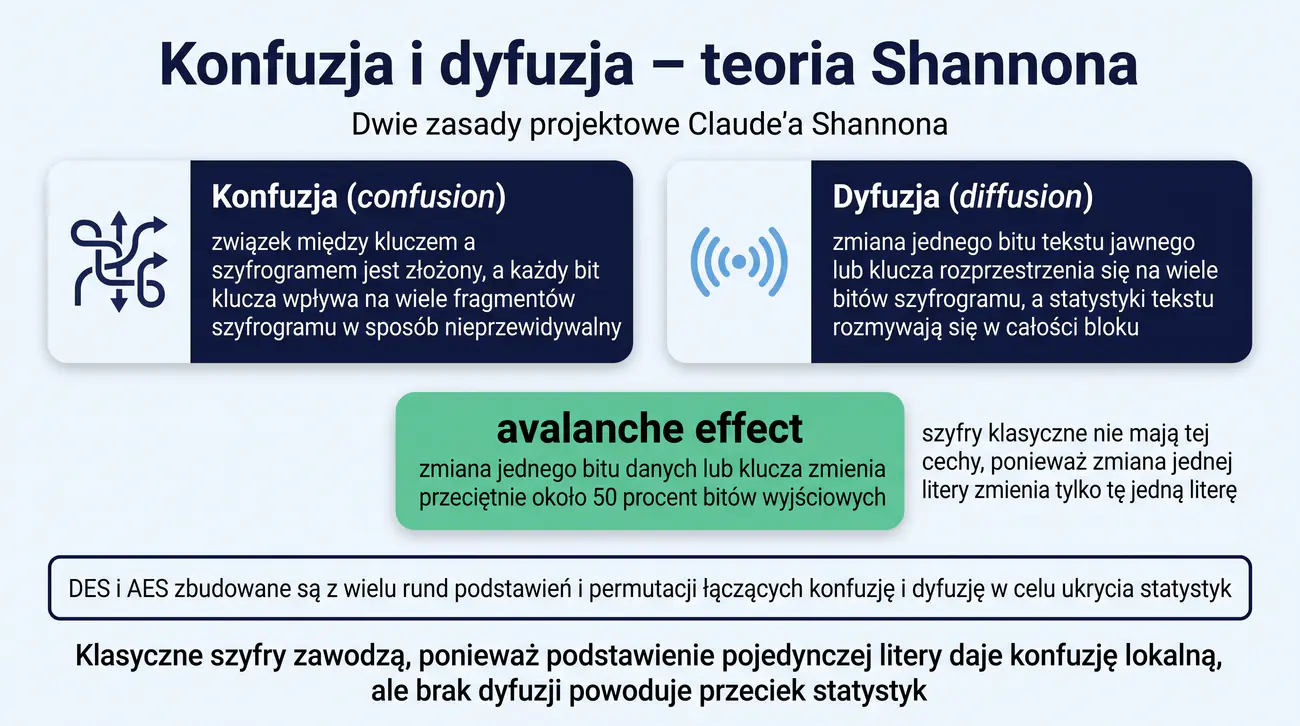
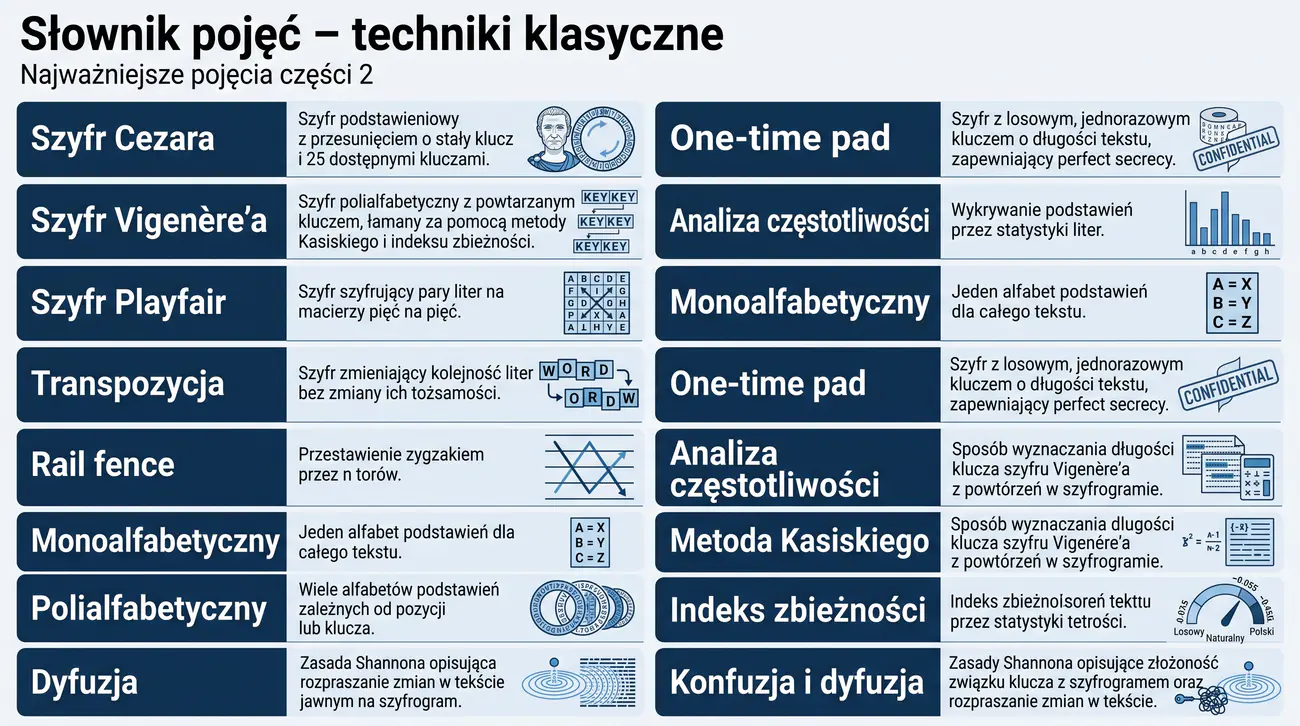
Konfuzja i dyfuzja to dwie zasady projektowe sformułowane przez Claude'a Shannona, które opisują pożądane właściwości wszystkich solidnych algorytmów kryptograficznych. Konfuzja dotyczy złożoności zależności pomiędzy kluczem a wynikowym szyfrogramem, dzięki czemu żaden fragment klucza nie daje się przewidzieć w prosty sposób na podstawie obserwacji wyjścia. Dyfuzja odnosi się do rozpraszania wpływu każdego znaku lub bitu tekstu na wiele elementów szyfrogramu, co zaciera statystyczne prawidłowości przekazu.
W praktyce obie cechy osiąga się przez wielokrotne powtarzanie prostych operacji podstawieniowych i permutacyjnych w ramach kolejnych rund algorytmu. Właśnie tak zbudowane są szyfry blokowe, które naprzemiennie stosują tablice podstawień oraz przekształcenia porządkujące bity, aby uzyskać efekt lawinowego reagowania na niewielkie zmiany wejścia. Obserwowany efekt, polegający na zmianie około połowy bitów wyjścia po zmianie jednego bitu danych czy klucza, nosi nazwę efektu lawinowego.
Zestawienie tego modelu z właściwościami szyfrów klasycznych pokazuje przyczynę ich słabości, gdyż podstawienie pojedynczych liter realizuje jedynie lokalną konfuzję bez zapewnienia odpowiedniej dyfuzji. W najprostszych szyfrach klasycznych zmiana jednej litery wpływa zatem na jedną literę szyfrogramu, co pozostawia atakującemu cenne informacje o strukturze tekstu; wyjątkami są Playfair (jedna litera wpływa na parę) i szyfry stanowe typu Enigma, gdzie każde naciśnięcie zmienia stan maszyny. Zrozumienie różnicy między tymi pojęciami stanowi klucz do interpretacji konstrukcji nowoczesnych algorytmów omawianych w kolejnej części materiału.
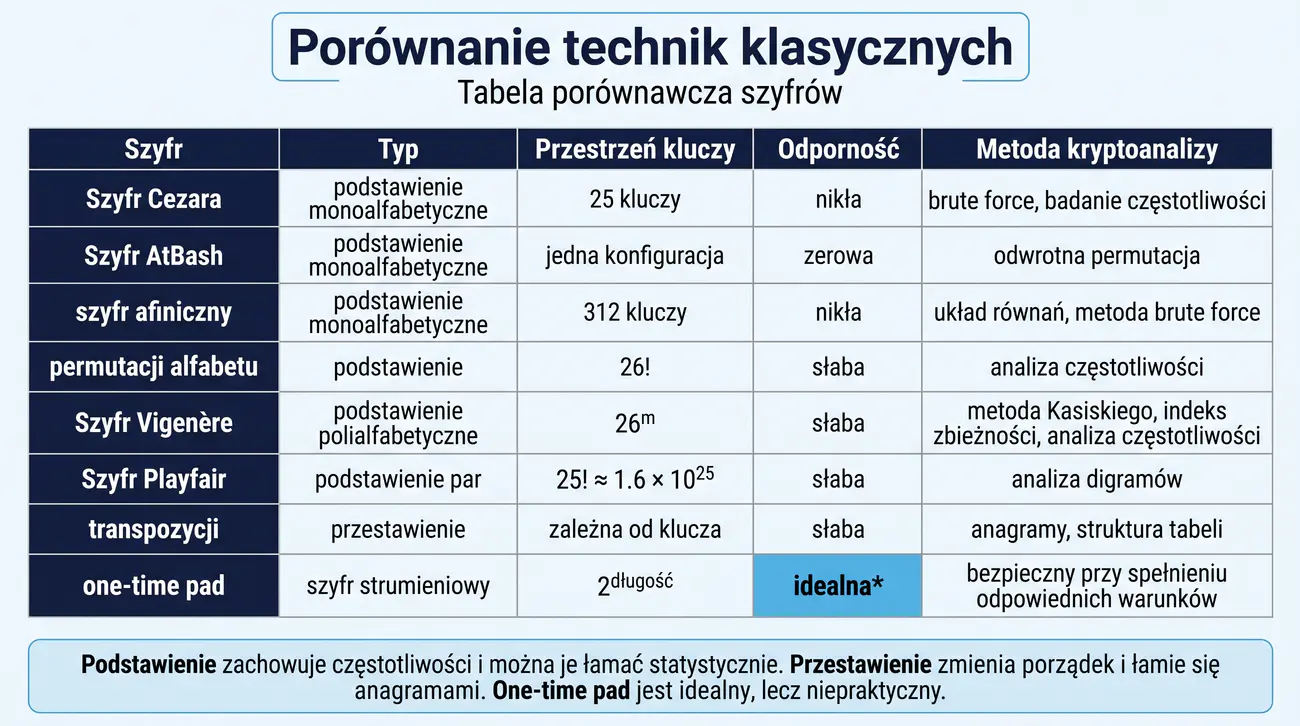
| Szyfr | Typ | Przestrzeń kluczy | Odporność | Metoda kryptoanalizy |
|---|---|---|---|---|
| Cezar | podstawienie monoalf. | 25 | nikła | brute force / częstotliwości |
| AtBash | podstawienie monoalf. | 1 | zero | odwrotna permutacja |
| Afiniczny | podstawienie monoalf. | 312 | nikła | układ równań / brute |
| Permutacja alfabetu | podstawienie monoalf. | 26! | słaba | analiza częstotliwości |
| Vigenère | podstawienie poli. | 26m | słaba | Kasiski + IC + częstotliwość |
| Playfair | podstawienie par | 25! (ok. 1,6×1025) | słaba | analiza digramów |
| Rail fence | przestawienie | liczba torów (mała) | bardzo słaba | wzorce zygzaga |
| Transpozycja | przestawienie | zależna od klucza | słaba | anagramy / struktura tabeli |
| One-time pad | strumieniowy | qL (np. 26L dla liter) | idealna* | bezpieczny przy warunkach |
Wnioski: podstawienie zachowuje częstotliwości (można łamać statystycznie), przestawienie zmienia porządek (anagramy); OTP idealny, lecz niepraktyczny. Wielkość przestrzeni kluczy nie wystarcza do oceny siły szyfru: 25! Playfaira to ok. 1,6×1025, czyli mniej niż 2128 dla AES-128, a mimo to Playfair daje się złamać analizą digramów – liczy się struktura, nie sam rzut liczby.
Tabela porównawcza zgromadzona na slajdzie pozwala w skrócony sposób zestawić wszystkie poznane szyfry według typu, rozmiaru przestrzeni kluczy oraz przewidywanej metody kryptoanalizy. Dzięki takiemu ujęciu łatwo ocenić, jak zmienia się poziom odporności w miarę rozwoju technik od prostych przesunięć po układy polialfabetyczne. Warto zauważyć, że wielkość przestrzeni kluczy nie jest jedynym czynnikiem decydującym o sile, co jasno pokazuje przypadek permutacji alfabetu o ogromnej liczbie możliwych ustawień.
Rozróżnienie między podstawieniem a przestawieniem, odzwierciedlone w tabeli, ma fundamentalne znaczenie dla podejścia do analizy szyfrogramu. Podstawienie zachowuje rozkład częstości liter, natomiast przestawienie zmienia porządek bez zmiany tożsamości znaków, co determinuje całkowicie różne metody ataku. Z kolei szyfr jednorazowy wyróżnia się teoretyczną, idealną odpornością, choć jego praktyczne zastosowanie ograniczają trudności logistyczne, na które wskazuje adnotacja o warunkach bezpieczeństwa.
Analiza takiej tabeli rozwija umiejętność syntetycznego porównywania systemów, która jest przydatna również przy ocenie nowoczesnych algorytmów. Przyglądając się metodom kryptoanalizy, uczymy się przewidywać, które atrybuty konstrukcji czynią ją bardziej lub mniej podatną na ataki. Dzięki temu potrafi świadomie ocenić, kiedy wykorzystanie techniki klasycznej jest dopuszczalne wyłącznie w celach dydaktycznych czy rekreacyjnych, a kiedy konieczne jest zastosowanie algorytmów nowoczesnych.
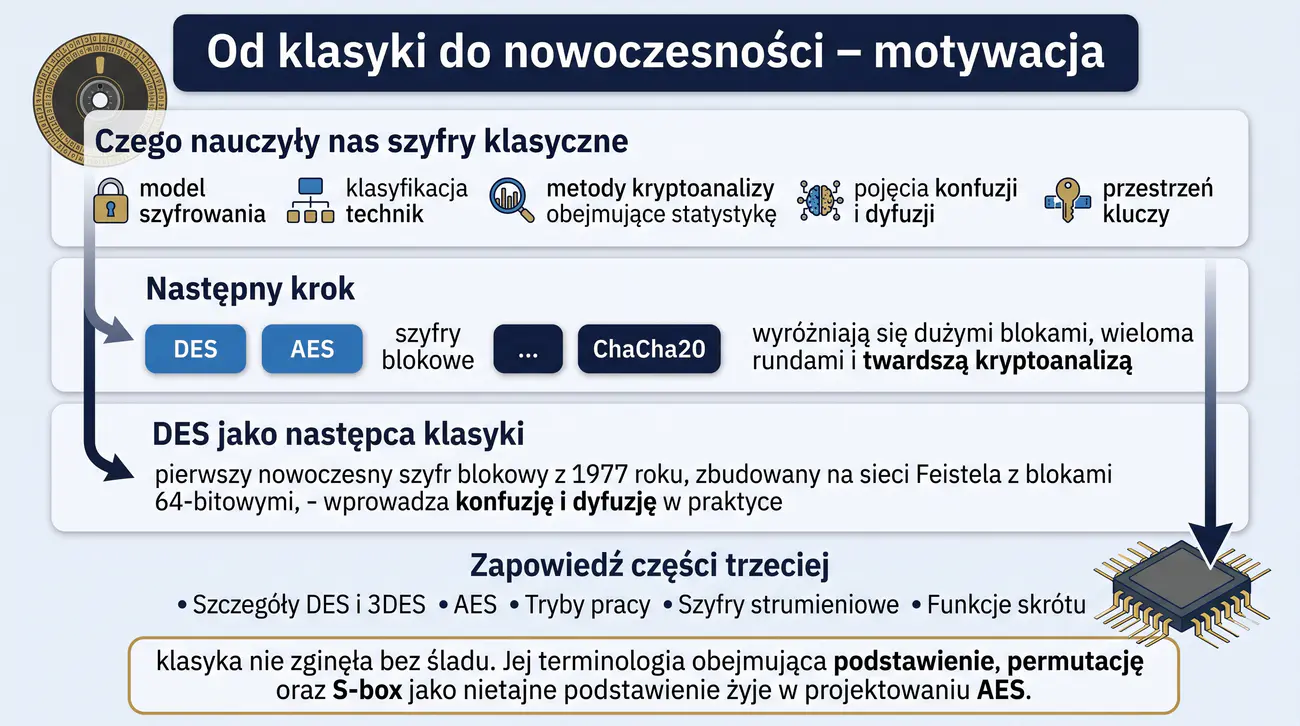
Przejście od szyfrów klasycznych do nowoczesnych nie oznacza całkowitego porzucenia idei wypracowanych w poprzednich stuleciach, lecz raczej ich twórcze rozwinięcie i dostosowanie do świata cyfrowego. Terminy podstawienie i permutacja, wypracowane przez kryptoanalityków epoki klasycznej, weszły do kanonu narzędzi stosowanych w projektowaniu współczesnych algorytmów. Tablice podstawień, występujące w nowoczesnych szyfrach pod nazwą S-boxów, są wprost kontynuacją klasycznych mapowań liter.
Pierwszym szeroko rozpowszechnionym szyfrem blokowym, który w pełni wykorzystał koncepcje konfuzji i dyfuzji, był standard DES zaprojektowany w latach siedemdziesiątych dwudziestego wieku. Jego konstrukcja opiera się na sieci Feistela, w której kolejne rundy naprzemiennie dzielą i przekształcają bloki danych, a całość wzorowana jest na wielokrotnym powtarzaniu prostych operacji podstawieniowych i permutacyjnych. Ten właśnie wzorzec, w połączeniu ze znacznie większymi przestrzeniami kluczy, stał się wzorem dla późniejszych rozwiązań, w tym zwycięskiego w konkursie NIST algorytmu AES.
Zapowiedź omówienia szyfrów blokowych i strumieniowych wskazuje, że poznane tu pojęcia będą intensywnie wykorzystywane w dalszych częściach materiału. Warto zatem solidnie opanować terminologię oraz umieć wyjaśnić różnice między podstawieniem a przestawieniem, a także między szyframi blokowymi a strumieniowymi. Takie przygotowanie pozwoli płynnie przejść do analizy budowy nowoczesnych struktur kryptograficznych i ich bezpieczeństwa.
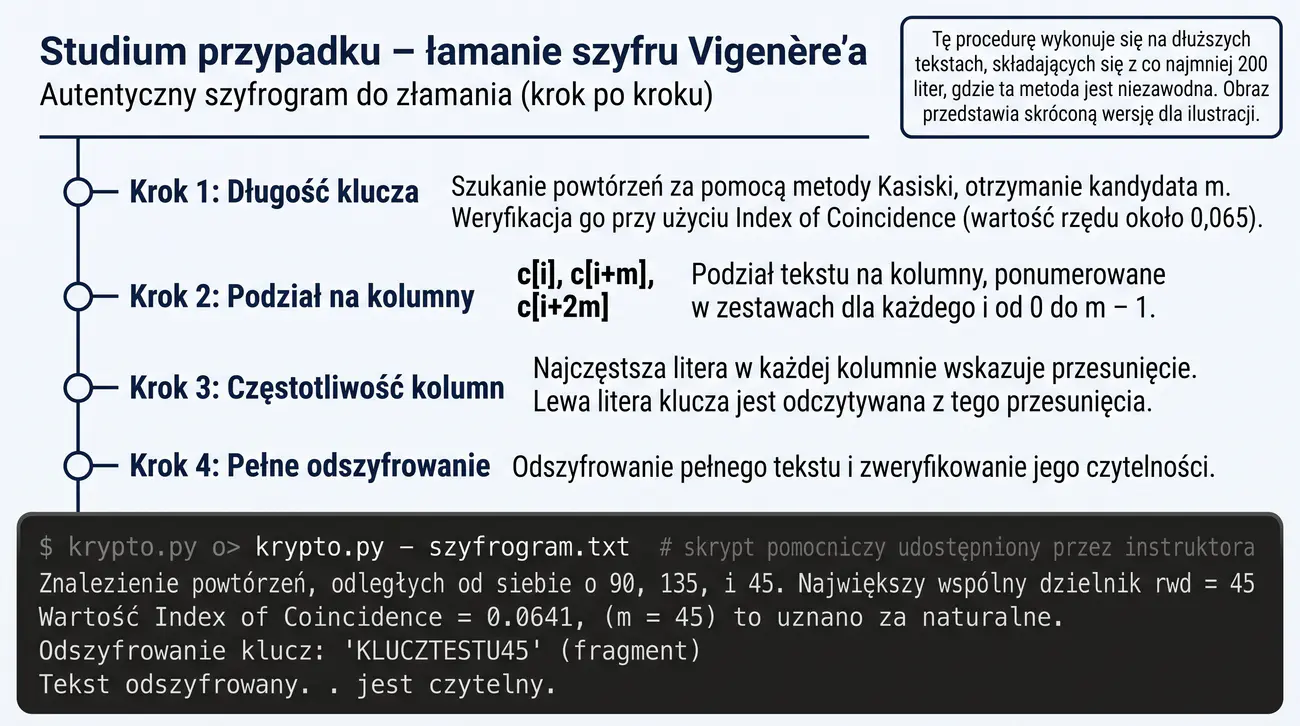
Szyfrogram: kluczowy warunek to długość – metody statystyczne zawodzą poniżej ok. 300 znaków. Poniższe wyniki pochodzą z poniższego, samowystarczalnego skryptu dla tekstu polskiego długości 878 znaków zaszyfrowanego kluczem 12-literowym. Dane wejściowe czytane są z pliku szyfrogram.txt (jeden ciąg liter A-Z).
$ python3 -c " from collections import Counter A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' F=[10.3,1.1,5.1,3.1,8.8,0.6,1.3,1.3,7.4,2.3,3.1,3.1,2.6,6.5,8.4,3.2,0.1,5.0,4.6,4.5,2.4,0.1,4.5,0.1,4.5,6.4] c=open('szyfrogram.txt').read().strip() pos={}; dist=[] for i in range(len(c)-2): g=c[i:i+3] if g in pos: dist.append(i-pos[g]) else: pos[g]=i dz=Counter(d for d in dist for k in range(2,21) if d%k==0) print('1. powtorzonych trigramow:',len(dist)) print('2. najczestsze odleglosci:',' '.join('%d (%dx)'%(d,n) for d,n in dz.most_common(3))) def ic(s): n=len(s) return sum(v*(v-1) for v in Counter(s).values())/(n*(n-1)) if n>1 else 0 print('3. IC:',' | '.join('m=%d -> %.4f'%(m,sum(ic(c[i::m]) for i in range(m))/m) for m in (6,12,15))) m=12 def shift(s): n=len(s); t=Counter(s); e=[max(f*n/sum(F),0.5) for f in F] return min(range(26), key=lambda k: sum((t.get(A[(A.index(x)+k)%26],0)-p)**2/p for x,p in zip(A,e))) k=''.join(A[shift(c[i::m])] for i in range(m)) print('4. klucz odczytany:',k) print('5. tekst:',''.join(A[(A.index(x)-A.index(k[i%m]))%26] for i,x in enumerate(c))[:60])" 1. powtorzonych trigramow: 80 2. najczestsze odleglosci: 240 (88x) 96 (70x) 120 (50x) # 240=12*20, 120=12*10, 96=12*8 -> kandydat m=12 3. IC: m=6 -> 0.0516 | m=12 -> 0.0597 | m=15 -> 0.0471 # maksimum przy m=12 -> potwierdzone dlugosci klucza 4. klucz odczytany: TROJSZYKLUCZ 5. tekst: DOBRYSZYFRNIEJESTTYLKOKROKIEMWALGORYTMIEKAZDYUZYTKOWNIKPOWIN...
Studium przypadku poświęcone łamaniu szyfru Vigenère’a pokazuje, jak kompletna procedura składa się z etapów omawianych wcześniej na slajdach teoretycznych. Zastosowanie metody Kasiskiego do długiego szyfrogramu ujawnia powtórzenia fragmentów, na podstawie których wyznacza się kandydatów na długość klucza. Następny etap, weryfikacja wybranej długości indeksem zbieżności, pozwala odrzucić błędne wartości i zdyscyplinować cały wywód.
W trakcie pracy z tekstem liczącym blisko tysiąc znaków widać, że dopasowanie rozkładu liter poszczególnych kolumn daje wiarygodny obraz liter klucza. Przy wystarczającej ilości materiału rozkład liter w każdej kolumnie jest zbliżony do naturalnego, co znacznie ułatwia wyznaczenie przesunięcia. Taki przebieg działania potwierdza, że metody poznane wcześniej mają zastosowanie praktyczne również w analizie dłuższych przekazów.
Ważnym elementem studium jest zwrócenie uwagi na rolę narzędzi pomocniczych, takich jak krótki skrypt automatyzujący powtarzalne obliczenia. Jednocześnie uczymy się interpretować wyniki skryptu i sprawdzać ich sensowność na każdym etapie, zamiast przyjmować je bezrefleksyjnie. Takie podejście uczy równowagi między automatyzacją a weryfikacją, niezmiernie istotnej w pracy analityka bezpieczeństwa.
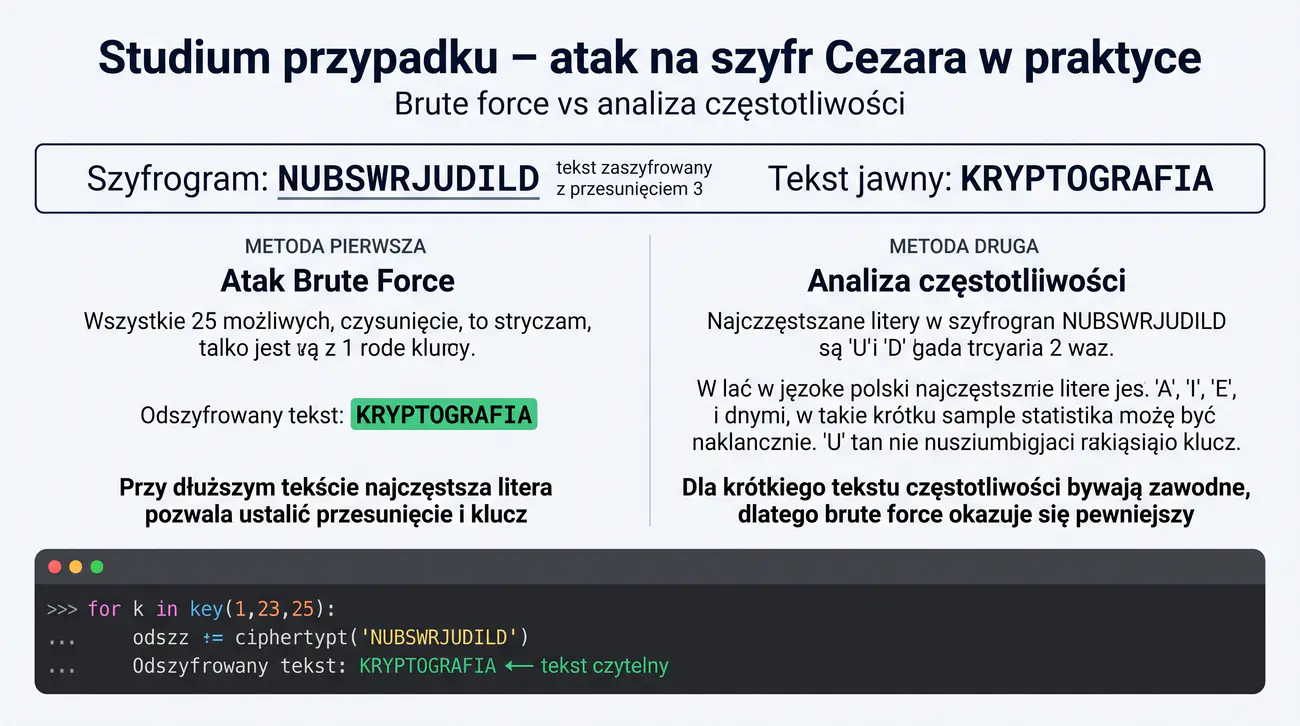
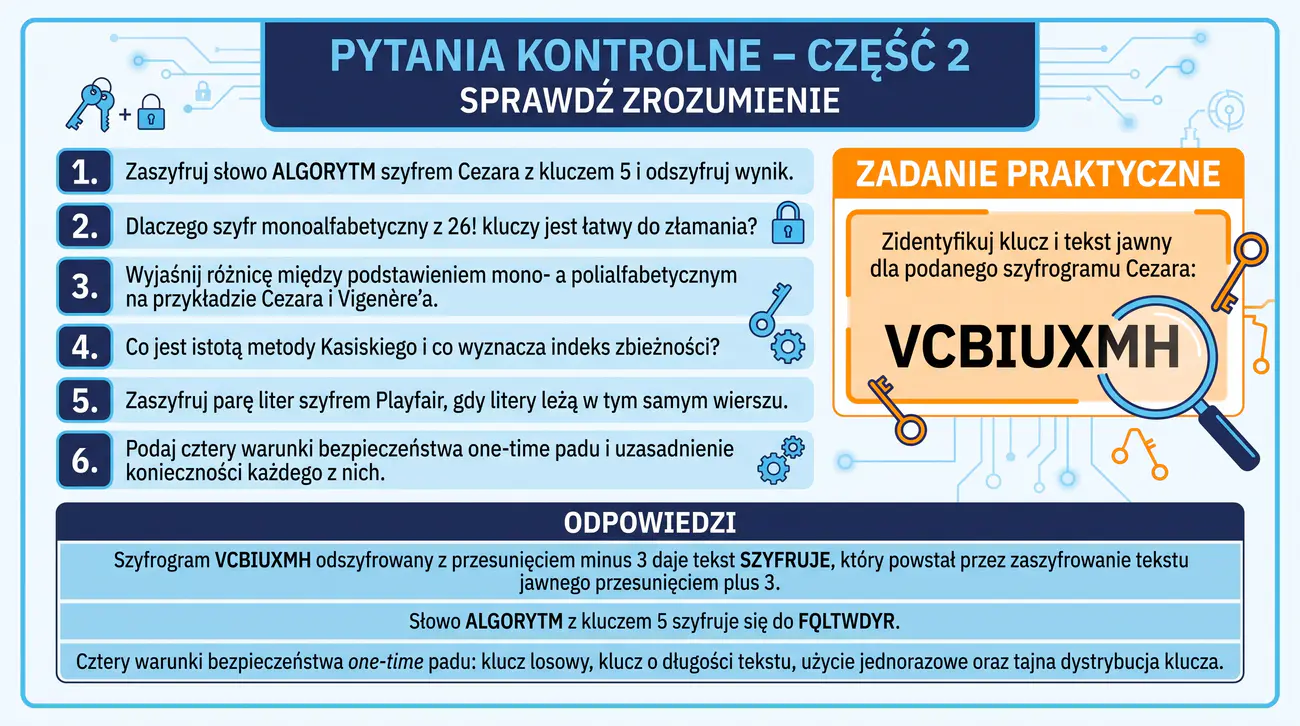
Szyfrogram: NUBSWRJUDILD (przesunięcie 3, tekst jawny KRYPTOGRAFIA).
Metoda 1 – brute force: przetestuj wszystkie 25 przesunięć; tylko jedno daje czytelny tekst.
Metoda 2 – częstotliwości: najczęstsze litery szyfrogramu to U i D (po 2 wystąpienia). W polskim najczęstsza to A/I/E..., ale w tak krótkiej próbce statystyka bywa myląca, a samo U nie wskazuje jednoznacznie klucza. Przy dłuższym tekście litera najczęstsza → przesunięcie → klucz. Dla krótkiego tekstu częstotliwości bywają zawodne – dlatego brute force bywa pewniejszy.
$ python3 -c " c='NUBSWRJUDILD'; A='ABCDEFGHIJKLMNOPQRSTUVWXYZ' for k in range(1,26): d=''.join(A[(A.index(x)-k)%26] for x in c) print(k,d) # k=3 -> KRYPTOGRAFIA (czytelny!)"
Studium przypadku dotyczące szyfru Cezara doskonale pokazuje, dlaczego przy krótkich wiadomościach metoda analizy częstotliwości bywa zawodna, a prostsze przeszukanie wszystkich kluczy okazuje się pewniejsze. W szyfrogramie o zaledwie kilkunastu literach rozkład wystąpień poszczególnych liter nie odzwierciedla w sposób wiarygodny struktury języka, ponieważ próbka jest zbyt mała. Dopiero przy dłuższych tekstach częstość występowania liter zaczyna przypominać rozkład teoretyczny.
W przedstawionym przykładzie jedną z najczęstszych liter szyfrogramu, obok D, jest U (obie występują dwukrotnie), co mogłoby sugerować, że odpowiadają one najczęstszym literom języka polskiego, jednak wnioskowanie takie nie prowadzi do jednoznacznego rozwiązania. Przegląd wszystkich przesunięć pozwala natomiast od razu zobaczyć, że tylko jedna z wartości tworzy czytelny tekst, co czyni tę metodę bezwzględnie skuteczną. Taki wynik uczy, że wybór strategii ataku powinien zależeć od długości materiału oraz charakteru dostępnych danych.
Porównanie obu metod w tym jednym przykładzie ma też wartość ogólną, ponieważ uwidacznia różnicę między atakiem wyczerpującym a atakiem statystycznym. Atak statystyczny opiera się na przewidywalnych prawidłowościach języka i sprawdza się przy dużych ilościach danych, natomiast przeszukanie wszystkich kluczy jest niezawodne, gdy liczba możliwości jest mała. Umiejętność wyboru właściwej metody w zależności od sytuacji jest jedną z najważniejszych kompetencji kryptoanalityka.
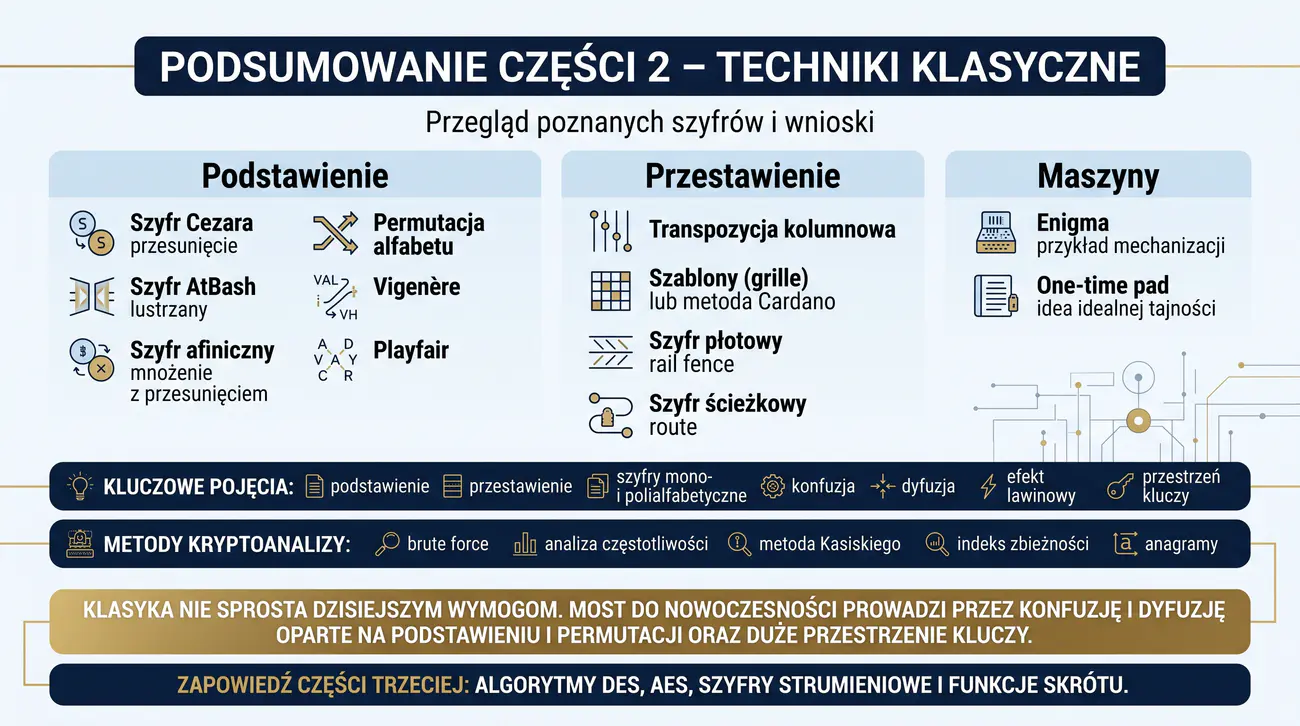
Podsumowanie części drugiej ma na celu uporządkowanie materiału i zwrócenie uwagi na logiczne powiązania pomiędzy poszczególnymi rodzinami szyfrów. Opanowanie nazw, mechanizmów działania i metod łamania każdej techniki pozwala zbudować spójną mapę wiedzy o klasycznych systemach szyfrowania. Kluczowym wnioskiem pozostaje spostrzeżenie, że bezpieczeństwo zależy nie tylko od złożoności mechanizmu, lecz przede wszystkim od właściwości kryptograficznych całości systemu.
Swoboda w posługiwaniu się terminami, takimi jak podstawienie, przestawienie, monoalfabetyczność czy polialfabetyczność, przekłada się wprost na zdolność samodzielnej analizy nowych, nieznanych konstrukcji. Znajomość przewodnich metod kryptoanalizy, od ataku wyczerpującego po analizę statystyczną, daje podstawę do oceny odporności systemów poznanych w dalszych częściach materiału. Umiejętność łączenia tych elementów w praktyczne scenariusze jest najcenniejszym rezultatem tej części.
Przejście od klasyki do nowoczesności nie nastręcza trudności, jeśli rozumie się, że współczesne algorytmy rozwijają te same idee w znacznie większej skali. Kolejna część, poświęcona szyfrom symetrycznym, stanowi naturalne przedłużenie poznanego materiału. Warto wykonać ćwiczenia podsumowujące i utrwalić wzorce rozumowania, które przydadzą się przy analizie bardziej zaawansowanych systemów.
Słownik pojęć zgromadzony na slajdzie służy jako szybka pomoc przy powtórkach i samodzielnej pracy nad zadaniami, umożliwiając precyzyjne odwoływanie się do terminologii. Zrozumienie każdej definicji wymaga jednak więcej niż zapamiętania słów, ponieważ pojęcia te tworzą sieć wzajemnych powiązań, które wyjaśniają strukturę całego działu. Warto czytać słownik zawsze w kontekście omawianych przykładów, a nie w izolacji.
Porównując definicje, dostrzega się między innymi różnicę między podstawieniem a przestawieniem oraz między systemami mono- i polialfabetycznymi, która wynika ze sposobu odwzorowania liter. Wiele terminów, takich jak analiza częstotliwości czy indeks zbieżności, opisuje jednocześnie narzędzia i techniki, które można stosować w praktyce. Taka dwoistość pojęć odzwierciedla ścisły związek między teorią a praktyką kryptoanalizy.
Układ haseł odpowiada kolejności omawianych slajdów, dzięki czemu słownik można wykorzystywać jako swego rodzaju spis kontrolny opanowanych zagadnień. Podczas powtórki warto dla każdego hasła umieć podać definicję, przykład oraz sposób zastosowania. Takie trójstopniowe opanowanie materiału przekłada się na trwałą wiedzę, przydatną także w późniejszych częściach materiału.
Pytania kontrolne zamieszczone na slajdzie odzwierciedlają poziomy trudności, z jakimi trzeba się zmierzyć po opanowaniu tej części materiału, oraz zakres umiejętności, które warto zdobyć. Część pytań wymaga bezpośredniego wykonania obliczeń, na przykład zaszyfrowania wyrazu szyfrem Cezara, co sprawdza biegłość w posługiwaniu się wzorami. Inne pytania bazują na umiejętności wyjaśnienia różnic między systemami czy uzasadnienia warunków bezpieczeństwa, co wymaga głębszego zrozumienia zagadnień.
Samodzielne rozwiązywanie zadań jest najlepszym sposobem weryfikacji przygotowania, a błędy popełnione w trakcie takich prób należy starannie analizować. Ważne jest przy tym stosowanie spójnych reguł, na przykład ustalonej konwencji numerowania liter i sposobu obchodzenia się z polskimi znakami. Odpowiedź do przykładowego zadania, zamieszczona w ramce, pozwala porównać własny tok rozumowania z wynikiem wzorcowym.
Ewentualne pytania i wątpliwości warto rozstrzygać od razu – z pomocą źródeł, dokumentacji albo konsultacji – a nie odkładać na koniec. Systematyczna powtórka z wykorzystaniem zadań praktycznych znacząco zwiększa pewność siebie i poprawia wyniki. Dobre przygotowanie do pytań kontrolnych jest jednocześnie przygotowaniem do zadań praktycznych opisanych w dalszej części prezentacji.
Zadania tej części łączą w sobie trzy aktywności: złamanie szyfrogramu, zaprogramowanie algorytmu oraz pracę z narzędziami graficznymi, dzięki czemu sprawdzają różnorodne kompetencje. Rozwiązanie zadania Vigenère’a wymaga zastosowania całej sekwencji metod, od wykrycia długości klucza po odtworzenie jego liter, co stanowi kompletne podsumowanie omawianych zagadnień. Wybór szyfrogramu o odpowiednio dużej długości jest istotny, ponieważ krótki tekst nie pozwoli na uzyskanie wiarygodnych statystyk.
Implementacja w języku Python powinna być poparta starannie przemyślaną strukturą, z wydzielonymi funkcjami szyfrowania, odszyfrowywania i wyznaczania klucza. W trakcie testów należy porównywać wyniki z ręcznie wykonanymi obliczeniami na wygenerowanych tekstach, aby wykryć błędy na wczesnym etapie. Przy pracy z narzędziami typu CrypTool warto zwrócić uwagę na konfigurację alfabetu i języka, które mają być zgodne z treścią zadania.
Raport powinien zawierać opis toku postępowania, użyte narzędzia oraz uzyskane wyniki wraz z komentarzem, zgodnie z kryteriami przedstawionymi w dalszej części prezentacji. Dokumentacja każdego etapu, nawet z pozoru błahego, znacząco ułatwia późniejsze przedstawienie rozwiązania i jego weryfikację. Taka praktyka przyzwyczaja do rzetelnej dokumentacji technicznej, niezbędnej w pracy zawodowej.
Literatura zgromadzona w tym zestawie obejmuje zarówno pozycje historyczne, jak i podręczniki techniczne, dzięki czemu można dobrać źródła do własnego stylu uczenia się. Książka Simona Singha przedstawia dzieje kryptografii w atrakcyjnej, narracyjnej formie, co pomaga zrozumieć kontekst poznawanych algorytmów i motywacje ich twórców. Podręczniki o charakterze akademickim dostarczają natomiast szczegółowych opisów i formalnych definicji, niezbędnych podczas opracowywania trudniejszych zagadnień.
Zasoby internetowe wymienione na slajdzie stanowią uzupełnienie literatury papierowej, umożliwiając interaktywne eksperymenty i szybkie sprawdzenie przykładów. Należy jednak pamiętać o weryfikowaniu informacji pochodzących z serwisów internetowych, gdyż nie wszystkie podają opisy z jednakową precyzją. Zbiory archiwalne i opracowania dotyczące Enigmy pozwalają z kolei poznać historyczny kontekst osiągnięć polskich kryptologów.
Podczas samodzielnej nauki warto łączyć czytanie wybranych fragmentów literatury z wykonywaniem ćwiczeń praktycznych, co utrwala wiedzę poprzez bezpośrednie zastosowanie. Prowadzenie notatek z lektury ułatwi późniejsze powtórki i pozwoli szybko odnaleźć potrzebne informacje. Dobrze prowadzona bibliografia pracy dyplomowej czy raportu technicznego jest przy tym umiejętnością, którą warto ćwiczyć od samego początku nauki.
Materiały przeznaczone do samodzielnej nauki stanowią dodatkowe wsparcie dla osób pragnących pogłębić zrozumienie zagadnień. Filmy i wykłady o charakterze popularnonaukowym pomagają oswoić się z pojęciami, zanim przejdziesz do samodzielnych ćwiczeń praktycznych. Z kolei zadania o charakterze konkursowym, zwłaszcza te z dziedziny tak zwanych platform treningowych typu capture the flag, dostarczają realistycznych przykładów łamania szyfrów klasycznych.
Interaktywne strony umożliwiają natychmiastowe sprawdzenie działania poszczególnych szyfrów na własnych tekstach, co ułatwia eksperymentowanie i wyrabianie intuicji. W trakcie pracy z takimi narzędziami warto celowo zaszyfrowywać własne zdania i próbować odszyfrować je różnymi metodami, aby zrozumieć wpływ parametrów na wynik. Uzupełnieniem tego treningu powinno być prowadzenie notatek, w których gromadzi się opisy wykonanych eksperymentów wraz z wnioskami.
Wskazówki dotyczące pracy praktycznej przypominają o konieczności sprawdzania czytelności tekstów, doboru odpowiedniej długości kluczy oraz weryfikacji liczby kolumn w przypadku transpozycji. Te pozornie drobne czynności chronią przed kosztownymi błędami w późniejszych, bardziej złożonych zadaniach. Właściwie zorganizowana samodzielna nauka pozwala przekształcić wiedzę teoretyczną ze slajdów w trwałe i użyteczne umiejętności.
Poniższa lista służy do sprawdzenia własnej pracy – każde zadanie można ocenić w skali 0–2 pkt (0: brak, 1: częściowo, 2: poprawnie).
| Zadanie | Na co zwrócić uwagę |
|---|---|
| Złamanie szyfrogramu Vigenère’a | poprawny klucz, jawnie opisany tok (Kasiski, IC, kolumny), czytelny tekst odszyfrowany |
| Kod Python (szyfrowanie i łamanie) | poprawne wyniki dla znanych przypadków, czytelność, nazewnictwo zmiennych, brak „magii” w kodzie |
| Praca w narzędziu (CrypTool) | zgodność konfiguracji alfabetu i języka z zadaniem, opis obserwacji |
| Notatka z Kasiskiego i IC | wzory, przykład liczbowy policzony ręcznie i potwierdzony kodem |
Najczęstsze błędy: brak jawnej konwencji dla liter polskich, testowanie na tekstach krótszych niż 300 znaków, brak weryfikacji odczytanego klucza na czytelnym tekście.
Forma zapisu: kod w pliku .py z komentarzami, raport w pliku .md lub .pdf, opis uruchomionych poleceń.
Lista kontrolna przedstawiona na slajdzie pozwala zorientować się, które elementy rozwiązania musi zawierać kompletna praca. Najwięcej uwagi wymaga złamanie szyfrogramu Vigenère’a oraz implementacja algorytmów, bo to one wymagają samodzielnej analizy. Przejrzystość kryteriów ułatwia planowanie pracy i koncentrację na aktywnościach o największym znaczeniu.
W opisach zadań zwraca się uwagę nie tylko na poprawność wyniku, lecz także na jakość dokumentacji przebiegu pracy, w tym opis zastosowanych metod i komentarze do uzyskanych rezultatów. Taki model odpowiada rzeczywistym oczekiwaniom pracodawców, którzy cenią inżynierów potrafiących wyjaśnić i udokumentować swoje rozwiązania. Dobrze przygotowany raport, zawierający kolejne etapy analizy, świadczy o systematyczności i rzetelności autora.
Forma zapisu pracy – pliki kodu, raport, zrzuty ekranu – wymaga odpowiedniego planowania czasu i porządkowania materiałów. Rozpoczęcie pracy od razu, zamiast odkładania jej na koniec, minimalizuje ryzyko braków. Takie zarządzanie własną pracą pozostaje przydatne w życiu zawodowym.
Materiał warto kontynuować samodzielnie: powtórzyć obliczenia z tabel, wykonać studium przypadku ze slajdu 46 na własnym tekście i sprawdzić każdy wynik kodem.
Uwagi końcowe części drugiej zamykają materiał poświęcony technikom klasycznym, podsumowując kompetencje, które warto już mieć opanowane. Umiejętność szyfrowania i odszyfrowywania szyfrów Cezara, Vigenère’a, Playfair oraz transpozycji, zarówno ręcznie, jak i programistycznie, stanowi praktyczny fundament dalszej nauki. Rozumienie ograniczeń klasyki, takich jak podatność na analizę statystyczną czy małe przestrzenie kluczy, pozwala krytycznie oceniać każdy nowy system.
Zdobyte narzędzia, w tym skrypty w języku Python oraz aplikacje typu CrypTool, warto wykorzystywać także poza ćwiczeniami, podczas samodzielnych eksperymentów. Świadome korzystanie z narzędzi automatycznych, z jednoczesną weryfikacją wyników, przypomina standardy pracy w ramach rzeczywistych zespołów bezpieczeństwa. Takie podejście uczy nie tylko liczyć, lecz także rozumieć, dlaczego dany wynik jest poprawny.
Część trzecia wskazuje naturalny kierunek dalszej nauki, który prowadzi od klasyki do współczesnych algorytmów symetrycznych. Opanowanie pojęć konfuzji, dyfuzji i przestrzeni kluczy – które stanowią most łączący oba działy wiedzy – ułatwia przejście do algorytmów blokowych i strumieniowych. Praca samodzielna i weryfikowanie każdej hipotezy kodem pozostają najlepszą drogą do pełnego opanowania materiału.