Kryptologia i bezpieczna wymiana informacji
Część 4 - Kryptografia asymetryczna: RSA, ECC, Diffie-Hellman i podpisy cyfrowe
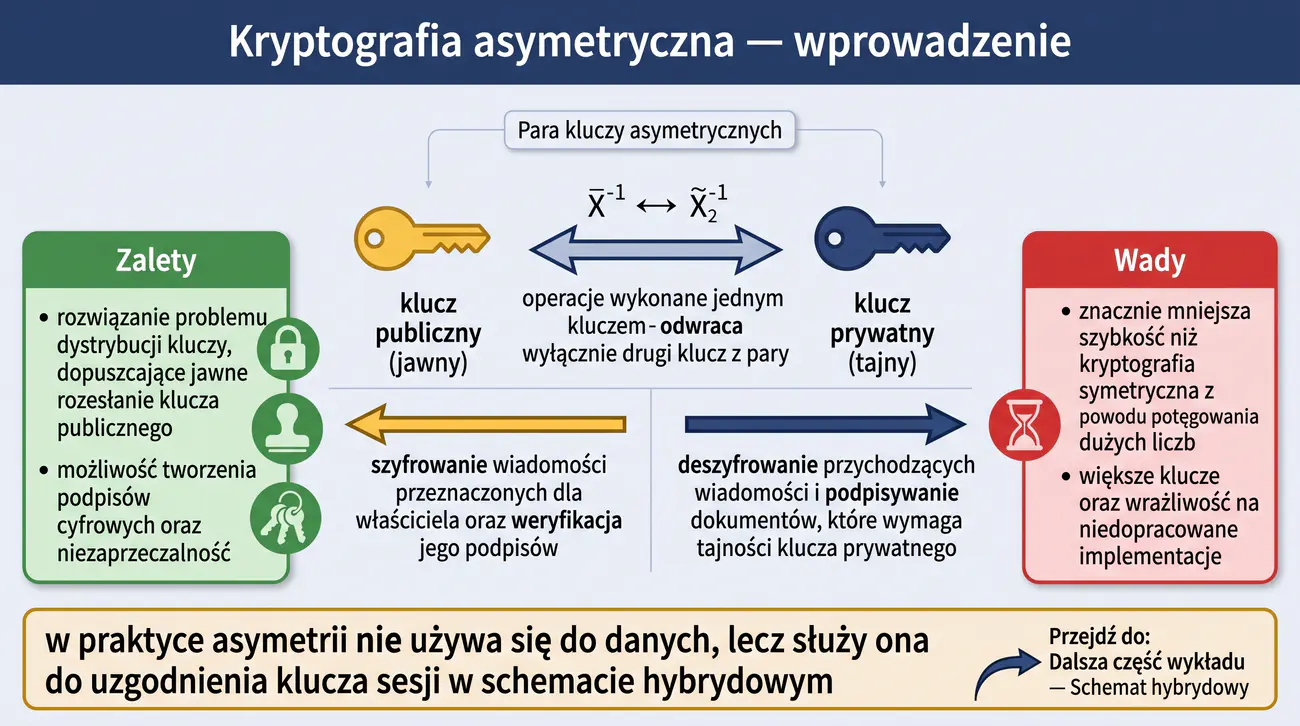
Kryptografia asymetryczna zmienia paradygmat ochrony wiadomości, bo po raz pierwszy strony nadawcy i odbiorcy nie muszą wcześniej ustalać wspólnej tajemnicy. Jej istota sprowadza się do pary kluczy powiązanych matematycznie w taki sposób, że operacje wykonywane jednym z nich odwraca wyłącznie drugi. Dzięki temu klucz publiczny można jawnie publikować, zachowując pełną kontrolę nad operacjami wymagającymi klucza prywatnego.
Ta część opracowania prowadzi od podstaw matematycznych, przez konkretne algorytmy, aż po praktyczne mechanizmy podpisów cyfrowych i wymiany kluczy. Kolejność tematów nie jest przypadkowa, ponieważ zrozumienie trudnych problemów obliczeniowych ułatwia późniejszą analizę bezpieczeństwa RSA, krzywych eliptycznych i protokołów uzgadniania sekretu. Poznaje się przy tym nie tylko prawidłowe użycie, lecz także przyczyny i skutki błędów implementacyjnych, które w praktyce decydują o rzeczywistej skuteczności ochrony.
Materiał przygotowano z myślą o osobach zainteresowanych bezpieczeństwem IT, dlatego opracowanie łączy teorię z konkretnymi przykładami uruchamianymi w Pythonie i w narzędziu OpenSSL. Omawiane zagadnienia wprost odnoszą się do efektów uczenia wymienionych w programie, co pozwala świadomie przygotowywać się do kolokwiów i zadań praktycznych. Wiedza zdobyta w tej części stanowi również fundament pod kolejne tematy dotyczące infrastruktury klucza publicznego i bezpiecznych protokołów sieciowych.
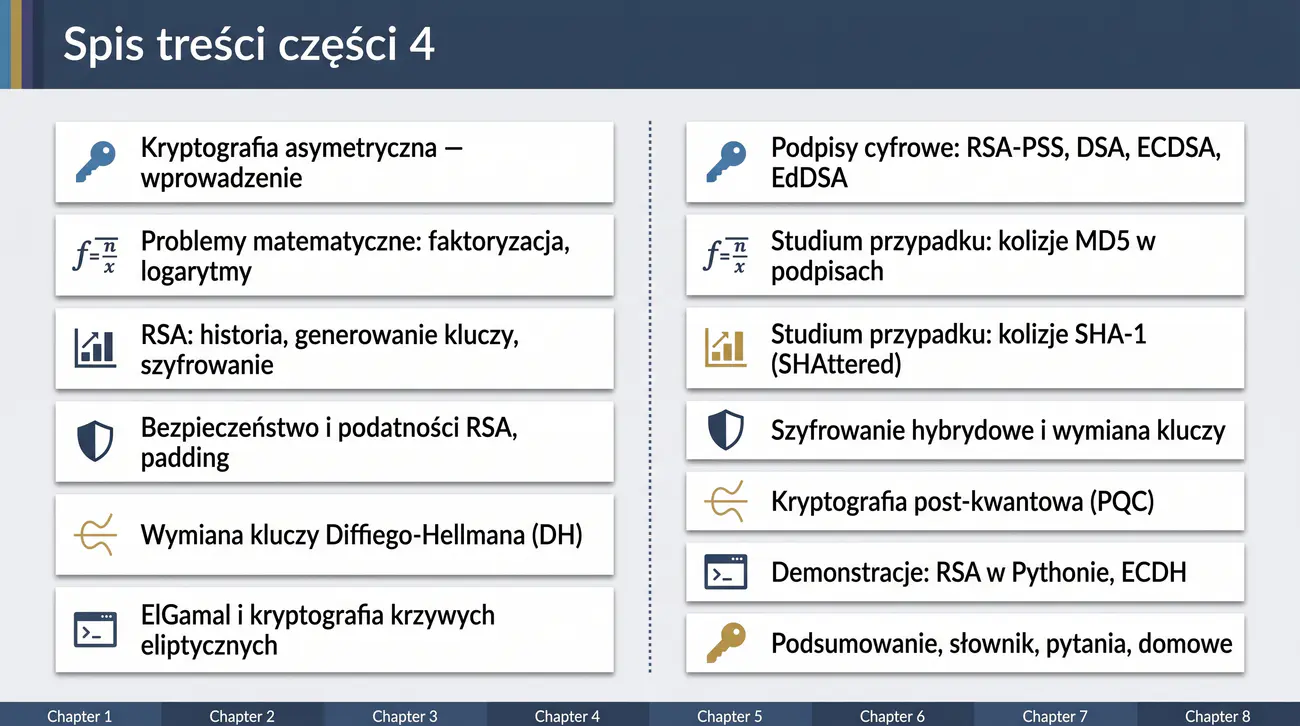
Układ spisu treści odzwierciedla logiczny tok wykładu, w którym najpierw pojawiają się problemy matematyczne i historia, a dopiero później szczegółowe algorytmy i przypadki ich nieprawidłowego użycia. Dzięki takiemu uporządkowaniu zagadnienia powracają w kolejnych blokach, co ułatwia utrwalenie i pozwala łączyć nowe informacje z wcześniejszą wiedzą. Świadome śledzenie tej struktury pomaga systematycznie porządkować wiedzę.
Bloki poświęcone podpisom cyfrowym oraz studium przypadków kolizji funkcji skrótu pokazują, że bezpieczeństwo systemu zależy nie tylko od samego algorytmu, ale także od sposobu jego użycia i jakości zastosowanych funkcji pomocniczych. Przykłady katastrof, takich jak kolizje MD5 czy ponowne użycie nonce, dobrano tak, aby uczulać na realne przyczyny kompromitacji. Te przypadki stanowią jednocześnie punkt wyjścia do dyskusji o dobrych praktykach wdrożeniowych.
Końcowe fragmenty materiału, obejmujące demonstracje w Pythonie, podsumowanie i pytania kontrolne, pełnią rolę metodyczną i przygotowują do pracy samodzielnej. Warto wracać do spisu także po zakończeniu wykładu, aby dostrzec wzajemne powiązania między omawianymi tematami. Takie holistyczne spojrzenie bywa pomocne przy rozwiązywaniu zadań projektowych wymagających łączenia wiedzy z różnych części kursu.
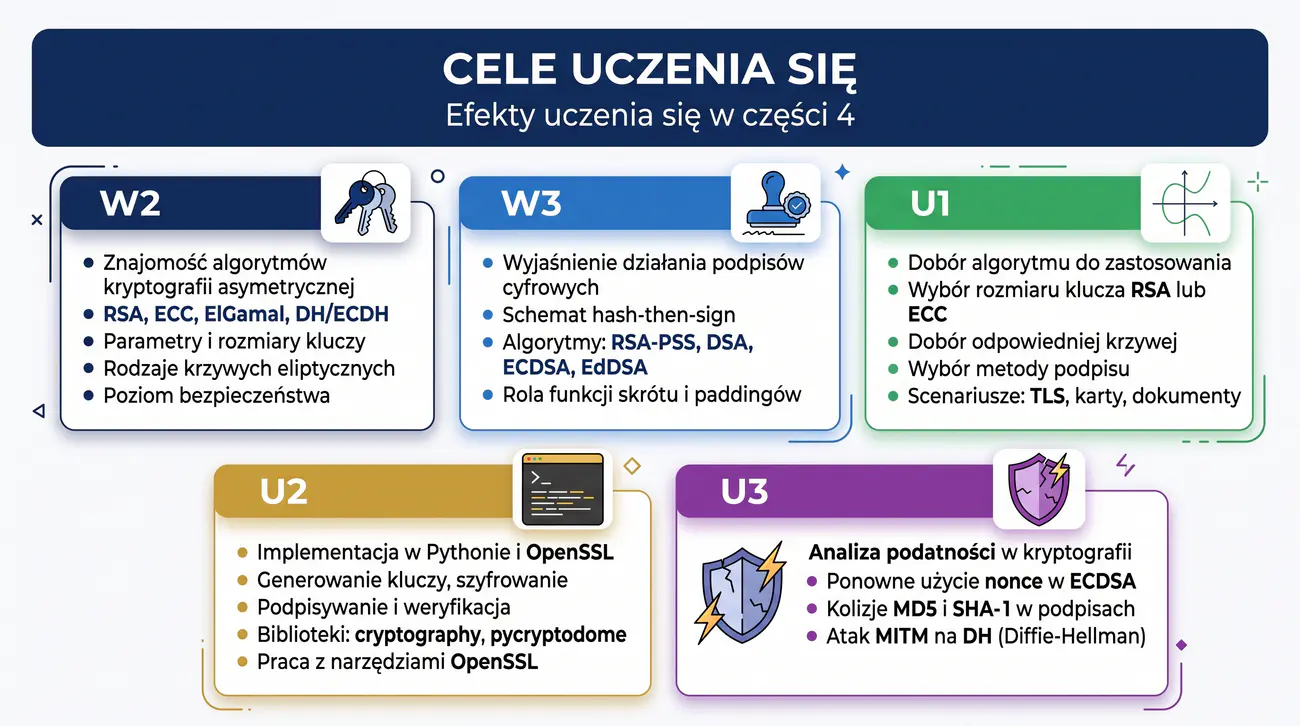
Efekty uczenia się sformułowano w taki sposób, aby pokrywały cały cykl pracy inżynierskiej, od znajomości algorytmów, przez umiejętność ich doboru, aż po praktyczną implementację i ocenę podatności. Pierwsza grupa zagadnień dotyczy wiedzy o algorytmach kryptografii asymetrycznej oraz o zasadach działania podpisów cyfrowych. Kolejne efekty z grupy U przenoszą nacisk na kompetencje praktyczne, sprawdzane między innymi na zajęciach laboratoryjnych.
Umiejętność doboru właściwego algorytmu i parametrów wymaga rozumienia relacji między rozmiarem klucza, poziomem bezpieczeństwa i kosztem obliczeniowym, dlatego w materiałach pojawiają się zestawienia porównawcze rozmiarów kluczy. Implementowanie mechanizmów w Pythonie i OpenSSL pozwala natomiast oswoić się z narzędziami spotykanymi w codziennej pracy administratora i programisty. Te kompetencje są dziś poszukiwane na rynku pracy, zwłaszcza w zespołach zajmujących się bezpieczeństwem systemów.
Analiza podatności, wymieniona jako ostatni efekt, uczy krytycznego myślenia i przewidywania skutków decyzji projektowych. Osoba, która potrafi wyjaśnić, dlaczego dana konfiguracja jest niebezpieczna, rzadziej popełni ten sam błąd w przyszłości. Systematyczne dążenie do osiągnięcia wszystkich wymienionych efektów pozwala ugruntować zdobytą wiedzę.
Model dwóch kluczy opiera się na odmiennych rolach materiału publicznego i tajnego, co rozwiązuje praktyczny problem dystrybucji kluczy, który wcześniej zmuszał strony do osobistego spotkania lub korzystania z zaufanego kuriera. Klucz publiczny może być rozprowadzany bez obaw, ponieważ sam w sobie nie umożliwia odczytywania wiadomości ani fałszowania podpisów właściciela. Wrażliwym elementem pozostaje natomiast klucz prywatny, którego przejęcie przez napastnika oznacza praktycznie całkowitą kompromitację ochrony.
Warto od początku zwracać uwagę, że asymetria nie służy w praktyce do szyfrowania dużych strumieni danych, a jedynie do ochrony kluczy sesyjnych i uwierzytelniania stron. Potęgowanie dużych liczb jest bowiem o kilka rzędów wielkości wolniejsze od operacji szyfrów blokowych, co wyklucza bezpośrednie szyfrowanie obszernych plików. Dlatego w protokołach takich jak TLS najpierw uzgadnia się klucz symetryczny, a właściwe dane szyfruje już algorytmem z grupy AES.
Kolejnym istotnym czynnikiem jest wrażliwość na błędy implementacyjne, które potrafią obalić nawet matematycznie poprawną konstrukcję. Szyfrowanie bez odpowiedniego wypełnienia, przewidywalne generatory liczb losowych czy nieprawidłowe wykorzystanie danych do podpisu to przykłady typowych słabości systemów opartych na asymetrii. Te zagadnienia wracają w dalszej części wykładu przy omawianiu konkretnych ataków i zaleceń dotyczących bezpiecznych bibliotek.
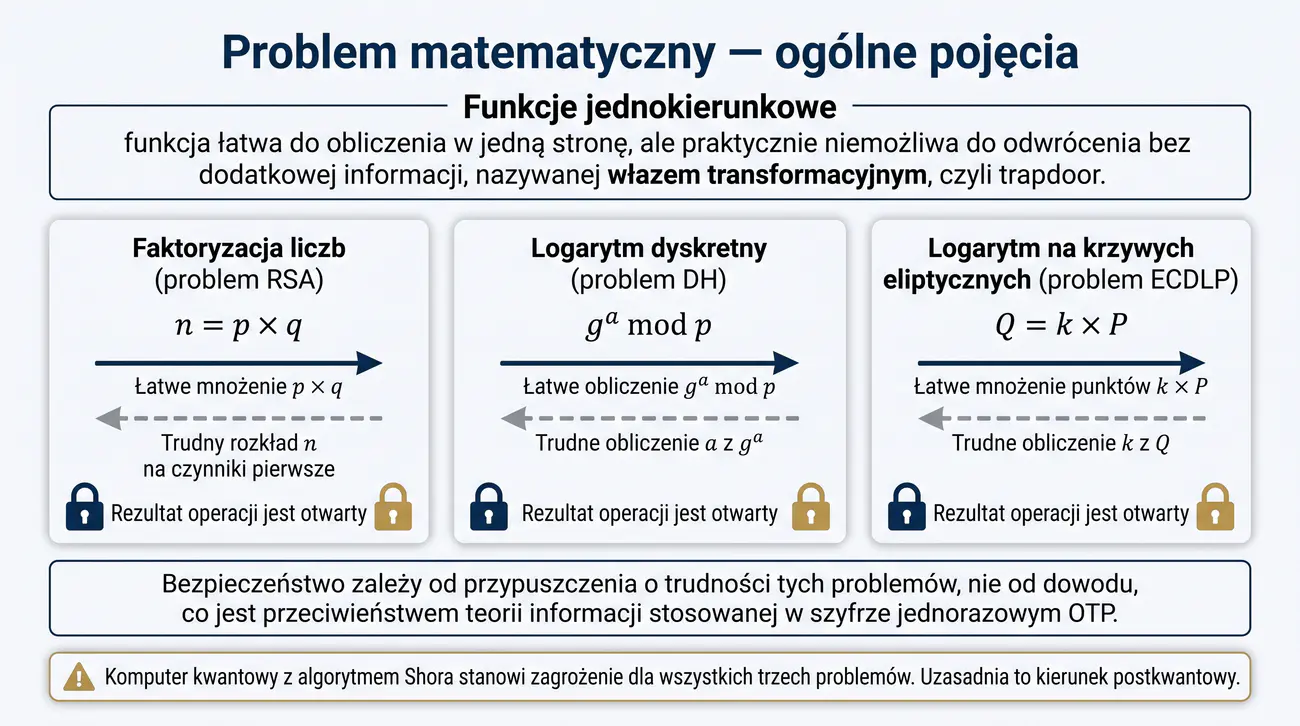
Funkcje jednokierunkowe leżą u podstaw wszystkich współczesnych systemów klucza publicznego, ponieważ gwarantują, że bez znajomości dodatkowej informacji nie da się w praktyce odwrócić wykonanego obliczenia. W kryptografii asymetrycznej używa się zatem problemów, których poprawność uznawana jest za możliwą do sprawdzenia, a rozwiązanie za praktycznie niewykonalne. Mówi się przy tym o przypuszczeniach dotyczących złożoności obliczeniowej, a nie o dowodach matematycznych, co odróżnia te konstrukcje od szyfru o idealnej tajności.
Właśnie to bezpieczeństwo oparte na przypuszczeniach stanowi najważniejszą różnicę względem jednorazowej podkładki, której niezniszczalność wynika z teorii informacji. Jeśli wykonanie danego problemu okaże się kiedyś łatwiejsze, wszystkie systemy na nim oparte przestaną być bezpieczne, dlatego środowisko kryptograficzne nieustannie monitoruje postęp w tej dziedzinie. Warto zrozumieć, że stosowane nazwy, takie jak problem faktoryzacji czy logarytmu dyskretnego, opisują hipotezy, których ważność jest okresowo weryfikowana.
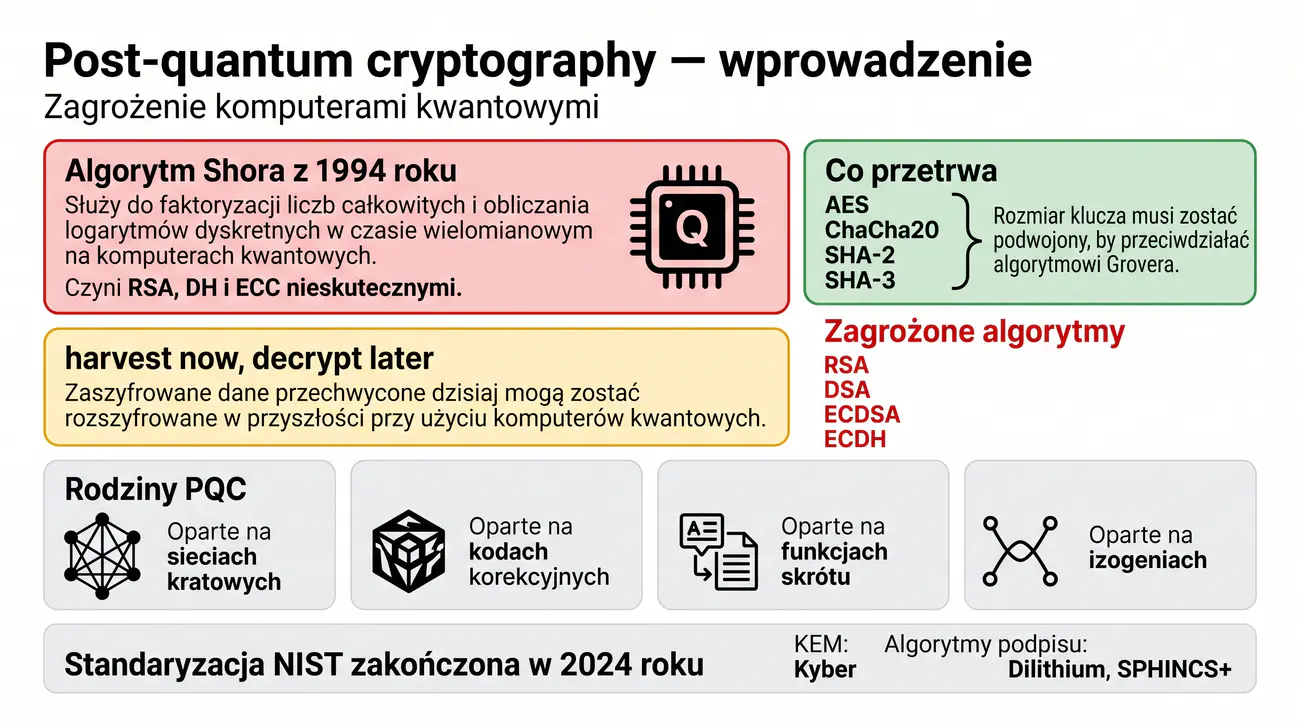
Zagrożenie komputerami kwantowymi uwydatnia jeszcze jedną cechę tych problemów, ponieważ algorytm Shora potrafi rozwiązać je w czasie wielomianowym. Stąd intensywne prace nad kryptografią odporną na ataki kwantowe i równoczesne przygotowywanie standardów zastępczych. Znajomość tego kontekstu pomaga zrozumieć, dlaczego obecnie zachęca się do planowania migracji już dziś, a nie dopiero po pojawieniu się dużych komputerów kwantowych.
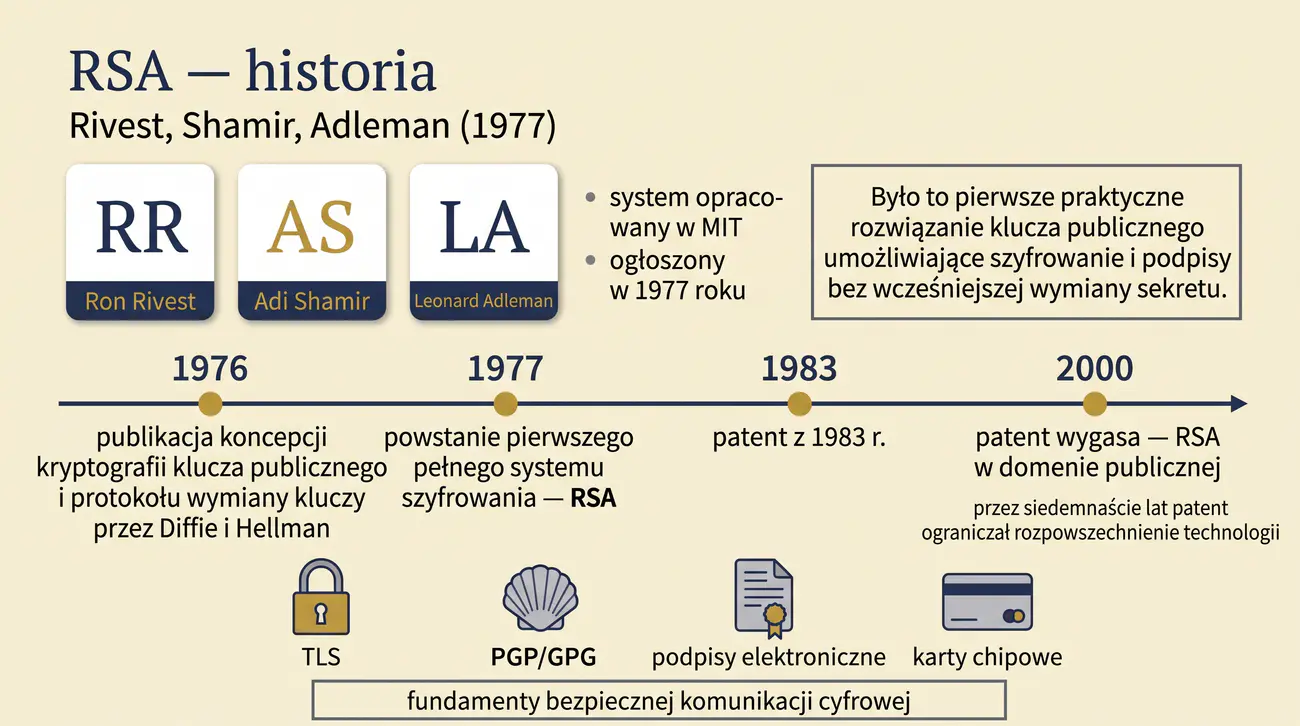
Historia RSA pokazuje, jak teoretyczne rozważania nad możliwością zbudowania szyfru z dwoma kluczami przerodziły się w praktyczny system o niezwykle szerokim zastosowaniu. Zanim powstał RSA, Diffie i Hellman opisali samą ideę kryptografii klucza publicznego i protokół wymiany kluczy, nie tworząc jednak pełnego mechanizmu szyfrowania. Dopiero pomysł oparty na trudności faktoryzacji liczb złożonych dał praktyczną realizację tej koncepcji.
Obowiązywanie patentu przez siedemnaście lat, od 1983 do 2000 roku, wyhamowało komercyjne wdrożenia i przyczyniło się do rozwoju alternatywnych standardów w innych regionach świata. Po wygaśnięciu ochrony RSA weszło do powszechnego użytku, a jego implementacje pojawiły się w niemal wszystkich systemach teleinformatycznych. Ta historia ilustruje zarazem, jak duży wpływ na rozwój technologii mogą mieć czynniki pozatechniczne, takie jak prawo i ekonomia.
Od strony dydaktycznej ważne jest, aby dostrzec ciągłość myśli kryptograficznej, od idei klucza publicznego, przez konstrukcję RSA, aż po współczesne systemy hybrydowe. Zrozumienie przyczyn, dla których pewne pomysły powstały i upowszechniły się, ułatwia ocenę nowszych rozwiązań. Znajomość historii pozwala również unikać błędów popełnianych we wczesnych latach stosowania tych technologii.
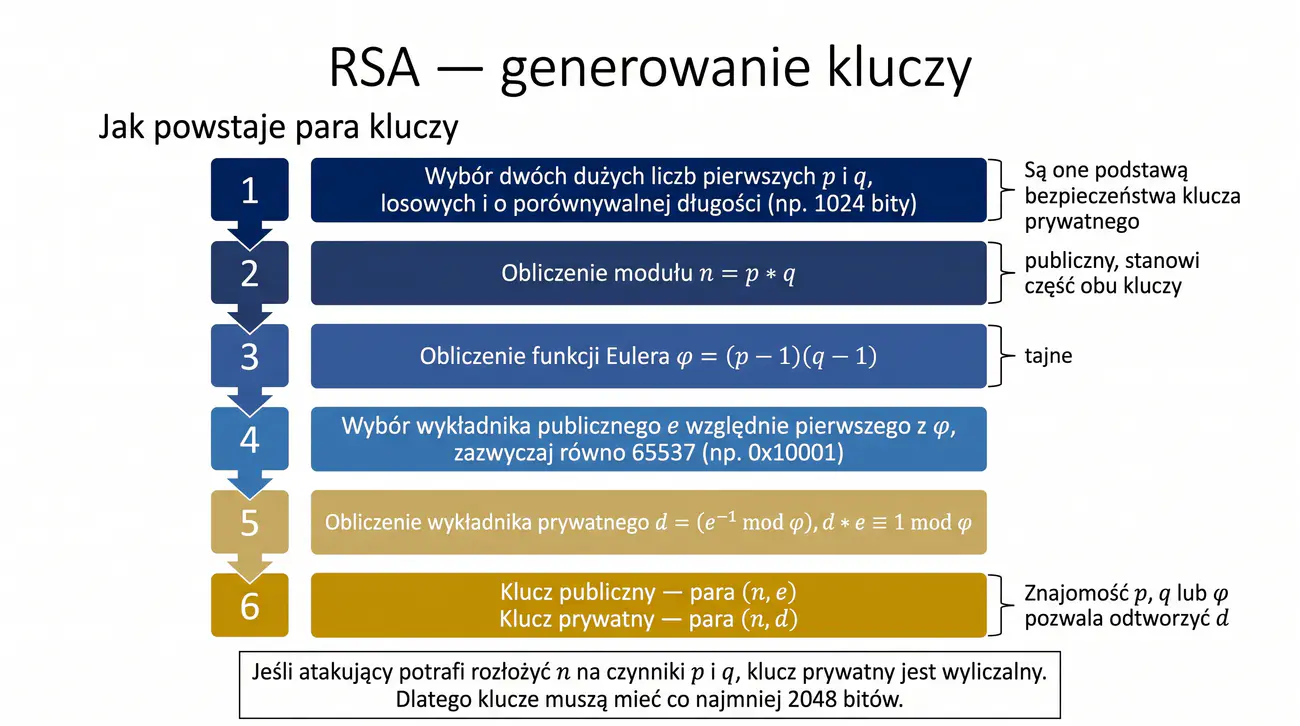
Generowanie pary kluczy RSA rozpoczyna się od wyboru dwóch losowych liczb pierwszych o porównywalnej długości, co jest zadaniem bardziej złożonym, niż mogłoby się wydawać, ponieważ wymaga niezawodnych testów pierwszości. W praktyce stosuje się probabilistyczne testy typu Millera-Rabina, które odrzucają liczby złożone z bardzo dużym prawdopodobieństwem. Kluczowe jest przy tym, aby liczby pochodziły z bezpiecznego źródła losowości, gdyż ich przewidywalność natychmiast niweczy ochronę całego systemu.
Wyborowi publicznego wykładnika e nie towarzyszą zwykle żadne trudności, dlatego standardowo przyjmuje się 65537, liczbę o korzystnych właściwościach obliczeniowych i dużej odporności na wybrane rodzaje ataków. Wykładnik prywatny wylicza się następnie jako odwrotność modularną e względem funkcji Eulera, a wynikową parę zapisuje się w odpowiednio chronionym formacie. W realnych systemach klucz prywatny przechowywany jest w formacie standardowym, często z dodatkową ochroną hasłem lub w sprzętowych modułach bezpieczeństwa.
Początkujący studenci bywają zaskoczeni, że sam proces generowania dużych kluczy może trwać nawet kilka sekund, co wynika z kosztownych testów pierwszości. Jest to jednak działanie wykonywane jednorazowo, dlatego nie stanowi praktycznego ograniczenia w codziennym użytkowaniu. Warto przy tym pamiętać, że jakość generatora losowego użytego podczas tworzenia klucza może w przyszłości przesądzić o bezpieczeństwie całej komunikacji.
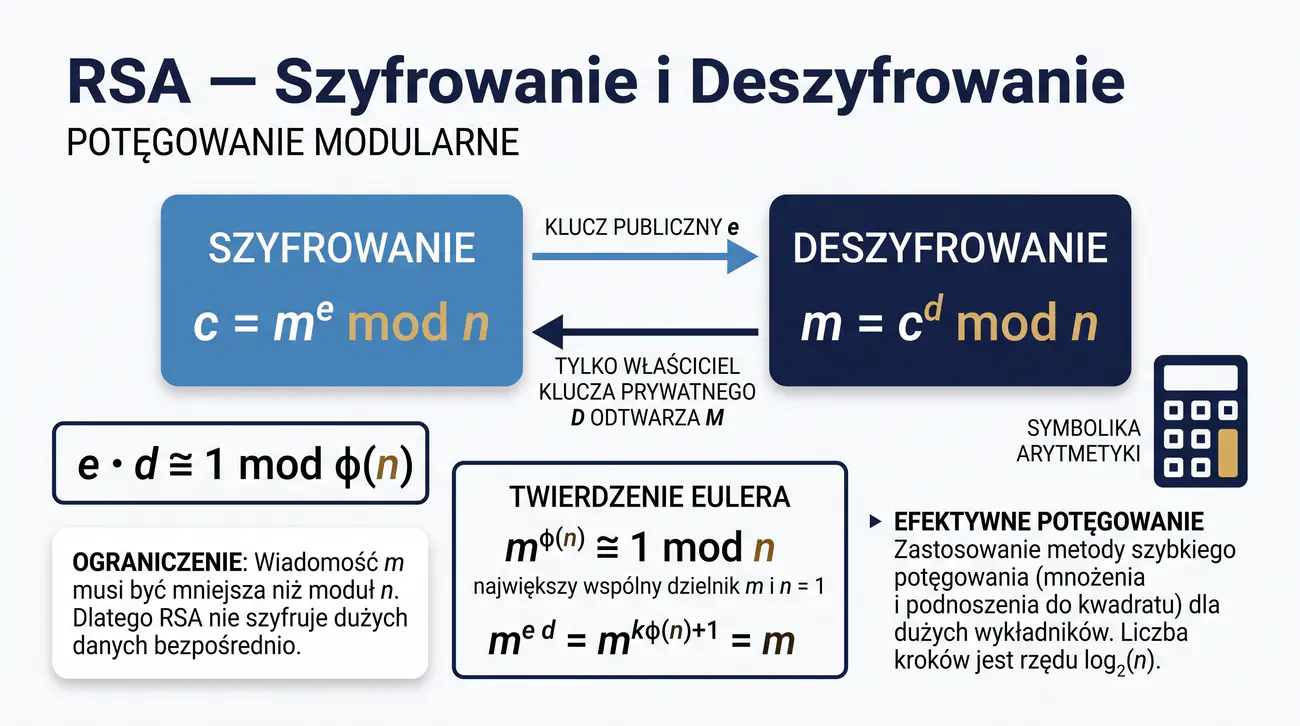
Potęgowanie modularne, opisane wzorem: c równa się m podniesione do potęgi e modulo n, wykonuje się znacznie sprawniej niż zwykłe wielokrotne mnożenie, dzięki algorytmowi kwadratowania i mnożenia. Metoda ta wymaga liczby kroków proporcjonalnej do długości wykładnika, a nie do jego wartości, co czyni obliczenia wykonalnymi nawet dla bardzo dużych liczb. Dzięki temu szyfrowanie i deszyfrowanie RSA pozostają praktyczne w systemach działających w czasie rzeczywistym.
Warunek mniejszości liczby wiadomości względem modułu wymusza podział danych na niewielkie porcje lub użycie takich mechanizmów jak wypełnienie, dlatego w praktyce RSA szyfruje wyłącznie klucze sesyjne i podobne krótkie wartości. Poprawność całego schematu wynika z twierdzenia Eulera i zależności między wykładnikami, co bywa dogodnie demonstrowane na małych liczbach.
W realnych implementacjach często stosuje się dodatkowe optymalizacje, takie jak szybsze wykonywanie deszyfrowania opartego na dwóch liczbach pierwszych, co skraca czas obliczeń nawet kilkukrotnie. Takie przyspieszenia nie zmieniają jednak reguł bezpieczeństwa i wymagają szczególnej ostrożności w zapobieganiu tzw. atakom z wykorzystaniem kanałów bocznych. Dlatego biblioteki kryptograficzne dokładają starań, aby operacje wrażliwe na takie ataki działały w czasie mniej zależnym od danych.
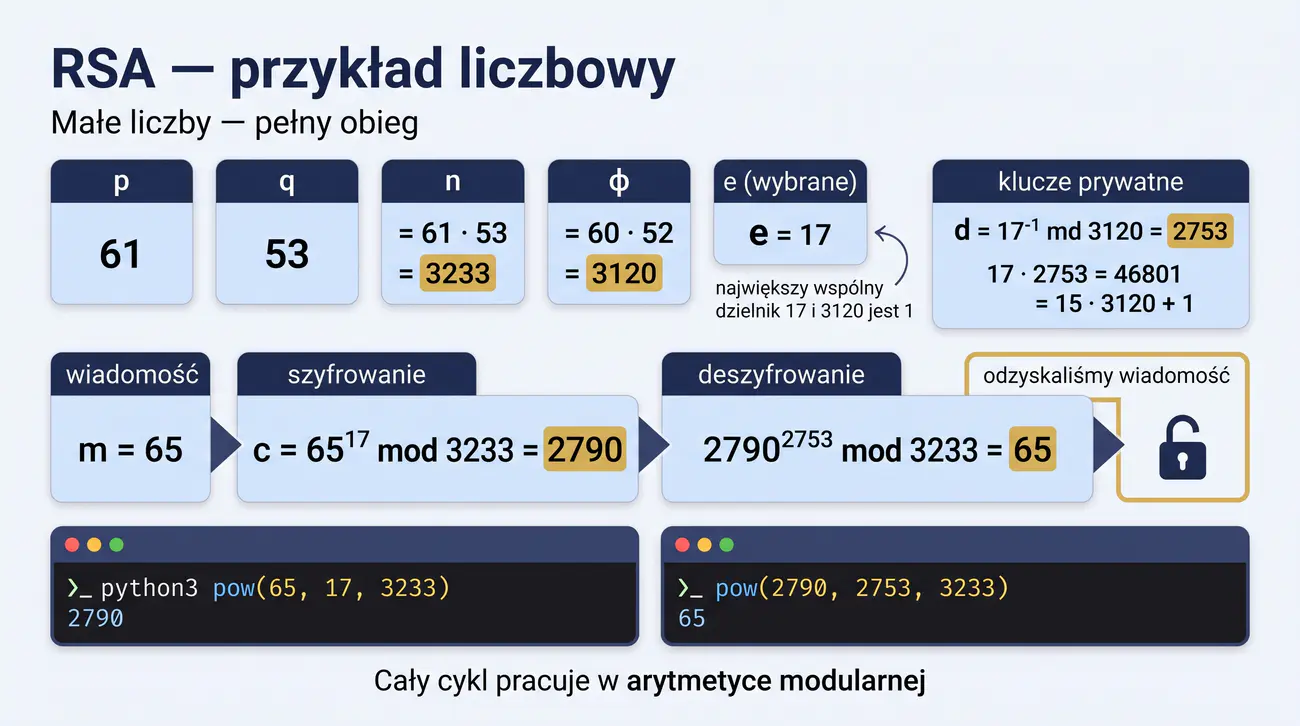
Przykład z małymi liczbami pierwszymi pozwala prześledzić cały cykl działania RSA w sposób w pełni czytelny, co w przypadku rzeczywistych modułów o tysiącach bitów nie byłoby możliwe. Każdy krok, od wyznaczenia modułu i funkcji Eulera, przez dobór wykładnika, aż po szyfrowanie i deszyfrowanie, można łatwo zweryfikować za pomocą prostych narzędzi. Takie ćwiczenia budują intuicję niezbędną do późniejszej analizy poprawności bardziej złożonych schematów.
Należy przy tym pamiętać, że pokazane rozmiary liczb żadnego praktycznego bezpieczeństwa nie zapewniają, a ich jedyną zaletą jest transparentność obliczeń. W prawdziwych systemach moduł ma co najmniej 2048 bitów, a dobór wykładników uwzględnia dużo szersze spektrum wymagań. Porównanie obu skal pozwala zrozumieć, dlaczego przyrost rozmiaru klucza oznacza drastyczny wzrost kosztu ataku.
Arytmetyka modularna, w której cały czas operuje się resztami z dzielenia, wraca w kolejnych tematach dotyczących wymiany kluczy i krzywych eliptycznych, dlatego warto ją opanować na prostych przykładach. Jednocześnie wykonanie tych obliczeń w interpreterze to dobry sposób na samodzielne sprawdzenie poprawności zapisu matematycznego. Takie drobne eksperymenty budują wiarę we własne możliwości i pomagają w rozwiązywaniu zadań na zajęciach.
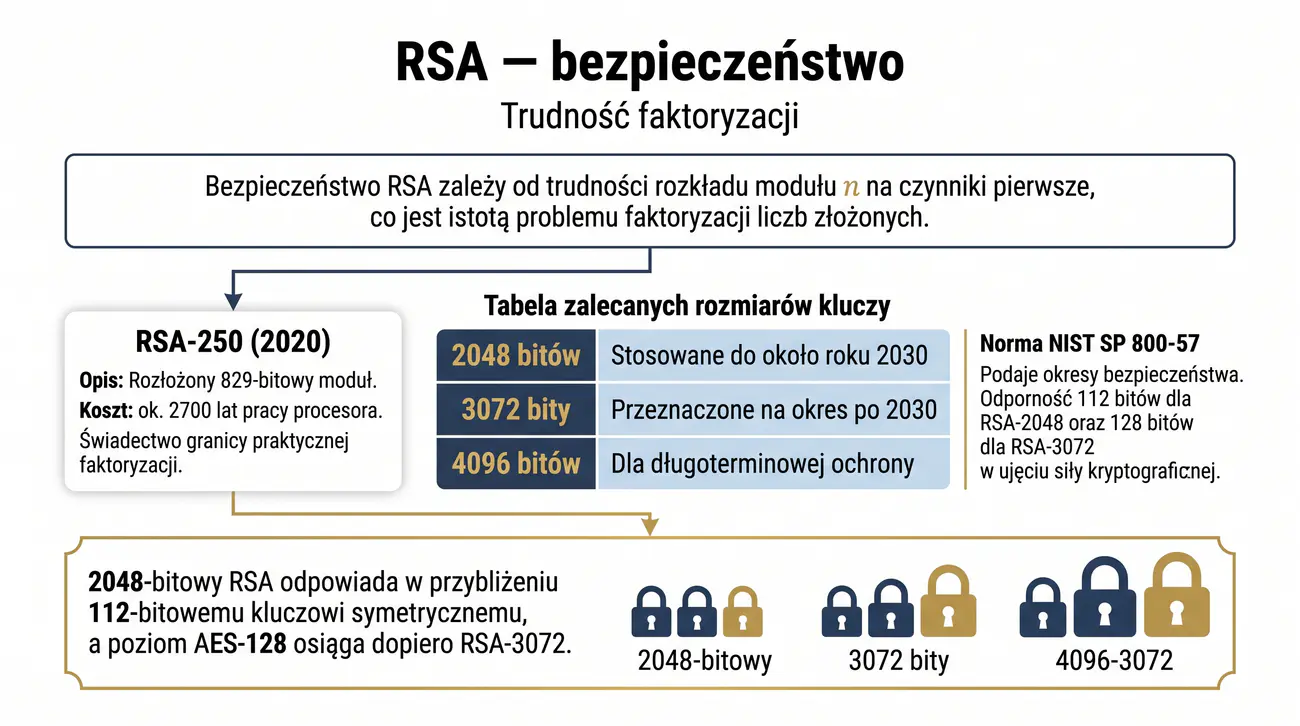
Bezpieczeństwo RSA sprowadza się w gruncie rzeczy do trudności rozkładu modułu na czynniki pierwsze, a wszelkie postępy w tej dziedzinie znajdują natychmiastowe przełożenie na wymagane rozmiary kluczy. Współczesne ataki korzystają z zaawansowanych metod algebraicznych i dużych klastrów obliczeniowych, a koszt ich prowadzenia systematycznie maleje wraz z postępem techniki. Dlatego rekordy faktoryzacji, na przykład rozłożenie modułu o 250 cyfrach w 2020 roku, są śledzone przez środowisko jako ważne sygnały rozwoju sytuacji.
Zalecenia dotyczące minimalnych rozmiarów kluczy pochodzą od instytucji normalizacyjnych i uwzględniają nie tylko aktualne możliwości wykonania ataków, lecz także planowaną długość ochrony danych. Standardy bezpieczeństwa określają przy tym tzw. poziom odporności, czyli porównawczą miarę siły klucza względem szyfrów symetrycznych. Dzięki temu można łatwo ocenić, że klucz 2048-bitowy zapewnia podobną ochronę jak algorytm o kluczu 112-bitowym, a pełny poziom 128-bitowy osiąga się dopiero przy modułach 3072-bitowych.
Studenci powinni pamiętać, że sam rozmiar klucza nie gwarantuje bezpieczeństwa, jeśli nie są spełnione pozostałe warunki, takie jak właściwe losowanie, odpowiednie wypełnienie i bezpieczne przechowywanie klucza. Tylko łączne spełnienie wszystkich tych wymagań pozwala mówić o bezpiecznej konfiguracji RSA.
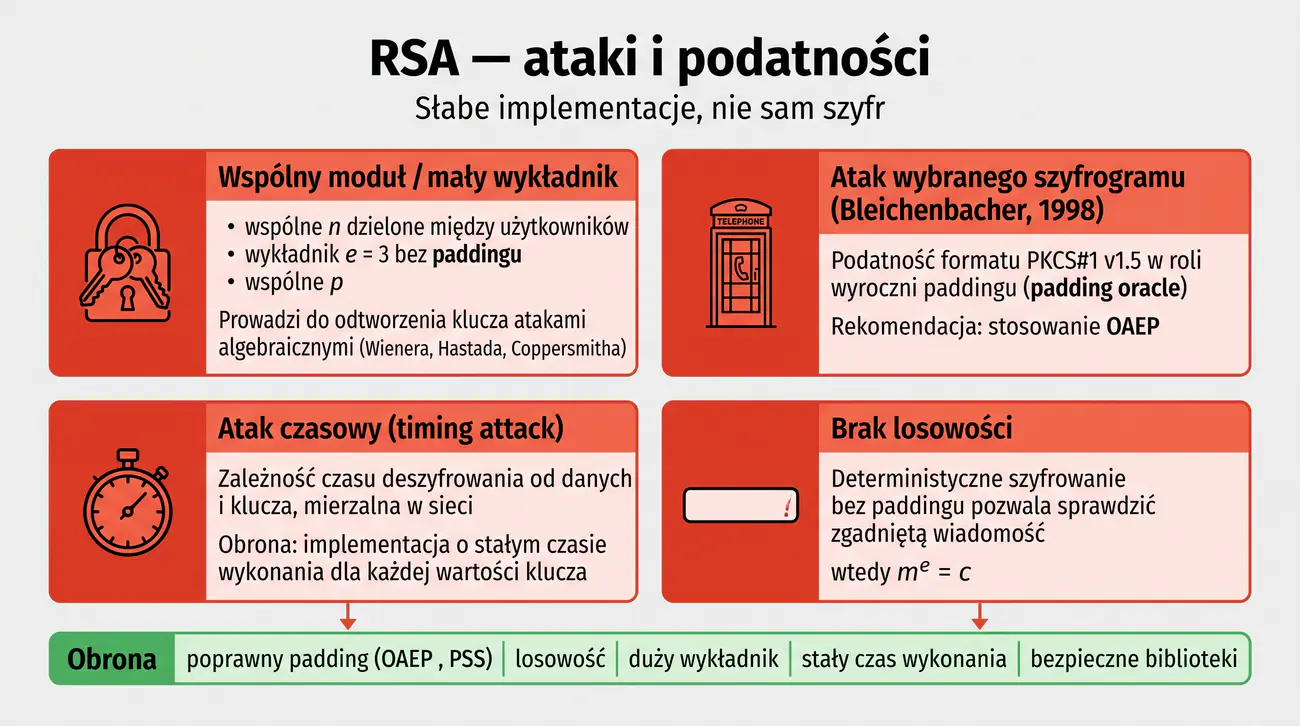
Większość znanych ataków na RSA nie wynika z wady samej konstrukcji matematycznej, lecz z niewłaściwego doboru parametrów lub błędów w sposobie użycia szyfru. Drobny wykładnik publiczny czy wspólne czynniki między modułami potrafią umożliwić odtworzenie klucza, mimo że formalnie RSA opiera się na trudnym problemie. Grupa ataków algebraicznych, opisanych między innymi przez Wienera, Håstada i Coppersmitha, pokazuje, jak ważna jest staranność przy wyborze wszystkich parametrów.
Atak Bleichenbachera z 1998 roku ujawnił z kolei, że nawet pozornie pewne mechanizmy wypełniania mogą służyć napastnikowi jako źródło informacji zwrotnej, jeżeli system reaguje odmiennie na poprawne i niepoprawne szyfrogramy. Dlatego zamiast historycznego formatu PKCS 1 wersji 1.5 zaleca się obecnie schemat OAEP i stałą kolejność weryfikacji. Na mocy tej samej zasady unika się również ujawniania informacji o przyczynie błędu w protokołach.
Ataki czasowe pokazują natomiast, że pominąć nie można nawet fizycznej warstwy działania sprzętu, gdyż różnice w czasie wykonania mogą zdradzić dane matematyczne kluczy. Współczesne biblioteki stosują w tych miejscach techniki stałoczasowe, równoważąc czas operacji niezależnie od wartości danych. Omówienie tych zagrożeń przygotowuje do oceny rozwiązań proponowanych przez producentów oprogramowania kryptograficznego.
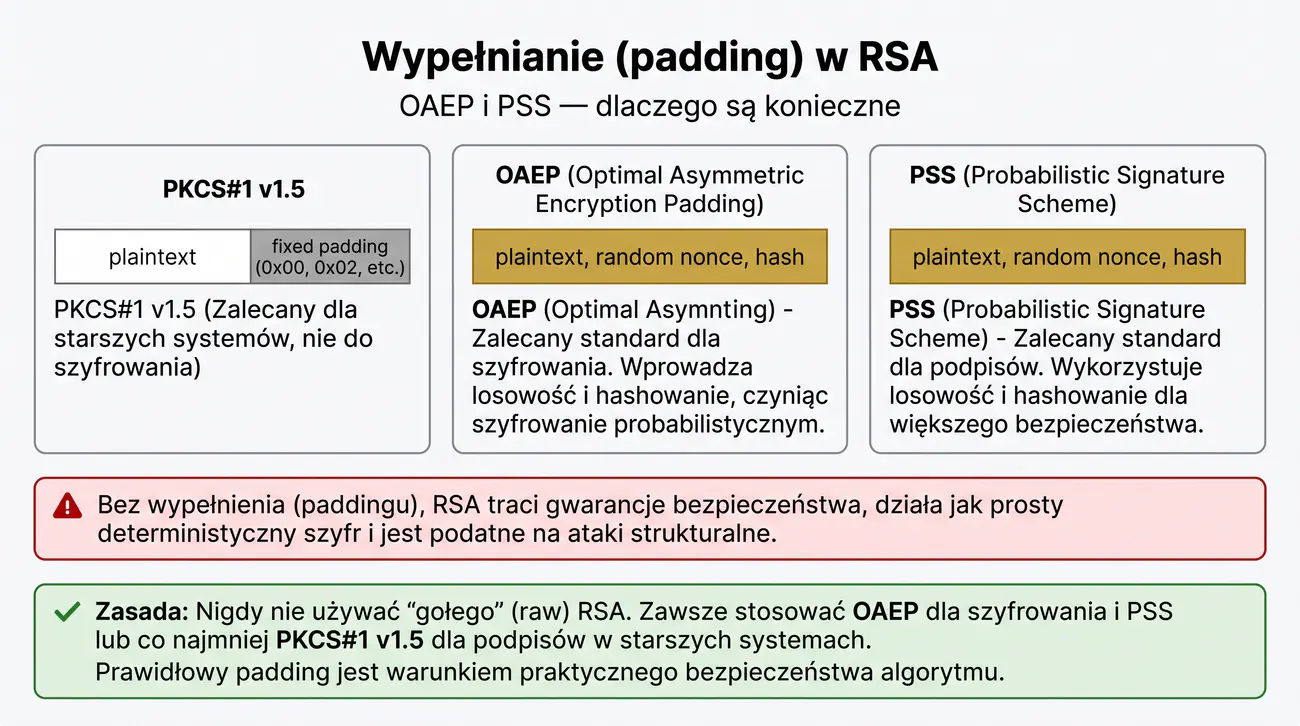
Wypełnianie odgrywa podwójną rolę, ponieważ zarówno uzupełnia wiadomość do wymaganej długości, jak i nadaje szyfrowaniu charakter probabilistyczny, dzięki czemu ten sam tekst jawny szyfruje się za każdym razem inaczej. Mechanizm OAEP łączy losową wartość pomocniczą z funkcją skrótu i przekształceniem, które zapewniają, że nawet niewielka zmiana danych daje całkowicie odmienny szyfrogram. Dzięki temu napastnik nie jest w stanie skutecznie testować hipotez co do zawartości wiadomości.
Schemat PSS pełni analogiczną funkcję w obszarze podpisów, wprowadzając do wyniku losowość oraz dodatkową strukturę kryptograficzną opartą na funkcji skrótu. W protokole TLS w wersji 1.3 wypełnienie PSS stało się obowiązkowym sposobem podpisywania wiadomości przez RSA, co podnosi poziom bezpieczeństwa handshake. Takie decyzje normalizacyjne pokazują, że dobór wypełnienia nie jest kwestią kosmetyczną, lecz istotnym elementem całego projektowanego systemu.
Stosowanie gołego algorytmu bez wypełnienia pozostaje natomiast źródłem opisanych w literaturze ataków strukturalnych, dlatego wszystkie solidne biblioteki wymagają jawnego wskazania schematu. Umiejętność rozróżniania tych schematów i rozumienia ich roli stanowi ważny element kompetencji projektanta bezpiecznych systemów. W trakcie pracy z Pythonem i OpenSSL warto zatem świadomie dobierać odpowiedni wariant wypełnienia do realizowanego zadania.
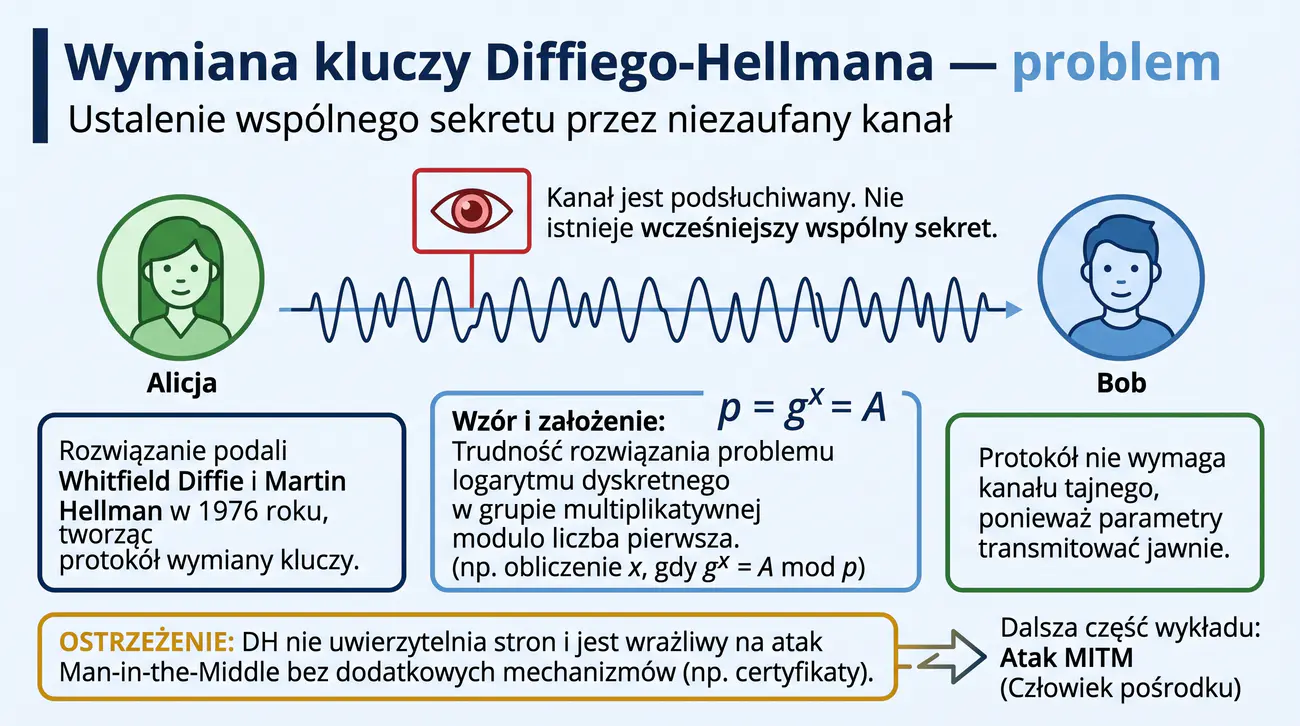
Protokół Diffiego i Hellmana rozwiązał fundamentalny problem uzgodnienia sekretu przez niezaufany kanał, mimo że obie strony nie dysponują żadną wcześniejszą wspólną tajemnicą. Oparto go na przekonaniu, że obliczenie logarytmu dyskretnego w grupie modulo liczba pierwsza jest zadaniem praktycznie niewykonalnym dla odpowiednio dużych parametrów. Wartość uzgodnionego sekretu zależy przy tym od obu składników dobranych losowo przez uczestników rozmowy.
Warto podkreślić, że protokół nadaje się zarówno do użycia w grupach o parametrach globalnych, jak i w odmianach z użyciem krzywych eliptycznych, gdzie rolę potęgowania przejmuje mnożenie punktów. Ta obserwacja pozwala zrozumieć, dlaczego współcześnie w praktyce dominuje wariant ECDH, oferujący mniejsze klucze i szybsze obliczenia. Wybór konkretnej odmiany zależy od możliwości platformy oraz wymagań organizacyjnych.
Uczestnicy protokołu muszą jednak mieć świadomość, że sam schemat nie potwierdza tożsamości rozmówcy, co otwiera przestrzeń do ataków polegających na podstawieniu w trakcie wymiany. Dlatego w realnych systemach uzgodnione wartości są dodatkowo uwierzytelniane podpisami lub certyfikatami. Ta zależność między wymianą kluczy a uwierzytelnianiem wraca wielokrotnie przy omawianiu protokołów transportowych i infrastruktury klucza publicznego.
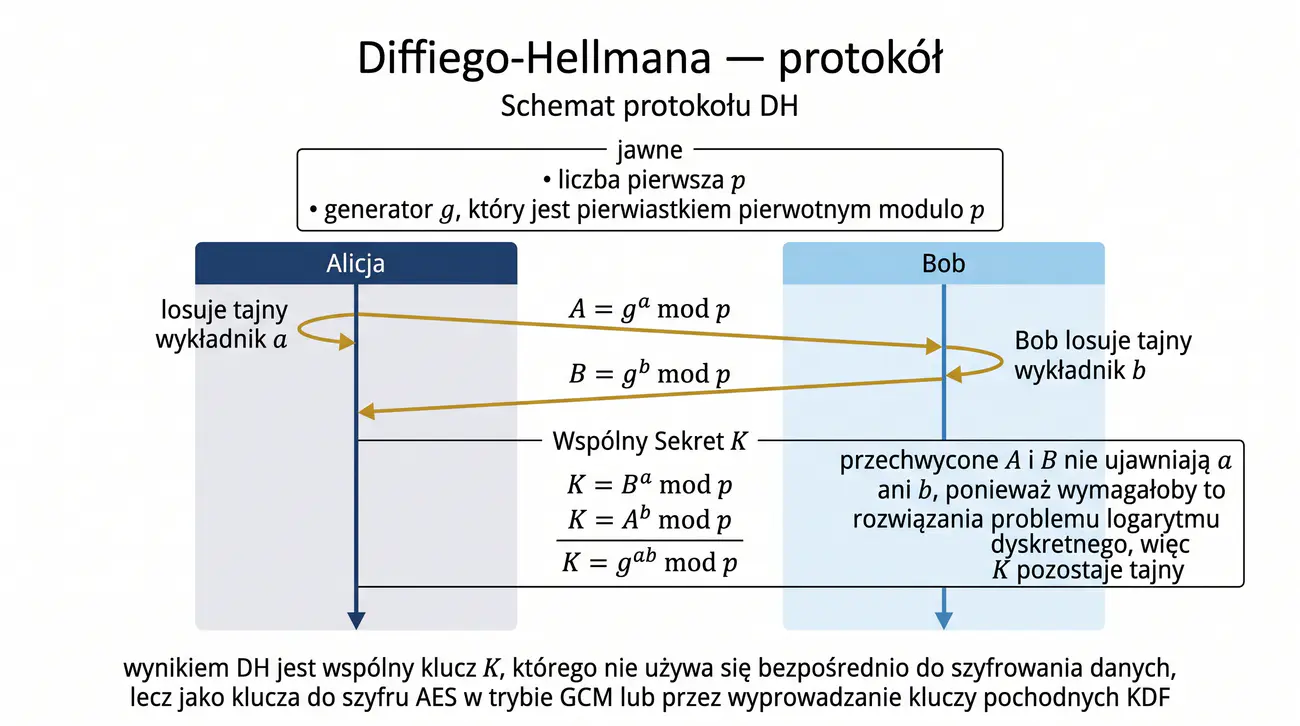
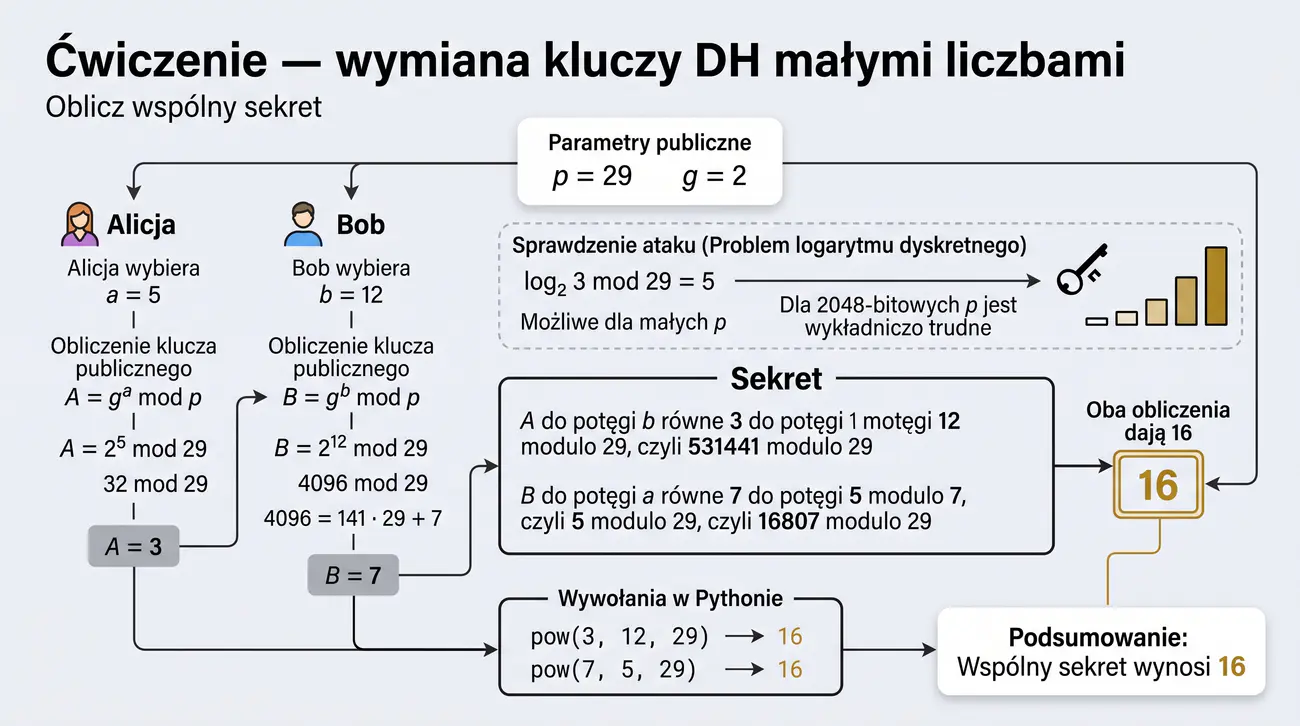
Schemat protokołu opiera się na jawnie ogłoszonych parametrach, takich jak liczba pierwsza i generator, które nie stanowią żadnej tajemnicy i mogą być rozpowszechniane razem ze specyfikacją. Każda ze stron losuje własny wykładnik tajny, a następnie przesyła wyliczony na jego podstawie wynik potęgowania modularnego. Oba wysłane rezultaty są wystarczające, aby obie strony uzgodniły tę samą wartość bez konieczności przekazywania czegokolwiek więcej.
Bezpieczeństwo opisanej wymiany sprowadza się do niemożliwości wyznaczenia wykładnika z samej potęgi, co dla dużych parametrów pozostaje poza zasięgiem współczesnych metod. W praktyce stosuje się wobec tego liczby pierwsze o długości 2048 lub 3072 bitów oraz grupy opisane w osobnych dokumentach normalizacyjnych, które precyzują zalecane wartości generatora. Uzgodniony wynik nie jest jeszcze dobrym kluczem sesyjnym i dlatego przepuszcza się go przez funkcję wyprowadzania klucza, która nadaje mu odpowiednie właściwości statystyczne.
Celem całego procesu nie jest szyfrowanie danych wprost, lecz wskazanie wspólnego materiału, z którego obie strony wywiodą klucze do symetrycznego szyfrowania. Taki podział ról umożliwia łączenie zalet szybkości algorytmów blokowych z bezpieczeństwem uzgadniania sekretu. Zrozumienie tego schematu jest kluczem do prawidłowej analizy współczesnych protokołów, takich jak TLS.
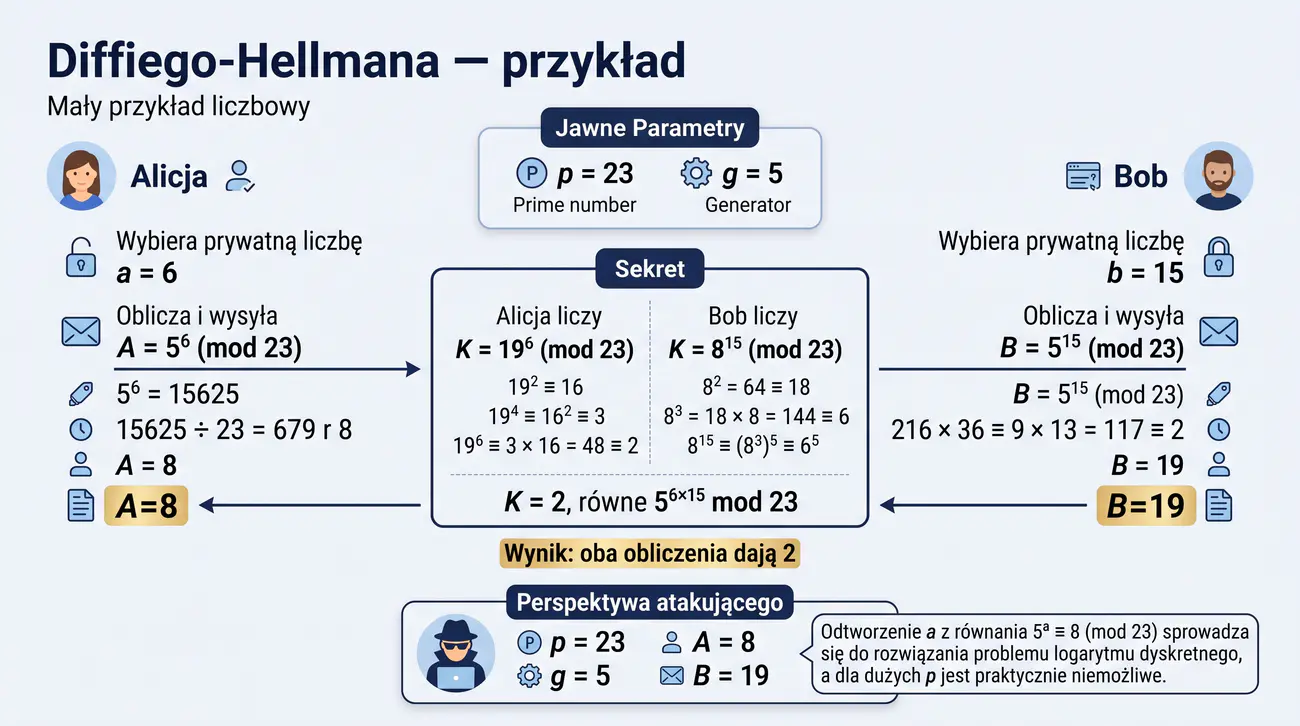
Mały przykład liczbowy ułatwia sprawdzenie wszystkich kroków protokołu, gdyż każdy wynik potęgowania można bez trudu powtórzyć w kalkulatorze lub interpreterze. Widać przy tym wyraźnie, że dane pośrednie i ostateczny wspólny sekret zależą od obu tajnych wykładników, których żadna ze stron nie ujawnia. Cała arytmetyka sprowadza się do działań na resztach z dzielenia przez liczbę p, co w przykładzie uwidacznia się w każdej zwracanej wartości.
Napastnik obserwuje wprawdzie wszystkie jawnie wysłane wartości, jednak przy dużych parametrach samo ich przechwycenie nie umożliwia wyliczenia sekretu. Różnica między skalą pokazaną w przykładzie, gdzie logarytm można obliczyć nawet ręcznie, a skalą rzeczywistych parametrów doskonale ilustruje, czym różni się przykład dydaktyczny od praktycznego użycia. W tego rodzaju ćwiczeniach ważne jest również sprawdzenie, czy wybrany generator tworzy wystarczająco obszerną grupę.
Praktyczne wdrożenia korzystają z dokładnie opisanych stałych, aby wykluczyć zbyt małe podgrupy i inne słabości strukturalne, dlatego nie należy przyjmować arbitralnych wartości parametrów. Obserwacja, że obie drogi obliczeniowe prowadzą do tego samego wyniku, utrwala natomiast rozumienie samej idei protokołu. Warto w ten sposób wykonać kilka podobnych przykładów, aż cały mechanizm będzie wykonywany automatycznie.
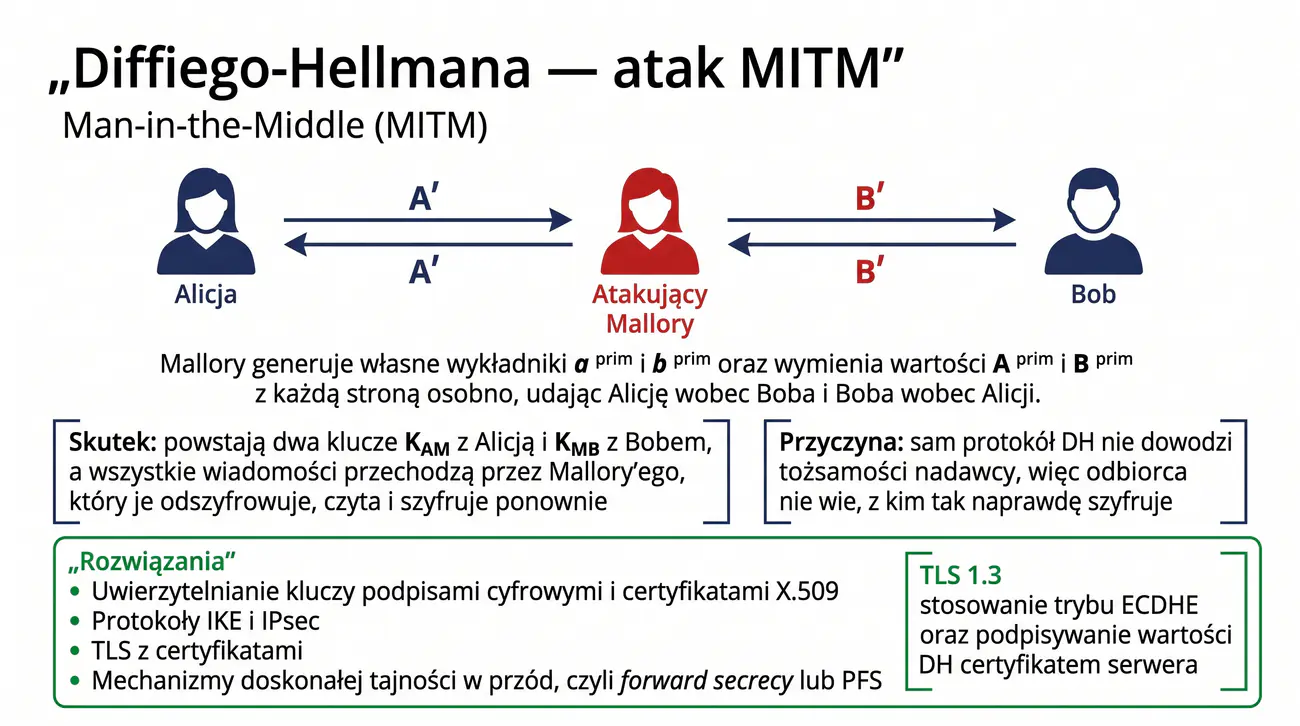
Atak pośrednika polega na podmianie wartości wymiany kluczy w taki sposób, aby każda ze stron rozmawiała z fałszywym rozmówcą, zachowując przy tym wrażenie autentycznej komunikacji. Napastnik uzgadnia wówczas z nadawcą jedną wspólną wartość, a z odbiorcą drugą, dzięki czemu przechwytuje i modyfikuje cały strumień wiadomości. Kluczem do sukcesu takiego działania jest brak mechanizmu potwierdzającego tożsamość użytkowników w samym protokole.
Zapobieganie tego typu zagrożeniu wymaga uwierzytelnienia udziału stron, co uzyskuje się przez podpisy cyfrowe, certyfikaty i dedykowane protokoły uwierzytelniające. W strukturze TLS strony uzgadniają klucze z użyciem wartości tymczasowych, a tożsamość serwera potwierdza podpis poświadczony certyfikatem. Analogiczne rozwiązania stosuje się w sieciach prywatnych, gdzie niezależne mechanizmy uwierzytelniania zabezpieczają etap wymiany sekretów.
Wprowadzenie ulotnych wartości do procedury wymiany zapewnia dodatkowo właściwość doskonałej tajności w przód, dzięki której złamanie długoterminowego klucza nie umożliwia odczytania wcześniej zarejestrowanego ruchu. Ta właściwość uważana jest dziś za standard dobrej jakości systemów komunikacji. Studenci powinni zatem kojarzyć sam protokół wymiany kluczy z pamięcią o konieczności jego rzetelnego uwierzytelniania.
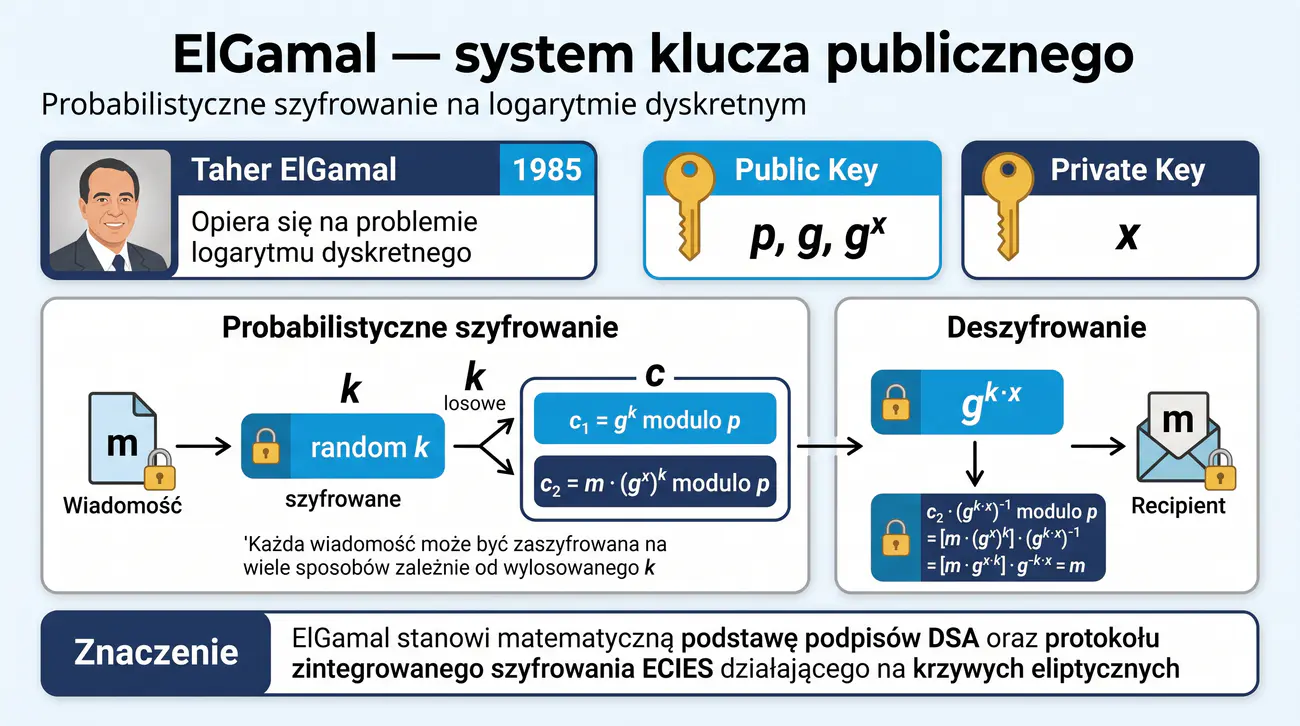
System ElGamala wprowadza do szyfrowania klucza publicznego element losowości, dzięki czemu każda próba zaszyfrowania tej samej wiadomości daje inny wynik. Tajny wykładnik wybierany jednorazowo pełni funkcję maski, a jego znajomość jest niezbędna, aby odbiorca mógł odwrócić przekształcenie i odzyskać pierwotną treść. Taki mechanizm zapewnia mocniejsze właściwości bezpieczeństwa niż szyfrowanie deterministyczne.
Konstrukcja opiera się na tych samych operacjach potęgowania w grupie modulo liczba pierwsza co wymiana kluczy, dlatego zależność między tymi zagadnieniami łatwo dostrzec. Ponieważ każde zaszyfrowanie wymaga losowego składnika, wdrożenie musi dysponować niezawodnym źródłem losowości, a jego wady natychmiast przekładają się na podatności. W praktyce ElGamal bywa kosztowniejszy obliczeniowo, co ogranicza go głównie do protokołów, w których liczą się własności matematyczne.
Struktura ta posłużyła także jako podstawa algorytmu podpisu DSA, w którym losowy składnik pełni rolę właściwego nonce, oraz wariantów opartych na krzywych eliptycznych. Zrozumienie wspólnego rdzenia tych rozwiązań ułatwia późniejszą analizę ich bezpieczeństwa i porównywanie między sobą. Dzięki temu nie uczy się każdego algorytmu od zera, lecz rozpoznaje w nich powtarzalne wzorce konstrukcyjne.
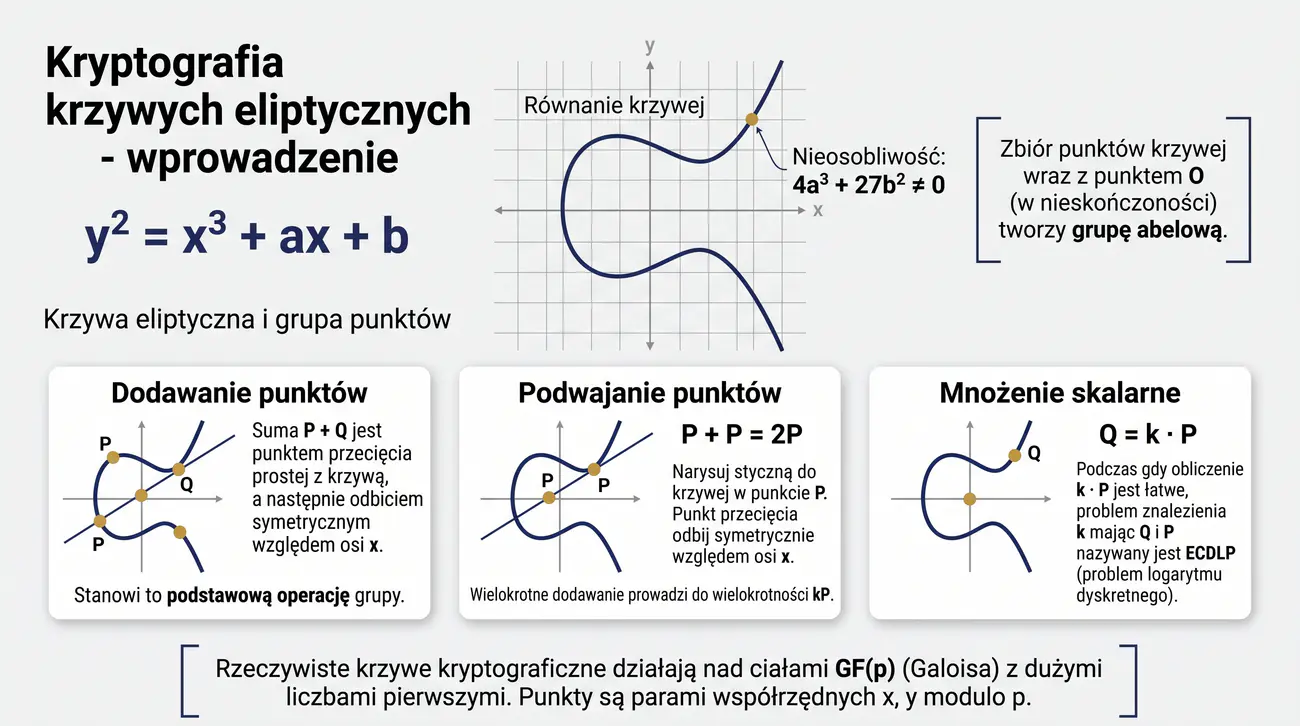
Krzywe eliptyczne nad ciałami skończonymi dostarczają grup, w których mnożenie punktów jest łatwe, a operacja odwrotna pozostaje praktycznie niewykonalna. Dodawanie punktów zdefiniowane jest geometrycznie jako odbicie punktu przecięcia prostej z krzywą, a współrzędne wszystkich elementów liczy się w arytmetyce modularnej. Punkt w nieskończoności pełni rolę elementu neutralnego, dzięki czemu cały zbiór punktów ma strukturę grupy abelowej.
W praktyce konstrukcje oparte na krzywych wykorzystują wyłącznie skończone ciała, takie jak pola binarne lub ciała o dużej liczbie pierwszej, a nie ciągłe krzywe znane z geometrii analitycznej. Liczenie operacji w ciele skończonym eliminuje problemy numeryczne i pozwala jednoznacznie opisać wszystkie elementy systemu. Dobór parametrów krzywej, takich jak współczynniki równania i rząd grupy, ma decydujący wpływ na bezpieczeństwo całego mechanizmu.
Operacje grupowe można zaimplementować szybko i deterministycznie, co sprawdza się zarówno w oprogramowaniu, jak i w układach sprzętowych. Różnica między zwykłym mnożeniem a problemem odwrotnym jest właśnie fundamentem bezpieczeństwa kryptografii krzywych eliptycznych. Zrozumienie tej struktury umożliwia świadome analizowanie dokumentów dotyczących krzywych i standardów bezpieczeństwa.
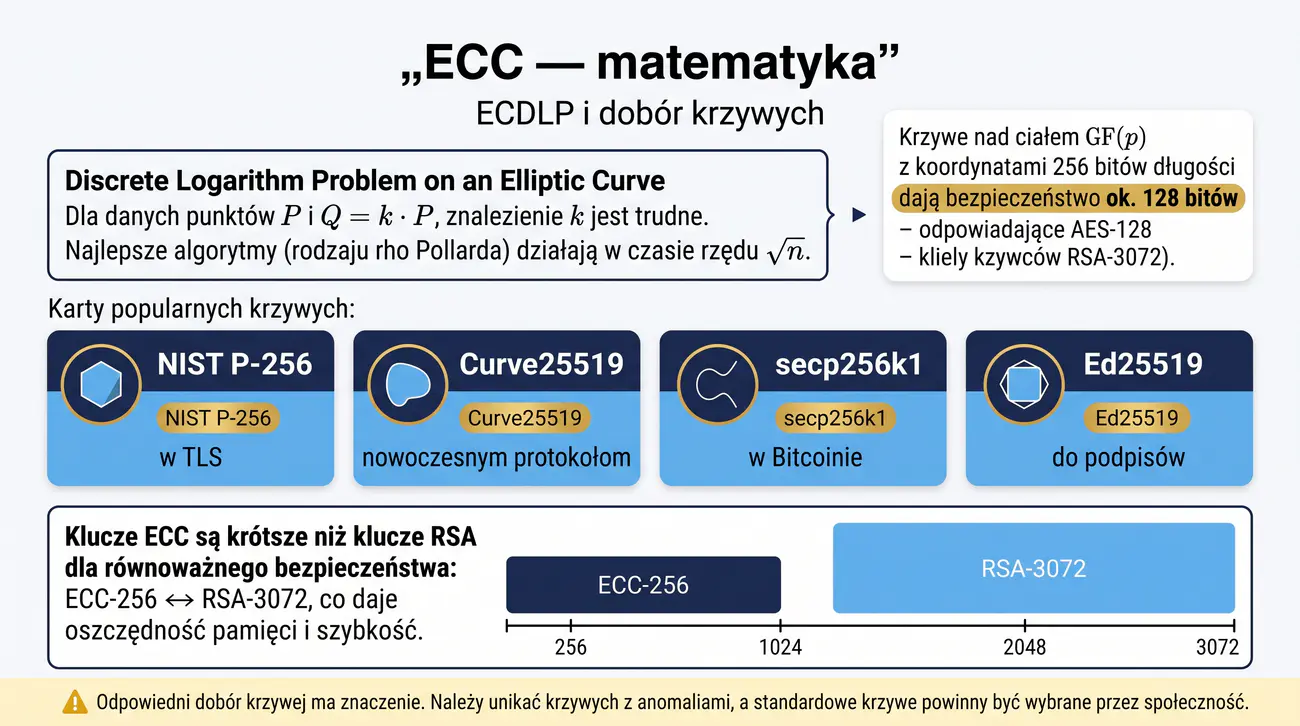
Stopień trudności problemu logarytmu dyskretnego na krzywej jest miarą bezpieczeństwa całego systemu, a najlepsze znane algorytmy mają złożoność wciąż w przybliżeniu pierwiastkową względem rozmiaru grupy. Oznacza to, że zwiększanie długości współrzędnych o niewielką liczbę bitów znacząco podnosi koszt ewentualnego ataku. Dzięki temu krzywe o znacznie krótszych kluczach niż RSA mogą zapewnić porównywalny poziom bezpieczeństwa.
W porównaniu z problemem logarytmu w grupie modulo liczba pierwsza, krzywe nie doczekały się dotąd efektywnych ataków o logarytmicznej złożoności, co tłumaczy ich popularność w nowoczesnych systemach. Standardowe krzywe, takie jak P-256, secp256k1 czy Curve25519, różnią się pod względem struktury matematycznej, szybkości i właściwości implementacyjnych. Wybór między nimi powinien uwzględniać rekomendacje instytucji normalizacyjnych oraz charakter platformy docelowej.
Nieodpowiednio dobrana krzywa, w szczególności taka z anomalnymi właściwościami grupy, może jednak osłabić cały system mimo pozornie długich kluczy. Dlatego projektanci zalecają korzystanie wyłącznie z krzywych zbadanych przez szerokie środowisko i objętych standardami. Ta zasada powtarza się w całej kryptografii, w której wartość rozwiązania rośnie proporcjonalnie do zakresu niezależnej analizy.
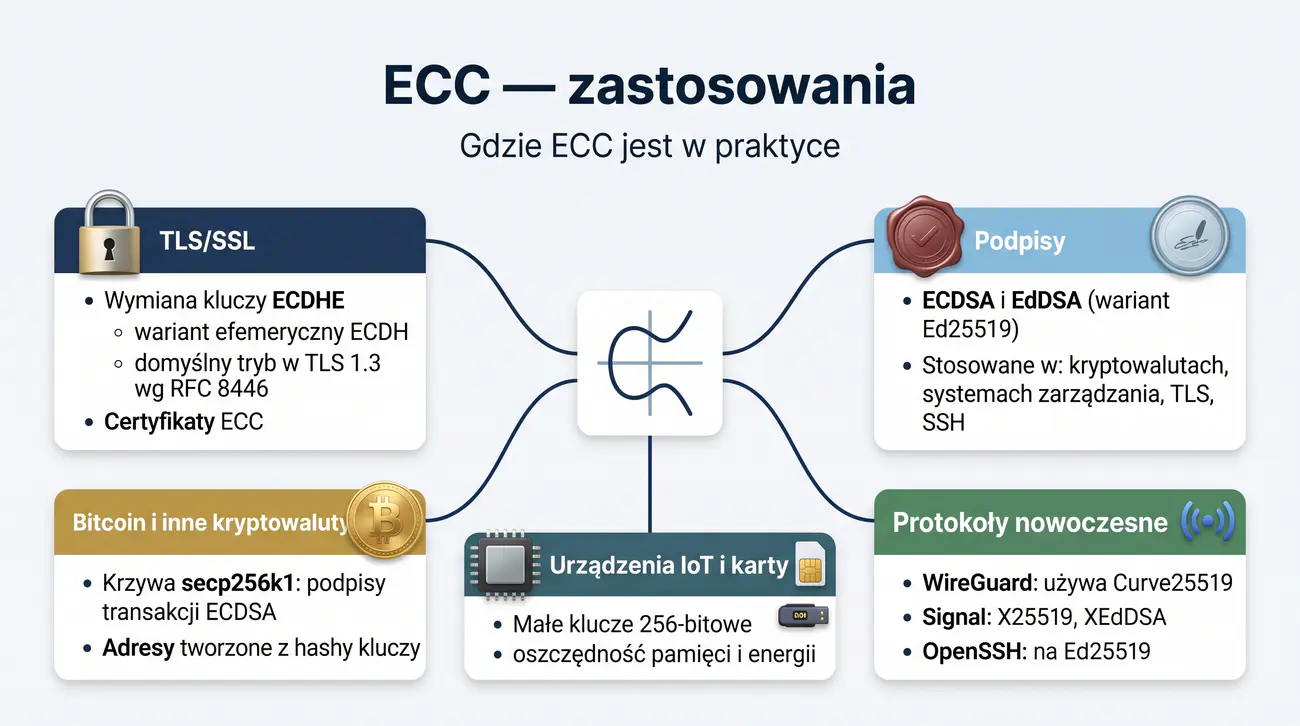
Kryptografia krzywych eliptycznych znalazła zastosowanie praktyczne przede wszystkim tam, gdzie ważne są małe rozmiary kluczy, szybkie przetwarzanie i energooszczędność, czyli w protokołach TLS, systemach mobilnych i urządzeniach wbudowanych. Dzięki krótkim kluczom certyfikaty i komunikaty podpisów zajmują znacznie mniej miejsca, co ma znaczenie w środowiskach o ograniczonej przepustowości. Właśnie te cechy przesądziły o wyborze krzywych w nowoczesnych rozwiązaniach komunikacyjnych.
W praktyce spotyka się dwa podstawowe zastosowania, czyli wymianę kluczy oraz podpisy cyfrowe, realizowane wariantami ECDH i ECDSA, a coraz częściej także nowoczesnym podpisem Ed25519. Protokoły takie jak WireGuard czy Signal ujęły krzywe wprost w swoich specyfikacjach, co czyni je powszechnym fundamentem szyfrowania komunikacji w wielu aplikacjach. Również systemy zarządzania transakcjami cyfrowymi, w szczególności kryptowaluty, opierają na tych krzywych bezpieczeństwo swoich transakcji.
Rozpowszechnienie krzywych eliptycznych oznacza jednocześnie, że programista spotyka ich implementacje w bibliotekach standardowych wielu języków, dlatego warto poznać przynajmniej podstawowy interfejs tych usług. Umiejętność wyboru odpowiedniej krzywej i prawidłowego wywołania funkcji kryptograficznych należy dziś do podstawowych kompetencji inżyniera bezpieczeństwa. Na zajęciach szczególną uwagę warto poświęcić porównaniu krzywych pod kątem wymagań konkretnego zastosowania.
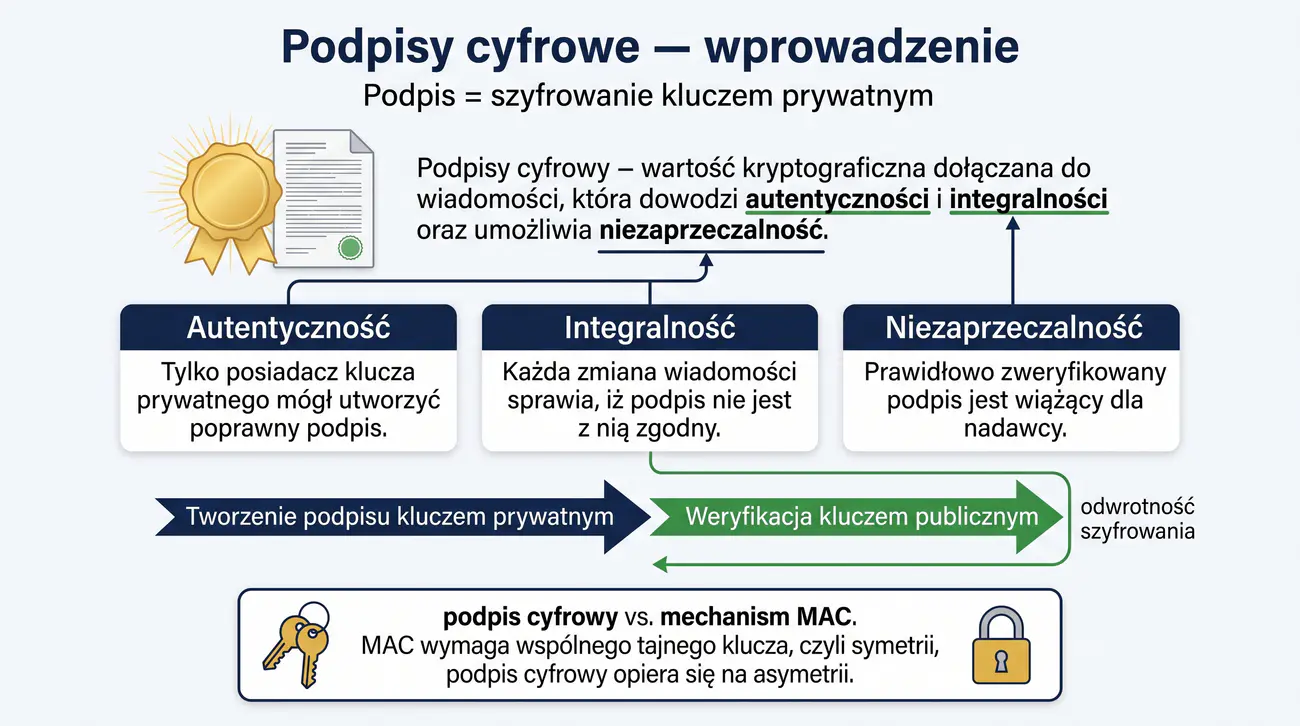
Podpis cyfrowy to mechanizm przeznaczony do potwierdzania pochodzenia i integralności wiadomości, działający jednak w odniesieniu do konkretnego twórcy, a nie do pary komunikujących się stron. Właśnie możliwość przypisania podpisu do jednej osoby wyróżnia go spośród symetrycznych kodów uwierzytelniających, które wymagają wspólnego sekretu. Dzięki temu rozwiązanie sprawdza się w systemach, w których strony nie dzielą się żadnym wspólnym materiałem kluczowym.
Podpis umożliwia egzekwowanie trzech podstawowych właściwości, czyli autentyczności, integralności i niezaprzeczalności, co nie jest osiągalne przy użyciu samego szyfrowania. Modyfikacja choćby jednego bajtu po podpisaniu powoduje, że weryfikacja kończy się niepowodzeniem, co czyni podpis wrażliwym na zmiany. Warto przy tym pamiętać, że samo szyfrowanie nie zapewnia integralności, a podpisy nie są jedynym sposobem jej zagwarantowania.
W praktyce z podpisów korzysta się w programach do elektronicznego obiegu dokumentów, w protokołach TLS i w systemach aktualizacji oprogramowania, gdzie ich właściwości budują zaufanie. Ważne jest zrozumienie różnicy między pojęciem podpisu kryptograficznego a podpisem elektronicznym jako kategorią prawną, która bywa realizowana przez kryptograficzne mechanizmy. Takie rozróżnienie pomaga w interpretacji przepisów i dokumentów branżowych.
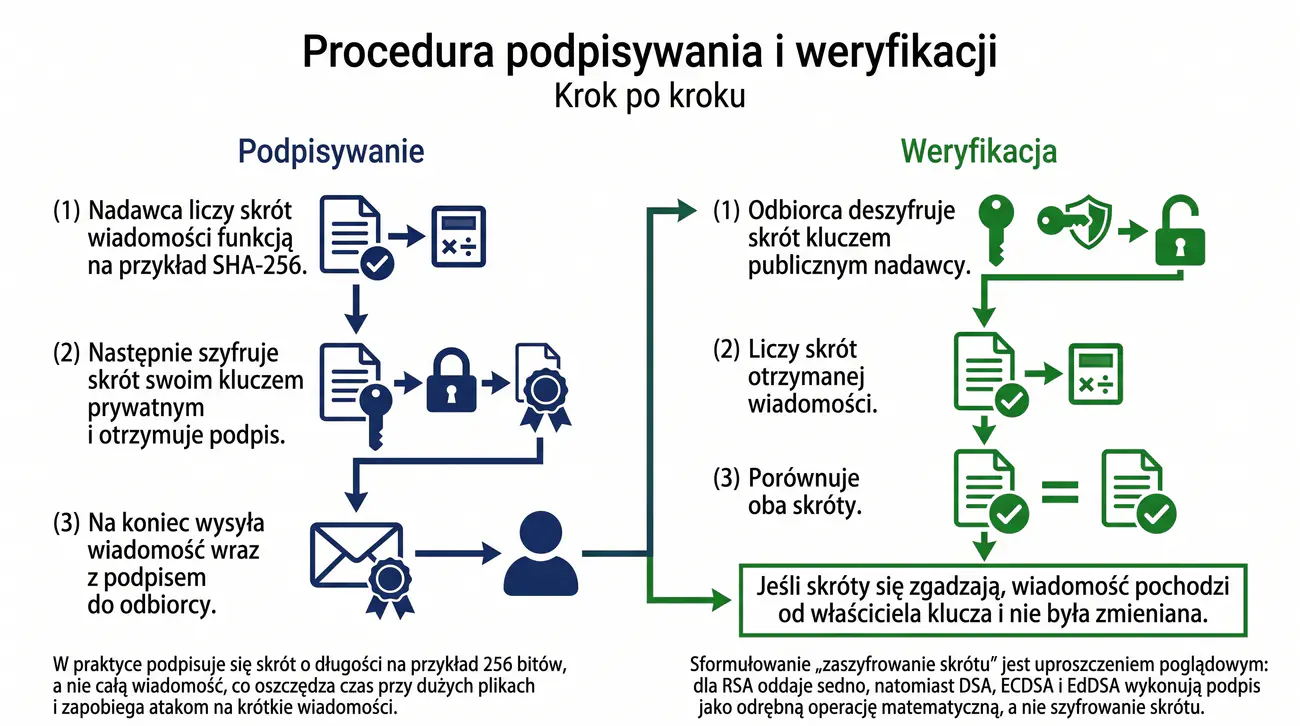
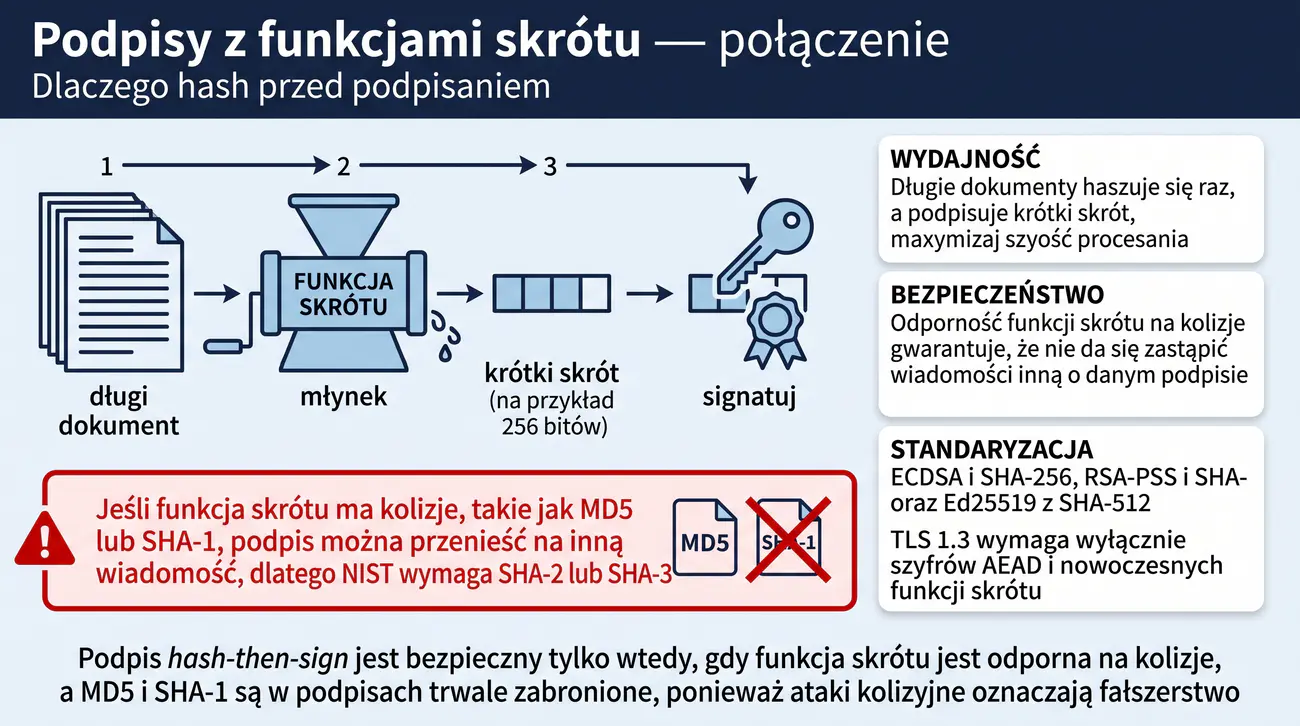
Typowa procedura podpisywania przebiega według schematu zwanego hash-then-sign, w którym najpierw oblicza się skrót dokumentu, a następnie przekształca ten skrót za pomocą prywatnego materiału nadawcy. Dzięki takiemu uproszczeniu podpis jest zawsze krótki i niezależny od długości oryginalnej treści, co znacząco przyspiesza przetwarzanie dużych plików. Odbiorca niezależnie oblicza skrót otrzymanej wiadomości i porównuje go z wartością zweryfikowaną przy użyciu klucza publicznego.
Opis mówiący o zaszyfrowaniu skrótu kluczem prywatnym jest uproszczeniem dydaktycznym, ponieważ w schematach takich jak DSA, ECDSA czy Ed25519 podpis powstaje w wyniku odrębnych operacji algebraicznych, a nie zwykłego szyfrowania skrótu. Wartość tej analogii polega jednak na wytłumaczeniu koncepcyjnego podziału ról między kluczami, który jest symetryczny do procesu szyfrowania. Precyzyjne rozumienie tego podziału zapobiega późniejszym nieporozumieniom przy analizie konkretnych standardów.
Weryfikacja podpisu nie wymaga dostępu do klucza prywatnego, dlatego może być wykonywana przez dowolny podmiot posiadający klucz publiczny, na przykład przez program kliencki. Proces ten powinien zawsze uwzględniać również kontrolę czasów ważności certyfikatów oraz zgodność algorytmów z aktualnymi zaleceniami. Tylko wówczas pomyślne porównanie skrótów prowadzi do rzetelnego wniosku o autentyczności dokumentu.
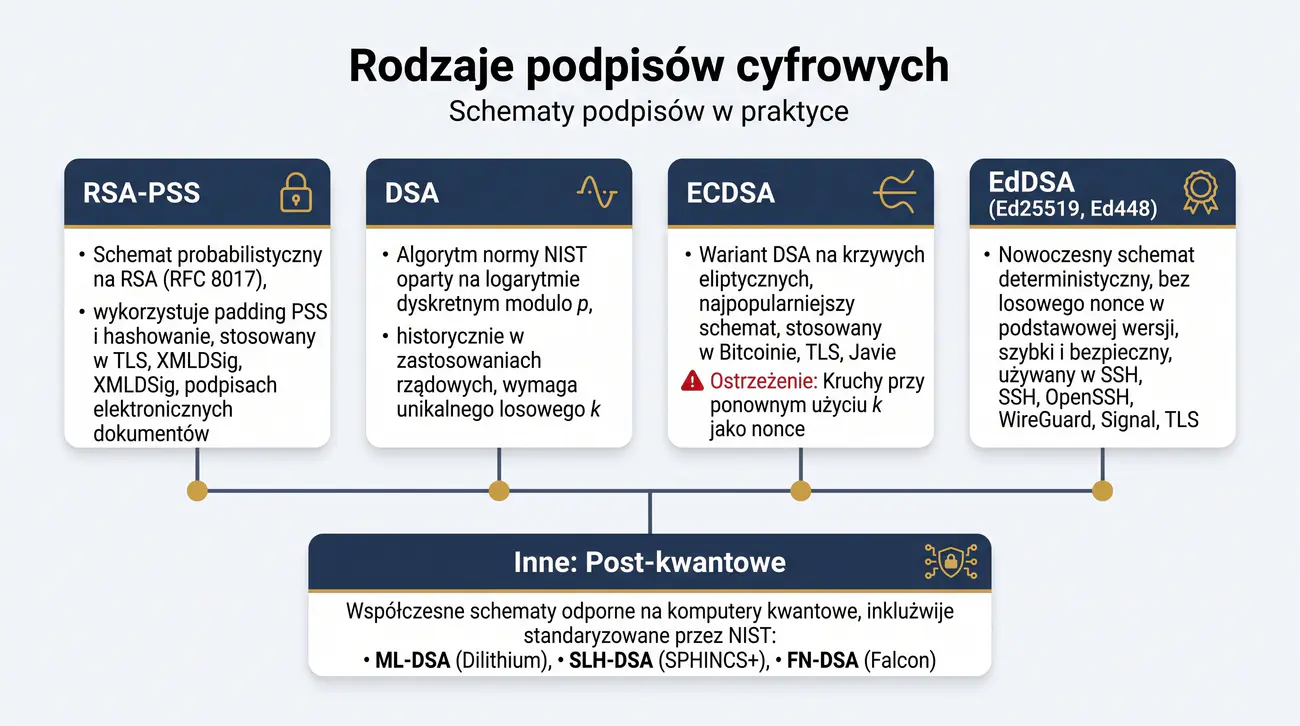
Rodzina schematów podpisów dzieli się ze względu na podstawowy problem matematyczny, na którym opiera swoje bezpieczeństwo: od faktoryzacji w przypadku RSA, przez logarytm dyskretny w DSA, aż po warianty krzywych eliptycznych. Każda z tych konstrukcji charakteryzuje się odmiennymi rozmiarami kluczy i podpisów oraz różną wydajnością na typowych platformach. Znajomość tych różnic pozwala precyzyjniej dobierać rozwiązanie do konkretnego scenariusza wdrożeniowego.
Współczesne standardy, w tym FIPS 186-5, przyznają szczególne miejsce algorytmom opartym na krzywych oraz nowoczesnym schematom deterministycznym, które eliminują problemy związane z nierzetelną losowością. W praktyce coraz częściej wybiera się Ed25519 ze względu na krótkie podpisy, stały czas operacji i łatwość bezpiecznej implementacji. Z drugiej strony RSA pozostaje szeroko stosowane w narzędziach administracyjnych i systemach dokumentowych, co uzasadnia równoległe omawianie obu rodzin.
Na horyzoncie pojawiają się także podpisy postkwantowe, które mają zapewnić bezpieczeństwo w erze komputerów kwantowych i stopniowo zastąpić obecne schematy. Ich wprowadzanie odbywa się wyłącznie w postaci standardów, aby zagwarantować zgodność implementacji. Dzięki omówieniu całej rodziny schematów można ocenić stopień dojrzałości poszczególnych rozwiązań i planować przyszłą migrację systemów.
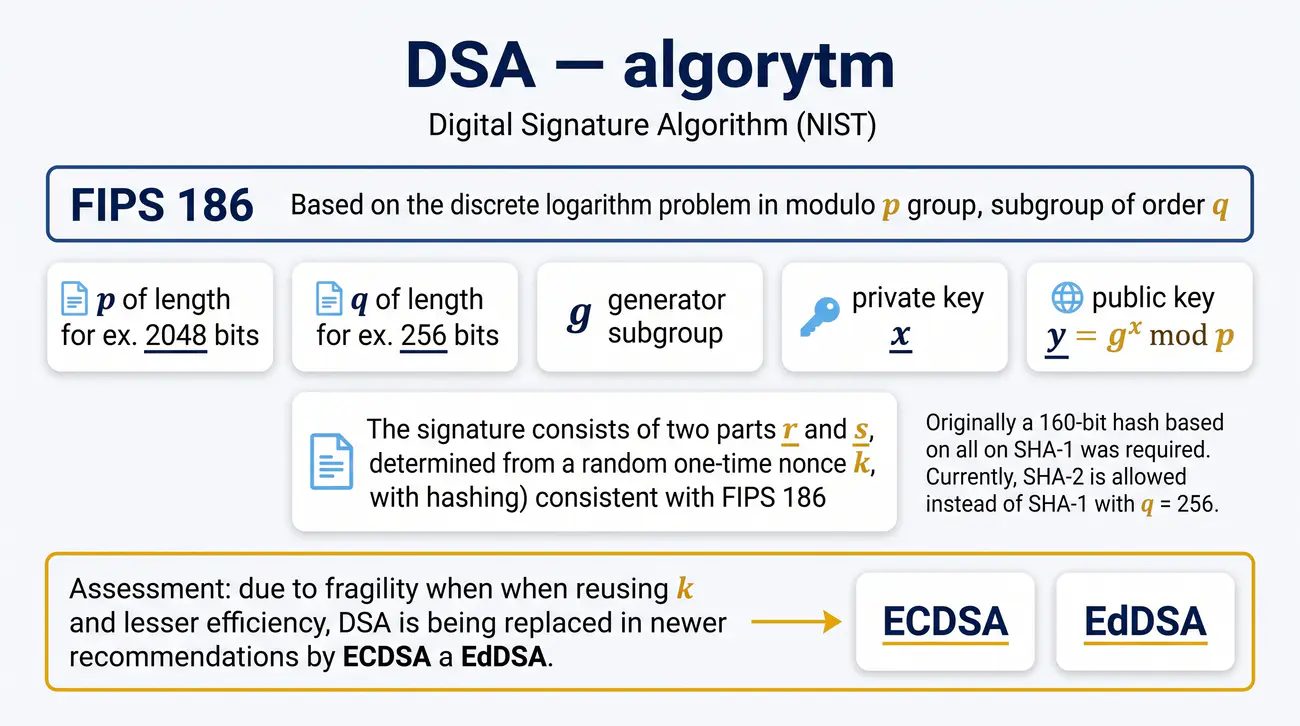
Algorytm DSA został zaprojektowany głównie z myślą o podpisywaniu, a nie szyfrowaniu, co odróżnia go od systemów takich jak RSA, które służą dwóm celom jednocześnie. Jego bezpieczeństwo opiera się na problemie logarytmu dyskretnego w podgrupie modulo odpowiednio duża liczba pierwsza, a rozmiar tej podgrupy wyznacza parametr rzędu. Podpis charakteryzuje się dwuczęściową strukturą, w skład której wchodzą wartości wyznaczane na podstawie obliczeń grupowych oraz skrótu wiadomości.
Przez lata algorytm wymagał używania funkcji skrótu dostosowanej do rozmiaru parametru rzędu, co zmuszało do zachowania szczególnej ostrożności przy doborze długości skrótu. Z czasem okazało się również, że rozwiązanie jest mniej elastyczne i mniej wydajne od wariantów opartych na krzywych, które do tych samych celów potrzebują znacznie mniejszych kluczy. Dlatego kolejne rewizje standardu ograniczyły rolę DSA do weryfikacji zgodności ze starszymi systemami.
Zagrożenia związane z powtarzaniem losowego składnika, które w praktyce prowadzą do odtworzenia klucza, sprawiły, że schematy tego rodzaju wymagają starannego zarządzania wartościami losowymi. Pokazana przy tej okazji zależność między składowymi podpisu i skrótem wiadomości stanowi ważny punkt wyjścia do omówienia wariantów krzywych. Zrozumienie DSA ułatwia zatem naukę nowszych, bezpieczniejszych schematów podpisu.
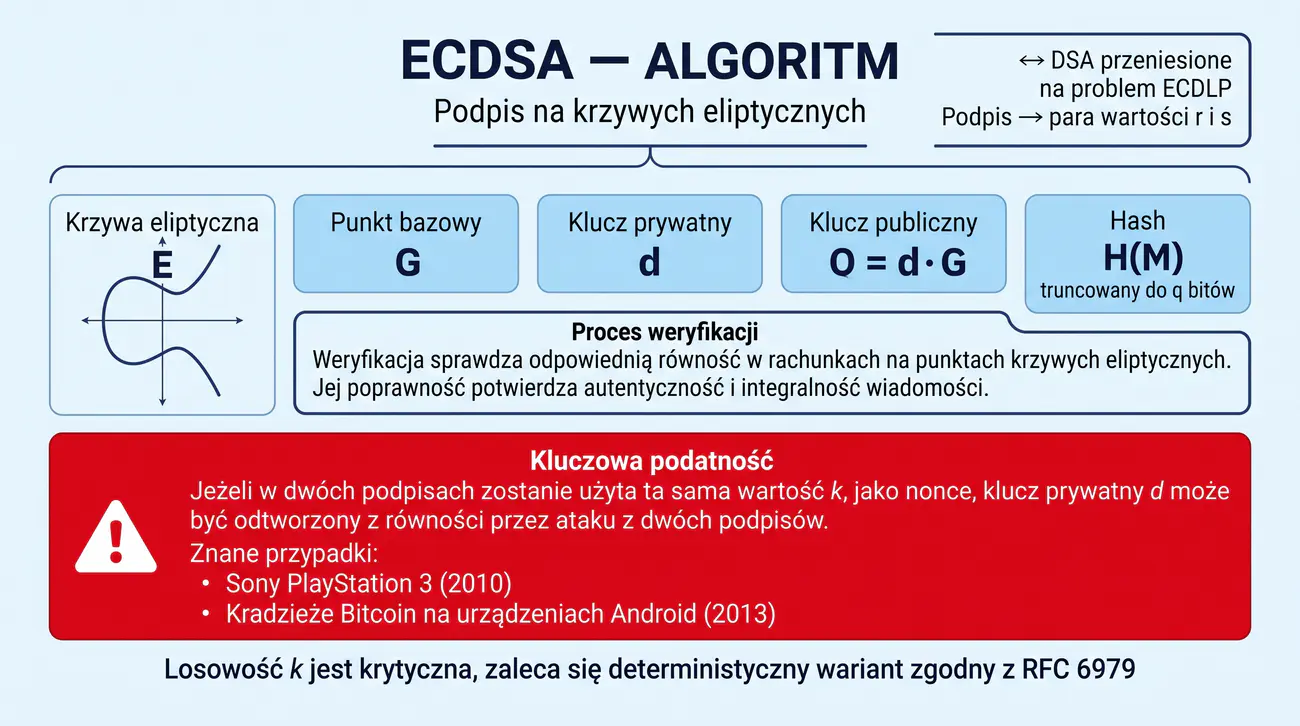
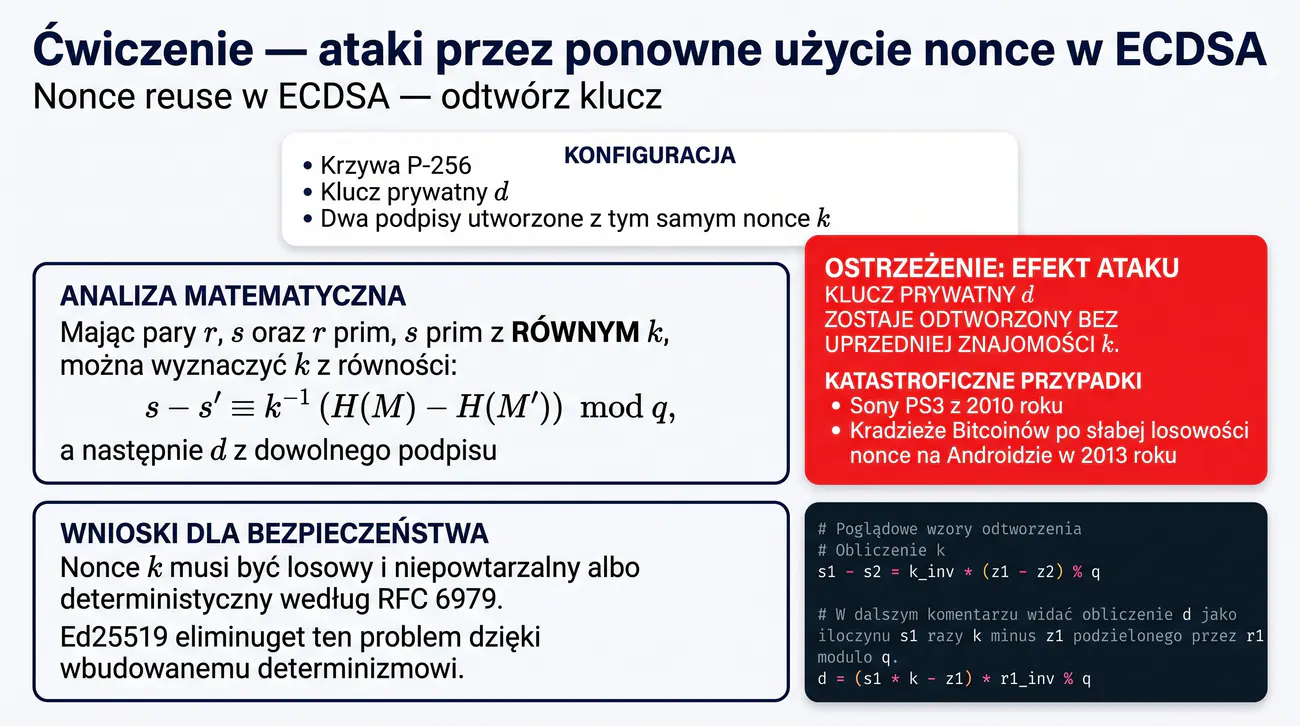
ECDSA przenosi schemat podpisu DSA na grupę punktów krzywej eliptycznej, dzięki czemu uzyskuje krótsze klucze i lepszą wydajność przy zachowaniu porównywalnego poziomu bezpieczeństwa. Podpis nadal składa się z dwóch wartości opartych na losowym składniku oraz na danych zaczerpniętych z wiadomości, a weryfikacja wymaga arytmetyki na punktach krzywej. Kluczowa dla zrozumienia jest zależność między składową podpisu, losowym nonce oraz prywatnym kluczem, ponieważ na tej zależności opiera się większość opisanych ataków.
Powtórzenie tej samej wartości k w dwóch podpisach pozwala bowiem matematycznie usunąć niewiadomą i odtworzyć klucz prywatny bez żadnej dodatkowej wiedzy. Incydent związany z konsolą PlayStation 3 oraz kradzieże środków z portfeli cyfrowych należą właśnie do tej kategorii słabości. Z tych doświadczeń wypracowano wartości w pełni deterministyczne na podstawie klucza i wiadomości, opisane w dokumencie RFC 6979, które redukują ryzyko błędnej losowości.
Wykorzystanie prawidłowych wartości losowych lub schematów deterministycznych należy dziś do podstawowych wymogów bezpiecznej implementacji ECDSA. Biblioteki kryptograficzne najczęściej same zarządzają tymi wartościami, co ogranicza ryzyko błędu po stronie programisty. Zrozumienie tej podatności przygotowuje do analizy incydentów bezpieczeństwa opisanych w literaturze i raportach branżowych.
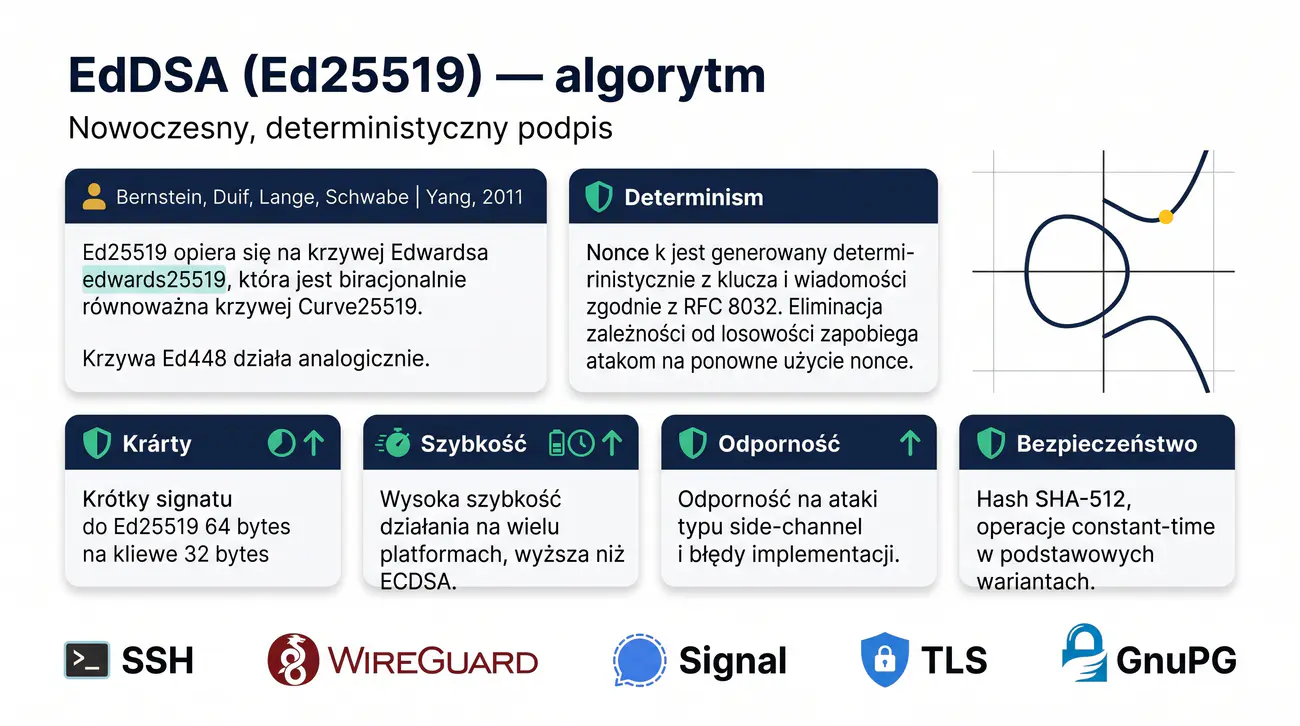
EdDSA to nowoczesna rodzina podpisów opartych na krzywych Edwardsa, z których najmocniejszą pozycję zdobył wariant Ed25519 używany w licznych protokołach i narzędziach. Wyróżnia go deterministyczne wytwarzanie wartości pomocniczych z klucza i treści wiadomości, dzięki czemu wynik podpisu nie zależy od jakości źródła losowości. Ta cecha eliminuje w zarodku grupę ataków związanych z powtarzaniem lub przewidywaniem losowych składników.
Struktura krzywej Edwardsa umożliwia ujednolicenie operacji dodawania i podwajania punktów, co upraszcza implementacje i skraca czas obliczeń, a jednocześnie sprzyja wykonywaniu ciągów operacji o stałym czasie. Podpisy i klucze mają przy tym zwarte rozmiary, co ma znaczenie w systemach o ograniczonych zasobach. Z tych powodów Ed25519 znalazł zastosowanie w protokołach SSH, w rozwiązaniach komunikacyjnych i w narzędziach do szyfrowania dokumentów.
Odporność na ataki czasowe oraz prostota prowadzenia bezpiecznej implementacji sprawiają, że wariant ten jest często rekomendowany także dla osób mniej doświadczonych w kryptografii. Warto przy tym pamiętać o różnicach między odmianami Ed25519 i Ed448, które dostosowują poziom bezpieczeństwa do potrzeb zaawansowanych systemów. Znajomość zasad działania EdDSA pomaga świadomie wybierać algorytmy podpisu w nowych projektach.
Łączenie funkcji skrótu z podpisem nie jest wyłącznie kwestią wygody, lecz warunkiem poprawności całego schematu, ponieważ chroni przed modyfikacją treści i umożliwia podpisywanie długich dokumentów. Funkcja skrótu sprowadza bowiem dowolnie obszerne dane do krótkiego, stałego ciągu wartości, który można potem przekształcać wydajnymi operacjami klucza. Jednocześnie odporność skrótu na kolizje gwarantuje, że inną wiadomość o tym samym wyniku trudno wytworzyć bez znajomości klucza.
Każdy standardowy schemat podpisu definiuje zalecane funkcje skrótu oraz parametry wypełnienia, a protokół TLS w wersji 1.3 przesądza o stosowaniu nowoczesnych algorytmów grupy SHA-2 i SHA-3. Gdy funkcja skrótu traci odporność na kolizje, podpisany dokument można zastąpić innym o identycznym skrócie, co udowodniono w atakach na MD5 i SHA-1. Dlatego rozważania o bezpieczeństwie podpisów zawsze obejmują również ocenę użytej funkcji skrótu.
Studenci powinni traktować podpis, skrót i wypełnienie jako spójny zespół decyzji projektowych, a nie jako niezależne elementy konfiguracji. Wybór skrótu o niewystarczającej długości może bowiem uczynić idealnie poprawny schemat podpisu całkowicie bezużytecznym. Ten pogląd wraca w praktycznych zaleceniach wdrożeniowych i podczas kontroli konfiguracji systemów.
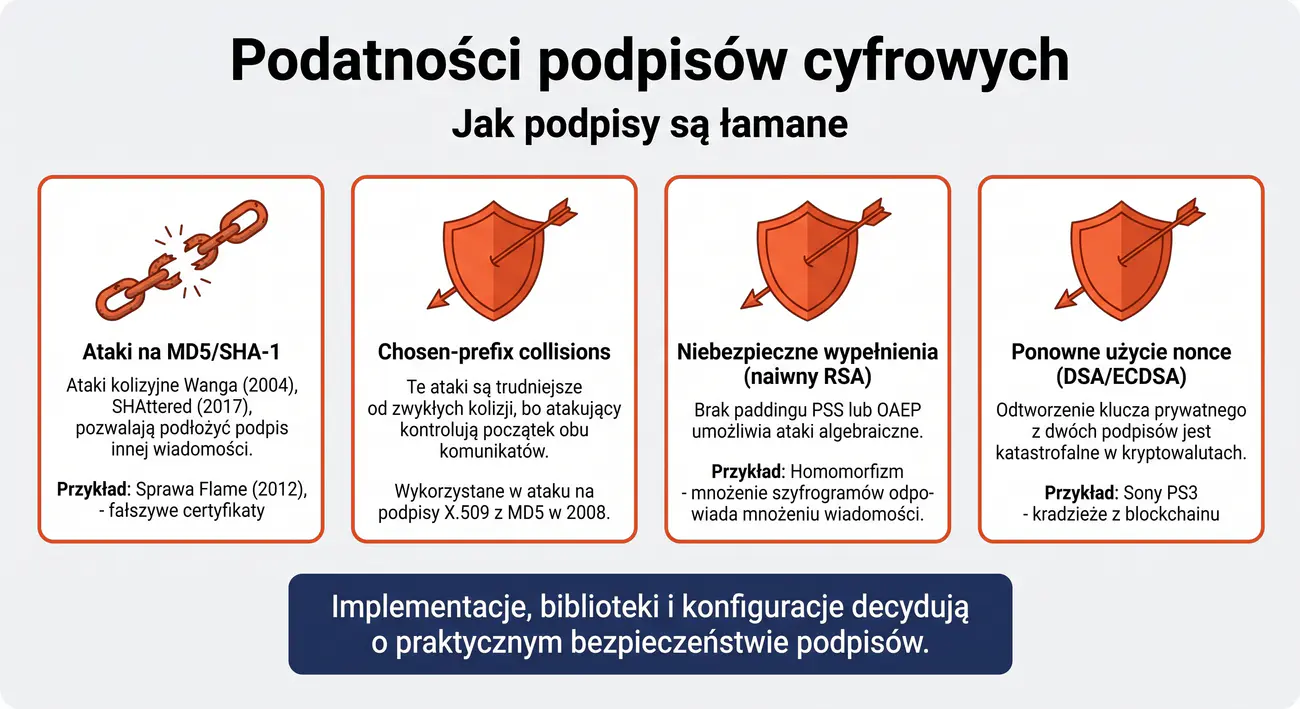
Analiza podatności podpisów dostarcza najciekawszych wniosków na temat ograniczeń schematów kryptograficznych, ponieważ ich skuteczność bywa przekreślana przez pozornie drugorzędne szczegóły. Kolizje funkcji skrótu dają napastnikowi możliwość przeniesienia ważnego podpisu z wiadomości niewinnej na przygotowaną wcześniej, a odmiana z kontrolowanym początkiem wiadomości dodatkowo ułatwia taką operację. Incydenty, takie jak fałszowanie certyfikatów czy szkodliwe oprogramowanie podpisane fałszywym kluczem, pokazują realne konsekwencje tych teoretycznych możliwości.
Niebezpieczne wypełnienia otwierają z kolei drogę atakom algebraicznym, w których właściwości homomorficzne szyfru pozwalają na manipulowanie wartościami szyfrogramów bez znajomości klucza. Ponowne użycie losowych składników w DSA i ECDSA również prowadzi do odtworzenia klucza, co obserwowano przed laty w bardzo kosztownych incydentach. Wspólnym mianownikiem tych problemów pozostaje niedostateczna staranność przy doborze parametrów i wartości losowych.
Wnioskiem z tej części materiału jest zasada rozdzielenia odpowiedzialności między projektowaniem algorytmu a jego używaniem, ponieważ wiele katastrof wynikało z błędów implementacyjnych. Korzystanie z aktualnych bibliotek, prawidłowych parametrów i dedykowanych wartości losowych znacząco obniża ryzyko. Umiejętność wyjaśnienia przyczyny konkretnych podatności stanowi przy tym ważny element oceny dojrzałości inżyniera.
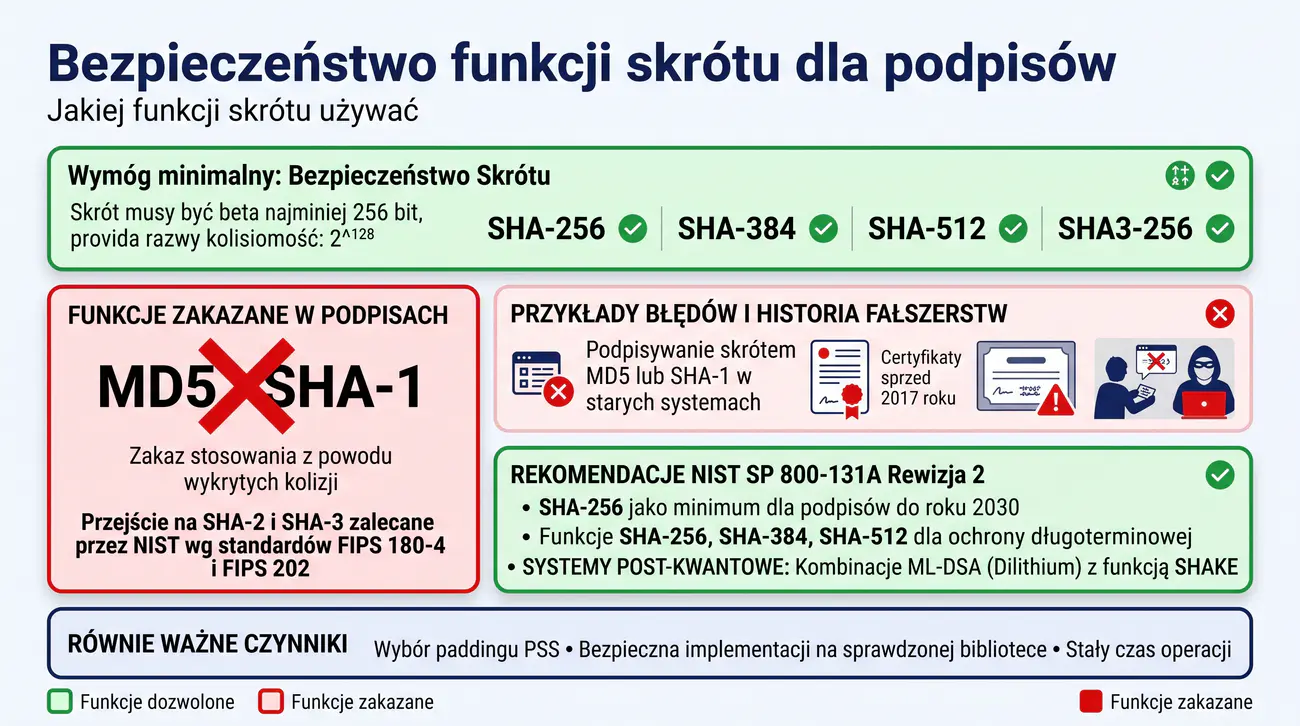
Wyboru funkcji skrótu do podpisów nie należy dokonywać na podstawie mody, lecz z uwzględnieniem poziomu bezpieczeństwa i przewidywanego okresu ochrony danych, co precyzują zalecenia instytucji normalizacyjnych. Funkcje przestarzałe, takie jak MD5 czy SHA-1, straciły odporność na kolizje i nie mogą być stosowane w żadnym nowym schemacie podpisu. W praktyce standardem pozostają funkcje z grupy SHA-2 oraz SHA-3 o wynikach nie krótszych niż 256 bitów.
Zalecenia dotyczące odporności odnoszą się zarówno do trudności znalezienia kolizji, jak i do kosztów znalezienia przeciwobrazu, dlatego długość wyniku bezpośrednio przekłada się na deklarowany poziom siły. Przy planowaniu długowiecznych systemów należałoby wybierać funkcje z dłuższym wynikiem i nowoczesne konstrukcje, takie jak rodzina SHA-3. Równolegle pojawia się wymóg stosowania bezpiecznych wypełnień oraz implementacji odpornych na ataki czasowe.
W systemach przygotowywanych na epokę kwantową rozważa się już konstrukcje oparte na funkcjach typu SHAKE, które mają dostarczać odpowiedniego marginesu bezpieczeństwa. Nawet najlepsza funkcja skrótu nie zastąpi jednak starannego projektowania całego systemu, dlatego ocenę bezpieczeństwa zawsze prowadzi się w kontekście pełnego scenariusza. Taki sposób myślenia odróżnia osoby wyłącznie mechanicznie wykonujące czynności od kompetentnych projektantów.
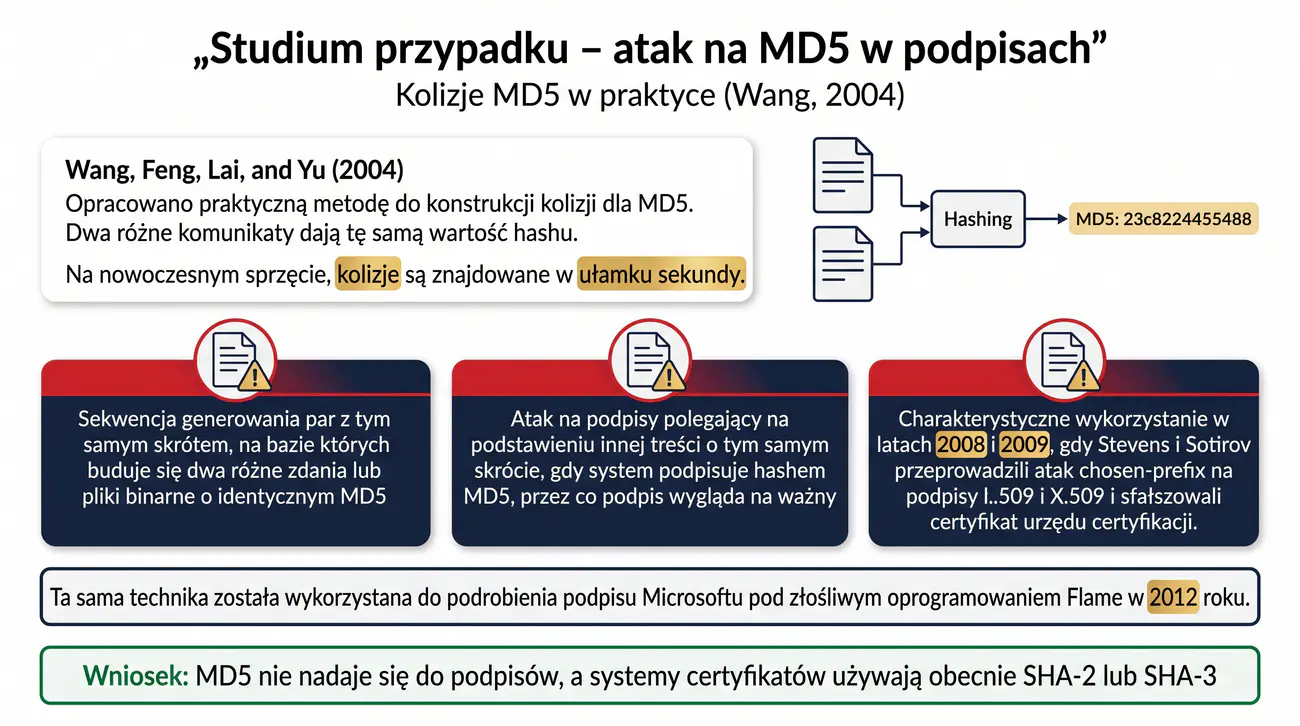
Atak na MD5 przedstawiany na slajdzie odbył się w 2004 roku, kiedy to grupa badaczy znalazła skuteczną metodę konstruowania kolizji, czyli dwu różnych wiadomości o identycznym skrócie. Wykorzystała w tym celu specyficzne zależności różnicowe w funkcji kompresji, dzięki czemu generowanie par oszukańczych dokumentów stało się zadaniem wykonalnym w czasie rzeczywistym. Dalsze prace przeniosły te osiągnięcia na trudniejszy wariant, w którym atakujący kontroluje początkową część treści.
Tak zwane kolizje z kontrolowanym początkiem, przedstawione w demonstracji z 2008 roku, posłużyły do sfałszowania certyfikatu urzędu certyfikacji, co pokazało podatność infrastruktury zaufania. Podobna technika wystąpiła później w szkodliwym oprogramowaniu, gdzie sfałszowano podpis umożliwiający rozpowszechnianie kodu w infrastrukturze systemowej. Te incydenty utwierdziły środowisko w przekonaniu o konieczności rezygnacji z MD5 we wszelkich zastosowaniach związanych z bezpieczeństwem.
Dzisiejsze systemy certyfikatów i podpisów świadomie unikają MD5, a wszystkie wdrożenia sprawdzają zgodność zastosowanych funkcji z aktualnymi zaleceniami. Historia tego algorytmu pozostaje jednak najlepszym przykładem, w jaki sposób teoretyczne słabości funkcji skrótu przekładają się na praktyczne zagrożenia. Dzięki analizie tych przypadków wyrabia się krytyczne podejście do zaufania technicznego w kryptografii.
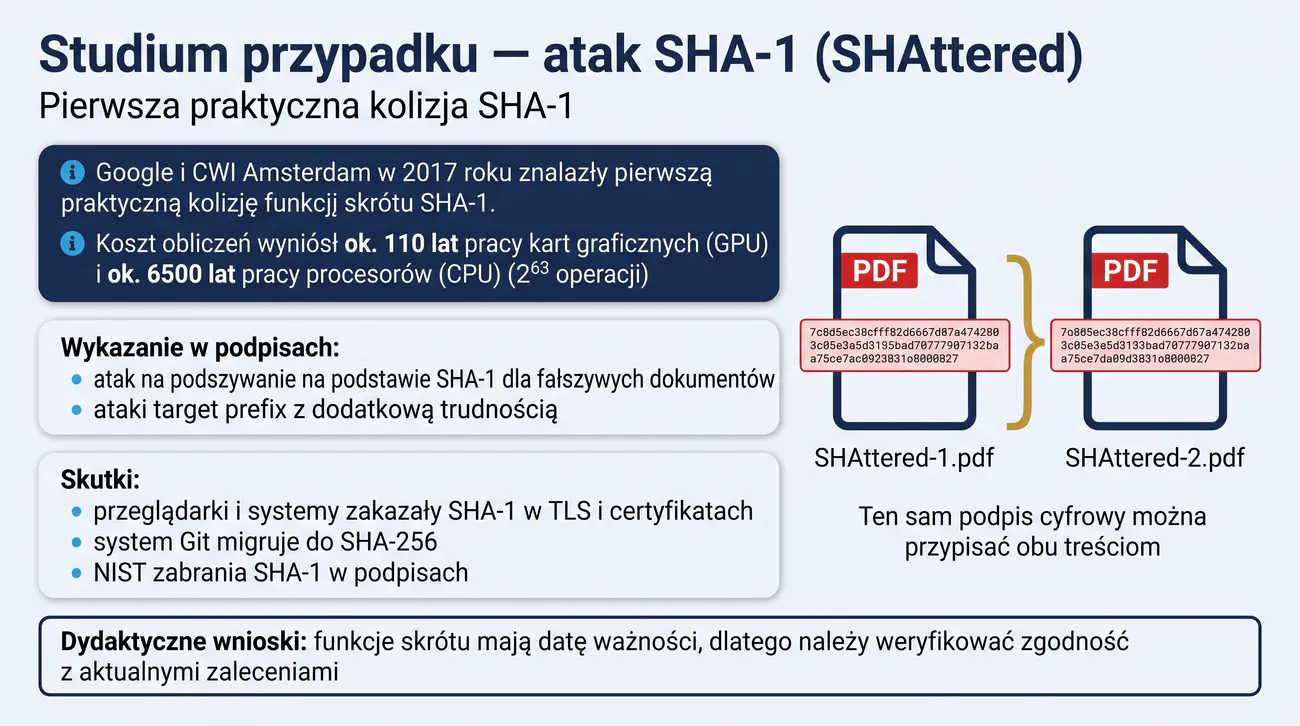
Atak na SHA-1 ogłoszony w 2017 roku przez zespół z Google i CWI w Amsterdamie uzyskał pierwsze praktyczne kolizje dla tej funkcji, kończąc tym samym okres względnego zaufania do jej bezpieczeństwa. Koszt obliczeniowy, szacowany na tysiące lat pracy procesorów i ponad sto lat pracy kart graficznych, był ogromny, lecz wciąż osiągalny dla wyspecjalizowanych zespołów. Wystarczyło przy tym przygotować dwa dokumenty o różnej treści wizualnej i identycznym skrócie, aby udokumentować zagrożenie.
Realne konsekwencje objęły migrację oprogramowania do kontroli wersji, wycofanie certyfikatów opartych na SHA-1 oraz odrzucenie tego algorytmu w protokołach komunikacyjnych. W środowisku systemów kontroli wersji przejście na dłuższe skróty wymagało nowych formatów danych i zmiany procedur. Doświadczenia te pokazały, że nawet algorytmy o długiej historii mogą wymagać nieoczekiwanego wycofania, dlatego planowanie przeciwdziałania awariom stanowi element strategii bezpieczeństwa.
Lekcja płynąca z tego ataku podkreśla znaczenie śledzenia postępów w kryptoanalizie oraz wcześniejszego wyznaczania terminów przejścia na nowsze rozwiązania. Warto umieć ocenić, kiedy dana funkcja skrótu znajduje się w strefie ryzyka, i potrafić uzasadnić ten wniosek argumentami. Takie przygotowanie ułatwia podejmowanie decyzji w zespołach odpowiedzialnych za bezpieczeństwo istniejących systemów.
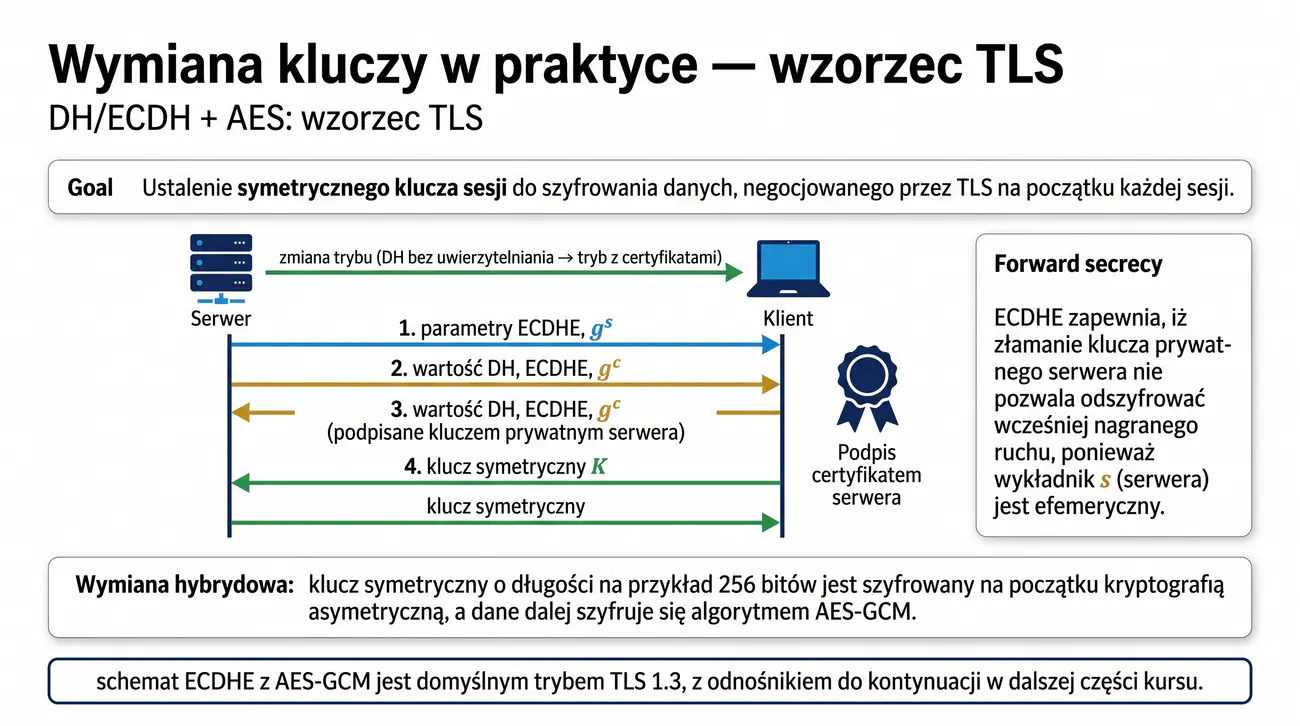
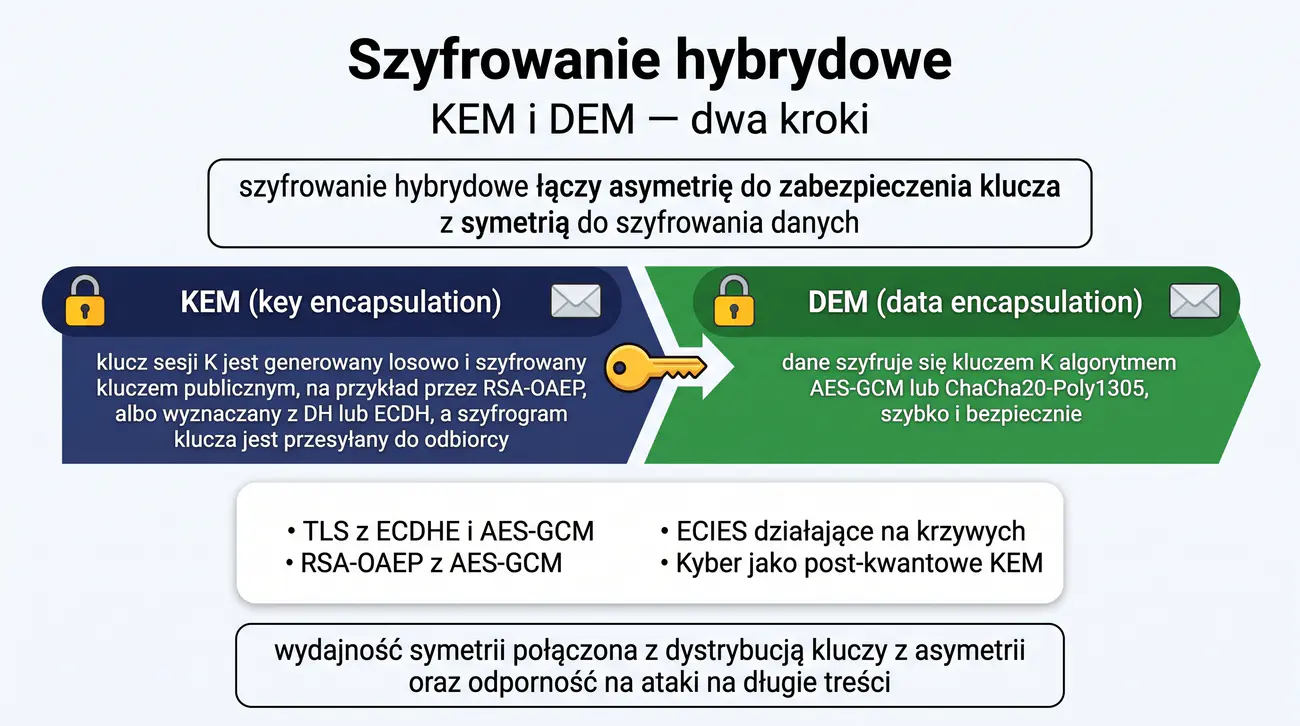
Protokół TLS wykorzystuje przedstawioną na slajdzie kombinację uzgadniania kluczy i szyfrowania symetrycznego, tworząc w ten sposób spójny mechanizm bezpiecznej komunikacji. W fazie negocjacji strony ustalają parametry kryptograficzne oraz uzgadniają wspólny sekret, z którego wyprowadzane są klucze do obu kierunków transmisji. Taki podział zadań umożliwia połączenie wolniejszej, ale elastycznej kryptografii asymetrycznej z szybkim szyfrowaniem blokowym.
Wariant z ulotnymi wartościami, oznaczany skrótem ECDHE, sprawia, że każda sesja korzysta z nowych parametrów tymczasowych, a złamanie długoterminowego klucza serwera nie pozwala odszyfrować wcześniej przechwyconego ruchu. Właściwość ta, nazywana tajnością w przód, należy obecnie do standardowych cech dobrej jakości konfiguracji TLS. Negocjowane przez strony algorytmy, w tym warianty szyfrowania AEAD, decydują o faktycznym poziomie bezpieczeństwa połączenia.
Istotne jest zrozumienie, że przedstawiony schemat stanowi wzorzec dla wielu innych protokołów, takich jak bezpieczna sieć VPN czy rozmaite systemy kryptograficzne. W dalszej części kursu, poświęconej infrastrukturze klucza publicznego i protokołom, omówione elementy wrócą już w pełnej strukturze handshake. Poznanie tego wzorca pomaga analizować komunikację sieciową i diagnozować nieprawidłowe konfiguracje.
Szyfrowanie hybrydowe łączy kryptografię asymetryczną z symetryczną w taki sposób, aby wykorzystać mocne strony obu rodzajów rozwiązań, czyli elastyczność dystrybucji kluczy i szybkość przetwarzania danych. Pierwszy etap, zwany owijaniem klucza, polega na zabezpieczeniu niewielkiej wartości sekretnej, która następnie służy do symetrycznego szyfrowania danych. Drugi etap, czyli właściwe szyfrowanie danych, wykonuje się już w szybkich trybach AEAD, które zapewniają także uwierzytelnianie.
Każde wdrożenie musi przy tym zadbać o poprawne wyprowadzenie kluczy i o unikalność wartości początkowych dla kolejnych komunikatów, ponieważ naruszenie tych zasad psuje całość nawet przy silnych algorytmach. Wariant oparty na krzywych, znany jako ECIES, stanowi współczesny przykład łączący matematykę krzywych z ochroną symetryczną. Właśnie tego typu schematy znalazły się u podstaw najnowszych standardów kryptografii postkwantowej.
Liczba dokumentów normatywnych opisujących te mechanizmy rośnie z każdą kolejną rewizją standardów, co wymaga od integratorów bieżącego śledzenia zmian. Dla praktyka najważniejszy jest jednak prosty wniosek o podziale zadań i o niezbędnej kontroli nad każdym składnikiem całości. To właśnie takie połączenie daje zarówno bezpieczeństwo, jak i wydajność w systemach pracujących na dużą skalę.
Zagrożenie ze strony komputerów kwantowych wynika z możliwości rozwiązania pewnych problemów matematycznych w czasie wielomianowym przez algorytm Shora, a nie z jakiejkolwiek słabości samych szyfrów. Faktoryzacja i logarytm dyskretny, a z nimi systemy RSA, DH, DSA i ECDSA, straciłyby bezpieczeństwo, gdyby nie przygotowane plany zastępcze. Mniej groźny w skutkach algorytm Grovera dotyka jedynie szyfrów symetrycznych i funkcji skrótu, wymagając raczej powiększenia długości kluczy.
Równolegle do rozwoju komputerów kwantowych obserwujemy strategię przechwycenia danych teraz i ich odszyfrowania później, w myśl której napastnicy archiwizują dziś ruch w nadziei na przyszłą dekryptację. Dlatego organizacje przetwarzające dane o długim okresie ważności zaczynają już przygotowywać migrację na konstrukcje odporne na ataki kwantowe. Standardowe rodziny kryptografii postkwantowej, oparte między innymi na sieciach kratowych, kodach korekcyjnych i funkcjach skrótu, dają do tego odpowiednie narzędzia.
Warto podchodzić do zagadnienia pragmatycznie i rozumieć, że komputer kwantowy wystarczającej wielkości może jeszcze długo nie powstać, ale koszty przygotowania i przejścia są tak duże, że odpowiedzialne projektowanie należy zacząć już dziś. Najczęściej wskazane jest stosowanie rozwiązań hybrydowych, łączących klasyczne algorytmy z ich kwantowymi odpowiednikami. Takie podejście daje bezpieczeństwo niezależnie od tego, który nurt rozwoju techniki zwycięży.
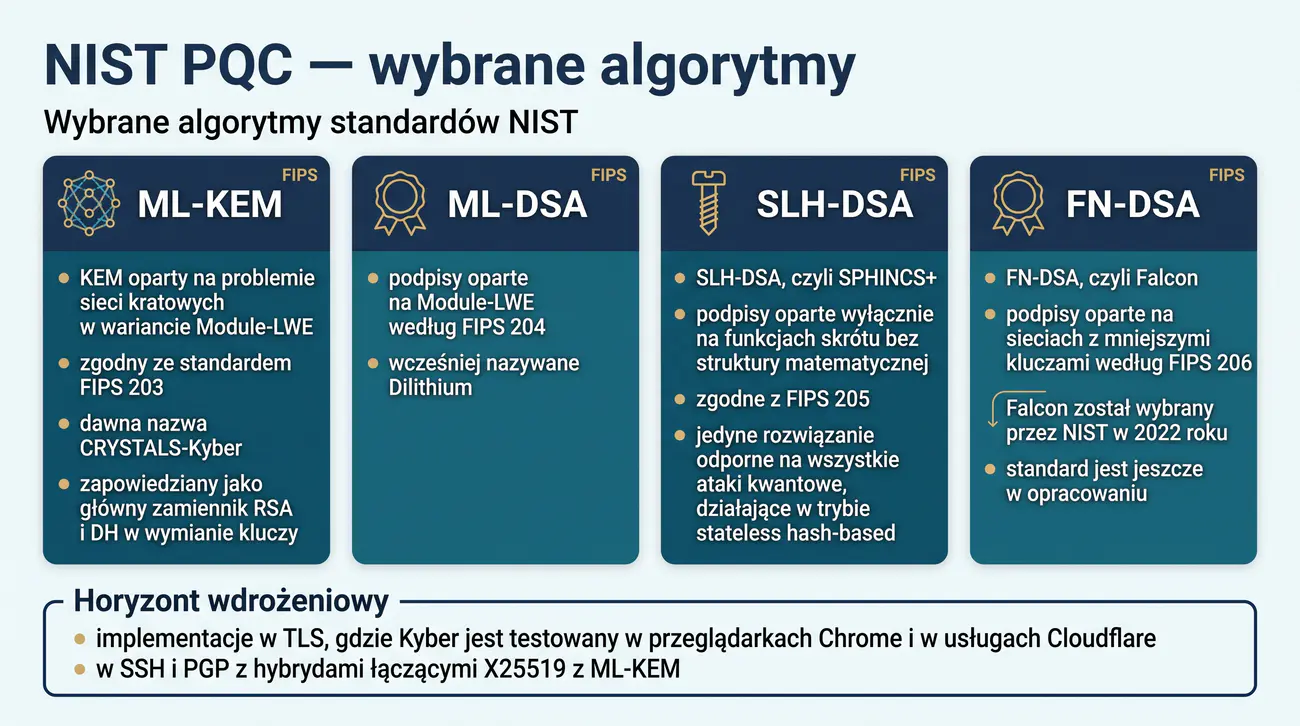
Z prac normalizacyjnych nad kryptografią postkwantową wyłoniły się pierwsze gotowe konstrukcje, z których każda pełni ściśle określoną rolę w architekturze przyszłych systemów. ML-KEM, przeznaczony do owijania kluczy, stanowi odpowiedź na potrzebę bezpiecznej wymiany materiału w erze kwantowej, podczas gdy ML-DSA dostarcza z kolei mechanizmu podpisów o równoważnej odporności. Szczególne miejsce zajmuje konstrukcja oparta wyłącznie na funkcjach skrótu, która wyróżnia się prostotą uzasadnienia bezpieczeństwa i niewielkim zaufaniem do złożonej struktury algebraicznej.
Jako kolejny element przygotowywanych standardów wybrano wcześniej schemat FN-DSA, rozwijany pod roboczą nazwą Falcon i oparty na sieciach kratowych, który wyróżnia się wyjątkowo zwartą postacią podpisu. Decyzja o jego przyjęciu zapadła jeszcze w roku 2022, jednak dokument normalizacyjny FIPS 206 pozostawał przez lata w stadium projektu i dyskusji. Projekt przesłano do zatwierdzenia w sierpniu 2025 roku, a finalną publikację zaplanowano na przełom lat 2026 i 2027.
Decyzje środowiska normalizującego oraz producentów wpływają na tempo wdrażania nowych algorytmów w przeglądarkach, narzędziach i bibliotekach, gdzie zastosowanie znalazły już między innymi warianty hybrydowe łączące krzywe z konstrukcjami kratowymi. Dla praktyka oznacza to konieczność monitorowania kompatybilności i aktualności używanych standardów. Studenci powinni zatem rozumieć, że dojrzałość algorytmu zależy nie tylko od publikacji dokumentu, lecz także od jego realizacji w realnym oprogramowaniu.
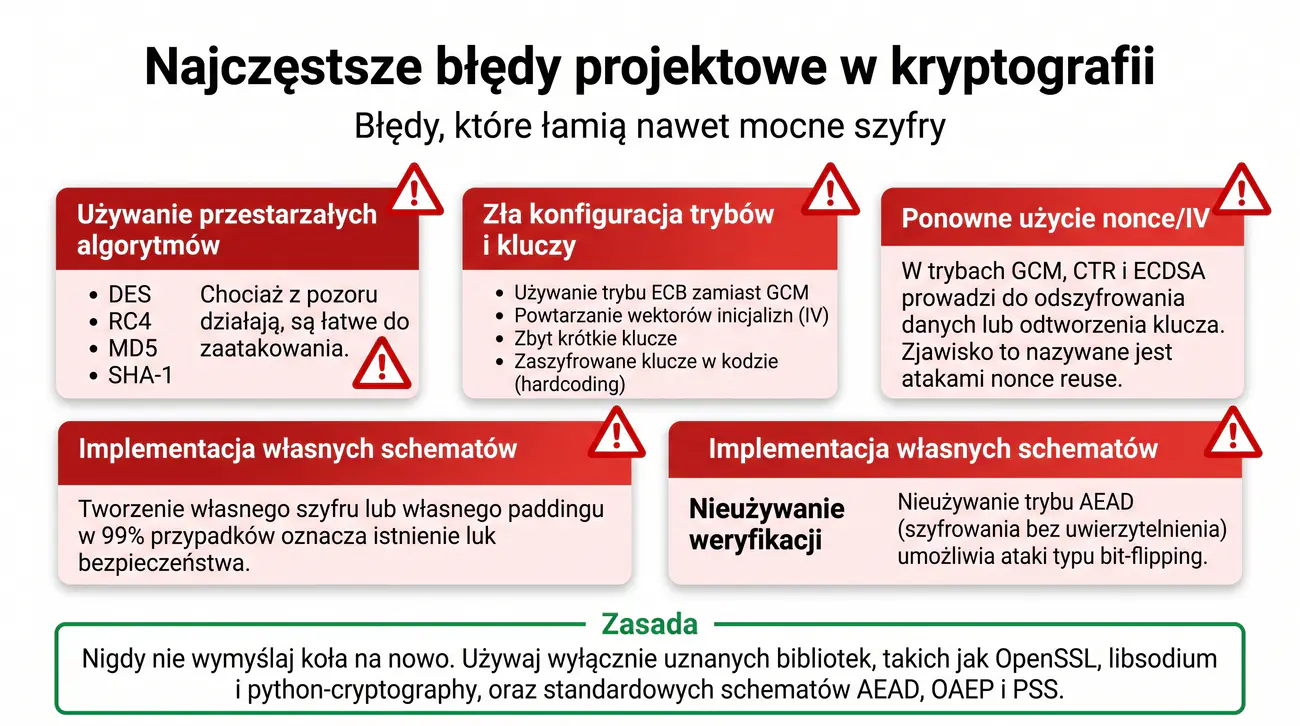
Większość opisanych w tej części wykładu katastrof bezpieczeństwa nie wynika z zastosowania matematycznie słabych konstrukcji, lecz z błędów projektowych popełnianych przez programistów systemów. Typowe pomyłki obejmują przestarzałe algorytmy, niewłaściwe tryby pracy, ponowne użycie wektorów inicjalizujących, a także pomijanie uwierzytelniania wiadomości w schematach szyfrowania. Każda z tych decyzji, pozornie usprawiedliwiona napiętym harmonogramem projektu, tworzy możliwość ataku niezależną od siły samego szyfru.
Poważny problem stanowi także praktyka kształtowania własnych rozwiązań kryptograficznych przez zespoły bez odpowiedniego zaplecza, ponieważ w dziedzinie kryptografii nie da się w dowodowy sposób zagwarantować bezpieczeństwa konstrukcji. Zjawisko to dotyczy zarówno własnych szyfrów, jak i nietypowych schematów wypełniania oraz niestandardowych sposobów wyprowadzania kluczy. Wobec dostępnych, starannie zbadanych standardów decyzja o sięgnięciu do własnych pomysłów pozostaje prawie zawsze błędem.
Szyfrowanie bez uwierzytelniania zamyka listę najczęstszych braków, gdyż umożliwia modyfikację danych bez naruszenia samego procesu deszyfrowania. W konsekwencji nowoczesne rekomendacje wymagają, aby komunikacja chroniona była z użyciem schematów AEAD, które łączą te dwa rodzaje ochrony w jednym mechanizmie. Przyswojenie tych zasad jest warunkiem budowania rozwiązań odpornych na realne ataki.
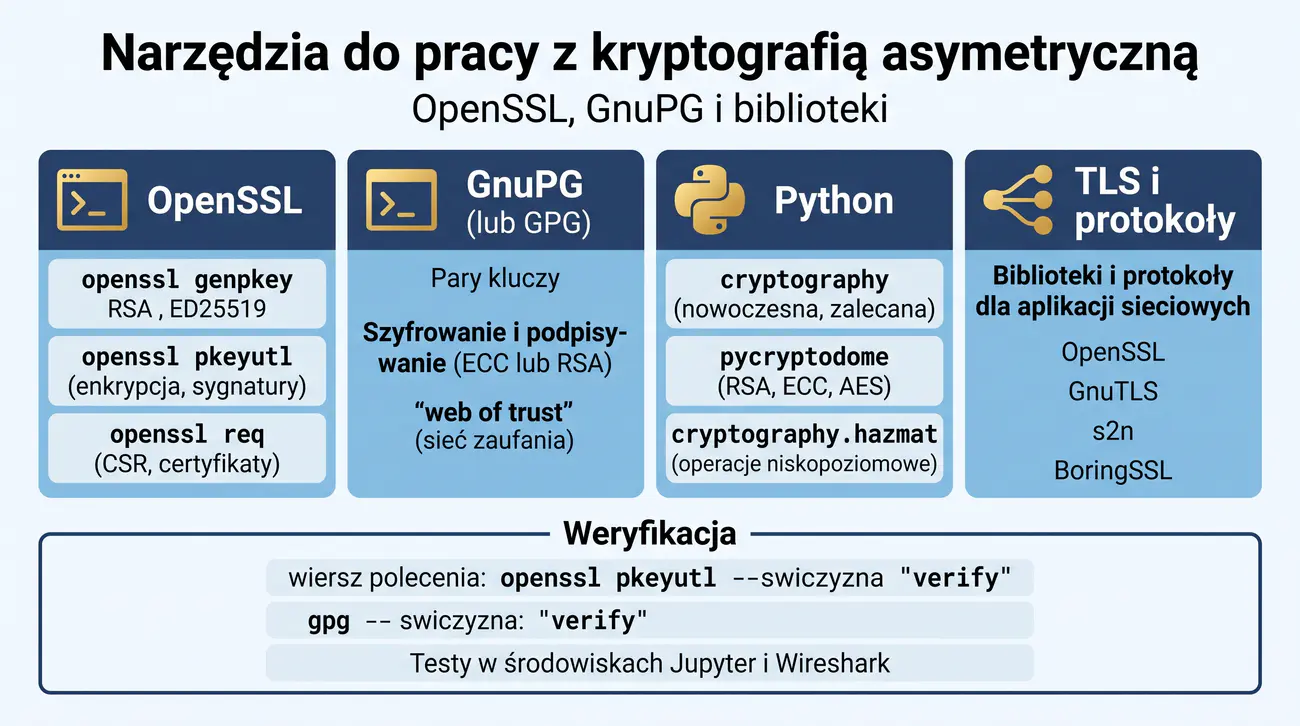
cryptography (nowoczesna, zalecana) i pycryptodome (RSA, ECC, AES); cryptography.hazmat dla niskopoziomowych operacji.Narzędzia takie jak OpenSSL, GnuPG czy biblioteki języka Python należą do podstaw wyposażenia każdego inżyniera bezpieczeństwa, ponieważ oferują zweryfikowane implementacje wszystkich kluczowych mechanizmów. Polecenia OpenSSL pozwalają wykonywać operacje na kluczach, certyfikatach i wiadomościach z linii poleceń, co bywa wygodne przy automatyzacji i testowaniu. Natomiast GnuPG zapewnia praktyczną obsługę szyfrowania i podpisów w środowisku znanym z narzędzi pocztowych i repozytoriów oprogramowania.
Korzystanie z bibliotek programistycznych wymaga zrozumienia różnic między interfejsami wysokopoziomowymi a tak zwanymi warstwami ryzyka, które udostępniają składniki wymagające szczególnej ostrożności. Biblioteka w Pythonie udostępnia zarówno prosty, bezpieczny interfejs, jak i warstwę eksperymentalną, którą należy stosować tylko w uzasadnionych przypadkach. Umiejętność właściwego wyboru funkcji z zakresu oferowanych interfejsów decyduje o bezpieczeństwie pisanego oprogramowania.
Równie ważne jak biblioteki są procedury weryfikacji wyników, dlatego w materiałach pojawiają się przykłady porównywania podpisów i skrótów przy użyciu niezależnych narzędzi. Dzięki temu można wykryć błędy konfiguracji i upewnić się, że operacje wykonano zgodnie z intencją. Znajomość zestawu narzędzi oraz dobrych nawyków ich stosowania przekłada się wprost na jakość pracy przyszłych specjalistów.
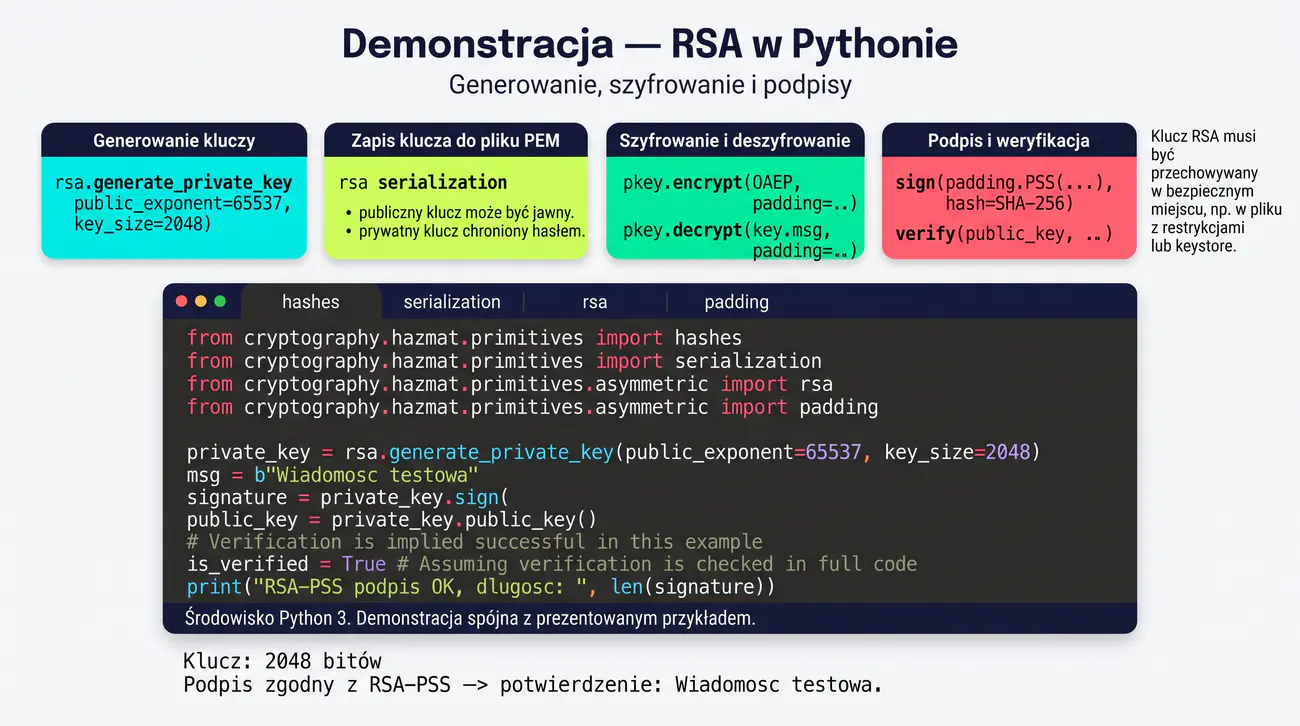
$ python3 -c from cryptography.hazmat.primitives import hashes, serialization from cryptography.hazmat.primitives.asymmetric import rsa, padding key = rsa.generate_private_key(public_exponent=65537, key_size=2048) msg = b"Wiadomosc testowa" sig = key.sign(msg, padding.PSS(mgf=padding.MGF1(hashes.SHA256()), salt_length=padding.PSS.MAX_LENGTH), hashes.SHA256()) key.public_key().verify(sig, msg, padding.PSS(mgf=padding.MGF1(hashes.SHA256()), salt_length=padding.PSS.MAX_LENGTH), hashes.SHA256()) print("RSA-PSS podpis OK, dlugosc:", len(sig))
Demonstracja w języku Python korzysta z biblioteki, która w sposób bezpieczny łączy generowanie kluczy, szyfrowanie, podpisywanie i weryfikację, eliminując tym samym ryzyko błędów w ręcznej arytmetyce. Funkcja generująca klucz przyjmuje odpowiednio duży wykładnik i rozmiar klucza, a jej wynik zawiera wewnętrznie powiązane komponenty potrzebne do wszystkich operacji. Serializacja kluczy do formatu PEM pozwala zapisać je w plikach, przy czym prywatny materiał chroniony jest dodatkowym hasłem lub prawami dostępu.
Prezentowany fragment pokazuje podpisywanie danych z wypełnieniem PSS oraz weryfikację przy użyciu klucza publicznego, co obrazuje pełny cykl pracy z podpisami w praktyce. W przypadku próby podpisania lub weryfikacji zmienionej przez napastnika treści, biblioteka zgłosi błąd, co jest pożądanym zachowaniem zabezpieczającym integralność danych. Dzięki temu można uruchomić gotowy przykład i obserwować różnicę między poprawnym podpisaniem a próbą modyfikacji treści.
Zapoznanie się z przykładem powinno obejmować również eksperymenty własne, takie jak zmiana rozmiaru klucza czy użycie innego wypełnienia, co ułatwia zrozumienie wpływu parametrów na wynik. Znajomość tego rodzaju kodu przygotowuje do prac projektowych i do oceny rozwiązań stosowanych w komercyjnym oprogramowaniu. Tego typu ćwiczenia stanowią jednocześnie podstawę do dalszych zadań laboratoryjnych przewidzianych w programie przedmiotu.
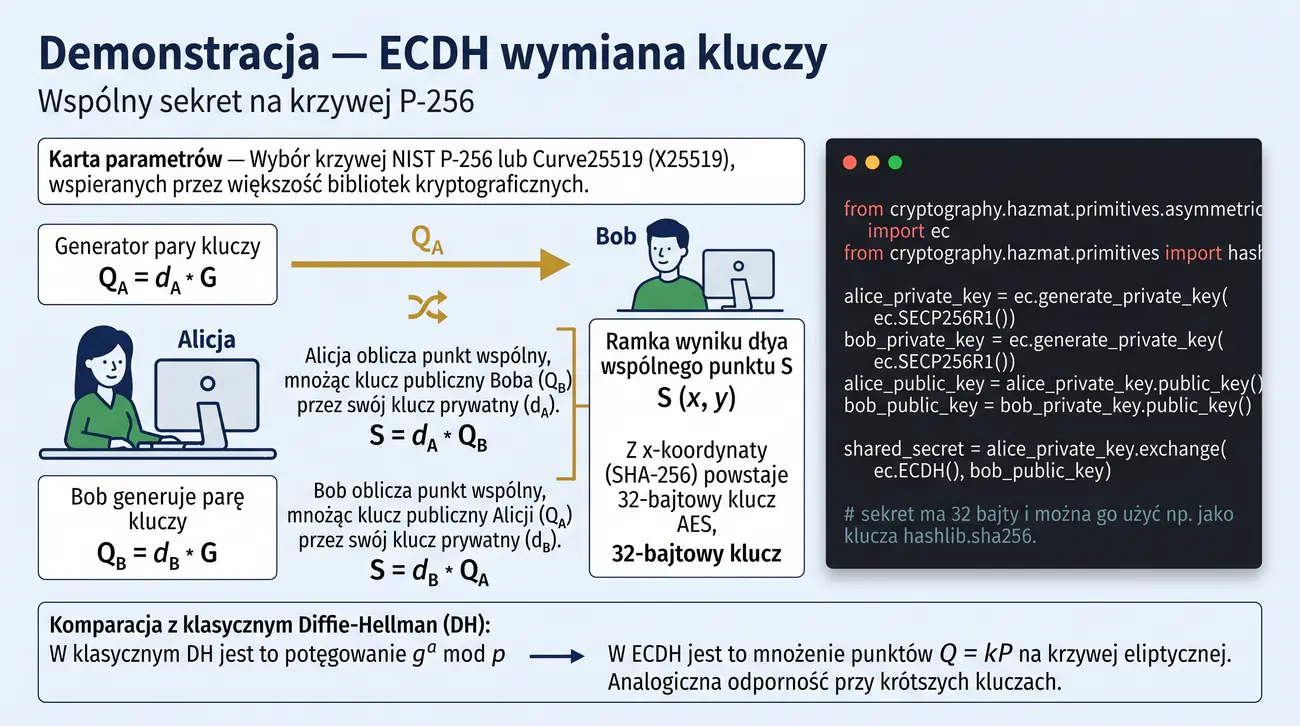
$ python3 -c from cryptography.hazmat.primitives.asymmetric import ec alice = ec.generate_private_key(ec.SECP256R1()) bob = ec.generate_private_key(ec.SECP256R1()) sekret = alice.exchange(ec.ECDH(), bob.public_key()) # sekret = 32B; użyj np. hashlib.sha256 jako klucz
Demonstracja wymiany kluczy opiera się na krzywej, której parametry zapisane są w bibliotece jako gotowe stałe, dzięki czemu programista nie musi samodzielnie definiować współczynników równania. Każda ze stron generuje parę kluczy, a następnie oblicza wspólny sekret na podstawie klucza publicznego partnera. Wynik tych obliczeń jest liczbą o ustalonej długości, która sama w sobie nie jest jeszcze gotowym kluczem sesyjnym.
W praktyce uzgodniona wartość przepuszcza się przez funkcję skrótu lub zaawansowany mechanizm wyprowadzania kluczy, aby uzyskać materiał o właściwościach wymaganych przez algorytmy symetryczne. Taka pośrednia obróbka oddziela mechanizm uzgadniania od szczegółów szyfrowania i pozwala stosować tę samą wymianę w różnych protokołach. Warto zwrócić uwagę na rolę bezpiecznej losowości w wyprowadzaniu kluczy oraz na konieczność zachowania wartości w pamięci tylko tak długo, jak jest potrzebna.
Porównanie z klasycznym protokołem pozwala dostrzec, że zmiana grupy operacji z potęgowania na mnożenie punktów nie narusza ogólnej struktury, a jedynie poprawia wydajność i zmniejsza objętość przesyłanych danych. Znajomość tej oszczędności pomaga uzasadnić wybór krzywych w nowoczesnych systemach tam, gdzie liczy się przepustowość i zasoby. Wykonanie demonstracji w interpreterze stanowi dobry punkt wyjścia do samodzielnych prac z protokołami.
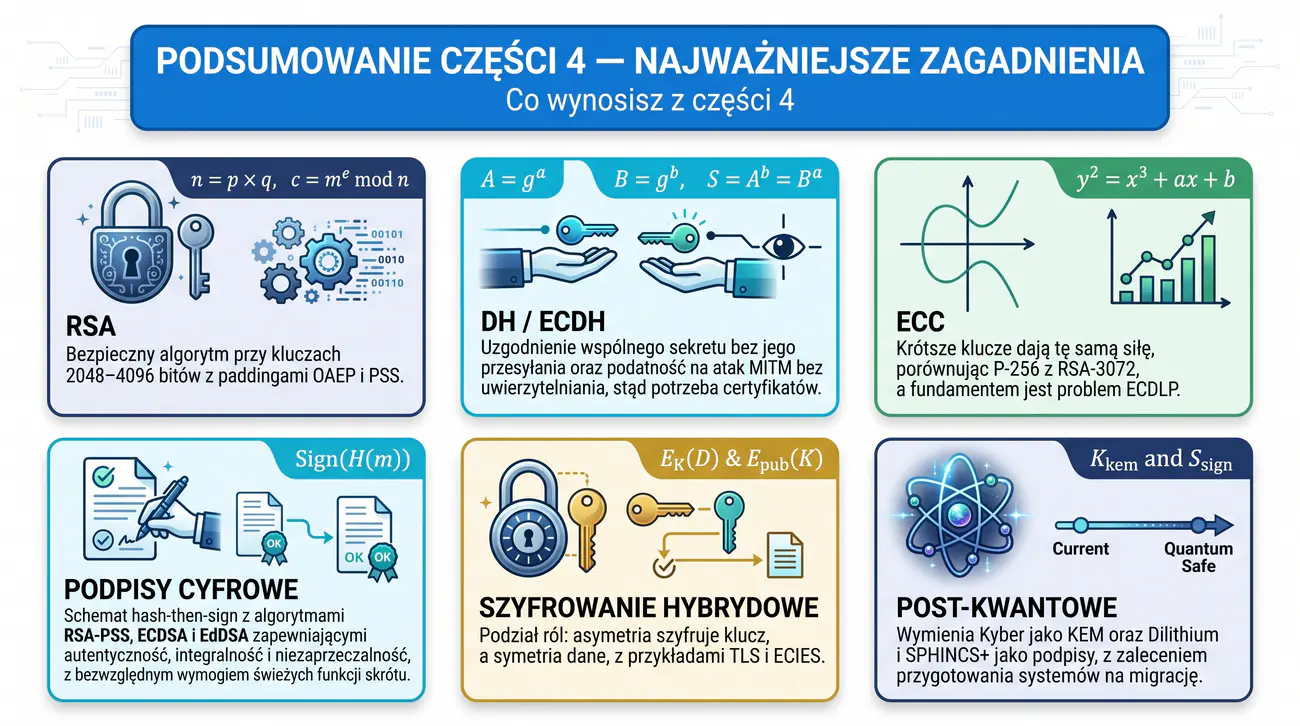
Podsumowanie części 4 porządkuje wiedzę wokół kilku skal: matematycznych podstaw, rozmiarów kluczy, schematów podpisów i charakteru zastosowań kryptograficznych. Dzięki takiemu uporządkowaniu można szybko przypomnieć sobie, które rodziny algorytmów odpowiadają za które operacje oraz dlaczego ich łączenie jest konieczne. Jest to także naturalny moment do dokonania samooceny i wytypowania zagadnień wymagających dalszych ćwiczeń.
Warto podczas powtórki zwrócić uwagę na powtarzające się motywy, takie jak rola trudnych problemów obliczeniowych, znaczenie odpowiednich parametrów czy wrażliwość na błędy w użyciu. Właśnie te powtarzające się reguły, a nie pojedyncze algorytmy, stanowią trwałą wiedzę wyniesioną z kursu. Zauważenie ich ułatwia analizowanie nowych konstrukcji pojawiających się w literaturze.
Zdobyte kompetencje znajdą bezpośrednie zastosowanie w kolejnych częściach kursu, poświęconych infrastrukturze klucza publicznego, protokołom i systemom przechowywania danych. Dobrze opanowana wiedza teoretyczna stanowi przy tym podstawę do rozwiązywania zadań praktycznych z użyciem narzędzi. Dlatego warto poświęcić czas na powtórkę, zanim przejdzie się do następnych tematów.
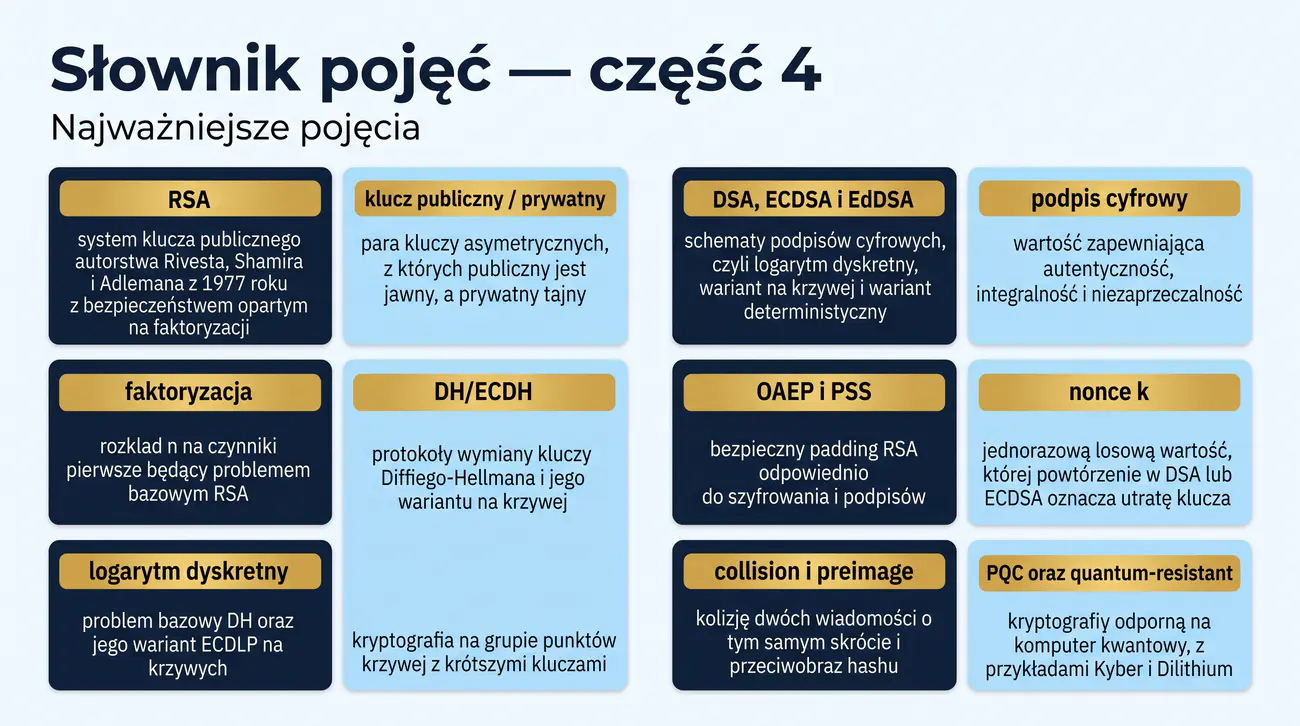
Słownik zebrany na tym slajdzie to nie zwykła lista haseł, lecz praktyczne narzędzie pracy, z którego można korzystać w trakcie rozwiązywania zadań i powtórek. Pozycje, takie jak faktoryzacja, logarytm dyskretny czy problem ECDLP, układają się w grupy odpowiadające kolejnym częściom wykładu, co ułatwia odszukanie szerszego kontekstu każdego terminu. Zamiast uczyć się definicji na pamięć, warto sięgać do słownika wtedy, gdy w tekście lub kodzie pojawia się niejasność.
Porządkowanie każdego zagadnienia wokół tej samej struktury, czyli definicji, roli w algorytmie i zagrożenia, pozwala szybko porównywać terminy między sobą. Powiązanie hasła z konkretnym przykładem liczbowym lub fragmentem programu wzmacnia przy tym pamięć i zrozumienie. Taki schemat pracy jest naturalnym sposobem notowania w dziedzinie kryptografii.
W trakcie powtórek słownik można potraktować jako listę zagadnień do sprawdzenia, odpowiadając sobie na każde hasło bez pomocy notatek. Gdy definicja okazuje się niejasna, najlepiej wrócić do odpowiedniego slajdu i przeczytać materiał w szerszym kontekście. Taka metoda pozwala szybko zdiagnozować luki w wiedzy przed podejściem do kolokwium.
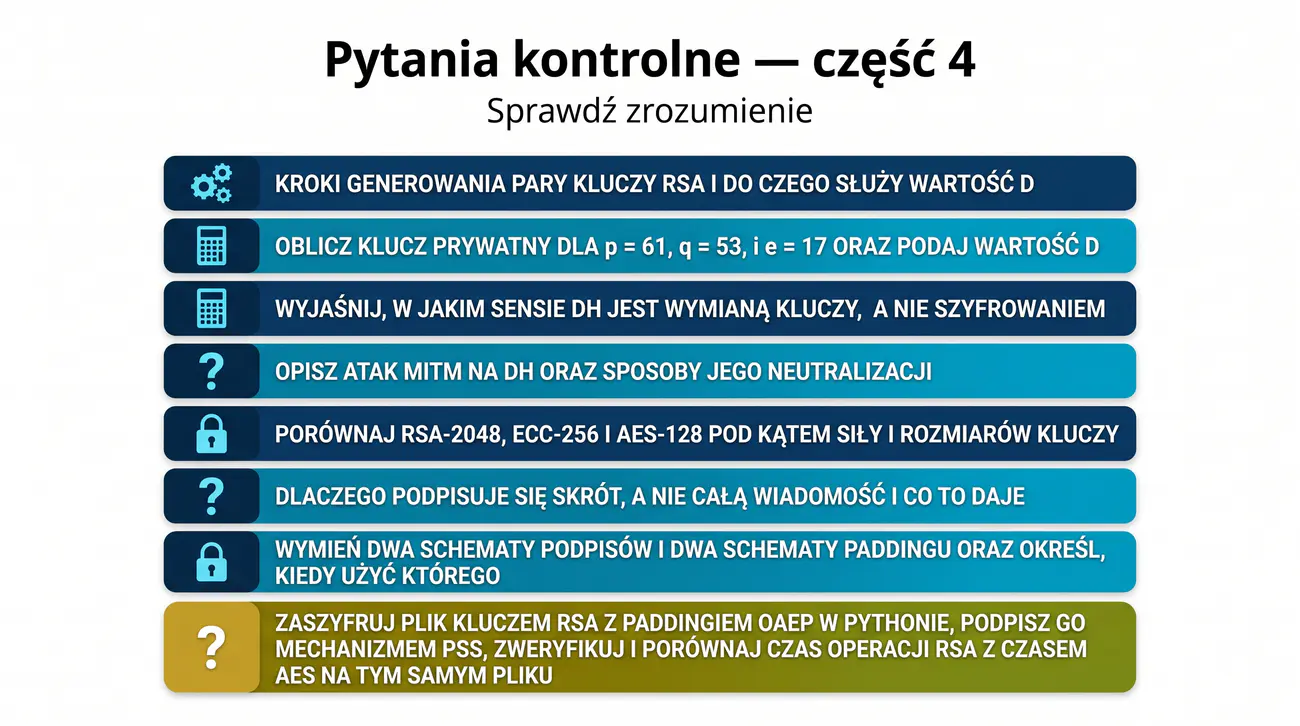
Pytania kontrolne zebrane na tym slajdzie pozwalają samodzielnie ocenić, jak głęboko opanowana została wiedza z części czwartej. Część pytań ma charakter obliczeniowy, na przykład wymaga wyznaczenia klucza prywatnego dla danych liczb pierwszych, a inne dotyczą rozumienia pojęć i różnic między mechanizmami. Dzięki takiemu zróżnicowaniu pytania sprawdzają zarówno sprawność rachunkową, jak i zdolność opisywania działania algorytmów własnymi słowami.
Najlepszy efekt przynosi próba udzielenia odpowiedzi bez zaglądania do notatek, a dopiero później porównanie jej z treścią slajdów. Przy pytaniu o generowanie kluczy RSA należy zachować pełną kolejność kroków, począwszy od wyboru liczb pierwszych, przez obliczenie funkcji Eulera, aż po wyznaczenie wykładnika odwrotnego. Przykładowo dla p równego 61, q równego 53 oraz e równego 17, poprawne d wynosi 2753, co można szybko zweryfikować mnożeniem.
Regularne odpytywanie się przy użyciu takiej listy pomaga utrwalić materiał w sposób trwały i ujawnia tematy wymagające dodatkowej pracy. Warto przy tym zapisywać zagadnienia, które sprawiły trudność, i wracać do nich po wykonaniu kolejnych przykładów. Tak zorganizowana powtórka okazuje się znacznie skuteczniejsza niż bierne przeglądanie slajdów.
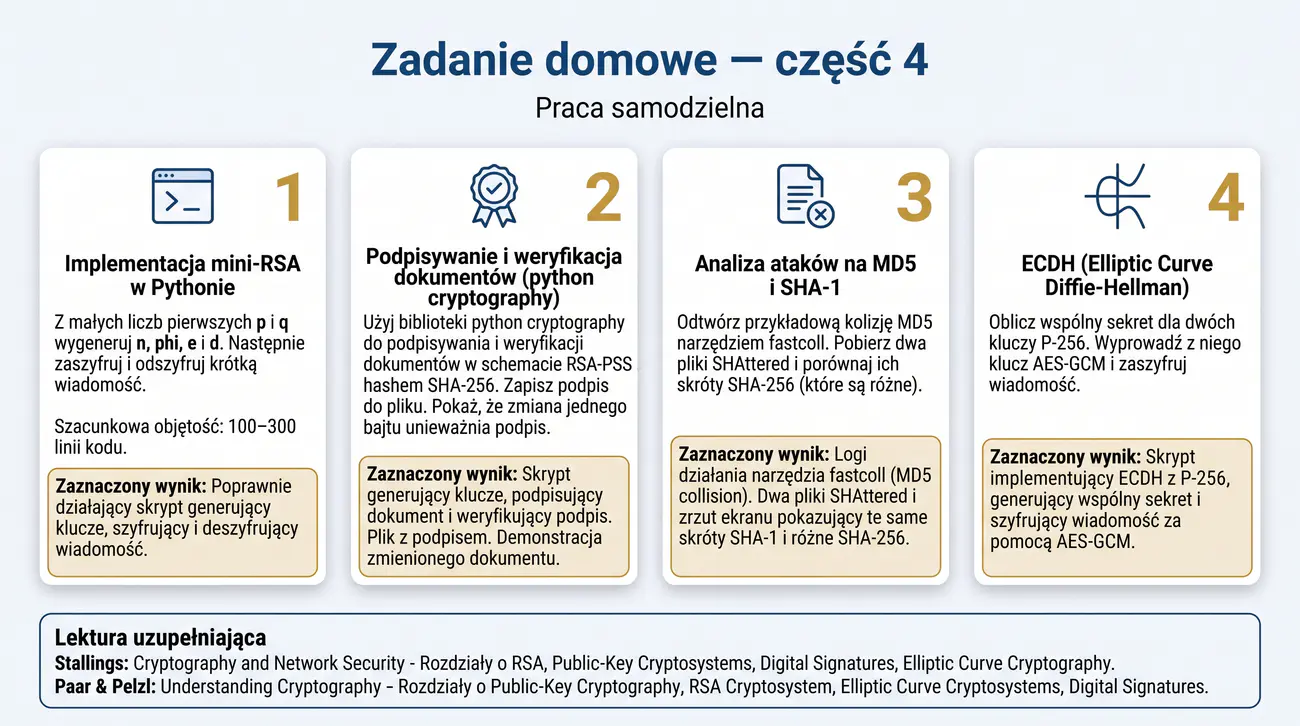
Zadanie domowe zamykające część czwartą łączy pracę z kodem, obsługę bibliotek oraz analizę historycznych ataków, dzięki czemu wykorzystuje w praktyce całą zdobytą wiedzę. Pierwszy etap polega na samodzielnym zbudowaniu mini-RSA w Pythonie na podstawie małych liczb pierwszych, co wymaga zaprogramowania szyfrowania, deszyfrowania i wyznaczania klucza prywatnego. Zapisanie takiego programu od zera buduje zrozumienie, którego nie daje samo odczytanie gotowego przykładu.
Druga część zadania przenosi doświadczenia na standardowe narzędzie i polega na podpisaniu dokumentu z użyciem RSA-PSS oraz funkcji skrótu, a następnie na sprawdzeniu, że zmiana nawet jednego bajtu treści powoduje niepowodzenie weryfikacji. Wykonanie tego kroku pozwala w praktyce poznać rolę wypełnienia i schematu hash-then-sign, które zajmują tak ważne miejsce w treści wykładu. Zapisanie podpisu do pliku i ponowne jego odczytanie przy okazji wprowadza w tematykę formatów danych.
Końcowy element zadania dotyczy funkcji skrótu i polega na wytworzeniu oraz przeanalizowaniu kolizji MD5, a także na porównaniu wyników z nowoczesnym skrótem SHA-256. Taka konfrontacja dawnych i obecnych rozwiązań obrazuje w najprostszy sposób, dlaczego przestarzałe funkcje zostały wycofane z użycia. Tempo wykonania całego zadania warto zaplanować z wyprzedzeniem, aby móc skonsultować pojawiające się wątpliwości.
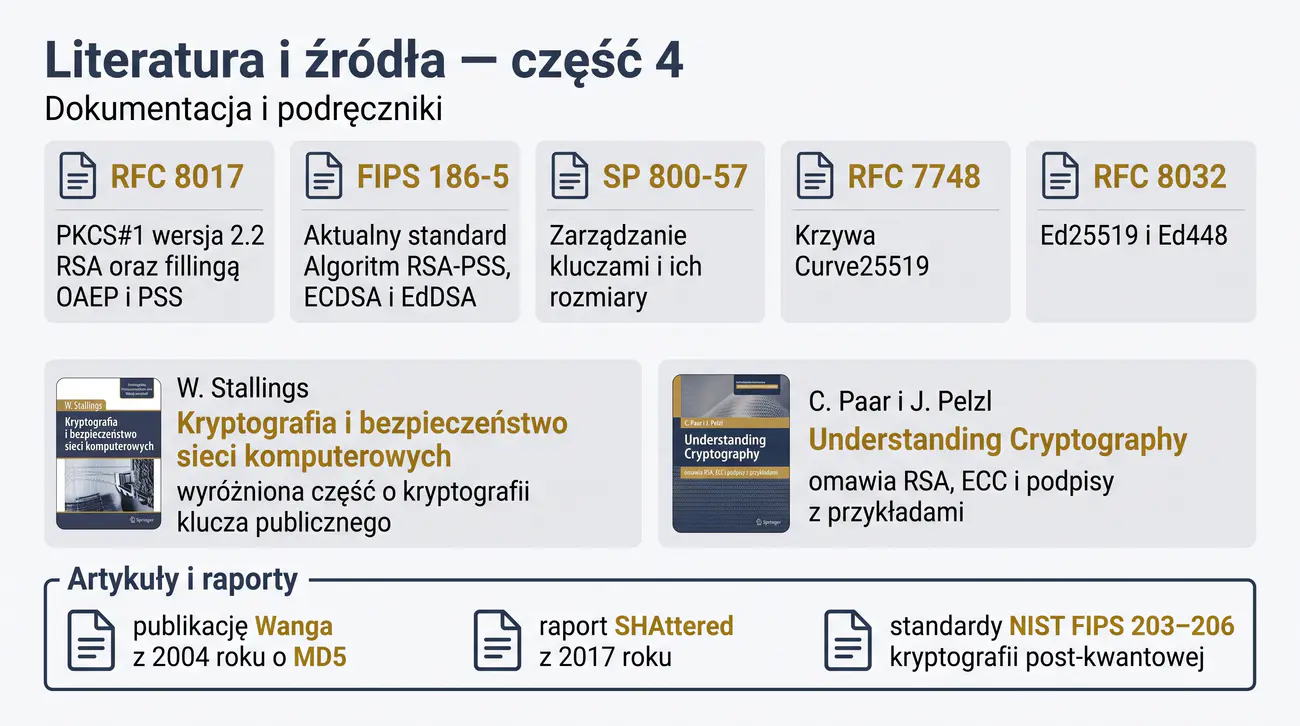
Wykaz dokumentów i podręczników zebrany na slajdzie pełni rolę przewodnika po źródłach, w których można pogłębić wiedzę o algorytmach asymetrycznych. Dokument RFC 8017 opisuje dokładnie konstrukcję RSA oraz wypełnienia OAEP i PSS, natomiast FIPS 186-5 porządkuje zagadnienia podpisów RSA (RSASSA-PSS), ECDSA i EdDSA (dodając wariant HashEdDSA) oraz usuwa z zakresu generowanie podpisów DSA, pozostawiając wyłącznie ich weryfikację. Sięgnięcie przynajmniej do wybranych fragmentów tych specyfikacji uczy czytania oficjalnej dokumentacji, co jest codziennym zadaniem inżyniera.
Z kolei zalecenia zawarte w publikacji SP 800-57 dotyczą zarządzania kluczami i ich rozmiarów, stanowiąc podstawę decyzji o konfiguracji systemów produkcyjnych. Należy przy tym pamiętać, że dokumenty tego rodzaju bywają cyklicznie rewidowane i przed zastosowaniem trzeba zweryfikować ich aktualne wydanie. Tylko świeża dokumentacja pozwala utrzymać zgodność między konfiguracją a aktualnym stanem wiedzy.
Zaleca się samodzielne przeczytanie chociaż fragmenty RFC 7748 i RFC 8032 opisujące krzywe Curve25519 oraz podpisy Ed25519. Taki kontakt z pierwotną specyfikacją wyjaśnia wiele szczegółów, które w podręcznikach bywają pominięte lub podane w wielkim skrócie. Dzięki temu czytanie dokumentów technicznych staje się jedną z podstawowych umiejętności przyszłego specjalisty.
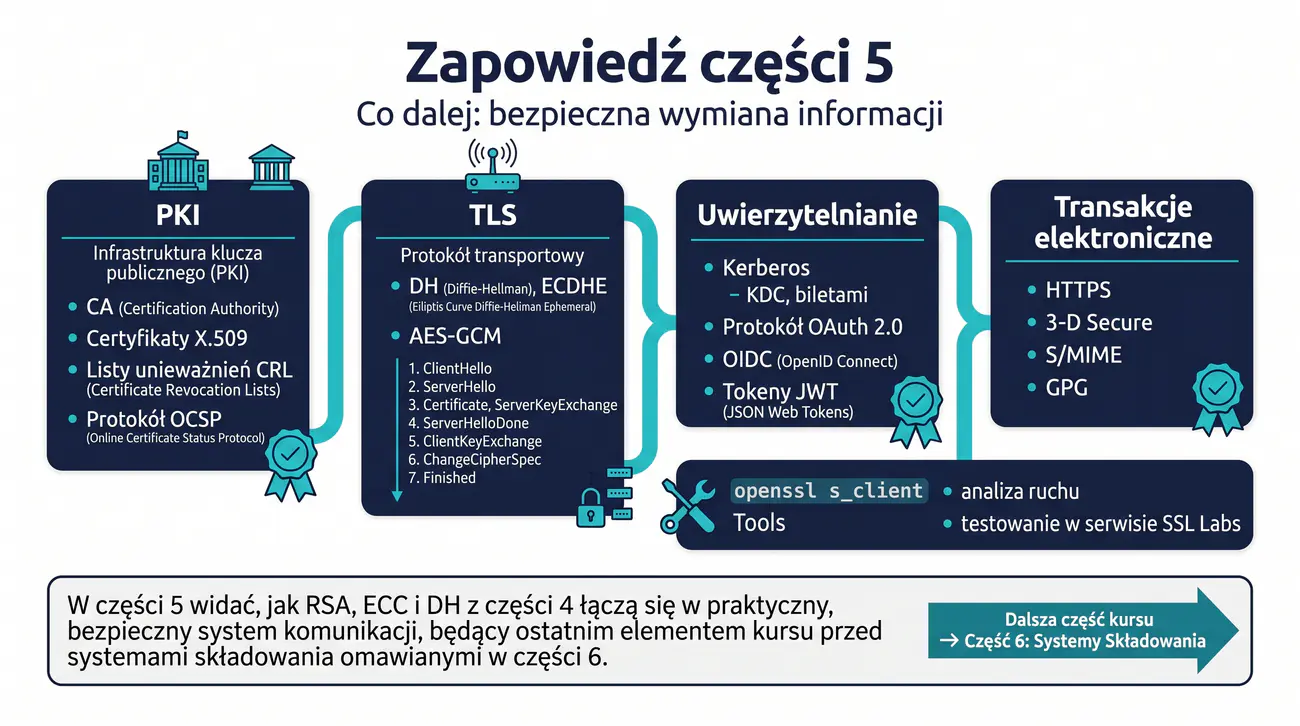
Zapowiedź piątej części wykładu wskazuje kierunki, w których wiedza o kryptografii asymetrycznej znajdzie dalsze praktyczne zastosowanie. Najważniejszym z tych kierunków jest infrastruktura klucza publicznego, która porządkuje wydawanie, przechowywanie i weryfikację certyfikatów X.509. Bez tego mechanizmu trudno byłoby zastosować opisane tu podpisy i uzgodnienia kluczy w dużej skali sieci komputerowych.
Omówienie protokołu TLS w części piątej pokaże, w jaki sposób wszystkie poznane elementy, czyli wymiana ECDHE, podpisy cyfrowe i szyfrowanie AEAD, składają się na jeden spójny przebieg nawiązywania połączenia. Kolejny blok poświęcony uwierzytelnianiu, z usługami Kerberos oraz standardami OAuth 2.0 i JWT, poszerzy perspektywę na systemy rozproszone i aplikacje internetowe. Dzięki temu cała część czwarta znajdzie ujście w konkretnych mechanizmach sieciowych.
Traktowanie tej zapowiedzi jak mapy dalszego materiału pomaga zrozumieć, dlaczego szczegóły poznane teraz okażą się istotne w praktyce. Warto zatem zachować własne notatki oraz działające przykłady, wykorzystując je w kolejnych tygodniach zajęć. Takie planowanie nauki pozwala płynnie przejść od teorii do budowy realnych systemów.
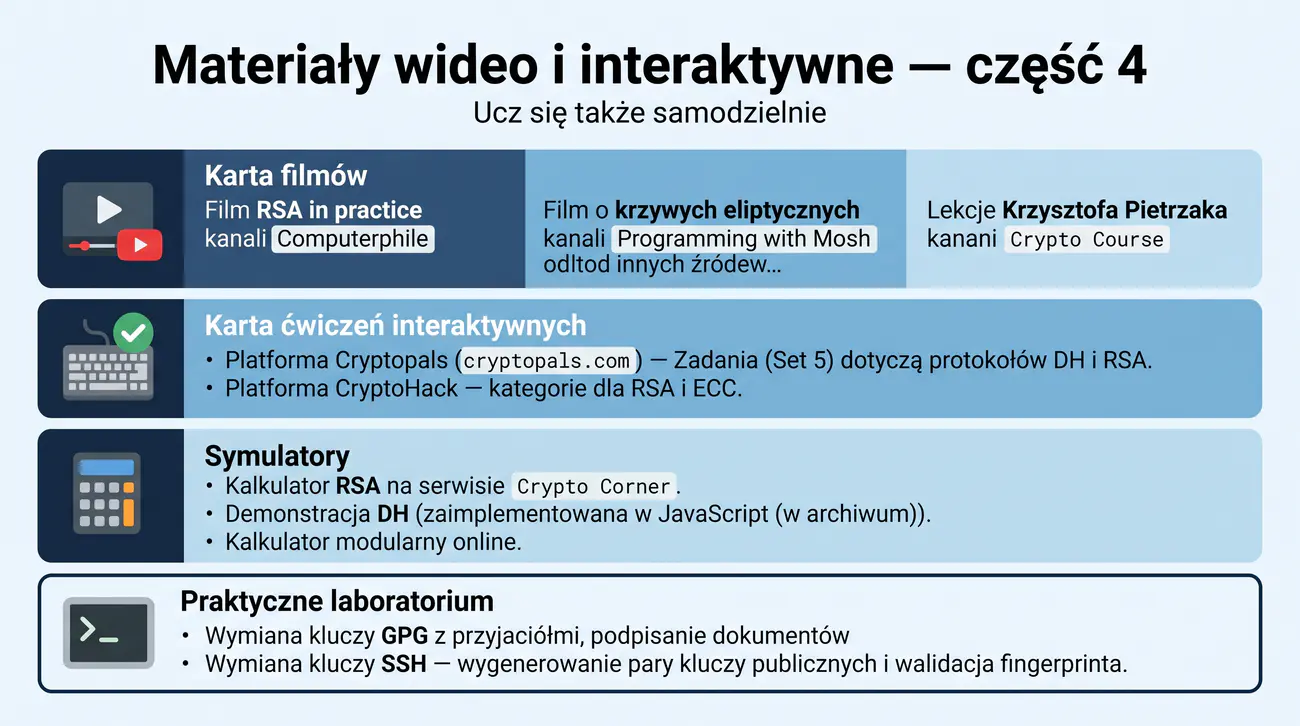
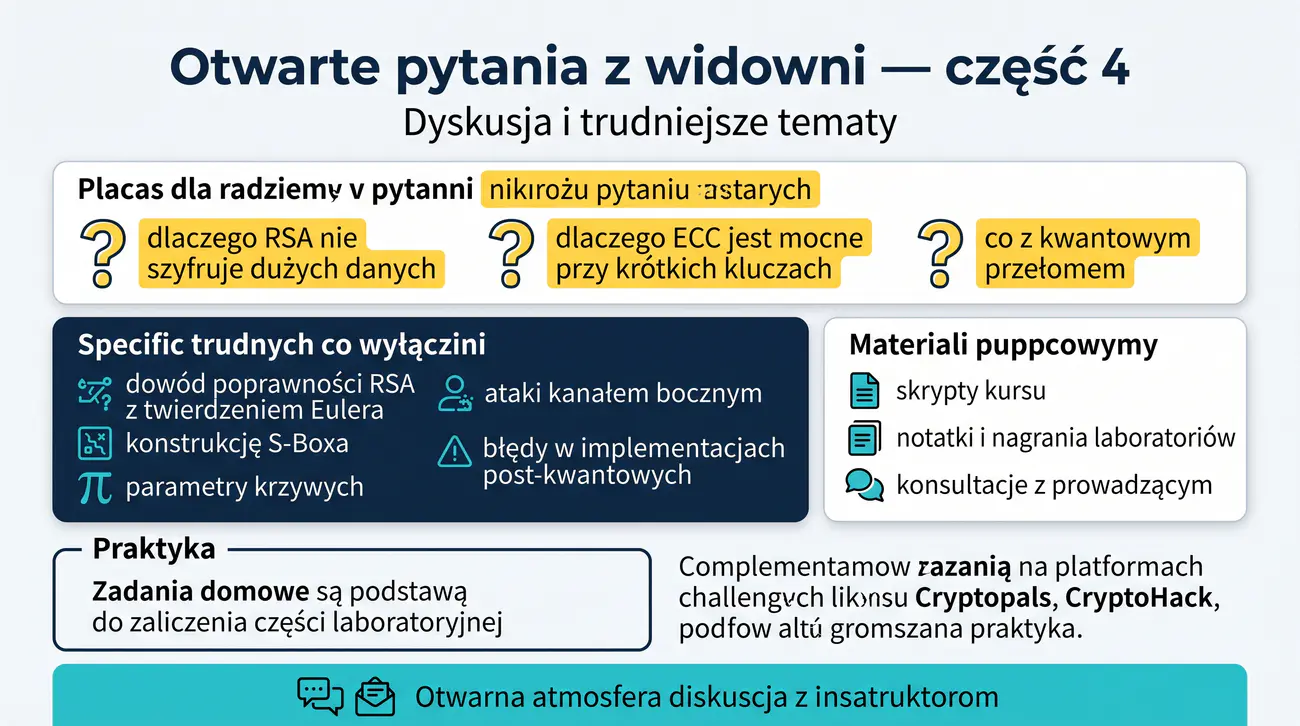
Zebrane na slajdzie materiały wideo i interaktywne uzupełniają wykład, dostarczając treści, które można przyswoić samodzielnie w dogodnym tempie, co szczególnie przydaje się przed kolokwium. Filmy popularnonaukowe tłumaczą najważniejsze koncepcje, takie jak RSA czy krzywe eliptyczne, w sposób przystępny, a nagrania wykładów akademickich prowadzą przez matematyczne podstawy znacznie głębiej. Dobór treści pozwala wracać do trudnych tematów tyle razy, ile wymaga tego proces uczenia.
Ćwiczenia interaktywne, dostępne między innymi na platformach Cryptopals i CryptoHack, przekształcają wiedzę w umiejętności praktyczne wzorowane na realnej pracy analityków bezpieczeństwa. Każde kolejne zadanie wymaga sięgania do dokumentacji i szukania rozwiązań, przez co rozwija zdolności projektowania i testowania. Wciągająca forma ćwiczeń sprawia, że nauka przebiega niemal bez wysiłku, a zdobyte kompetencje zostają na dłużej.
Warto korzystać z tych materiałów w umiarkowanych dawkach i wracać do wybranych zadań w miarę postępów w wykładzie, tak aby ich treść pokrywała się z aktualnie omawianym tematem. Połączenie wykładu, literatury i ćwiczeń interaktywnych daje pełniejszy obraz bezpiecznych systemów, niż może dostarczyć sama prezentacja. Taki wielokanałowy sposób uczenia jest szczególnie zalecany osobom przygotowującym się do zajęć projektowych.
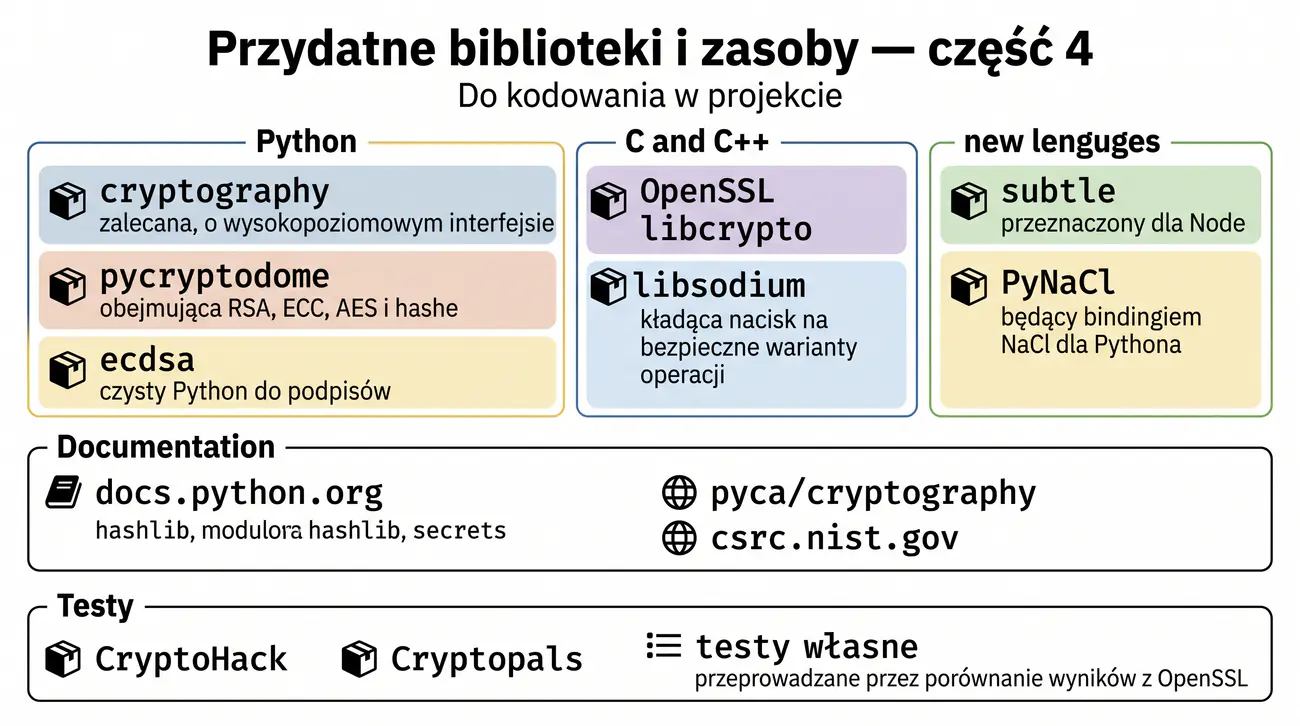
cryptography (zalecana, interfejs wysokopoziomowy), pycryptodome (RSA, ECC, AES, hashe), ecdsa (czysty Python dla podpisu).OpenSSL libcrypto, libsodium (nacisk na bezpieczne warianty).subtle (Node), PyNaCl (Python binding NaCl).Ten slajd systematyzuje informacje o narzędziach i sposobach ich użycia, przedstawiając je jako zestaw elementów wspierających pracę inżyniera bezpieczeństwa. Zgodnie z zawartą tu propozycją skuteczna praca wymaga zarówno znajomości poleceń, jak i świadomości ograniczeń każdego z narzędzi. Umiejętność wyboru właściwego narzędzia do zadania decyduje w praktyce o jakości wyników.
Praktyczne podejście zakłada traktowanie materiałów szkoleniowych jako przewodnika po funkcjach dostępnych w konkretnych wersjach programów, a nie jako zamkniętej listy wszystkich możliwości. Równolegle zaleca się stałą weryfikację wyników operacji w niezależny sposób, co podnosi pewność uzyskanych rezultatów. Utrwalenie takich nawyków odbywa się najlepiej przez wykonywanie samodzielnych ćwiczeń.
Znajomość narzędzi nie zastępuje jednak wiedzy teoretycznej, a jedynie ją dopełnia w codziennym działaniu. Dlatego dalsze bloki materiału prowadzą krok po kroku przez praktyczne przykłady obsługi kluczy, szyfrowania oraz podpisów cyfrowych. W ten sposób teoria i praktyka pozostają ze sobą w stałym związku.
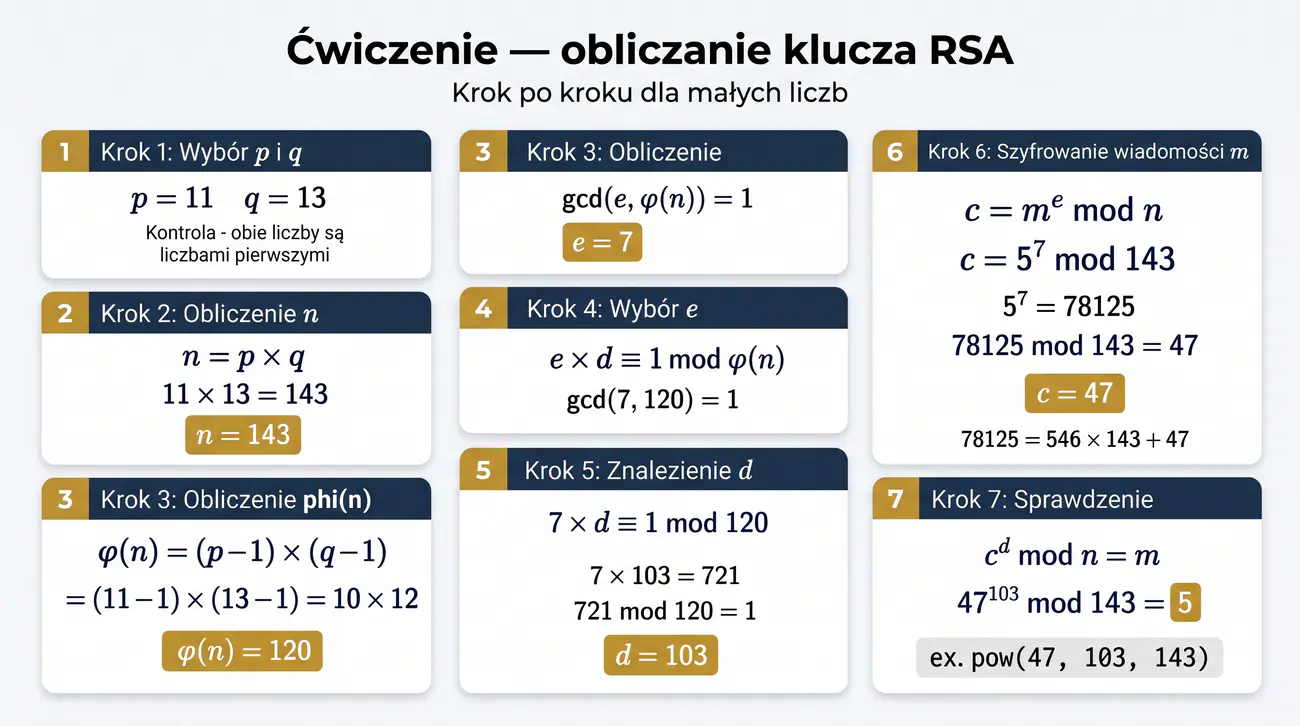
Praktyczny przykład liczbowy umożliwia przeprowadzenie pełnej symulacji szyfrowania i deszyfrowania, co utrwala wiedzę zdobytą na poprzednich slajdach. Warto przy tym samodzielnie powtórzyć wszystkie obliczenia w interpreterze, aby potwierdzić poprawność przedstawionych wyników. Takie ćwiczenie buduje zaufanie do rozumienia algorytmu i przygotowuje do rozwiązywania zadań projektowych.
Zwraca uwagę stopniowy charakter obliczeń, w którym każda kolejna operacja opiera się na wyniku poprzedniej, co dobrze pokazuje, dlaczego właściwa kolejność kroków ma kluczowe znaczenie. Obserwacja wszystkich wartości pośrednich pozwala zrozumieć, dlaczego pewne informacje muszą być chronione, a inne mogą pozostać jawne. Ta świadomość jest fundamentem projektowania bezpiecznych systemów.
W trakcie takiej symulacji warto dodatkowo sprawdzić, co dzieje się po zmianie jednego z parametrów, na przykład długości klucza. Tego rodzaju obserwacje pomagają dostrzec zależność między rozmiarem danych a kosztem obliczeń. Ćwiczenie to stanowi zarazem naturalne wprowadzenie do kolejnego studium przypadku.
Przykład ten dotyczy uzgodnienia wspólnego sekretu przez obie strony przy użyciu jawnej komunikacji i pokazuje, w jaki sposób osiąga się to zadanie bez wymiany materiału tajnego. Staranna analiza wszystkich wartości przepływających przez kanał pozwala wyjaśnić, dlaczego napastnik nie potrafi odtworzyć wyniku mimo podglądania transmisji. Taka lekcja bywa najbardziej pouczająca w całym materiale.
Warto jednocześnie zwrócić uwagę na to, że przedstawione wartości są jedynie przykładami i nie mogą być użyte w warunkach produkcyjnych ze względu na zbyt małe rozmiary parametrów. Rzeczywiste systemy stosują liczby o długości umożliwiającej utrzymanie wymaganego poziomu bezpieczeństwa. Porównanie tych dwóch światów pomaga zrozumieć rolę rozmiaru parametrów.
Symulacja ta prowadzi także do wniosku, że protokół uzgadniania sekretu nie potwierdza tożsamości rozmówców, co musi być uzupełnione o dodatkowe mechanizmy uwierzytelniania. Dostrzeżenie tej luki stanowi ważny krok w rozumieniu współczesnych protokołów transportowych. Kolejne slajdy rozwijają te zagadnienia w szerszym kontekście.
$ python3 -c # poglądowo - wzór odtworzenia d z 2 podpisów # s1 - s2 = k^-1*(z1 - z2) mod q => k # d = (s1*k - z1) / r1 mod q
Demonstracja ta ilustruje, w jaki sposób porównanie dwóch podpisów uwidacznia ich matematyczną strukturę i prowadzi do wniosków o bezpieczeństwie użytych wartości losowych. Kluczowe obserwacje, dotyczące powtarzających się wielkości, pozwalają prześledzić cały tok rozumowania napastnika. Przeprowadzenie tego ćwiczenia w interpreterze utrwala w praktyce wiedzę z poprzednich części materiału.
Analiza prowadzi do odtworzenia klucza prywatnego na podstawie obserwowanych podpisów, co w sposób niezmiernie sugestywny pokazuje konsekwencje złego gospodarowania wartościami losowymi. Należy przy tym podkreślić, że samo wykonanie obliczeń nie wymaga dostępu do żadnych tajnych informacji przechowywanych u właściciela klucza. Właśnie ta możliwość przeprowadzenia ataku bez dostępu do urządzenia właściciela klucza czyni go tak niebezpiecznym.
Wniosek praktyczny jest przy tym prosty: wystarczy konsekwentnie stosować nowoczesne biblioteki i unikać ręcznego dobierania losowych składników. Takie postępowanie usuwa całą klasę podatności bez konieczności zmiany algorytmu. Dlatego demonstracje tego rodzaju mają silne uzasadnienie dydaktyczne w programie zajęć.
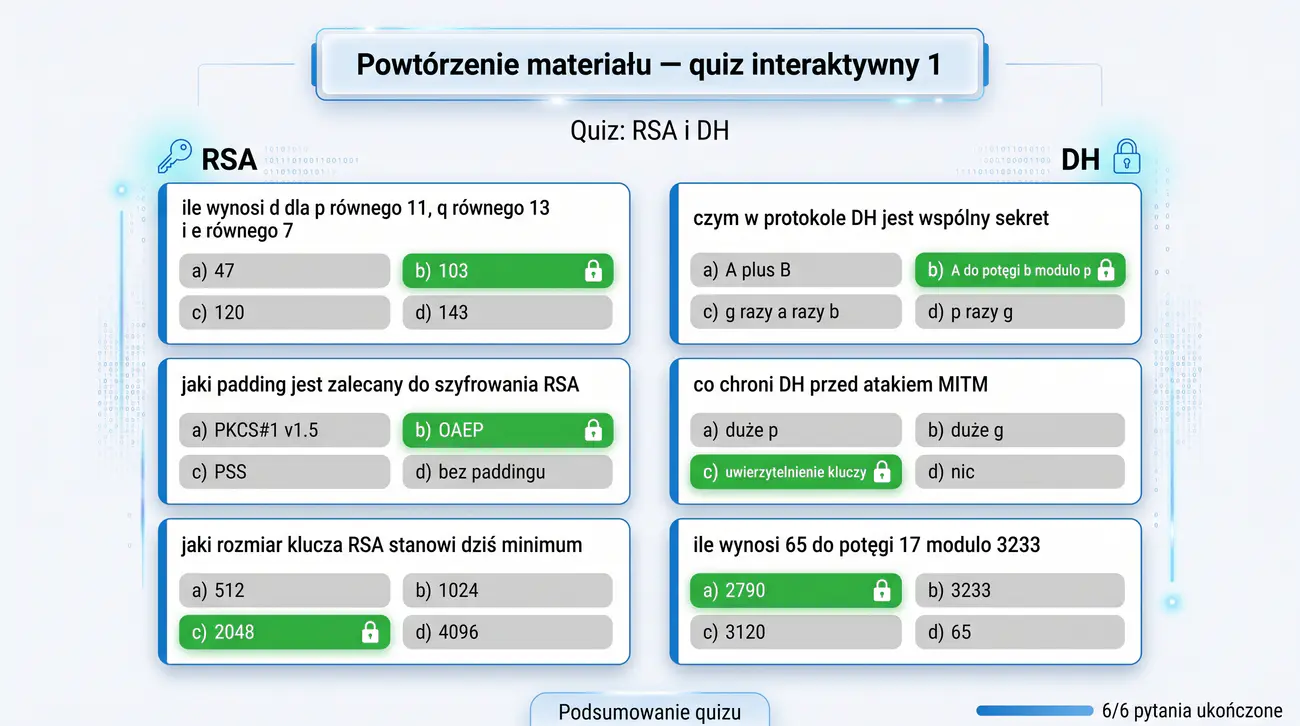
Quiz interaktywny stanowi krótkie, lecz systematyczne sprawdzenie wiadomości o RSA i protokole Diffiego-Hellmana, podzielone na jednoznacznie sformułowane pytania. Część zadań ma charakter rachunkowy, na przykład wyznaczenie wykładnika prywatnego dla modułu równego 143 i wykładnika równego 7, a część wymaga wyboru właściwego wypełnienia lub odpowiedniego rozmiaru klucza. Dzięki temu jeden zestaw pytań obejmuje zarówno szczegóły matematyczne, jak i ogólne zalecenia projektowe.
Warianty odpowiedzi zostały tak dobrane, aby ograniczać przypadkowe zgadywanie, dlatego pytania wymagają zrozumienia pojęcia, a nie tylko skojarzenia z nazwy. Poprawna odpowiedź na pytanie o zalecane wypełnienie powinna wskazywać na rozróżnienie między OAEP stosowanym w szyfrowaniu a PSS przeznaczonym do podpisów, które bywa źródłem pomyłek w konfiguracji. Z kolei wybór minimalnego rozmiaru klucza RSA opiera się na aktualnych rekomendacjach dotyczących poziomu bezpieczeństwa.
Rozwiązywanie quizu najlepiej zaczynać od samodzielnej odpowiedzi, zanim spojrzy się na dostępne warianty, co wzmacnia pamięć oraz przekonanie o własnych kompetencjach. Po błędnej odpowiedzi warto od razu przejść do właściwego slajdu i przeanalizować przyczynę pomyłki. Tak powtarzany cykl rozpoznania i poprawy przynosi znacznie trwalsze efekty uczenia.
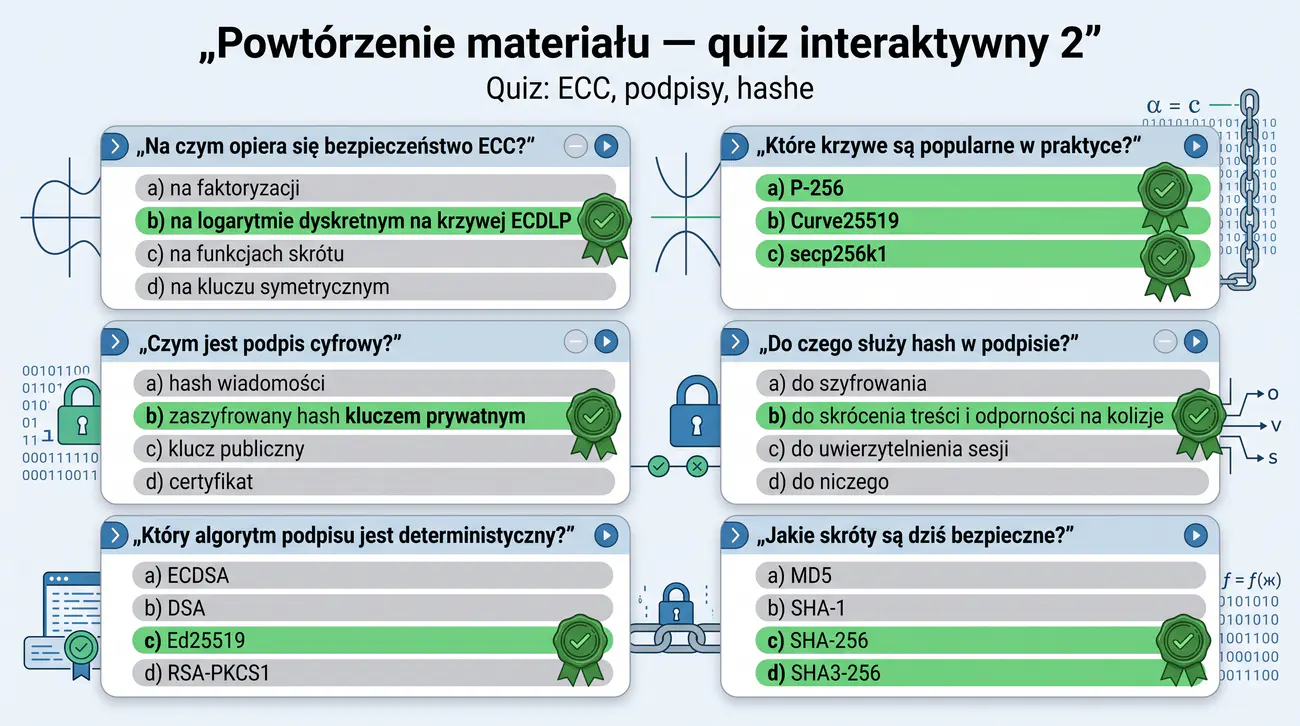
Drugi quiz dotyka krzywych eliptycznych, podpisów cyfrowych i funkcji skrótu, czyli zagadnień szczególnie często obecnych w nowoczesnych systemach. Pytanie o podstawę bezpieczeństwa krzywych sprawdza znajomość problemu ECDLP i umiejętność odróżnienia go od faktoryzacji stosowanej w RSA. Z kolei zadanie o popularnych krzywych wymaga rozpoznania nazw takich jak P-256, Curve25519 i secp256k1 oraz kontekstu ich wykorzystania.
W pytaniu o istotę podpisu cyfrowego kluczowe jest wskazanie schematu, w którym skrót wiadomości zostaje przekształcony kluczem prywatnym, a weryfikacja przebiega za pomocą klucza publicznego. Wybór właściwej odpowiedzi pokazuje, czy odróżnia się podpis od zwykłego skrótu i czy rozumie podział ról między składnikami pary kluczy. Takie rozróżnienie bywa podstawą poprawnych decyzji projektowych w systemach dokumentowych.
Quiz warto potraktować jako ćwiczenie odświeżające, a nie tylko formę sprawdzenia, dlatego dobrze jest do niego wrócić po kilku dniach od pierwszej próby. Ponowne rozwiązanie pytań ujawnia, które wiadomości uległy zapomnieniu i wymagają utrwalenia. Regularne powroty do tego typu ćwiczeń są zalecaną techniką przygotowań do kolokwium.
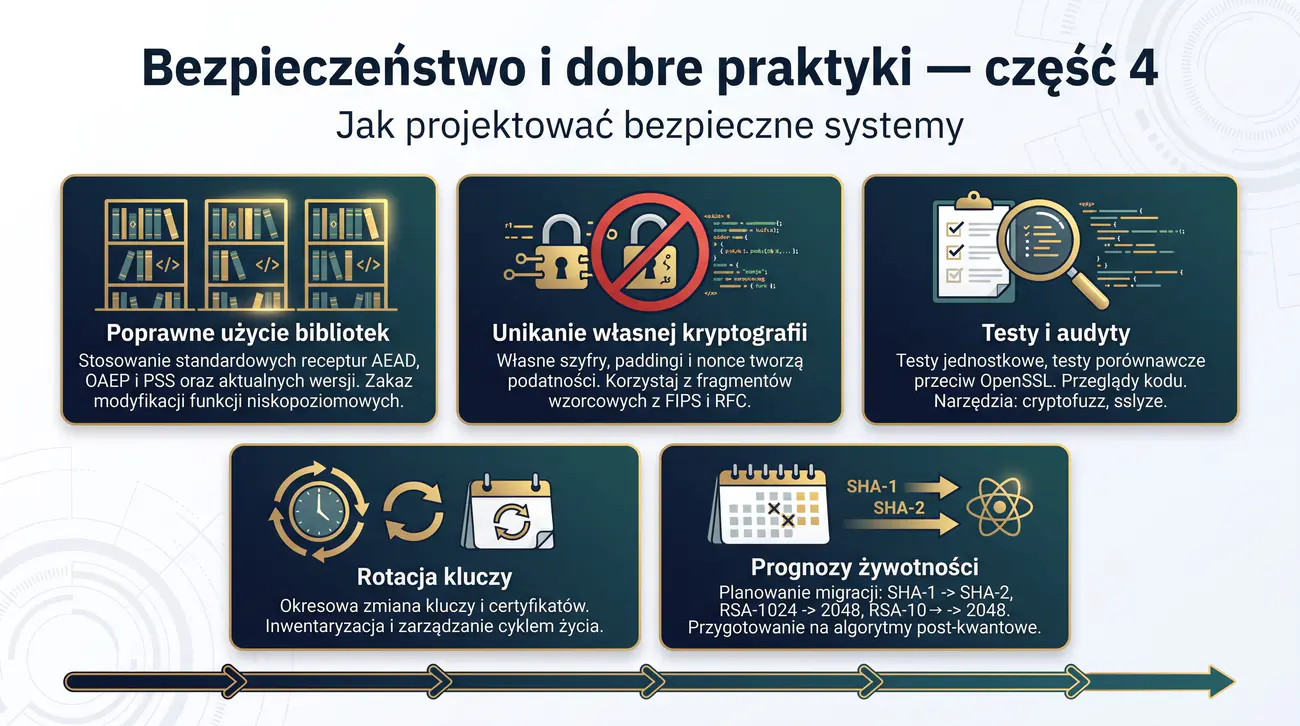
Zasady zebrane na tym slajdzie koncentrują się na bezpiecznym projektowaniu systemów, które w praktyce decydują o skuteczności nawet najlepszych algorytmów. Podstawową regułą jest korzystanie ze sprawdzonych bibliotek i gotowych receptur, takich jak szyfrowanie AEAD, wypełnienie OAEP czy schemat podpisów PSS, zamiast własnych modyfikacji niskopoziomowych funkcji. Odstępstwo od tej zasady, choćby podyktowane chęcią optymalizacji, bardzo często wprowadza podatność w pozornie dobrze zabezpieczonym kodzie.
Równie ważny jest zakaz tworzenia własnych szyfrów, wypełnień i sposobów zarządzania wartościami losowymi, ponieważ w kryptografii każda autorska konstrukcja wymaga lat analiz, aby zyskać zaufanie środowiska. Organizacje powinny zatem opierać swoje rozwiązania na algorytmach i parametrach opisanych w normach FIPS oraz dokumentach grupy RFC. Dzięki temu bezpieczeństwo systemu zależy od zweryfikowanej wiedzy, a nie od pomysłowości pojedynczego programisty.
Uzupełnieniem tych zasad są systematyczne testy i audyty, w tym testy jednostkowe, porównania wyników z niezależnym narzędziem takim jak OpenSSL oraz przeglądy kodu. Do wykrywania subtelnych błędów można używać wyspecjalizowanych narzędzi typu cryptofuzz, które automatycznie podsuwają konfiguracje bliskie granicy poprawności. Powtarzany cykl tworzenia, testowania i przeglądu stanowi najlepszą gwarancję, że wdrożone rozwiązanie rzeczywiście spełnia postawione wymagania bezpieczeństwa.
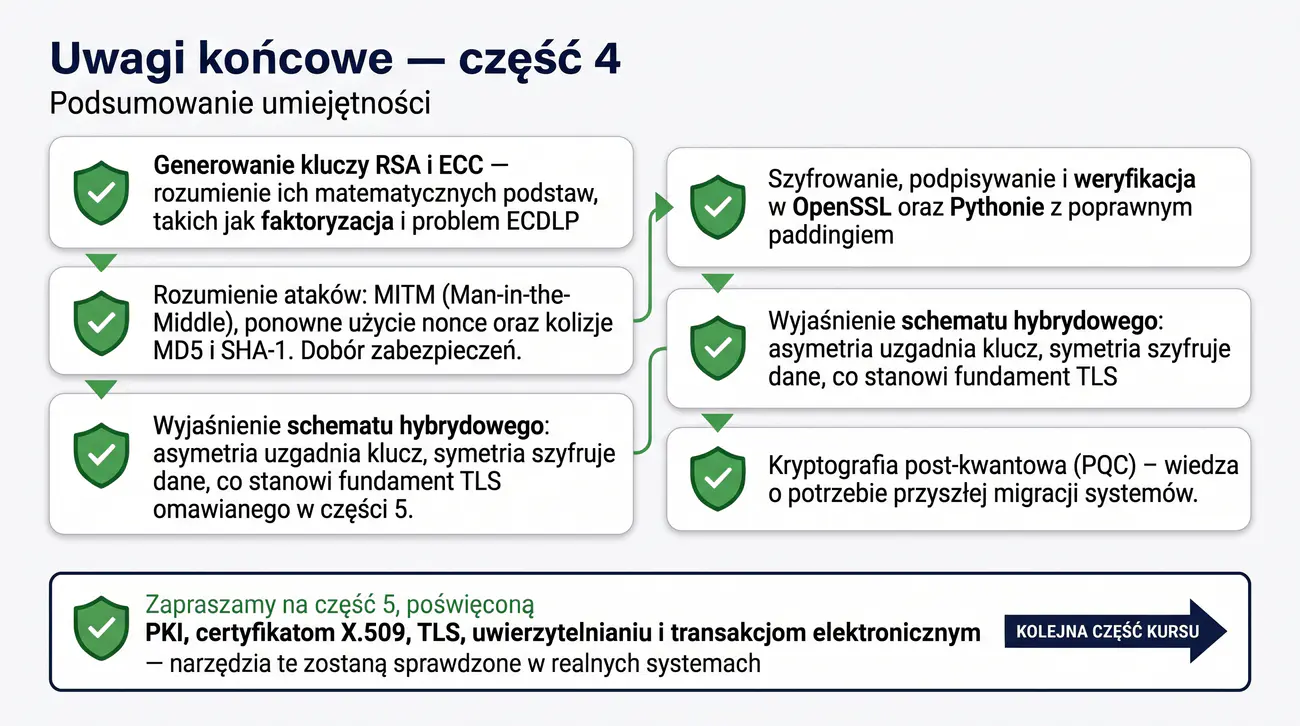
Uwagi końcowe części czwartej podsumowują kompetencje, które zdobyto w trakcie całego bloku, i pozwalają ocenić, czy wszystkie zakładane efekty uczenia zostały osiągnięte. Omówione zostały możliwości generowania kluczy RSA i ECC wraz z matematycznym uzasadnieniem ich bezpieczeństwa, a także sprawnego szyfrowania, podpisywania i weryfikowania przy użyciu standardowych narzędzi. Przegląd ten przypomina przy tym, że sama znajomość algorytmów nie wystarcza bez umiejętności ich poprawnego zastosowania.
Na szczególną uwagę zasługuje zdolność rozpoznawania typowych ataków, takich jak MITM, ponowne użycie nonce czy kolizje funkcji skrótu, która pozwala projektować systemy ukierunkowane na realne zagrożenia. Dobrze jest przy tym samodzielnie odtworzyć opisane podatności we własnej demonstracji, co sprawia, że wiedza staje się praktycznie osadzona i trwała. Taki sposób pracy odróżnia rzetelne przygotowanie inżynierskie od mechanicznego zapamiętania treści ze slajdów.
Końcowa refleksja prowadzi do wniosku, że omówione mechanizmy tworzą spójną całość, w której każdy element pełni określoną rolę w ochronie danych. Świadome łączenie tych elementów, od kluczy, przez podpisy, aż po wypełnienia, jest podstawą kompetencji w zakresie bezpieczeństwa informacji. Zdobyte w ten sposób umiejętności będą stanowić punkt wyjścia dla kolejnych części wykładu, poświęconych infrastrukturze klucza publicznego i protokołom.
Końcowy slajd czwartej części opracowania tworzy swego rodzaju zakończenie, które osadza omówioną tematykę w szerszym programie przedmiotu. Zdobyta wiedza o kryptografii asymetrycznej, podpisach cyfrowych i wymianie kluczy stanowi bezpośrednią podstawę dalszych części poświęconych infrastrukturze klucza publicznego oraz protokołom komunikacyjnym. Warto potraktować ten moment jako okazję do uporządkowania całego materiału.
Zakończenie to zachęca zarazem do pogłębionej refleksji nad tym, które z przedstawionych wątków wymagają jeszcze dodatkowej pracy. Warto w tym celu wrócić do pytań kontrolnych i wykonać samodzielnie przykłady demonstracyjne, porównując wyniki z oczekiwaniami. Taka systematyczna powtórka przynosi znacznie lepsze efekty niż pobieżny przegląd slajdów tuż przed kolokwium.
Opanowanie problemów części czwartej otwiera drzwi do kolejnych zagadnień, w tym do praktycznego wykorzystania narzędzi kryptograficznych w projektach grupowych. Przekazywane tu treści są także istotne dla pełnego zrozumienia kryptografii asymetrycznej. Dlatego warto poświęcić temu materiałowi należytą uwagę i uzupełnić ewentualne braki w zrozumieniu przed przejściem dalej.