Kryptologia i bezpieczna wymiana informacji
Część 6 - Sieciowe systemy składowania danych: SAN, NAS i macierze RAID
Część szósta zamyka opracowanie poświęcone bezpieczeństwu informacji, przenosząc akcent z warstwy algorytmicznej na warstwę fizycznego i logicznego przechowywania danych. Dotychczasowe części dotyczyły szyfrów, kluczy, certyfikatów i protokołów, czyli głównie danych w ruchu. Równie ważne jest jednak miejsce, w którym informacja ostatecznie spoczywa, dlatego te zajęcia poświęcone są magazynom danych.
W praktyce decyzje o architekturze składowania zapadają, zanim pojawi się konkretne szyfrowanie, a błędny dobór sprzętu potrafi zniweczyć nawet najlepsze zabezpieczenia. Materiał prowadzi czytelnika od nośników i parametrów, przez poziomy RAID, aż po architektury DAS, NAS i SAN. Każdy blok kończy się elementami bezpieczeństwa, co podkreśla spójność z wcześniejszymi częściami.
Materiał ma charakter praktyczny i przygotowuje do pracy w zespołach utrzymujących systemy informatyczne. Semestr piąty, rok trzeci studiów stacjonarnych o profilu praktycznym, sprzyja takiemu zestawieniu teorii z realnymi problemami projektowymi. Wiedza uzyskana w tej części stanowi też most między kryptografią a inżynierią systemów.
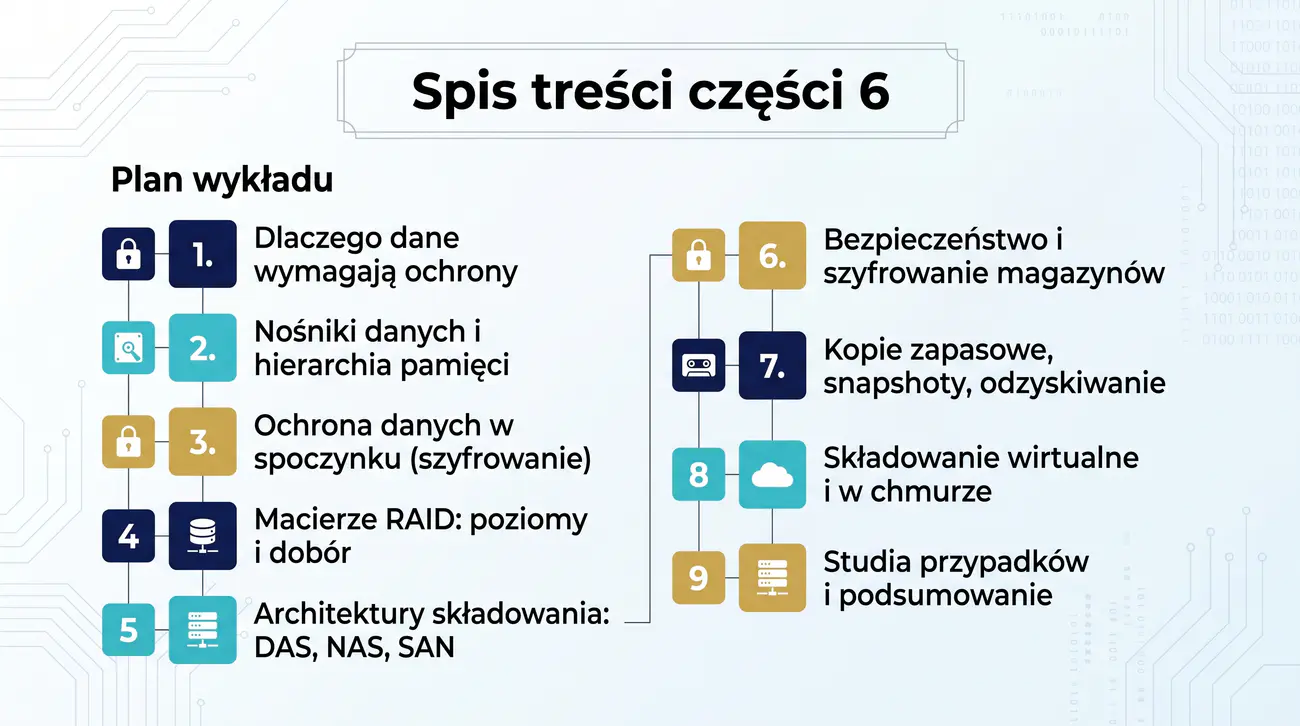
Spis treści odsłania logiczną sekwencję materiału, która zaczyna się od uzasadnienia potrzeby ochrony danych, a kończy na podsumowaniach i studiach przypadków. Kolejne bloki tematyczne odnoszą się do nośników, poziomów RAID, architektur składowania oraz kopii zapasowych. Dzięki takiemu uporządkowaniu uczestnik może śledzić postęp nauki i wracać do wybranych zagadnień.
Układ materiału nie jest przypadkowy, bo zrozumienie parametrów nośników ułatwia późniejszy dobór poziomu RAID, a znajomość macierzy pozwala świadomie wybierać między dostępem plikowym a blokowym. Podczas utrwalania wiedzy warto traktować spis treści jako mapę zagadnień obowiązkowych. W ten sposób unika się uczenia pojedynczych definicji bez zrozumienia ich wzajemnych relacji.
Fragmenty poświęcone bezpieczeństwu magazynów łączą tematykę części szóstej z zagadnieniami kryptografii omawianymi w poprzednich częściach. Studia przypadków na końcu materiału weryfikują natomiast umiejętność zastosowania wiedzy w praktyce. Regularne zaglądanie do tego spisu pozwala utrzymać całość materiału w polu uwagi.
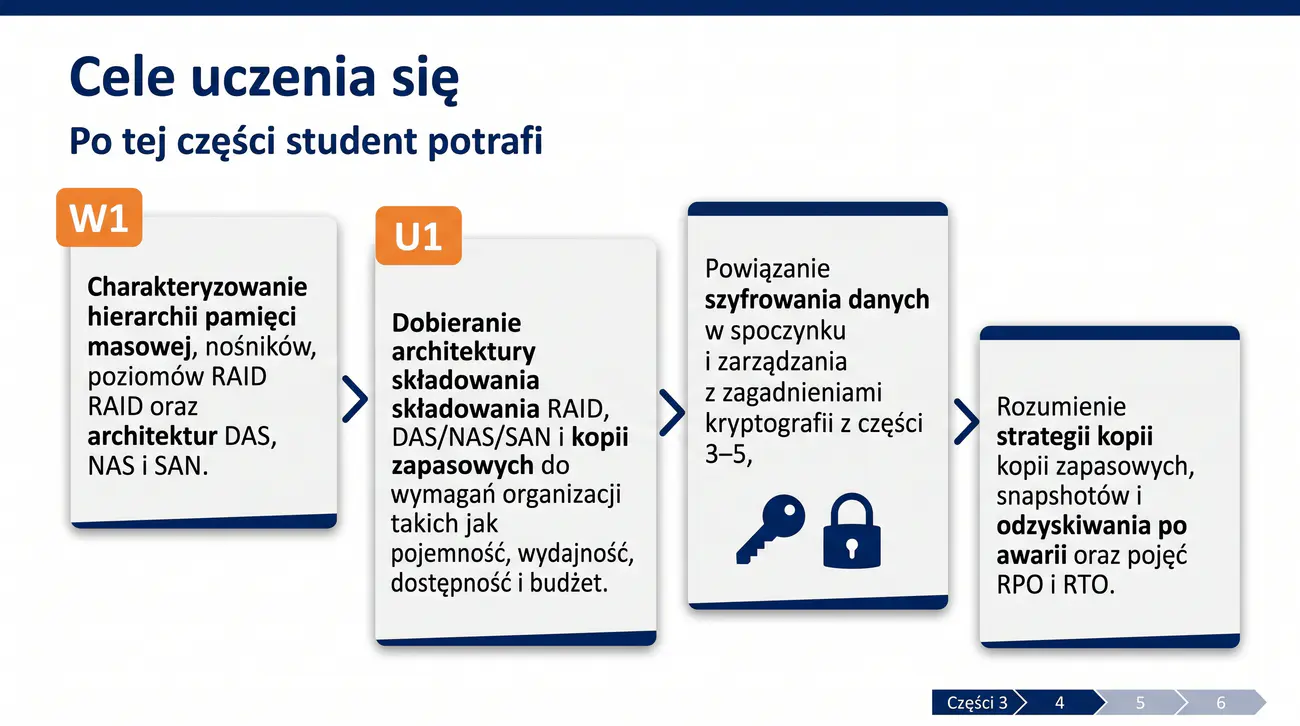
Efekty uczenia się opisują etapy, które uczestnik powinien osiągnąć po zakończeniu tej części: od wiedzy o hierarchii pamięci, przez znajomość poziomów RAID, aż po umiejętność doboru architektury składowania. Wymienione efekty W1 i U1 wyznaczają kluczowe kompetencje zawodowe w obszarze infrastruktury. Ich osiągnięcie wymaga nie tylko zapamiętania definicji, lecz także rozumienia kompromisów inżynierskich.
Umiejętność doboru przejawia się w analizie wymagań, takich jak pojemność, wydajność, dostępność i budżet, a następnie w przekładaniu ich na konkretne decyzje projektowe. W procesie tym ważne jest uzasadnianie wyborów, ponieważ w praktyce inżynierskiej kluczowy jest poprawny tok rozumowania i analiza ryzyka. Taka kompetencja jest cenna w pracy administratora i projektanta infrastruktury.
Cele uczenia się wskazują również na powiązanie szyfrowania danych w spoczynku z materiałem z części trzeciej, czwartej i piątej. Dzięki temu widać, że ochrona magazynów nie jest osobnym tematem, lecz kontynuacją całego opracowania. Świadome planowanie pracy nad osiągnięciem tych efektów ułatwia sprawną realizację zadań wdrożeniowych i konfiguracyjnych.
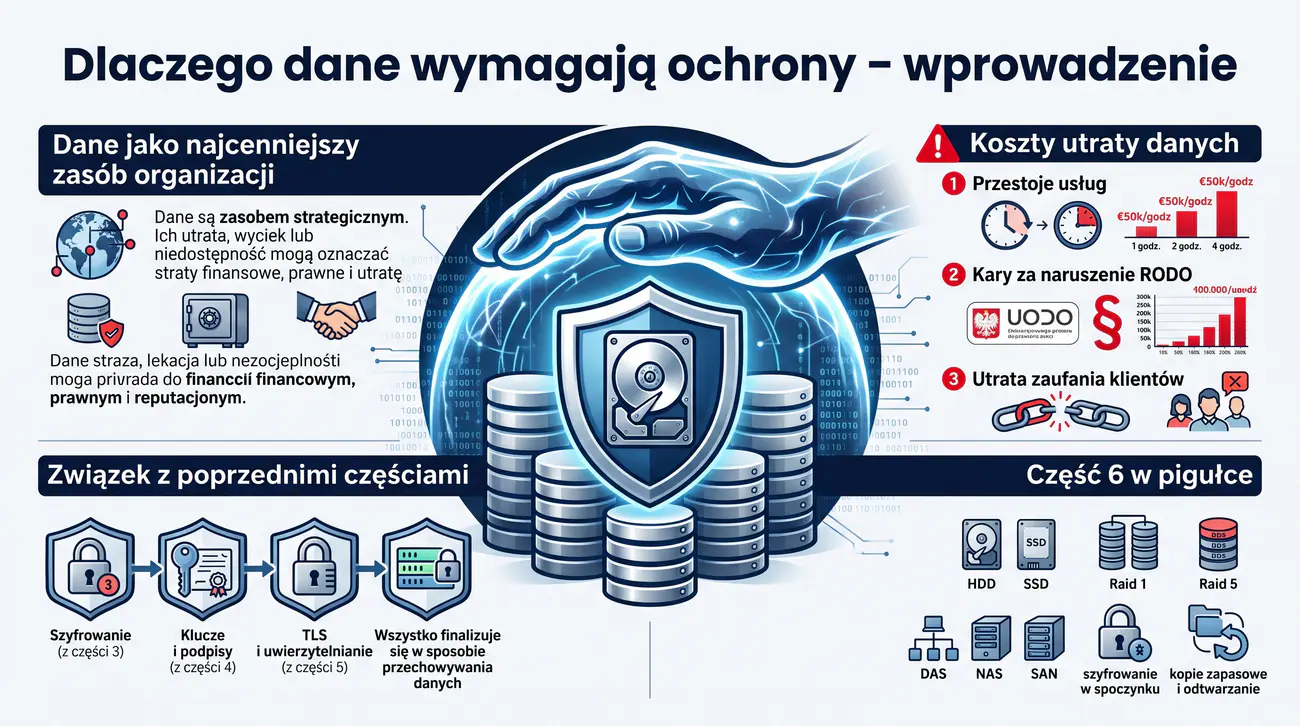
Współczesne organizacje funkcjonują dzięki danym, które generują, gromadzą i analizują każdego dnia, dlatego ich utrata nie jest zwykłą niedogodnością, lecz zdarzeniem o realnych skutkach finansowych. Przerwa w działaniu systemów może oznaczać zatrzymanie produkcji, brak rozliczeń czy opóźnienia w obsłudze klientów. Do tego dochodzą kary wynikające z naruszenia przepisów, które od kilku lat są znacznie surowsze.
Dane należy chronić przed kradzieżą, ale także przed przypadkowym usunięciem, uszkodzeniem nośnika i działaniem złośliwego oprogramowania. Szyfrowanie samo w sobie nie wystarczy, jeśli informacje giną przez błąd ludzki lub błędnie skonfigurowaną kopię zapasową. Dlatego ochrona danych w spoczynku uzupełnia szyfrowanie transmisji omawiane w części piątej.
Z perspektywy zarządczej najprostsze jest myślenie o koszcie pojedynczego dysku, a najtrudniejsze – oszacowanie wartości danych, które na nim spoczywają. Właśnie to szacowanie decyduje o tym, ile środków warto przeznaczyć na macierze, kopie i szyfrowanie. Kompleksowa strategia bezpieczeństwa musi zatem obejmować wszystkie etapy cyklu życia danych.
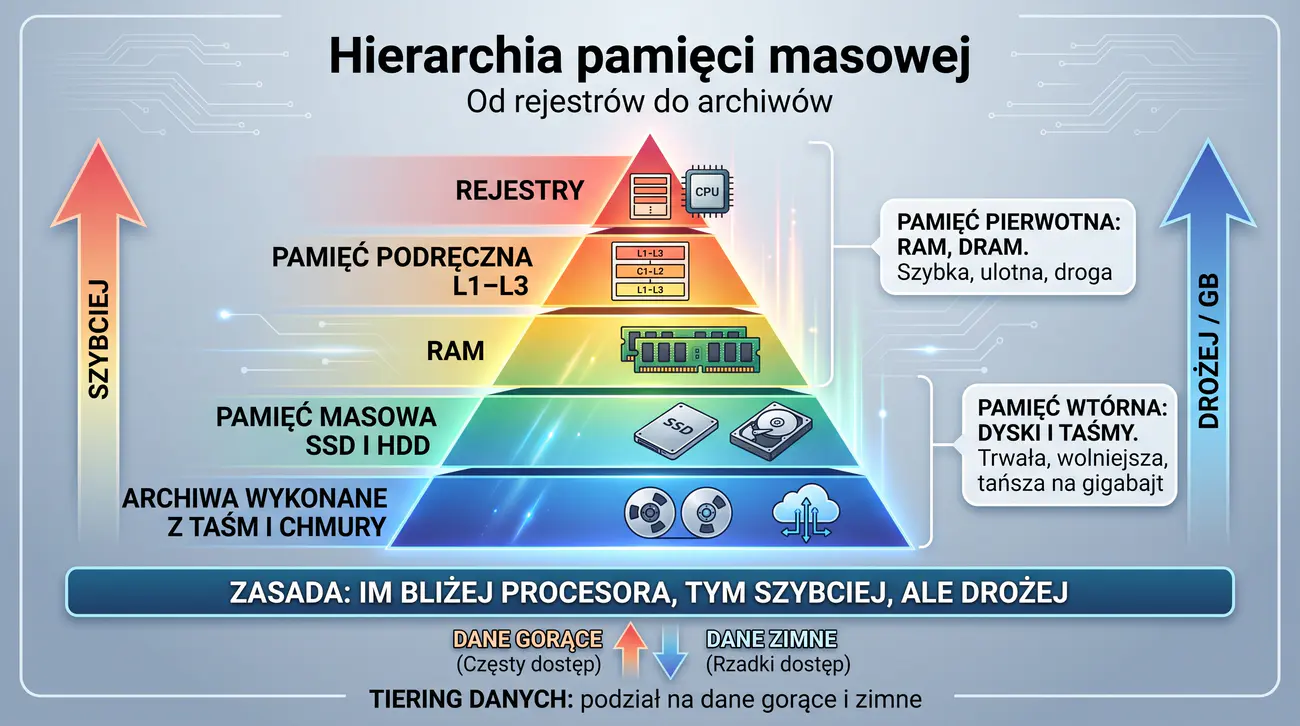
Hierarchia pamięci wynika z niemożliwej do pogodzenia zależności między szybkością, pojemnością i ceną układów pamięciowych. Najszybsze rejestry mają pojemność mierzoną w bajtach i czas dostępu w ułamkach nanosekundy, podczas gdy taśmy oferują najniższy koszt przechowywania, ale wyłącznie dostęp sekwencyjny. Systemy operacyjne ukrywają te różnice dzięki mechanizmom buforowania, które podsuwają często używane dane do warstw szybszych.
Właściwości te opisuje zjawisko lokalności: lokalność czasowa sprawia, że raz wykorzystany fragment danych będzie szybko potrzebny ponownie, a lokalność przestrzenna, że obok aktualnie używanego fragmentu znajdą się dane sąsiednie. Projektanci magazynów wykorzystują tę obserwację, dzieląc dane na gorące, ciepłe i zimne. Dzięki tieringowi tylko niewielka część zasobów musi korzystać z najdroższych nośników.
Konsekwencją hierarchii jest konieczność planowania, gdzie fizycznie spoczywają kolejne zbiory, ponieważ nieopłacalne jest przechowywanie wszystkich danych na dyskach NVMe. W praktyce spotyka się więc magazyny wielowarstwowe, w których pamięć podręczna przyspiesza odczyt, a archiwum taśmowe trzyma dane historyczne. Znajomość tych zależności ułatwia rozumienie późniejszych zagadnień dotyczących nośników i macierzy.
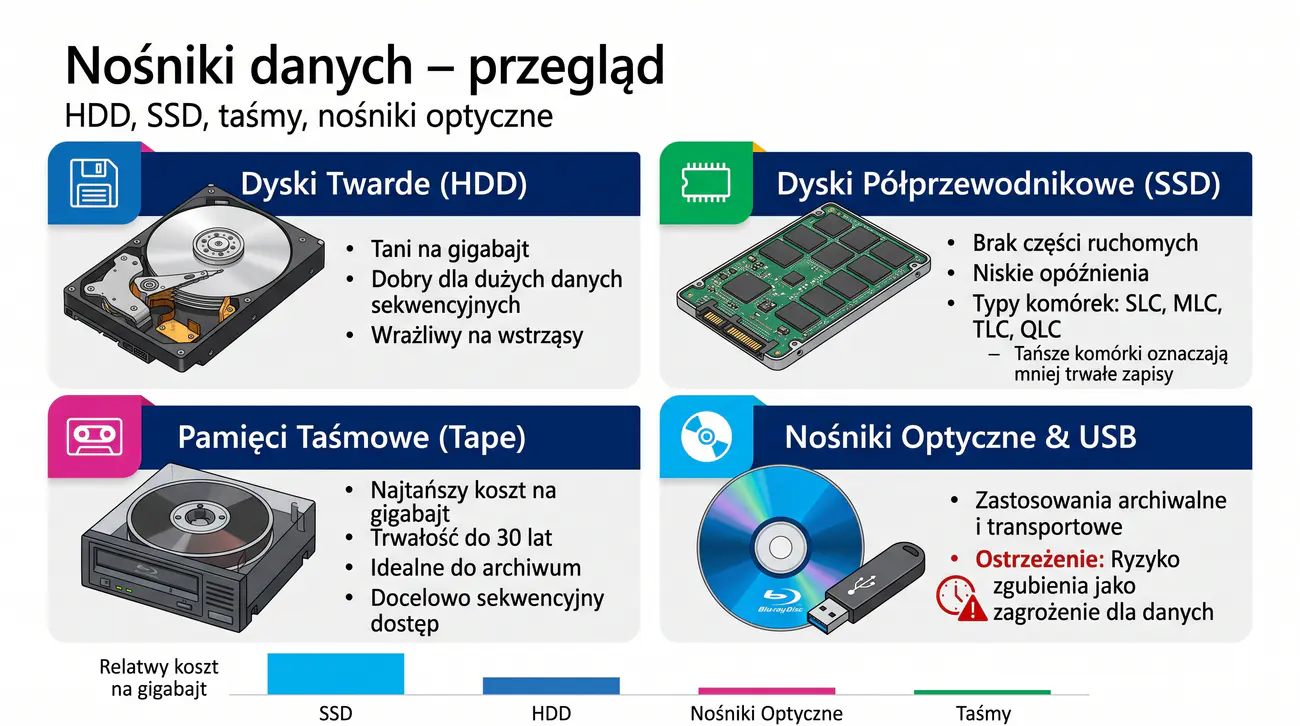
Dyski twarde przez dziesięciolecia dominowały w środowisku serwerowym ze względu na najkorzystniejszy stosunek pojemności do ceny, choć opierają się na ruchomych, delikatnych mechanizmach. Ich konstrukcja musi tolerować wibracje i zmiany temperatury, a każdy ruch głowicy wiąże się z fizycznym czasem pozycjonowania. Z tych powodów dyski HDD pozostają wrażliwe na wstrząsy i słabo sprawdzają się przy losowych małych operacjach.
Pamięć flash, z której korzystają dyski SSD, nie zawiera części ruchomych i charakteryzuje się niskim opóźnieniem, ale jej komórki zużywają się z każdym cyklem zapisu. Dlatego producenci oferują warianty SLC, MLC, TLC i QLC różniące się trwałością oraz kosztem. Identyczne pojemnościowo dyski mogą mieć więc zupełnie różne właściwości, co trzeba uwzględniać przy wyborze do obciążeń zapisowych.
Taśmy magnetyczne zachowały swoją pozycję w archiwach dzięki zapotrzebowaniu na długotrwałe przechowywanie danych przy minimalnych kosztach. Nośniki optyczne i przenośne pełnią funkcje transportowe, ale ich mały rozmiar zwiększa ryzyko zgubienia. W korporacjach najczęściej łączy się te technologie w warstwy, przypisując każdej rodzaj danych, dla którego jest najlepiej dopasowana.
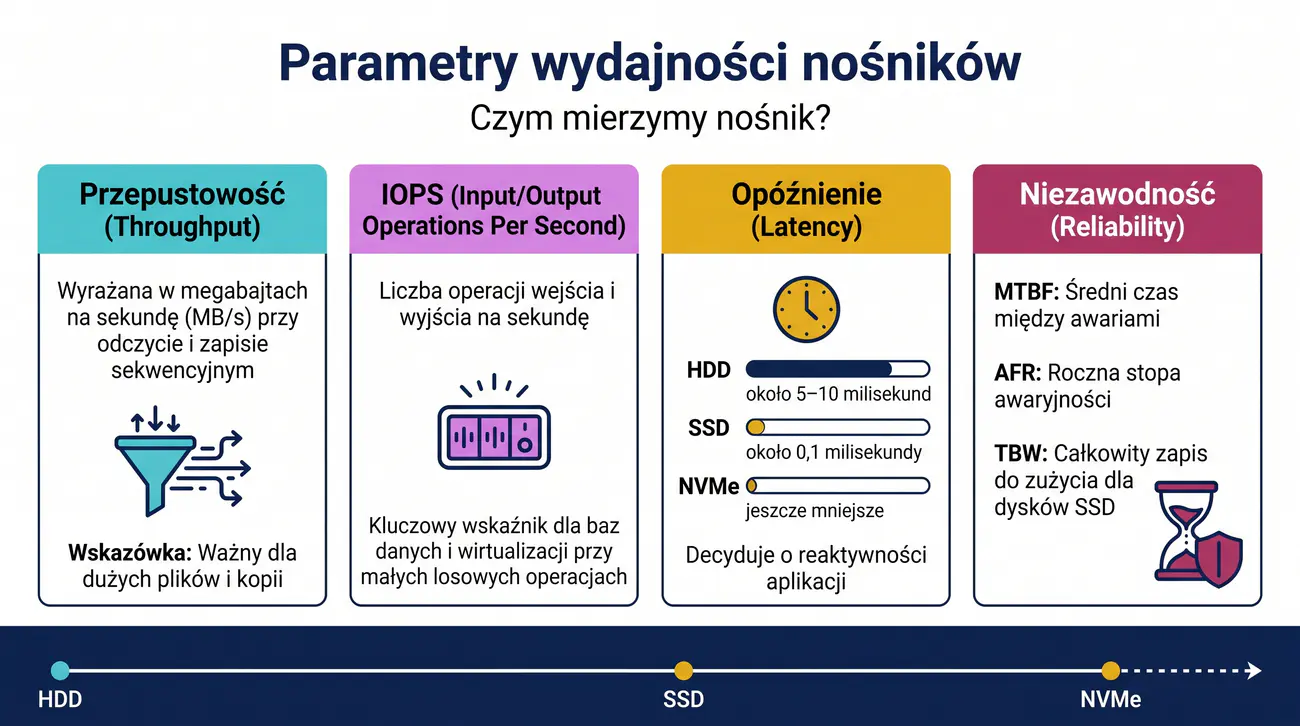
Parametry wydajnościowe opisują odmienne aspekty pracy nośnika i dlatego nie należy ich ze sobą mylić. Przepustowość wyrażana w megabajtach na sekundę opisuje transfery dużych porcji danych, a liczba IOPS dotyczy obsługi drobnych żądań losowych. Opóźnienie z kolei mówi, jak szybko nośnik odpowiada na pojedyncze żądanie, co bezpośrednio wpływa na odczucia użytkownika.
W praktyce pomiarów używa się narzędzi generujących obciążenie, na przykład programu fio, który potrafi odtworzyć wzorce zapisu charakterystyczne dla baz danych. Wyniki mocno zależą od wielkości bloków, liczby równoległych wątków i proporcji odczytów do zapisów, dlatego porównywanie liczb z ulotek wymaga ostrożności. Producenci podają wartości dla konkretnych scenariuszy, które łatwo przecenić.
Niezawodność opisują wskaźniki MTBF i AFR, wyznaczane na podstawie dużych populacji dysków, a dla pamięci flash dodatkowo parametr TBW oznaczający całkowitą objętość zapisów do zużycia. Interpretacja tych liczb pozwala planować wymiany nośników i rozumieć gwarancje producentów. Świadoma analiza parametrów chroni przed zakupem dysku, który nie sprosta obciążeniu.
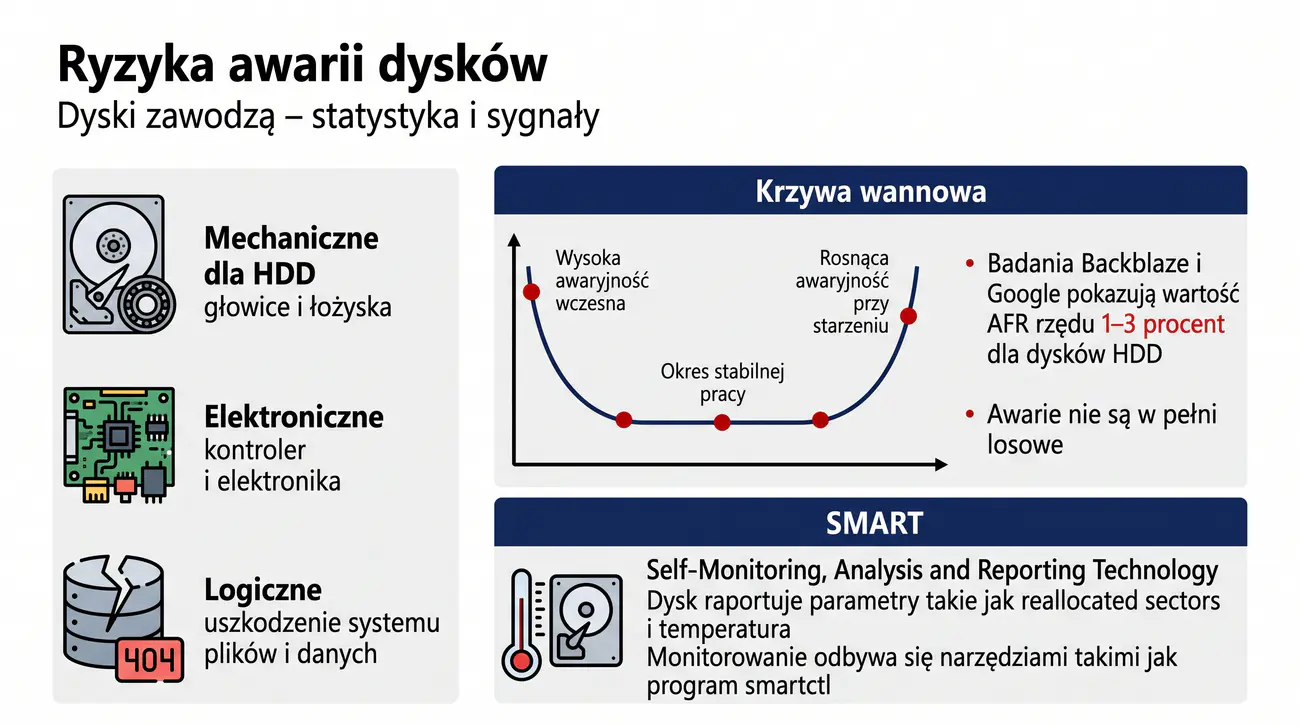
smartctl).Dyski zawodzą znacznie częściej, niż mogłoby wynikać z pojedynczych egzemplarzy i gwarancji, dlatego podstawą zarządzania ryzykiem są dane statystyczne. Badania prowadzone na masową skalę przez firmy takie jak Google czy Backblaze pokazują, że roczna stopa awaryjności dysków twardych mieści się zwykle w przedziale od jednego do kilku procent. Co ważne, awarie nie są całkowicie losowe, bo częściej padają urządzenia intensywnie eksploatowane.
Rozkład awarii w czasie przybiera kształt tak zwanej krzywej wannowej: wiele uszkodzeń występuje tuż po uruchomieniu, potem następuje stabilny okres, a na końcu życia nośnika ryzyko ponownie rośnie. Wiedza ta sygnalizuje, że nowe dyski należy poddać testom wygrzewania, a stare stopniowo wycofywać. Do tego dochodzi efekt temperatury, gdyż przegrzewanie wyraźnie skraca żywotność komponentów.
Mechanizm SMART pozwala dyskowi raportować własny stan dzięki pomiarom, takim jak liczba przeniesionych sektorów, czas pracy czy temperatura. Narzędzie smartctl i systemy monitorujące umożliwiają automatyczne odczytywanie tych wartości i wysyłanie alarmów. Wczesne ostrzeżenie daje czas na wykonanie kopii i spokojną wymianę dysku, zanim nastąpi całkowita utrata danych.
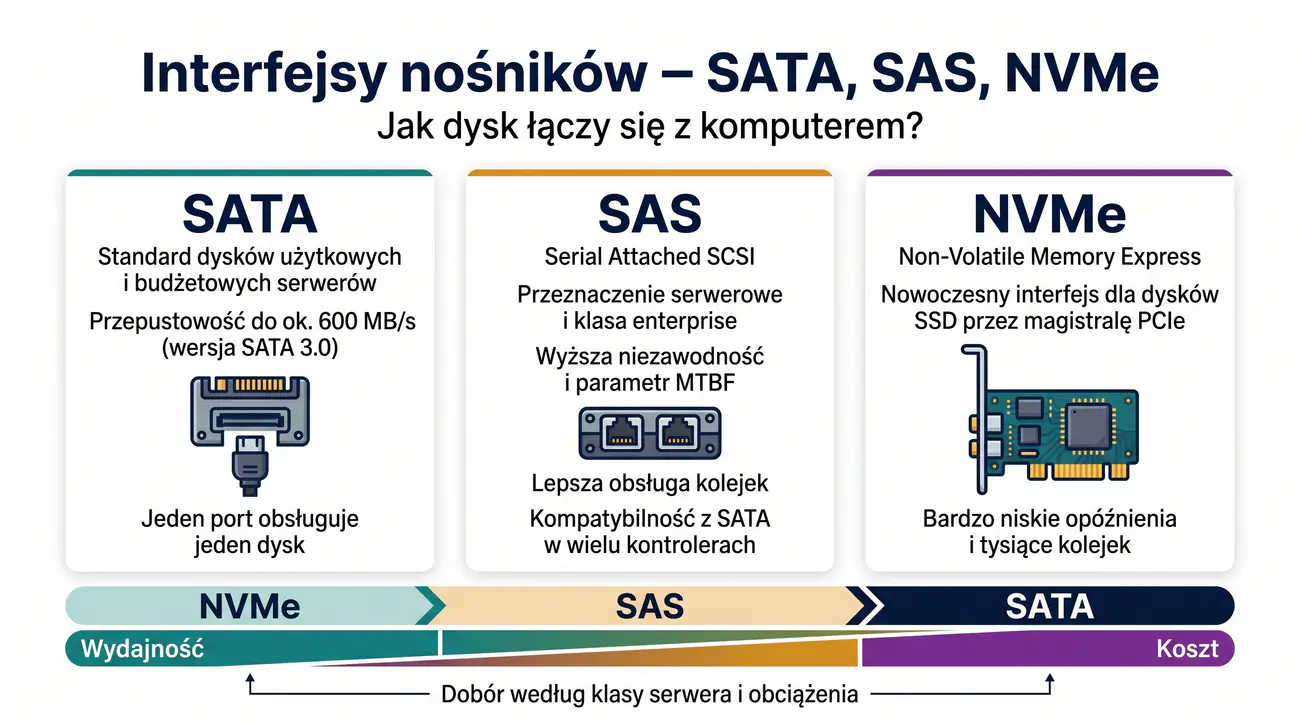
Interfejs określa, w jaki sposób nośnik łączy się z resztą systemu i ile danych może przesłać w jednostce czasu. SATA to prosty i tani standard przeznaczony głównie dla komputerów biurowych oraz tańszych serwerów, z przepustowością około sześciuset megabajtów na sekundę w wersji trzeciej. Jedno gniazdo obsługuje przy tym pojedynczy dysk, co ogranicza możliwość skalowania pojemności.
Standard SAS został zaprojektowany z myślą o środowisku korporacyjnym i oferuje lepsze zarządzanie kolejkami poleceń oraz możliwość dołączania wielu urządzeń przez ekspandery SAS (ang. expanders). Dzięki temu jeden kabel może obsłużyć cały zestaw dysków w obudowie serwera. Ponadto wiele kontrolerów SAS współpracuje z dyskami SATA, co ułatwia awaryjne podmiany.
Protokół NVMe powstał dla pamięci półprzewodnikowych i korzysta bezpośrednio z magistrali PCI Express, osiągając tysiące kolejek zamiast jednej wspólnej kolejki. Taka konstrukcja minimalizuje opóźnienia i wykorzystuje równoległość pamięci flash. Dla najbardziej wymagających aplikacji, takich jak bazy danych czy maszyny wirtualne, NVMe jest dziś standardowym wyborem.
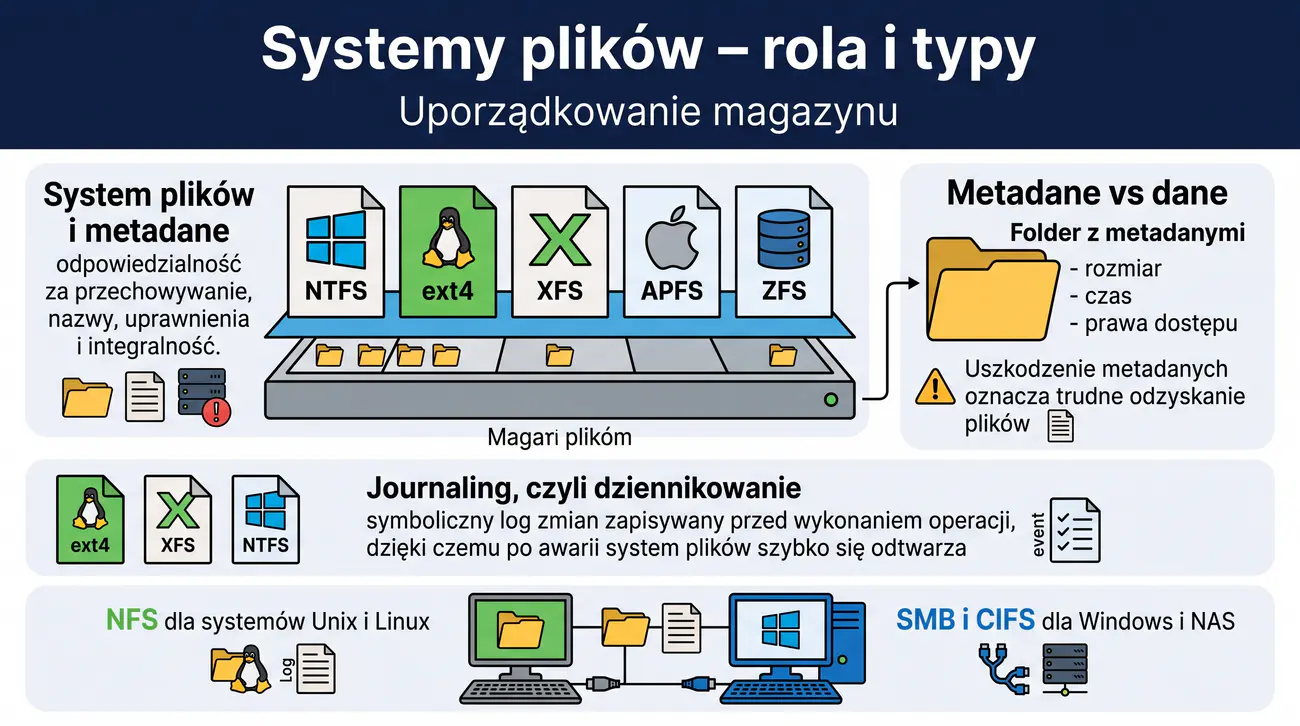
System plików przekształca surową przestrzeń dysku w uporządkowaną hierarchię katalogów, plików i metadanych, bez której urządzenie pozostaje jedynie zbiorem bloków. Osobno przechowywane metadane zawierają nazwy, rozmiary, czasy i uprawnienia, a ich uszkodzenie zwykle oznacza trudne do odzyskania dane. Dlatego ochrona struktury systemu plików bywa ważniejsza niż samo kopiowanie treści.
Mechanizm dziennikowania chroni spójność po nagłym zaniku zasilania, ponieważ opis operacji zapisywany jest wcześniej niż sama treść. Jeśli wykonanie zostanie przerwane, system może szybko cofnąć niepełne zmiany i powrócić do stabilnego stanu. Rozwiązania zaawansowane, takie jak ZFS, dodają sumy kontrolne i samoczynną naprawę wykrytych uszkodzeń.
W środowiskach sieciowych funkcję systemów plików przejmują protokoły NFS i SMB, które udostępniają odległe katalogi klientom. Wybór protokołu zależy od dominujących systemów w organizacji oraz wymagań dotyczących uprawnień. Znajomość tych mechanizmów pozwala przewidzieć, które operacje będą szybkie, a które staną się wąskim gardłem.
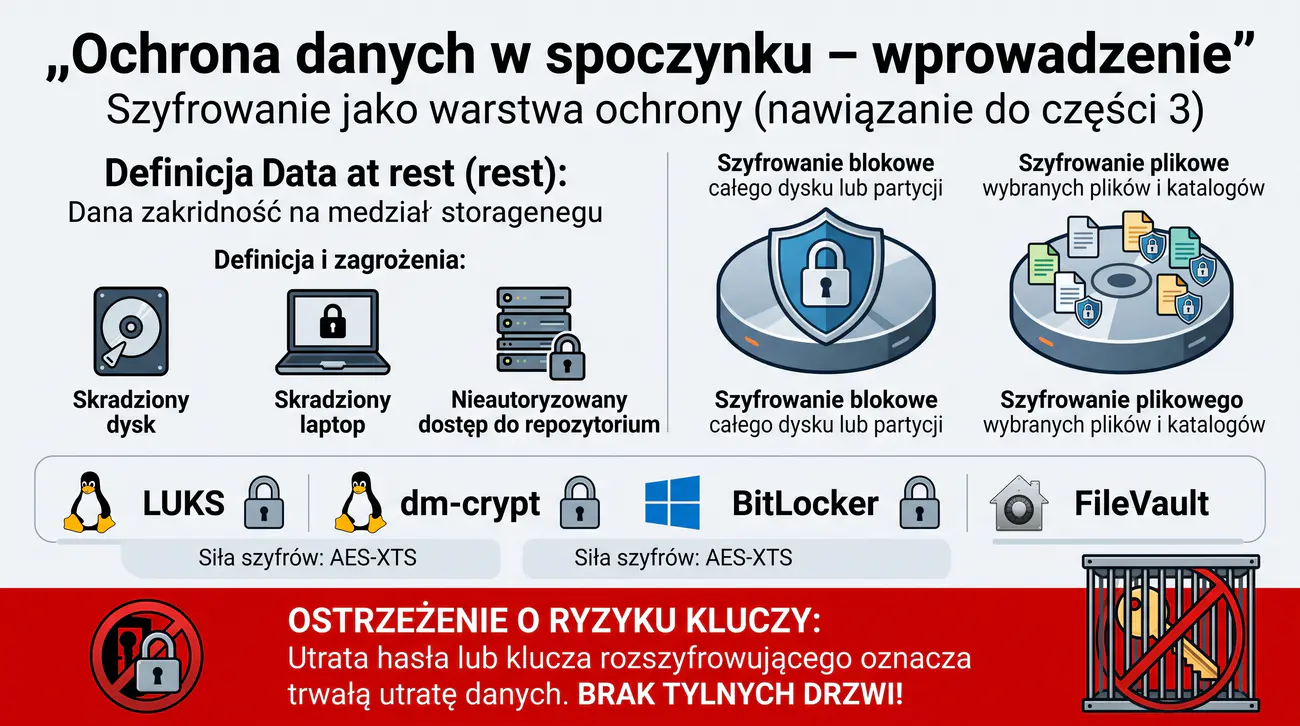
Zapisane na nośniku dane są wyjątkowo łatwym celem ataku, bo wystarczy ukraść komputer, dysk lub taśmę, aby uzyskać pełną treść informacji. Szyfrowanie całego wolumenu blokowego sprawia, że nośnik bez znajomości klucza pozostaje bezużyteczny. W systemach operacyjnych rolę tę pełnią mechanizmy, takie jak LUKS, BitLocker czy FileVault.
Rozwiązania te opierają się na sprawdzonych algorytmach i trybach pracy, a mechanizmy przeznaczone dla dysków systemowych, takie jak BitLocker, współpracują dodatkowo z modułem TPM. Moduł ten przechowuje tajemnice w izolowanym chipie i komplikuje atak polegający na przeniesieniu dysku do innej maszyny. Dzięki temu ochrona działa nawet wtedy, gdy system nie został jeszcze w pełni uruchomiony.
Zasada bezpieczeństwa głosi jednak, że danych kryptograficznie zabezpieczonych nie odzyska się bez klucza, więc utrata hasła czy pliku klucza oznacza utratę treści. Przed wdrożeniem szyfrowania należy zatem przygotować procedury odzyskiwania, na przykład kopie kluczy lub wydruki kodów ratunkowych. Szyfrowanie w spoczynku jest więc decyzją organizacyjną, a nie tylko techniczną.
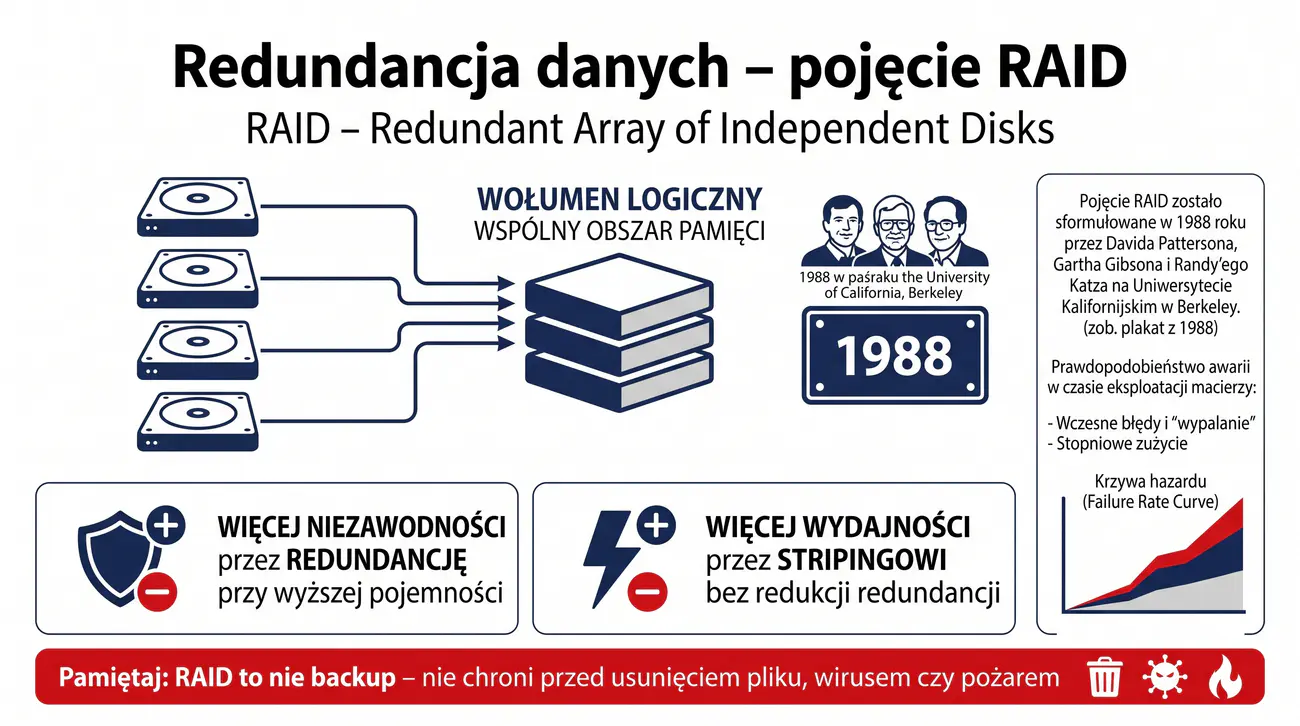
Pojęcie macierzy niezależnych dysków narodziło się w Berkeley w pracy naukowej Pattersona, Gibsona i Katza, która proponowała połączenie wielu tanich napędów w jeden logiczny wolumen. Pierwotnie skrót RAID oznaczał macierz niedrogich dysków, a dopiero z czasem utrwaliła się interpretacja dotycząca dysków niezależnych. Poziomy RAID zrodziły się z wyborów, jakie niesie sama koncepcja nadmiarowości.
Trzy cele, którym może służyć macierz, to wydajność, pojemność i niezawodność, przy czym zwykle w drodze kompromisu realizuje się jeden lub dwa z nich. Paskowanie poprawia szybkość, lustro daje odporność, a parzystość oferuje ochronę za cenę części pojemności. Wybór poziomu sprowadza się w gruncie rzeczy do ustalenia hierarchii tych celów.
Należy zapamiętać, że RAID nie zastępuje kopii zapasowych, bo nie chroni przed logicznymi błędami, wirusami ani katastrofami. Świadomość tej różnicy chroni przed fałszywym poczuciem bezpieczeństwa typowym dla początkujących administratorów. To rozróżnienie pojawia się zresztą w wielu zagadnieniach kontrolnych całego materiału.
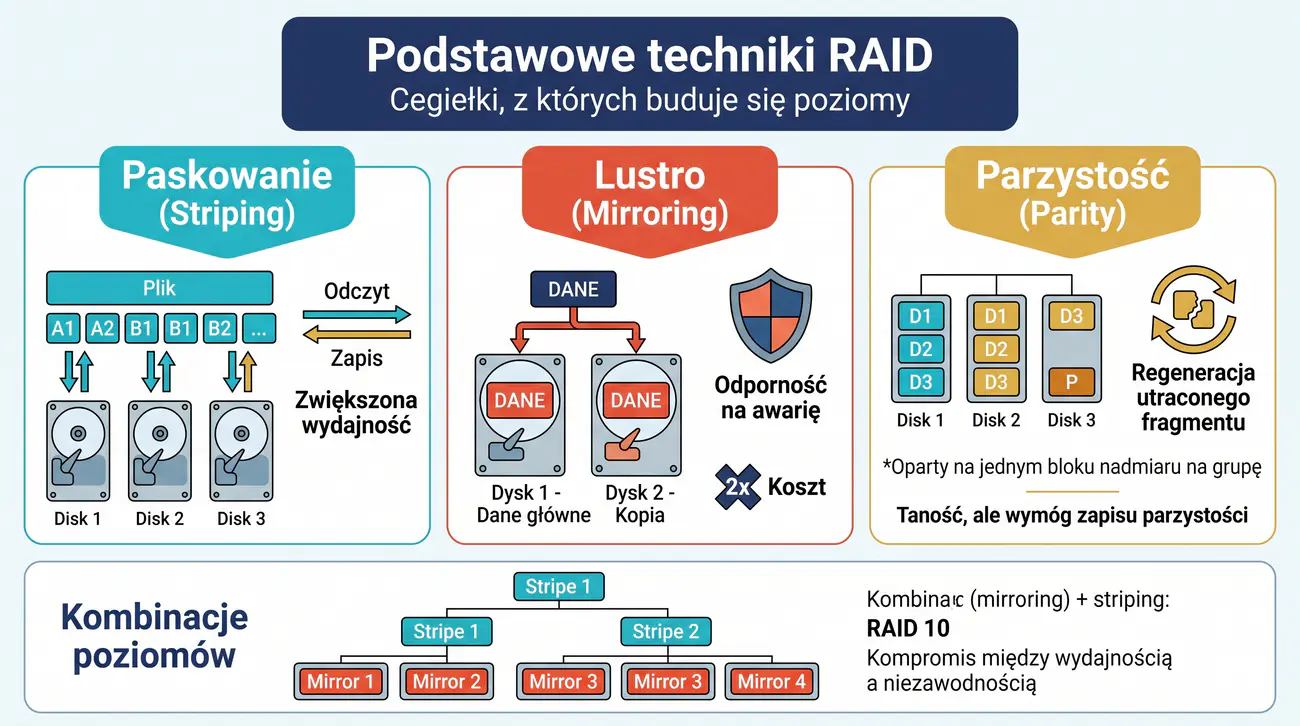
Wszystkie poziomy RAID można rozłożyć na trzy podstawowe techniki o różnych kosztach i właściwościach. Paskowanie dzieli strumień danych na równe fragmenty rozłożone po dyskach, dzięki czemu operacje wejścia-wyjścia wykonują się równolegle. Lustrowanie natomiast tworzy pełną kopię zapisaną na drugim nośniku, podwajając koszt pojemności.
Parzystość dodaje nadmiarowy blok wyliczony na podstawie pozostałych danych, z którego można odtworzyć utracony fragment. Zapis z parzystością wymaga odczytu danych przed ich aktualizacją, co obniża wydajność najmniejszych operacji zapisu. Z kolei odczyty nie ponoszą takiego kosztu, dlatego macierze z parzystością lubią obciążenia odczytowe.
Łącząc techniki, otrzymuje się poziomy kaskadowe, czego przykładem jest RAID 10 łączący lustro z paskowaniem. Umiejętność rozłożenia dowolnego poziomu na te cegiełki pozwala oceniać właściwości macierzy bez zapamiętywania całych tabel. Ta metoda analizy przydaje się także przy ocenie niestandardowych rozwiązań producentów.
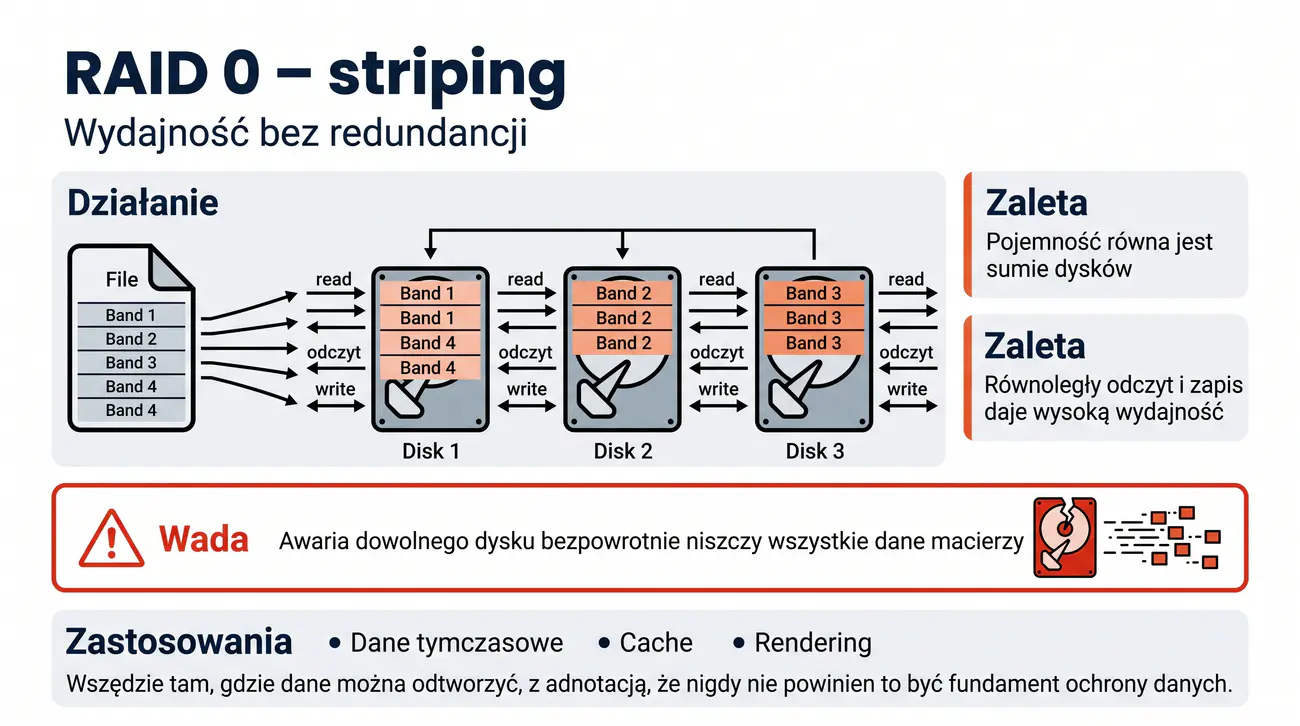
RAID 0 realizuje wyłącznie paskowanie i nie zawiera żadnej nadmiarowości, przez co wszystkie dyski szybko pracują na rzecz jednego wolumenu. Równoległy zapis sprawia, że wydajność rośnie wraz z liczbą urządzeń, a cała pojemność jest dostępna dla użytkownika. Taki układ bywa kuszący, zwłaszcza przy porównaniu z kosztownymi lustrami.
Awaria dowolnego elementu macierzy niszczy zawartość całości, bo każdy fragment danych jest rozdzielony między wiele dysków. Prawdopodobieństwo utraty danych rośnie wraz z liczbą napędów, co przekreśla stosowanie tego poziomu do magazynów krytycznych. Sensowne zastosowania to dane tymczasowe, pamięci cache renderów oraz obszary, które łatwo odtworzyć.
Projektant powinien mieć świadomość, że RAID 0 nie jest ochroną, lecz wyłącznie sposobem na zwiększenie wydajności. W systemach produkcyjnych pojawia się najczęściej nieświadomie w konfiguracjach niezalecanych przez producentów. Z tego względu w materiałach szkoleniowych podkreśla się, iż poziom zerowy nigdy nie powinien służyć jako podstawowa ochrona.
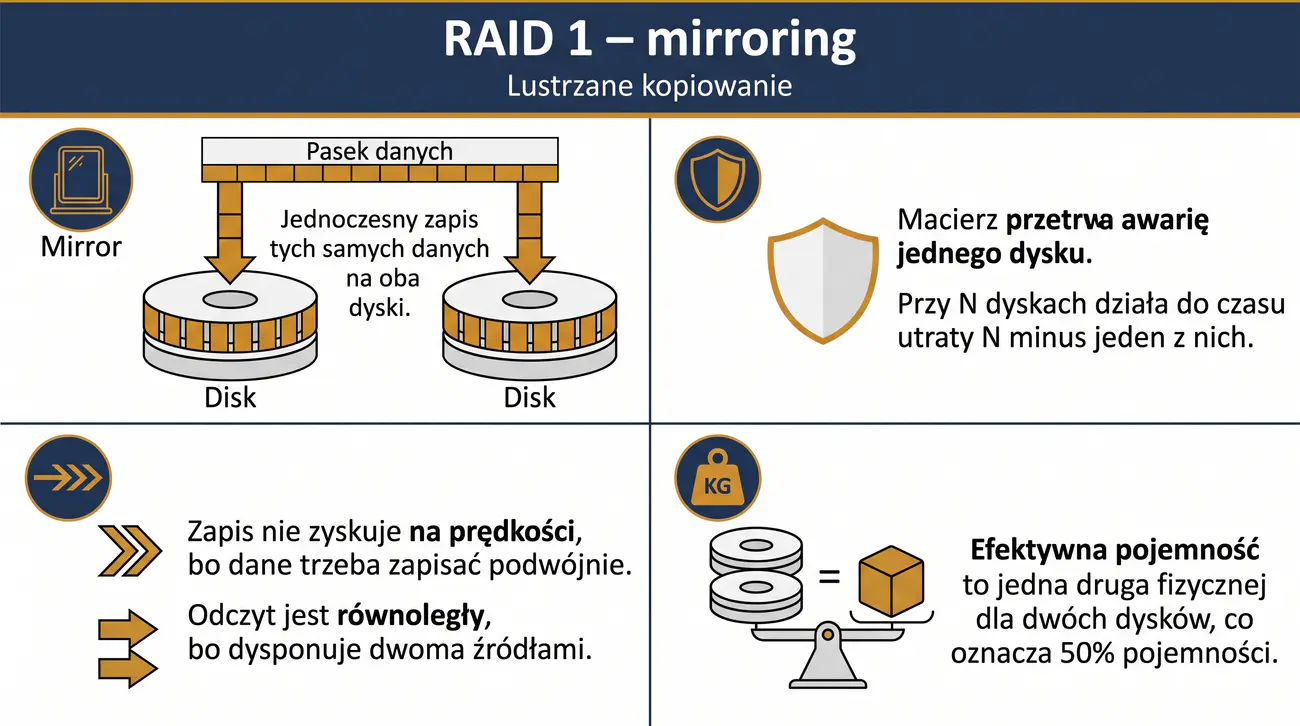
RAID 1 zapewnia najprostszy możliwy sposób odporności, bo każdy zapis trafia jednocześnie na dwa lub więcej dysków. Awaria jednego egzemplarza nie przerywa pracy, a system bezzwłocznie korzysta z pozostałych kopii. Dzięki temu odzyskanie po awarii nie wymaga czasochłonnego przeliczania parzystości.
Koszt tego komfortu to połowa pojemności fizycznej w typowej macierzy dwudyskowej, a także brak wzrostu prędkości zapisu. Odczyty można natomiast obsługiwać równolegle z obu egzemplarzy, co poprawia wydajność operacji odczytowych. Lustra sprawdzają się zwłaszcza dla danych o niewielkiej objętości i wysokiej wartości.
Często stosuje się je do systemowych dysków serwerów, gdzie priorytet stanowi szybkie uruchomienie i prosta odbudowa. Po wymianie uszkodzonego dysku kontroler po prostu kopiuje zawartość sprawnego nośnika. Taka odbudowa nie obciąża pozostałych dysków tak mocno, jak w macierzach opartych na parzystości.
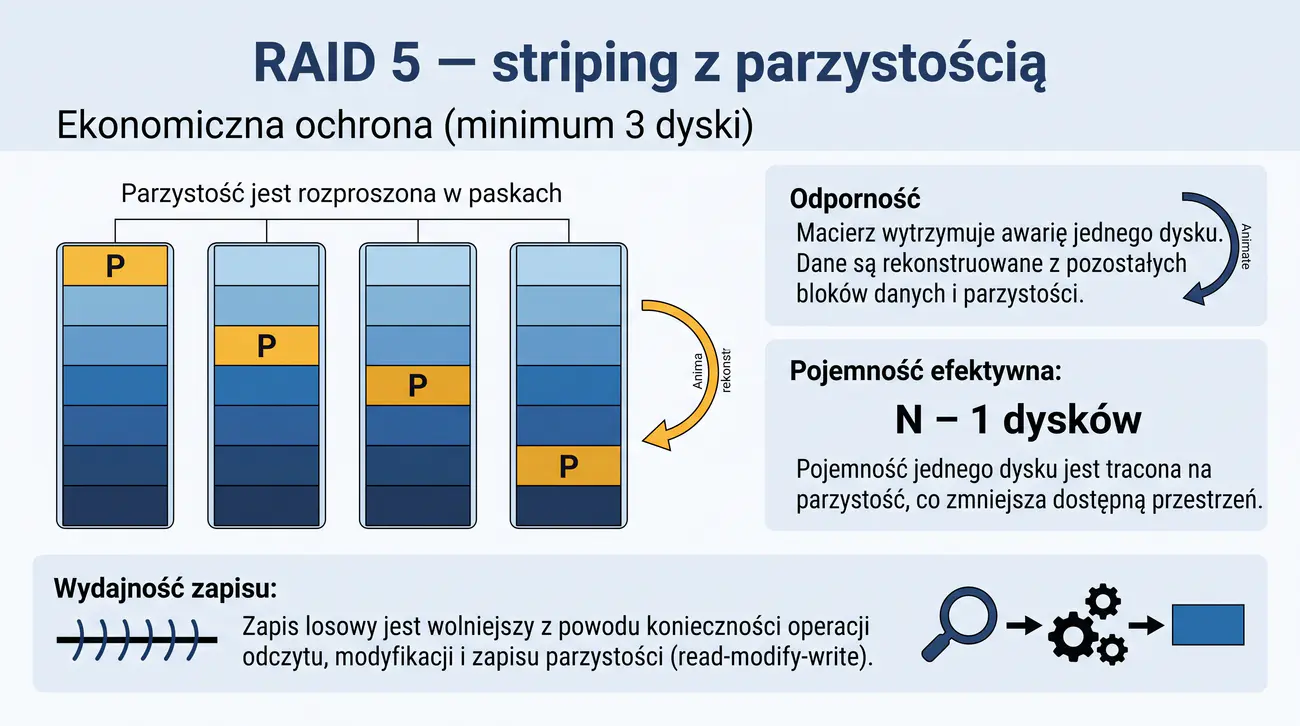
RAID 5 łączy paskowanie z parzystością rozproszoną po wszystkich dyskach, dzięki czemu bloki nadmiaru nie gromadzą się na jednym urządzeniu. Tolerancja obejmuje awarię pojedynczego dysku, a odtworzenie opiera się na danych i parzystości pozostałych nośników. Minimalna liczba dysków wynosi trzy, a pojemność efektywna jest o jeden dysk mniejsza od fizycznej.
Kosztem oszczędności pojemności jest tak zwana aktualizacja parzystości, która przy losowym zapisie wymaga odczytania starych bloków i zapisania nowych wyliczeń. Efekt ten obniża wydajność zapisu, zwłaszcza przy małych porcjach danych. Współczesne kontrolery łagodzą problem dzięki buforom, ale fizyczna zależność pozostaje.
Ze względu na dobrą równowagę między ceną a ochroną RAID 5 od lat pozostaje popularnym wyborem w urządzeniach NAS i serwerach plików. Przy bardzo dużych dyskach rośnie jednak ryzyko drugiej awarii w trakcie odbudowy. W takich konfiguracjach projektanci coraz częściej skłaniają się ku poziomowi szóstemu.
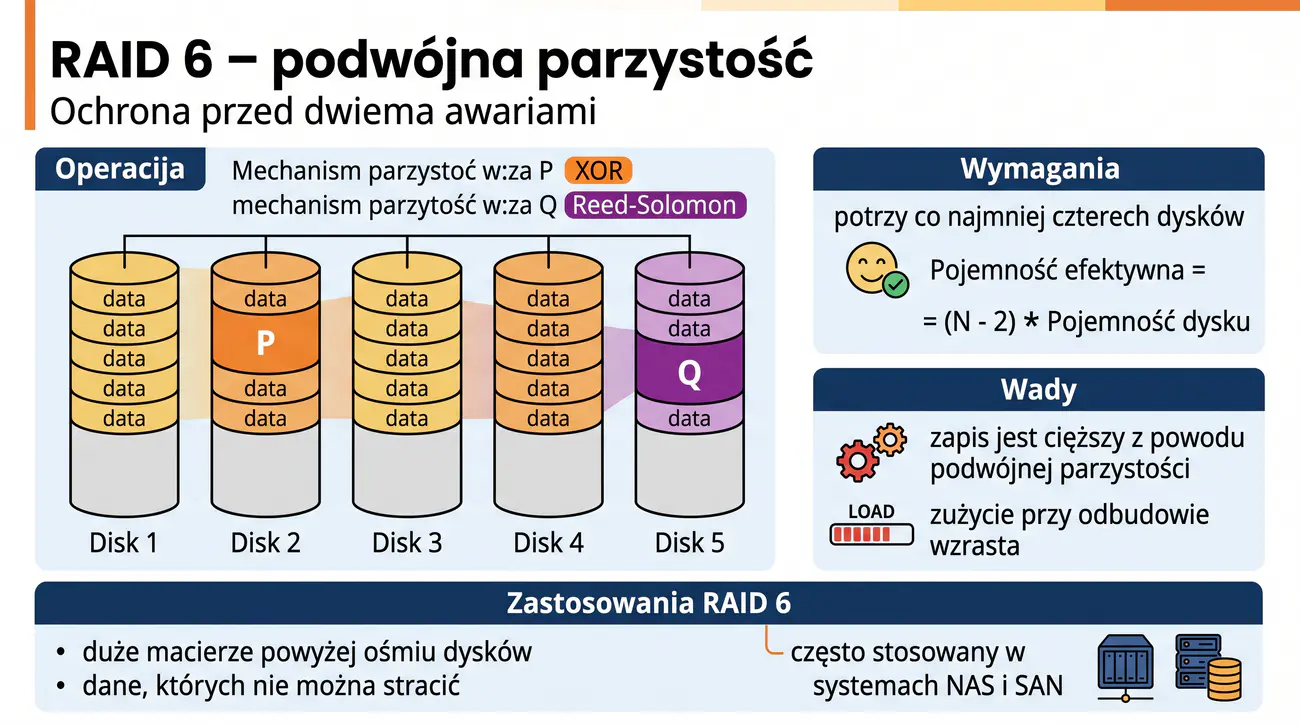
RAID 6 rozszerza ideę parzystości o drugi, niezależny zestaw bloków nadmiaru, dzięki czemu macierz toleruje jednoczesną awarię dwóch dysków. Są dwa spotykane warianty: klasyczny P+Q z dwoma niezależnie liczonymi blokami XOR (NetApp, Dell) oraz wariant z blokiem parzystości w kodzie Reed-Solomona (np. ADATA, IBM ServeRAID) - w obu przypadkach tolerowana jest awaria dwóch dysków. Takie zabezpieczenie jest szczególnie cenne w dużych macierzach, gdzie sama liczba nośników zwiększa prawdopodobieństwo równoczesnych usterek.
Podczas odbudowy pozostałe dyski pracują intensywniej, a rosnące obciążenie zwiększa szansę uszkodzenia kolejnego urządzenia, dlatego podwójna parzystość daje zapas bezpieczeństwa. Ceną jest pojemność pomniejszona o dwa dyski oraz wolniejszy zapis wynikający z aktualizacji dwóch bloków nadmiaru. Rozwiązanie to jest zatem zalecane w magazynach archiwalnych i środowiskach o bardzo wysokich wymaganiach dostępności.
Konstrukcje firmowe, takie jak RAID-DP z macierzy NetApp, realizują tę samą ideę w nieco innej formie. Podobieństwa między poziomami piątym a szóstym ułatwiają późniejsze migracje istniejących wolumenów. Do wyboru poziomu zachęca kilka konkretnych zaleceń omawianych w praktycznych studiach przypadków.
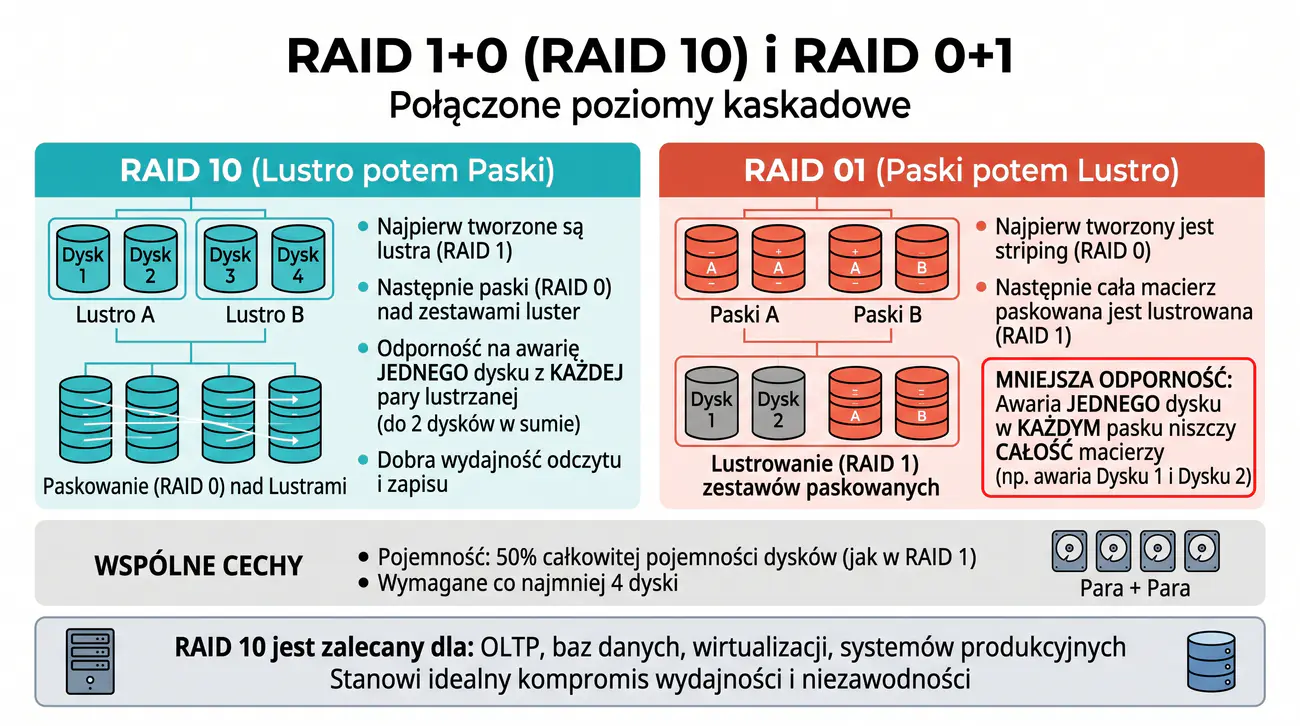
Poziomy kaskadowe powstają przez sekwencyjne zastosowanie dwóch technik, a ich właściwości zależą od kolejności wykonanych kroków. RAID 10 najpierw tworzy pary lustrzane, a dopiero nad nimi robi paskowanie, co daje wysoką wydajność i odporność na awarię jednego dysku w każdej parze. RAID 01 działa odwrotnie: najpierw paskuje, potem lustruje całość.
Różnica między tymi układami bywa nieintuicyjna, ale ma konkretne konsekwencje przy wielokrotnych awariach. W RAID 01 uszkodzenie jednego dysku w każdej z lustrzanych części prowadzi do utraty wszystkich danych. RAID 10 przeżywa natomiast awarię dowolnego dysku, o ile nie dotyczy tej samej pary.
Mimo że oba poziomy wymagają co najmniej czterech dysków i dają połowę pojemności, to RAID 10 jest jednoznacznie preferowany w systemach produkcyjnych. Znajduje zastosowanie w bazach danych OLTP oraz środowiskach wirtualizacji, gdzie liczy się równowaga między wydajnością a niezawodnością. W praktyce wiele kontrolerów nie oferuje nawet trybu 01.
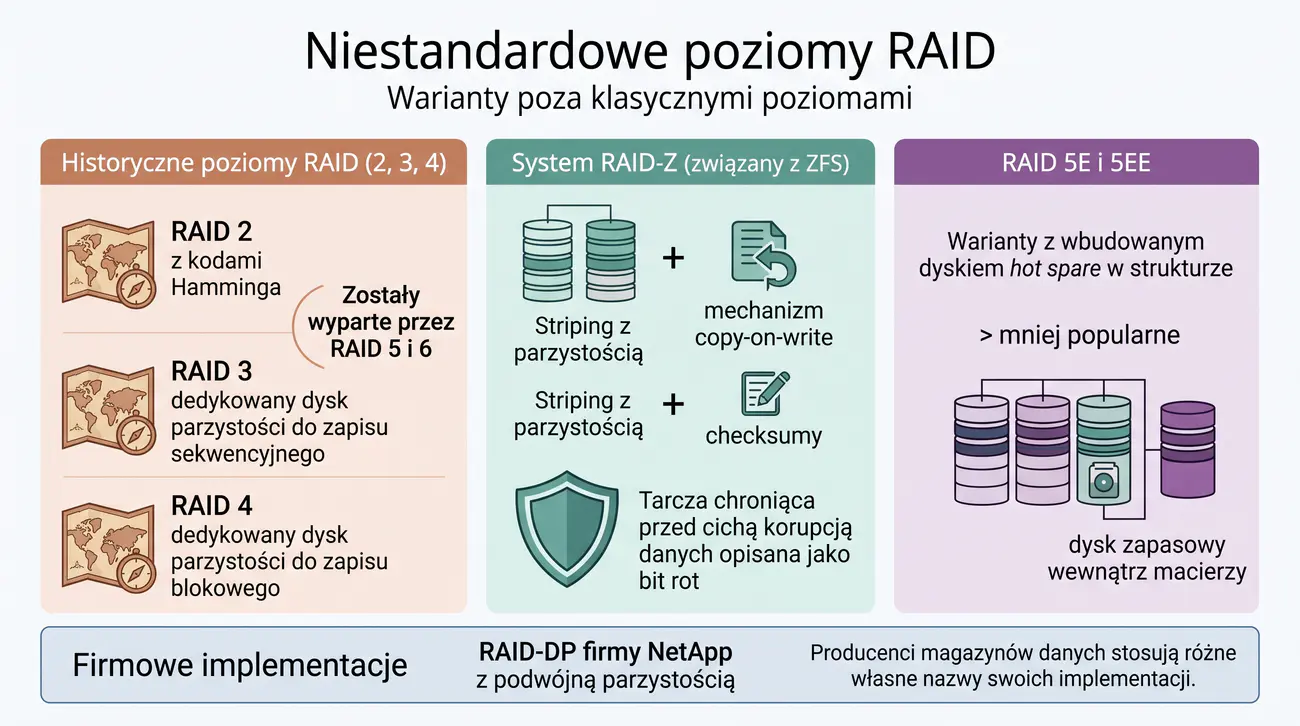
Obok klasycznych poziomów narodziło się wiele rozwiązań historycznych, firmowych i systemowych, które warto rozpoznawać po nazwie. Poziomy dwa, trzy i cztery były wczesnymi propozycjami opartymi na kodach korekcyjnych oraz dedykowanych dyskach parzystości, ale szybko ustąpiły miejsca nowoczesnym konstrukcjom. Współcześnie elementy ich idei wracają w zaawansowanych macierzach.
System plików ZFS wprowadził własną odmianę paskowania z parzystością, nazwaną RAID-Z, wzbogaconą o mechanizm kopiowania przy zapisie oraz sumy kontrolne. Dzięki temu architektura potrafi wykryć i naprawić cichą korupcję danych, zanim rozprzestrzeni się na cały wolumen. To istotna przewaga nad tradycyjnymi macierzami, które nie sprawdzają spójności danych.
Warianty oznaczone literą E, jak RAID 5E, osadzają dysk rezerwowy w strukturze macierzy, skracając czas odbudowy. Producenci klasy korporacyjnej tworzą własne nazwy, na przykład RAID-DP czy układy z potrójną parzystością. Inżynier nie musi znać szczegółów każdego rozwiązania, lecz powinien umieć ocenić, do czego służy konkretna konstrukcja.
| Poziom | Min. dyski | Odporność | Pojemność efektywna | Wydajność zapisu | Odczyt |
|---|---|---|---|---|---|
| RAID 0 | 2 | brak | N | wysoka | wysoka |
| RAID 1 | 2 | 1 dysk | N/2 | średnia | wysoka |
| RAID 5 | 3 | 1 dysk | N-1 | średnia (parzystość) | wysoka |
| RAID 6 | 4 | 2 dyski | N-2 | niższa (2× parzystość) | wysoka |
| RAID 10 | 4 | 1/para | N/2 | wysoka | bardzo wysoka |
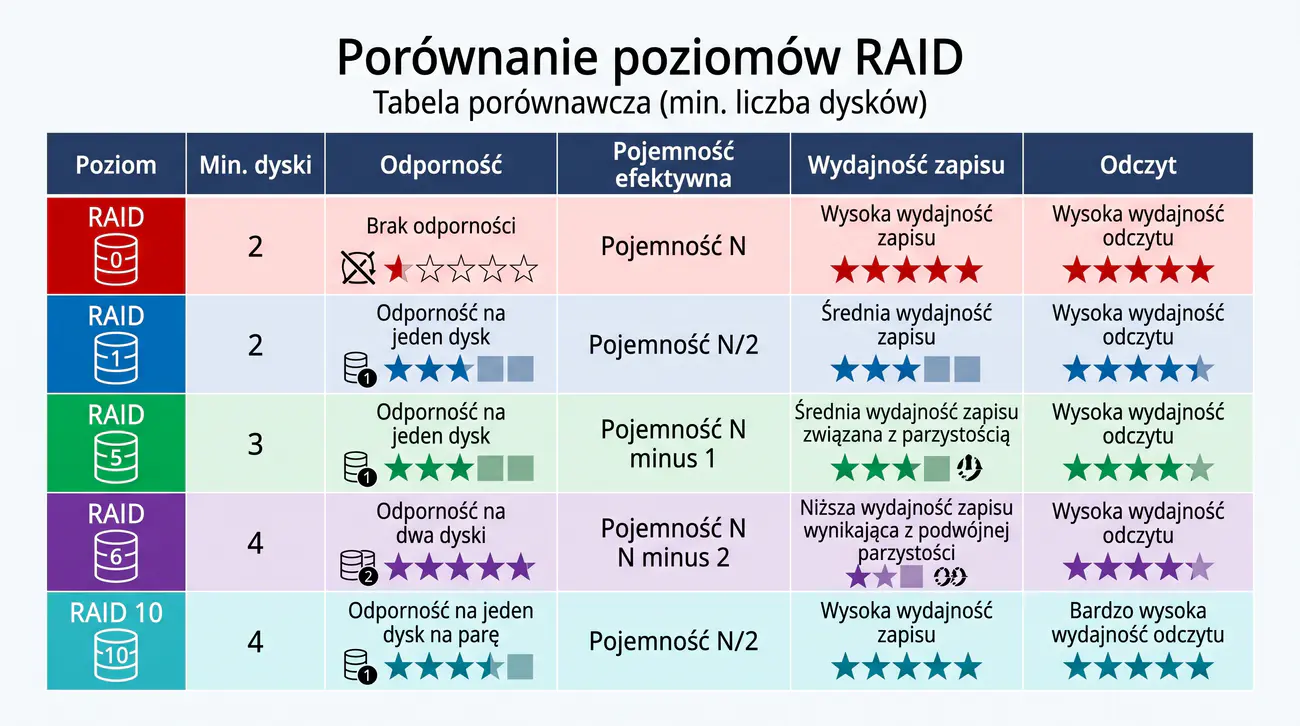
Zestawienie poziomów w tabeli porządkuje wiedzę i pozwala szybko porównać kluczowe parametry macierzy, takie jak minimalna liczba dysków czy tolerowane awarie. Wyróżnikiem RAID 10 jest wysoka wydajność zapisu przy koszcie połowy pojemności, natomiast RAID 5 i 6 optymalizują koszt przestrzeni. Czytając tabelę, należy pamiętać, że podane wskaźniki mają charakter względny.
Wartość odczytów oznaczona jako wysoka wynika głównie z równoległości, bo wiele dysków obsługuje jednocześnie różne porcje danych. Zapis w macierzach z parzystością bywa ograniczony, więc do intensywnych zapisów lepiej wybrać lustra. Wniosek z tabeli nie jest zatem jednoznaczny, a decyduje charakter aplikacji.
Pojemność efektywną wyraża się wzorami N, N podzielone przez dwa czy N pomniejszone o koszt parzystości, co wymaga ćwiczeń na konkretnych zestawach dysków. Właśnie takie rachunki pojawiają się w analizach technicznych i studiach przypadków. Umiejętność szybkiego wykonania obliczeń jest cenną kompetencją projektanta.
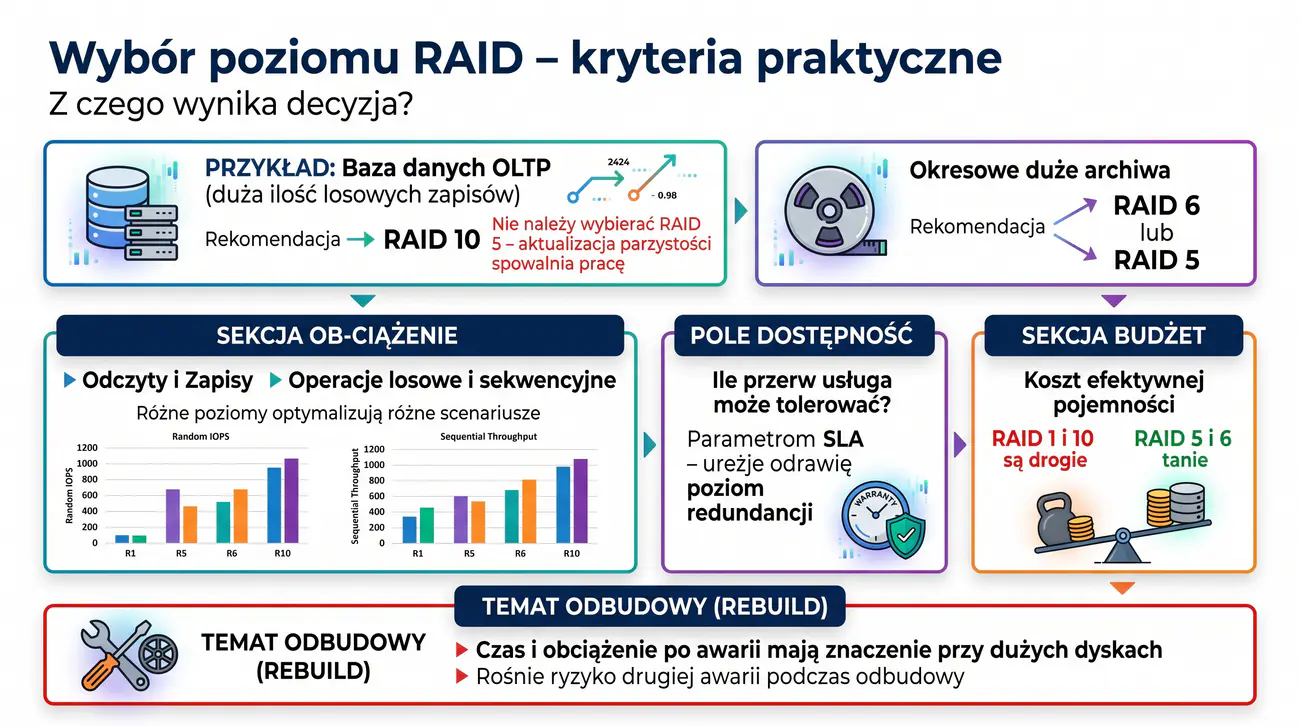
Wybór poziomu RAID rozpoczyna się od analizy obciążenia, bo odmienne wzorce dostępu wymagają innych konstrukcji macierzy. Bazy przetwarzające wiele drobnych zapisów zwykle najlepiej czują się na lustrach z paskowaniem, a duże wolumeny odczytowe radzą sobie z parzystością. Dopiero po tej diagnozie należy przejść do oceny kosztów.
Dostępność określona przez umowy poziomu usług decyduje o tym, ile redundancji jest niezbędne, a budżet narzuca granicę możliwych rozwiązań. Przy dużych dyskach szczególne znaczenie ma czas odbudowy, który rośnie wprost z pojemnością nośników. Im dłuższa odbudowa, tym wyższe ryzyko drugiej awarii, dlatego duże macierze skłaniają się ku RAID 6.
W praktyce decyzja bywa podejmowana w zespołach wieloosobowych i wymaga udokumentowania, aby przyszli administratorzy rozumieli jej podstawy. Dobrze prowadzone projekty przewidują też dyski zapasowe i procedury wymiany. Taki proces przekłada wymagania biznesowe na konkretny, przemyślany projekt infrastruktury.
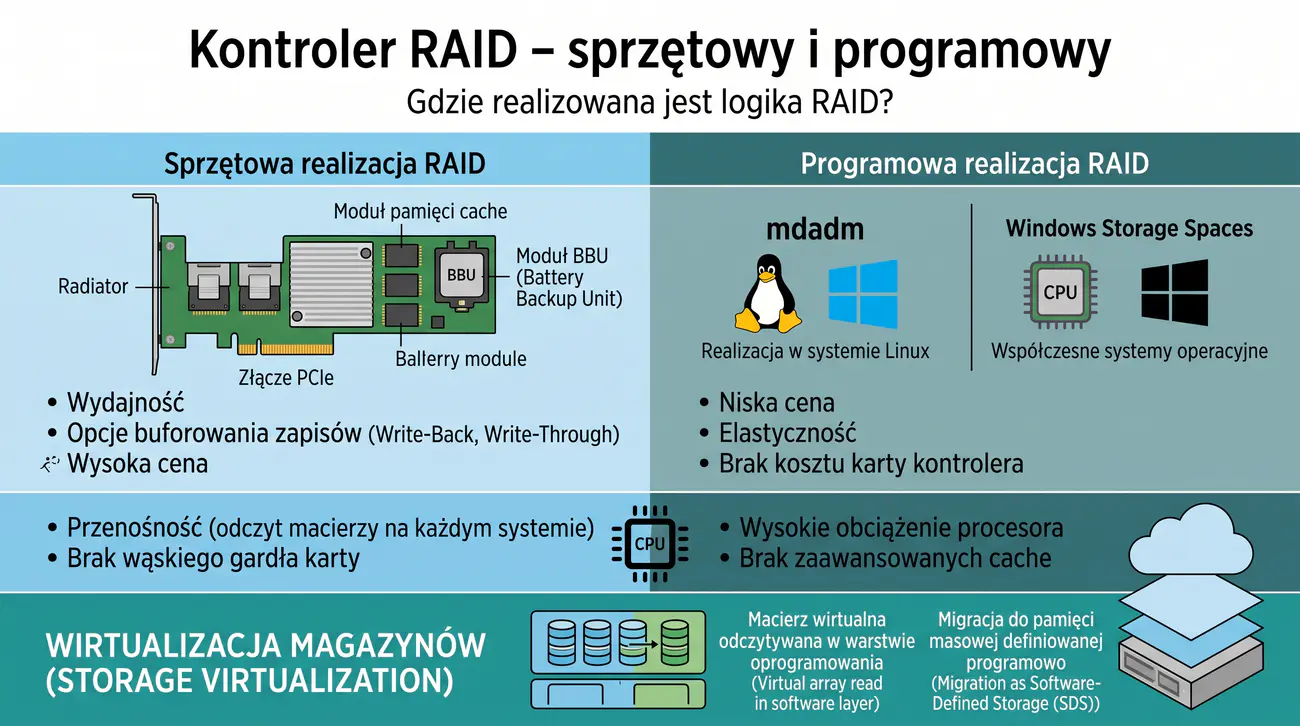
Logika macierzy może być realizowana przez dedykowaną kartę kontrolera albo przez oprogramowanie systemu operacyjnego, a wybór wpływa na wydajność i przenośność. Kontroler sprzętowy posiada własny procesor i pamięć podręczną, która w połączeniu z modułem baterii umożliwia bezpieczny bufor zapisu. Tryb taki, nazywany write-back, znacznie przyspiesza operacje kosztem ryzyka utraty bufora przy braku zasilania.
Rozwiązania programowe, takie jak mdadm w systemie Linux czy Storage Spaces w Windows, korzystają z zasobów procesora głównego. Ich zaletą jest niższy koszt i możliwość odczytania macierzy na innym sprzęcie bez czekania na identyczną kartę. Wada polega na obciążaniu CPU oraz braku zaawansowanych funkcji buforowania.
Nowoczesne systemy operacyjne implementują nawet cienkie warstwy wirtualizacji magazynu, które oddzielają logikę od fizycznego sprzętu. Takie podejście, określane mianem pamięci masowej definiowanej programowo (Software-Defined Storage, SDS), pozwala centralnie zarządzać pojemnością wielu serwerów. Projektant, który rozumie te różnice, potrafi ocenić, kiedy warto zainwestować w dedykowane kontrolery.
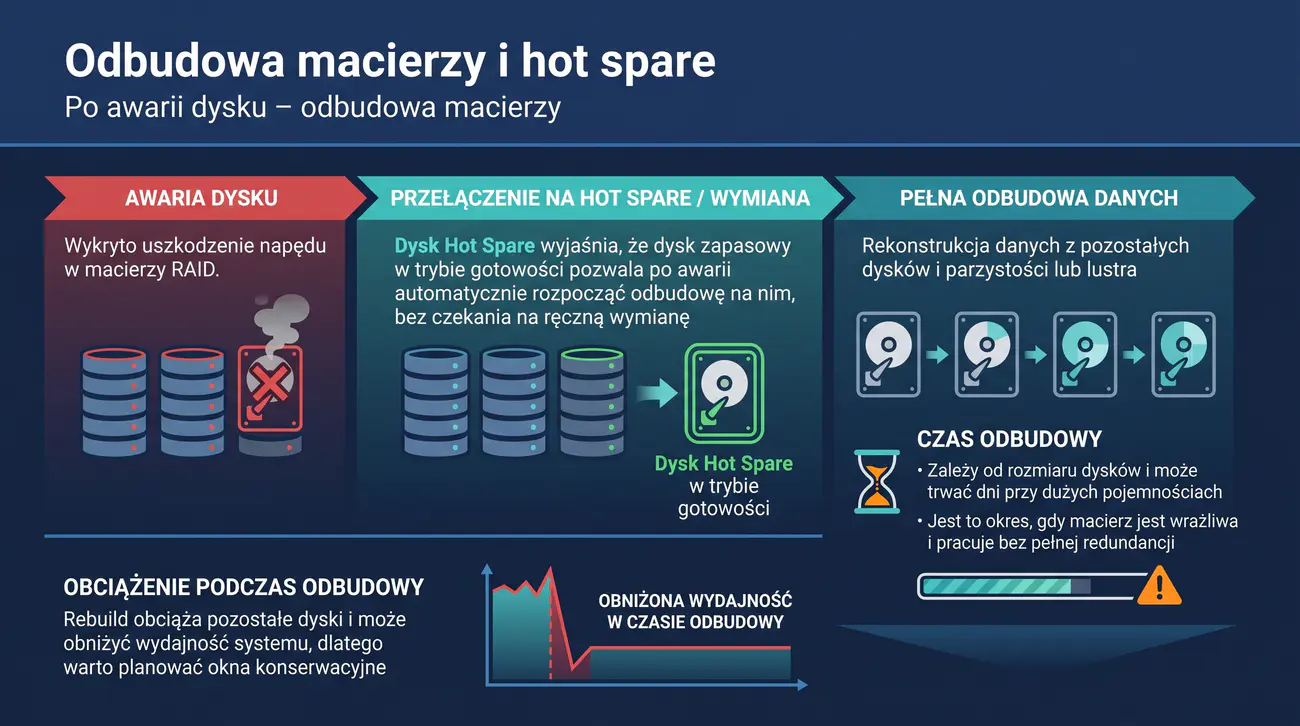
Po awarii dysku kluczowe jest jak najszybsze przywrócenie pełnej redundancji, a proces ten nazywa się odbudową macierzy. Kontroler przelicza dane z pozostałych nośników, wykorzystując parzystość lub lustro, i zapisuje je na nowym dysku. Czas odbudowy zależy od pojemności, szybkości interfejsu i bieżącego obciążenia systemu.
Mechanizm dysku rezerwowego, czyli hot spare, skraca ten okres, bo urządzenie czeka w gotowości i automatycznie przejmuje rolę uszkodzonego nośnika. Dzięki temu nie trzeba czekać na interwencję człowieka, a ryzyko pracy bez pełnej ochrony maleje. Układy te dzieli się na dedykowane dla jednej macierzy oraz globalne, wspólne dla wielu wolumenów.
Należy pamiętać, że podczas odbudowy pozostałe dyski pracują intensywniej, co może obniżać wydajność usług i zwiększać temperaturę. Z tego powodu dobrze zaplanowane środowiska wykonują takie operacje poza szczytem obciążenia. Dodatkowo cykliczne odczyty kontrolne pozwalają wykryć ukryte uszkodzenia sektorów czekające na swoją kolej.
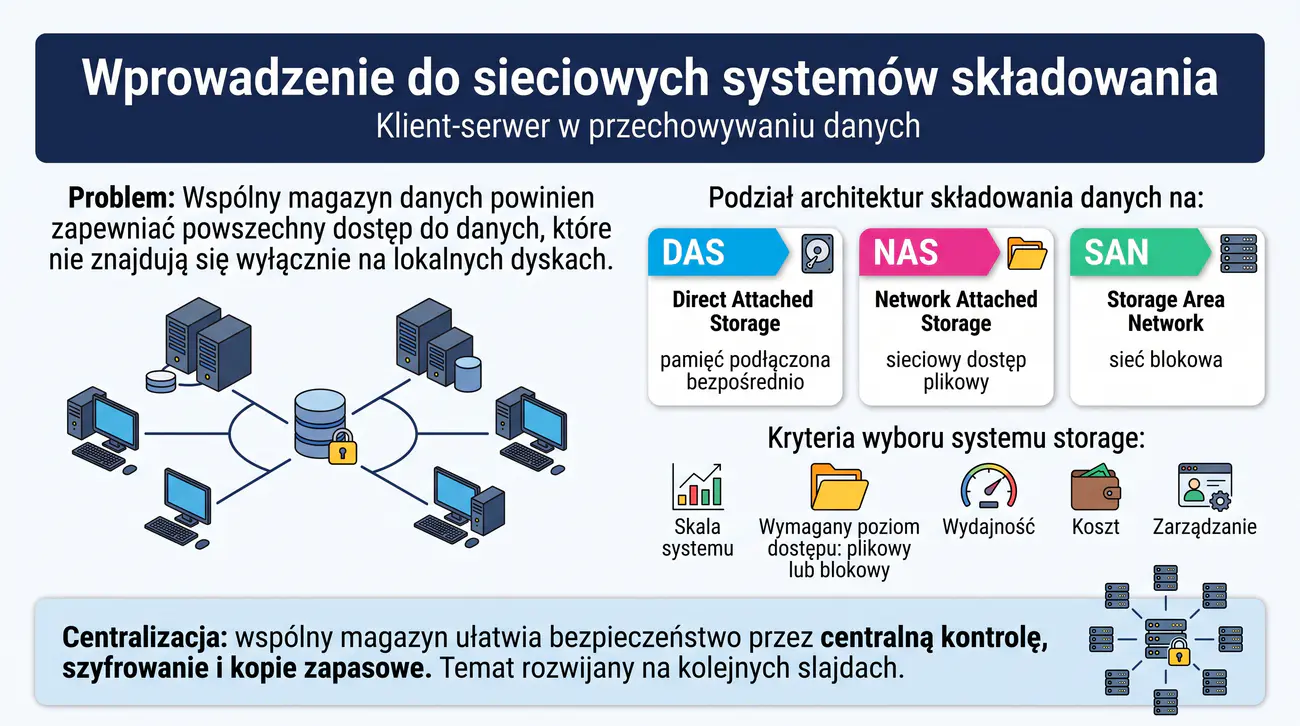
Rosnąca liczba serwerów i stacji roboczych sprawia, że przechowywanie danych wyłącznie lokalnie staje się niepraktyczne. Gdy wiele maszyn musi korzystać z tych samych zasobów, trzeba zapewnić im wspólny, centralnie zarządzany magazyn. To właśnie ten problem rozwiązują architektury NAS i SAN, natomiast DAS pozostaje rozwiązaniem dla pojedynczych hostów.
Trzy architektury różnią się rodzajem dostępu, poziomem udziału w sieci oraz kosztami, dlatego wybór należy poprzedzić analizą wymagań. Dostęp plikowy oferuje wygodę stosowaną w biurach, a dostęp blokowy precyzję potrzebną bazom danych. Pomocne w decyzjach są kryteria skali, wydajności oraz umiejętności zespołu administracyjnego.
Centralizacja przynosi również korzyści bezpieczeństwa, bo kontrola dostępu, szyfrowanie i kopie zapasowe koncentrują się w jednym miejscu. Jednocześnie rośnie rola pojedynczych urządzeń, dlatego ich awarie należy przewidywać przez redundancję. Ten kompromis między prostotą a niezawodnością towarzyszy projektantom magazynów od lat.
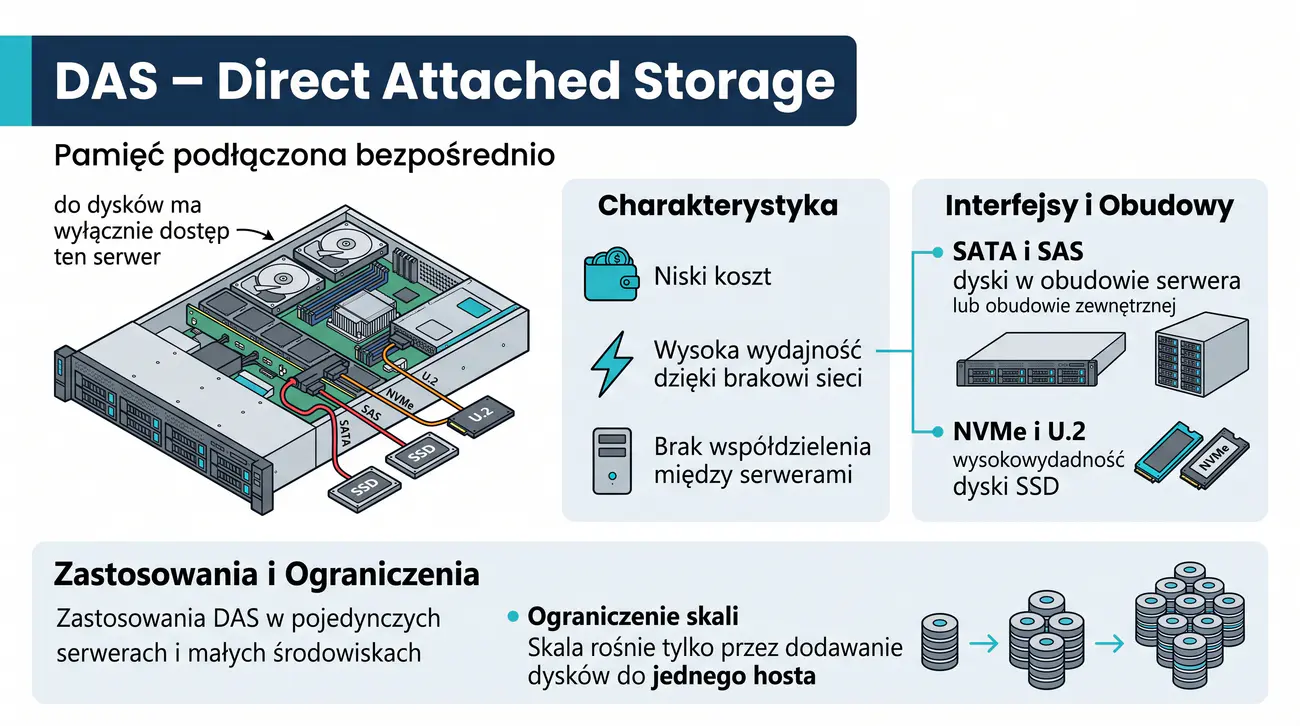
Architektura DAS wymaga bezpośredniego podłączenia nośników do pojedynczego serwera, co daje najkrótszą drogę przesyłu danych. Brak pośredników sieciowych przekłada się na niskie opóźnienia i pełną dostępność przepustowości dla jednego hosta. Takie rozwiązanie jest przy tym najtańsze i najprostsze w utrzymaniu.
Główną wadą DAS jest brak współdzielenia, bo do dysków dociera wyłącznie serwer, do którego są podłączone. Rozbudowa pojemności ogranicza się do dodawania kolejnych nośników w obrębie jednego urządzenia, co utrudnia centralne zarządzanie. W efekcie architektura ta sprawdza się w małych środowiskach i na stanowiskach o jasno określonych zadaniach.
Należy także zadać sobie pytanie o awaryjność i dostępność, ponieważ utrata serwera oznacza utratę dostępu do jego magazynu. Z tego powodu DAS uzupełnia się zwykle o kopie zapasowe i plany odzyskiwania. W środowiskach rozproszonych pełni rolę warstwy pomocniczej obok centralnych macierzy i urządzeń NAS.
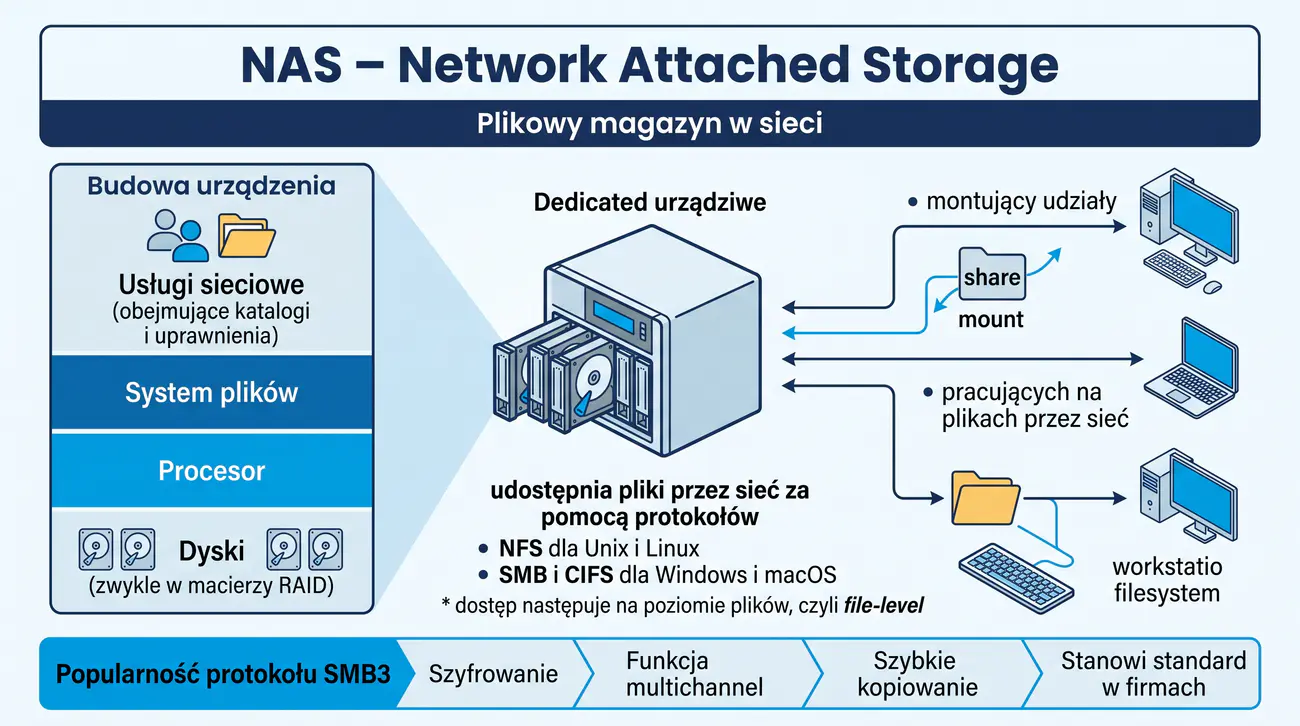
Urządzenie klasy NAS jest gotowym do wdrożenia serwerem plików, który przechowuje dane na dyskach i udostępnia je przez sieć. Klienci korzystają z udziałów protokołami NFS lub SMB, traktując je jak zwykłe foldery lokalne. Takie podejście odciąża stacje robocze od odpowiedzialności za magazynowanie danych.
Dostęp na poziomie pliku sprawia, że NAS doskonale sprawdza się w zadaniach biurowych, takich jak współdzielone dokumenty, kopie robocze czy repozytoria projektów. Dodatkowo urządzenie często oferuje gotowe narzędzia do migawek, replikacji i odzyskiwania. Dzięki temu mały zespół może prowadzić profesjonalną ochronę danych bez zatrudniania wyspecjalizowanych inżynierów.
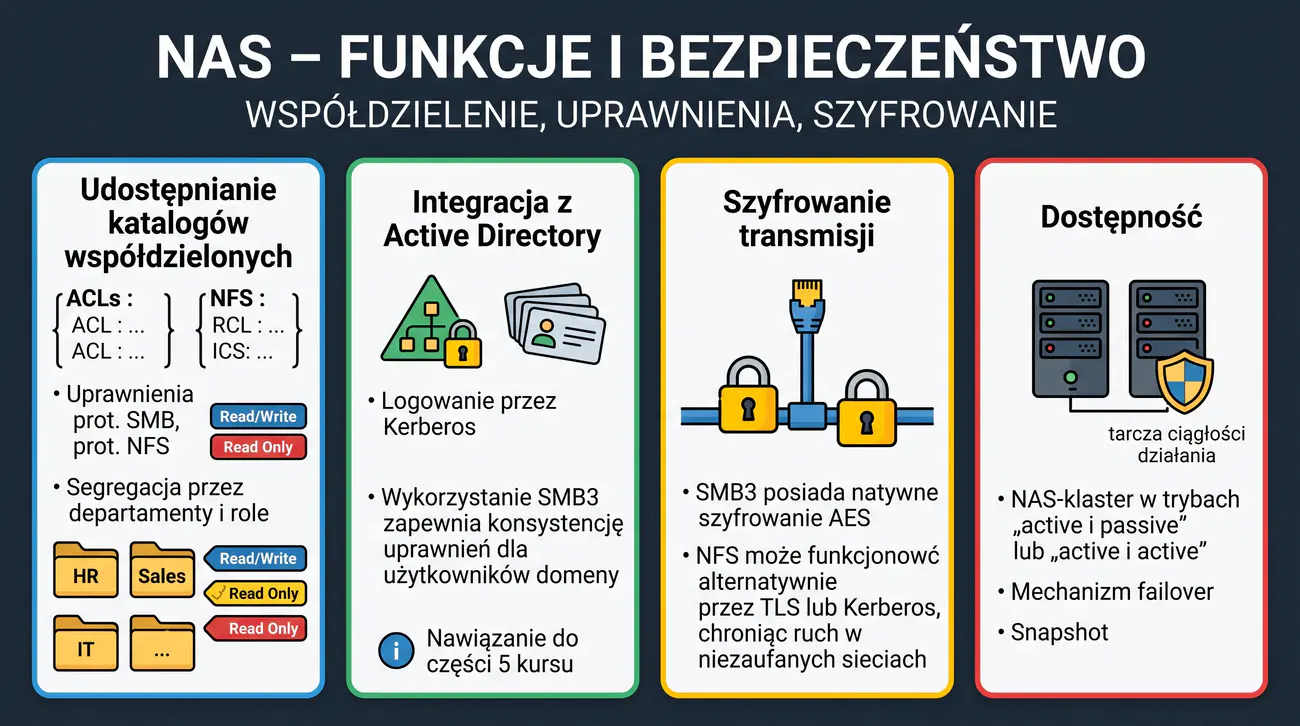
Nowoczesne urządzenia NAS obsługują szyfrowanie ruchu w warstwie protokołu SMB3 oraz integrację z domenami Active Directory. Dzięki temu pojedyncze urządzenie może pełnić rolę centralnego magazynu dla całego działu. W dużych organizacjach urządzenia te występują w klastrach, gwarantując ciągłość pracy.
Zaawansowane urządzenia NAS przypominają pełnoprawne serwery plików, oferując kontrolę dostępu opartą na listach ACL i integrację z usługą katalogową. Dzięki uwierzytelnianiu Kerberos oraz listom ACL prawa można przypisywać konkretnym użytkownikom domeny, zamiast posługiwać się kontami lokalnymi. W ten sposób polityka dostępu jest spójna z resztą infrastruktury firmy.
Ochrona transmisji w sieci o ograniczonym zaufaniu wymaga szyfrowania ruchu, które w SMB3 realizuje się natywnie, a w NFS przez rozszerzenia bezpieczeństwa. Szyfrowanie to nie zwalnia jednak od konieczności stosowania silnych haseł i certyfikatów. Administrator powinien także segregować dane według działów, aby ograniczać krąg osób mających dostęp.
Dostępność osiąga się przez klastry aktywne-pasywne lub aktywne-aktywne, które przejmują pracę po awarii węzła. Ważne jest również monitorowanie logów i alertów o nieudanych logowaniach, gdyż szybkie wykrycie anomalii chroni przed włamaniem. Urządzenia NAS bywają pierwszym celem ataków ransomware, dlatego ich ochrona powinna być traktowana priorytetowo.
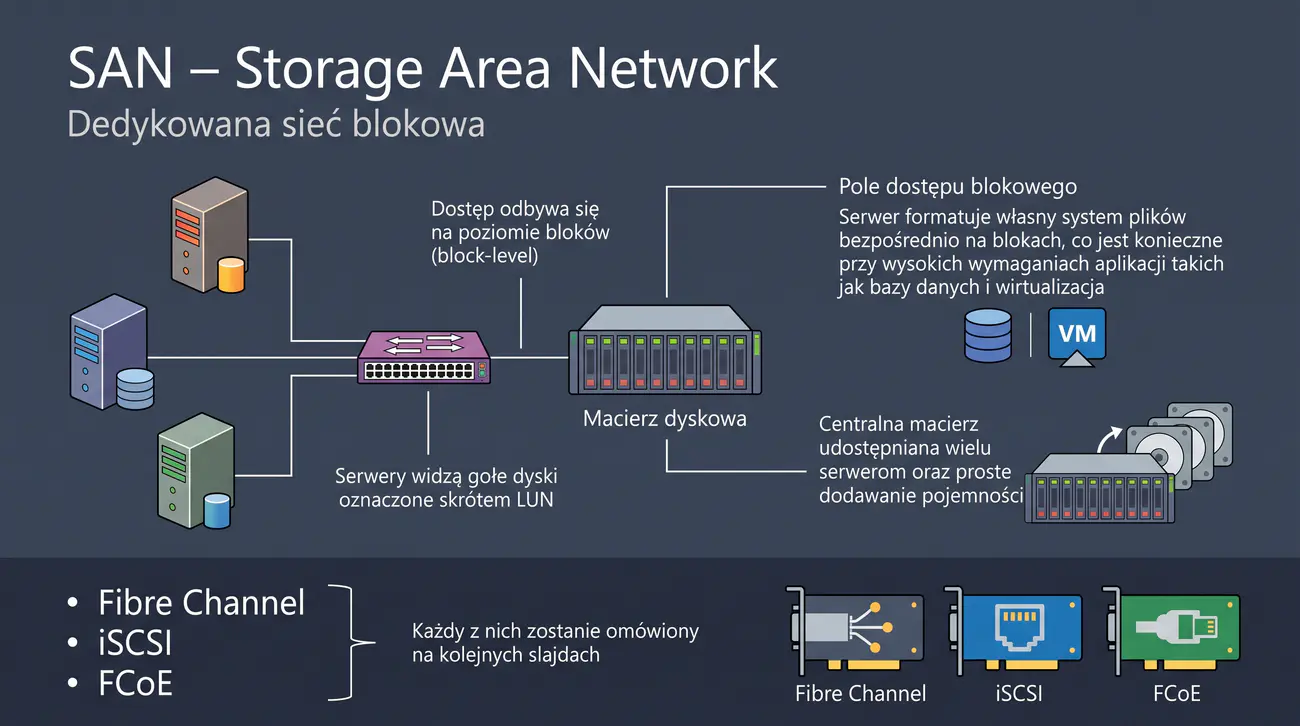
Sieć SAN przenosi ciężar udostępniania pamięci z warstwy plików na warstwę bloków, przez co serwery postrzegają wolumeny jak lokalne dyski. Każdy host tworzy na przydzielonym LUN-ie własny system plików, co daje pełną kontrolę nad formatowaniem. Dostęp blokowy jest naturalnym wyborem dla baz danych i systemów wirtualizacji.
Centralna macierz obsługuje wielu klientów, więc administratorzy dodają pojemność w jednym punkcie, bez dotykania poszczególnych serwerów. Technologie transportu blokowego, takie jak Fibre Channel czy iSCSI, różnią się kosztem i wydajnością. Przydzielanie wolumenów odbywa się przy tym z zachowaniem ścisłej kontroli, kto widzi jaki zasób.
Ceną tych możliwości jest wysoka złożoność infrastruktury oraz konieczność utrzymywania wykwalifikowanego zespołu administracyjnego. SAN stosuje się zatem przede wszystkim w środowiskach, gdzie awaria dostępu do danych jest niedopuszczalna. W mniejszych organizacjach role centrów danych przejmują tańsze warianty oparte na sieci IP.
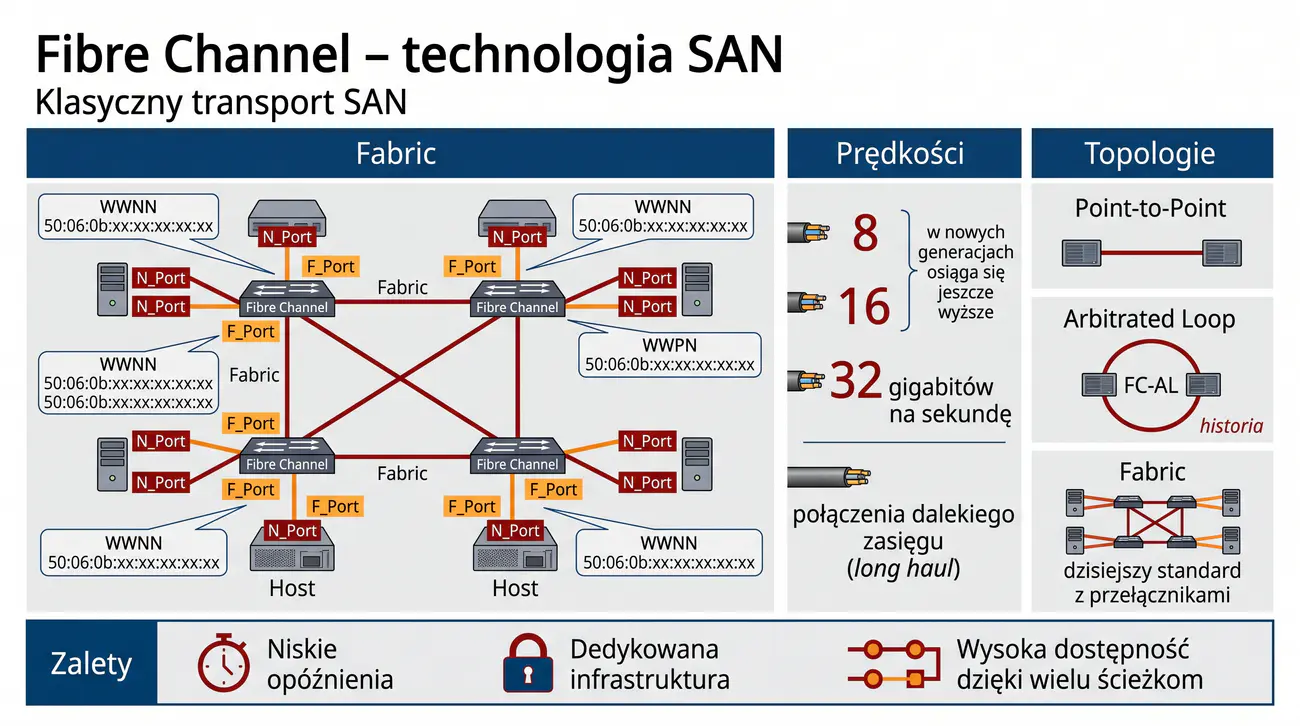
Technologia Fibre Channel powstała z myślą o niezawodnym przesyłaniu danych blokowych i przeszła długą ewolucję, zanim trafiła do współczesnych centrów danych. Infrastruktura opiera się na przełącznikach tworzących strukturę zwaną fabric, do której przyłączają się porty hostów i macierzy. Urządzenia identyfikuje się globalnie unikalnymi adresami WWNN i WWPN, co pozwala precyzyjnie sterować komunikacją.
Struktury te obsługują obecnie prędkości od ośmiu do trzydziestu dwóch gigabitów na sekundę i więcej, a światłowody umożliwiają łączenie oddalonych od siebie budynków. W przeszłości funkcjonowała także topologia pętli arbitrowanej, wyparta całkowicie przez przełączane struktury. Dzięki wielu równoległym ścieżkom infrastruktura zapewnia wysoki stopień dostępności.
Podstawową przewagą Fibre Channel pozostały niskie opóźnienia i przewidywalność działania, niedostępne w sieciach Ethernet z protokołem TCP/IP. Kosztowność wdrożenia skłania jednak wiele firm do wyboru tańszych technologii. W środowiskach krytycznych połączenie wielu ścieżek HBA i przełączników staje się wzorcem wysokiej dostępności.
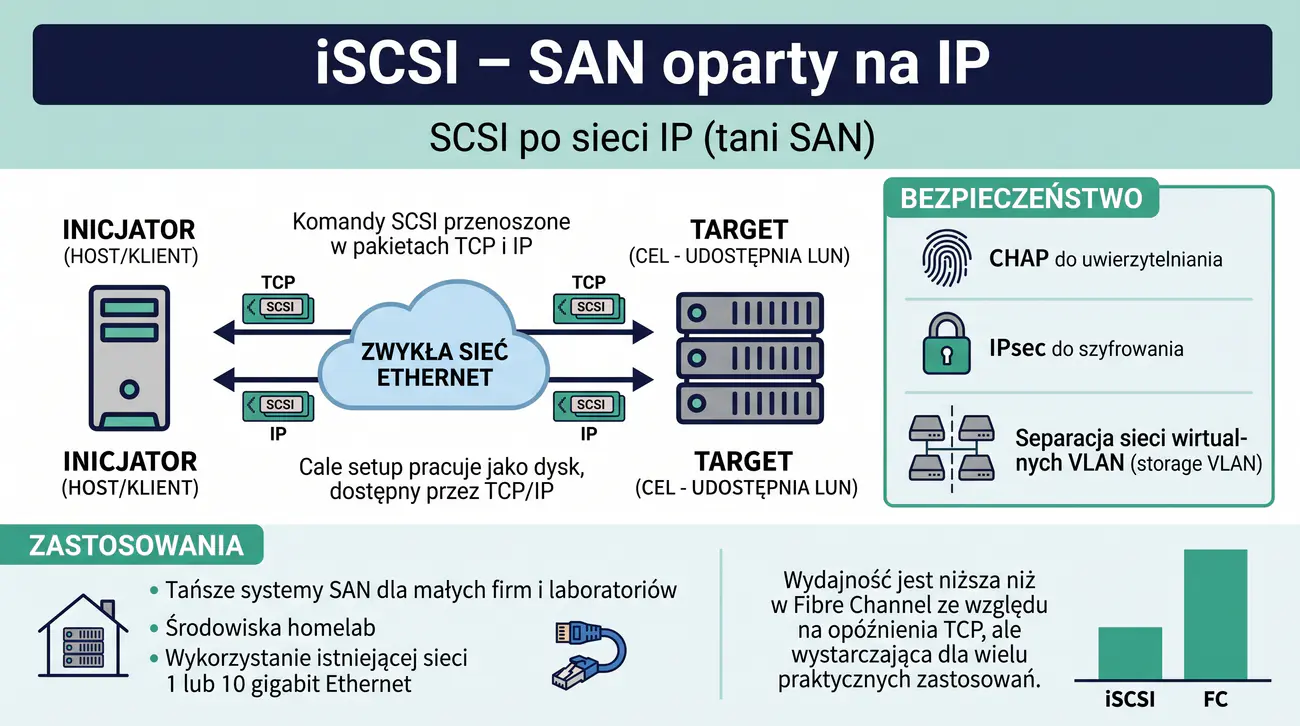
Protokół iSCSI przenosi komendy i dane SCSI w pakietach TCP/IP, dzięki czemu magazyn blokowy można zbudować na istniejącej infrastrukturze Ethernet. Urządzeniem docelowym, nazywanym targetem, zajmuje się macierz lub dedykowany serwer, a inicjatorem zwykle sterownik systemu operacyjnego klienta. Utworzone w ten sposób wolumeny wyglądają w systemie jak zwykłe dyski.
Uwierzytelnianie połączeń odbywa się najczęściej protokołem CHAP, a sieci wymagające szyfrowania korzystają z IPsec. Zaleca się przy tym wydzielenie ruchu iSCSI do osobnej sieci VLAN, aby ograniczyć dostęp przypadkowych urządzeń. Chociaż opóźnienia stosu TCP nie dorównują Fibre Channel, dla wielu zastosowań wydajność iSCSI w pełni wystarcza.
Standard iSCSI opisano pierwotnie w dokumencie RFC 3720. Aktualna specyfikacja to RFC 7143 (kwiecień 2014, Standards Track - Proposed Standard, nie Internet Standard STD 80), która wycofuje RFC 3720, RFC 3980, RFC 4850 i RFC 5048 oraz aktualizuje RFC 3721 (nazewnictwo i discovery). Technologia ta jest szczególnie popularna w środowiskach testowych, chmurach prywatnych oraz firmach, które potrzebują dostępu blokowego tylko okazjonalnie. Dzięki niskiemu kosztowi pozwala wprowadzić dostęp blokowy do organizacji, których nie stać na dedykowany SAN.
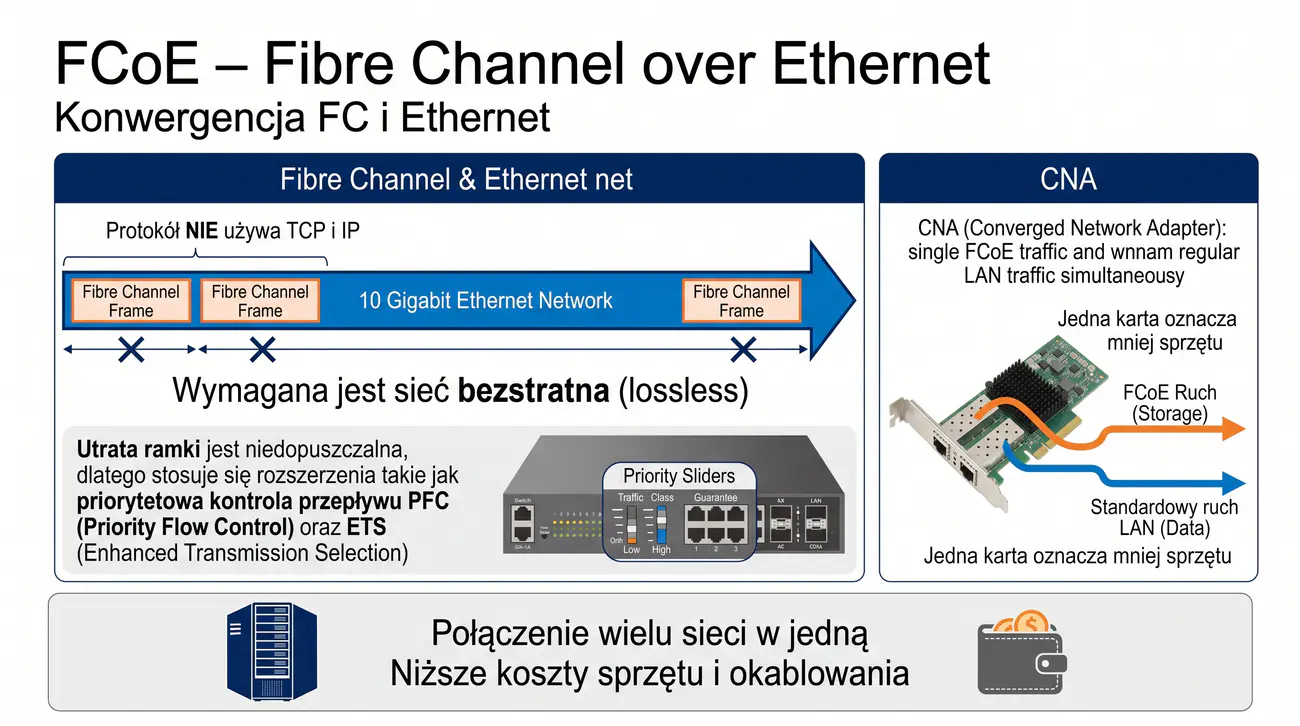
Technologia FCoE, czyli Fibre Channel przez Ethernet, przesyła ramki Fibre Channel bezpośrednio po sieci Ethernet bez pośrednictwa TCP/IP. Dzięki temu zachowuje wiele właściwości oryginalnego protokołu, w tym niskie opóźnienia i zachowanie kolejności ramek. Warunkiem działania jest jednak bezstratna sieć, której zwykły Ethernet nie gwarantuje.
Mechanizmy, takie jak kontrola przepływu według priorytetów (PFC) oraz wzbogacony wybór transmisji (ETS), zapobiegają odrzucaniu ramek w przepełnionych buforach. Do obsługi obu rodzajów ruchu służą adaptery konwergentne, które w jednej karcie łączą funkcje karty Fibre Channel i zwykłej karty sieciowej. Dzięki temu liczba kart i okablowania w serwerze znacznie maleje.
Podstawową korzyścią FCoE jest konsolidacja infrastruktury i obniżenie kosztów sprzętu, bez rezygnacji z cech transportu blokowego. Należy jednak pamiętać o osobnej konfiguracji stref i o zachowaniu izolacji ruchu. W praktyce FCoE najczęściej spotyka się w środowiskach konwergentnych z przełącznikami klasy data center.
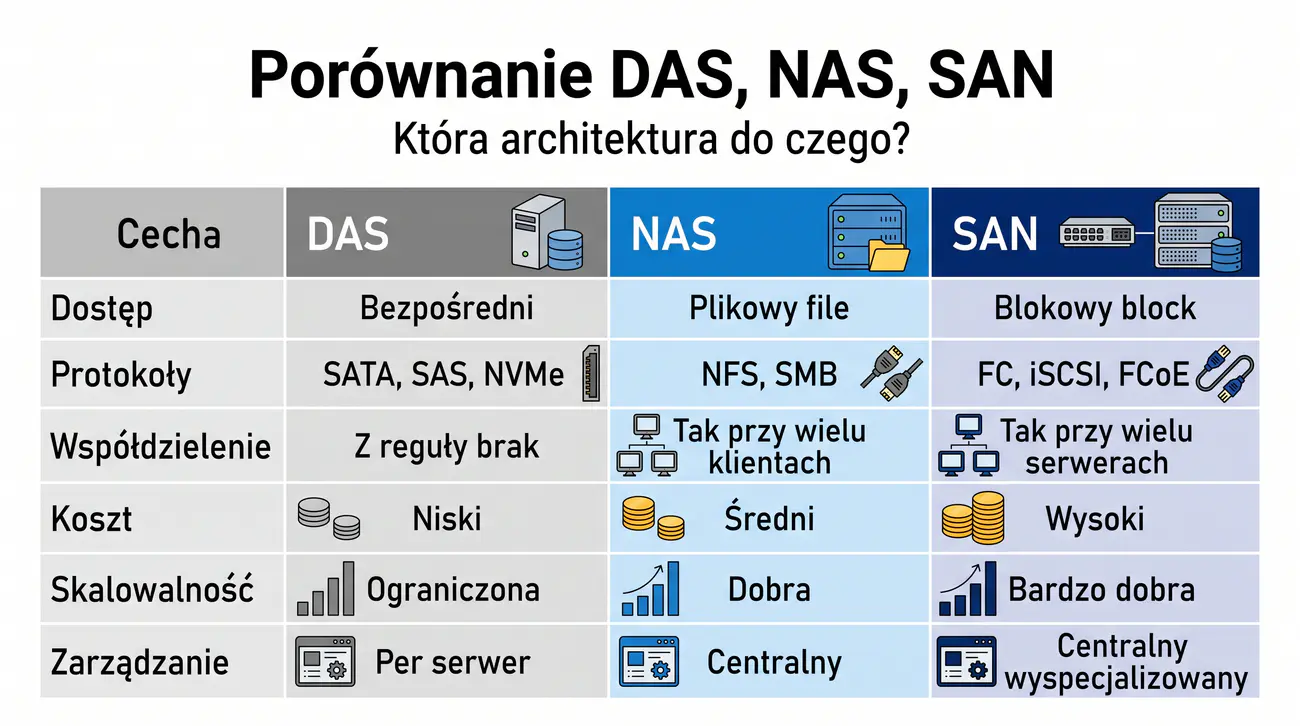
| Cecha | DAS | NAS | SAN |
|---|---|---|---|
| Dostęp | bezpośredni | plikowy (file) | blokowy (block) |
| Protokoły | SATA/SAS/NVMe | NFS, SMB | FC, iSCSI, FCoE |
| Współdzielenie | z reguły brak | tak (wiele klientów) | tak (wiele serwerów) |
| Koszt | niski | średni | wysoki |
| Skalowalność | ograniczona | dobra | bardzo dobra |
| Zarządzanie | per serwer | centralne | centralne, wyspecjalizowane |
Porównanie architektur najlepiej prowadzi się w trzech wymiarach: sposobu dostępu, możliwości współdzielenia oraz kosztu wdrożenia. DAS reprezentuje najprostsze podejście, bo jego magazyn pracuje dla jednego serwera, a dostępność osiąga się za pomocą lokalnych mechanizmów. NAS oferuje dostęp plikowy dla wielu klientów i centralne zarządzanie uprawnieniami.
SAN zapewnia dostęp blokowy z najwyższą wydajnością i skalowalnością, ale kosztem rozbudowanej infrastruktury i specjalistycznej obsługi. W tabeli widoczne są różnice protokołów, które determinują kompatybilność z konkretnymi aplikacjami. Dobór architektury wymaga zatem oceny, która warstwa dostępu najlepiej pasuje do zadania.
W praktyce duże organizacje stosują jednocześnie wszystkie trzy rozwiązania, przypisując każde z nich do właściwych usług. Baza danych korzysta z SAN, udziały plikowe z NAS, a pojedyncze serwery z lokalnych dysków. Takie łączenie architektur optymalizuje koszty i pozwala dostosować magazyn do charakteru danych.
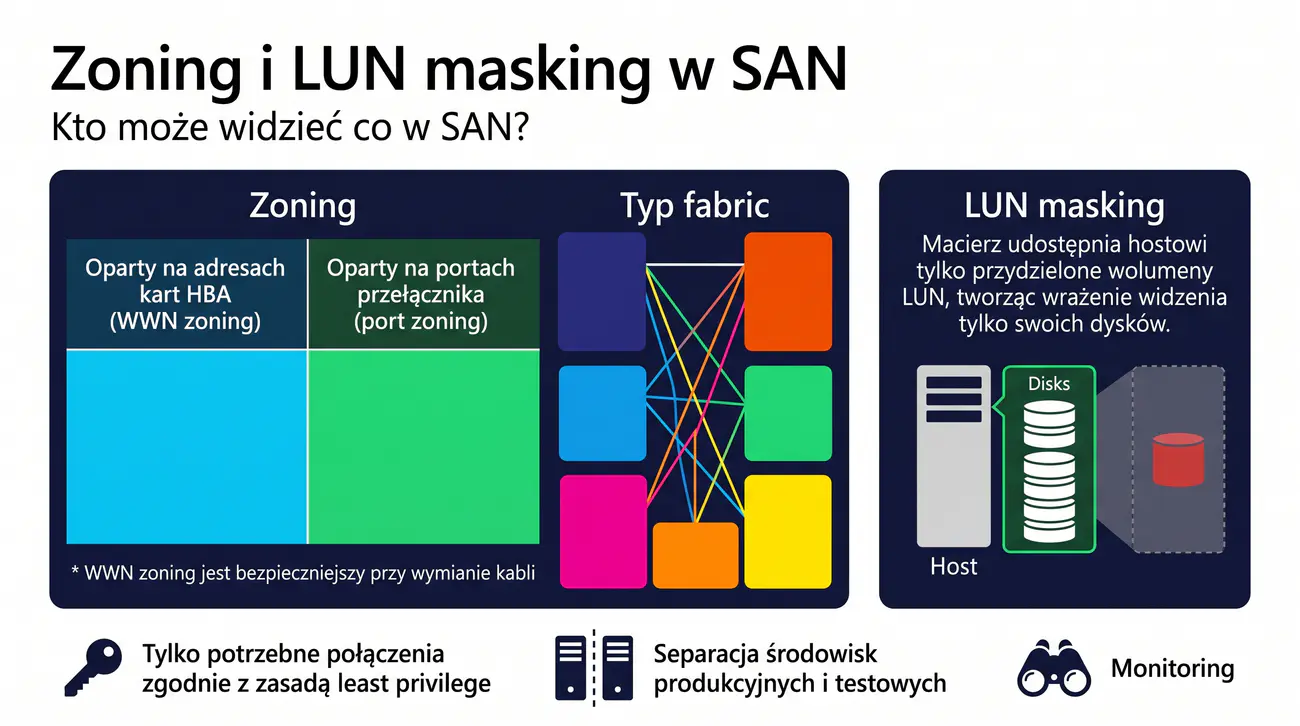
W sieci SAN kluczowe jest precyzyjne określenie, które serwery mogą komunikować się z którymi portami macierzy, a służy do tego mechanizm zoning. Strefy grupują urządzenia według adresów światłowodowych lub numerów portów przełącznika. Zoning oparty na adresach WWPN pozostaje poprawny nawet po zmianie kabli, dlatego jest bezpieczniejszy.
Maskowanie LUN działa po stronie macierzy i decyduje o tym, jakie wolumeny widzi dany host. Oba mechanizmy uzupełniają się, tworząc dwie niezależne warstwy ochrony przed przypadkowym dostępem. Zgodnie z zasadą minimalnych uprawnień serwer produkcyjny nie powinien widzieć dysków środowiska testowego.
Konfigurację stref i mapowań warto dokumentować i regularnie weryfikować, bo błędy w tych ustawieniach zdarzają się częściej, niż się wydaje. Monitoring wykrywa próby dostępu spoza ustalonych stref. Te proste czynności bywają decydujące dla bezpieczeństwa całego magazynu.
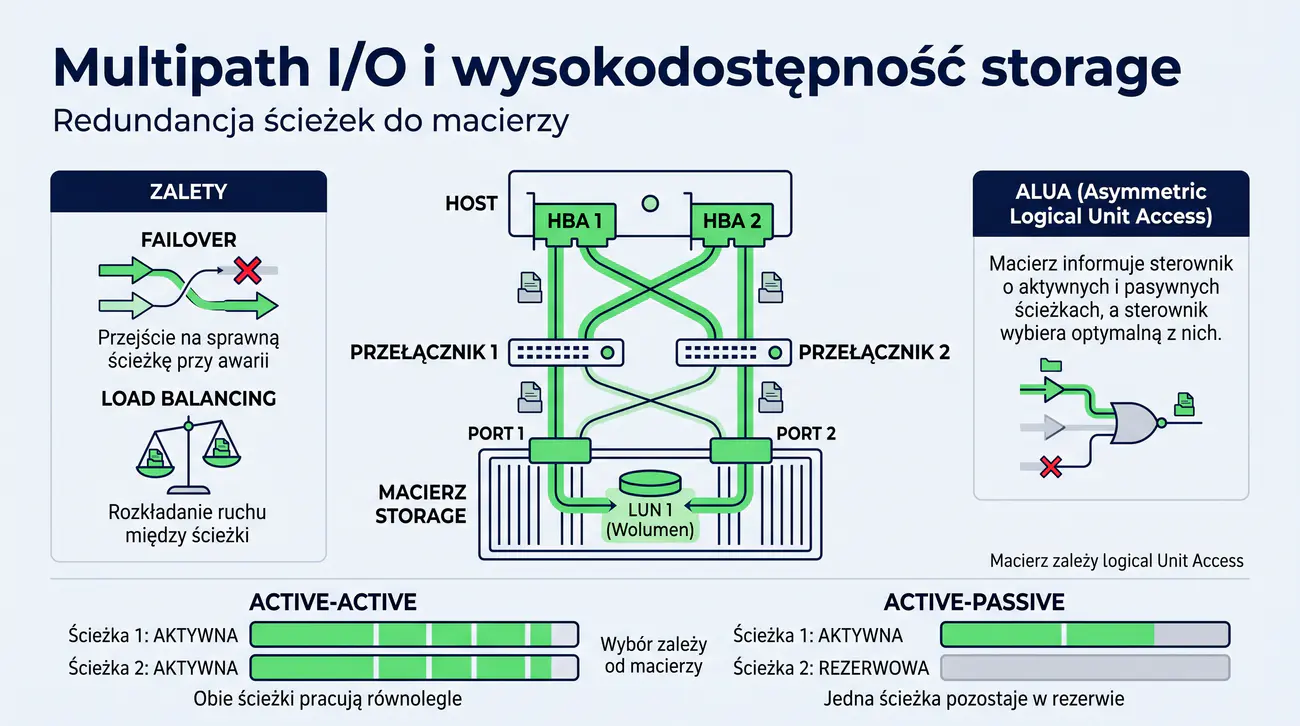
Aby uniknąć pojedynczego punktu awarii, serwery łączy się z macierzą przez wiele niezależnych ścieżek fizycznych, co nazywa się multipathingiem. Zwykle oznacza to dwa adaptery HBA, dwa przełączniki i dwa porty kontrolera, przez które prowadzą równoległe drogi do tego samego LUN. Uszkodzenie dowolnego elementu nie przerywa wówczas dostępu do danych.
Warstwa oprogramowania na serwerze wykrywa stan poszczególnych ścieżek, automatycznie przenosząc ruch na działającą trasę po wykryciu awarii. Ruch może być także rozdzielany między zdrowe ścieżki, co zwiększa osiągi. Mechanizm ALUA informuje dodatkowo o charakterze ścieżek, rozróżniając stany aktywne (w tym zoptymalizowane) oraz pasywne.
Architektura aktywna-aktywna obsługuje żądania na obu trasach jednocześnie, a aktywna-pasywna trzyma jedną w rezerwie. Wybór modelu zależy od konstrukcji macierzy oraz wymagań aplikacji. Multipathing stał się standardowym elementem środowisk baz danych i wirtualizacji, wymagających ciągłej dostępności.
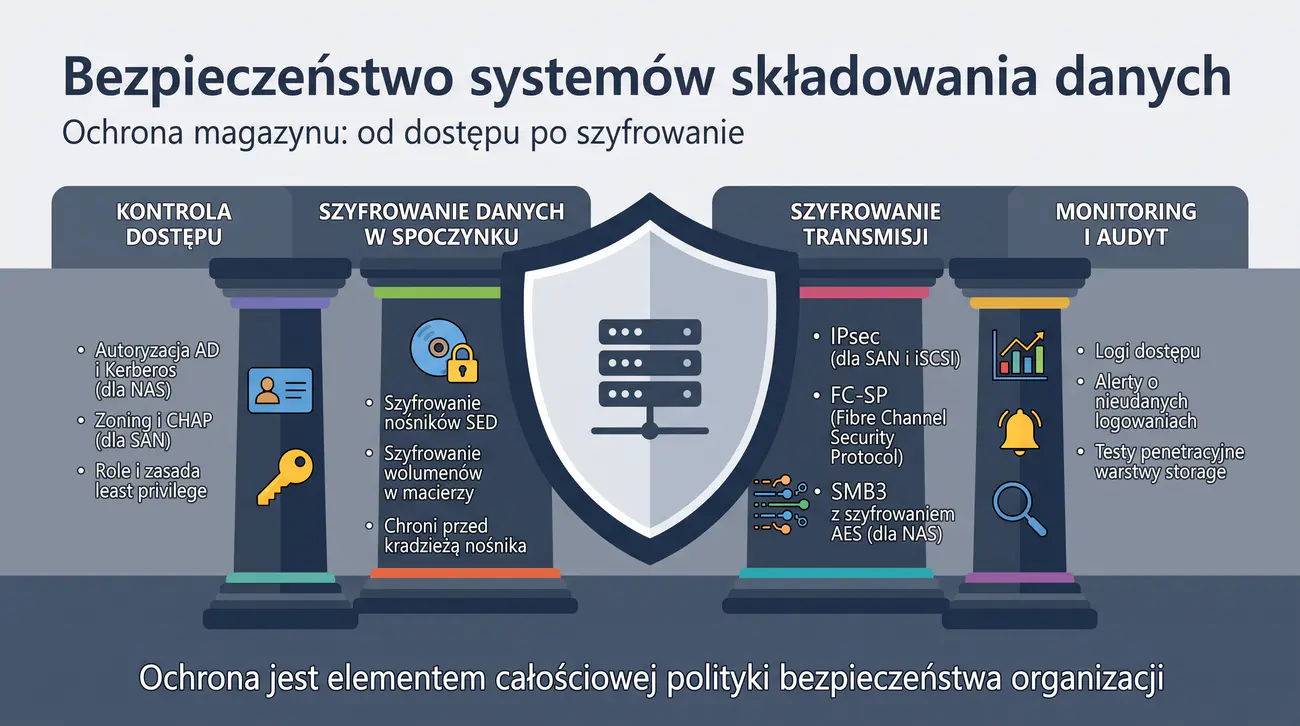
Bezpieczeństwo systemów składowania należy rozpatrywać w trzech uzupełniających się warstwach: kontroli dostępu, szyfrowania oraz monitoringu. Kontrola dostępu odpowiada na pytanie, kto może sięgnąć po dane, realizując ją zwykle przez mechanizmy uwierzytelniania i autoryzacji znane z wcześniejszych części. W warstwie sieciowej rolę tę pełnią strefy, maskowanie LUN czy protokół CHAP.
Szyfrowanie w spoczynku chroni dane przed konsekwencjami kradzieży nośnika, a szyfrowanie transmisji zabezpiecza ruch między klientem a magazynem. W przypadku technologii iSCSI stosuje się IPsec, a w sieciach Fibre Channel standard FC-SP (w praktyce rzadko włączany; podstawą ochrony pozostają zoning i maskowanie LUN). Urządzenia NAS opierają się natomiast na natywnym szyfrowaniu SMB3.
Nieodłącznym elementem strategii jest monitoring oparty na logach i alertach, który umożliwia szybką reakcję na incydenty. Regularne audyty i testy penetracyjne warstwy storage ujawniają konfiguracje podatne na ataki. Dopiero połączenie wszystkich trzech warstw daje spójną ochronę magazynu.
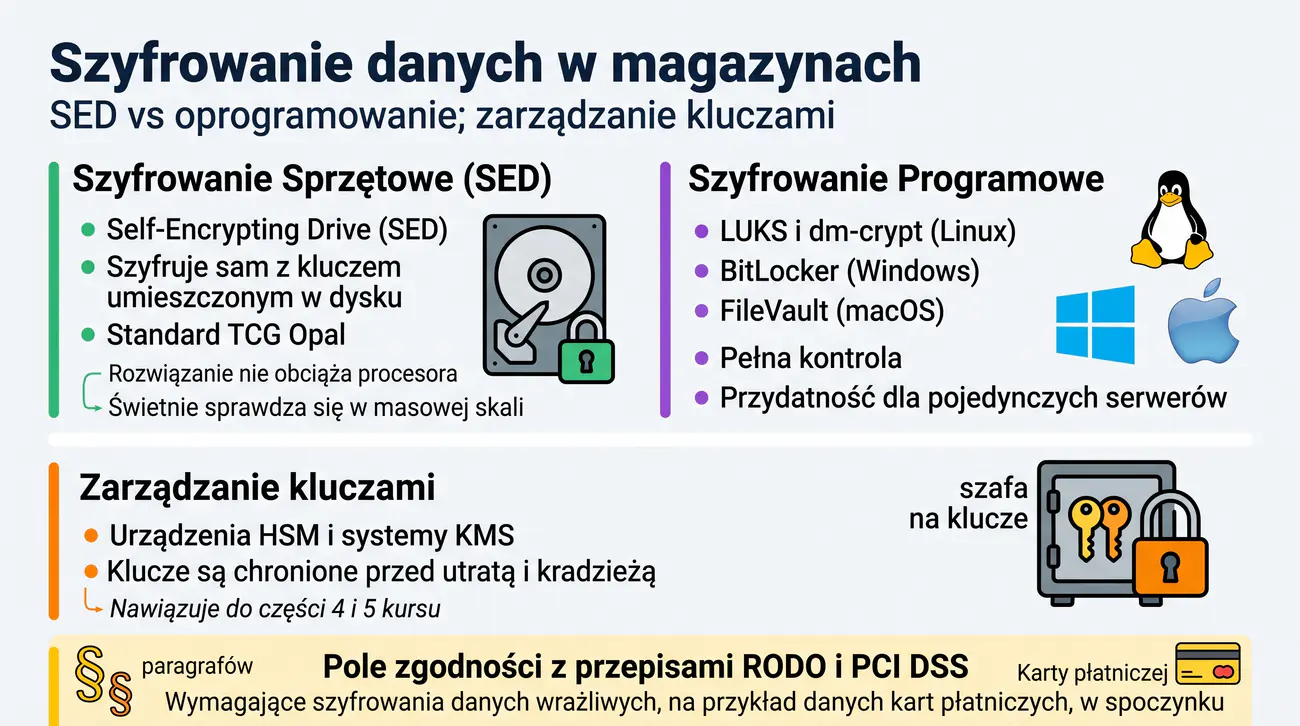
Szyfrowanie danych w spoczynku można realizować na dwa podstawowe sposoby: wewnątrz urządzenia lub w warstwie oprogramowania systemu. Dysk samoszyfrujący zgodny ze specyfikacją TCG Opal wykonuje operacje kryptograficzne we własnym kontrolerze, nie obciążając procesora serwera. Rozwiązania programowe, takie jak LUKS czy BitLocker, dają natomiast pełną kontrolę nad procesem.
Niezależnie od wyboru techniki kluczową rolę odgrywa zarządzanie kluczami, realizowane przez systemy KMS oraz sprzętowe moduły HSM. Moduły te przechowują materiały kryptograficzne w izolowanym układzie, co utrudnia ich kradzież nawet przy dostępie do serwera. Dobra praktyka owijania kluczy danych kluczami nadrzędnymi (ang. key wrapping) umożliwia rotację bez przepisywania całych magazynów.
Obowiązki wynikające z przepisów branżowych, takich jak PCI DSS dla danych posiadacza karty płatniczej, sprawiają, że szyfrowanie danych wrażliwych przestaje być kwestią wyboru; RODO wskazuje je w art. 32 jako jeden z adekwatnych środków. Wdrożenie wymaga przy tym przygotowania procedur odzyskiwania i dokumentacji kluczy. Bez tych przygotowań zaszyfrowany magazyn może stać się trwale niedostępny.
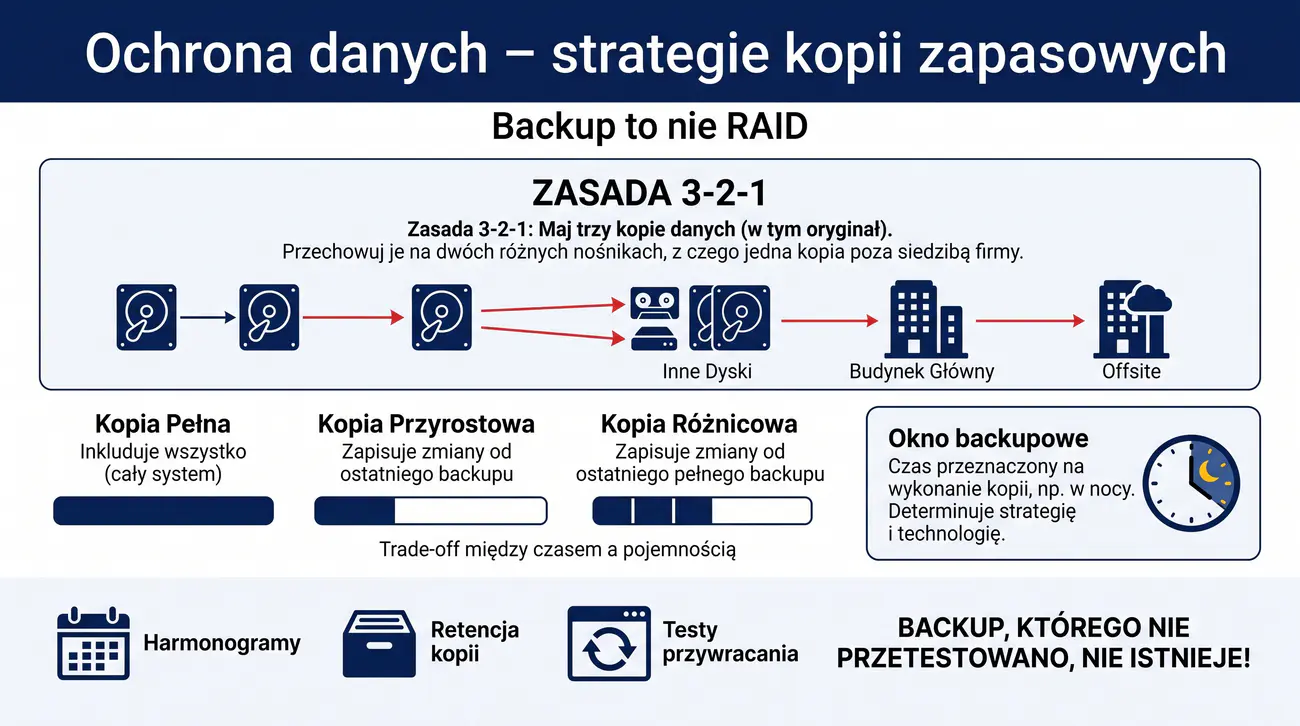
Strategia kopii zapasowych odpowiada na pytanie, kiedy i jak często należy powielać dane, aby ograniczyć ich utratę przy rozsądnych kosztach. Podstawowy podział obejmuje kopie pełne, przyrostowe oraz różnicowe, różniące się czasem wykonania i wielkością. Kopie pełne są najprostsze w przywracaniu, ale najwolniejsze i najbardziej pojemne.
Zalecana zasada 3-2-1 nakazuje przechowywanie trzech kopii danych, w tym oryginału, na dwóch różnych nośnikach, z jedną kopią poza siedzibą firmy. Takie podejście chroni nie tylko przed awarią sprzętu, ale i przed pożarem, kradzieżą czy działaniem złośliwego oprogramowania. Okno czasowe przeznaczone na backup narzuca natomiast ograniczenia, które trzeba uwzględnić w harmonogramie.
Retencja kopii zależy od wymogów prawnych i biznesowych, dlatego planuje się ją z wyprzedzeniem. Najważniejszym etapem jest jednak regularne testowanie przywracania, bo kopie, których nie sprawdzono, bywają bezużyteczne. Automatyzacja harmonogramów i alerty o błędach domykają cały proces.
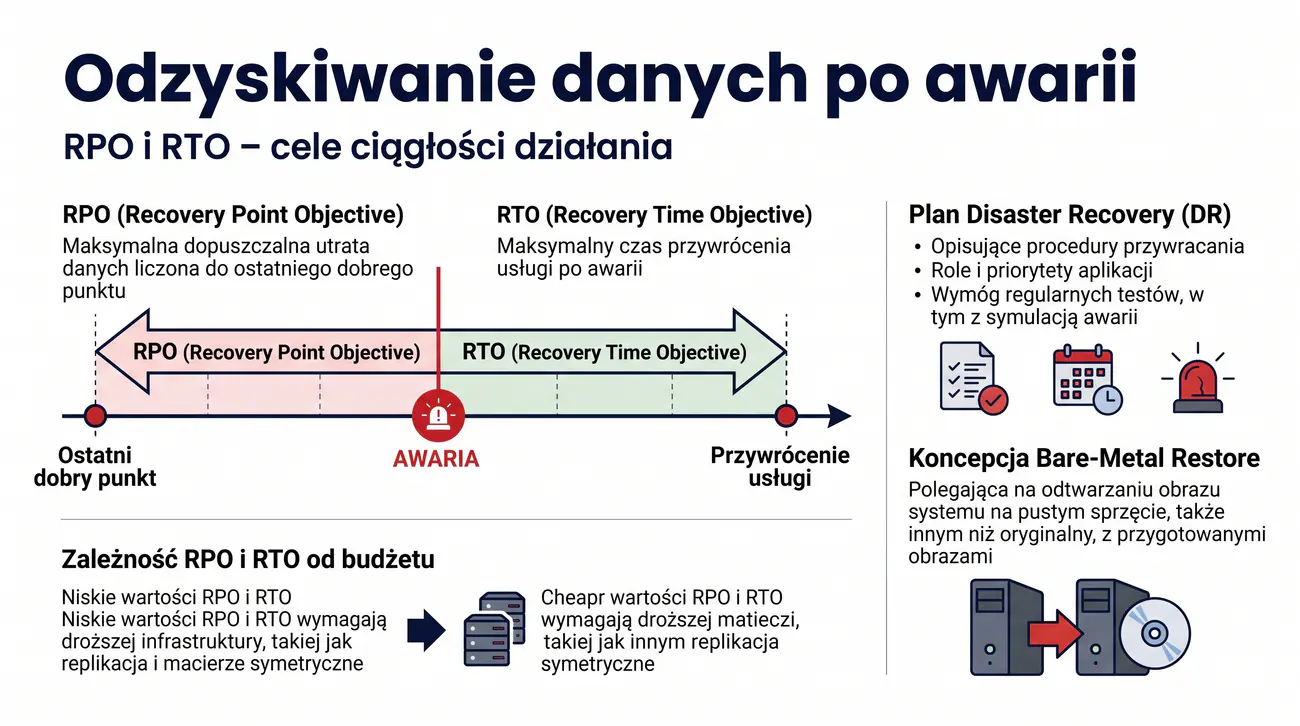
Cele ciągłości działania opisują dwie liczby: RPO określa największą akceptowalną utratę danych, a RTO maksymalny czas przywrócenia usługi. Pierwsza wielkość mówi, jak dawno wykonana kopia może być podstawą odtworzenia, a druga, jak długo organizacja toleruje przestój. Ich wartości ustala się na podstawie analizy biznesowej, a nie wyłącznie możliwości technicznych.
Niskie wartości RPO i RTO wymagają bogatej infrastruktury, na przykład replikacji w czasie rzeczywistym i zdalnych ośrodków, co przekłada się na koszty. Plan odzyskiwania powinien zawierać procedury, role, priorytety aplikacji oraz kontakty osób odpowiedzialnych. Regularne ćwiczenia z symulacją awarii weryfikują realność tych ustaleń.
Przywracanie na nowym sprzęcie, określane jako bare-metal restore, wymaga wcześniej przygotowanych obrazów i nośników rozruchowych. Takie podejście skraca czas odtwarzania i uniezależnia od identycznego sprzętu. Dzięki treningowi zespół potrafi sprawnie przeprowadzić operację nawet w stresującej sytuacji.
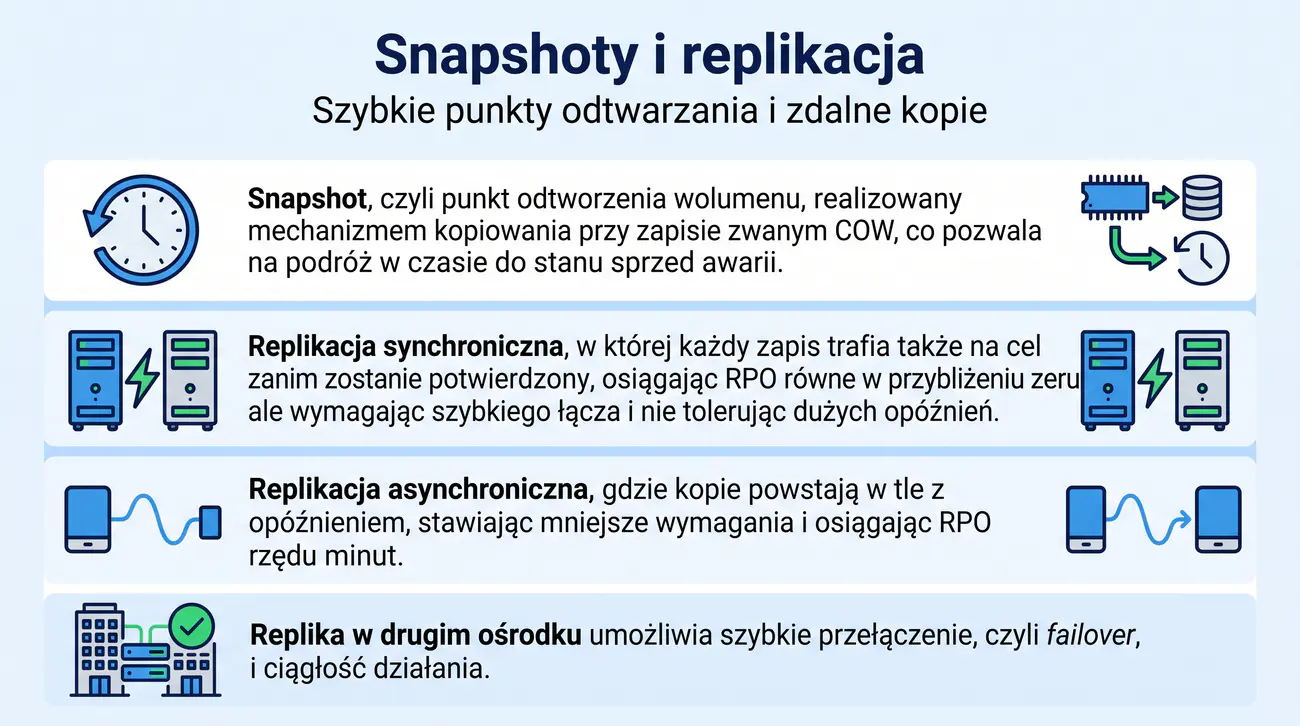
Migawka wolumenu tworzy logiczny punkt odtworzenia bez kopiowania wszystkich danych, dzięki technice kopiowania przy zapisie. Oryginalna treść pozostaje niezmieniona, a modyfikowane bloki (bądź ich wersje pierwotne) trafiają do dedykowanego obszaru migawki, więc zajmowana przestrzeń rośnie proporcjonalnie do zmian. Dzięki temu migawki wykonują się niemal natychmiast i są wygodne do częstego stosowania.
Replikacja synchroniczna potwierdza zapis dopiero po skopiowaniu danych na cel, co gwarantuje niemal zerową utratę informacji, ale wymaga szybkiego łącza. Tryb asynchroniczny pozwala na opóźnienie, więc działa na wolniejszych łączach kosztem możliwego braku najświeższych zmian. Wybór między trybami wiąże się z kompromisem między kosztem a dopuszczalnym poziomem strat.
Zdalna replika w drugim ośrodku umożliwia szybkie przełączenie usług po katastrofie, zmniejszając czas przestoju. Migawki działają natomiast dobrze przy ratowaniu pojedynczych plików i testowaniu aktualizacji. Obie techniki stosowane razem tworzą solidny fundament planu odzyskiwania.
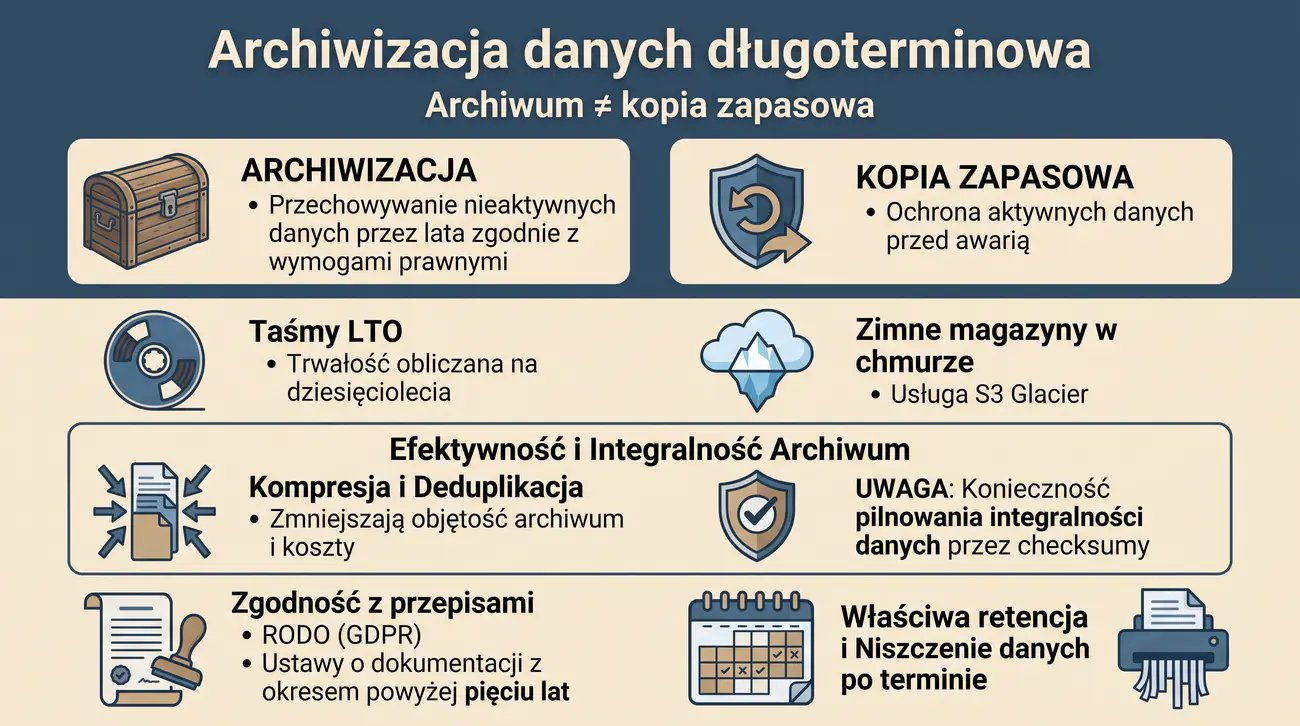
Archiwizacja i kopie zapasowe to odmienne zadania, których cel bywa mylony przez początkujących administratorów. Kopia chroni aktywne dane przed incydentem, natomiast archiwum przechowuje nieaktywne informacje o wartości dowodowej i prawnej. Dokumenty, takie jak faktury, muszą przetrwać nawet kilka lat i zostać udostępnione na żądanie kontrolerów.
Nośniki archiwalne wybiera się pod kątem trwałości, dlatego królują tu taśmy magnetyczne oraz chłodne warstwy magazynu chmurowego. Kluczowa jest przy tym integralność, potwierdzana sumami kontrolnymi i okresowymi weryfikacjami zawartości. Kompresja i deduplikacja zmniejszają wolumen, choć trzeba pamiętać o silniejszym ryzyku uszkodzeń skompresowanych plików.
Zasady przechowywania dokumentacji określa prawo, dlatego organizacja musi znać obowiązujące terminy retencji. Po ich upływie dane należy niszczyć w sposób bezpieczny i udokumentowany, aby nie naruszać prywatności. Archiwum jest zatem projektem procesowym, a nie tylko zakupem taśm.
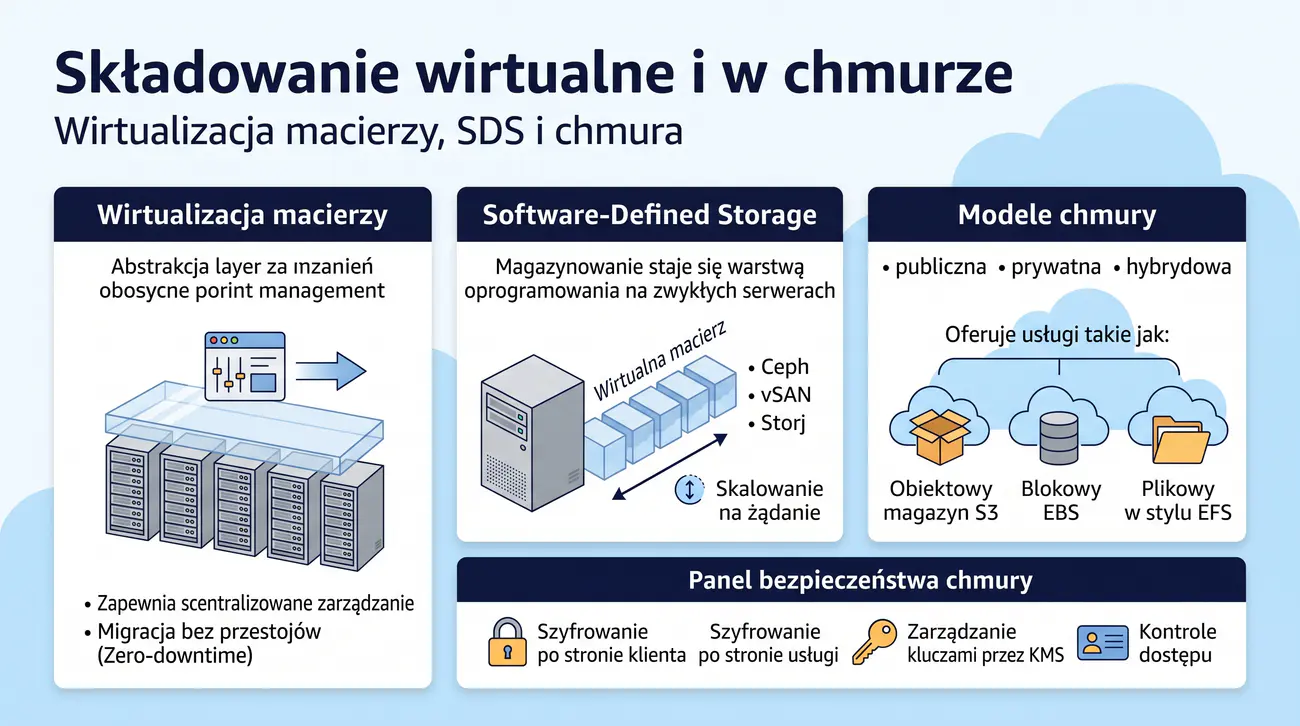
Wirtualizacja magazynu oddziela logiczne wolumeny od fizycznych dysków, dzięki czemu zmiany sprzętu nie wywołują przestojów. Rozwiązania typu software-defined storage przenoszą tę ideę na zwykłe serwery, na których oprogramowanie realizuje funkcje macierzy. Przykłady takie jak Ceph czy vSAN pokazują, jak oprogramowanie otwartoźródłowe i komercyjne konkuruje z klasycznymi macierzami.
Chmura publiczna dostarcza magazyny obiektowe, blokowe i plikowe, a model obiektowy wyróżnia dostęp przez interfejsy API i nienaruszalność wersji. Architektury prywatne i hybrydowe pozwalają trzymać wrażliwe dane lokalnie i używać chmury do skalowania. Zawsze należy zadać pytanie o lokalizację danych, jej zgodność z prawem oraz koszty transferu.
Bezpieczeństwo w chmurze zależy od szyfrowania po stronie klienta i usługodawcy oraz od polityk dostępu. Operacje na kluczach realizują systemy KMS, wspólne dla całego środowiska. Zrozumienie modeli usług pozwala świadomie planować migrację magazynów do nowych architektur.
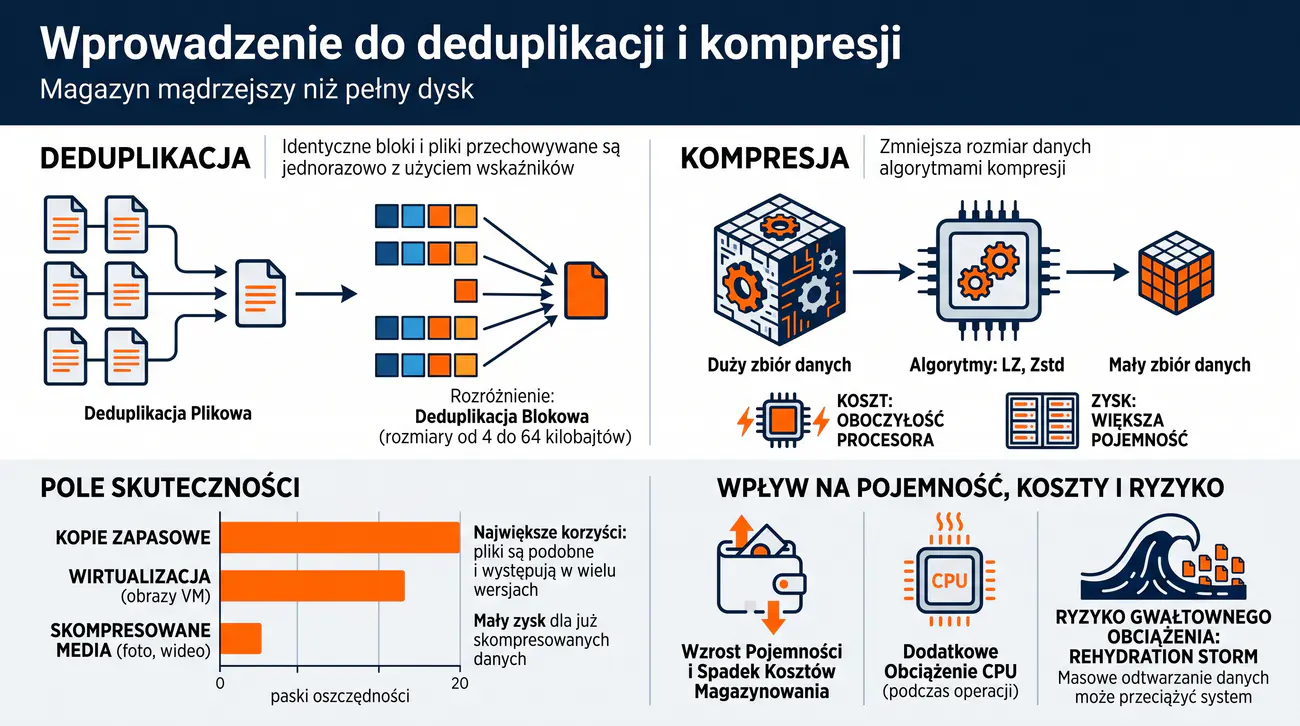
Deduplikacja eliminuje powtarzające się fragmenty danych przez zamianę ich na wskaźniki do jednej wspólnej kopii bloku. Kompresja działa odmiennie, bo przetwarza pojedyncze dane algorytmami takimi jak LZ czy Zstandard, usuwając zbędne wzorce bitowe. Obie techniki wykorzystywane są najczęściej w systemach kopii zapasowych, gdzie kolejne wersje plików prawie się nie różnią.
Skuteczność zależy silnie od charakteru danych, bo pliki tekstowe i kopie baz kompresują się znakomicie, a media bywają już skompresowane fabrycznie. Zyski z deduplikacji są szczególnie duże w środowiskach wirtualizacji, gdzie wiele maszyn dzieli podobne pliki systemowe. Trzeba jednak pamiętać o koszcie obliczeniowym obu procesów.
Przy odtwarzaniu wielu plików naraz może wzrosnąć zapotrzebowanie na moc obliczeniową, co obciąża zasoby systemu (zjawisko tzw. rehydration storm). Projektant musi więc zrównoważyć oszczędność miejsca z wydajnością operacji. Właściwie skonfigurowane rozwiązania zmniejszają koszty magazynu bez zauważalnego pogorszenia pracy.
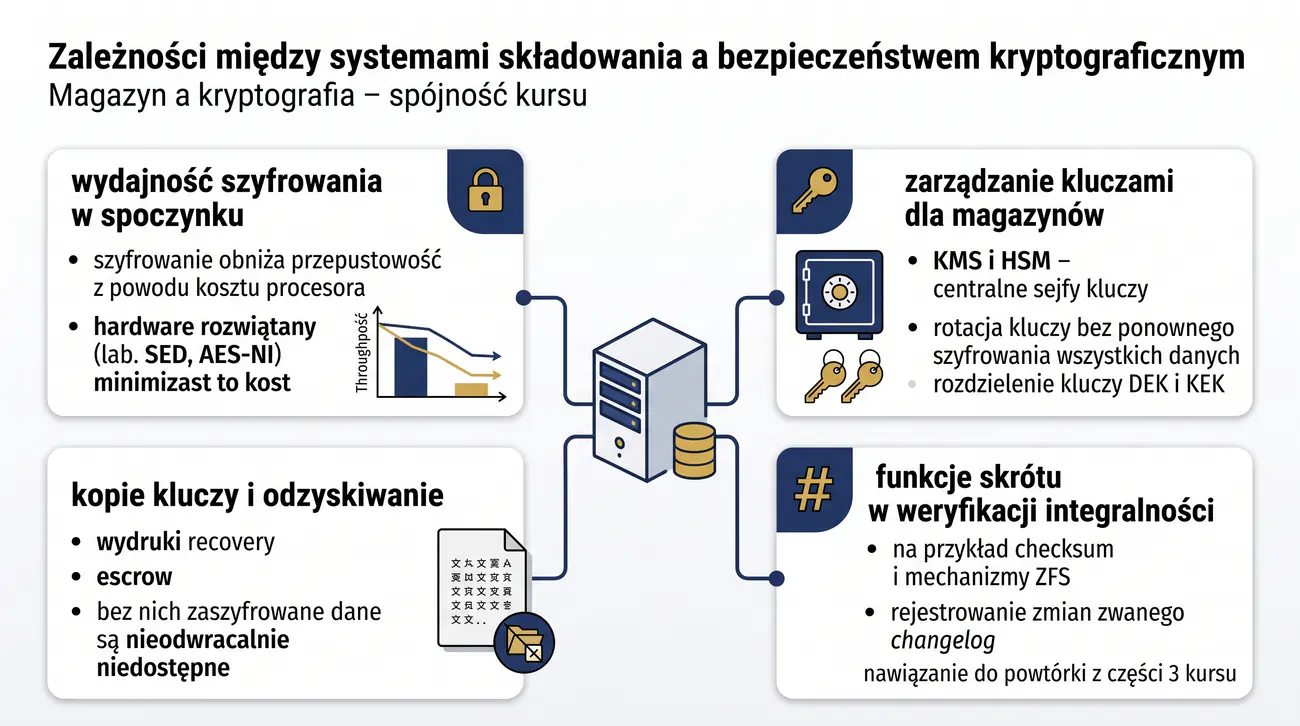
Powiązanie systemów składowania z kryptografią wykracza poza samo szyfrowanie danych, obejmując cały cykl życia kluczy. Centralne systemy zarządzania kluczami oraz moduły HSM chronią materiały kryptograficzne w izolowanym środowisku. Oddzielenie klucza szyfrującego dane od klucza opakowującego umożliwia rotację bez przepisywania wolumenów.
Funkcje skrótu wspierają natomiast integralność magazynu, bo systemy takie jak ZFS obliczają sumy kontrolne każdego bloku i wykrywają korupcję. Przechowywanie kopii kluczy, określane mianem escrow, pozwala odzyskać zaszyfrowane dane po awarii kadrowej lub technicznej. Bez takiego zabezpieczenia nawet największa redundancja nie pomoże, gdy klucz zniknie.
Przepustowość szyfrowania w spoczynku zależy od sprzętowej akceleracji, dlatego podczas projektowania sprawdza się wsparcie rozkazów AES czy dyski szyfrujące. Zarządzanie kluczami jest tematem łączącym wszystkie części materiału, od algorytmów po infrastrukturę. Należy traktować tę zależność jako kluczowy element projektowania, a nie dodatkowy problem.
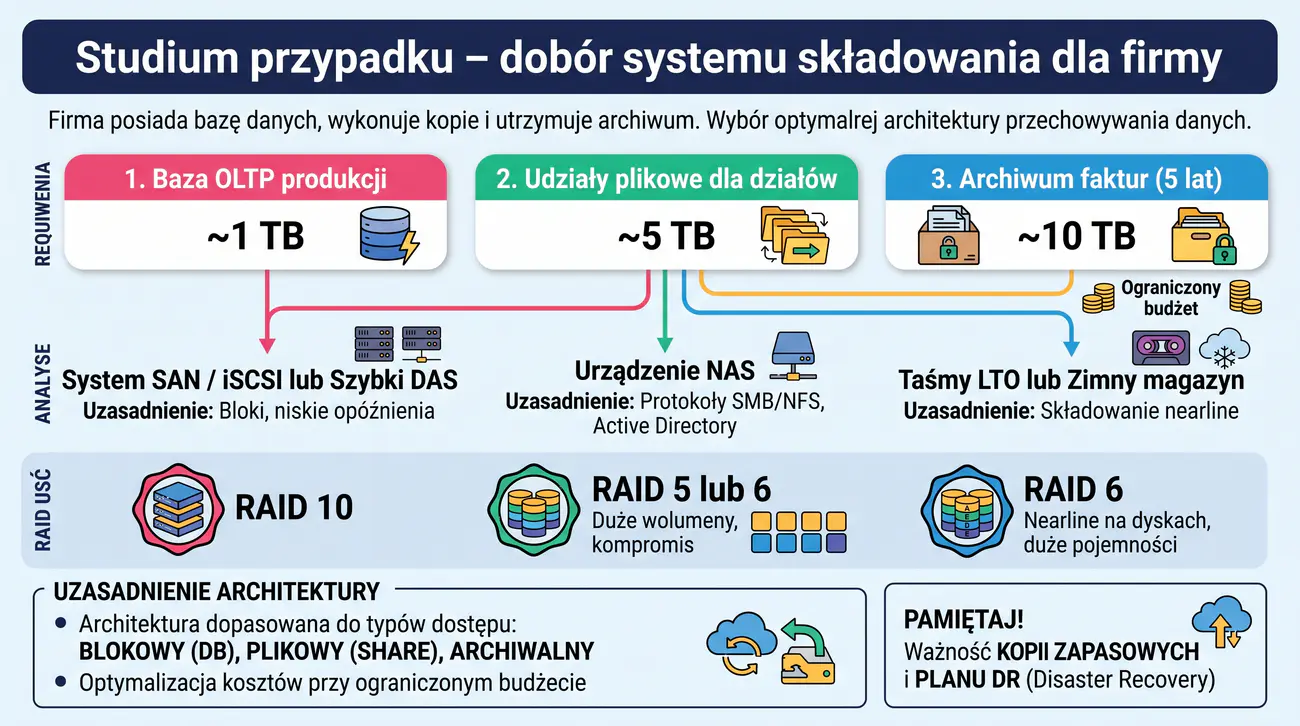
Studium przypadku pokazuje, jak od wymagań biznesowych przechodzi się do konkretnych decyzji technicznych w odpowiedniej kolejności. Pierwszym krokiem jest zestawienie pojemności, charakteru dostępu i budżetu dla każdego zbioru danych. Analiza bazy OLTP wskazuje, że liczą się niskie opóźnienia i wiele małych zapisów, co kieruje w stronę dostępu blokowego.
Udziały plikowe o dużej objętości i zmiennym charakterze nadają się natomiast do urządzenia NAS, które łączy wygodę z centralnym zarządzaniem. Dane archiwalne z długim okresem przechowywania najtaniej spoczywają na taśmach lub w chłodnym magazynie chmury. Dopiero po tych ustaleniach dobiera się konkretny poziom RAID dla każdej warstwy.
Decyzji towarzyszy zwykle analiza opłacalności, obejmująca koszty sprzętu, energii i obsługi administracyjnej. Ważne jest też planowanie rozbudowy, bo zapotrzebowanie na pojemność rośnie w tygodniach, a nie latach. Takie podejście jest powtarzalne i daje się zastosować w dowolnej organizacji.
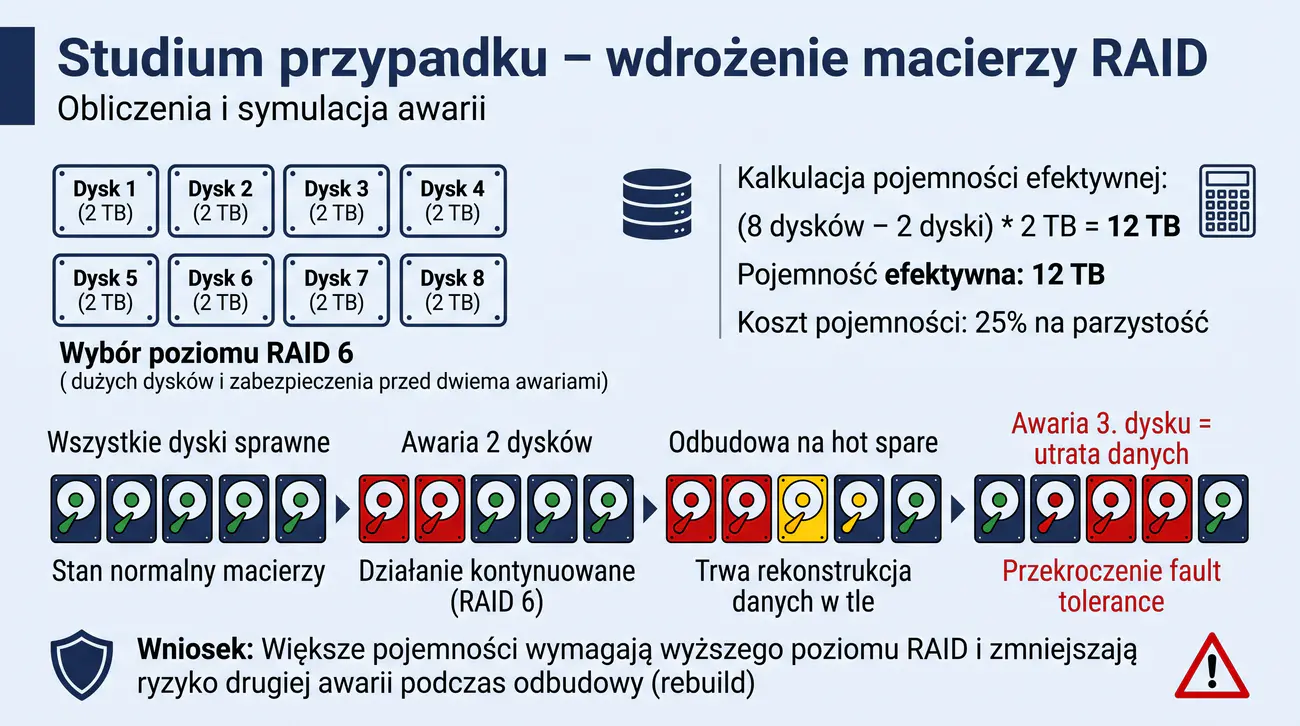
Drugie studium przypadku uczy liczenia pojemności macierzy i oceny ryzyka związanego z odbudową. Dla ośmiu dysków o pojemności dwóch terabajtów każdy w poziomie RAID 6 efektywna przestrzeń wynosi dwanaście terabajtów. Koszt nadmiaru stanowi wówczas jedną czwartą fizycznej pojemności, co przekłada się na konkretne sumy budżetowe.
Symulacja awarii ujawnia, dlaczego poziom szósty obronił się w tym zestawieniu: dwie równoczesne usterki nie przerywają pracy, a odbudowa zachodzi w tle. Gdyby zastosowano RAID 5, drugie uszkodzenie w oknie naprawy oznaczałoby utratę danych. Właśnie dlatego duże pojemności dysków wymuszają silniejszą parzystość.
Zadanie to pokazuje, jak ważne jest prowadzenie kalkulacji przed zakupem sprzętu, a nie dopiero w trakcie wdrożenia. Umiejętność wyznaczania efektywnej pojemności przydaje się przy każdej rozbudowie magazynu. Wysoka świadomość ryzyka chroni przed banalnymi, ale kosztownymi błędami konfiguracyjnymi.
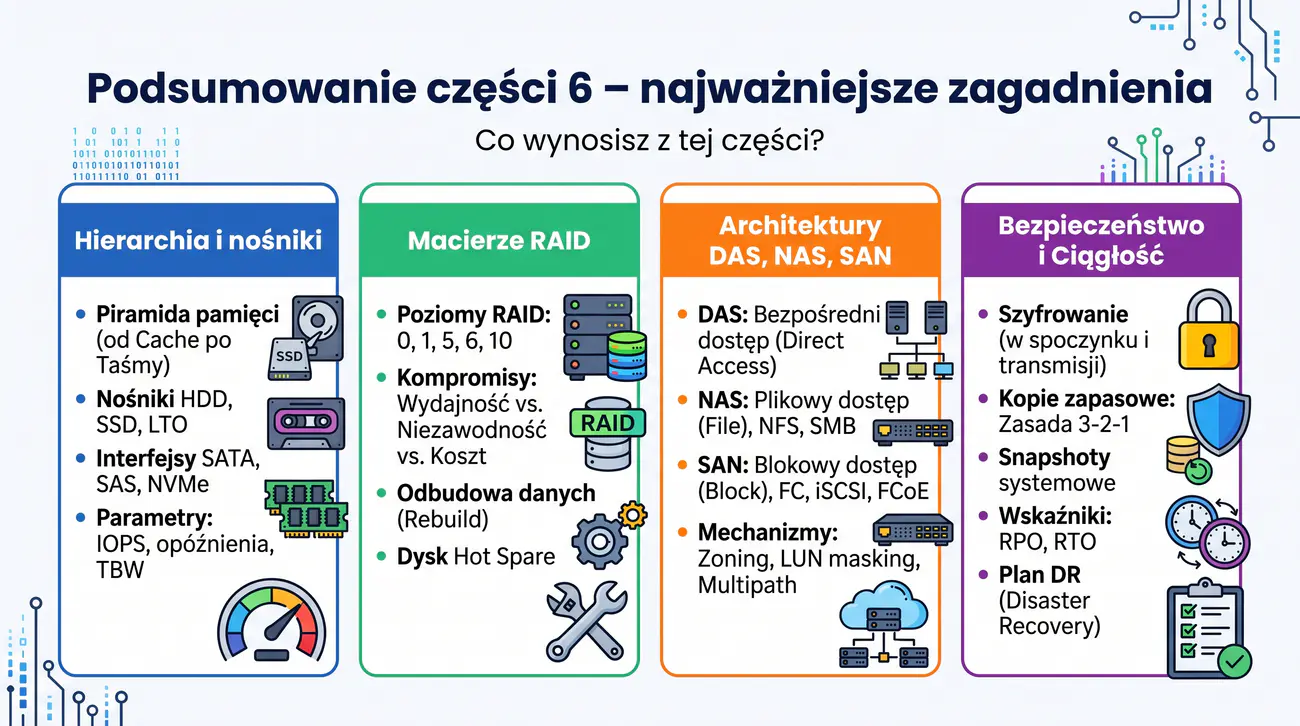
Podsumowanie porządkuje sześć bloków tematycznych części szóstej i przypomina o ich chronologii: nośniki, parametry, RAID, architektury, bezpieczeństwo i odzyskiwanie. Taki układ przekształca szczegóły techniczne w trwałą strukturę wiedzy, łatwą do przywołania z pamięci. Warto podczas powtórki samodzielnie odtworzyć tę sekwencję bez zaglądania do notatek.
Najważniejsze wnioski powtarzają się w całym opracowaniu: RAID chroni tylko przed awarią fizyczną, a kopie zapasowe przed większością innych zagrożeń. Bez starannie zaprojektowanej warstwy dostępu nie sposób mówić o scentralizowanym bezpieczeństwie magazynów. Te uniwersalne zasady łatwo przenieść na dowolne środowisko produkcyjne.
Podsumowanie stanowi także punkt wyjścia do pytań kontrolnych i zadań samodzielnych umieszczonych na dalszych slajdach. Uczestnik, który potrafi precyzyjnie streścić całą część w kilku zdaniach, z łatwością poradzi sobie z audytem i konfiguracją systemów. Systematyczne powtarzanie tych zagadnień utrwala materiał na długo.
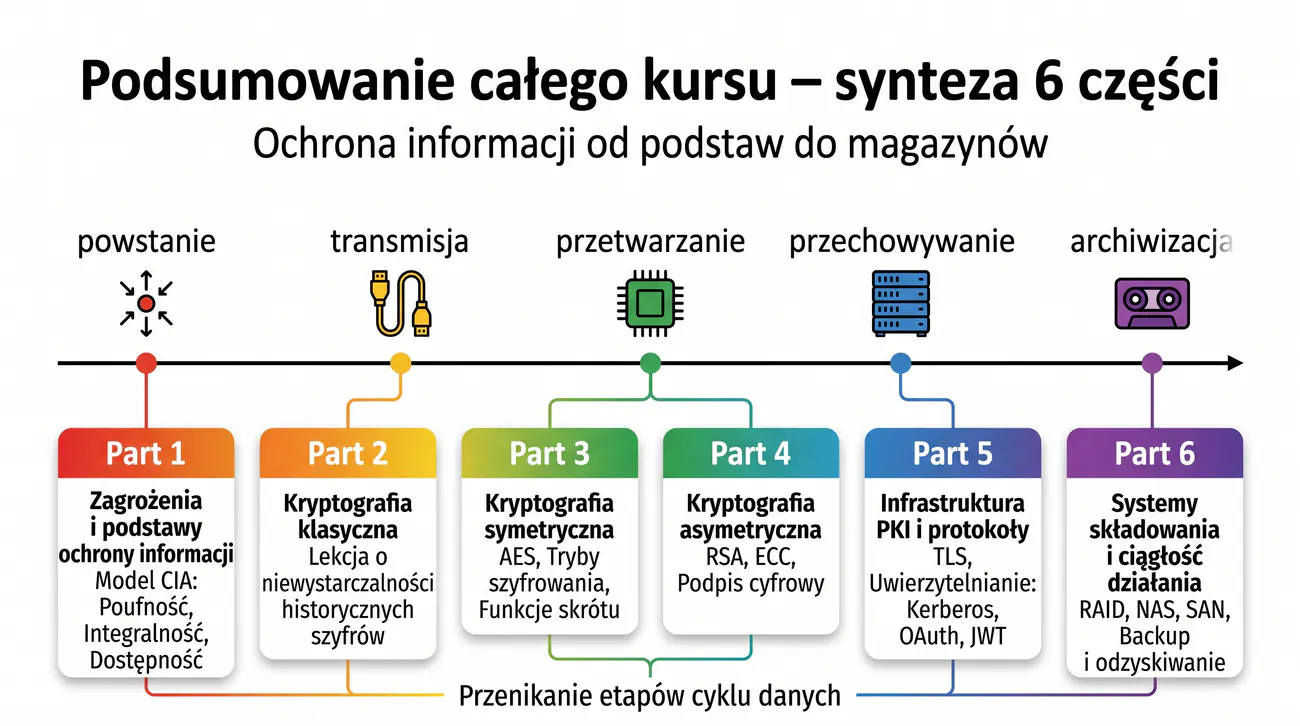
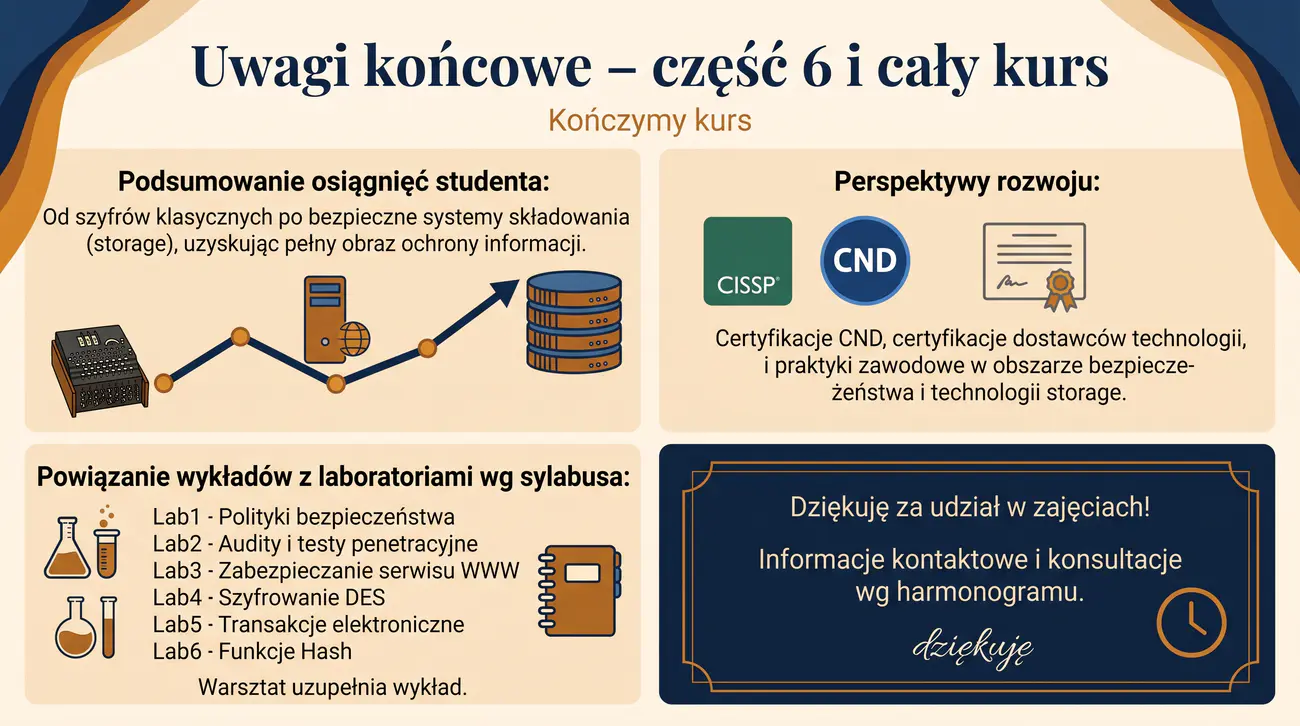
Końcowe podsumowanie całości zestawia sześć części opracowania w jeden spójny model ochrony informacji, od szyfrów klasycznych po magazyny danych. Kolejne moduły dodawały kolejne warstwy: kryptografię symetryczną, asymetryczną, infrastrukturę klucza publicznego oraz protokoły komunikacyjne. Część szósta uzupełniła obraz o trwałe przechowywanie informacji.
Taka konstrukcja materiału odzwierciedla rzeczywisty cykl życia danych, który zaczyna się w momencie powstania informacji, przechodzi przez transmisję i przetwarzanie, a kończy na przechowywaniu i archiwizacji. Widać dzięki temu, że ochrona nie kończy się na przesłaniu wiadomości przez TLS. Bezpieczeństwo musi towarzyszyć informacji do ostatniego momentu jej istnienia.
Podsumowanie podkreśla również znaczenie laboratoriów, które weryfikują teorię w praktyce, od konfiguracji szyfrowania po tworzenie macierzy. Obie ścieżki, teoretyczna i warsztatowa, rozwijają kompetencje potrzebne w pracy zawodowej. Opracowanie przygotowuje tym samym do realnych obowiązków inżyniera bezpieczeństwa.
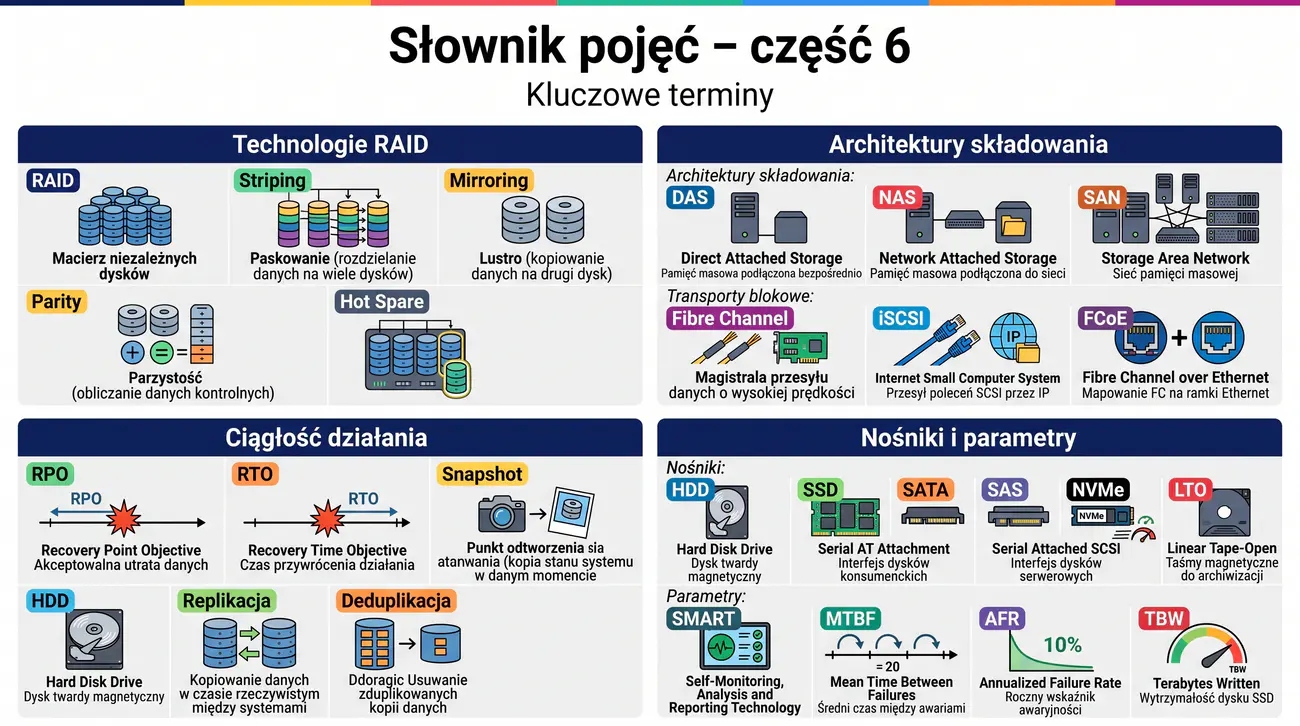
Słownik pojęć zestawia najważniejsze terminy części szóstej w szybko przeszukiwalny zbiór przeznaczony do powtórek. Warto powtarzać definicje własnymi słowami, a nie odtwarzać ich z pamięci, bo ta druga metoda nie ujawnia braków zrozumienia. Przykłady własne, takie jak macierz z konkretnej liczby dysków, utrwalają znaczenie terminów.
Hasła takie jak RPO czy RTO opisują pojęcia, które łatwo pomylić, dlatego pomocne jest opracowanie krótkich scenariuszy ilustrujących różnicę. Mapa pojęć łącząca RAID z odbudową i dyskiem rezerwowym pokazuje natomiast pokrewieństwo definicji. Taki rysunek ujawnia, że większość haseł tworzy spójną sieć zależności.
Systematyczne wplatanie słownika do planu powtórek, w małych porcjach rozłożonych w czasie, przynosi lepsze efekty niż jednorazowa sesja. Warto też wracać do definicji podczas rozwiązywania zadań obliczeniowych. Dzięki temu słownictwo staje się narzędziem, a nie tylko materiałem do zapamiętania.
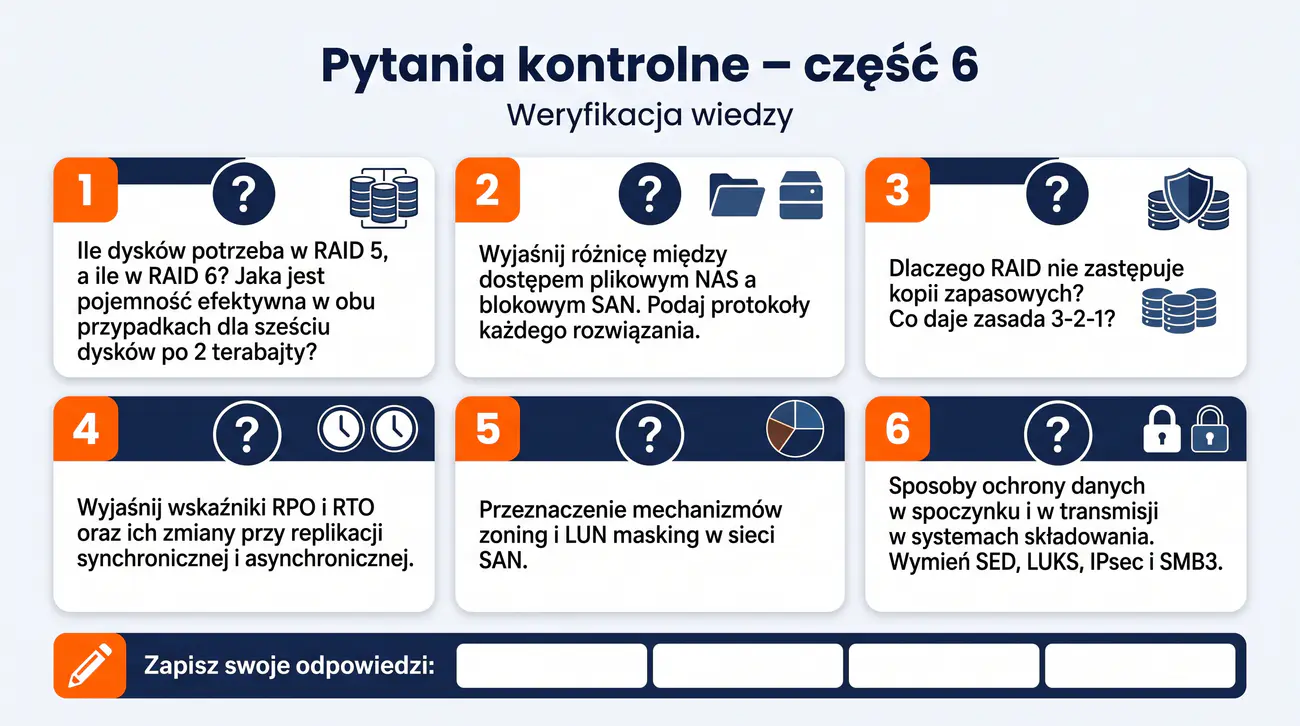
Pytania kontrolne sprawdzają cztery typy umiejętności: pamięciowe, obliczeniowe, porównawcze i projektowe. Część zadań wymaga wyliczenia pojemności macierzy, a inne – analizy różnic między architekturami dostępu. Właśnie te różnorodne zapytania przygotowują do wszechstronnej analizy technicznej i wdrożeniowej.
Odpowiadając na pytania otwarte, warto wypowiadać się pełnymi zdaniami, podając argumenty techniczne i konkretne przykłady. Ćwiczenie odpowiedzi ustnej, na przykład z kolegą, ujawnia luki w rozumowaniu, zanim przystąpi się do samodzielnych wdrożeń produkcyjnych. Taka praktyka pozwala też opracować własny styl prezentowania wiedzy.
Zadania o zasadzie 3-2-1 oraz o parametrach RPO i RTO pojawiają się w wielu wariantach, dlatego warto przećwiczyć je szczególnie dokładnie. Rozwiązując pytania po kolei, uczestnik naturalnie porządkuje cały materiał części szóstej. Regularna praca z tym zbiorem znacznie zwiększa pewność podczas samodzielnej pracy zawodowej.
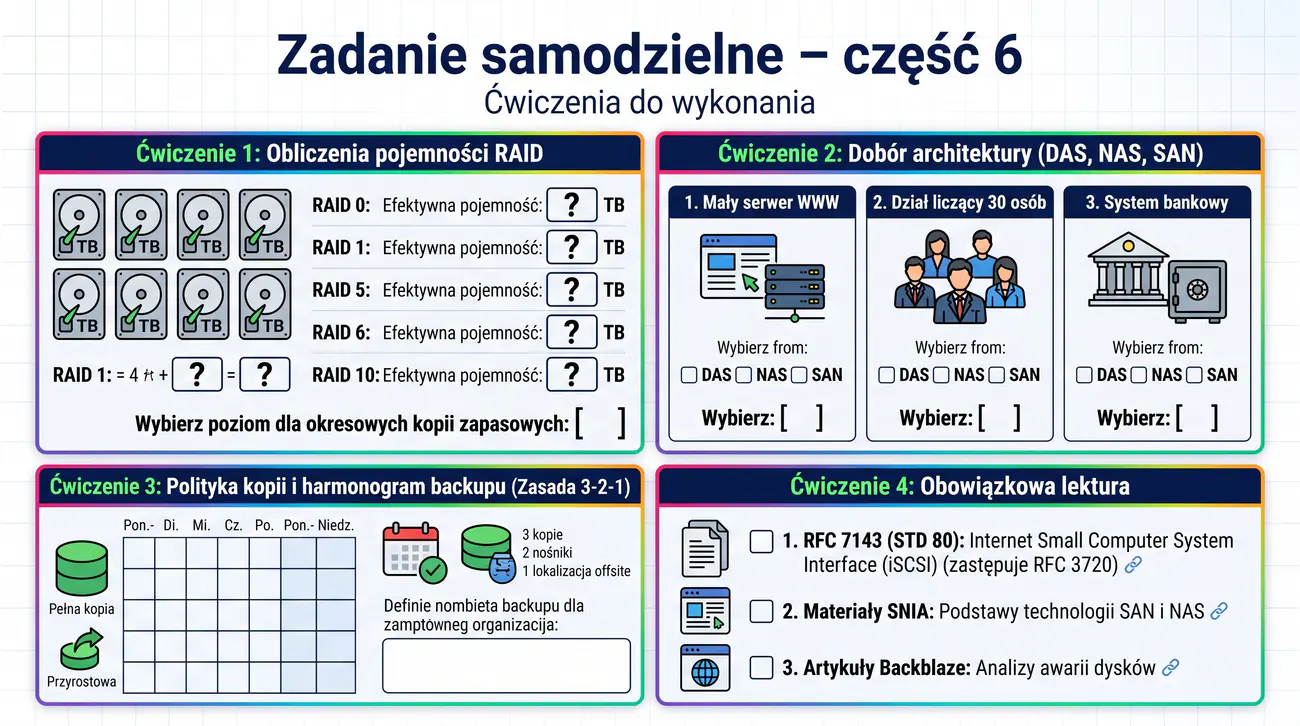
Zadania samodzielne wykraczają poza pamięciowe opanowanie materiału i wymagają samodzielnego rozumowania oraz wykonania obliczeń. Przykładowe ćwiczenie dotyczące ośmiu dysków rozwija umiejętność wyznaczania pojemności efektywnej dla wszystkich poziomów. Porównanie trzech scenariuszy biznesowych uczy natomiast dopasowywania architektur do realnych warunków.
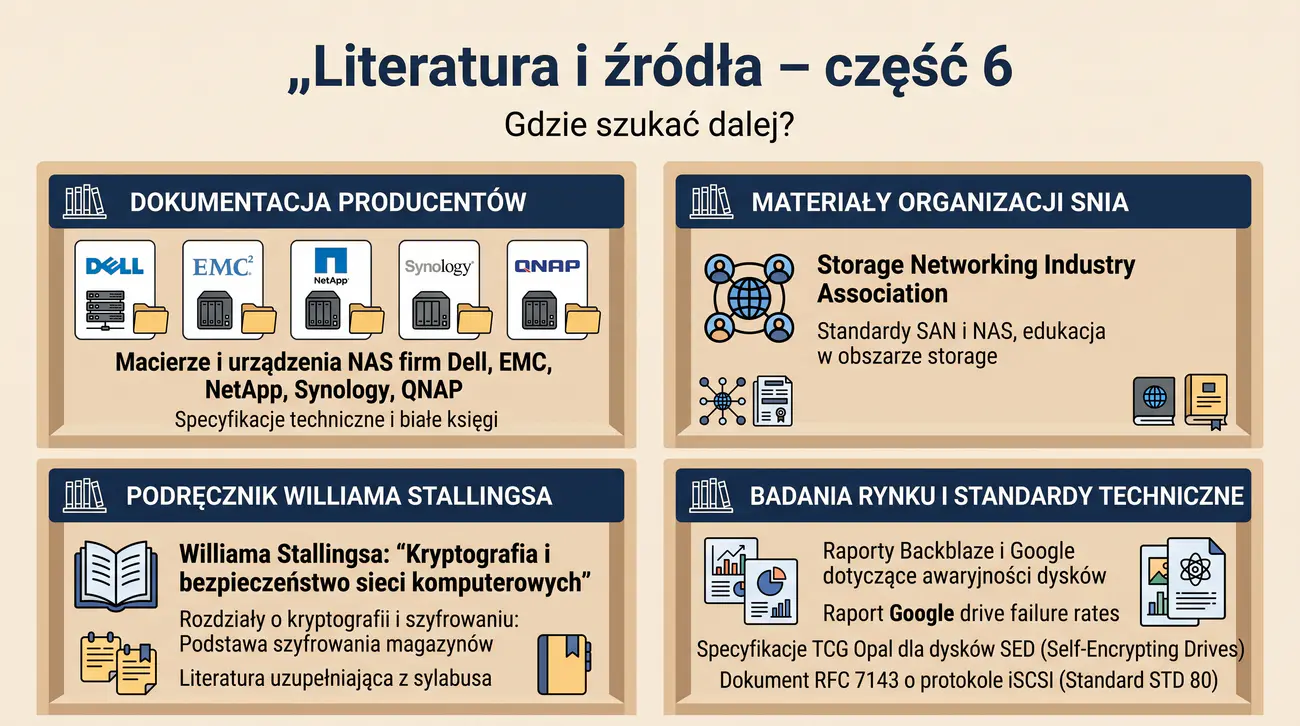
Projektowanie polityki kopii zapasowych z zasadą 3-2-1 zmusza do przeanalizowania harmonogramów, retencji i testowania przywracania. Zadania te najlepiej rozwiązywać w formie pisemnej, a wyniki weryfikować po ponownej analizie założeń. Do lektury zaleca się dokument RFC 7143 oraz materiały organizacji SNIA.
Raporty o awariach dysków publikowane przez firmę Backblaze dostarczają cennych danych statystycznych do własnych analiz. Rozwiązane zadania warto omówić w zespole inżynierskim lub zweryfikować z dokumentacją producenta. Samodzielna praktyka jest tu warunkiem skutecznego przyswojenia wiedzy.
Bibliografia części szóstej prowadzi czytelnika do źródeł, z których korzystają projektanci infrastruktury w codziennej pracy. Dokumentacja producentów, taka jak specyfikacje macierzy i urządzeń NAS, zawiera szczegóły techniczne niedostępne w podręcznikach. Materiały organizacji SNIA porządkują z kolei standardy SAN i NAS w spójną całość.
Podręcznik Stallingsa dostarcza podstaw kryptograficznych, na których opiera się problematyka szyfrowania magazynów. Raporty o awaryjności dysków publikowane przez Backblaze umożliwiają weryfikację teoretycznych wskaźników niezawodności na danych empirycznych. Dokumenty normatywne, takie jak RFC 7143 opisujący iSCSI, są natomiast źródłem precyzyjnych definicji.
Praca z takimi materiałami rozwija nawyk sprawdzania informacji w wielu źródłach, kluczowy dla inżyniera. Warto notować najważniejsze wnioski i odnośniki, tworząc własną bazę wiedzy. Taka staranna dokumentacja przydaje się później przy przygotowywaniu opisów technicznych.
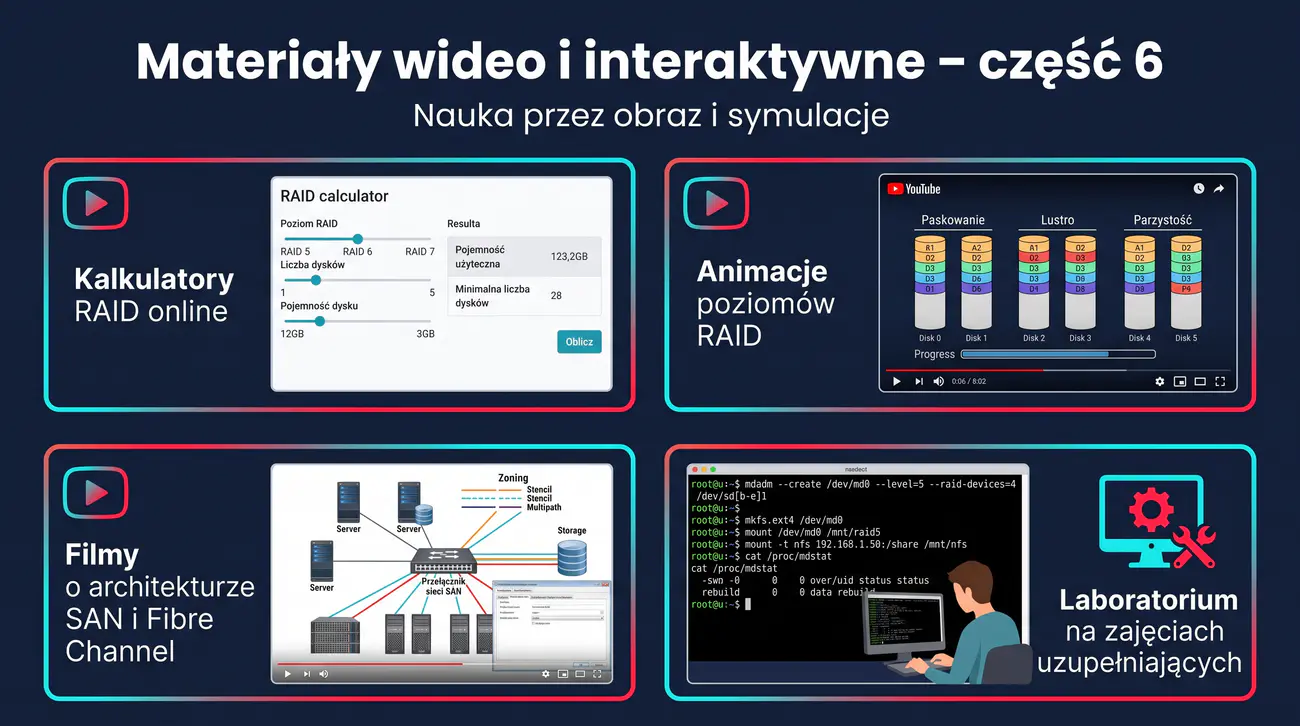
Materiały wideo i interaktywne uzupełniają opracowanie o wizualizacje, które szczególnie dobrze sprawdzają się przy pojęciach abstrakcyjnych. Animacje poziomów RAID pokazują paskowanie, lustro i parzystość w ruchu, co ułatwia ich zrozumienie. Kalkulatory online pozwalają natomiast szybko sprawdzić pojemność i liczbę dysków dla podanej konfiguracji.
Niezależnie od gotowych materiałów warto rysować własne schematy macierzy i prześledzić na nich przebieg zapisu czy awarii. Taki własnoręczny szkic utrwala wiedzę znacznie lepiej niż samo oglądanie cudzych animacji. Dopiero potem warto sięgnąć po filmy instruktażowe pokazujące konfigurację stref, multipath czy urządzeń NAS.
Nauka aktywna, łącząca czytanie, rysowanie i próby samodzielne, daje trwalsze efekty niż bierne przeglądanie treści. Podczas oglądania materiałów warto notować skróty i przygotowywać własne podsumowania. Takie podejście przekształca pasywne oglądanie w proces budowania wiedzy.
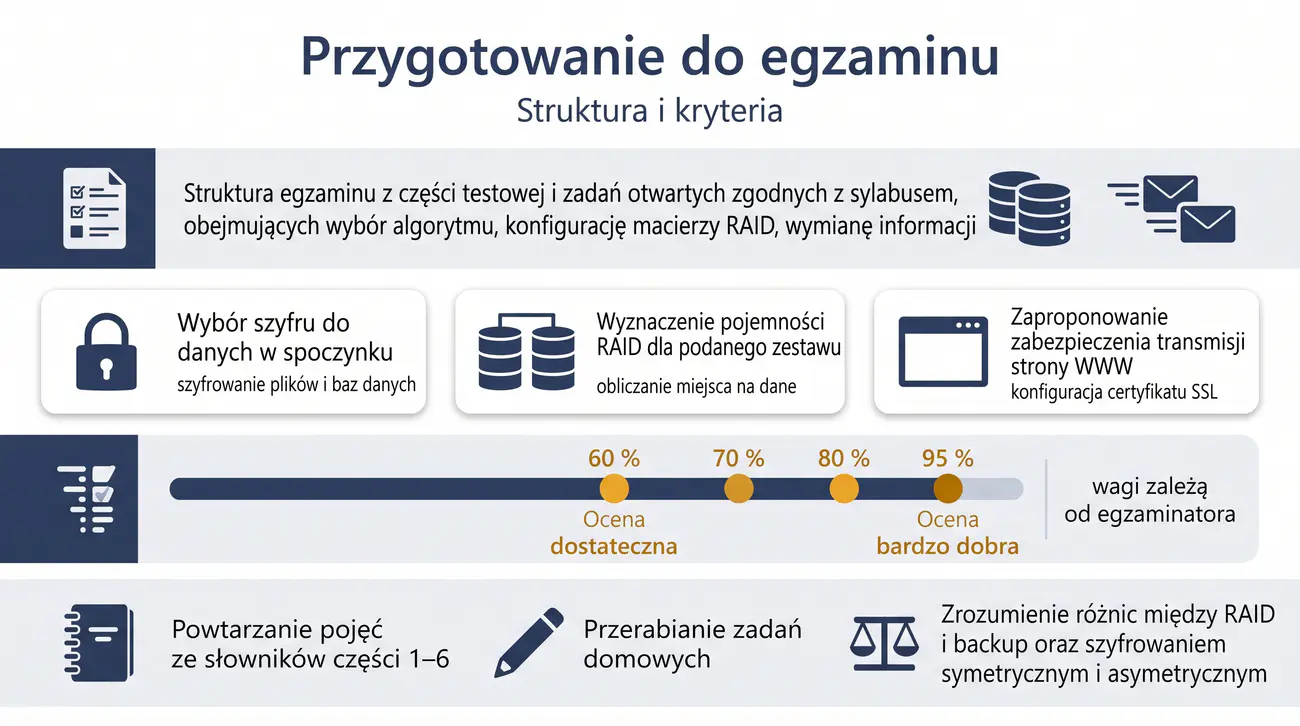
Usystematyzowanie wiedzy powinno łączyć powtarzanie pojęć z ćwiczeniem obliczeń i projektowaniem architektur składowania. W zadaniach otwartych istotny jest pokazany tok rozumowania, a nie tylko sam wynik. Dlatego warto przyzwyczaić się do zapisywania kolejnych kroków rozwiązań.
Przy zadaniach o macierzach należy najpierw wypisać dane, następnie zastosować wzór na pojemność, a na końcu przedyskutować kompromisy. Wiedza z poprzednich części, na przykład o szyfrach symetrycznych, ułatwia odpowiedzi o szyfrowaniu magazynów. Powtarzanie słownika wszystkich części w odstępach czasowych daje trwały efekt i ułatwia rozwiązywanie problemów wdrożeniowych.
Staranne przećwiczenie pytań kontrolnych i zadań obliczeniowych pozwala na biegłe opanowanie zagadnień bezpieczeństwa i niezawodności magazynów. Systematyczność i praktyka są tu ważniejsze niż jakakolwiek metoda szybkiego wkuwania.
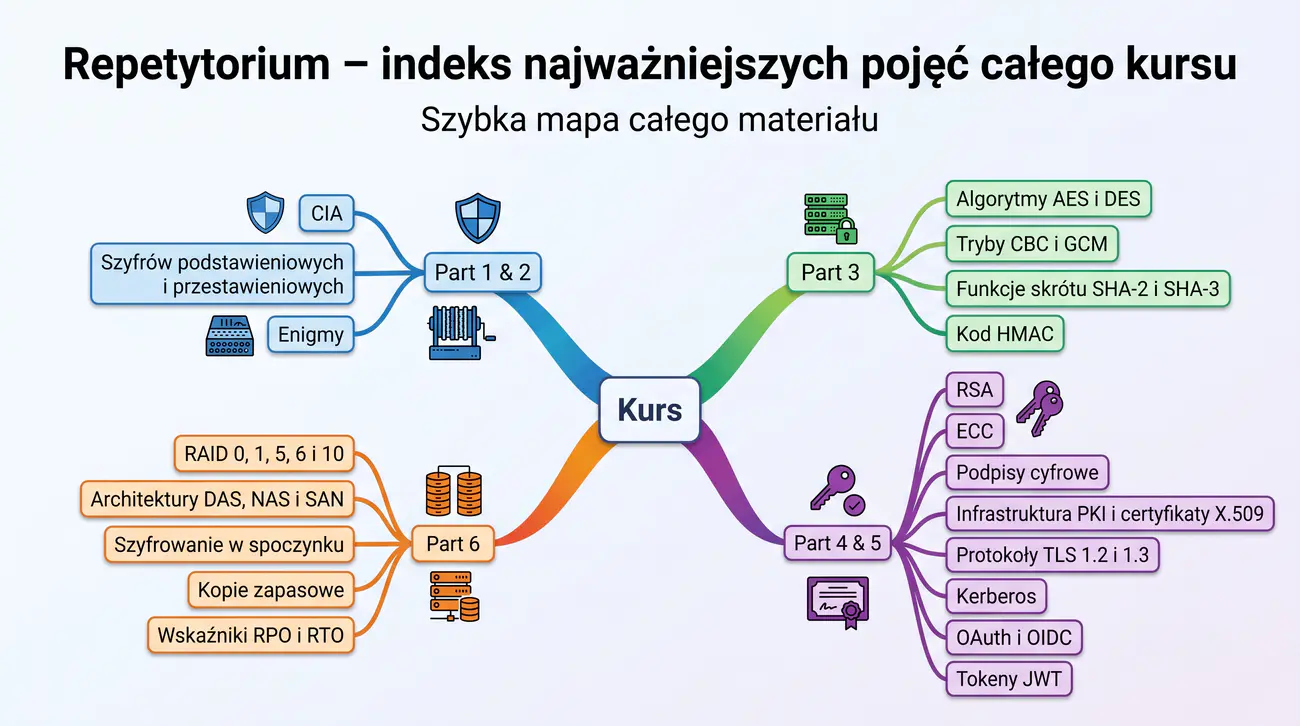
Repetytorium zbiera najważniejsze pojęcia całości w zwięzłą mapę, dzięki której można szybko ocenić poziom opanowania materiału. Poruszając się po nim od części pierwszej do szóstej, uczestnik sprawdza, czy płynnie wyjaśnia kolejne hasła. Terminy z wcześniejszych części są bowiem bazą dla zagadnień składowania.
Warto traktować repetytorium jako listę kontrolną i odhaczać tematy opanowane, koncentrując się następnie na słabszych obszarach. Szybkie testy samosprawdzające, w których definicje wypowiada się na głos lub zapisuje z pamięci, ujawniają realny stan wiedzy. Tak prowadzona rewizja utrwala kluczowe pojęcia i relacje między nimi.
Powtarzanie w małych porcjach rozłożonych w kilka dni utrwala informacje znacznie lepiej niż intensywna nauka w przeddzień. Zwracanie uwagi na powiązania między częściami, na przykład między szyfrowaniem a magazynami, ułatwia zapamiętywanie. W ten sposób repetytorium staje się narzędziem skutecznego usystematyzowania wiedzy inżynierskiej.
Uwagi końcowe zamykają opracowanie przypomnieniem o praktycznym wymiarze wszystkich omówionych zagadnień. Zdobyta wiedza znajduje bezpośrednie zastosowanie w pracy administratora, projektanta infrastruktury i inżyniera bezpieczeństwa. Część szósta, dotycząca magazynów, doskonale komponuje się z całością opracowania, bo pokazuje, gdzie ostatecznie spoczywają dane.
Przedstawione treści przygotowują również do certyfikacji branżowych oraz praktyk zawodowych, stanowiących kolejny krok rozwoju. Uzupełnieniem teorii są ćwiczenia praktyczne, na których wiedza przeradza się w konkretne umiejętności operacyjne i inżynierskie.
Zmienność technologii składowania wymusza ciągłą aktualizację wiedzy, dlatego dobre nawyki samodzielnego uczenia się są tu nieocenione. Materiał daje solidne podstawy, na których specjalista buduje swoje doświadczenie zawodowe. Takie zakończenie jest zarazem zaproszeniem do dalszego rozwoju w dziedzinie bezpieczeństwa informacji.