Kryptologia i bezpieczna wymiana informacji
Część 3 - Kryptografia symetryczna: nowoczesne algorytmy i funkcje skrótu
Trzecia część opracowania przenosi uwagę na mechanizmy, które w praktyce dźwigają największy ciężar ochrony danych, czyli szyfry symetryczne oraz funkcje skrótu. Kolejność omawianych tematów prowadzi od klasycznych szyfrów blokowych, przez tryby pracy, aż po szyfry strumieniowe i zagadnienia integralności. Taki układ pozwala pokazać, że wybór algorytmu nigdy nie jest przypadkowy, lecz wynika z analizy zastosowania i modelu zagrożeń.
Szyfry symetryczne stanowią fundament niemal wszystkich współczesnych protokołów, dlatego ich opanowanie jest niezbędne przy rozumieniu działania TLS, sieci VPN czy systemów szyfrujących dyski. Dzięki szybkości przetwarzania mają zastosowanie tam, gdzie kryptografia asymetryczna byłaby zbyt kosztowna. Warto od początku zwracać uwagę na relacje między poszczególnymi blokami materiału, ponieważ omówione wcześniej pojęcia wracają w kolejnych częściach materiału.
Część czwarta cyklu, poświęcona kryptografii asymetrycznej, uzupełni ten obraz o rozwiązanie problemu dystrybucji kluczy. Śledzenie aktualnych zaleceń instytucji normalizacyjnych pozwala natomiast zrozumieć, jak dynamicznie zmienia się ocena bezpieczeństwa poszczególnych konstrukcji. Ta świadomość jest jedną z najważniejszych kompetencji przyszłego inżyniera bezpieczeństwa.
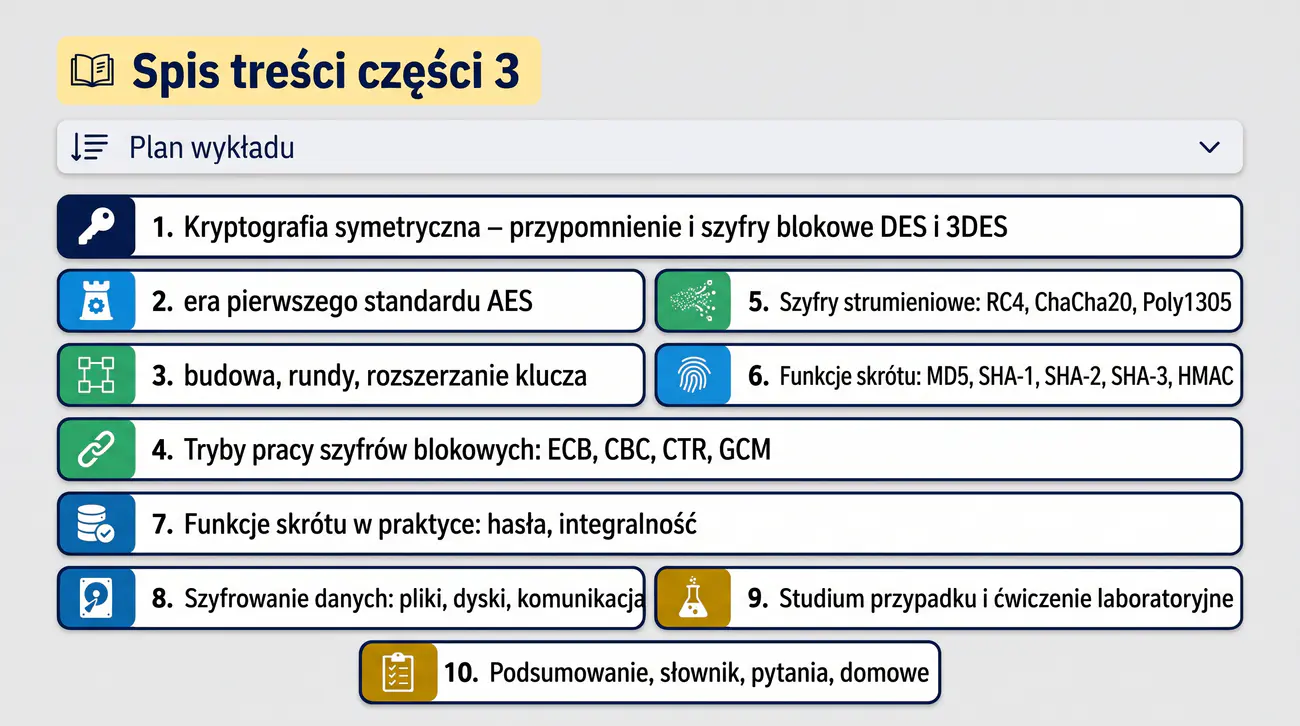
Spis treści porządkuje cały wykład według rosnącej złożoności, rozpoczynając od szyfrów blokowych i kończąc na praktycznych zastosowaniach. Dzięki temu każdy kolejny temat odwołuje się do wiedzy zdobytej wcześniej, co ułatwia systematyczne opanowanie materiału. Znajomość struktury wykładu pozwala także śledzić postęp własnej nauki i planować powtórki.
Bloki tematyczne, takie jak tryby pracy szyfrów czy funkcje skrótu, nie występują w spisie oderwane od siebie, lecz tworzą spójną narrację dydaktyczną. Zrozumienie AES ułatwia bowiem analizę trybu GCM, a znajomość właściwości funkcji skrótu pozwala ocenić działanie mechanizmu HMAC. Tego rodzaju powiązania są widoczne dopiero wtedy, gdy odbiorca sam je odnajduje w trakcie powtórek.
Zapowiedziane na końcu wykładu studium przypadku oraz ćwiczenie praktyczne mają charakter wdrożeniowy i łączą treści teoretyczne z konkretnymi poleceniami narzędzi. Takie połączenie odzwierciedla profil praktyczny studiów i przygotowuje do rozwiązywania rzeczywistych zadań. Regularne wracanie do wybranych fragmentów spisu pomaga utrzymać wszystkie omawiane zagadnienia w polu uwagi.
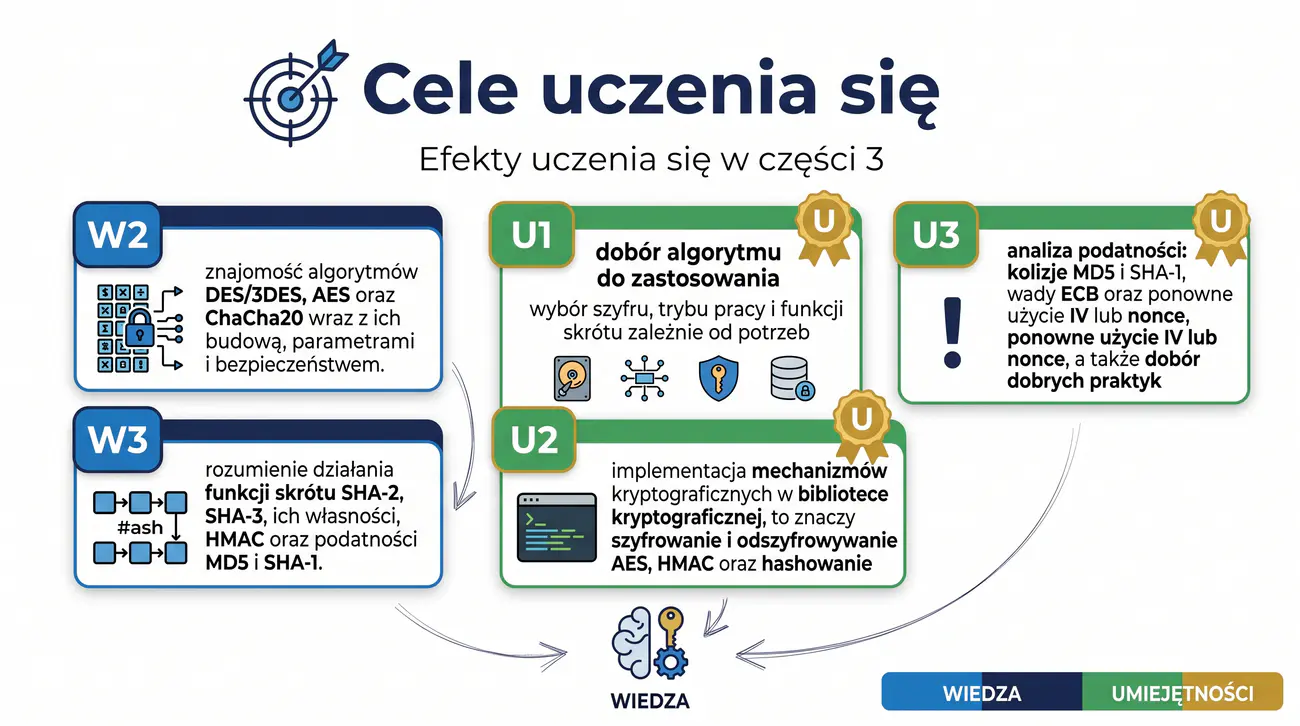
Zagadnienia zostały sformułowane w trzech grupach, które opisują stopniowe przechodzenie od znajomości faktów do samodzielnej pracy implementacyjnej. Pierwsza grupa obejmuje wiedzę o algorytmach i ich parametrach, druga umiejętność ich właściwego doboru, a trzecia zdolność oceny podatności. Taki podział wymaga od odbiorcy nie tylko pamięciowego opanowania definicji, lecz także rozumienia mechanizmów działania.
Dobór algorytmu powinien być uzasadniany w kontekście konkretnego scenariusza i modelu zagrożeń, a nie wyłącznie mody lub przyzwyczajeń zespołu projektowego. Osoba przyswajająca ten materiał potrafi rozstrzygnąć, kiedy zastosować szyfr blokowy, kiedy tryb AEAD, a kiedy dedykowaną funkcję przeznaczoną do haseł. Ta umiejętność jest szczególnie ceniona w pracy inżyniera, który odpowiada za bezpieczeństwo całego systemu.
Analiza podatności wymaga poznania historycznych przypadków kompromitacji oraz ich przyczyn, dlatego w materiale pojawiają się opisane zagadnienia, takie jak kolizje MD5 czy wady trybu ECB. Rozumienie, dlaczego dane konstrukcje zawiodły, chroni przed powtarzaniem tych samych błędów w przyszłych projektach. Dzięki temu odbiorca może świadomie oceniać informacje o nowych algorytmach, zamiast przyjmować je bezrefleksyjnie.
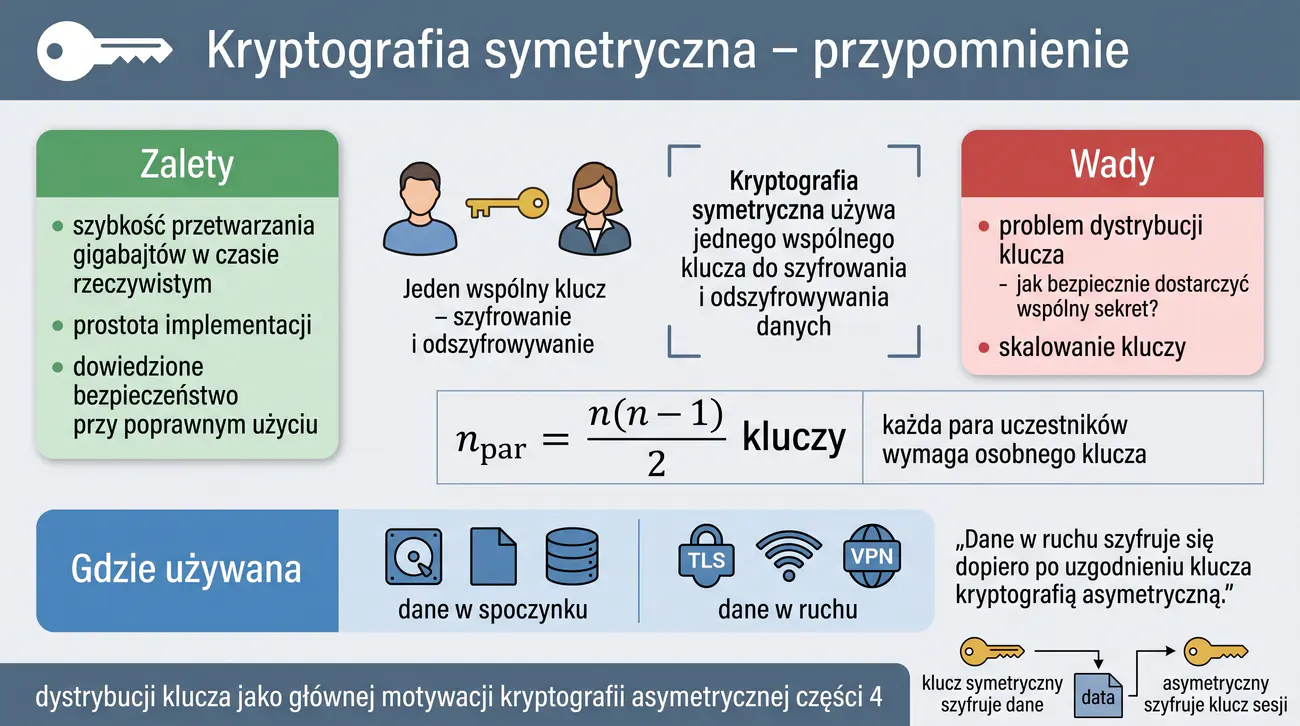
Model kryptografii symetrycznej opiera się na założeniu, że obie strony komunikacji dysponują identycznym, tajnym kluczem, natomiast sam algorytm może być całkowicie jawny. Cała siła ochrony wynika zatem z poufności klucza, a nie z sekretu dotyczącego procedury szyfrującej. Taka konstrukcja pozwala na publiczną weryfikację algorytmu przez całe środowisko naukowe.
Najważniejszą słabością tego modelu jest dostarczenie klucza stronie odległej bez ryzyka jego przechwycenia, co bywa trudniejsze niż samo szyfrowanie komunikatów. W większych grupach użytkowników liczba niezbędnych par kluczy rośnie kwadratowo, dlatego sama kryptografia symetryczna nie skaluje się dobrze w systemach wielu uczestników. W praktyce problem rozwiązuje kryptografia hybrydowa, w której asymetryczna wymiana klucza poprzedza proces symetryczny.
Szybkość działania szyfrów symetrycznych, wspierana przez sprzętową akcelerację, pozostaje decydująca przy przesyłaniu dużych wolumenów danych. Należy jednak pamiętać, że bezpieczeństwo całego systemu zależy również od jakości losowania kluczy oraz od sposobu ich przechowywania. Błędna praktyka dotycząca kluczy potrafi zniweczyć nawet najsilniejszy algorytm.
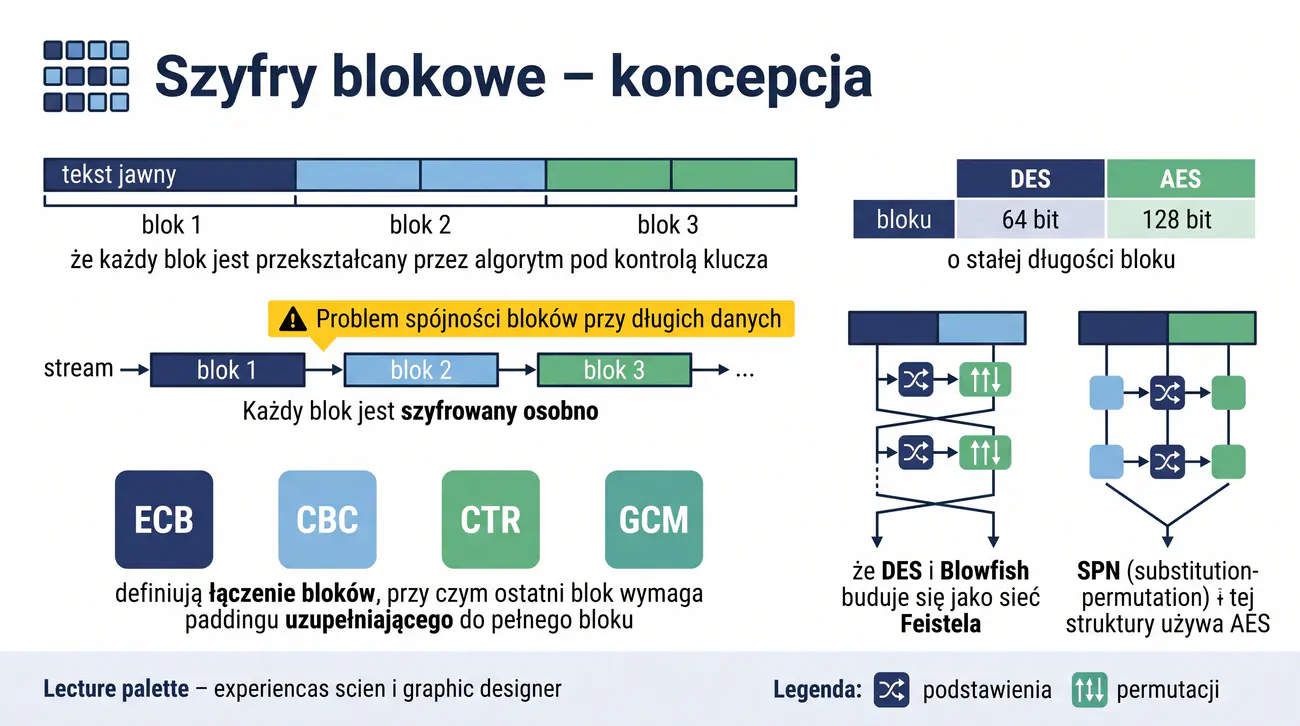
Szyfr blokowy przetwarza dane w porcjach o stałej długości, dlatego każda wiadomość dłuższa niż pojedynczy blok wymaga dodatkowej decyzji o sposobie łączenia kolejnych porcji. Ostatni, niepełny blok trzeba przy tym uzupełnić do pełnej długości, co wprowadza konieczność stosowania dopełniania. Samo pojęcie dopełniania bywa źródłem błędów w implementacjach i pośrednio przyczyniło się do powstania znanych ataków.
Z konstrukcyjnego punktu widzenia szyfry blokowe dzieli się na sieci Feistela oraz sieci SPN. W sieci Feistela tylko połowa bloku przepływa przez funkcję rundową, podczas gdy konstrukcja SPN przekształca cały stan naraz, jak dzieje się to w AES. Obie szkoły mają różne właściwości dotyczące szybkości, łatwości implementacji oraz odporności na kryptoanalizę.
Cechą wspólną wszystkich szyfrów iteracyjnych jest powtarzanie podobnych operacji w kolejnych rundach, przy czym klucz rundowy wnosi tajność do każdego etapu. Zrozumienie tej ogólnej konstrukcji pozwala analizować nowe algorytmy bez uprzedniego nauczenia się szczegółów każdego z nich. Dzięki temu można samodzielnie czytać specyfikacje kolejnych szyfrów blokowych spotykanych w literaturze branżowej.
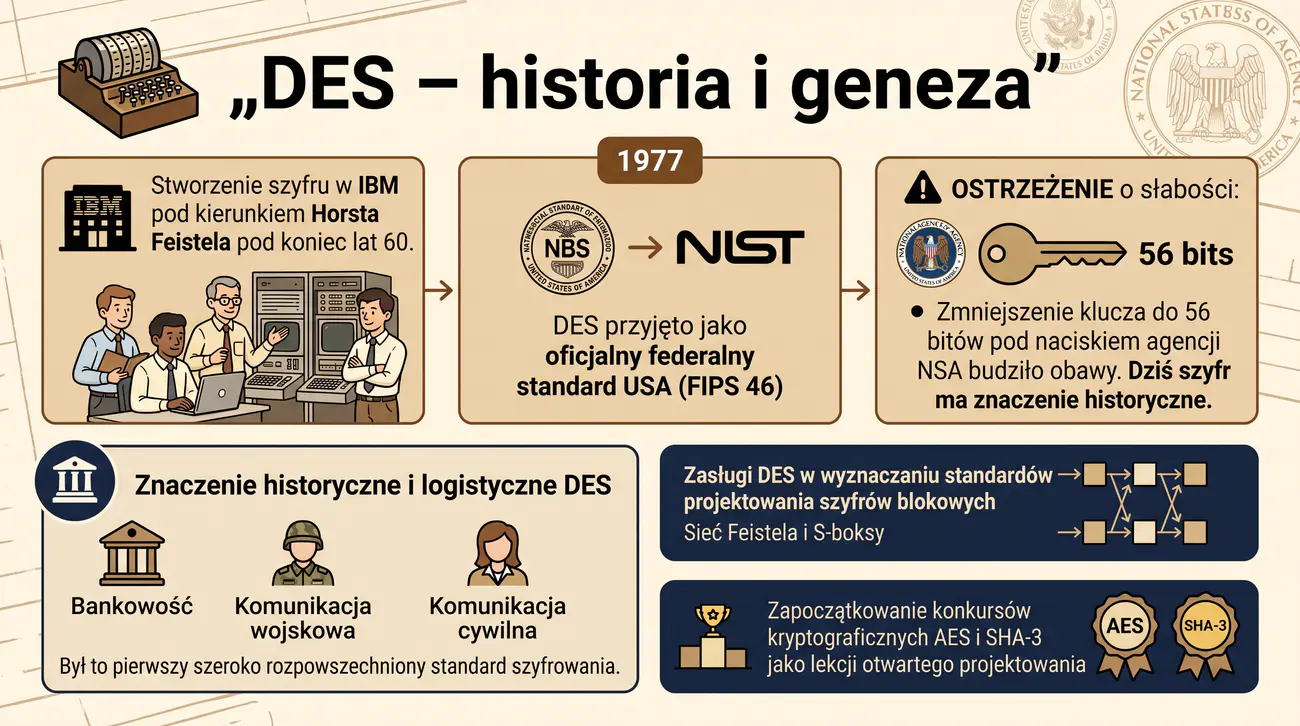
DES powstał w wyniku przekształcenia wcześniejszego szyfru Lucifer i przez kilkadziesiąt lat pozostawał wzorcowym przykładem otwartego standardu kryptograficznego. Jego przyjęcie przez NBS w 1977 roku dało początek szeroko stosowanym regulacjom dotyczącym szyfrowania w sektorze bankowym oraz administracji. Zasięg oddziaływania standardu sprawił, że stał się on punktem odniesienia dla wszystkich późniejszych projektów.
Skrócenie klucza z przewidywanych 64 do 56 bitów budziło od początku kontrowersje dotyczące udziału służb rządowych w projektowaniu standardu. Spór ten pokazuje, że decyzje kryptograficzne bywają warunkowane czynnikami instytucjonalnymi, a nie wyłącznie matematycznymi. Racjonalna ocena każdego standardu wymaga więc znajomości zarówno kontekstu technicznego, jak i politycznego.
Historia DES uczy także, że otwarta i niezależna analiza algorytmu pozwala ujawnić jego pełne właściwości, w tym szczegóły projektowe S-boksów. Dzięki tej lekcji kontestowane wcześniej konstrukcje bywają obecnie z założenia poddawane publicznej weryfikacji. Tak właśnie postępowano później podczas przygotowywania następców DES i SHA-1.
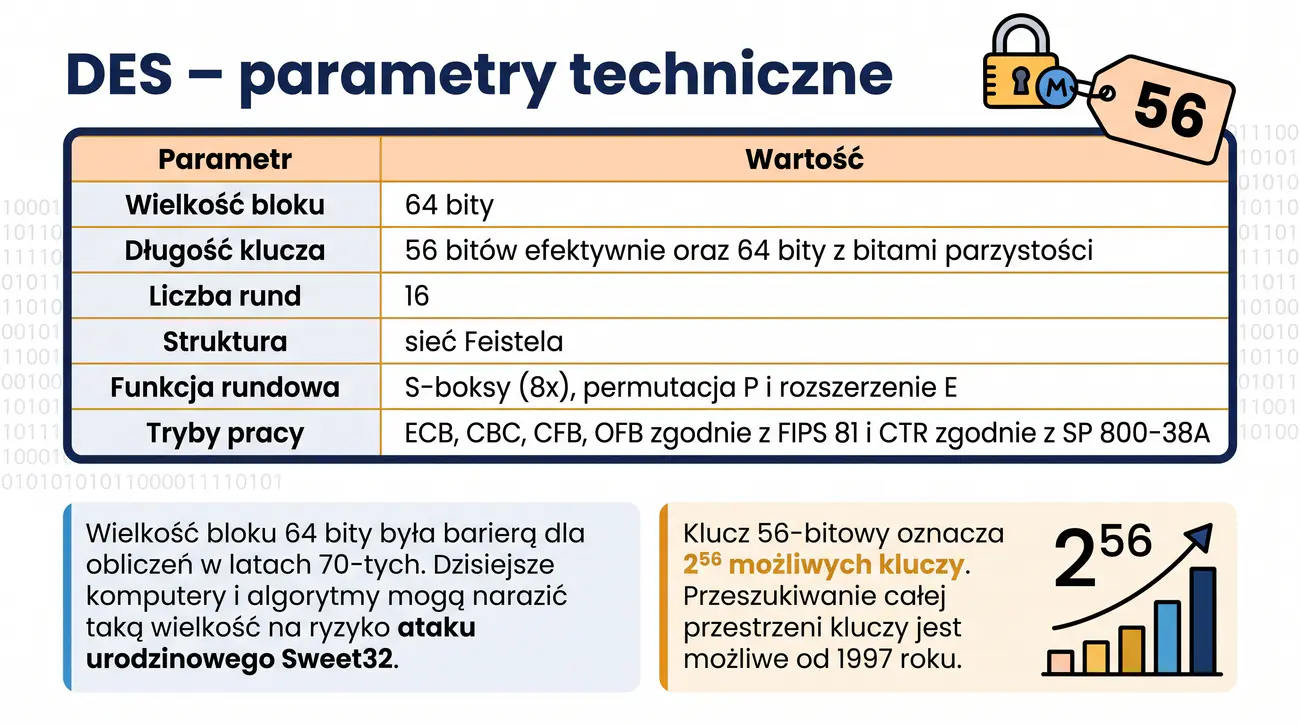
| Parametr | Wartość |
|---|---|
| Wielkość bloku | 64 bity |
| Długość klucza | 56 bitów efektywnie (64 bity z bitami parzystości) |
| Liczba rund | 16 |
| Struktura | sieć Feistela |
| Funkcja rundowa | S-boksy (8x), permutacja P, rozszerzenie E |
| Tryby pracy | ECB, CBC, CFB, OFB (FIPS 81), CTR (SP 800-38A) |
Parametry DES, czyli blok 64-bitowy i klucz 56-bitowy, doskonale oddają możliwości obliczeniowe epoki powstania standardu. Blok tej długości był w latach siedemdziesiątych rozsądnym wyborem, lecz współcześnie stanowi wąskie gardło ograniczające bezpieczeństwo dużych wolumenów danych. Mała przestrzeń kluczy czyni z kolei przeszukiwanie siłowe zadaniem w pełni wykonalnym przy dzisiejszej mocy obliczeniowej.
Warto zwrócić uwagę na bity parzystości umieszczane w co ósmym bicie klucza, które nie zwiększają poziomu bezpieczeństwa, a jedynie ułatwiają kontrolę poprawności wpisywanego materiału. Ich obecność bywa źródłem nieporozumień przy implementacji, gdyż nominalna długość klucza wynosi 64 bity, a rzeczywista siła tylko 56. Taki przykład pokazuje, jak istotne jest rozróżnienie między zapisem klucza a jego faktyczną mocą kryptograficzną.
Czytając parametry dowolnego szyfru, należy brać pod uwagę wszystkie elementy jednocześnie, obejmując blok, klucz, liczbę rund i strukturę, ponieważ dopiero ich całość determinuje poziom bezpieczeństwa. Parametry AES, omawiane w dalszej części wykładu, wyznaczają współczesny punkt odniesienia dla tych porównań. Dzięki takim zestawieniom łatwiej dostrzec, które wartości w praktyce decydują o przydatności algorytmu.
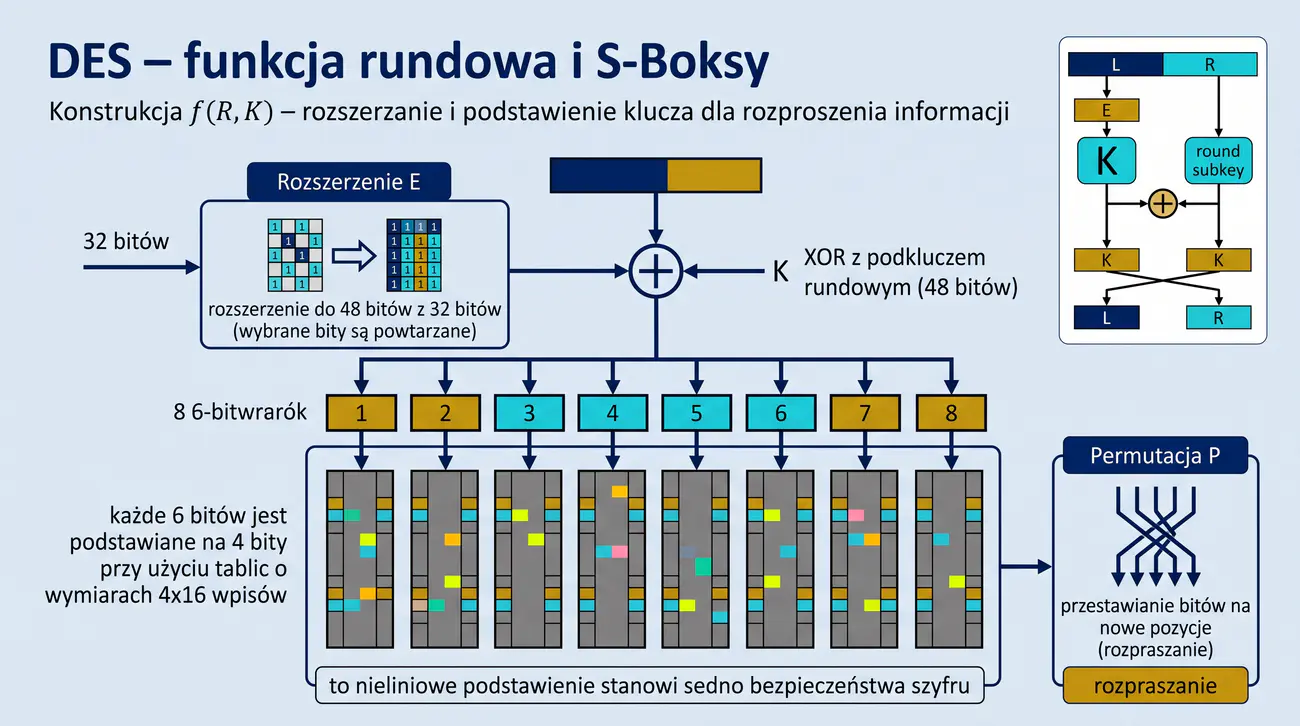
Funkcja rundowa DES działa na 32-bitowej prawej połówce (R) i 48-bitowym podkluczu rundowym (K):
Funkcja rundowa DES jest klasycznym przykładem realizacji zasad konfuzji i dyfuzji opisanych przez Shannona, dlatego analiza jej kolejnych kroków uczy rozumienia nowoczesnych szyfrów iteracyjnych. Nieliniowość, wprowadzana przez S-boksy, odpowiada za odporność na kryptoanalizę różnicową i liniową, natomiast pozostałe operacje rozpraszają wpływ pojedynczego bitu na cały blok. Właśnie połączenie struktur liniowych z nieliniowymi stanowi o sile całej konstrukcji.
Rozszerzenie E zwiększa blok z 32 do 48 bitów, co pozwala na dodanie klucza rundowego, a równocześnie tworzy zależności między sąsiednimi bitami wykorzystywane w analizie różnicowej. Permutacja P porządkuje natomiast wynik operacji tak, aby w następnej rundzie wpływał na inne pozycje prawej połówki. Taki dobór elementów został dopracowany na etapie projektowania i jest dziś interpretowany jako jeden z najwcześniejszych świadomych projektów mieszania danych.
Zrozumienie tej struktury przygotowuje do analizy szyfru AES, który celowo zaprojektowano tak, aby nieliniowość dała się opisać ściśle matematycznie. Dzięki temu dostrzega się ciągłość ewolucji między konstrukcją DES a późniejszymi standardami. Ta ewolucja stanowi zarazem ilustrację, jak duże znaczenie mają jawne, opisane podstawy projektowania.
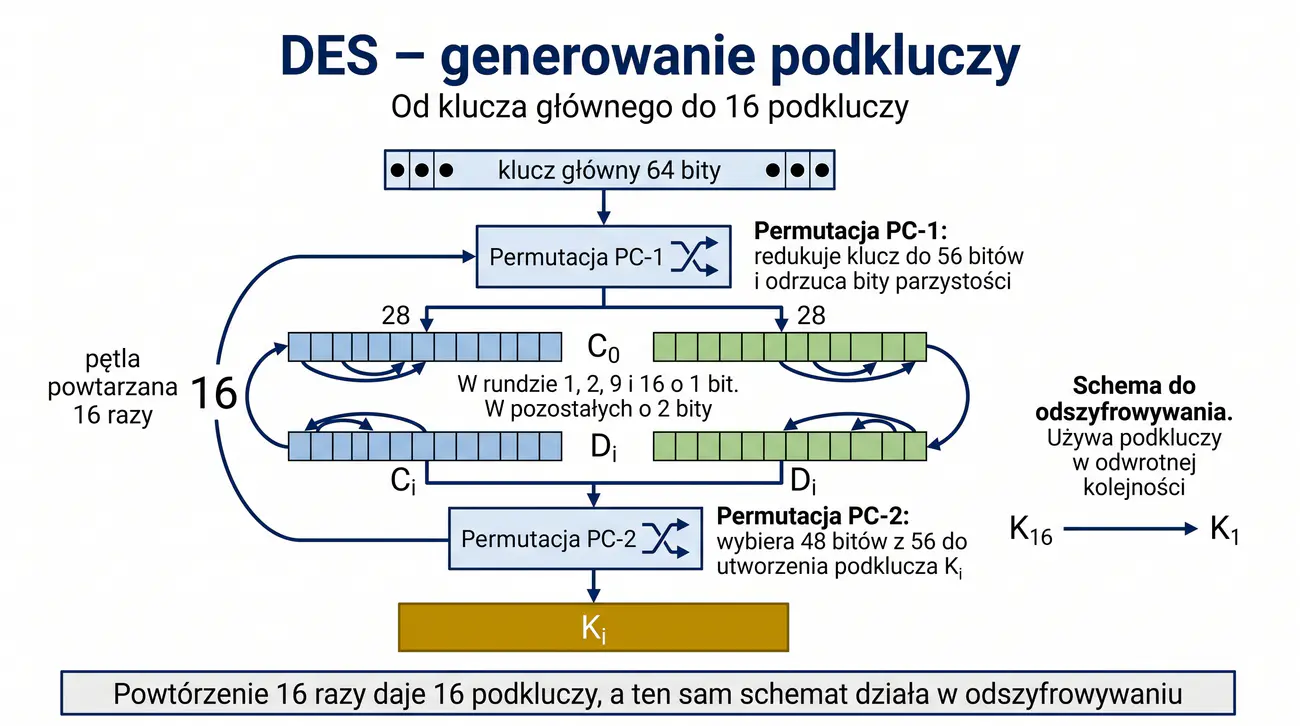
Powtarzane 16 razy daje 16 podkluczy; ten sam schemat w odszyfrowaniu (klucze używane w odwrotnej kolejności).
Harmonogram kluczy DES przekształca klucz główny w szesnaście podkluczy rundowych za pomocą permutacji i przesunięć cyklicznych. W pierwszym kroku permutacja PC-1 usuwa bity parzystości, redukując klucz do 56 bitów i dzieląc go na dwie połówki. Dopiero po serii przesunięć, których liczba zależy od numeru rundy, permutacja PC-2 wybiera 48 bitów podklucza.
Interesującą cechą tego harmonogramu jest brak operacji jednokierunkowych, takich jak hashowanie, co sprawia, że odszyfrowywanie może korzystać z tej samej procedury w odwrotnej kolejności. Taki symetryczny przepływ upraszcza implementację i zmniejsza ryzyko rozbieżności między oboma kierunkami przekształceń. Jednocześnie konstruktorom zależało na tym, aby żaden bit klucza nie pozostawał w stagnacji w kolejnych rundach.
Znajomość szczegółów harmonogramu jest dziś potrzebna głównie do analizy historycznej i odtworzeniowych implementacji. W przypadku AES, omawianego w dalszej części, rozszerzanie klucza przybiera już odmienną, bardziej algebraiczną postać. Porównywanie harmonogramów kluczy różnych szyfrów to zresztą jedna z dróg do zrozumienia ich podobieństw i różnic.
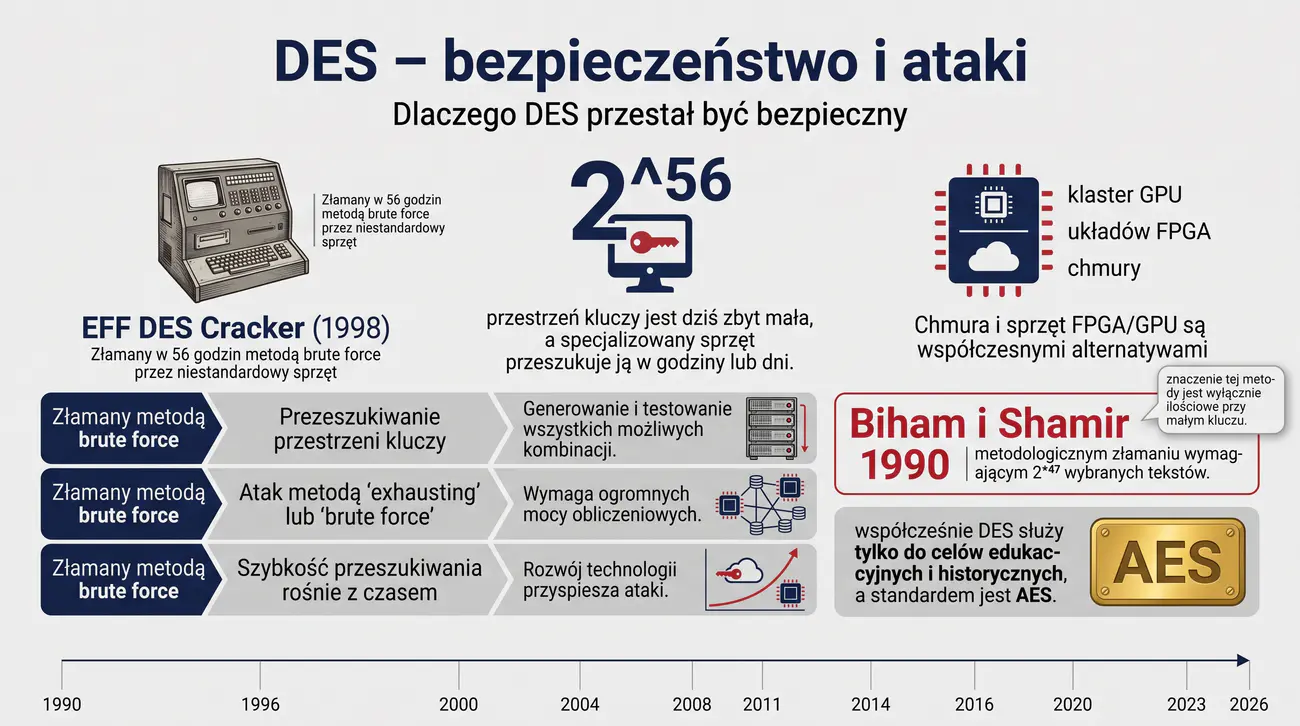
Historia praktycznych ataków na DES ilustruje, jak zmiany w mocy obliczeniowej sprzętu potrafią zmienić ocenę formalnie poprawnej konstrukcji. Przestrzeń kluczy rzędu 2^56, przez długi czas uznawana za niedostępną, z czasem okazała się osiągalna dla wyspecjalizowanych maszyn. Ważny jest przy tym aspekt ekonomiczny, ponieważ koszt potrzebnego sprzętu systematycznie spadał wraz z rozwojem technologii.
Zbudowana w 1998 roku przez Electronic Frontier Foundation maszyna DES Cracker ukończyła przeszukiwanie całej przestrzeni kluczy w kilkadziesiąt godzin, co było wydarzeniem szeroko komentowanym w prasie. Analizy teoretyczne, takie jak kryptoanaliza różnicowa Bihama i Shamira, dowiodły jednocześnie, że struktura szyfru nie należy do najsłabszych elementów systemu. To właśnie niezależność tych dwóch rodzajów wyników pozwoliła wyodrębnić długość klucza jako właściwą przyczynę upadku standardu.
Współczesne klastry kart graficznych i układy FPGA wykonują zbliżone obliczenia jeszcze szybciej, dlatego DES pozostaje wyłącznie materiałem dydaktycznym. Zastąpienie go standardem AES było wynikiem świadomej decyzji o dopasowaniu poziomu bezpieczeństwa do realnych możliwości atakujących. Z tej historii płynie również wniosek o potrzebie planowego monitorowania postępu techniki przez zespoły odpowiadające za bezpieczeństwo.
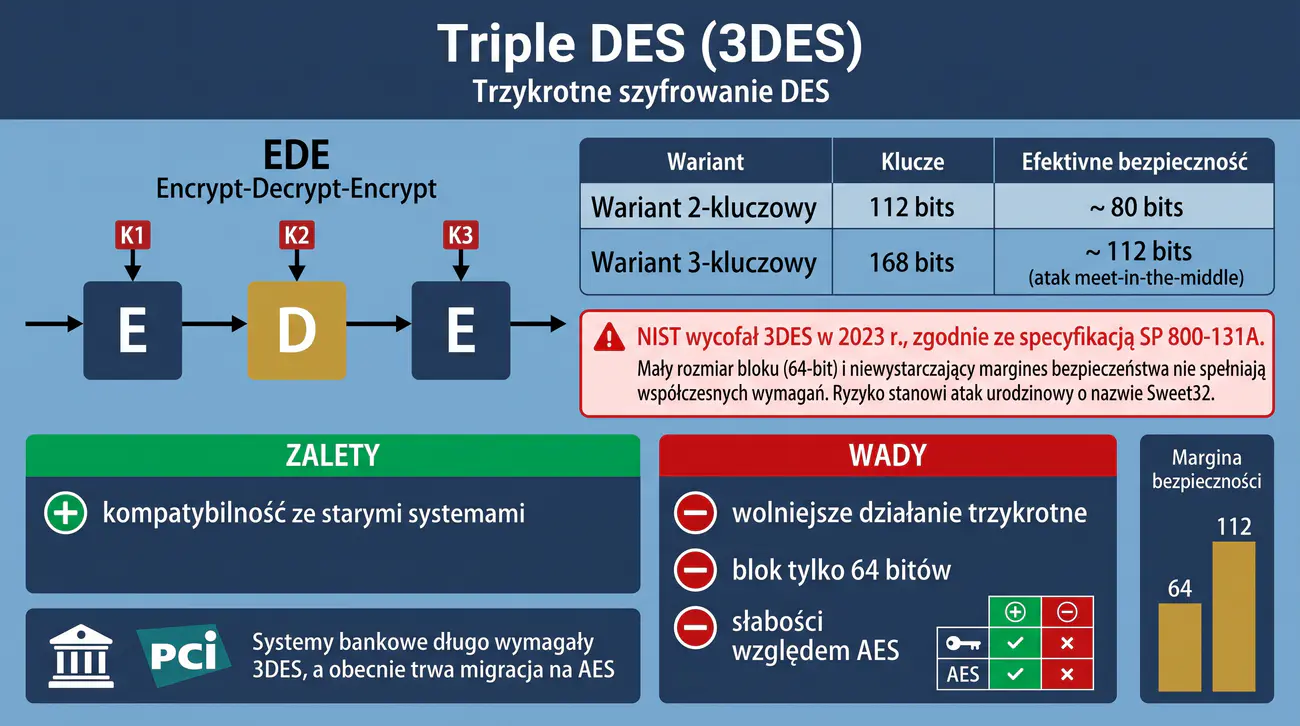
Potrójne szyfrowanie DES miało przedłużyć żywotność standardu bez konieczności opracowania całkowicie nowego algorytmu. Sekwencja EDE, czyli naprzemienne powtórzenie szyfrowania i odszyfrowywania, została dobrana tak, aby przy identycznych kluczach całość sprowadzała się do zwykłego DES. Dzięki temu starsze systemy mogły płynnie przechodzić między trybami bez zmiany struktury danych.
Wariant 2-kluczowy oferuje kompromis między długością klucza a liczbą potrzebnych operacji, natomiast wariant 3-kluczowy daje większy margines przy kosztowniejszym przetwarzaniu. Zastosowanie ataku meet-in-the-middle obniża efektywne bezpieczeństwo obu wariantów poniżej sumy długości użytych kluczy. Niewielka prędkość, wynikająca z potrójnego szyfrowania, stanowiła dodatkowy argument za przejściem na nowsze algorytmy.
Wycofanie 3DES przez NIST w 2023 roku podyktowane było połączeniem małego bloku, ograniczonego marginesu bezpieczeństwa oraz istnienia znanych ataków. Historia tej konstrukcji stanowi przykład stopniowego, kontrolowanego wycofywania przestarzałego standardu ze stosowania. Praktyka pokazuje przy tym, że proces taki wymaga zaplanowanych działań po stronie zgodności systemów i wysokiej jakości wdrożeń.
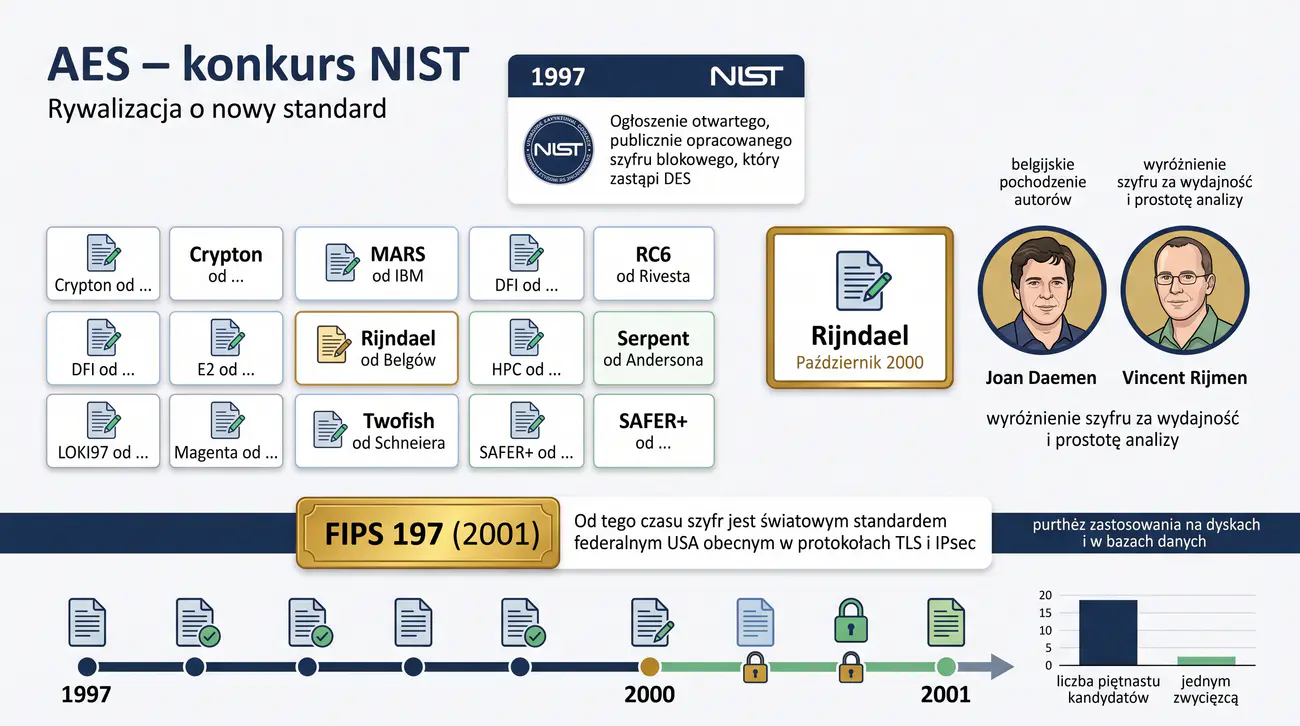
Konkurs NIST na nowy standard szyfrowania otworzył nową erę w standaryzacji kryptografii, ponieważ proces ten był w pełni jawny i oparty na publicznych zgłoszeniach. Każdy kandydat musiał zostać nie tylko poprawnie zaimplementowany, lecz również poddany analizie teoretycznej przez niezależne środowisko. Dzięki temu zwycięzca konkursu cieszył się od początku zaufaniem, jakiego trudno oczekiwać od rozwiązań zamkniętych.
Spośród piętnastu zgłoszeń do finału przeszło pięć rozwiązań, a wybór padł na algorytm Rijndael, wyróżniający się prostotą i elegancją matematyczną. Jego autorzy, Joan Daemen i Vincent Rijmen, położyli nacisk na analizowalność konstrukcji, co znacząco ułatwiło ocenę jego bezpieczeństwa. Pozostałe finałowe algorytmy miały różne mocne strony, jednak Rijndael wypadł najlepiej w ogólnym zestawieniu kryteriów.
Organizacja zawodów NIST stała się wzorcem dla późniejszych inicjatyw, między innymi konkursu na funkcję skrótu SHA-3. Doświadczenia związane z procesem AES pokazały, że kolektywne przetestowanie rozwiązań znacząco zwiększa ich wiarygodność. Dla projektantów systemów organizacja konkursu jest też dobrą lekcją powiązań między teorią, implementacją a procedurami oceny.
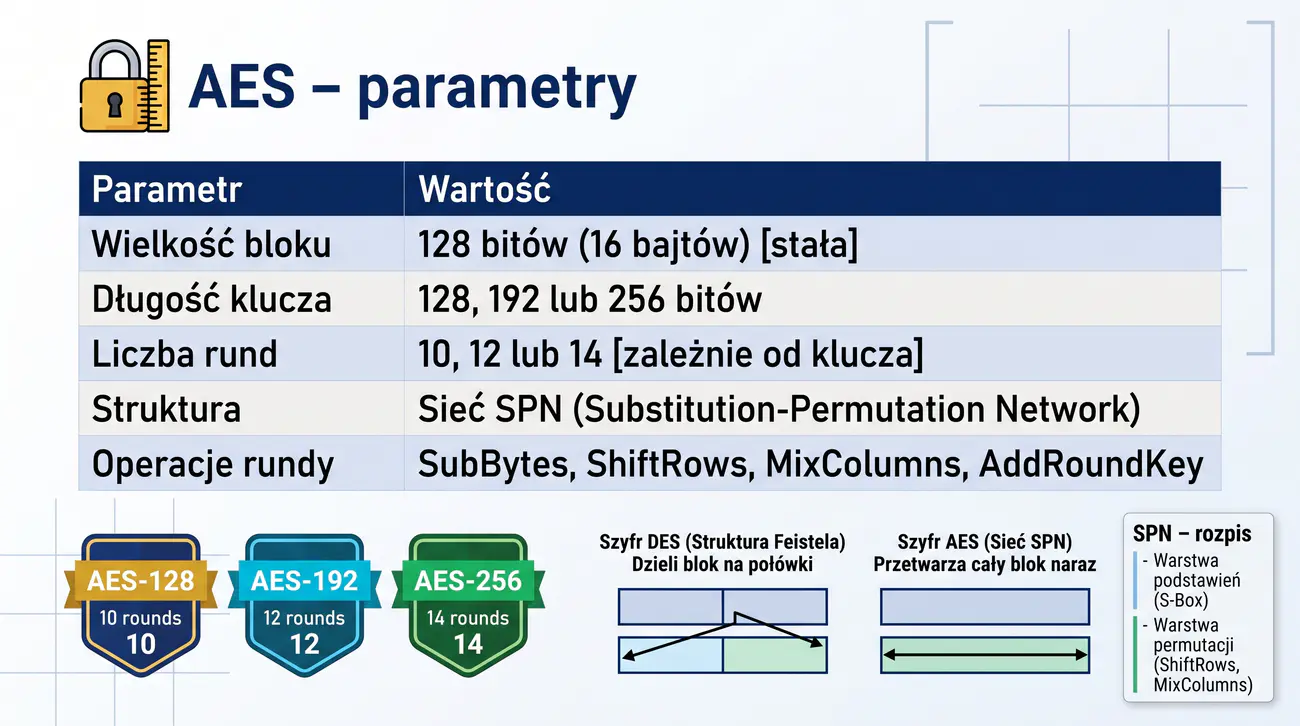
| Parametr | Wartość |
|---|---|
| Wielkość bloku | 128 bitów (16 bajtów) - stała |
| Długość klucza | 128 / 192 / 256 bitów |
| Liczba rund | 10 / 12 / 14 (zależnie od klucza) |
| Struktura | sieć SPN (substitution-permutation network) |
| Operacje rundy | SubBytes, ShiftRows, MixColumns, AddRoundKey |
| Trzy wersje | AES-128, AES-192, AES-256 |
AES wyróżnia się stałym blokiem 128 bitów oraz możliwością wyboru klucza o długości 128, 192 lub 256 bitów, przy czym liczba rund zależy właśnie od rozmiaru klucza. Zaproponowana hierarchia wariantów pozwala aplikacjom dobrać kompromis między szybkością a żądanym poziomem ochrony. Nawet najsłabszy wariant pozostaje przy tym poza zasięgiem ataku siłowego.
Utrzymanie stałego rozmiaru bloku upraszcza implementacje programowe oraz sprzętową akcelerację, eliminując słabości obserwowane wcześniej w konstrukcjach o blokach 64-bitowych. Dzięki delikatnej zależności liczby rund od długości klucza projektanci uzyskali równomierny margines bezpieczeństwa dla wszystkich wersji. Taki dobór parametrów stał się punktem wyjścia do licznych zaleceń dotyczących konkretnych zastosowań.
Znajomość parametrów AES należy do podstawowej wiedzy każdego inżyniera odpowiedzialnego za bezpieczeństwo systemów. Wybór konkretnej wersji algorytmu bywa jednak tylko jednym z wielu elementów całej konfiguracji ochronnej. Ta wiedza bywa również początkiem głębszych analiz, które później powracają przy ocenie innych rozwiązań kryptograficznych.
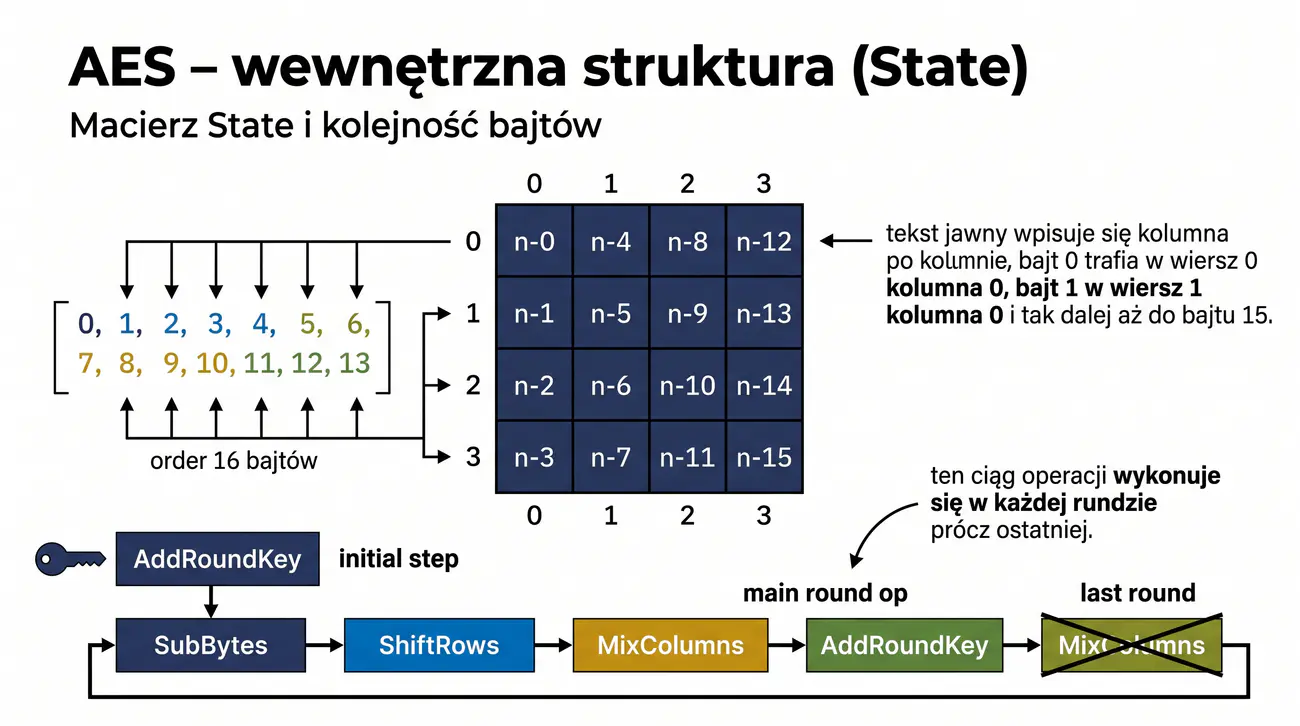
Pojęcie macierzy State porządkuje wszystkie operacje wewnętrzne AES i stanowi punkt wyjścia do opisu kolejnych rund. Blok 128 bitów dzielony jest na szesnaście bajtów wpisywanych do macierzy kolumna po kolumnie, co determinuje interpretację każdego przekształcenia. Dzięki temu same specyfikacje algorytmu można czytać w sposób jednoznaczny, bez ryzyka nieporozumień interpretacyjnych.
Ścieżka przetwarzania przewiduje wstępny XOR stanu z kluczem, a następnie serię rund, w których kolejno stosowane są podstawienie, przesunięcia i mieszanie kolumn. Ostatnia runda odbiega od pozostałych pominięciem mieszania kolumn, co nadaje całości symetryczny charakter i ułatwia odszyfrowywanie. Taka konstrukcja nie jest przypadkowa, ponieważ rozstrzyga o prostocie dowodów matematycznych.
Zrozumienie układu danych wewnątrz stanu jest niezbędne przy implementowaniu szyfru od podstaw lub przy analizie wyników pośrednich w narzędziach dydaktycznych. Częstym błędem jest przy tym polegające na myleniu kolejności bajtów w błędnie zapisanej macierzy. Analiza stanu pomaga więc odróżnić błędy interpretacji od rzeczywistych właściwości algorytmu podczas czytania specyfikacji.
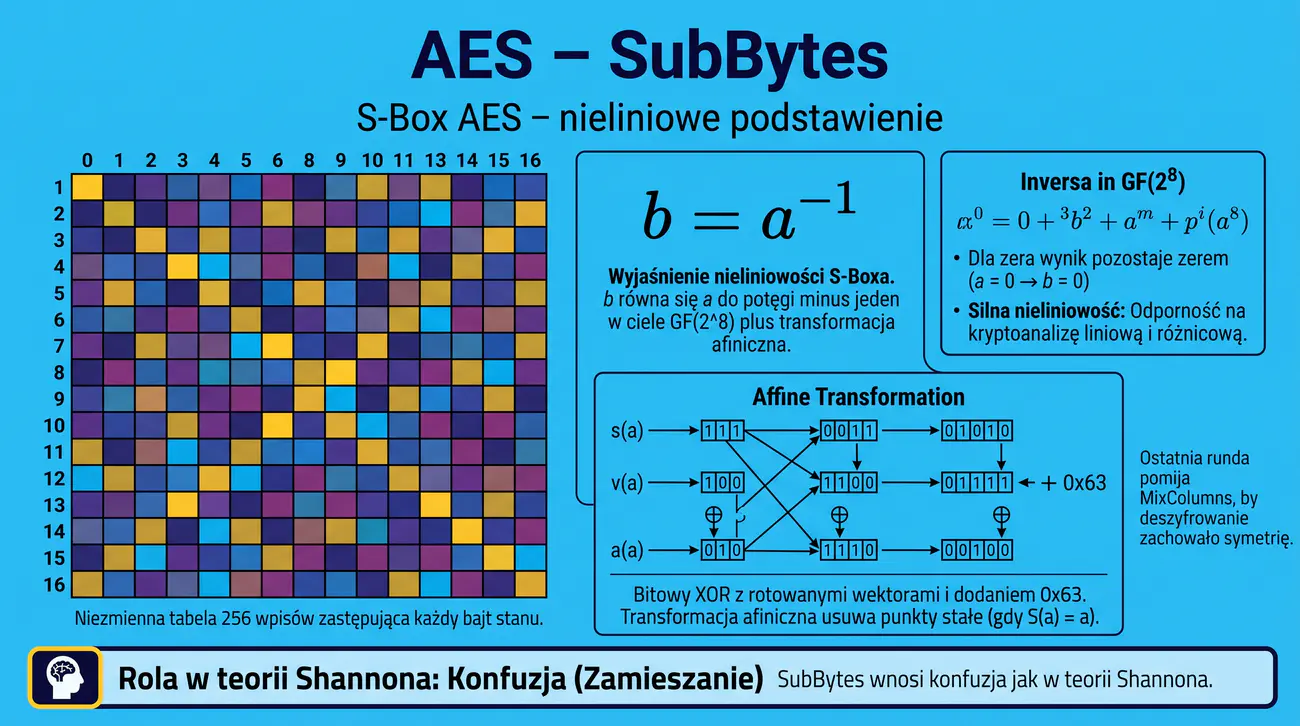
S-Box AES różni się od tabel DES użytych wcześniej tym, że ma ścisłą podstawę algebraiczną, a nie arbitralnie dobrane wpisy. Kluczowym krokiem jest obliczenie odwrotności bajtu w ciele Galois o 256 elementach, którą dla zera definiuje się osobno. Dopiero na tak uzyskanym wyniku wykonuje się transformację afiniczną z dobranym stałym składnikiem.
Tak zaprojektowane podstawienie zapewnia nieliniowość o bardzo dobrych własnościach, co minimalizuje skuteczność ataków opartych na statystykach różnicowych i liniowych. Dodatkowo transformacja afiniczna eliminuje zależności typu punkty stałe, w których bajt pozostawałby bez zmiany. Dzięki tym zabiegom S-Box AES można poddać rygorystycznej ocenie teoretycznej.
W praktyce kompletna tabela podstawień jest liczona raz podczas uruchamiania implementacji, a następnie wykorzystywana wielokrotnie w każdej rundzie. Znajomość matematycznej genezy S-Boksu ułatwia zrozumienie, dlaczego projektanci porzucili w tym miejscu prostą, zapisaną tabelę. Warto także zapamiętać, że parametry podstawienia pozostają niezmienne dla wszystkich wariantów klucza.
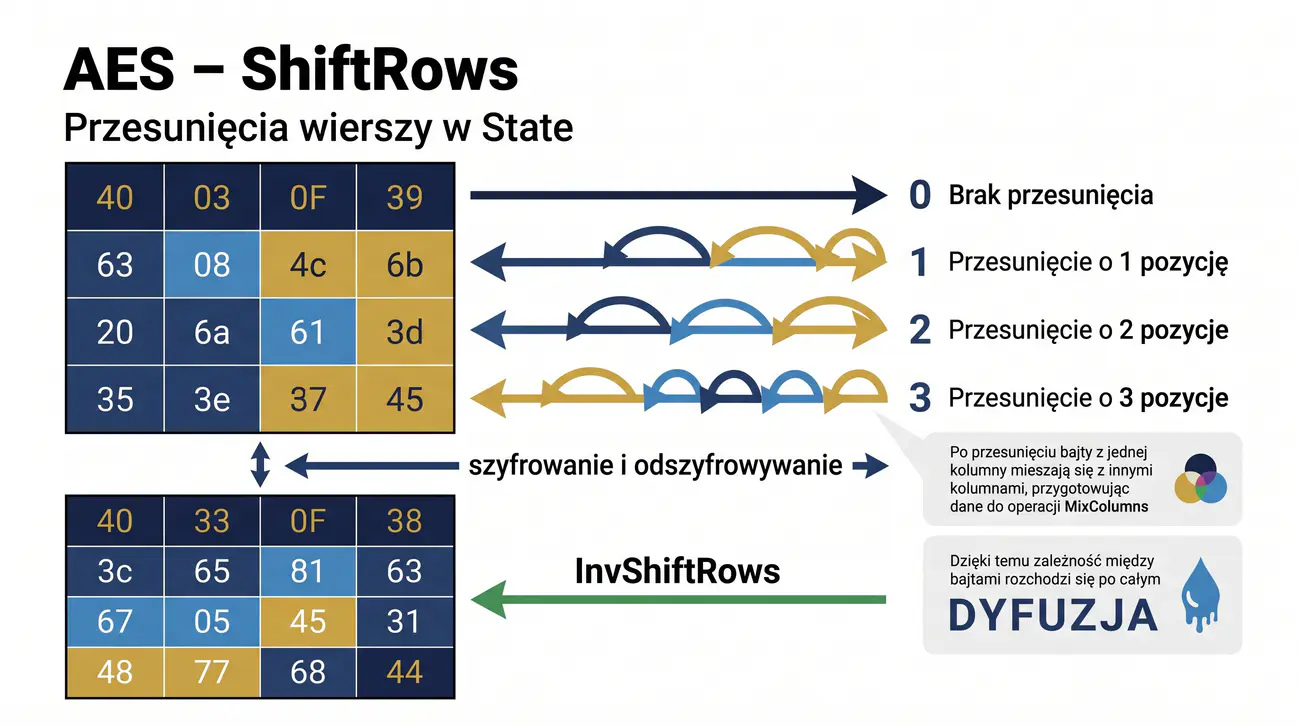
Operacja ShiftRows dokonuje cyklicznych przesunięć bajtów w obrębie wierszy macierzy State, przy czym każdy wiersz przesuwany jest o inną, ściśle określoną liczbę pozycji. Przesunięcia te przenoszą bajty pomiędzy kolumnami i tworzą warunki do pełnej dyfuzji w kolejnym kroku procesu. To właśnie dzięki nim informacja z jednego punktu bloku rozprzestrzenia się na całą jego powierzchnię.
Efekt takiego mieszania jest szczególnie istotny po połączeniu z operacją MixColumns, która wymaga aktywności wszystkich kolumn jednocześnie. Zależność między dowolnymi bajtami bloku powstaje po niewielkiej liczbie rund, co jest jedną z podstawowych własności ocenianych podczas analizy szyfru. W trakcie odszyfrowywania wykonuje się analogiczne przesunięcia w kierunku odwrotnym, co przywraca porządek bloku.
Przesunięcia dobrano tak, aby kolumny, po wymieszaniu, pozostawały w relacjach możliwych do precyzyjnego opisania matematycznego. Takie podejście uczyniło konstrukcję AES wyjątkowo podatną na formalne dowody odporności. Taka systematyczność to zresztą element charakteryzujący dobre implementacje każdego szyfru blokowego.
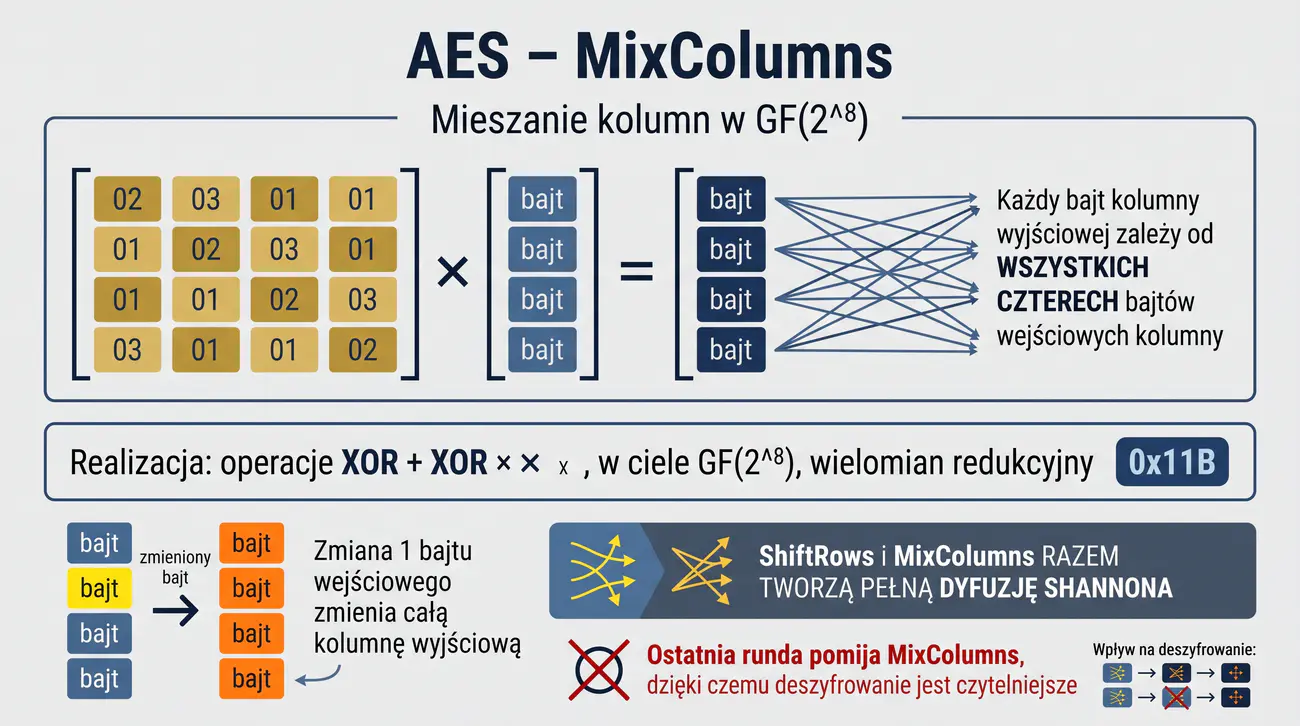
Operacja MixColumns przekształca każdą kolumnę stanu przez mnożenie przez stałą macierz w ciele Galois, dzięki czemu każdy bajt wyniku zależy od wszystkich czterech bajtów kolumny wejściowej. Arytmetyka w ciele 256 elementów pozwala przy tym zachować odwracalność przekształcenia, nie naruszając jednocześnie jego liniowości względem wskazanego ciała. Ten zabieg jest drugim, obok przesunięć wierszy, mechanizmem rozpraszania danych w szyfrze.
Wybrane współczynniki macierzy gwarantują, że zmiana niewielkiej liczby bajtów wejściowych zawsze przekłada się na zmianę odpowiednio dużej liczby bajtów wyjściowych, co określa się liczbą gałęzi przekształcenia. Właściwość ta zapewnia szyfrowi dobrą odporność na ataki grupujące modyfikacje w wąskich obszarach danych. Pominięcie MixColumns w ostatniej rundzie nie obniża poziomu bezpieczeństwa, natomiast nadaje procesowi czytelną symetrię.
Warto zwrócić uwagę, że mnożenie w ciele Galois realizowane jest we wszystkich implementacjach w identycznej, określonej w specyfikacji postaci. Dzięki temu implementacje niezależnych twórców zawsze prowadzą do identycznych wyników pośrednich. Te własności czynią z MixColumns modelowy przykład operacji rozpraszania, od którego warto zaczynać analizę nowych konstrukcji.
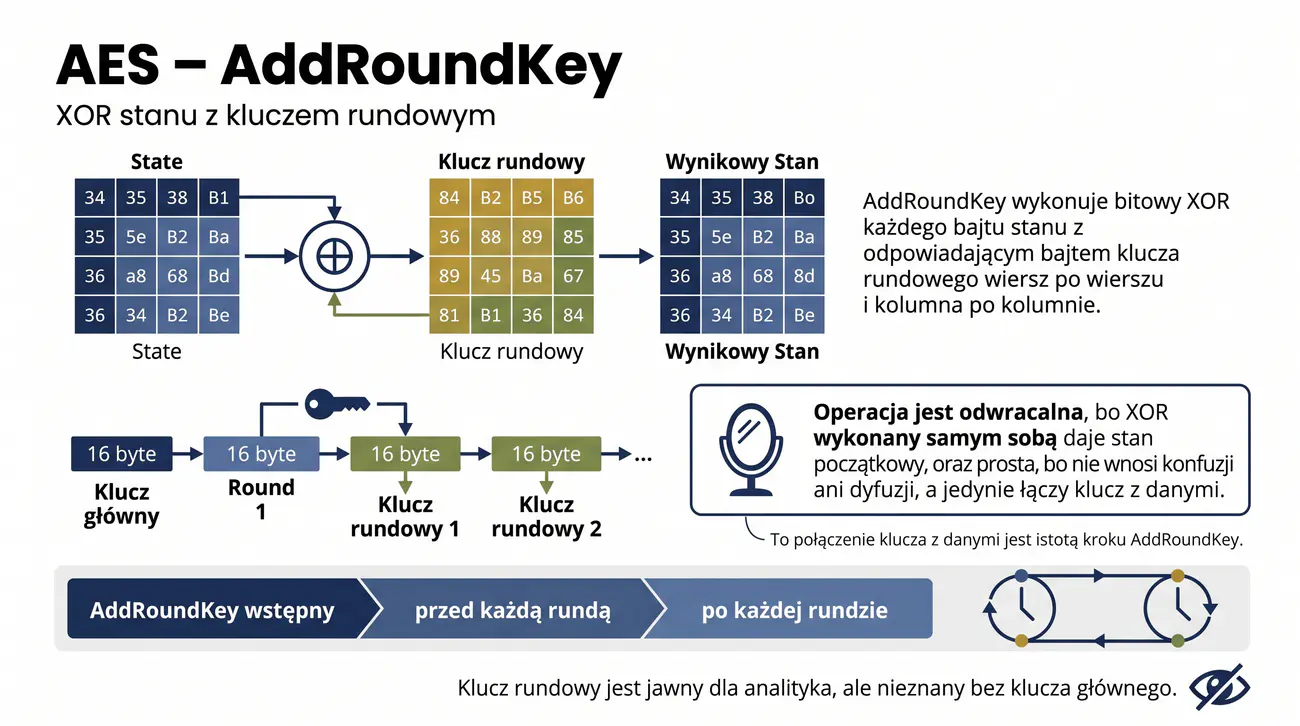
Operacja AddRoundKey łączy bieżący stan szyfru z fragmentem rozszerzonego klucza, zapewniając, by każda warstwa przekształceń była uzależniona od znajomości sekretu. Ze względu na właściwości XOR-owania operacja ta wygląda identycznie dla szyfrowania i odszyfrowywania, co eliminuje potrzebę odwrotnej arytmetyki. Nie wnosi przy tym ani nieliniowości, ani dyfuzji, pozostając prostym połączeniem danych z kluczem.
Wykonanie XOR-a przed pierwszą rundą oraz po rundzie ostatniej sprawia, że atakujący nie rozpoczyna analizy od stanu złożonego wyłącznie z danych. Klucz rundowy nie jest tajemnicą dla osoby znającej klucz główny, ale bez niego pozostaje poza zasięgiem rozumowania praktycznego. Powiązanie poszczególnych rund z różnymi fragmentami rozszerzonego klucza uniemożliwia uproszczenie algorytmu do mniejszej liczby kroków.
Krok AddRoundKey bywa uznawany za trywialny, tymczasem to właśnie on nadaje szyfrowi zależność od sekretu w każdym punkcie działania. Pozostałe operacje rundy nadają natomiast strukturę rozpraszania i konfuzji, bez których sam XOR nie zapewniłby żadnej ochrony. Zrozumienie tej współpracy operacji rundy jest zresztą istotne przy projektowaniu własnych rozwiązań opartych na AES.
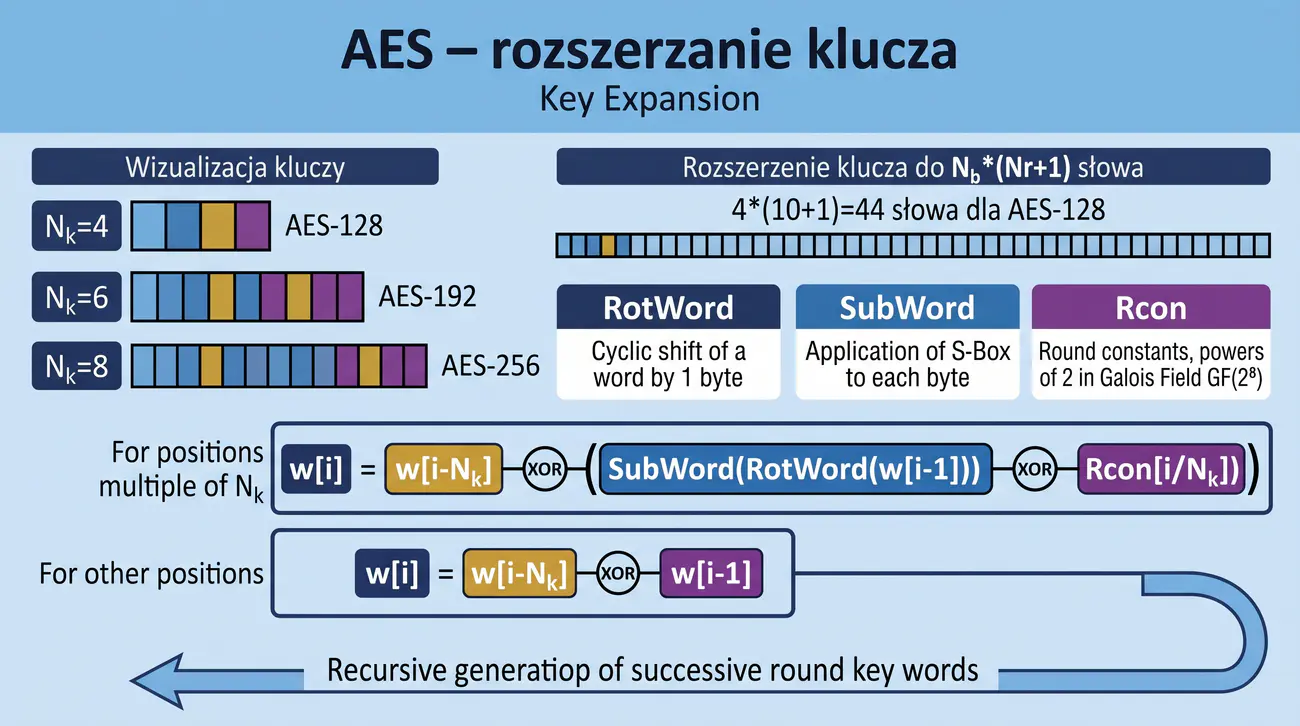
Rozszerzanie klucza przekształca klucz główny w ciąg słów potrzebnych do wykonania wszystkich rund, wyznaczając tym samym zawartość każdej operacji AddRoundKey. Stosowane funkcje pomocnicze wprowadzają do harmonogramu nieliniowość i odstępy między kolejnymi fragmentami, dzięki czemu pokrewne części klucza nie ujawniają widocznych podobieństw. Stałe rundowe dodatkowo nadają każdemu cyklowi niepowtarzalny charakter.
Rekurencyjny wzór generowania kolejnych słów sprawia, że każdy nowy wyraz zależy od kilku wcześniejszych, ale dyfuzja harmonogramu kluczy AES jest słaba, wobec czego z pojedynczego klucza rundowego (zwłaszcza ostatniego) można odtworzyć klucz główny. W zależności od długości klucza konstrukcja harmonogramu różni się szczegółami, co widać porównując warianty 128, 192 i 256-bitowe. Te różnice implementacyjne mają znaczenie przy pracy z bibliotekami wymagającymi pełnej zgodności ze specyfikacją.
Znajomość reguł rozszerzania klucza bywa pomocna również wtedy, gdy bada się, czy dany fragment klucza rundowego nie zdradza informacji o kluczu głównym. Analiza taka należy do standardowych kroków oceny bezpieczeństwa nowego szyfru. Znajomość szczegółów harmonogramu przydaje się także przy weryfikowaniu poprawności działania bibliotek kryptograficznych.
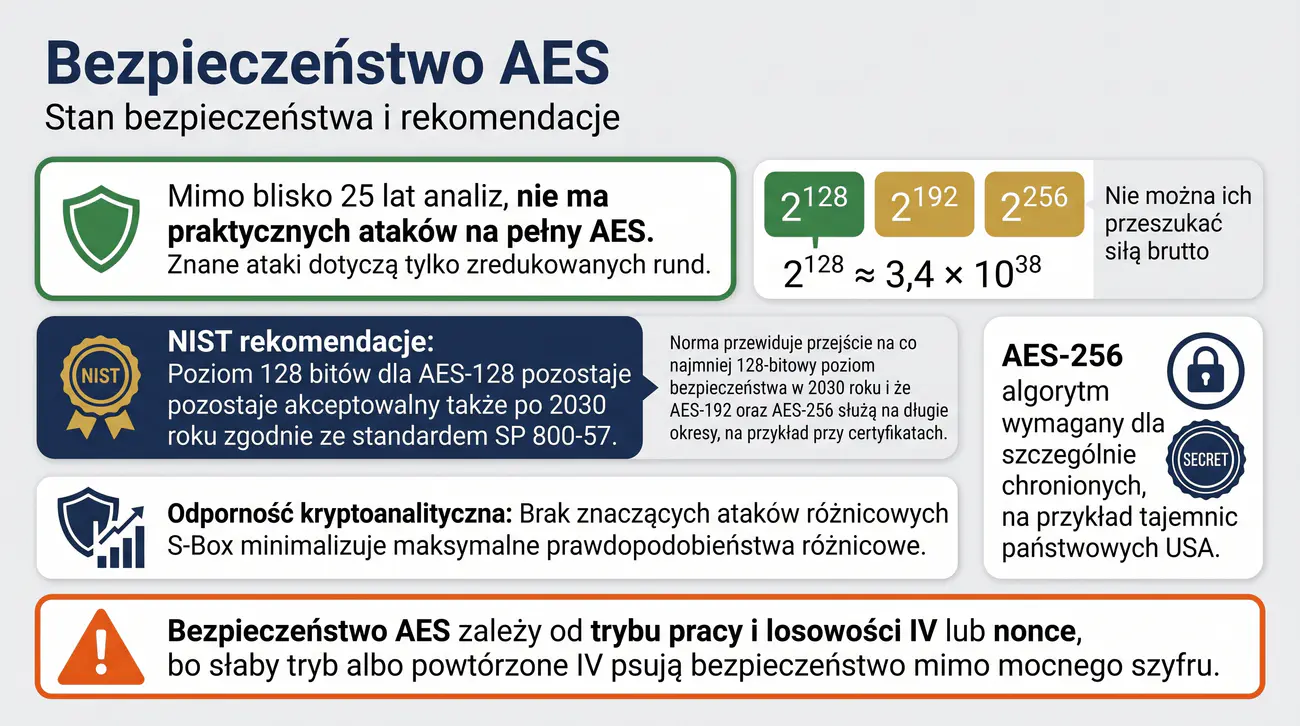
Po ponad dwóch dekadach badań nie opublikowano praktycznego ataku na pełny AES, a wszystkie znane metody dotyczą wyłącznie wariantów o zredukowanej liczbie rund. Dostępna przestrzeń kluczy nawet dla wersji 128-bitowej leży poza zasięgiem realnych obliczeń, co czyni ten algorytm jednym z najlepiej zbadanych w historii. Ta stabilność sprawia, że AES stanowi domyślny punkt odniesienia w większości systemów komercyjnych i administracyjnych.
Większość realnych zagrożeń związanych z AES wynika z błędów użytkowania, takich jak niewłaściwe tryby pracy czy ponowne użycie wektorów startowych, a nie z samej struktury szyfru. Wspomniane na slajdzie zalecenia NIST porządkują poziomy bezpieczeństwa zależnie od cyklu życia danych, przyjmując poziom 128 bitów jako dopuszczalny dla standardowych zastosowań. Dla materiałów o bardzo długim okresie ważności proponowane są warianty o dłuższych kluczach.
Należy przy tym odróżnić siłę samego algorytmu od trudności całego zadania ochrony danych, obejmującego także klucze, hasła i protokoły. Kompetentny specjalista ocenia zawsze cały system, a nie wyłącznie wybrany element. Dobre nawyki dotyczące całości systemu pozostają przy tym najważniejszym składnikiem bezpieczeństwa niezależnym od wyboru rodziny algorytmów.
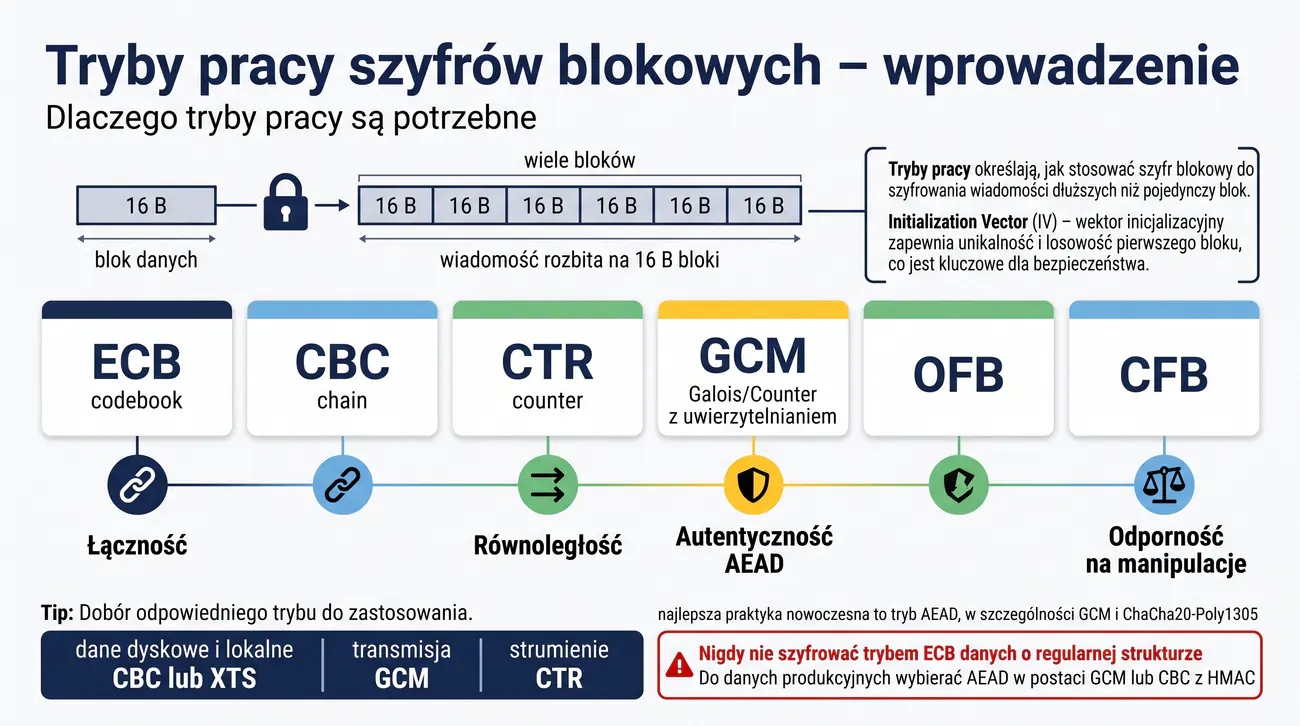
Tryby pracy rozwiązują fundamentalny problem poradzenia sobie z danymi dłuższymi niż pojedynczy blok i definiują rolę wektora inicjalizującego. Zapewniają także, że identyczne fragmenty wiadomości nie dadzą identycznego szyfrogramu, co byłoby niepożądane w poufnym przekazie. Wybór trybu przesądza więc o wielu praktycznych właściwościach całego systemu.
Tryby różnią się możliwością równoległego przetwarzania, sposobem propagacji błędów oraz zdolnością do uwierzytelniania komunikatów. Niektóre z nich, jak tryb GCM, łączą szyfrowanie z ochroną integralności, tworząc nadrzędną klasę rozwiązań nazywanych AEAD. Inne wymagają doposażenia w osobne mechanizmy kontroli spójności.
Przy doborze trybu do zastosowania liczą się zarówno warunki techniczne, jak i model zagrożeń, a także możliwości platformy docelowej. Znajomość tych cech pozwala uniknąć szkodliwych konfiguracji dostępnych w bibliotekach i narzędziach administracyjnych. Docelowe uzupełnienie tej wiedzy przynoszą kolejne slajdy poświęcone poszczególnym trybom pracy.
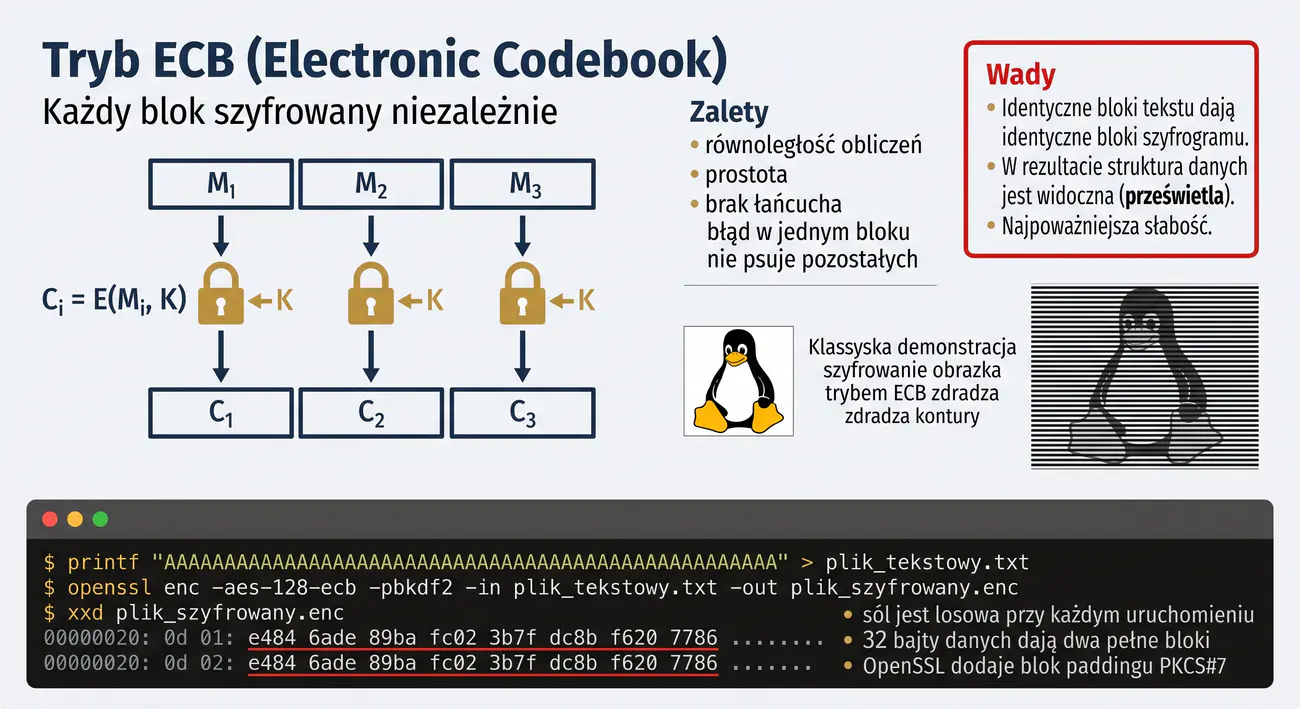
$ printf 'AAAAAAAABBBBBBBBAAAAAAAABBBBBBBB' > plik.txt $ openssl enc -aes-128-ecb -pbkdf2 -S 3ae3dae0747fa8c9 -in plik.txt -out plik.enc -pass pass:haslo $ xxd plik.enc 00000000: 5361 6c74 6564 5f5f 3ae3 dae0 747f a8c9 Salted__:...t... 00000010: e484 6ade 89ba fc02 3b7f dc8b f620 7786 ..j.......... 00000020: e484 6ade 89ba fc02 3b7f dc8b f620 7786 ..j.......... 00000030: 337c 919f 1d5a c7bb b71b 2e0e 3ce1 4f1e 3|...Z......<.O. # dwa identyczne bloki tekstu jawnego -> dwa identyczne bloki # szyfrogramu (obszar e484...7786 powtórzony); sól 3ae3dae0747fa8c9 # jest wymuszona flagą -S, bo inaczej jest losowa przy każdym uruchomieniu # 32 B danych = 2 pełne bloki, więc OpenSSL dopisuje jeszcze blok # paddingu PKCS#7 - czwarty wiersz (00000030)
Tryb ECB, najprostszy z istniejących, szyfruje każdy blok całkowicie niezależnie i nie ukrywa powtarzających się fragmentów tekstu. Identyczne porcje danych jawnych dają identyczne porcje szyfrogramu, co bywa dostrzegalne gołym okiem na regularnych danych wizualnych. Taka właściwość jest z punktu widzenia poufności nie do zaakceptowania w praktycznych systemach.
Ponieważ bloki nie są ze sobą powiązane, napastnik może również dowolnie zamieniać lub powielać całe porcje szyfrogramu, nie wywołując przy tym żadnych oznak nieprawidłowości. Szyfrowanie w trybie ECB nie daje zatem odbiorcy żadnej wskazówki dotyczącej manipulacji danymi. Z tych przyczyn tryb ten spotyka się w dokumentacji jedynie jako ostrzegawczy przykład lub element eksperymentów dydaktycznych.
Studenci często koncentrują się na poznaniu właściwości matematycznych szyfru i zapominają o cechach trybu pracy, które w praktyce są równie ważne. Demonstracja z obrazem szyfrowanym w trybie ECB dostarcza najprostszego dowodu tej zależności. Warto przy tym zapamiętać, że nawet pozornie drobna decyzja o trybie pracy potrafi zniweczyć poufność danych.
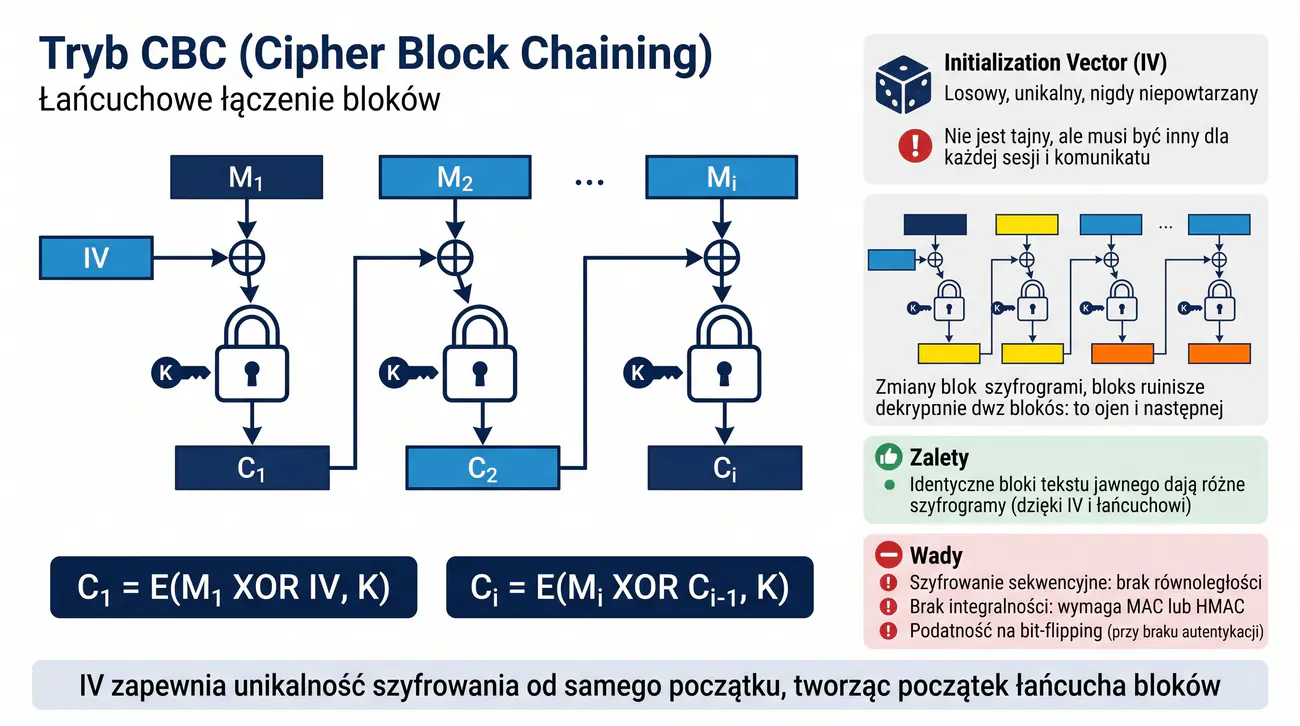
Tryb CBC wprowadza łańcuch, w którym każdy blok tekstu jest XOR-owany z poprzednim blokiem szyfrogramu, a pierwszy blok łączy się z wektorem inicjalizacyjnym. Dzięki temu identyczne części wiadomości dają różne porcje szyfrogramu, o ile zmienia się materiał wejściowy. Łańcuch wymusza jednak sekwencyjne przetwarzanie danych w kierunku szyfrowania.
Wektor inicjalizacyjny nie musi pozostać tajny, ale musi być nieprzewidywalny i nie może się powtarzać pomiędzy sesjami i komunikatami. Naruszenie tych zasad prowadzi do odtworzenia części danych lub do powstawania wzorców ułatwiających kryptoanalizę. Osobny problem stanowi brak wbudowanego uwierzytelniania, przez co sam tryb nie wykrywa celowych modyfikacji.
W praktyce CBC bywa łączony z niezależnym mechanizmem kontroli integralności, na przykład z kodem HMAC, co tworzy bezpieczniejszą całość. Zalecenia instytucji normalizacyjnych kierują jednak nowe wdrożenia na tryby typu AEAD, które łączą poufność z uwierzytelnianiem w jednej konstrukcji. Ten obraz domyka zbiór zasad, które należy stosować przy każdej konfiguracji używającej trybów łańcuchowych.
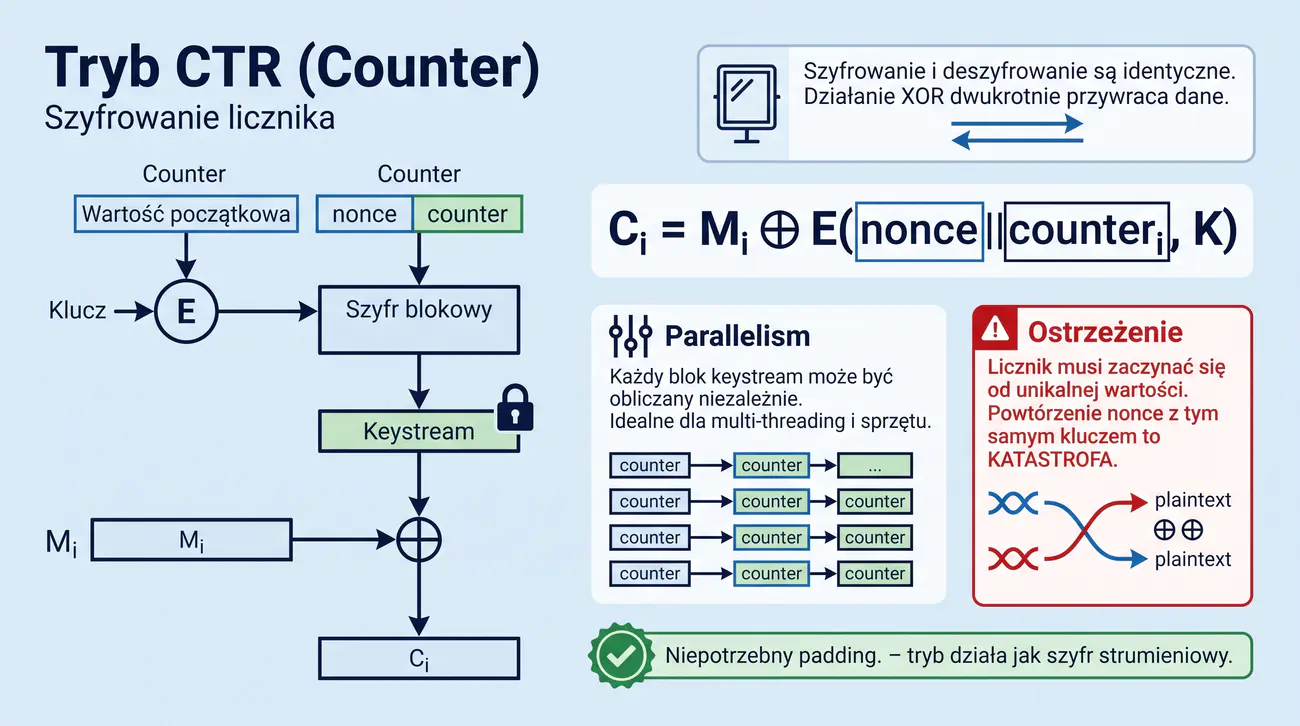
Tryb licznikowy zamienia szyfr blokowy w praktyczny szyfr strumieniowy, szyfrując kolejne wartości licznika i XOR-ując otrzymany strumień klucza z danymi. Ponieważ szyfrowanie i odszyfrowywanie wykonują identyczne operacje, ten sam fragment kodu obsługuje oba kierunki przekazu. Brak łańcucha umożliwia równoległe wyznaczanie kolejnych bloków strumienia klucza.
Równoległość oraz brak dopełniania bloków czynią tryb CTR atrakcyjnym dla szybkich transmisji i zastosowań sprzętowych. Warunkiem bezpieczeństwa jest jednak niepowtarzalność wartości początkowej licznika, czyli nonce, dla każdego komunikatu. Powtórzenie strumienia klucza prowadzi do XOR-a dwóch tekstów jawnych, co pozwala doświadczonemu analitykowi odtworzyć ich treść.
Właśnie ta wrażliwość na ponowne użycie licznika zbliża tryb CTR do klasycznych szyfrów strumieniowych i wymaga starannego zarządzania wartościami startowymi. Współczesne tryby typu AEAD budowane na bazie licznika zawierają te same ostrzeżenia w instrukcji obsługi. Identyczna wrażliwość występuje również w innych trybach strumieniowych, co warto zawsze uwzględniać przy projektowaniu nowych mechanizmów.
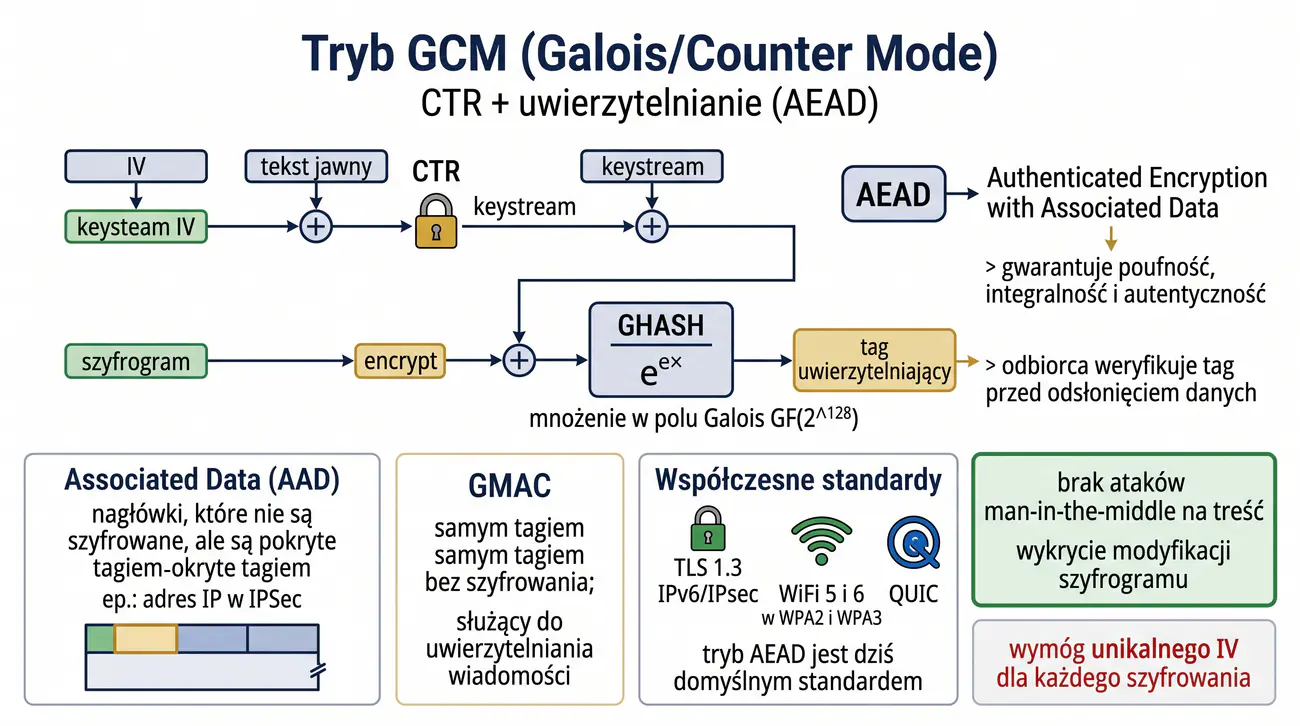
Tryb GCM łączy szyfrowanie licznikowe z obliczaniem kodu uwierzytelniającego w ciele Galois, dostarczając w jednej konstrukcji poufność, integralność i autentyczność. Dane dodatkowe, takie jak nagłówki pakietów, mogą pozostawać jawne, a mimo to są wiązane z tagiem uwierzytelniającym. Taka konstrukcja zaliczana jest do klasy rozwiązań AEAD, w której szyfrowanie idzie w parze z uwierzytelnianiem.
Niewielki narzut obliczeniowy i naturalna zdolność do równoległości sprawiły, że GCM wybrano jako domyślne rozwiązanie w wielu protokołach, w tym w TLS 1.3 i nowych standardach sieci bezprzewodowych. Odbiorca weryfikuje tag przed przystąpieniem do dalszego przetwarzania, co wyklucza ataki polegające na podstawieniu zmodyfikowanego szyfrogramu. Od strony praktycznej istotne jest również rozróżnienie między szyfrowaniem danych a uwierzytelnianiem danych jawnych.
Szczególnego znaczenia nabiera unikalność wektora startowego, ponieważ jego powtórzenie umożliwia odtworzenie klucza używanego do tworzenia tagów. Takie naruszenie całkowicie zmienia status bezpieczeństwa systemu mimo pozornie mocnego szyfru. Z tego względu zarządzanie wektorami startowymi uznaje się za jeden z ważniejszych punktów kontrolnych audytu.
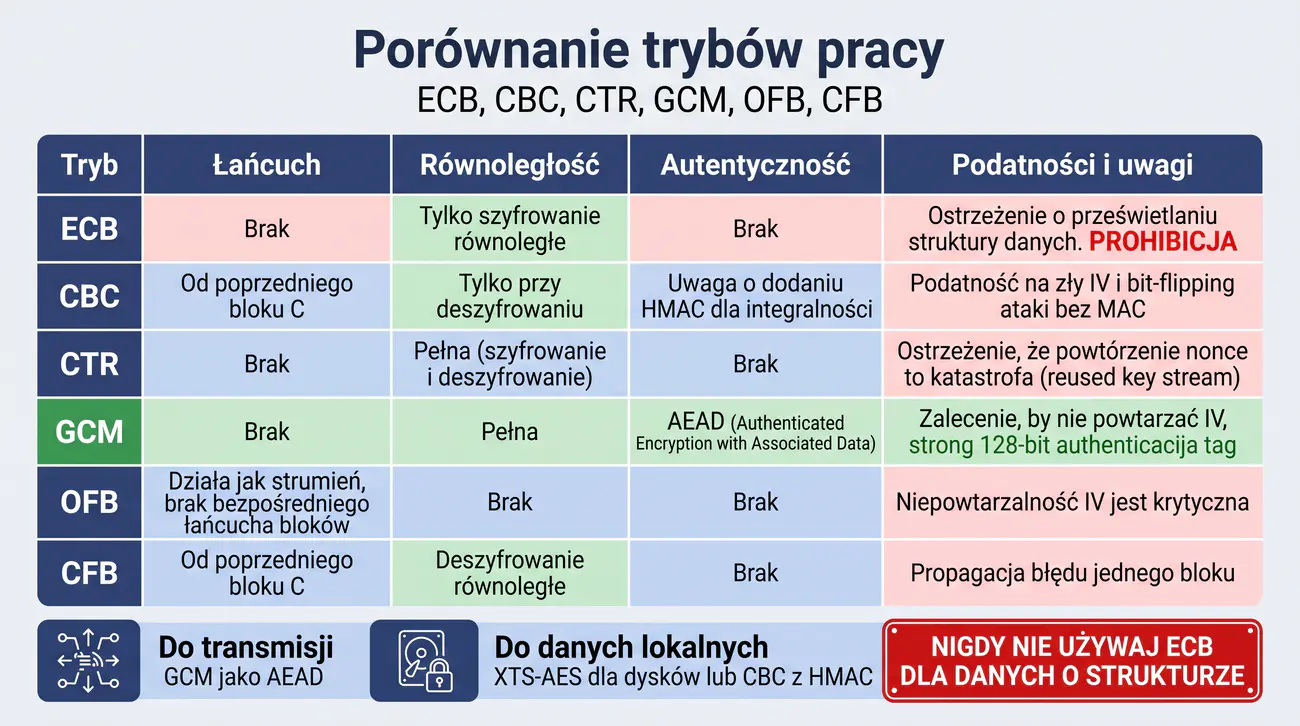
| Tryb | Łańcuch | Równoległość | Autentyczność | Podatności / uwagi |
|---|---|---|---|---|
| ECB | brak | tak | nie | prześwietlanie struktury - NIE STOSOWAĆ |
| CBC | tak (poprzedni C) | tylko deszyfr | nie (dodaj HMAC) | zły IV/bit-flipping bez MAC |
| CTR | brak | tak | nie | powtórzenie nonce = katastrofa |
| GCM | brak | tak | tak (AEAD) | nie powtarzaj IV! silny 128-bitowy tag |
| OFB | sprzężenie wyjściowe | nie | nie | brak propagacji błędu w szyfrogramie; powtórzenie IV |
| CFB | tak (poprzedni C) | tylko deszyfr | nie | błąd propagacji 1 blok; poufność, brak integralności |
Rekomendacje praktyczne: do transmisji - GCM (AEAD); do danych lokalnych - XTS-AES (dyski) lub CBC+HMAC; nigdy ECB dla danych o strukturze.
Zestawienie trybów pracy porządkuje wiedzę według trzech kluczowych kryteriów: sposobu łączenia bloków, możliwości równoległości oraz obecności uwierzytelniania. Obecność i brak łańcucha z góry rozstrzygają o zachowaniu szyfrogramu w przypadku błędów przesyłu. Autentyczność z kolei przesądza o tym, czy odbiorca dostrzeże próby manipulacji treścią.
Z tabeli wynika praktyczna zasada, zgodnie z którą komunikację przesyłaną w sieci zabezpiecza się trybami typu AEAD, a dane przechowywane lokalnie, zwłaszcza na dyskach, chroni się konstrukcją zaprojektowaną z myślą o całych sektorach. Klasyczne tryby wymagające osobnych mechanizmów kontroli integralności nie są już pierwszym wyborem dla nowych systemów. Znajomość tych zależności umożliwia świadomą ocenę konfiguracji spotykanych w dokumentacji narzędzi administracyjnych.
CFB wiąże kolejne bloki poprzednim blokiem szyfrogramu, natomiast OFB tworzy jedynie sprzężenie wyjściowe strumienia klucza i nie propaguje błędów w szyfrogramie. Najczęstszym błędem popełnianym w praktyce jest dobór trybu ECB do danych o strukturze regularnej, co można wykryć już podczas zwykłego przeglądu konfiguracji. Umiejętność szybkiego odczytania zależności z tabeli porównawczej bywa przydatna podczas audytów bezpieczeństwa. Taka demonstracja bywa zresztą standardowym elementem szkoleń z bezpieczeństwa aplikacji.
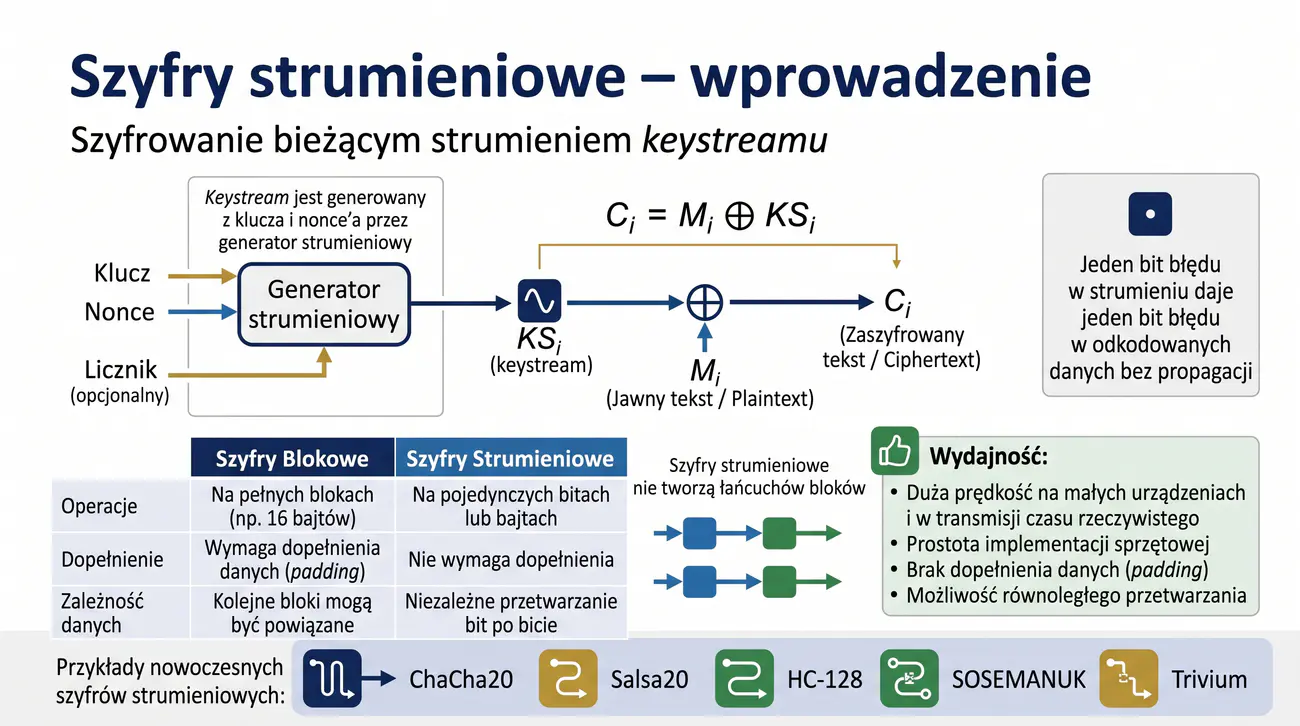
Szyfry strumieniowe przetwarzają dane porcjami pojedynczych bajtów lub bitów, korzystając z ciągłego strumienia klucza i operacji XOR. Taki mechanizm nie wymaga dopełniania bloków ani stosowania łańcucha, dzięki czemu sprawdza się w przekazach przychodzących stopniowo. Właśnie dlatego bywa wybierany w rozwiązaniach pracujących w czasie rzeczywistym.
Związek między szyframi strumieniowymi a blokowymi nie ma charakteru konkurencji, lecz komplementarności, ponieważ część trybów pracy przekształca szyfry blokowe w struktury strumieniowe. Umożliwia to łączenie zalet obu rodzin przy zachowaniu dobrze zbadanych właściwości podstawowej konstrukcji. Wybór rodziny algorytmów zależy przede wszystkim od platformy oraz wymagań dotyczących opóźnień i przepustowości.
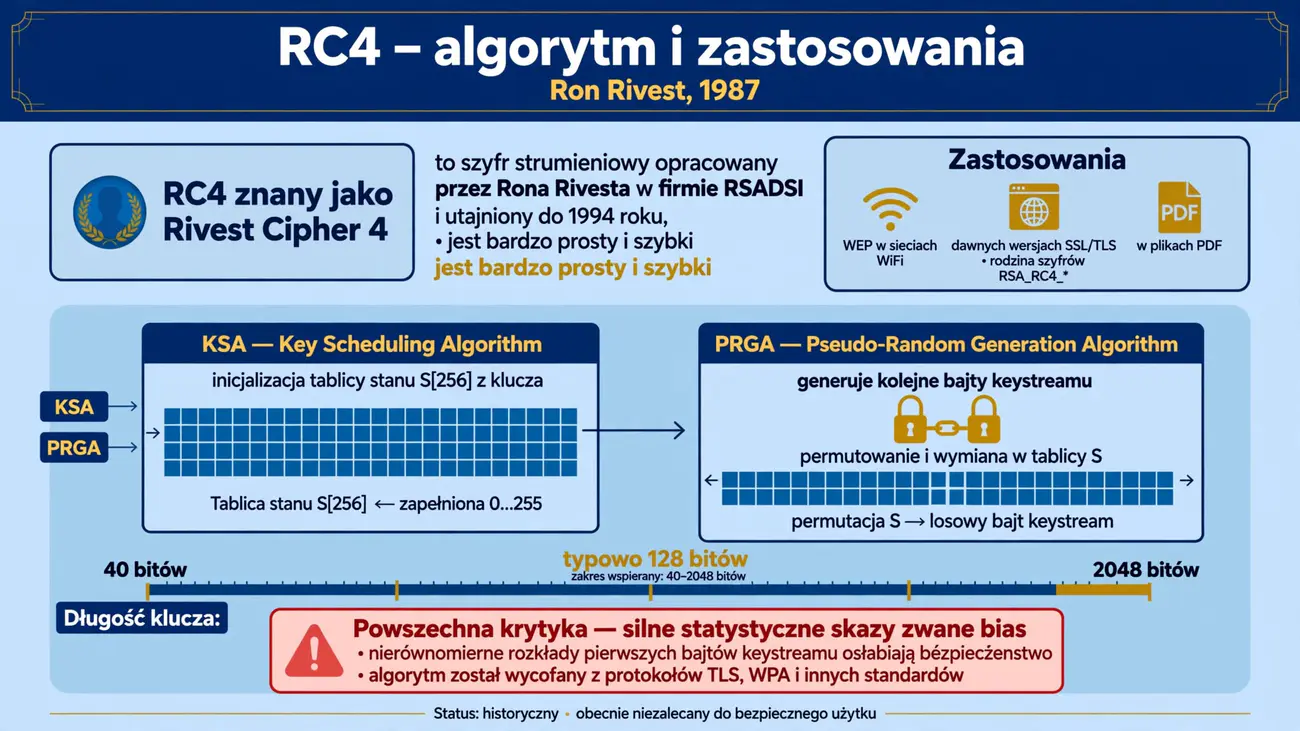
Bezpieczeństwo szyfrów strumieniowych opiera się na jakości generatora strumienia klucza oraz na niepowtarzalności wartości startowych. Historia RC4 pokazuje, że nawet prosty i szybki generator może zawierać kosztowne skazy statystyczne. Umiejętność rozpoznania rodziny szyfru po jego zachowaniu przydaje się w codziennej pracy administratora.
RC4 zdobył popularność dzięki niezwykłej prostocie, krótkiej liczbie operacji wykonywanych na bajt oraz łatwości implementacji w nawet skrajnie ograniczonych środowiskach. Algorytm składa się z inicjalizacji tablicy stanu oraz pętli generującej kolejne wartości strumienia klucza. Cała trudność zadania kryje się w tajemnicy klucza i sposobie jego przemieszania w fazie startowej.
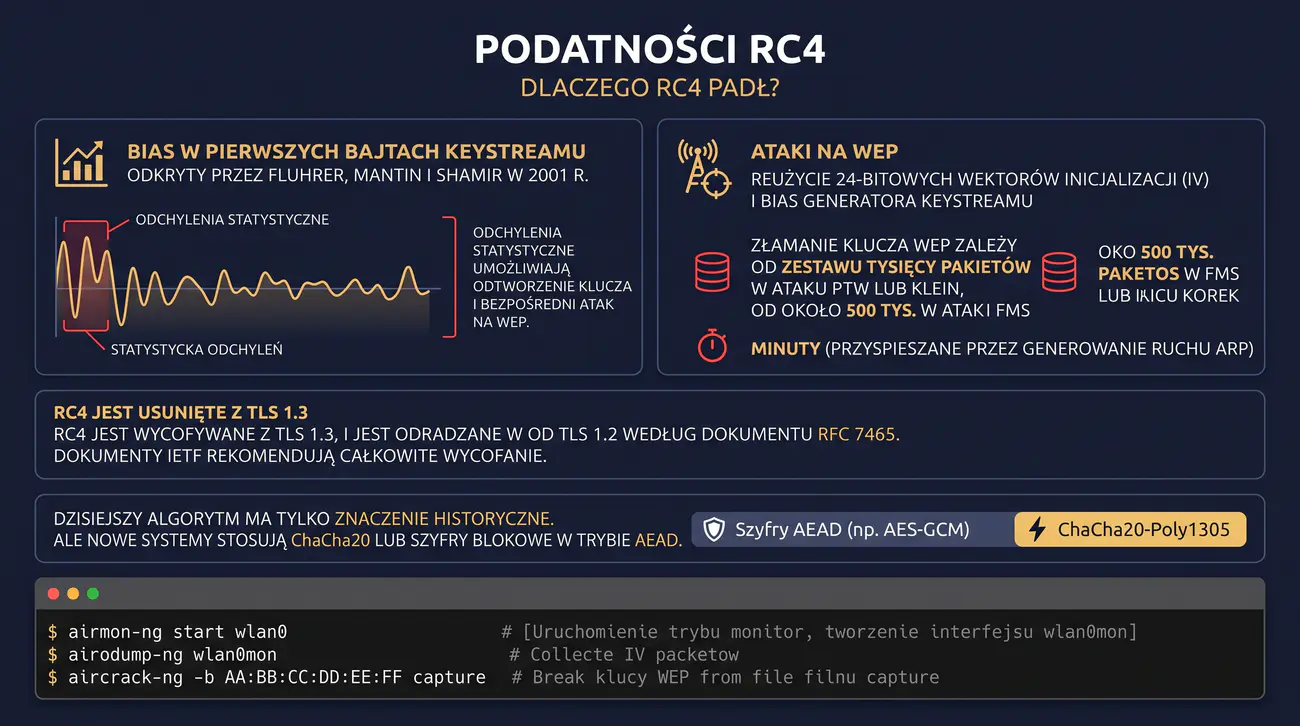
Mimo technicznej elegancji RC4 przez całe lata istnienia obarczony był drobnymi odchyleniami statystycznymi strumienia klucza, które stopniowo wykorzystywano w kolejnych atakach. Protokoły opierające się na tym szyfrze, poczynając od WEP, stykały się z zagrożeniami, których pojedyncza zmiana parametryczna nie mogła już wyeliminować. Rozwiązania strumieniowe projektowane później uwzględniały właśnie potrzebę usunięcia tych skaz.
Z perspektywy dydaktycznej RC4 pozostaje wygodnym punktem odniesienia do przedstawienia ogólnej budowy szyfrów strumieniowych. Jego prosta implementacja dobrze ilustruje także różnicę między generatorami pamięciowymi a konstrukcjami opartymi na permutacjach. Znajomość tego przykładu pozwala zarazem docenić, dlaczego nowoczesne szyfry strumieniowe są projektowane z myślą o losowości wyników.
$ airmon-ng start wlan0 # monitor mode (tworzy np. wlan0mon) $ airodump-ng wlan0mon # zbieranie pakietów (IV) $ aircrack-ng -b AA:BB:CC:DD:EE:FF capture.cap # złamanie WEP
Analizy RC4 prowadzone przez wiele lat ujawniały systematyczne odchylenia w pierwszych bajtach strumienia klucza, a także subtelne skazy w dalszej części generowanych danych. W kontekście sieci bezprzewodowych krótkie, powtarzalne wektory inicjalizacyjne protokołu WEP dawały napastnikowi materiał do odtworzenia klucza w czasie rzędu minut. Łamanie sieci wspierane narzędziami automatyzującymi zbieranie pakietów stało się przy tym zadaniem dostępnym dla szerokiego grona użytkowników.
Skażone strumienie klucza nie pozostały obojętne także dla szyfrowania transportowego, dlatego zalecenia i doświadczenia związane z TLS doprowadziły do formalnej rezygnacji z szyfru RC4. Zdarzenie to należy do najlepiej udokumentowanych przykładów powolnej detronizacji stosowanego rozwiązania. Nowe konstrukcje strumieniowe oraz tryby AEAD zostały przebadane pod kątem właśnie tych zagrożeń.
Najważniejszy jest wniosek, że prostota algorytmu bywa złudna, a o jego bezpieczeństwie rozstrzygają subtelne właściwości statystyczne. Szczegółowa analiza RC4 dostarcza jednocześnie narzędzi pojęciowych przydatnych przy ocenie każdego generatora strumienia klucza. Dzięki tej analizie można samodzielnie ocenić, czy oferowane przez producentów szyfrowanie opiera się na przebadanych rozwiązaniach.
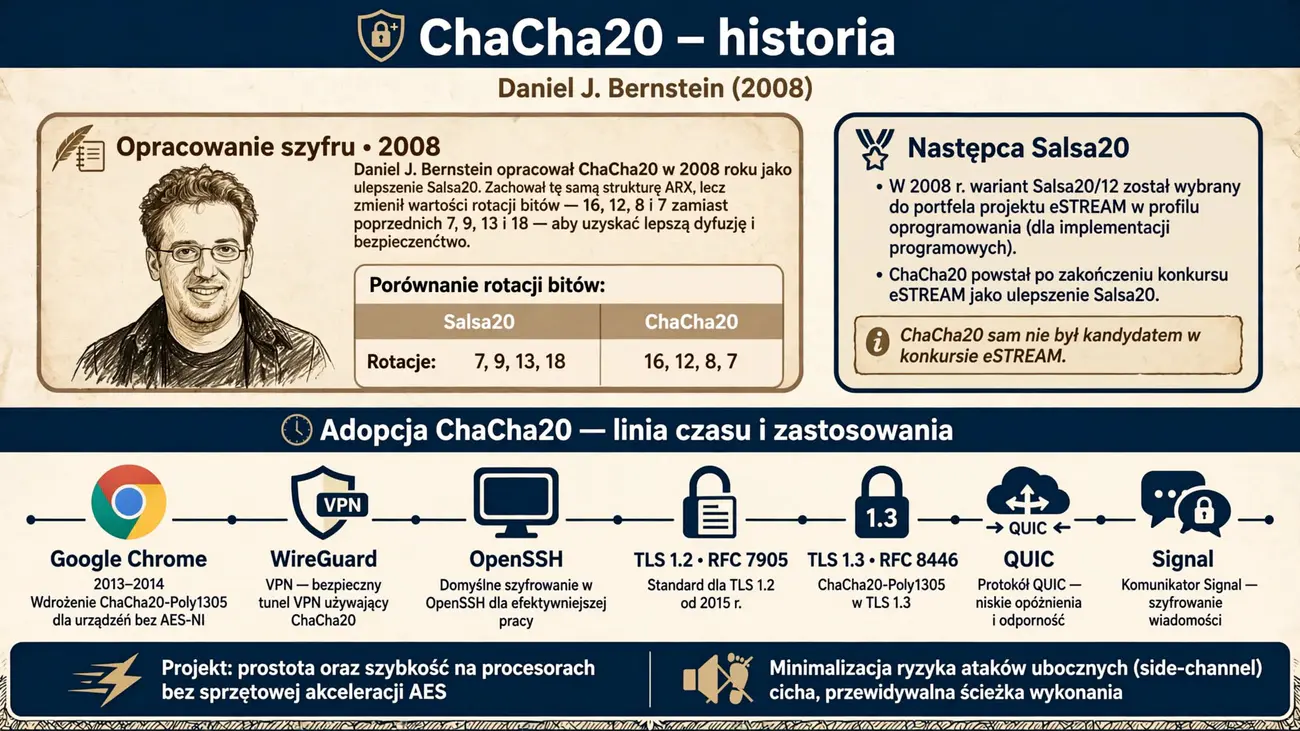
ChaCha20 powstał jako rozwinięcie wcześniejszej rodziny Salsa20 i od początku był projektowany z myślą o prostocie, szybkości oraz odporności na ataki zależne od czasu wykonania. Autor położył przy tym nacisk na jednolite działanie na procesorach ogólnego przeznaczenia, bez wymogu wsparcia sprzętowego. Taka filozofia sprawiła, że algorytm stał się naturalnym kandydatem dla urządzeń mobilnych i wbudowanych.
Z czasem ChaCha20, wraz z uzupełniającym go kodem uwierzytelniającym, trafił do protokołów o kluczowym znaczeniu dla współczesnej komunikacji internetowej. Szerokie wdrożenie w TLS, sieciach VPN i systemach wymiany wiadomości potwierdziło jego praktyczne zalety. Niezależna od AES konstrukcja daje projektantom protokołów dodatkowy wybór tam, gdzie architektura sprzętowa faworyzuje jedno z tych rozwiązań.
Istotne jest zrozumienie, że młodszy algorytm nie musi być gorszy, a racje wyboru leżą w specyfice miejsca zastosowania. Protokoły negocjujące warianty szyfrowania pozwalają stronom dopasować algorytm do własnych możliwości. Dzięki tej historii łatwiej zrozumieć również, że o wartości algorytmu decydują nie tylko parametry, lecz także kontekst jego wdrożenia.
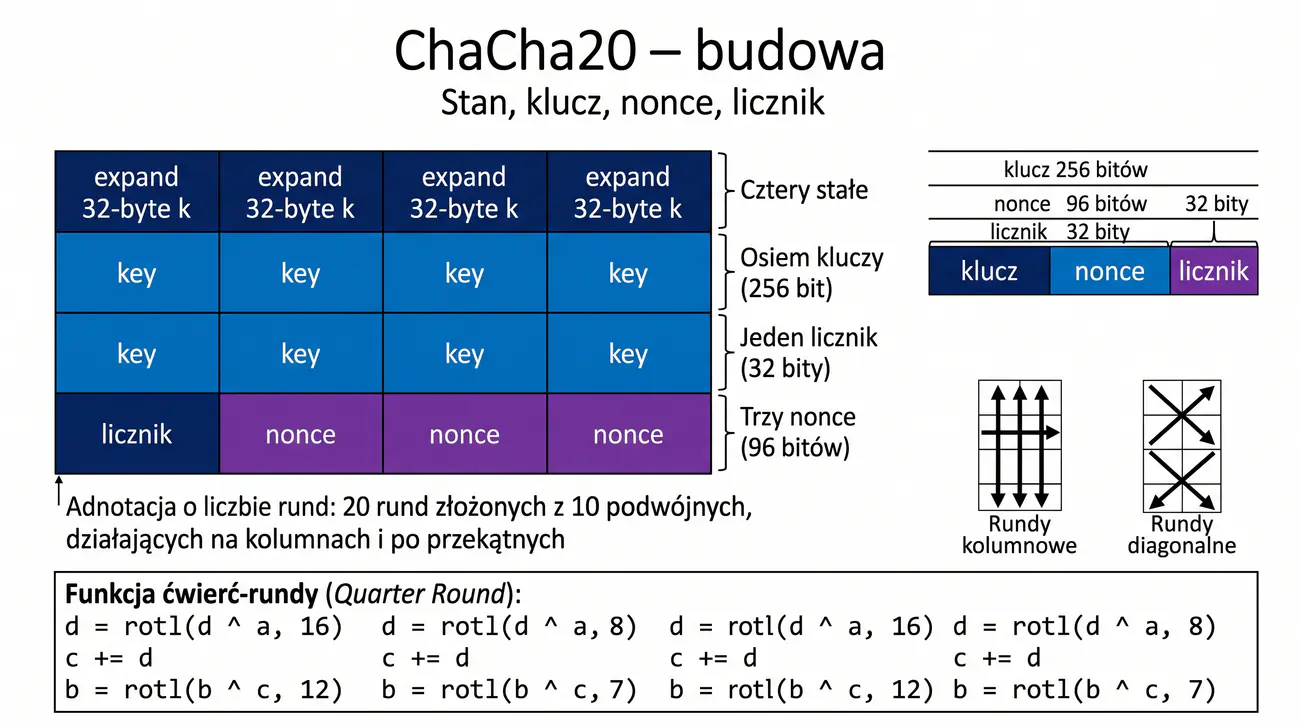
Stan roboczy ChaCha20 ma postać macierzy szesnastu słów, w której znajdują się stałe, klucz, licznik i wartość startowa. Podstawowa jednostka obliczeniowa, nazywana rundą ćwiartkową, łączy dodawanie, operację XOR oraz rotacje o dobrane liczby bitów. Dziesięciokrotne powtórzenie przekształceń na kolumnach i przekątnych daje razem dwadzieścia rund pełnego procesu.
Dobór operacji eliminuje potrzebę mnożenia lub dużych tabel, dzięki czemu implementacja pozostaje zwarta i łatwo poddaje się niezależnej weryfikacji. Właśnie ta prostota i przewidywalność wykonania sprawiają, że algorytm jest odporny na ataki czasowe na wielu platformach. Każda zmiana jednego słowa stanu rozprzestrzenia się na całą macierz już po kilku rundach.
Zrozumienie układu macierzy jest niezbędne przy ręcznym śledzeniu przykładów lub przy pisaniu własnych implementacji. Kolejność słów, jak i wartości stałe, precyzyjnie określa dokument RFC, co gwarantuje zgodność między implementacjami. Ten sam porządek macierzy stosowany jest w całej rodzinie ChaCha, co ułatwia przenoszenie wiedzy między wariantami.
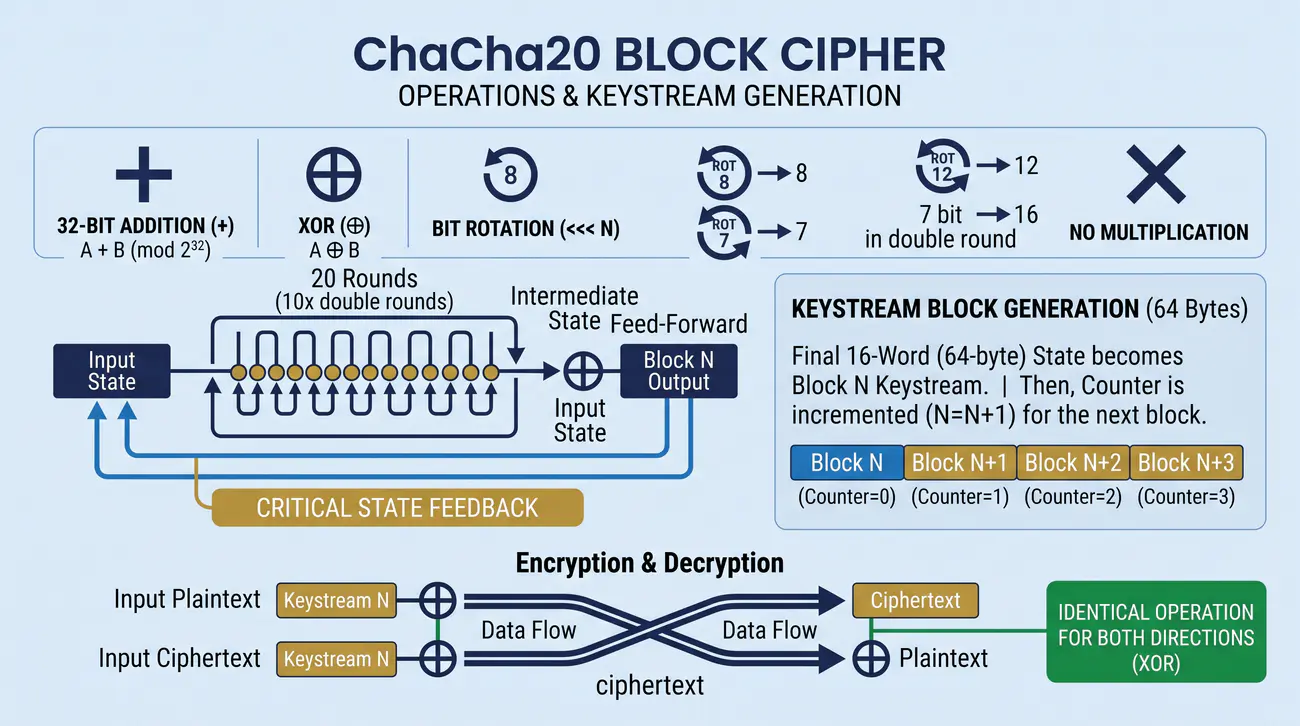
Blok wyjściowy ChaCha20 powstaje przez dodanie stanu sprzed przekształceń do stanu po dwudziestu rundach, co nadaje wynikowi pełną zależność od wszystkich danych wejściowych. Sześćdziesięcioczterobajtowy fragment strumienia klucza odpowiada przy tym jednemu blokowi, a zwiększenie licznika pozwala wygenerować kolejne porcje strumienia klucza. Taki mechanizm przypomina budowę szyfrów blokowych używanych w trybie licznikowym.
Ta sama funkcja generowania strumienia obsługuje zarówno szyfrowanie, jak i odszyfrowywanie, gdyż obie strony operują identycznym strumieniem klucza. Różnica sprowadza się wyłącznie do kolejności XOR-owania danych, co nie wymaga rozdzielnych procedur. Z tego powodu implementacje ChaCha20 są szczególnie zwarte i łatwe do przeniesienia na różne języki programowania.
Warto przy tym pamiętać, że o ile operacja XOR jest odwracalna, o tyle samo generowanie strumienia klucza pozostaje jednokierunkowe bez znajomości klucza. Stan wewnętrzny nie ujawnia zatem informacji umożliwiających odtworzenie tekstu. Z praktycznego punktu widzenia korzystna jest też możliwość łatwego testowania poszczególnych bloków strumienia w debuggerach.
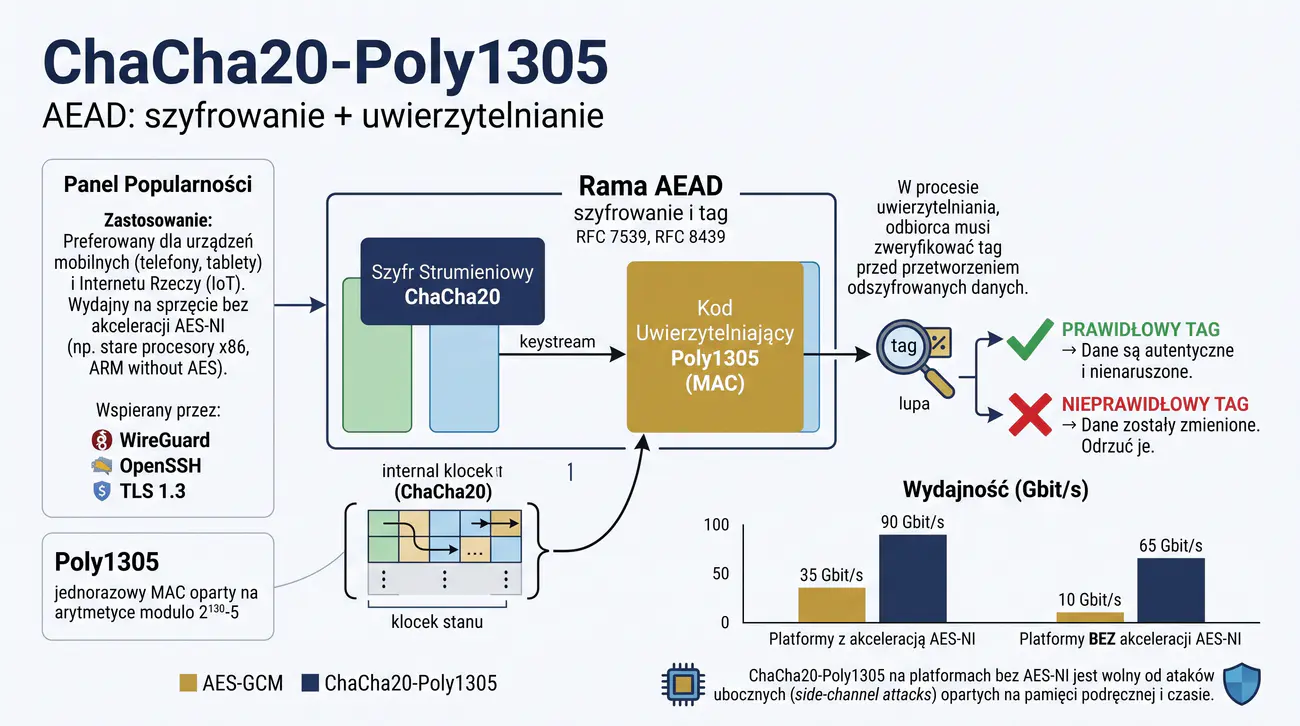
ChaCha20-Poly1305 łączy szyfrowanie z niezależnym kodem uwierzytelniającym, wykorzystując wartościowanie wielomianów modulo pewną dużą liczbę pierwszą. Klucz jednorazowy dla kodu Poly1305 wywodzi się z pierwszego bloku szyfru, dzięki czemu cały mechanizm pozostaje samowystarczalny i nie wymaga dodatkowych materiałów losowych. W ten sposób jedna konstrukcja zapewnia jednocześnie poufność i weryfikowalność komunikatu.
Tryb ten szczególnie dobrze sprawdza się tam, gdzie brakuje sprzętowej akceleracji AES, a więc w urządzeniach wbudowanych, telefonach i oprogramowaniu wykorzystywanym w sieciach prywatnych. Dzięki odporności na ataki czasowe i stałemu czasowi wykonania sprawdza się nawet na prostych mikrokontrolerach. Właśnie ta uniwersalność przesądziła o jego obecności w wielu współczesnych protokołach.
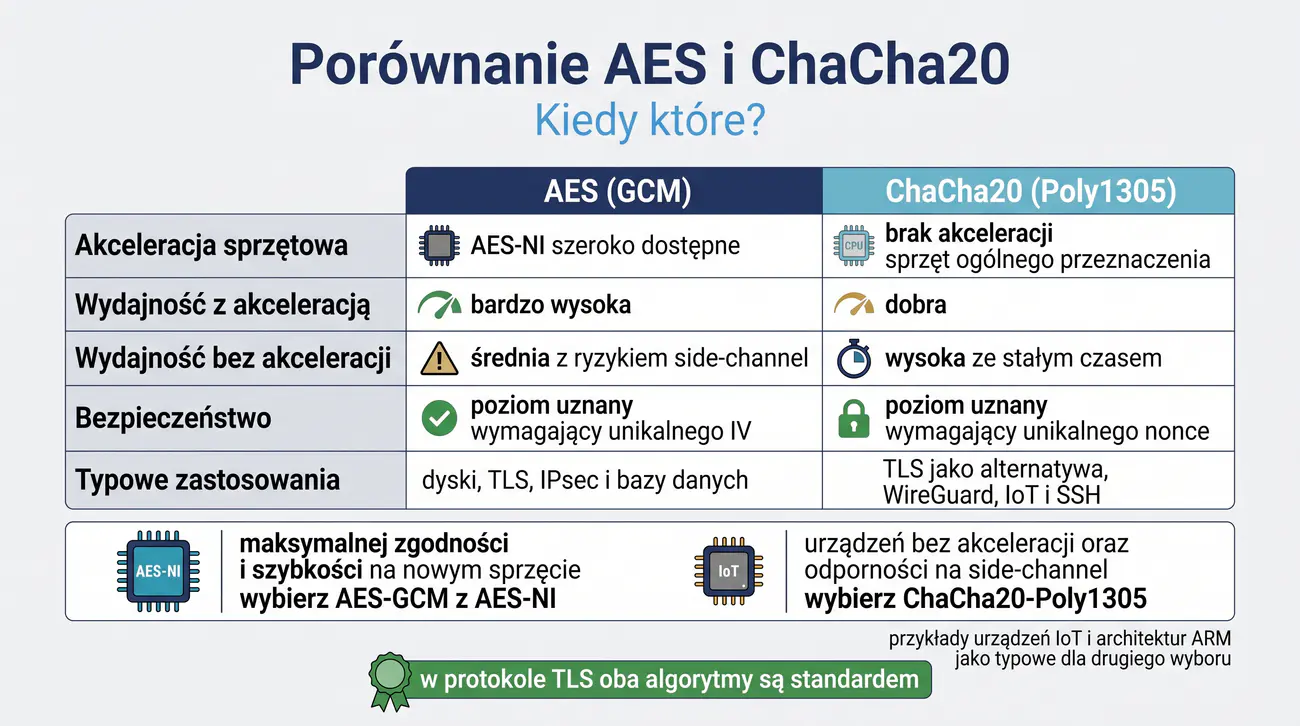
Porównując z trybem GCM, warto pamiętać, że oba rozwiązania należą do klasy AEAD i różnią się przede wszystkim bazowymi operacjami oraz zachowaniem na różnych platformach. Dobór między nimi powinien uwzględniać sprzęt, na którym system będzie działał. Ta wiedza pomaga zrozumieć, dlaczego część witryn i aplikacji celowo wybiera właśnie tę kombinację algorytmów.
| Cecha | AES (GCM) | ChaCha20 (Poly1305) |
|---|---|---|
| Sprzętowa akceleracja | AES-NI (szeroko) | brak (general purpose) |
| Wydajność z AES-NI | bardzo wysoka | dobra |
| Wydajność bez akceleracji | średnia, ryzyko ataków bocznych | wysoka, stały czas |
| Bezpieczeństwo | uznane, wymaga unikalnego IV | uznane, wymaga unikalnego nonce |
| Typowe zastosowania | dyski, TLS, IPsec, bazy | TLS (alternatywa), WireGuard, IoT, SSH |
Rekomendacje: oba są dobre; dla maksymalnej zgodności i szybkości na nowym sprzęcie wybierz AES-GCM z AES-NI; dla urządzeń bez akceleracji i odpornych na ataki boczne (IoT, ARM) - ChaCha20-Poly1305. W TLS oba są standardem.
Wybór między AES-GCM a ChaCha20-Poly1305 powinien opierać się na charakterystyce platformy docelowej oraz modelu zagrożeń, a nie na kwestiach prestiżowych. Procesory wyposażone w instrukcje sprzętowej akceleracji AES zwykle osiągają przy GCM wyższe przepustowości. Na architekturach pozbawionych takiego wsparcia przewagę często uzyskuje natomiast ChaCha20, korzystając ze stałego czasu wykonania.
Z tego powodu w dużych systemach rozsądne jest dopuszczenie obu rozwiązań w fazie negocjacji, tak by klient i serwer mogli wybrać wariant odpowiedni dla własnych możliwości. Tak właśnie postępuje protokół TLS, który traktuje oba algorytmy jako równoważne opcje. Dzięki temu kompatybilność nie stoi w sprzeczności z optymalizacją wydajności.
Warto umieć porównać obie rodziny nie tylko pod kątem szybkości, lecz także istniejącego stanu badań i zaleceń normalizacyjnych. Świadomy wybór technologii wymaga bowiem umiejętności czytania specyfikacji i oceny argumentów. Równie istotna jest znajomość ograniczeń projektowanych rozwiązań, związanych między innymi z rozmiarem wektorów startowych.
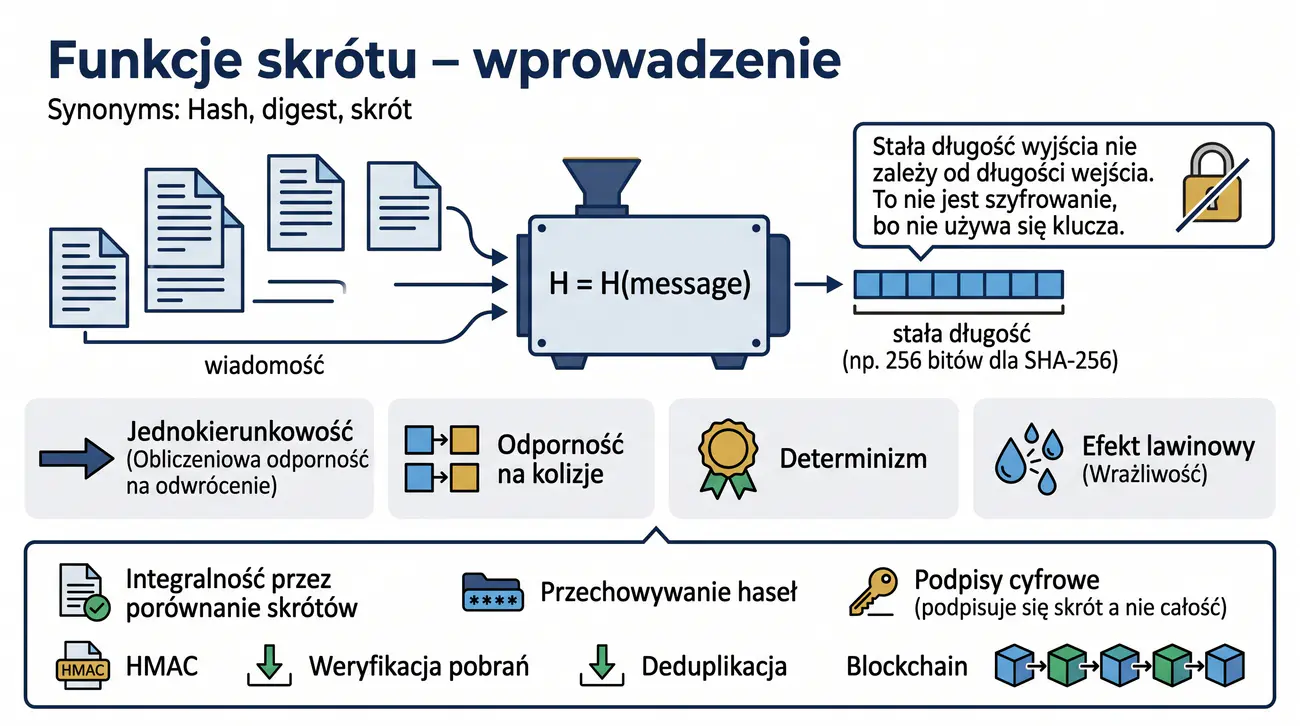
Funkcje skrótu przypisują dowolnej wiadomości ciąg znaków o stałej długości, wykonując przekształcenie, które nie ma charakteru szyfrowania. Determinizm działania i wrażliwość na każdą, nawet pojedynczą zmianę wejścia czynią z nich podstawę weryfikacji integralności. Przechowywanie haseł wymaga osobnej konstrukcji: solone, powtarzalnie (lub kosztownie) iterowane KDF (Argon2id, scrypt, bcrypt, PBKDF2), bo zwykłe skróty są zbyt szybkie do odtwarzania haseł metodą słownikową. Samo pojęcie skrótu nie jest przy tym związane z zachowaniem tajności, co bywa źródłem początkowych nieporozumień.
Właściwości funkcji skrótu wykorzystywane są także w mechanizmach pozornie odległych od kryptografii, takich jak drzewa skrótów czy systemy deduplikacji danych. Determinizm pozwala porównywać dane bez konieczności przesyłania ich w całości, co przyspiesza wiele operacji w systemach rozproszonych. Jednocześnie brak klucza oznacza, że osoba znająca skrót nie może na jego podstawie odtworzyć treści.
Stała długość wyniku sprawia, że różne dane mogą potencjalnie prowadzić do tego samego skrótu, a odkrycie takich powiązań jest właśnie przedmiotem zainteresowania kryptoanalityków. Dlatego wybór długości skrótu ma bezpośrednie konsekwencje dla poziomu bezpieczeństwa systemu. Tak rozumiana rola funkcji skrótu stanowi wstęp do szczegółowej analizy ich własności w kolejnych slajdach.
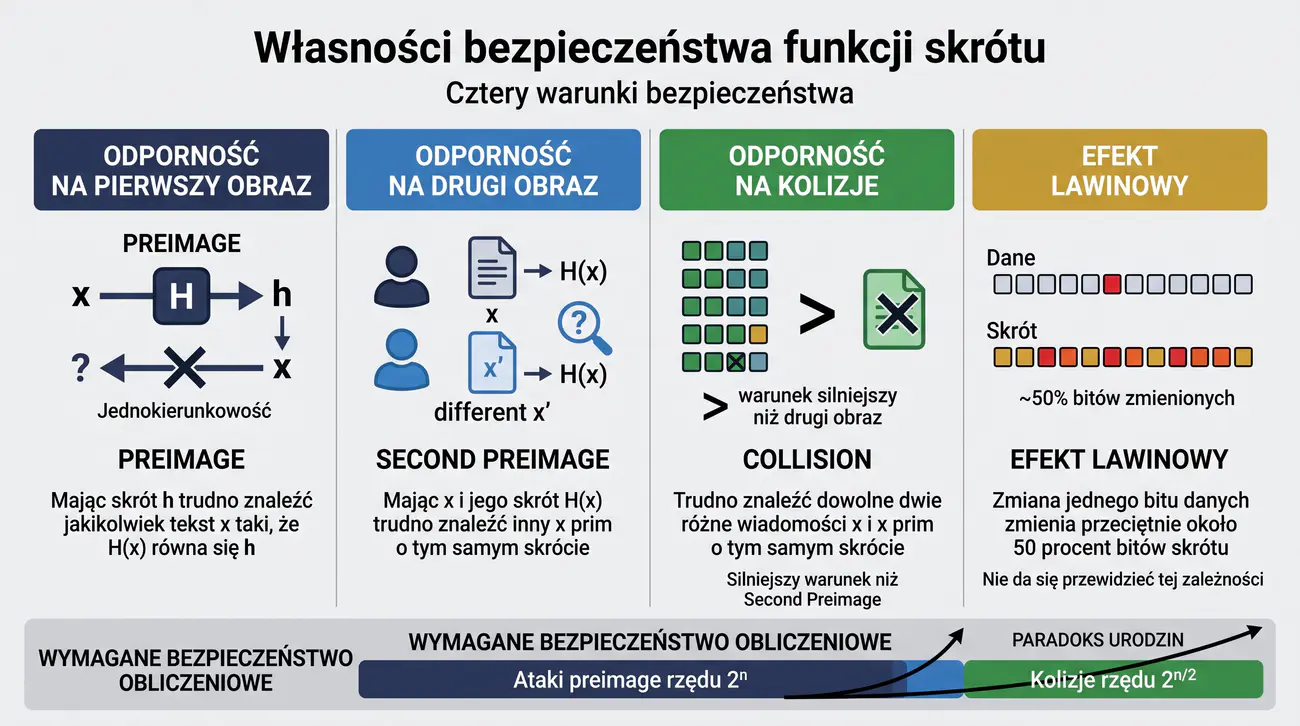
Wymagane bezpieczeństwo obliczeniowe: dla skrótu o n bitach ataki preimage wymagają ok. 2^n, kolizje ok. 2^(n/2) (paradoks urodzin).
Trzy klasy zadań o wyraźnie różnym stopniu trudności porządkują sposób myślenia o odporności funkcji skrótu, czyli o znalezieniu pierwszego obrazu, drugiego obrazu oraz kolizji. Najtrudniejsze z nich dotyczy znalezienia dowolnego wejścia dla zadanego wyniku i wymaga nakładu porównywalnego z liczbą możliwych skrótów. Zadania zwane kolizjami bywają natomiast łatwiejsze dzięki paradoksowi urodzin.
Zależności te przekładają się na konkretne wartości progowe dla różnych długości wyjścia, co pozwala oceniać, czy dana funkcja jeszcze spełnia oczekiwania bezpieczeństwa. Efekt lawinowy, obserwowany przy minimalnej zmianie danych, wzmacnia poczucie nieprzewidywalności wyników. Dzięki tym właściwościom skróty nadają się do szybkiej i wiarygodnej kontroli spójności danych.
Istotne jest odróżnienie trudności teoretycznej od kosztu praktycznego, który zmienia się wraz z postępem techniki. Ta sama funkcja może przez lata uchodzić za bezpieczną, a następnie przestać spełniać zadane wymagania. Świadomość tych zależności jest zresztą niezbędna przy doborze algorytmów do konkretnych systemów.
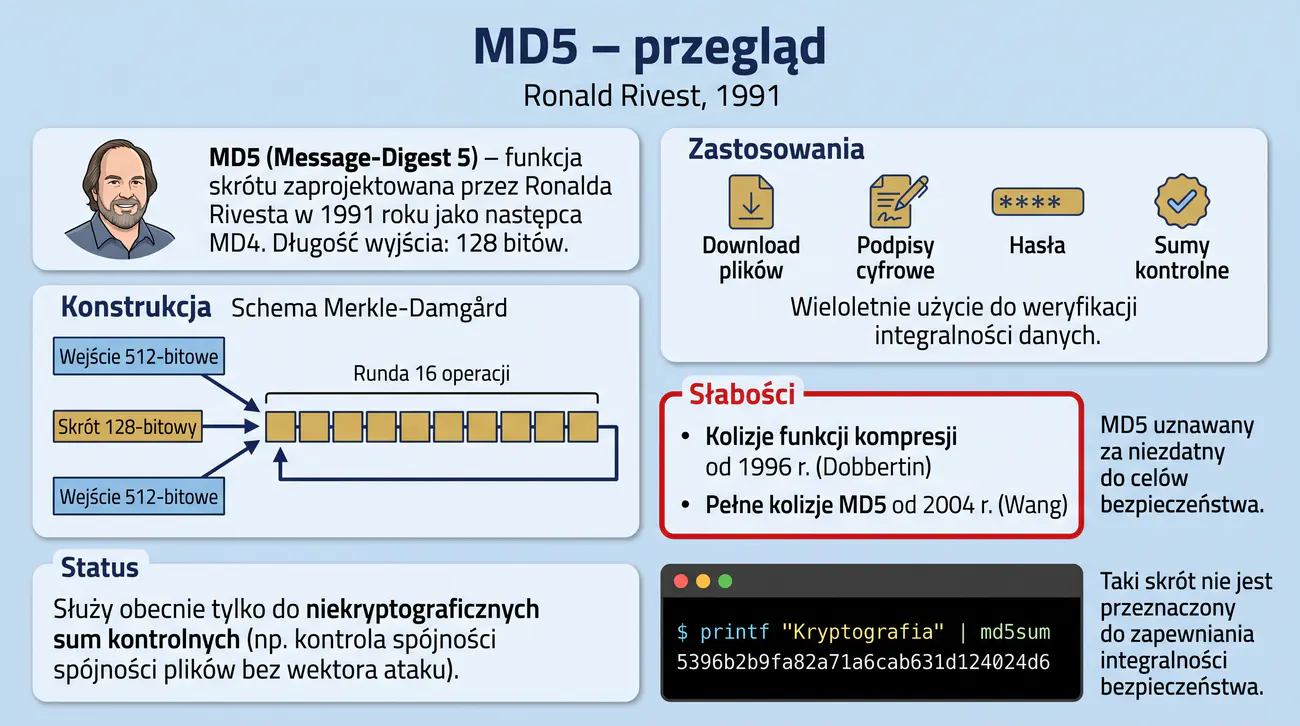
$ printf 'Kryptografia' | md5sum
5396b2b9fa82a71a6cab631d124024d6 -
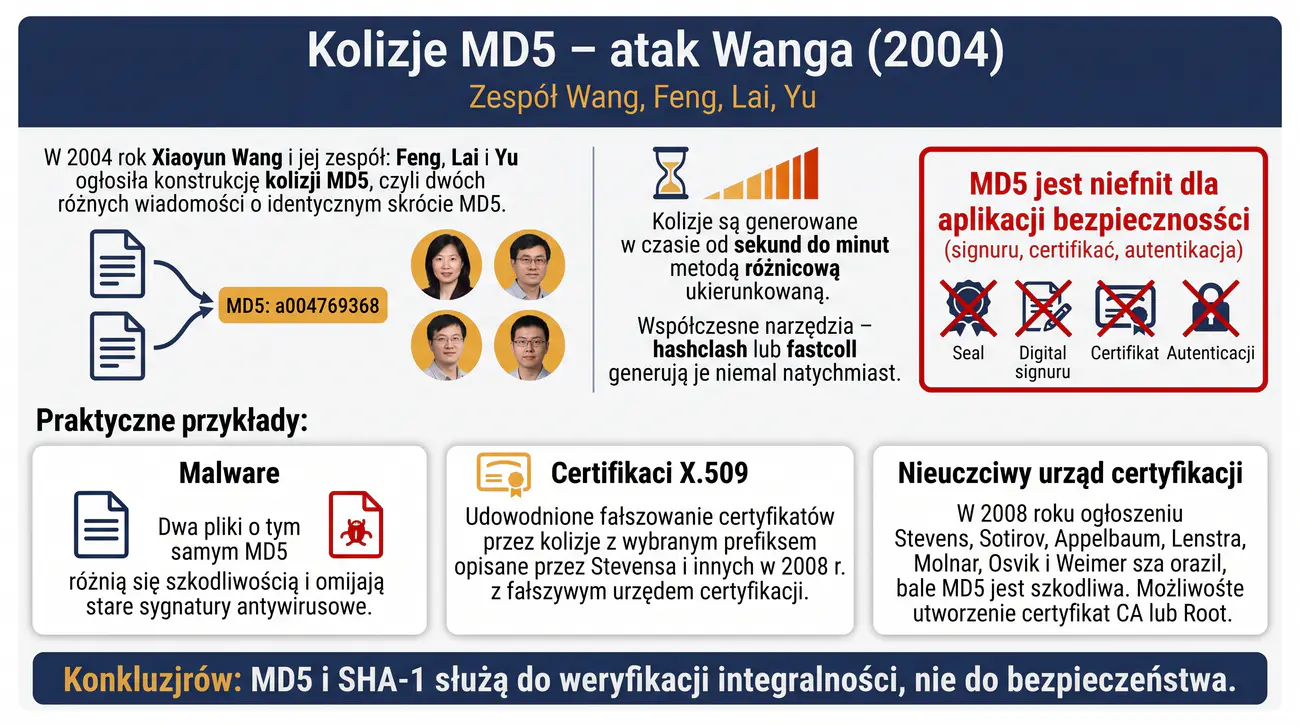
MD5 przez długie lata pełnił rolę uniwersalnej funkcji kontrolnej obecnej w niezliczonych narzędziach i protokołach. Jego konstrukcja typu Merkle-Damgårda z blokami 512-bitowymi przez wiele lat wydawała się w pełni wystarczająca. Dopiero kolejne analizy struktury kompresji ujawniły słabości przekładające się na praktyczne możliwości ataku.
Wykrycie kolizji, które można generować szybko nawet na zwykłych komputerach, odebrało MD5 status funkcji kryptograficznej. Rozwiązania branżowe przeszły wówczas na dłuższe skróty, utrzymując jednak zgodność ze starym oprogramowaniem jedynie tam, gdzie nie decydowało bezpieczeństwo. To właśnie ta podwójna rola MD5, użytkowa i badawcza, czyni z niego ciekawy przykład ewolucji standardów.
Dziś MD5 może być stosowany wyłącznie do zadań kontrolnych niemających znaczenia dla bezpieczeństwa, na przykład do wykrywania przypadkowych uszkodzeń plików. Porównując z nowoczesnymi funkcjami, należy pamiętać, że kwestia długości skrótu nie jest jedynym kryterium ich oceny. Takie porównanie pomaga też zrozumieć, że długość skrótu to tylko jeden z wielu wyznaczników jego siły.
Ogłoszenie w 2004 roku konstrukcji kolizji MD5 zmieniło status tej funkcji z narzędzia powszechnego na obiekt szczegółowych badań nad konsekwencjami wykonalnego ataku. Odkryty mechanizm różnicowy pozwalał wskazać dwie różne wiadomości o identycznym skrócie w czasie mierzonym w sekundach lub minutach. Następne prace rozszerzyły te możliwości na techniki dopasowania prefiksu, w których atakujący kontroluje początkową część dokumentu.
Praktyczne skutki objęły między innymi zagrożenia dla infrastruktury certyfikatów, ponieważ przygotowane dokumenty mogły prowadzić do fałszowania podpisów cyfrowych. Teoretyczne możliwości zostały z czasem potwierdzone demonstracjami związanymi z fałszywymi urzędami certyfikacji. Historia MD5 uczy, że pozornie nieistotna kolizja bywa w stanie podważyć zaufanie całych systemów.
Kluczowy jest wniosek, że ocena funkcji skrótu musi uwzględniać nie tylko formalne własności, lecz także wyniki bieżących badań. Zalecenia normalizacyjne ewoluują właśnie w odpowiedzi na takie odkrycia. Zdobyta w ten sposób wiedza pozwala z dystansem oceniać także przyszłe doniesienia o słabościach kolejnych konstrukcji.
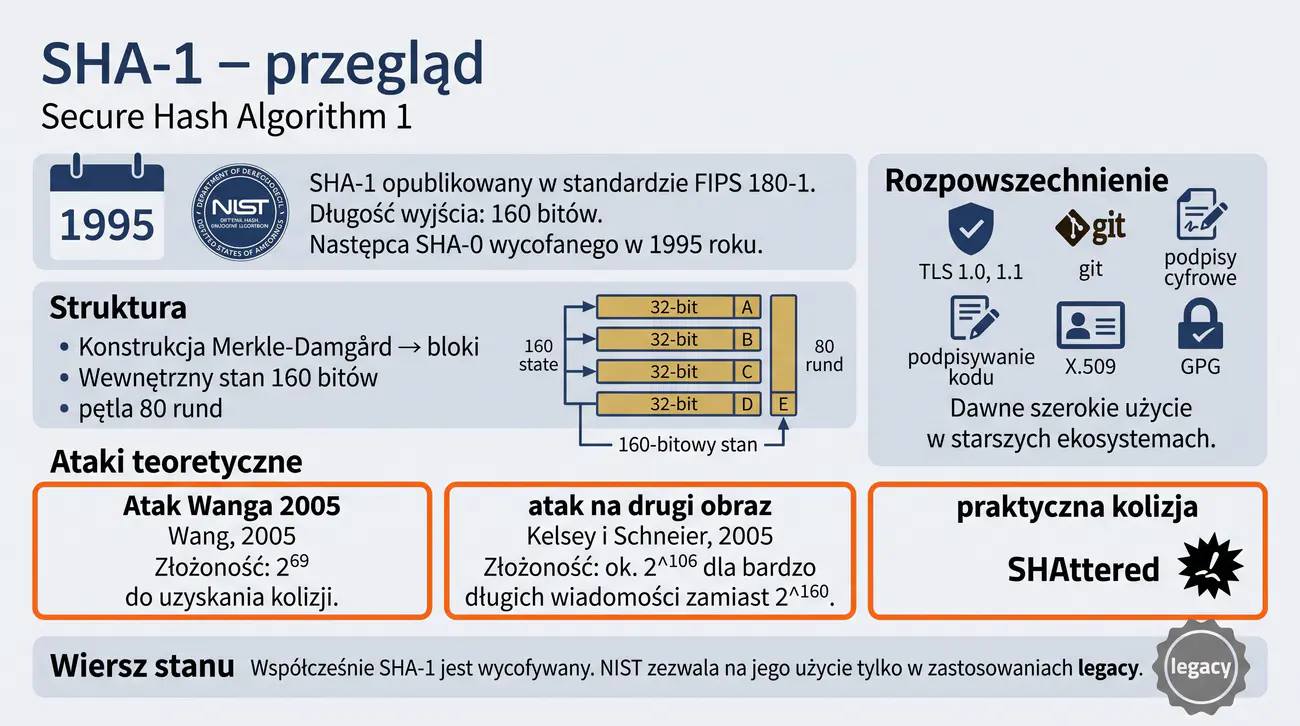
SHA-1 przez wiele lat uchodził za bezpieczne rozwinięcie idei wywodzących się z rodziny SHA-0, a jego 160-bitowe wyjście zdawało się wystarczające dla ówczesnych zastosowań. Stopniowe obniżanie szacunków złożoności możliwych ataków przygotowało grunt pod praktyczne demonstracje słabości. Krytyczną rolę odegrały prace wykazujące, że koszt znajdowania kolizji jest znacznie niższy niż sugerowała sama długość skrótu.
Powszechne rozpowszechnienie SHA-1 w systemach kontroli wersji, certyfikatach i protokołach komunikacyjnych spowolniło proces jego wycofywania w porównaniu z MD5. Trwająca migracja pokazuje, jak kosztowne może być porzucanie rozpowszechnionego standardu po odkryciu jego słabości. Jednocześnie pozostają w obiegu starsze dane i podpisy chronione wyłącznie tym algorytmem.
Utrzymywanie kompatybilności w systemach informatycznych wymaga więc planowania harmonogramu wymiany algorytmów znacznie wcześniej niż pojawienie się twardych dowodów kompromitacji. Ta praktyczna wiedza jest jedną z najważniejszych lekcji płynących z historii funkcji skrótu. Przemyślane zarządzanie zmianą algorytmów należy zresztą do codziennych zadań działów bezpieczeństwa w dużych organizacjach.
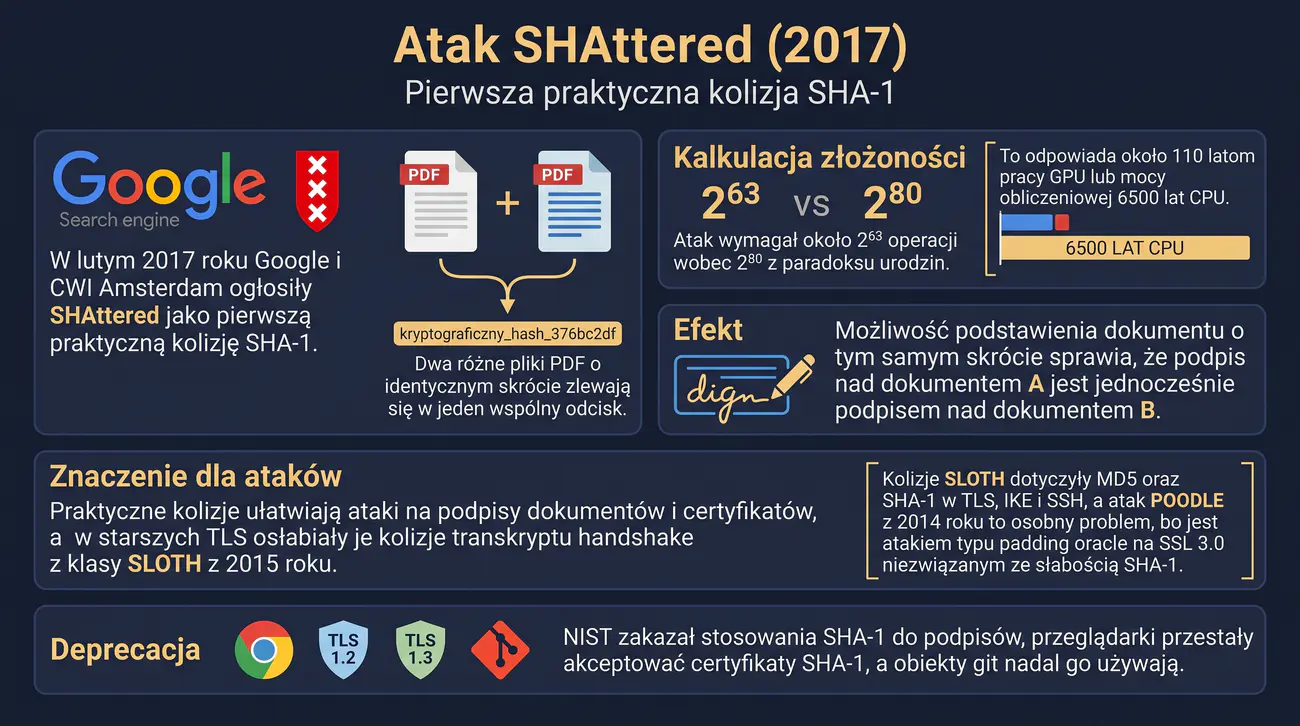
Demonstracja SHAttered w 2017 roku pokazała, że koszt znalezienia kolizji SHA-1 spadł do poziomu osiągalnego przez podmioty dysponujące dużymi klastrami obliczeniowymi. Dwa różne dokumenty PDF o identycznym skrócie udowodniły możliwość podstawienia treści w środowisku podpisów cyfrowych. Wydarzenie to wywołało szeroką reakcję branży, w tym odrzucenie certyfikatów opartych na SHA-1 przez przeglądarki i instytucje normalizacyjne.
Obliczenia potrzebne do skonstruowania kolizji ilustrują przy tym proporcje między pracą teoretyczną, związaną z projektowaniem przekształceń różnicowych, a etapem wykonawczym rozgrywanym na kartach graficznych. Koszt wyrażany w jednostkach obliczeniowych skłania do ponownego przemyślenia marginesów bezpieczeństwa dla innych funkcji. Historia tego ataku jest dziś regularnie przywoływana w materiałach szkoleniowych dotyczących zarządzania ryzykiem.
Najistotniejszy jest wniosek o potrzebie wczesnej migracji i o traktowaniu progów teoretycznych jako dolnej granicy, a nie jako gwarancji. Kolejne zalecenia normalizacyjne silnie podkreślają właśnie te dwie zasady. Z tych samych powodów na bieżąco weryfikowana jest także odporność pozostałych, uznawanych dziś funkcji skrótu.
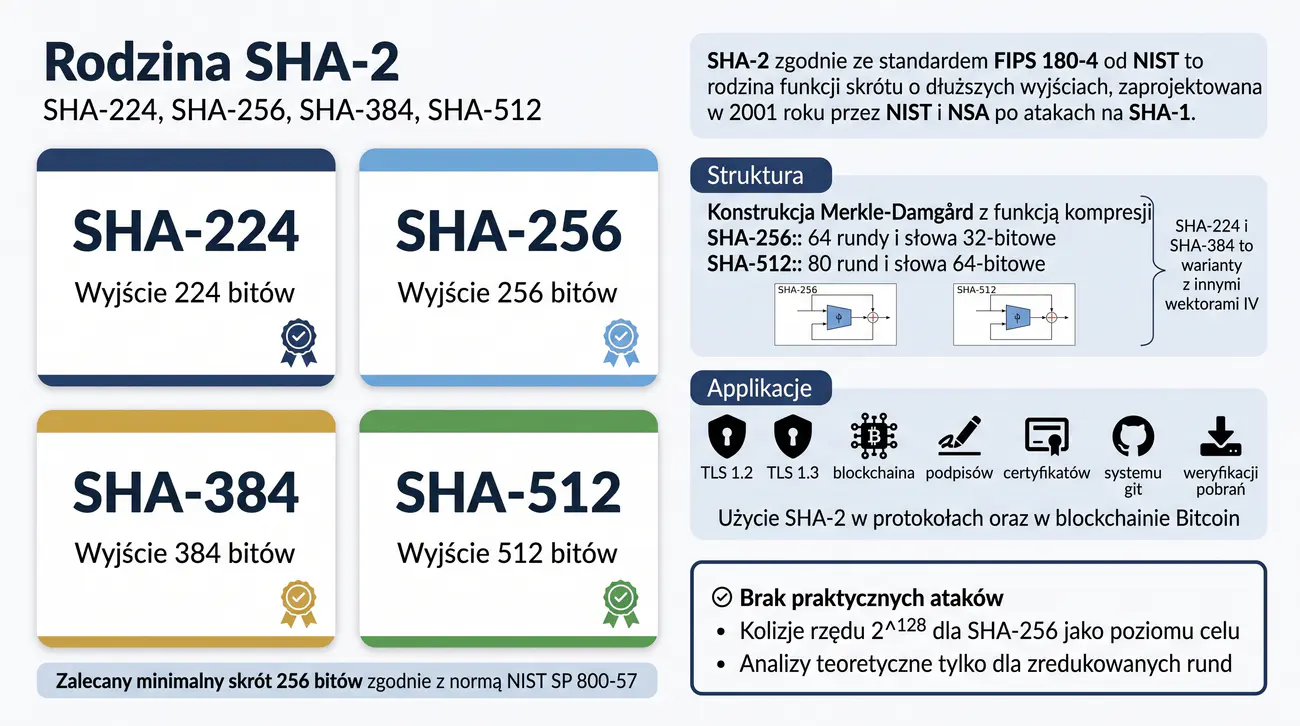
Rodzina SHA-2 oferuje warianty o długościach wyniku od 224 do 512 bitów i pozostaje podstawowym wyborem w praktycznie wszystkich współczesnych protokołach. Warianty te buduje się na wspólnej konstrukcji z funkcją kompresji działającą na słowach o ustalonej długości. Mimo intensywnych badań nie opublikowano dotąd praktycznego ataku na żaden z nich.
Wartość 256 bitów przyjęła się jako standard minimalny, natomiast warianty o dłuższych wynikach stosuje się tam, gdzie wymagany jest zwiększony margines bezpieczeństwa, na przykład przy długoterminowym podpisywaniu dokumentów. Obecność SHA-2 w blockchainach, certyfikatach i systemach kontroli wersji świadczy o uniwersalności całej rodziny. Rozwój SHA-3 nie spowodował przy tym rezygnacji z SHA-2, ponieważ obie rodziny funkcjonują obecnie równolegle.
Należy odróżniać bezpieczeństwo samej funkcji od kontekstu jej użycia, takiego jak mechanizm wyprowadzania klucza czy kod MAC. Dopiero całość zabezpieczeń decyduje o poziomie ochrony całego systemu. Analiza tych zagadnień rozwija umiejętności przydatne na każdym etapie kariery w branży bezpieczeństwa.
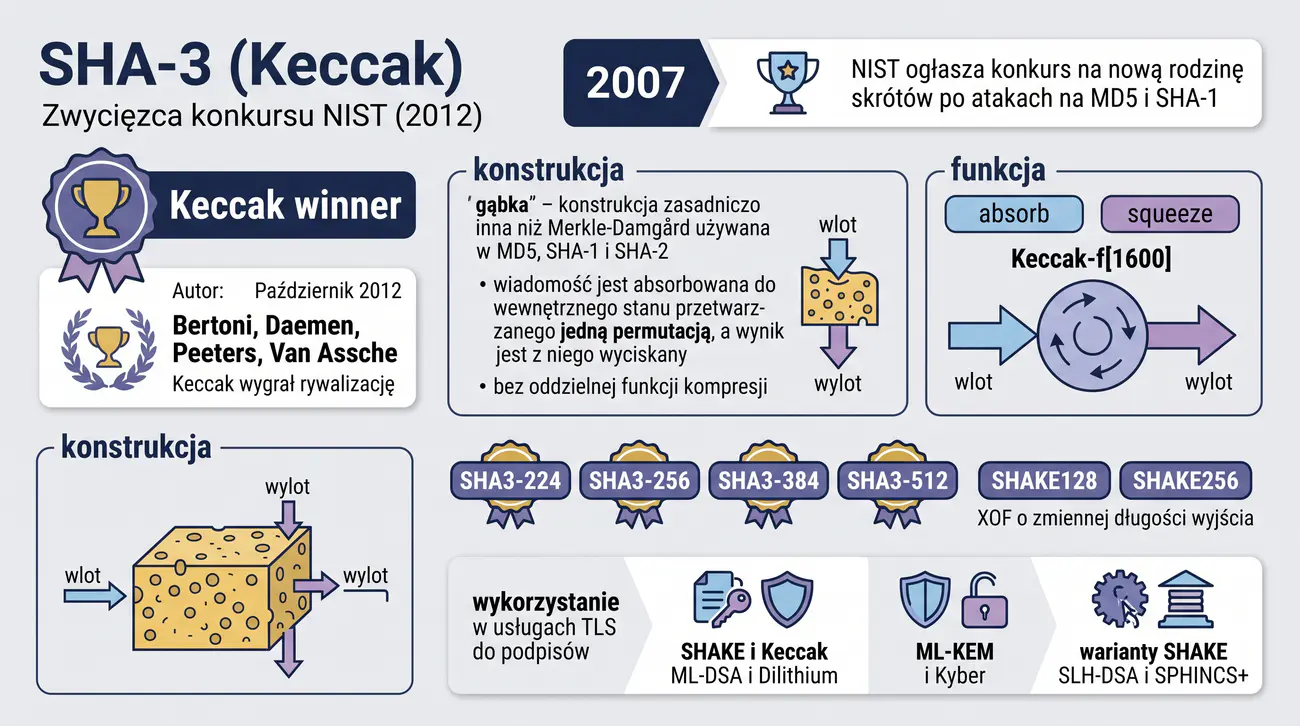
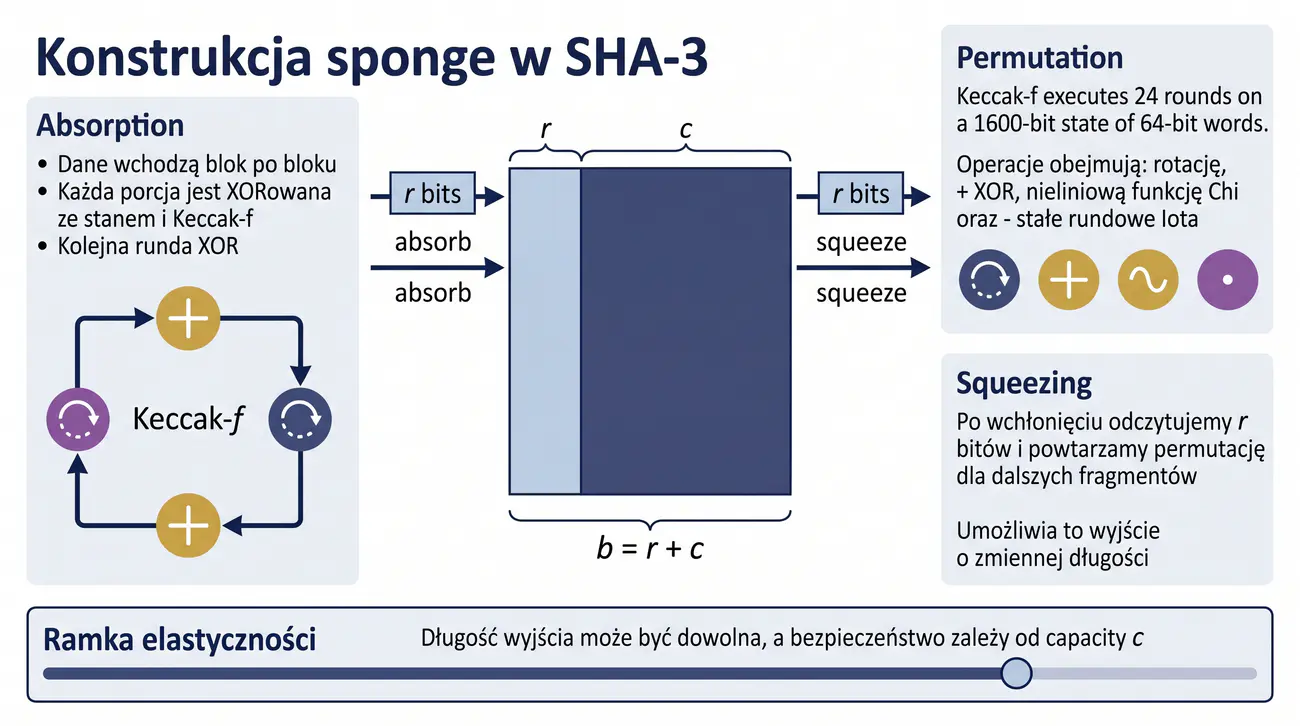
SHA-3 wywodzi się z algorytmu Keccak, zwycięzcy otwartego konkursu NIST, i wprowadza konstrukcję gąbkową całkowicie odmienną od znanych wcześniej układów typu łańcuchowego. Nowa budowa zapewnia atrakcyjne właściwości, w tym możliwość generowania wyniku o dowolnej długości. Dzięki temu funkcje z tej rodziny można stosować w zadaniach nieosiągalnych dla klasycznych skrótów.
Warianty o zmiennej długości wyniku, oznaczane skrótem SHAKE, dają projektantom systemów narzędzie dostosowywania poziomu bezpieczeństwa do potrzeb. Keccak znalazł również miejsce w protokołach postkwantowych, które wykorzystują jego operacje jako bloki składowe. Ta elastyczność przyczyniła się do dłuższego cyklu życia algorytmu w porównaniu z wcześniejszymi rodzinami.
Z perspektywy dydaktycznej cenna jest możliwość porównania dwóch odmiennych konstrukcji, łańcuchowej i gąbkowej, działających w tej samej kategorii zadań. Taka analiza rozwija umiejętność oceny nowych propozycji pojawiających się w literaturze. Ta umiejętność tworzenia alternatywnych konstrukcji stanowi zresztą istotny element kultury kryptograficznej.
Konstrukcja gąbki opisuje funkcję jako sekwencję absorpcji i wyciskania materiału przy użyciu stanu wewnętrznego o ustalonej pojemności. Kolejne fragmenty wiadomości są łączone ze stanem i przetwarzane nieliniową permutacją, co zapewnia zarówno determinizm, jak i gwałtowną propagację zmian. Bezpieczeństwo całej konstrukcji zależy przy tym od części stanu pozostającej poza zasięgiem bezpośredniego odczytu, nazywanej pojemnością.
Zwiększanie pojemności podnosi koszt ataków kosztem zmniejszenia przepustowości obliczeń, dlatego poszczególne warianty SHA-3 różnią się proporcjami między oboma parametrami. Projektant systemu musi zatem zdecydować, jaki kompromis najlepiej odpowiada jego zastosowaniu. Ta świadomość jest przydatna również przy wyborze funkcji o zmiennej długości wyniku.
Konstrukcja gąbkowa bywa łatwiejsza do intuicyjnego wyjaśnienia niż klasyczny łańcuch, co ułatwia prowadzenie zajęć dydaktycznych. Porównanie obu modeli pokazuje zarazem, że różne budowy mogą prowadzić do podobnie wysokiego poziomu bezpieczeństwa. Znajomość obu schematów pozwala także rozmawiać o konwersjach między funkcjami w specyfikacjach protokołów.
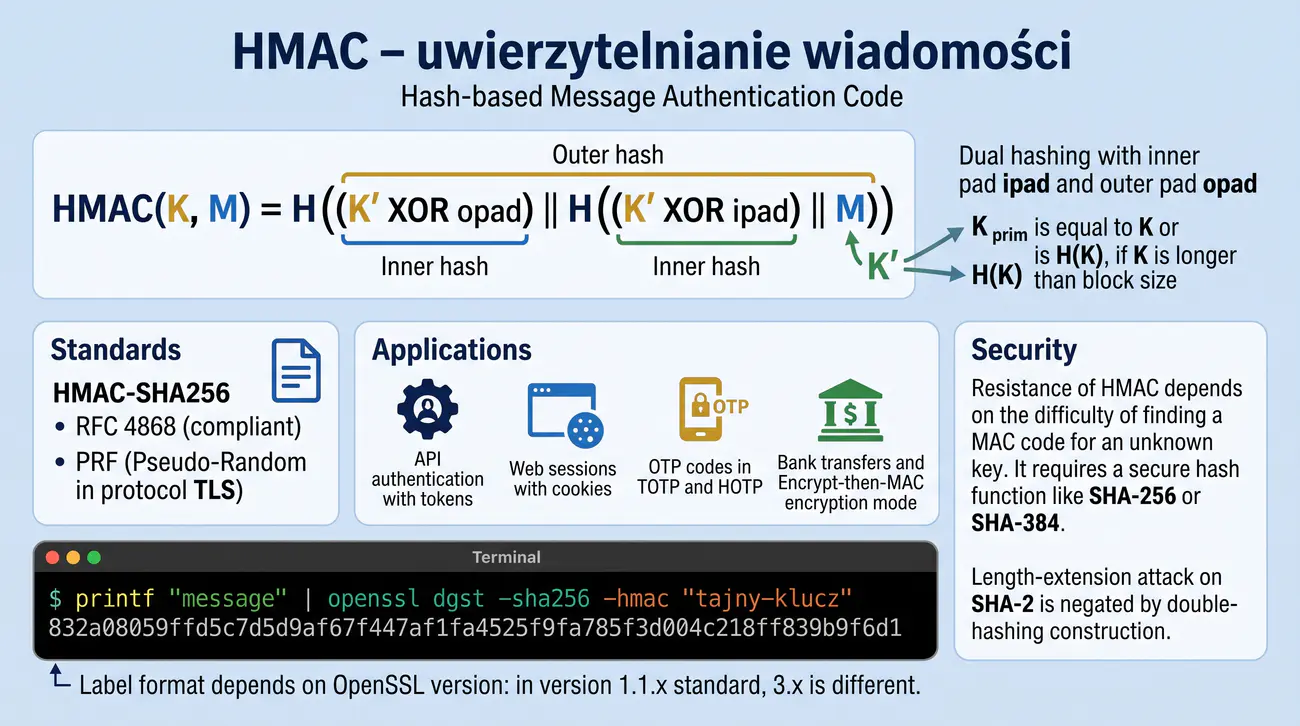
$ printf 'wiadomosc' | openssl dgst -sha256 -hmac 'tajny-klucz' (stdin)= 832a08059ffd5c7d5d9af67f447af1fa4525f9fa785f3d004c218ff839b9f6d1 # postać etykiety zależy od wersji OpenSSL: 1.1.x -> (stdin)=, 3.x -> np. SHA2-256(stdin)= lub HMAC-SHA2-256(stdin)=
HMAC rozwiązuje zadanie uwierzytelniania komunikatów przez połączenie klucza z funkcją skrótu, dając w wyniku kod, którego nie można wyznaczyć bez znajomości sekretu. Dwie wartości wewnętrznego i zewnętrznego dopełnienia zabezpieczają konstrukcję przed atakami polegającymi na rozszerzeniu długości wiadomości. Dzięki temu mechanizm bywa odporny na zagrożenia, które dotknęłyby zwykłe funkcje z rodziny Merkle-Damgårda.
W praktyce HMAC występuje w niezliczonych miejscach, od uwierzytelniania żądań API i sesji webowych, po generowanie jednorazowych haseł. Właściwy wybór funkcji bazowej, takiej jak SHA-256, decyduje o ostatecznym marginesie bezpieczeństwa całego mechanizmu. Konstrukcja ta dobrze ilustruje przy tym zasadę, zgodnie z którą dodanie klucza zmienia rolę narzędzia z kontroli spójności na uwierzytelnianie.
Warto rozumieć, że sam kod MAC nie obejmuje wymogu poufności, a jedynie integralność i autentyczność komunikatu. Właśnie dlatego w systemach łączy się go zwykle z szyfrowaniem w sprawdzonej kolejności operacji. Utrwalenie tej konstrukcji ułatwia później analizę bardziej złożonych mechanizmów, takich jak protokoły wymiany kluczy.
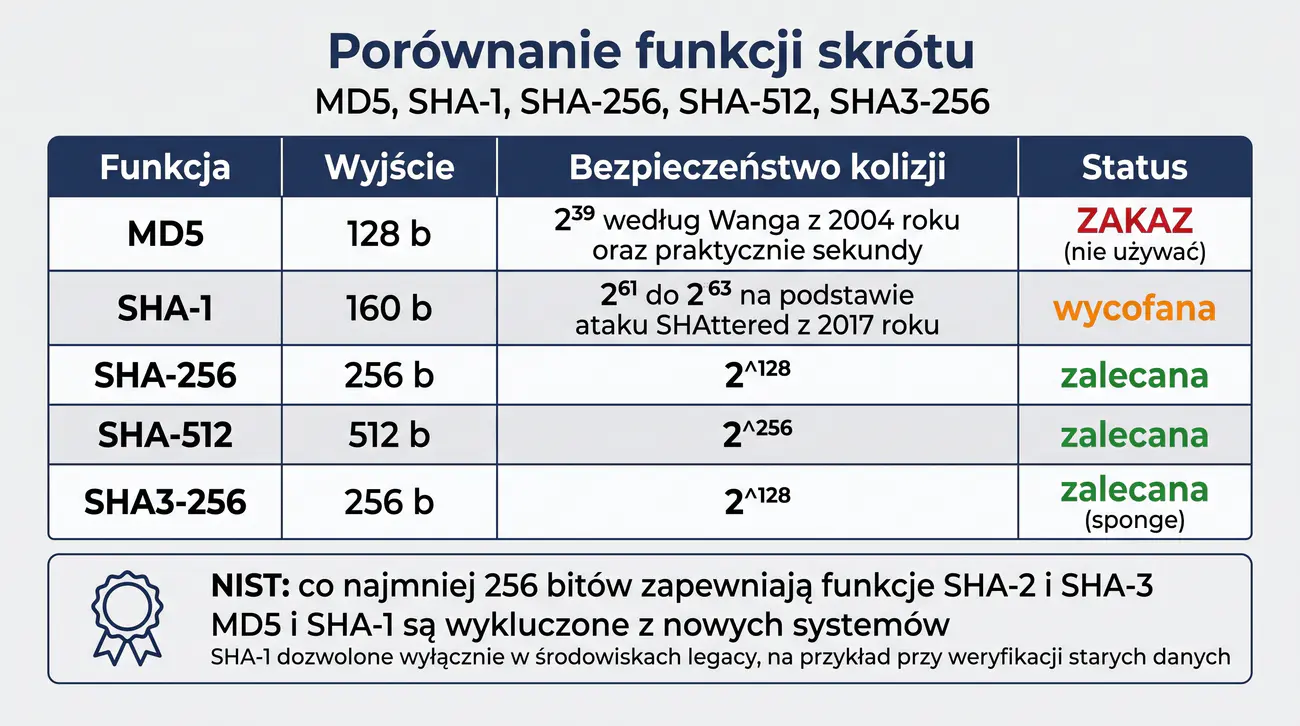
| Funkcja | Wyjście | Bezpieczeństwo kolizji | Status |
|---|---|---|---|
| MD5 | 128 b | 2^32 do 2^64 (teoria); praktycznie 2^18-2^20 (krótkie prefiksy, 2019) oraz sekundy dla znanych celów | ZAKAZ (nie używać) |
| SHA-1 | 160 b | 2^61-2^63 (SHAttered 2017); obecnie szacunki rzędu 2^30 do wyliczenia kolizji metodą wspólnych prefiksów | wycofana |
| SHA-256 | 256 b | 2^128 | zalecana |
| SHA-512 | 512 b | 2^256 | zalecana |
| SHA3-256 | 256 b | 2^128 | zalecana (sponge) |
Wytyczne NIST: co najmniej 256 bitów (SHA-2/SHA-3); MD5 i SHA-1 wykluczone z nowych systemów; SHA-1 dozwolone wyłącznie w legacy (np. weryfikacja starych).
Zestawienie funkcji skrótu według długości wyniku i spodziewanego kosztu kolizji pozwala uporządkować wiedzę o całej ich rodzinie. Różnica między wartościami progów dla krótkich i długich skrótów uświadamia, dlaczego era 128-bitowych wyników zakończyła się dla bezpieczeństwa systemów. Jednocześnie widać, że moce obliczeniowe rosną szybciej niż zwykłe zwiększanie liczby bitów wyniku.
Z tabeli wynika prosty wniosek praktyczny, aby w nowych projektach wybierać funkcje co najmniej 256-bitowe, najlepiej z rodziny SHA-2 lub SHA-3. Stare funkcje, takie jak MD5 i SHA-1, należy traktować wyłącznie jako narzędzia zgodności z przeszłością. Zarządzanie taką migracją jest jednym z typowych zadań inżyniera bezpieczeństwa.
Wszechstronność skrótów sprawia, że ich właściwy dobór ma znaczenie nie tylko dla integralności, lecz także dla całego modelu zaufania w systemie. Dlatego umiejętność czytania takich tabel bywa sprawdzana przez pracodawców podczas rekrutacji. Dzięki takiej praktyce zyskuje się też biegłość potrzebną do czytania tablic parametrów w dokumentacji produktów.
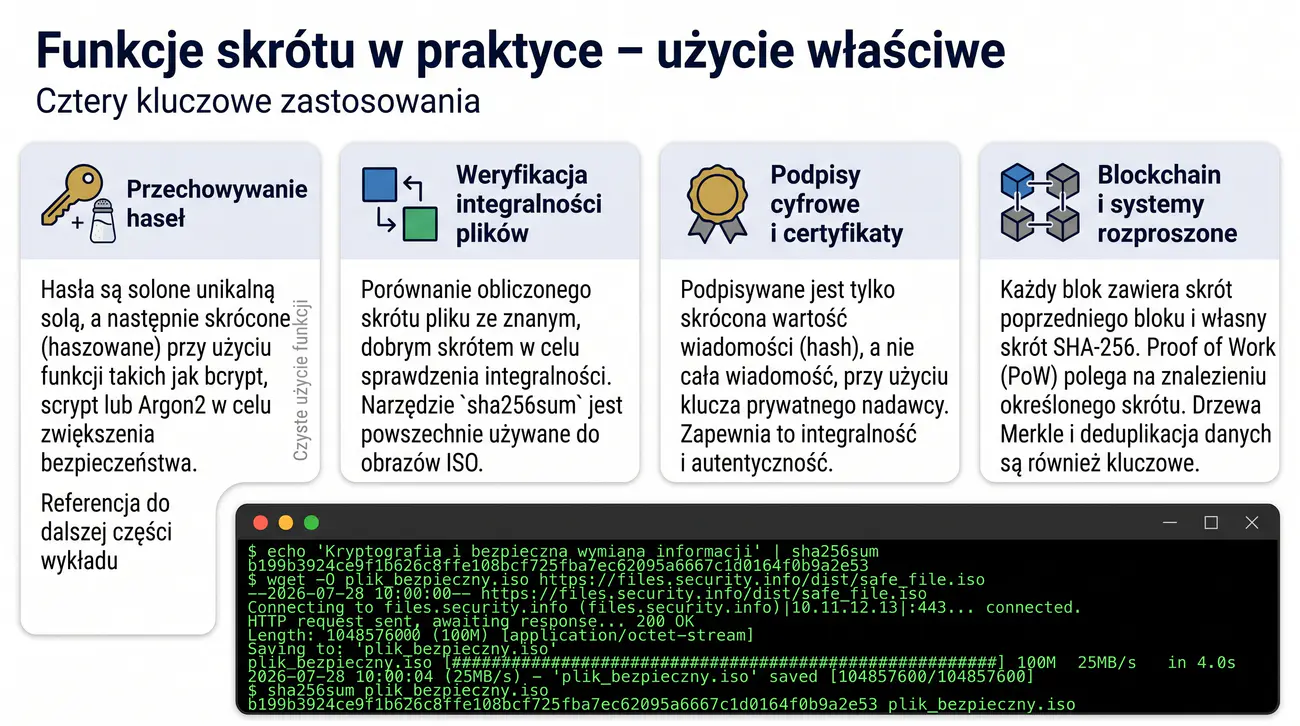
$ echo 'Kryptografia i bezpieczna wymiana informacji' | sha256sum b199b3924ce9f1b626c8ffe108bcf725fba7ec62095a6667c1d0164f0b9a2e53 - $ wget -O plik.iso https://example.com/distro.iso # przykład - liczy się porównanie skrótu $ sha256sum plik.iso # porównaj z oficjalnym skrótem
W praktyce funkcje skrótu pełnią wiele ról, a najczęściej spotykana dotyczy przechowywania haseł przy użyciu wyspecjalizowanych konstrukcji. W przypadku przekazywania plików porównanie ogłoszonego skrótu z wartością policzoną lokalnie pozwala potwierdzić nienaruszalność pobranego artefaktu bez przesyłania całego obrazu. Ta technika oszczędza czas i pasmo, dlatego stosowana jest przy niemal każdym dystrybutorze oprogramowania.
W podpisach cyfrowych skrót spełnia rolę reprezentacji dokumentu, którą można podpisać niewielkim kluczem prywatnym, co znacząco przyspiesza cały proces. W systemach rozproszonych skróty spinają natomiast części danych w drzewa, wspomagają deduplikację i stanowią podstawę mechanizmów konsensusu. W każdej z tych ról kluczowa jest deterministyczność i jedna długość wyniku.
Należy przy tym pamiętać, że zastosowania wymagające tajności, na przykład podpisywanie, nie wynikają z samej funkcji skrótu, lecz z całego protokołu wykorzystującego inne materiały kluczowe. Pełny obraz ochrony danych uzyskuje się dopiero po złączeniu wszystkich elementów systemu. Świadome rozdzielenie ról funkcji skrótu i szyfrowania należy do podstawowych kompetencji projektanta systemów.
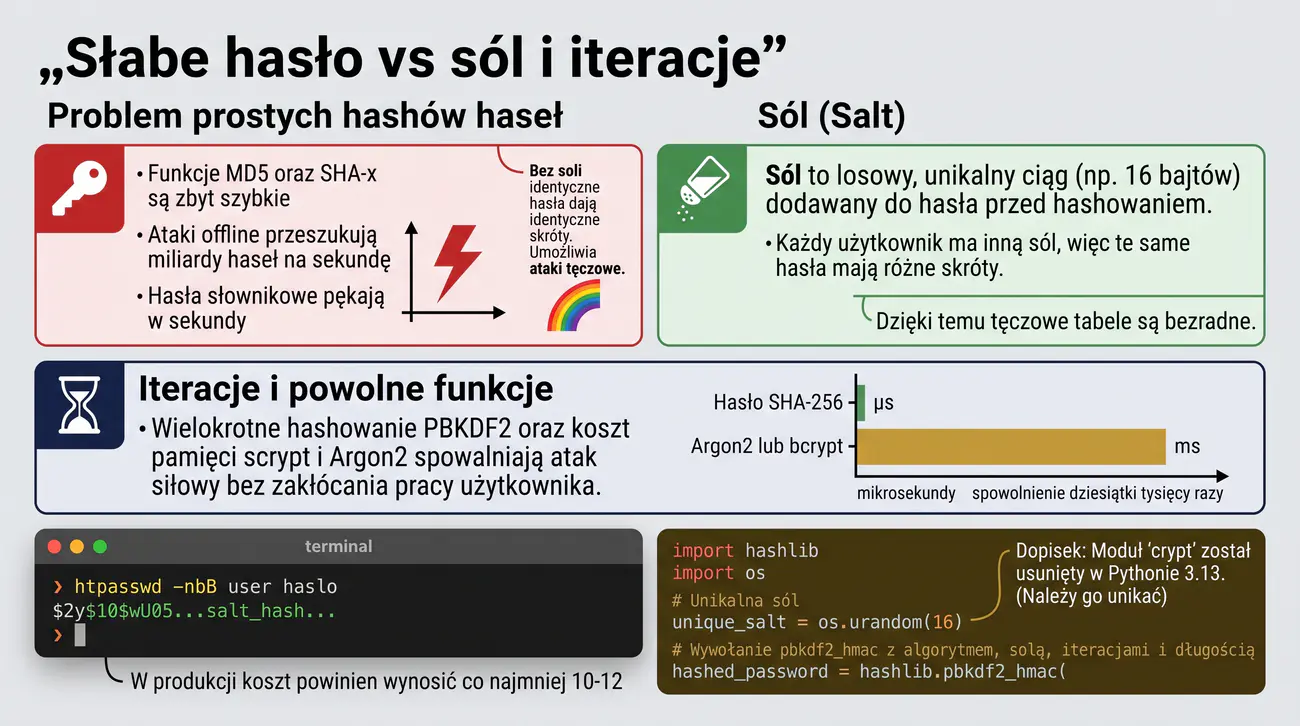
$ htpasswd -nbB user haslo # bcrypt + sól user:$2y$05$h6hXZBuSEQl1QKffHZMvOux8g.o3L/xsLwuttMkKYSgOm/9ntBKI. ( $2y = bcrypt, 05 = koszt, sól zakodowana w polu; w produkcji koszt co najmniej 10-12) $ python3 -c " import hashlib, os s = os.urandom(16) # sól - unikalna dla każdego użytkownika print(hashlib.pbkdf2_hmac('sha256', b'haslo', s, 600000, 32).hex()) " # PBKDF2 (hasło, sól, iteracje); uwaga: moduł 'crypt' jest przestarzały - usunięty w Pythonie 3.13
Przechowywanie haseł wymaga zastosowania funkcji celowo spowolnionych, ponieważ szybkie algorytmy ułatwiają masowe przeszukiwanie słowników i typowych haseł. Dodanie losowej soli do każdego wpisu eliminuje z góry przygotowane tablice tęczowe i sprawia, że identyczne hasła przyjmują odmienne skróty. Kolejne iteracje i wymagania pamięciowe czynią każdą próbę odgadnięcia kosztowniejszą obliczeniowo.
Parametry działania, takie jak liczba iteracji lub czas wykonywania, powinny być dostosowywane do możliwości sprzętu i okresu ważności przechowywanych danych. Wykorzystywane konstrukcje różnią się przy tym zasadami, na przykład kosztem pamięci, co wpływa na ich zachowanie na procesorach równoległych. Dzięki tej świadomości można racjonalnie wybrać narzędzie odpowiednie dla konkretnego systemu.
Warto przy tym pamiętać, że żadna funkcja nie zrekompensuje w pełni słabych, przewidywalnych haseł, dlatego konieczne są równocześnie polityki ich tworzenia. Bezpieczne przechowywanie haseł jest więc elementem szerszego systemu zarządzania tożsamością. Właśnie dlatego kompleksowe systemy łączą solidne funkcje do haseł z uwierzytelnianiem wieloskładnikowym i politykami długości haseł.
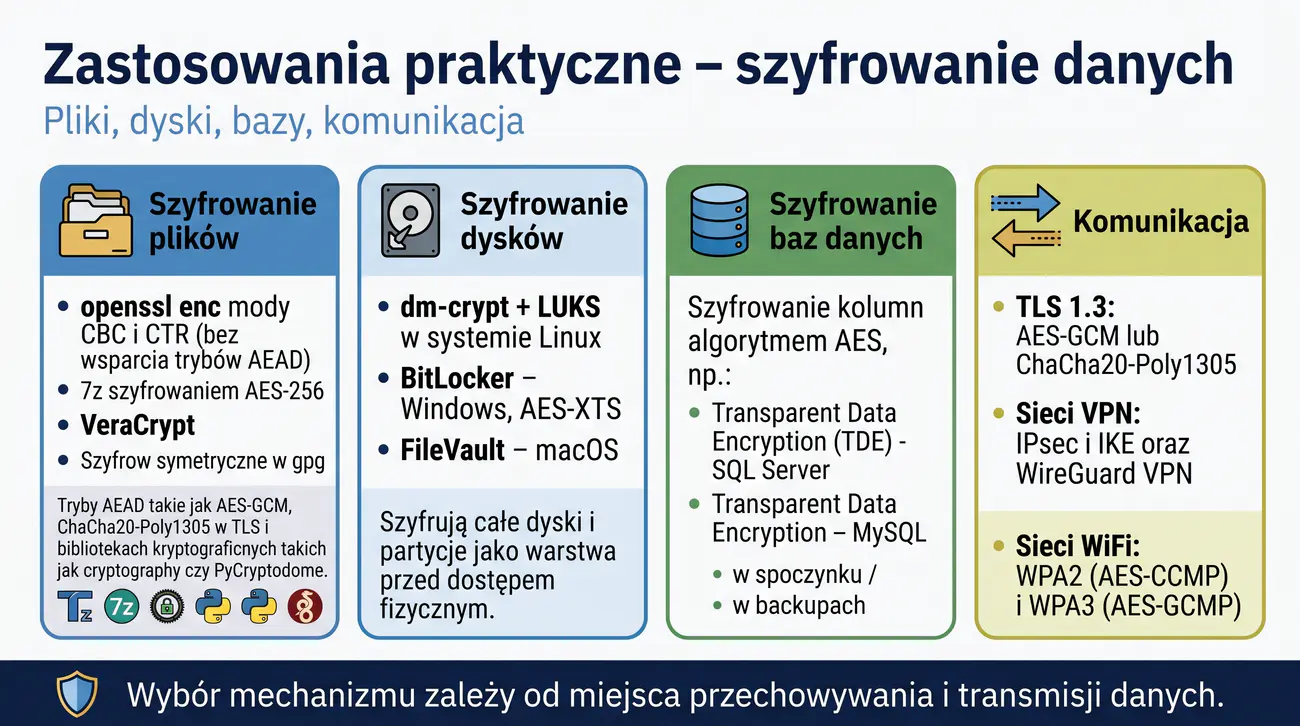
Szyfrowanie danych pojawia się na wszystkich warstwach systemu, począwszy od pojedynczych plików, przez całe wolumeny dysków, aż po połączenia sieciowe. Szyfrowanie całych dysków chroni dane przed odczytem po utracie lub kradzieży sprzętu, natomiast warstwa transportowa, realizowana przez TLS czy VPN, zabezpiecza komunikację podczas jej przesyłu. W bazach danych szyfrowaniu podlegają natomiast wybrane kolumny lub całe kopie zapasowe, zależnie od przyjętego modelu ryzyka.
Wspólnym mianownikiem tych rozwiązań pozostaje odpowiedni dobór algorytmu, trybu pracy oraz sposobu zarządzania kluczami. Nawet najsilniejszy szyfr nie pomoże, jeśli materiał kluczowy przechowywany będzie w niewłaściwym miejscu lub odtwarzany z przewidywalnych danych. Dlatego projektanci systemów przywiązują szczególną wagę do procedur życia kluczy, obejmujących ich tworzenie, odnawianie i niszczenie.
Należy umieć wskazać, w których punktach systemu konieczna jest ochrona poufności, a w których wystarczająca jest kontrola integralności. Taka analiza prowadzi zwykle do skuteczniejszych i tańszych rozwiązań niż otaczanie wszystkiego pełnym szyfrowaniem. Z taką kompleksową wiedzą łatwiej jest także oceniać realne potrzeby organizacji w zakresie ochrony danych.
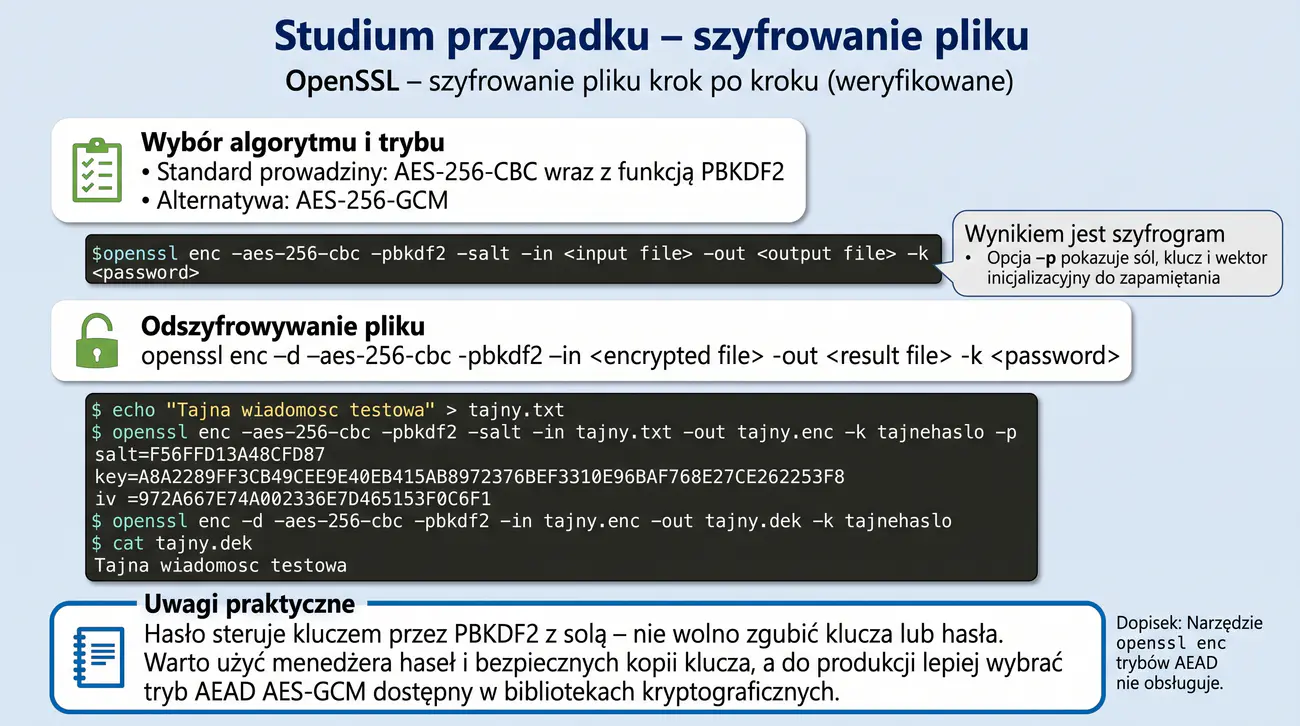
openssl enc -aes-256-cbc -pbkdf2 -salt -in plik -out plik.enc -kfile klucz.txt - w praktyce używaj pliku klucza lub menedżera sekretów, a nie hasła w wierszu poleceń (parametr -pass ujawnia je w historii powłoki i na liście procesów)-p pokazuje sól, klucz i IV (do zapamiętania).openssl enc -d -aes-256-cbc -pbkdf2 -in plik.enc -out plik -pass pass:haslo$ echo -n "Tajna wiadomosc testowa" > jawny.txt $ openssl enc -aes-256-cbc -pbkdf2 -salt -S F56FFD13A48CFD87 -in jawny.txt -out szyfr.bin -pass pass:tajnehaslo -p salt=F56FFD13A48CFD87 key=A8A2289FF3CB49CEE9E40EB415AB8972376BEF3310E96BAF768E27CE262253F8 iv =972A667E74A002336E7D465153F0C6F1 $ openssl enc -d -aes-256-cbc -pbkdf2 -in szyfr.bin -pass pass:tajnehaslo Tajna wiadomosc testowa
Przykład poleceń narzędzia OpenSSL ilustruje pełny cykl wyprowadzania klucza z hasła, szyfrowania i odszyfrowywania pliku na pojedynczym komputerze. Pokazane parametry, takie jak sól i początkowe dane, pozwalają prześledzić, skąd pochodzą klucz, wektor startowy i nagłówek zapisywany w pliku wynikowym. Dzięki temu można samodzielnie powtórzyć całą procedurę na dowolnych danych testowych.
Zastosowana funkcja wyprowadzania klucza z hasła, wraz z jawnym zapisaniem soli w nagłówku, przypomina rozwiązania stosowane w systemach przechowywania haseł. Warto przy tym pamiętać, że bezpieczeństwo takiego rozwiązania zależy od liczby iteracji oraz od jakości samego hasła. Dobre praktyki sugerują zatem wybór możliwie wysokiego kosztu obliczeniowego przy zachowaniu akceptowalnego czasu działania.
Interfejs poleceń opisany na slajdzie nie realizuje trybów AEAD, dlatego w systemach produkcyjnych częściej sięga się po narzędzia przeznaczone do konkretnych zastosowań. Znajomość podstawowych poleceń stanowi jednak punkt wyjścia do dalszych eksperymentów i budowania własnych procedur. Po wykonaniu zadania warto przy tym samodzielnie sprawdzić zachowanie narzędzia dla niepoprawnych haseł i uszkodzonych plików.
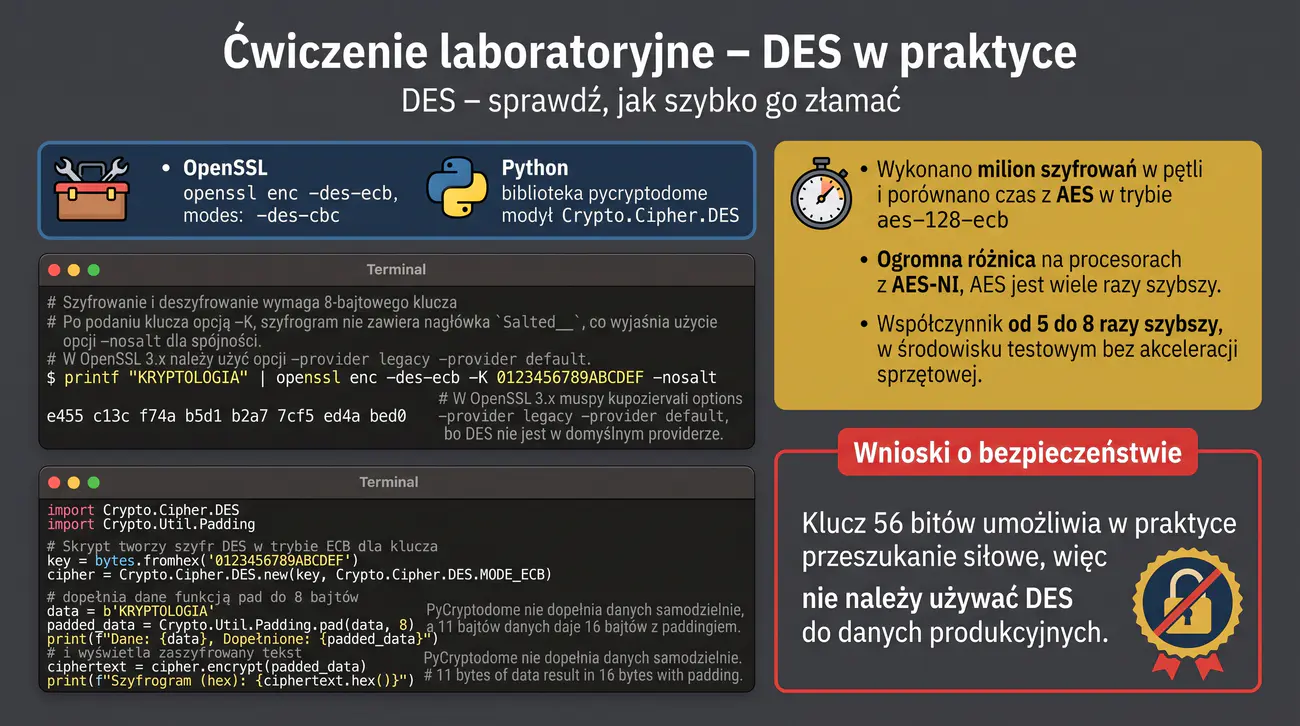
$ printf 'KRYPTOLOGIA' | openssl enc -des-ecb -K 0123456789ABCDEF -nosalt | xxd 00000000: e455 c13c f74a b5d1 b2a7 7cf5 ed4a bed0 .U.<.J......J.. # OpenSSL 3.x: dodaj -provider legacy -provider default (DES nie jest w domyślnym providerze) $ pip install --user pycryptodome # jeśli biblioteka nie jest zainstalowana $ python3 -c " from Crypto.Cipher import DES from Crypto.Util.Padding import pad # PyCryptodome NIE dopełnia danych samodzielnie c = DES.new(bytes.fromhex('0123456789ABCDEF'), DES.MODE_ECB) print(c.encrypt(pad(b'KRYPTOLOGIA', 8)).hex()) # 11 B danych -> 16 B z paddingiem"
Ćwiczenie laboratoryjne celowo zestawia przestarzały szyfr DES z nowoczesnym AES, aby pokazać realny wpływ długości klucza i konstrukcji na czas przetwarzania. Samodzielne pomiary setek tysięcy operacji oraz obserwacja powtarzalności bloków w trybie ECB pogłębiają intuicję, której nie daje samo czytanie opisów. Taka forma nauki rozwija przy okazji umiejętności posługiwania się narzędziami konsolowymi i bibliotekami.
W trakcie pracy warto zwracać uwagę na różnice między wersjami narzędzi, na przykład na konieczność włączenia odpowiednich komponentów starszego oprogramowania w nowszych środowiskach. Zapis wyników w formie tabel pozwala dostrzec, że czasy działania zależą od platformy i konfiguracji, a nie wyłącznie od algorytmu. Porównanie osiągów na różnych komputerach przygotowuje do interpretacji testów wydajnościowych spotykanych w dokumentacji.
Z punktu widzenia bezpieczeństwa ćwiczenie potwierdza przede wszystkim, że same pomiary szybkości nie decydują o klasie algorytmu. Decyzje o wykorzystaniu szyfru towarzyszą zawsze analizie jego parametrów i bieżących zaleceń. Umiejętność prowadzenia i interpretowania takich pomiarów przydaje się zresztą w wielu dziedzinach informatyki wykraczających poza samą kryptografię.
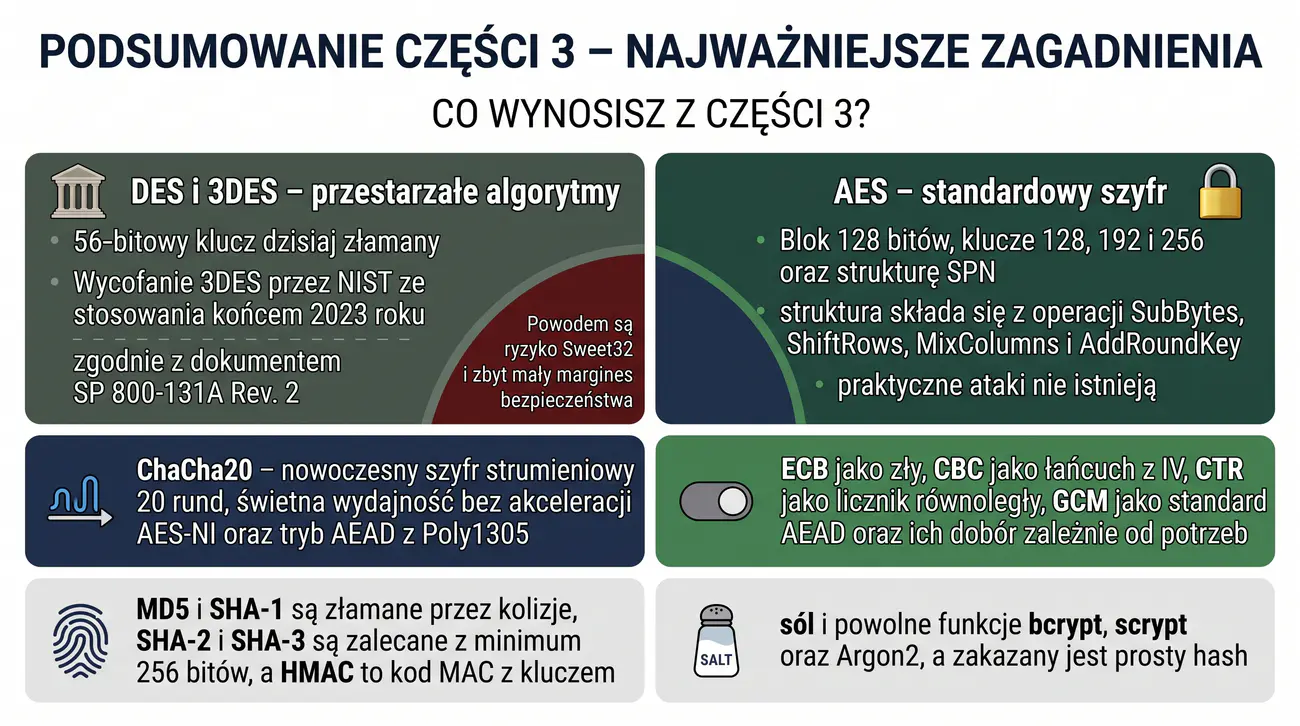
Podsumowanie porządkuje najistotniejsze wnioski, wskazując szyfry blokowe i strumieniowe jako dwa filary współczesnej kryptografii symetrycznej. Zapamiętanie, że siła szyfru zależy nie tylko od klucza, lecz także od trybu pracy i jakości wektorów startowych, pozwala uniknąć najczęstszych błędów wdrożeniowych. Wiedza o funkcjach skrótu i mechanizmie HMAC domyka obraz systemu, w którym poufność, integralność i autentyczność traktowane są jako odrębne wymagania.
Przy powtórce warto tworzyć własne zestawienia algorytmów z ich parametrami i przeznaczeniem, gdyż takie tabele przyspieszają przypominanie materiału. Utrwalenie omawianych zależności jest także warunkiem skutecznego rozwiązywania zadań laboratoryjnych i pytań kontrolnych. Regularne powracanie do tych treści sprzyja zbudowaniu trwałej wiedzy używanej w dalszych częściach cyklu.
Przed przystąpieniem do części asymetrycznej należy zwłaszcza utrwalić pojęcia materiału kluczowego, trybu pracy i funkcji jednokierunkowej. Stanowią one bowiem podstawę zrozumienia wymiany kluczy i podpisów cyfrowych. Powtórka materiału w tej formie przygotowuje zarazem do zadań praktycznych przydatnych w ocenie bezpieczeństwa systemów.
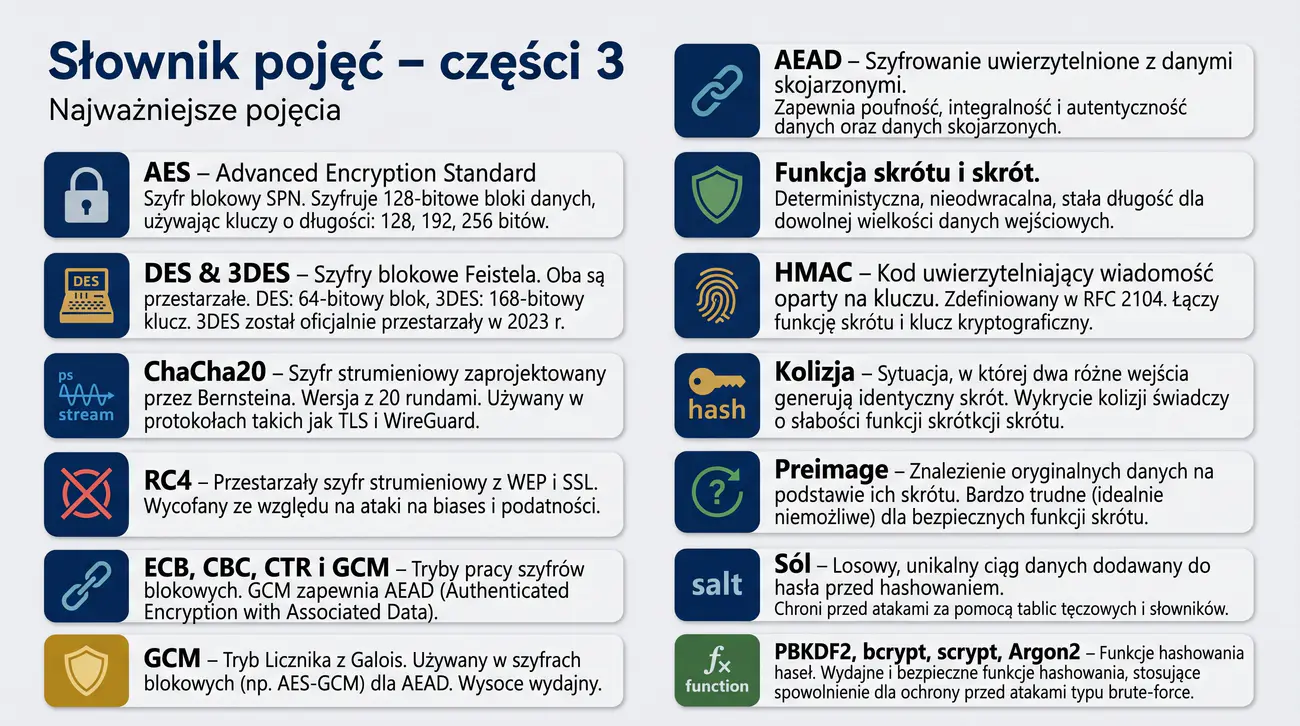
Słownik zbiera terminy najczęściej pojawiające się w literaturze branżowej i dokumentacji narzędzi, co ułatwia czytanie protokołów, standardów i komunikatów błędów. Biegłe posługiwanie się terminami takimi jak kolizja, skrót czy sól jest warunkiem porozumiewania się z innymi specjalistami. Właśnie dlatego opanowanie słownika traktuje się jako element przygotowania zawodowego.
W trakcie nauki warto rozbudowywać słownik własnymi wpisami, opisującymi konkretne parametry poznanych algorytmów oraz przykłady ich zastosowania. Takie notatki stanowią praktyczną ściągę przydatną podczas projektowania systemów i utrwalenia wiedzy. Zestawione definicje ułatwiają także szybkie odświeżenie wiedzy przed rozpoczęciem kolejnych części cyklu.
Świadoma znajomość pojęć zapobiega także nieporozumieniom, które powstają przy używaniu podobnie brzmiących terminów, na przykład skrótu i szyfrowania. Dlatego dobrą praktyką jest wyjaśnianie każdego terminu własnymi słowami. Słownik pozostaje przy tym materiałem otwartym, który każdy odbiorca może rozwijać wraz z postępem nauki.
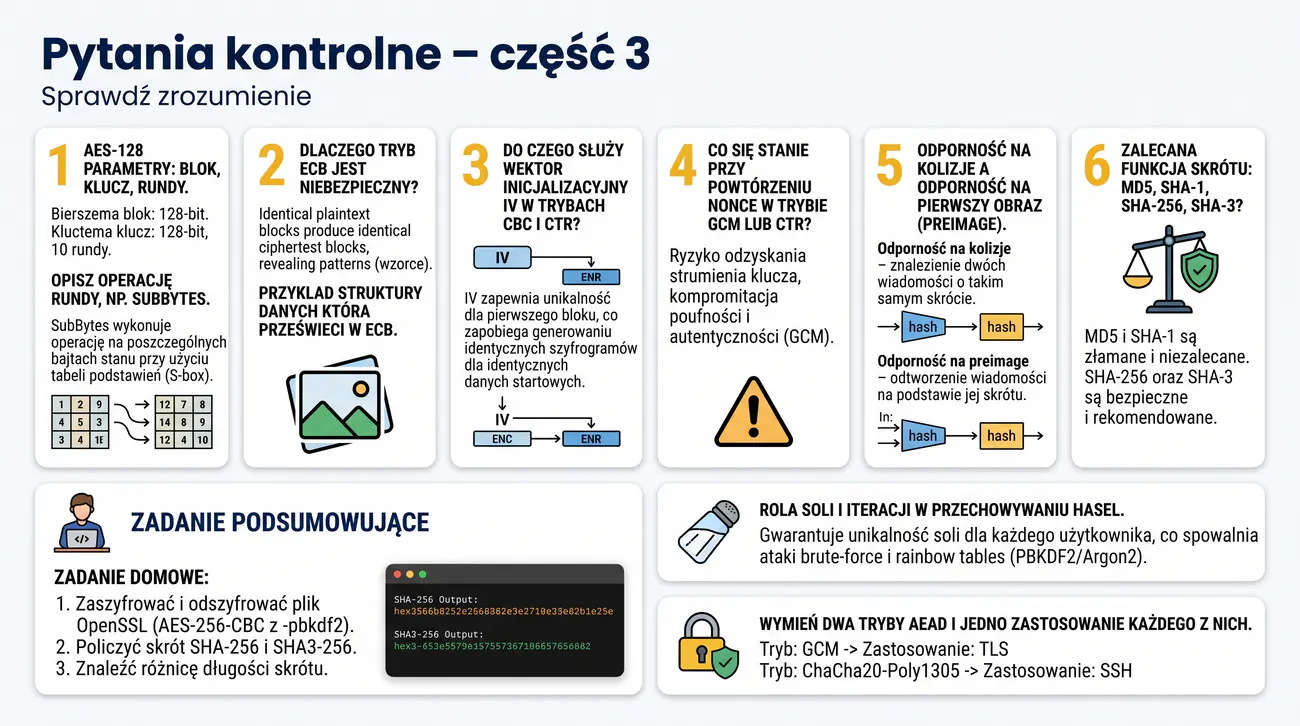
Pytania kontrolne zaprojektowano tak, aby wymusić aktywne przypominanie kolejnych zagadnień, a nie bierne przeglądanie slajdów. Formułowanie odpowiedzi przed ponownym czytaniem materiału pomaga wykryć luki w zrozumieniu, zwłaszcza w tematach dotyczących trybów pracy i własności funkcji skrótu. Wynik takiej samooceny wskazuje, które fragmenty wymagają dodatkowej pracy.
Zalecane jest też rozwiązywanie pytań w formie pisemnej lub ustnej, ponieważ taka praktyka przygotowuje do zadań wykonywanych podczas kolokwiów i rozmów kwalifikacyjnych. Powtarzanie materiału kilka dni po omówieniu tematu znacznie poprawia zapamiętywanie przy jednoczesnym wyłapywaniu błędów interpretacyjnych. Grupowe omawianie odpowiedzi rozwija dodatkowo umiejętność jasnego wyrażania myśli.
Pytania obejmują zarówno prostą wiedzę faktograficzną, jak i elementy wymagające rozumowania, dlatego warto rozstrzygać je samodzielnie, zanim sprawdzi się odpowiedź w materiałach. Dopiero po takim wysiłku wraca się pamięcią do źródła, by skorygować ewentualne błędy. Takie powtarzanie z wykorzystaniem pytań kontrolnych stanowi sprawdzoną metodę przygotowania do weryfikacji wiedzy technicznej.
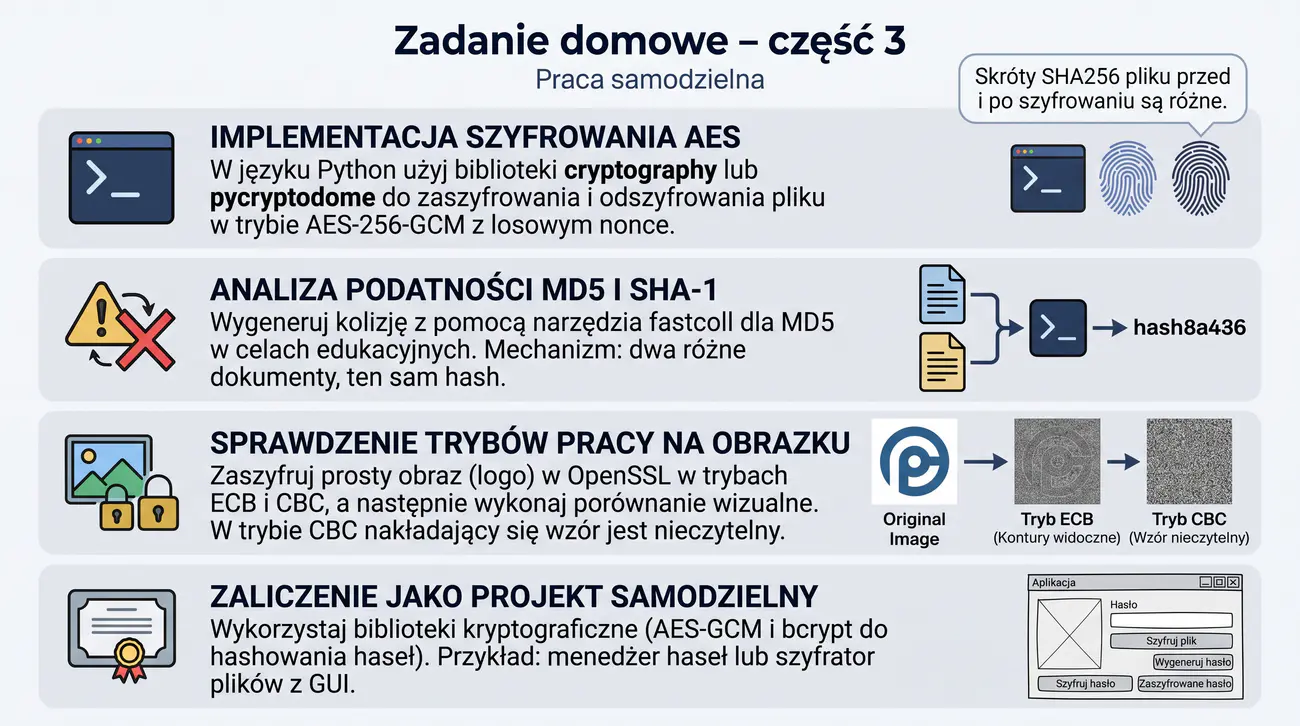
cryptography lub pycryptodome - zaszyfruj i odszyfruj plik (AES-256-GCM z losowym nonce). Krótki kod + wynik (skróty sha256 pliku przed/po = różne).openssl enc -d -aes-256-ecb -K ... -in obraz.enc -out obraz.png) i porównaj wizualnie - widać kontury w ECB (demonstracja).Zadania domowe łączą teorię z programowaniem, wymagając zarówno napisania własnych programów, jak i krytycznej obserwacji wyników narzędzi kryptograficznych. Tworzone w ten sposób skrypty powinny być krótkie, ale starannie udokumentowane, ponieważ ich celem jest nauka, a nie wyłącznie otrzymanie poprawnego wyniku. Pozostawienie komentarzy i zapisanie wszystkich wyników ułatwia późniejszą analizę i poprawę błędów.
W czasie pracy nad zadaniami warto urządzać eksperymenty z danymi o różnej długości i strukturze, aby obserwować wpływ parametrów na wyniki. Demonstracja polegająca na porównaniu skrótów przed i po zmianie danych dostarcza zresztą przekonującego obrazu właściwości funkcji skrótu. Przeprowadzane analizy podatności, wykonywane w środowisku edukacyjnym, powinny zawsze odbywać się wyłącznie na kontrolowanych materiałach.
Projekt samodzielny ma charakter praktyczny i bywa podstawą rozmowy o przebiegu zajęć, dlatego warto go traktować jako okazję do demonstracji kompetencji. Dobrze udokumentowany projekt wykorzystujący szyfrowanie i hashowanie haseł stanowi przy tym cenny element przyszłego CV. Rozsądna organizacja pracy nad zadaniami pozwala przy tym dotrzymać terminów bez poświęcania jakości wykonania.
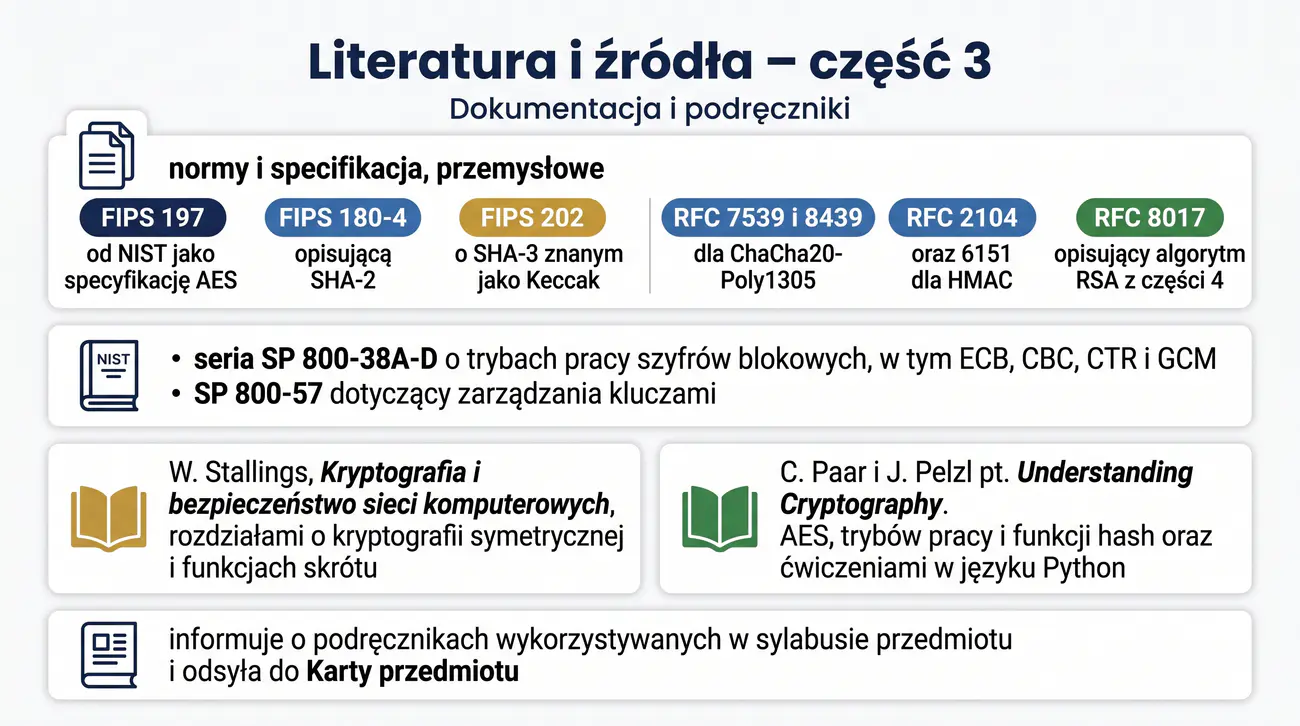
Wskazane dokumenty normalizacyjne i komentarze techniczne stanowią pierwotne, rozstrzygające źródła wiedzy dla każdego inżyniera bezpieczeństwa. Warto uczyć się czytać takie specyfikacje, gdyż dopiero w nich znajdują się ostateczne definicje parametrów, przypadków brzegowych i warunków stosowania. Komentarze do protokołów uzupełniają te informacje o praktyczne wnioski płynące z lat eksploatacji.
Podręczniki wymienione na slajdzie pomagają uporządkować materiał, ale nie zastępują praktyki ani bieżącego śledzenia zmian w zaleceniach. Zawarte w nich ćwiczenia warto natomiast wykonywać systematycznie, aby utrwalać wiedzę w sposób aktywny. Kompletowanie notatek na podstawie kilku źródeł rozwija umiejętność krytycznego porównywania informacji.
Regularne zaglądanie do komunikatów instytucji normalizacyjnych i grup roboczych pozwala zachować świadomość aktualnego stanu bezpieczeństwa. Ta nawykowa praktyka należy do cech profesjonalnie prowadzonej pracy w branży bezpieczeństwa informacji. Dojrzały inżynier potrafi przy tym ocenić wiarygodność stron internetowych i wybierać źródła o ugruntowanej reputacji.